Como Extrair Dados de Extrato Bancário para o Excel
— Por Que o OCR Tradicional Falha e Como a IA Corrige Isso
A extração de faturas é um problema resolvido para a maioria das ferramentas de dados. Uma fatura é um documento de uma página com campos rotulados e discretos — nome do fornecedor, valor, data — cada um em seu próprio espaço. Um extrato bancário é o oposto: uma tabela de transações de várias páginas onde cada linha depende da linha acima, onde um saldo acumulado deve permanecer contínuo da página um à página doze, e onde a única forma de verificar se a extração está correta é o teste mais antigo da contabilidade — o saldo inicial + créditos − débitos é igual ao saldo final? Se a ferramenta perde uma linha ou desloca uma coluna em uma linha, o extrato não concilia mais, e o resultado é pior que inútil: parece correto, mas falha na aritmética. Essa diferença — entre extrair campos rotulados e preservar um livro-razão de transações contínuo — é onde a maioria dos OCR falha em extratos bancários, e onde a extração semântica por IA adota uma abordagem fundamentalmente diferente.
Principais Conclusões
- A verdadeira barreira de extração em extratos bancários não é a precisão dos caracteres — é que uma tabela de transações de várias páginas é uma lista encadeada onde uma linha mal posicionada quebra a conciliação, independentemente de quão limpo cada caractere foi lido.
- Em um extrato empresarial de 12 páginas, cabeçalhos e subtotais de página se repetem em todas as páginas — uma tabela de transações com 147 linhas se torna um arquivo Excel de 160 linhas onde 13 linhas de ruído estrutural são indistinguíveis de dados reais.
- Quando a extração lê a estrutura do documento em vez de coordenadas de pixels, o resultado é um livro-razão verificado onde saldo inicial + créditos − débitos é igual ao saldo final — comprovado antes de entrar no seu sistema contábil.
Por que extratos bancários são estruturalmente mais difíceis que faturas
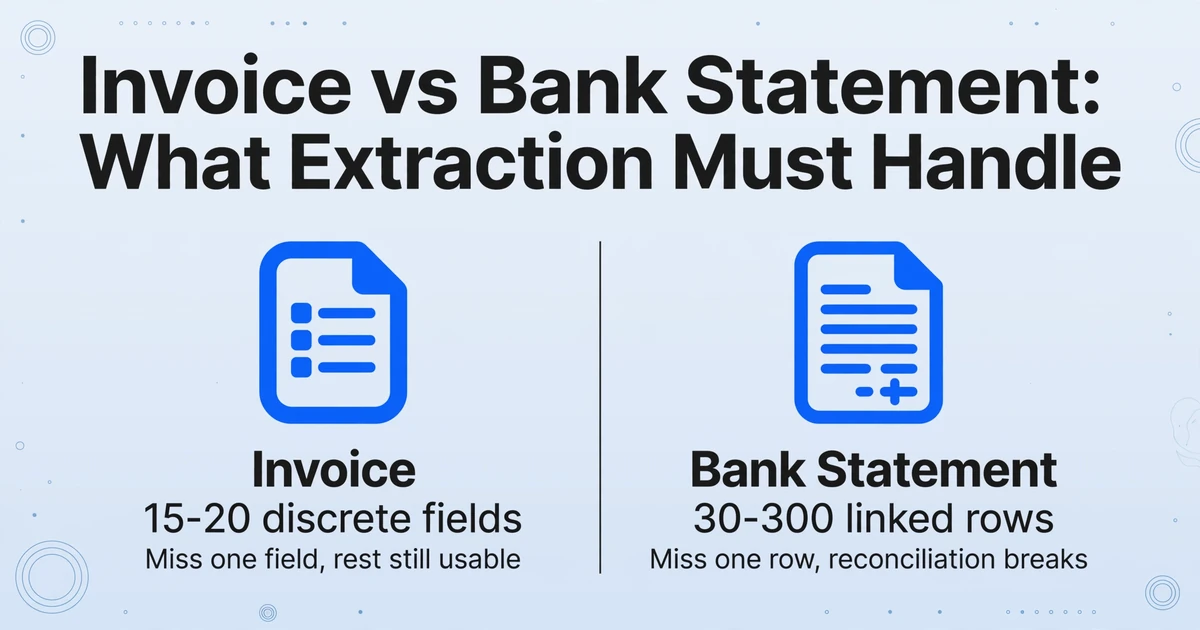
Um extrato bancário não é uma coleção de campos — é um livro-razão ordenado por tempo em que a posição de cada linha importa e a aritmética precisa fechar. Tratá-lo como uma fatura é a causa raiz da maioria das falhas de extração.
Uma fatura tem talvez 15 a 20 pontos de dados distribuídos em regiões rotuladas em uma única página: um número de fatura aqui, uma data de vencimento ali, um total no rodapé. Esses são campos discretos — extraí-los é uma operação de localizar e recuperar. Se a ferramenta perder um campo, ela perde uma informação. O restante da saída ainda é utilizável.
Um extrato bancário é uma estrutura de dados completamente diferente. Ele contém uma tabela de transações — normalmente 30 a 300 linhas por mês — em que cada linha tem uma data, uma descrição, um valor de débito ou crédito e um saldo acumulado. A coluna de saldo na linha 47 depende do saldo na linha 46, que depende da linha 45, até o saldo inicial. Isso é uma estrutura de dados de lista vinculada renderizada como uma tabela impressa. Se a ferramenta perder uma linha ou deslocar uma coluna em uma posição, a cadeia aritmética quebra e toda a conciliação falha — não apenas um campo. Um extrato de investimento adiciona uma tabela de participações sobre as linhas de transação, em que Quantidade, Preço e Valor de Mercado precisam permanecer consistentes dentro de cada linha — uma estrutura que a leitura de nomes de colunas faz sem um modelo específico do corretor.
Some-se o fato de que extratos bancários rotineiramente abrangem várias páginas (frequentemente 3 a 12 páginas para uma conta empresarial mensal), e que a tabela de transações pode quebrar no meio da página com um subtotal transportado, e você vê por que extrair um extrato bancário é um problema fundamentalmente diferente. Não é "OCR mais difícil". É uma classe diferente de extração: reconstrução contínua do livro-razão em vez de extração de campos.
Agravando isso está a enorme variedade de formatos de extratos bancários. Estima-se que existam milhares de layouts distintos de extratos bancários globalmente — do Chase e Bank of America nos EUA ao HSBC e Barclays no Reino Unido, do Deutsche Bank na Alemanha à Caixa no Brasil. Cada banco organiza suas colunas de transação de forma diferente, usa terminologia diferente para débitos e créditos e aplica formatação de página diferente. Uma ferramenta baseada em modelo que funciona para o PDF de um banco precisa de um modelo completamente novo para o extrato de outro banco. Para um escritório de contabilidade que atende clientes em vários bancos, isso significa manter dezenas de modelos apenas para cobrir os formatos comuns — e toda vez que um banco atualiza o design do extrato, outro modelo quebra.
A maioria das pessoas que encontra isso pela primeira vez assume que a solução é melhor OCR — maior precisão no nível de caracteres. Mas o problema real não é ler os caracteres. O problema é entender quais caracteres formam uma linha de transação, quais formam um cabeçalho, quais formam um saldo e como todos se conectam entre páginas. Isso não é reconhecimento óptico. Isso é compreensão de documentos.
O que o OCR Genérico Erra em Extratos Bancários
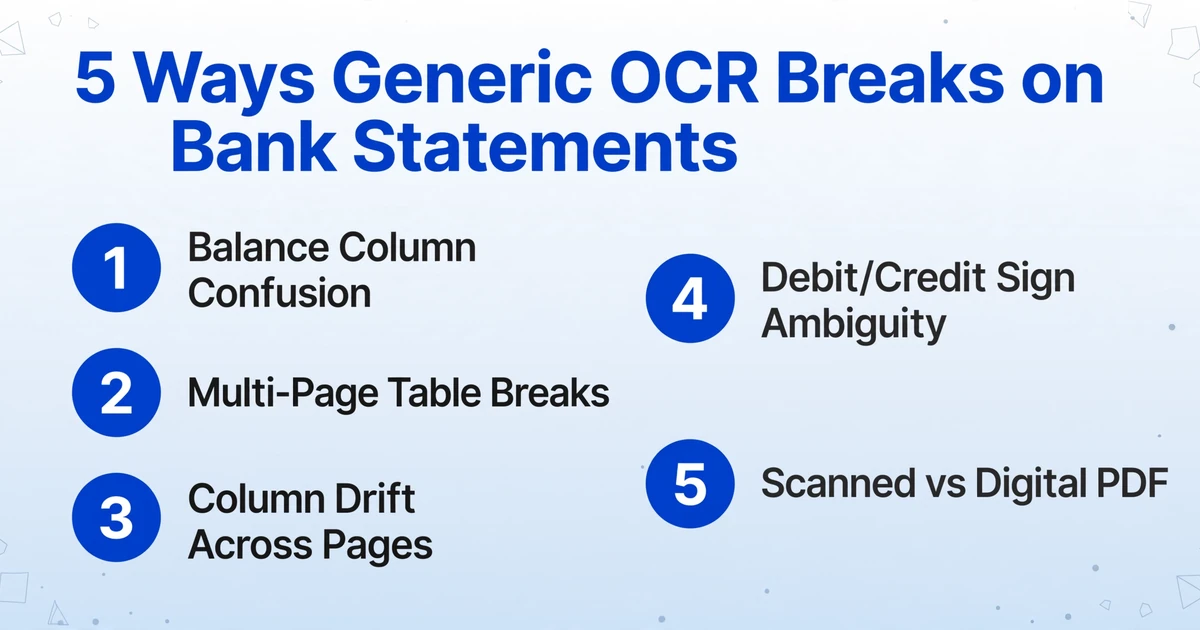
O OCR genérico lê todos os caracteres da página igualmente — ele não consegue distinguir um valor de transação de um saldo acumulado ou de um cabeçalho de página. Em um extrato bancário, isso significa que sua saída no Excel fica contaminada com ruído estrutural desde a primeira linha.
Ao enviar um PDF de extrato bancário por OCR padrão ou por um conversor de PDF para Excel, como a exportação integrada do Adobe, você obtém caracteres aproximadamente corretos dispostos em posições aproximadamente corretas. Mas "posições aproximadamente corretas" falha de cinco maneiras específicas em extratos bancários:
1. Confusão na coluna de saldo. Uma coluna de saldo acumulado parece apenas mais uma coluna de números para o OCR. O mecanismo de OCR não entende que o saldo na linha N é um valor derivado — ele deve ser o resultado de somar ou subtrair o valor da transação da linha N ao saldo anterior, e não um número extraído de forma independente. Quando um extrato tem um layout de quatro colunas (Data | Descrição | Débito | Crédito | Saldo), o OCR frequentemente mescla os valores de saldo nas colunas de débito/crédito ou vice-versa. A planilha resultante parece conter todos os dados, mas os números não batem — e o usuário gasta mais tempo corrigindo a extração do que gastaria digitando do zero, como descreveu um contador no r/Bookkeeping: "Seus PDFs de extrato bancário convertem para Excel corretamente? Os meus não…"
2. Quebras de tabela em várias páginas. Um extrato bancário de 6 páginas é uma única tabela contínua de transações dividida entre páginas. As quebras de página introduzem cabeçalhos de coluna repetidos ("Data | Descrição | Débito | Crédito | Saldo"), números de página e, frequentemente, uma linha de subtotal transportado. O OCR trata cada página como uma tabela independente. O resultado: linhas de cabeçalho e subtotais ficam intercaladas com linhas de transação na saída, quebrando a ordem das linhas e contaminando os dados. Um extrato com 147 transações reais pode acabar com mais de 160 linhas no Excel — 13 das quais são cabeçalhos de página e subtotais disfarçados de dados de transação.
3. Deslocamento de colunas entre páginas. Mesmo dentro do mesmo banco, as colunas de transação podem mudar de posição de uma página para outra. A página um pode ter colunas de Descrição ocupando 60% da largura da página porque não há coluna "Saldo" (ela aparece apenas como saldo inicial no topo). A página dois introduz o saldo acumulado como uma quinta coluna, comprimindo a largura da Descrição para 40%. O OCR que usa coordenadas fixas de coluna (OCR zonal) lerá incorretamente todas as linhas após a mudança de coluna — extraindo números de conta onde deveriam estar as descrições, ou valores de saldo onde deveriam estar os valores de transação.
4. Ambiguidade do sinal de débito/crédito. Alguns bancos usam colunas separadas de Débito e Crédito com números positivos em cada uma. Outros usam uma única coluna de Valor com números negativos para débitos. Ainda outros usam uma única coluna de Valor onde débitos são marcados com o sufixo "Dr" e créditos com "Cr." O OCR lê esses como strings de texto, não como lançamentos contábeis. A saída exige limpeza manual — converter "500.00Dr" para -500.00, ou unificar colunas duplas em uma única coluna com sinal — antes que qualquer conciliação possa começar. De acordo com o AICPA's 2025 Practice Efficiency Benchmark, o escritório de contabilidade médio gasta 11,3 horas por cliente por mês em conciliação bancária, com 78% desse tempo consumido pela correspondência de transações que segue padrões previsíveis e automatizáveis.
5. Confusão entre PDF escaneado e digital. Um PDF digital (gerado diretamente pelo sistema do banco) tem texto selecionável e legível por máquina. Um PDF escaneado (um extrato físico fotografado ou escaneado) é uma imagem de texto — não diferente de uma foto. Muitos tutoriais de PDF para Excel assumem PDFs digitais e falham silenciosamente em extratos escaneados. Motores de OCR projetados para texto digital limpo produzem gibberish em um escaneamento de 150 dpi de um extrato dobrado. No entanto, extratos escaneados continuam comuns: um tópico recente no r/Accounting com 28 upvotes discute a realidade contínua de clientes que "enviam PDFs escaneados para tudo."
Como a Extração por IA Lê Extratos Bancários de Forma Diferente
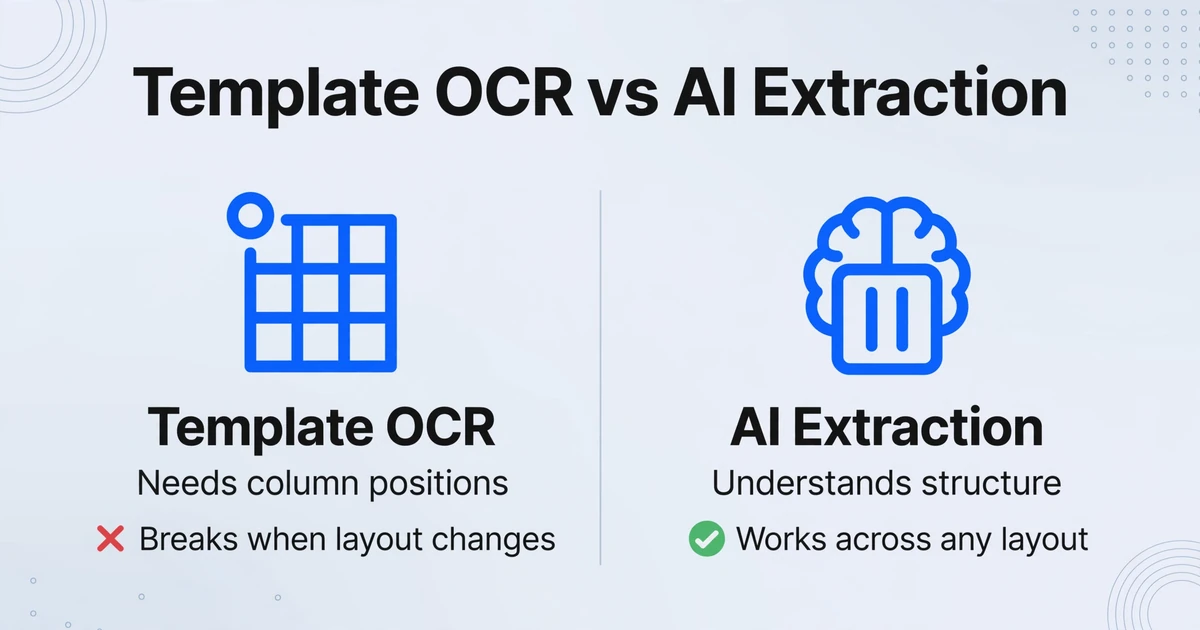
A mudança fundamental do OCR para a extração por IA é a transição de ler caracteres para entender a estrutura do documento — reconhecer que uma coluna de saldo não é apenas uma coluna de números, e uma linha de transação não é apenas uma linha de texto.
O OCR tradicional responde a uma pergunta: "Quais caracteres estão nestas coordenadas?" A extração por IA — especificamente por meio de grandes modelos de visão — responde a uma pergunta diferente: "O que este documento contém e como está organizado?"
Essa é a diferença entre extração baseada em posição e extração baseada em semântica. Uma ferramenta baseada em posição (OCR zonal, parsers baseados em modelo) precisa que lhe digam onde cada campo está na página — "o valor da transação está sempre na quarta coluna, começando a 73mm da borda esquerda." Quando o Chase muda o layout do extrato no próximo trimestre ou quando você recebe um extrato do Wells Fargo em um arranjo de colunas completamente diferente, esse modelo quebra. Você cria um novo.
Extraction de Colonnes Personnalisées — le mécanisme central d'ImageToTable.ai — adopte l'approche inverse. Au lieu d'indiquer au système où se trouvent les données sur la page, vous lui indiquez quelles données vous voulez : des noms de colonnes comme « Date de transaction », « Description », « Montant débité », « Montant crédité » et « Solde ». L'IA lit l'intégralité de la page, comprend quelles parties sont des en-têtes, lesquelles sont des lignes de transaction, lesquelles sont des lignes de solde et lesquelles sont des pieds de page — puis extrait chaque ligne de transaction dans les colonnes que vous avez définies, en préservant l'ordre des lignes de bout en bout. Peu importe la position de chaque colonne utilisée par chaque banque ; l'IA lit le sens sémantique, pas les coordonnées.
Cela importe particulièrement pour les soldes courants. Lorsque vous définissez une colonne « Solde », l'IA reconnaît que cette colonne est un champ dérivé — elle extrait la valeur telle quelle, mais la véritable vérification provient d'une colonne calculée (voir ci-dessous) qui vérifie l'arithmétique. Si l'IA peut également être instruite d'ignorer le solde imprimé et de le recalculer à partir des montants des transactions, vous obtenez une validation intégrée : toute divergence entre le solde calculé et le solde imprimé du relevé signale une ligne nécessitant une révision. Un tableau d'amortissement de prêt est le même type de chaîne — le solde final de chaque paiement doit devenir le solde initial du paiement suivant — donc une seule ligne mal lue fausse le remboursement final.
Le mécanisme qui rend cela possible est la même chose qui rend un modèle de vision-langage fondamentalement différent d'un moteur d'OCR : il traite la page comme une scène visuelle entière, et non comme une grille de boîtes englobantes de caractères. Il voit que « le tableau a 5 colonnes, la cinquième est un solde courant, les données continuent à travers les sauts de page, et la section du milieu a une ligne de sous-total qui n'est pas une transaction ». L'OCR traditionnel ne voit rien de tout cela — il voit des pixels disposés en grille.
Étape par étape : Extraire les données de relevés bancaires dans Excel
Le chemin d'un relevé bancaire PDF à une feuille de calcul propre et prête pour le rapprochement comporte quatre étapes. Aucun modèle, aucune configuration par banque, aucune donnée d'entraînement sur la position des colonnes.
Envie seu extrato bancário
Arraste um PDF, JPG ou PNG — qualquer banco, qualquer número de páginas, digital ou escaneado. Nenhum pré-processamento de formato é necessário.
Defina suas colunas
Digite os nomes das colunas que você quer: Transaction Date, Description, Debit Amount, Credit Amount, Balance, Reference/Check No., Transaction Type. Eles se tornam os cabeçalhos das suas colunas no Excel.
A IA extrai cada linha de transação
A IA lê o documento inteiro, identifica a tabela de transações em todas as páginas, extrai cada linha para as colunas definidas e preserva a ordem das linhas. Cabeçalhos, subtotais e rodapés de página são filtrados automaticamente.
Exporte e concilie
Baixe como Excel (XLSX) ou CSV. Os dados são estruturados, limpos e prontos para importação no QuickBooks, Xero, Sage ou na sua planilha de conciliação.
O fluxo de trabalho em quatro etapas acima — upload, definição de colunas, extração e exportação — é exatamente o que nosso conversor de extrato bancário para Excel faz em uma única passada, sem modelos e sem configuração por banco. Experimente gratuitamente com seu próprio extrato: envie um PDF, nomeie suas colunas e as linhas extraídas voltam em segundos, prontas para a verificação de conciliação.
Os arquivos são processados com segurança e não são armazenados.
O que torna este workflow diferente de um parser baseado em modelo é que você nunca informa ao sistema onde os dados estão — você apenas informa o que deseja. É isso que o torna sem modelo: a IA entende a estrutura do documento independentemente do layout. Quando você recebe um extrato de um novo banco — ou quando seu banco existente redesenha seu formato — não há nada para reconfigurar. Os mesmos nomes de colunas encontram os mesmos dados, independentemente de onde aparecem na página.
Como lidar com extratos de várias páginas e processamento em lote
Uma única conciliação de final de mês pode envolver 12 PDFs de 3 bancos diferentes. O processamento em lote lida com todos de uma vez, mesclando cada transação em uma única planilha de saída, com a ordem das linhas preservada por extrato.
A extração de extratos bancários raramente é um problema de um arquivo por vez. Um contador fechando os livros do Q1 pode enfrentar 3 meses × 3 contas bancárias = 9 PDFs. Uma firma de contabilidade que atende 50 clientes de escrituração pode processar 200+ extratos por mês. A abordagem manual — abrir cada PDF, ler cada linha, digitar no Excel — escala linearmente com a contagem de transações, e os dados do AICPA confirmam o resultado: 11,3 horas por cliente por mês, 3,5 funcionários equivalentes em tempo integral para uma firma com 50 clientes, apenas em conciliação bancária.
Processamento Prioritário em Lote significa que a ferramenta é projetada para aceitar vários arquivos de uma vez e mesclá-los em uma única tabela de saída. Você pode enviar Chase Janeiro, Chase Fevereiro, Chase Março, Wells Fargo Janeiro, Wells Fargo Fevereiro e Wells Fargo Março — seis arquivos em um único lote — e receber uma única planilha Excel com todas as transações dos seis extratos, cada uma marcada com o nome do arquivo de origem para rastreabilidade. A ordem das linhas dentro de cada extrato é preservada, e a saída pode opcionalmente anexar uma coluna de arquivo de origem para que você sempre saiba qual transação veio de qual extrato.
Para extratos de várias páginas, a IA entende que as páginas 1 a 6 de um único PDF representam uma tabela de transações contínua — não seis tabelas separadas. O saldo acumulado que aparece na página 3, linha 28, é reconhecido como a continuação da sequência de transações da página 2. Cabeçalhos, números de página, subtotais transportados e textos padrão do banco que se repetem em cada página são filtrados antes de chegar à sua saída Excel.
É aqui que a combinação lote + várias páginas cria um benefício composto em relação à entrada manual. Um extrato de conta empresarial de 12 páginas com 200 transações que levaria cerca de uma hora para digitar (a 3 minutos por página de entrada manual) é processado em 5–10 segundos por página. O Relatório de Tecnologia Contábil 2025 da Sage descobriu que firmas que automatizaram a conciliação bancária reduziram o tempo de processamento em 75%, enquanto melhoraram a precisão da correspondência na primeira passagem de 94,2% para 99,6%. O insight principal não é apenas a economia de tempo — é que mudar da entrada humana para a extração por IA elimina a categoria mais comum de erro: erros de transposição em que um humano lê "2.847,31" como "2.487,31" ou digita um valor na linha errada.
Para profissionais que precisam de dados diretamente no Google Sheets em vez de um arquivo Excel baixado, o complemento do Google Sheets fornece uma interface de barra lateral que envia extratos e anexa linhas de transações extraídas diretamente à planilha ativa — sem download de arquivo, sem etapa de importação. Para uma visão mais completa de como isso se compara à entrada manual em uma variedade de volumes de extratos, consulte nossa comparação entre entrada manual e IA para extratos bancários.
Tornando os Dados Extraídos Prontos para Reconciliação
Colocar as transações no Excel é o primeiro passo. Fazê-las reconciliar automaticamente — verificando se saldo inicial + créditos − débitos é igual ao saldo final — é onde as colunas calculadas transformam dados extraídos em dados verificados.
Mesmo com linhas de transação perfeitamente extraídas, a reconciliação exige uma verificação aritmética. O extrato bancário declara um saldo inicial e um saldo final; a soma de todas as transações entre eles deve conectar os dois. Um fluxo manual resolve isso fazendo a matemática em uma coluna separada do Excel após a importação. Um fluxo de extração com IA pode resolver isso durante a extração, usando colunas calculadas.
Colunas Calculadas permitem definir cálculos que são executados enquanto a IA processa cada extrato. Para reconciliação de extratos bancários, duas colunas calculadas são particularmente úteis:
Verificação de saldo acumulado: Você pode definir uma coluna calculada que calcula o saldo esperado após cada transação (saldo inicial + soma de todos os débitos e créditos até aquela linha) e o compara com o saldo impresso no extrato. Qualquer discrepância gera um sinalizador — a linha onde a aritmética quebra é a linha que precisa de revisão humana.
Compensação de débito/crédito: Para extratos com colunas separadas de débito e crédito, uma coluna calculada pode calcular o valor líquido de cada linha (Crédito − Débito) e o líquido acumulado em todas as linhas. O líquido acumulado final, somado ao saldo inicial, deve ser igual ao saldo final. Se não for, o valor da discrepância mostra exatamente o quão distante a extração está — e geralmente aponta para uma ou duas linhas específicas que foram lidas incorretamente.
Essas verificações calculadas não são opcionais para quem faz reconciliação — elas são a diferença entre "os dados parecem corretos" e "os dados estão comprovadamente corretos". A Association of Certified Fraud Examiners relata que aproximadamente 22% dos casos de fraude em demonstrações financeiras são descobertos por meio da reconciliação bancária, reforçando por que a etapa de validação aritmética não pode ser ignorada.
Após a extração e validação, a saída estruturada em Excel pode fluir para o seu software de contabilidade — QuickBooks Online, Xero, Sage, NetSuite ou qualquer plataforma que aceite importações CSV/XLSX — com os dados de transação já limpos, padronizados e verificados. Se você está avaliando qual ferramenta usar em todo o seu fluxo de documentos financeiros, nossa comparação de ferramentas de extração de extratos bancários mapeia o cenário por precisão, preço e integração contábil.
Extratos Bancários de Diferentes Bancos e Países
Um sistema de extração independente de formato trata um extrato do Chase, um extrato do Deutsche Bank e um extrato da Caixa como o mesmo problema — cada um é uma tabela de transações com datas, descripções e montos. As diferenças visuais de layout não alteram a lógica de extração.
Um dos custos silenciosos da extração baseada em modelos é a manutenção por banco. Se sua ferramenta de parsing exige treinamento ou criação de modelos para cada formato de banco, e sua empresa processa extratos de 15 bancos diferentes entre seus clientes, você mantiene 15 configurações de parsing. Quando qualquer um desses bancos atualiza o layout de seus extratos — uma mudança de fonte, uma reordenação de colunas, uma nova posição do logo — um de seus modelos deixa de funcionar. Você descobre isso quando tenta processar o extrato de um cliente e a saída fica ilegible, geralmente no final do mês, quando o tempo é mais escasso.
A extração por IA que é independente de formato contorna isso completamente. Se o banco usa um layout de duas colunas (Data + Descrição seguido de Débito + Crédito), um layout de cinco colunas (Data + Descrição + Débito + Crédito + Saldo), ou uma variante regional com terminologia local — "Retraits" em vez de "Débitos", "Versements" em vez de "Créditos" em extratos franceses — a IA identifica a tabela de transações pelo seu padrão estrutural: uma sequência repetitiva de data, descrição textual e montos numéricos. A disposição específica dentro desse padrão não importa.
Esta independência de formato também lida com extratos internacionais onde o padrão de dados subjacente difere. Bancos europeos emitem cada vez mais extratos em camt.053 — o formato XML ISO 20022 para extratos bancários de banco a cliente — que é um formato estruturado, legível por máquina, com metadados explícitos a nível de transação. Mas muitos bancos ainda emiten extratos PDF junto com ou em vez de arquivos camt.053, e alguns países estão a anos de adotar ISO 20022. A realidade para a maioria das equipes de contabilidade é que receben uma mistura: alguns clientes fornecen exportações CSV, alguns fornecen PDFs, e alguns poucos enviam extratos XML que não conseguem parsear. Uma única ferramenta que lida com os três formatos elimina a necessidade de um caminho de processamento separado por formato.
Mesmo dentro de um único país, a diversidade de layouts é substancial. Um extrato de conta corrente empresarial do Wells Fargo tem uma estrutura de tabela diferente de um extrato de conta corrente empresarial do Chase, que difiere de um extrato de uma cooperativa de crédito local. A abordagem independente de formato significa que o contador define as colunas uma vez — "Data da Transação, Descrição, Monto, Saldo" — e usa a mesma definição de colunas em todos os extratos de todos os clientes, independentemente de qual banco os emitiu. Para uma análise mais aprofundada de como isso se aplica especificamente à conciliação em lote de um ano inteiro, consulte nosso guía sobre processamento em lote de 12 meses de extratos bancários em uma única planilha.
Perguntas Frequentes
Funciona com extratos bancários de várias páginas?
Sim. A IA lê o extrato como uma única tabela contínua de transações, independentemente do número de páginas. Um extrato de 12 páginas com 250 transações é processado como uma unidade — cabeçalhos de página, rótulos de coluna repetidos, subtotais transportados e texto de rodapé são automaticamente identificados e filtrados para não contaminar sua saída no Excel. A ordem das linhas é preservada entre as páginas exatamente como aparece no extrato original.
Consegue extrair dados de extratos bancários digitalizados ou fotografados?
Sim. O modelo de linguagem visual lê texto de imagens, não apenas de PDFs digitais. Um extrato em papel digitalizado — seja por scanner de mesa, foto de celular ou digitalização do próprio banco de um registro antigo em papel — é processado da mesma forma que um PDF nativo. A qualidade da imagem importa (uma digitalização de 150 DPI com inclinação visível terá menor precisão do que uma digitalização limpa de 300 DPI), mas não há exigência de um PDF gerado digitalmente com texto selecionável.
Como funciona com a coluna de saldo atual?
A IA extrai o saldo atual conforme aparece no extrato. No entanto, como os saldos impressos podem conter erros ou a extração pode ler um dígito incorretamente, a prática recomendada é definir uma Coluna Calculada que recalcula o saldo atual a partir dos valores de débito e crédito extraídos. Se o saldo calculado coincidir com o saldo impresso, você tem uma verificação cruzada. Se divergirem, você sabe exatamente qual linha revisar. Isso transforma o saldo atual de um campo extraído passivo em um mecanismo de validação ativo.
Funciona com extratos de bancos diferentes com layouts diferentes?
Sim — esta é a principal vantagem da extração independente de formato. Um extrato do Chase, do Wells Fargo, do Barclays e de uma cooperativa de crédito local compartilham todos a mesma estrutura fundamental: uma tabela de transações datadas com descrições textuais e valores numéricos. A IA identifica essa estrutura independentemente da ordem das colunas, fonte, espaçamento ou layout da página. Você usa os mesmos nomes de coluna ("Data da Transação", "Descrição", "Valor") em todos os bancos. Não há necessidade de criar ou manter modelos específicos por banco.
Como os débitos e créditos são tratados?
Alguns bancos usam colunas separadas de Débito e Crédito, com valores positivos em ambas. Outros usam uma única coluna de valor, com números negativos para débitos. Outros ainda anexam sufixos "Dr" ou "Cr" aos valores. A IA pode extrair qualquer estrutura de coluna que exista no extrato, e você pode opcionalmente definir uma coluna calculada que normaliza os valores em uma única coluna de valor assinado (negativo para débitos, positivo para créditos) — produzindo uma saída uniforme, independentemente de como cada banco formata seu extrato.
Qual é a precisão na extração de transações de extratos bancários?
Para PDFs de extratos bancários impressos (digitais) com tipografia clara, a precisão em nível de campo chega a 99%. Para extratos digitalizados ou fotografados, a precisão depende da qualidade da imagem — uma digitalização limpa de 300 dpi se aproxima de resultados semelhantes, enquanto uma foto de celular de baixa resolução de um extrato de papel amassado será menor. A principal salvaguarda é a verificação de conciliação: como todo extrato bancário tem um saldo final verificável contra o qual as transações extraídas podem ser validadas, qualquer erro de extração grande o suficiente para afetar a conciliação será detectado pela etapa de verificação de saldo antes que os dados entrem no seu sistema contábil.
A Conclusão
A extração de extratos bancários fica na interseção de dois problemas que a maioria das ferramentas de dados resolve separadamente: leitura precisa de caracteres e compreensão estrutural de documentos. O OCR sozinho fornece os caracteres, mas não a estrutura — ele não consegue distinguir uma linha de transação de uma linha de cabeçalho, um saldo atual de um valor de transação, ou a tabela da página um da continuação da mesma tabela na página dois. A análise baseada em modelo adiciona estrutura, mas ao custo de configuração por banco e fragilidade quando os layouts mudam.
A extração por IA através de modelos de visão-linguagem colapsa isso em uma única etapa: a IA lê o documento como um todo, entende sua estrutura e extrai o que você pediu — preservando a ordem das linhas, filtrando ruído estrutural e permitindo verificação aritmética antes que os dados cheguem ao seu sistema contábil. A saída não é "aproximadamente os dados certos em aproximadamente a ordem certa". É um razão de transações que se amarra ao saldo final do extrato — o único padrão que importa para a conciliação. Experimente com seu próprio extrato bancário.
Extraia Seu Extrato Bancário Agora →
Grátis para começar — sem necessidade de cartão de crédito