Comment extraire les données de relevés bancaires dans Excel
— pourquoi l'OCR traditionnel échoue et comment l'IA corrige le tir
L'extraction de factures est un problème résolu pour la plupart des outils de données. Une facture est un document d'une page avec des champs étiquetés distincts — nom du fournisseur, montant, date — chacun dans sa propre case. Un relevé bancaire est l'inverse : un tableau de transactions multipage où chaque ligne dépend de la ligne précédente, où un solde courant doit rester continu de la première à la douzième page, et où la seule façon de vérifier que l'extraction est correcte est le test le plus ancien de la comptabilité — le solde d'ouverture + crédits − débits = solde de clôture ? Si l'outil omet une ligne ou décale une colonne d'une ligne, le relevé ne se rapproche plus, et le résultat est pire qu'inutile : il semble correct mais échoue à l'arithmétique. Cette différence — entre l'extraction de champs étiquetés et la préservation d'un registre de transactions continu — est là où la plupart des OCR échouent sur les relevés bancaires, et où l'extraction sémantique par IA adopte une approche fondamentalement différente.
Points clés à retenir
- Le véritable obstacle à l'extraction sur les relevés bancaires n'est pas la précision des caractères — c'est qu'un tableau de transactions multipage est une liste chaînée où une ligne mal placée casse le rapprochement, quel que soit le soin apporté à la lecture de chaque caractère.
- Sur un relevé professionnel de 12 pages, les en-têtes de page et les sous-totaux se répètent sur chaque page — un tableau de transactions de 147 lignes devient un fichier Excel de 160 lignes où 13 lignes de bruit structurel sont impossibles à distinguer des données réelles.
- Lorsque l'extraction lit la structure du document au lieu des coordonnées de pixels, le résultat est un registre vérifié où le solde d'ouverture + crédits − débits égale le solde de clôture — prouvé avant même d'entrer dans votre système comptable.
Pourquoi les relevés bancaires sont structurellement plus difficiles que les factures
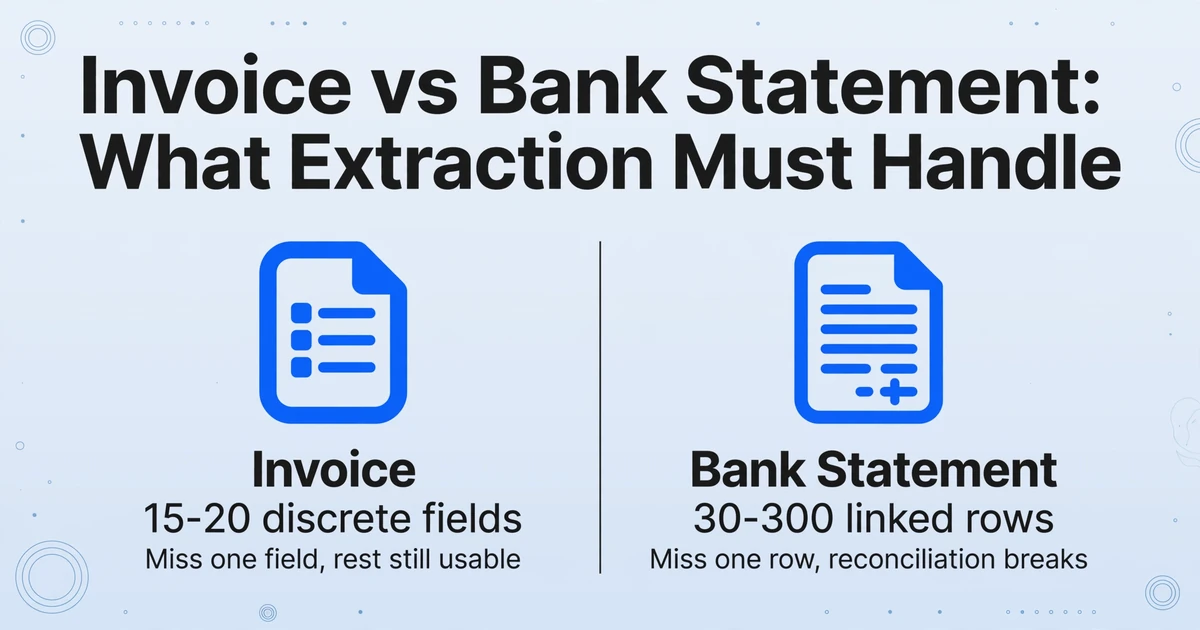
Un relevé bancaire n'est pas un ensemble de champs — c'est un registre chronologique où la position de chaque ligne compte et où l'arithmétique doit boucler. Le traiter comme une facture est la cause racine de la plupart des échecs d'extraction.
Une facture comporte peut-être 15 à 20 points de données répartis dans des zones étiquetées sur une seule page : un numéro de facture ici, une date d'échéance là, un total en bas. Ce sont des champs distincts — les extraire est une opération de recherche et de récupération. Si l'outil manque un champ, il manque une information. Le reste de la sortie reste utilisable.
Un relevé bancaire est une structure de données complètement différente. Il contient un tableau de transactions — généralement 30 à 300 lignes par mois — où chaque ligne a une date, une description, un montant débit ou crédit, et un solde courant. La colonne de solde à la ligne 47 dépend du solde de la ligne 46, qui dépend de la ligne 45, et ainsi de suite jusqu'au solde d'ouverture. C'est une structure de données en liste chaînée rendue sous forme de tableau imprimé. Si l'outil manque une ligne ou décale une colonne d'une position, la chaîne arithmétique se brise et tout le rapprochement échoue — pas seulement un champ. Un relevé de placement superpose un tableau de titres sur les lignes de transactions, où Quantité, Prix et Valeur de marché doivent rester cohérents dans chaque ligne — une structure que la lecture des noms de colonnes gère sans modèle spécifique au courtier.
Ajoutez le fait que les relevés bancaires couvrent couramment plusieurs pages (souvent 3 à 12 pages pour un compte professionnel mensuel), et que le tableau de transactions peut se couper en milieu de page avec un sous-total reporté, et vous comprenez pourquoi extraire un relevé bancaire est un problème fondamentalement différent. Ce n'est pas une « OCR plus difficile ». C'est une classe d'extraction différente : reconstruction continue du registre plutôt qu'extraction de champs.
Ce qui aggrave le problème, c'est la grande variété des formats de relevés bancaires. On estime à des milliers le nombre de mises en page distinctes de relevés bancaires dans le monde — de Chase et Bank of America aux États-Unis à HSBC et Barclays au Royaume-Uni, de Deutsche Bank en Allemagne à Caixa au Brésil. Chaque banque organise ses colonnes de transactions différemment, utilise une terminologie différente pour les débits et crédits, et applique un formatage de page différent. Un outil basé sur des modèles qui fonctionne pour le PDF d'une banque nécessite un tout nouveau modèle pour le relevé d'une autre banque. Pour un cabinet comptable qui gère des clients dans plusieurs banques, cela signifie maintenir des dizaines de modèles juste pour couvrir les formats courants — et chaque fois qu'une banque met à jour la conception de son relevé, un autre modèle casse.
La plupart des personnes qui rencontrent ce problème pour la première fois supposent que la solution est une meilleure OCR — une précision au niveau des caractères plus élevée. Mais le vrai problème n'est pas de lire les caractères. Le problème est de comprendre quels caractères forment une ligne de transaction, lesquels forment un en-tête, lesquels forment un solde, et comment tout cela se connecte entre les pages. Ce n'est pas de la reconnaissance optique. C'est de la compréhension documentaire.
Ce que l'OCR générique rate sur les relevés bancaires
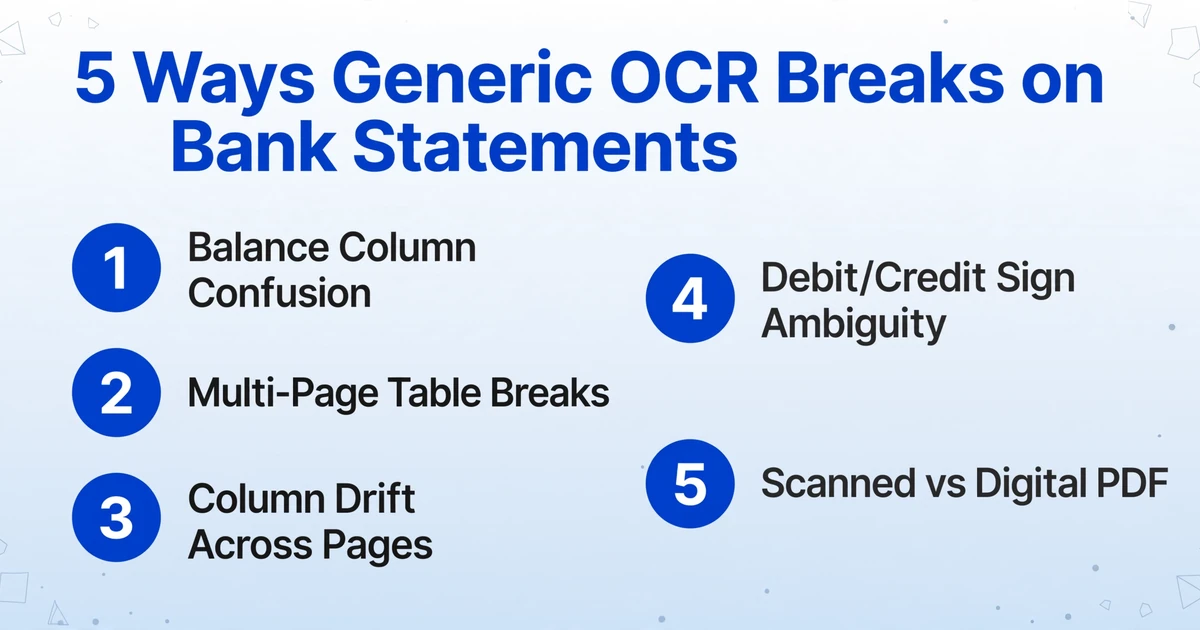
L'OCR générique lit chaque caractère de la page de manière égale — il ne peut pas distinguer un montant de transaction d'un solde courant ou d'un en-tête de page. Sur un relevé bancaire, cela signifie que votre sortie Excel est contaminée par du bruit structurel dès la première ligne.
Lorsque vous alimentez un PDF de relevé bancaire via un OCR standard ou via un convertisseur PDF vers Excel comme l'export intégré d'Adobe, vous obtenez des caractères approximativement corrects disposés à des positions approximativement correctes. Mais « des positions approximativement correctes » échoue de cinq manières spécifiques sur les relevés bancaires :
1. Confusion de la colonne Solde. Une colonne de solde courant ressemble à une simple colonne de nombres pour l'OCR. Le moteur OCR ne comprend pas que le solde de la ligne N est une valeur dérivée — il devrait être le résultat de l'ajout ou de la soustraction du montant de la transaction de la ligne N au solde précédent, et non un nombre extrait indépendamment. Lorsqu'un relevé a une disposition à quatre colonnes (Date | Description | Débit | Crédit | Solde), l'OCR fusionne souvent les valeurs de solde dans les colonnes débit/crédit ou vice versa. La feuille de calcul résultante semble contenir toutes ses données, mais les chiffres ne correspondent pas — et l'utilisateur passe plus de temps à corriger l'extraction qu'il n'en aurait passé à la saisir manuellement, comme l'a décrit un teneur de livres sur r/Bookkeeping : « Est-ce que vos PDF de relevés bancaires se convertissent proprement en Excel ? Les miens non… »
2. Ruptures de tableau multipage. Un relevé bancaire de 6 pages est un tableau de transactions continu divisé entre les pages. Les sauts de page introduisent des en-têtes de colonnes répétés (« Date | Description | Débit | Crédit | Solde »), des numéros de page, et souvent une ligne de sous-total reporté. L'OCR traite chaque page comme un tableau indépendant. Le résultat : les lignes d'en-tête et les lignes de sous-total se retrouvent mélangées aux lignes de transactions dans la sortie, brisant l'ordre des lignes et contaminant les données. Un relevé qui contenait 147 transactions réelles peut se retrouver avec plus de 160 lignes dans Excel — dont 13 sont des en-têtes de page et des sous-totaux déguisés en données de transaction.
3. Décalage des colonnes entre les pages. Même au sein d'une même banque, les colonnes de transactions peuvent changer de position d'une page à l'autre. La première page peut avoir des colonnes Description couvrant 60 % de la largeur de la page car il n'y a pas de colonne « Solde » (elle n'apparaît que comme solde d'ouverture en haut). La deuxième page introduit le solde courant comme cinquième colonne, comprimant la largeur de la Description à 40 %. Un OCR qui utilise des coordonnées de colonnes fixes (OCR zonal) lira mal chaque ligne après le décalage de colonnes — extrayant des numéros de compte là où devraient être les descriptions, ou des montants de solde là où devraient être les montants de transactions.
4. Ambiguïté débit/crédit. Certaines banques utilisent des colonnes Débit et Crédit séparées avec des nombres positifs dans chacune. D'autres utilisent une seule colonne Montant avec des nombres négatifs pour les débits. D'autres encore utilisent une seule colonne Montant où les débits sont marqués d'un suffixe « Dr » et les crédits de « Cr ». L'OCR lit ces éléments comme des chaînes de texte, et non comme des écritures comptables. La sortie nécessite un nettoyage manuel — conversion de « 500.00Dr » en -500.00, ou fusion de deux colonnes en une seule colonne signée — avant que tout rapprochement puisse commencer. Selon le Benchmark d'efficacité pratique 2025 de l'AICPA, le cabinet comptable moyen consacre 11,3 heures par client et par mois au rapprochement bancaire, 78 % de ce temps étant consacré à la correspondance des transactions qui suit des schémas prévisibles et automatisables.
5. Confusion PDF scanné vs numérique. Un PDF numérique (généré directement par le système de la banque) contient du texte sélectionnable et lisible par machine. Un PDF scanné (un relevé papier photographié ou scanné) est une image de texte — pas différent d'une photo. De nombreux tutoriels PDF vers Excel supposent des PDF numériques et échouent silencieusement sur les relevés scannés. Les moteurs d'OCR conçus pour du texte numérique propre produisent du charabia sur un scan de 150 dpi d'un relevé papier plié. Pourtant, les relevés scannés restent courants : un fil récent sur r/Accounting avec 28 votes positifs discute de la réalité persistante des clients qui « envoient des PDF scannés pour tout ».
Comment l'extraction par IA lit les relevés bancaires différemment
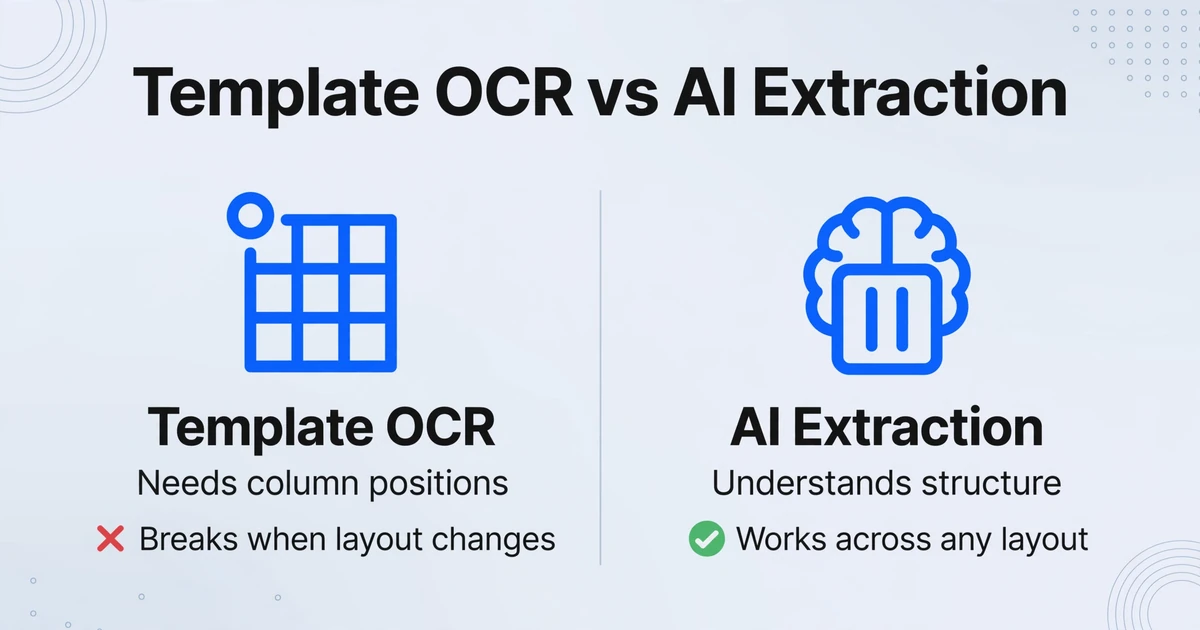
Le changement fondamental de l'OCR vers l'extraction par IA est le passage de la lecture de caractères à la compréhension de la structure du document — reconnaître qu'une colonne de solde n'est pas seulement une colonne de nombres, et qu'une ligne de transaction n'est pas seulement une ligne de texte.
L'OCR traditionnel répond à une question : « Quels caractères se trouvent à ces coordonnées ? » L'extraction par IA — spécifiquement via de grands modèles de vision — répond à une question différente : « Que contient ce document, et comment est-il organisé ? »
C'est la différence entre l'extraction basée sur la position et l'extraction basée sur la sémantique. Un outil basé sur la position (OCR zonal, analyseurs basés sur des modèles) doit savoir où chaque champ se trouve sur la page — « le montant de la transaction est toujours dans la quatrième colonne, à partir de 73 mm du bord gauche ». Lorsque Chase modifie sa mise en page de relevé le trimestre prochain ou que vous recevez un relevé Wells Fargo avec un agencement de colonnes complètement différent, ce modèle casse. Vous en créez un nouveau.
Extraction de colonnes personnalisées — le mécanisme central d'ImageToTable.ai — adopte l'approche inverse. Au lieu d'indiquer au système où se trouvent les données sur la page, vous lui indiquez quelles données vous voulez : des noms de colonnes comme « Date de transaction », « Description », « Montant débité », « Montant crédité » et « Solde ». L'IA lit l'intégralité de la page, comprend quelles parties sont des en-têtes, lesquelles sont des lignes de transaction, lesquelles sont des lignes de solde et lesquelles sont des pieds de page — puis extrait chaque ligne de transaction dans les colonnes que vous avez définies, en préservant l'ordre des lignes de bout en bout. Peu importe la position de colonne utilisée par chaque banque ; l'IA lit le sens sémantique, pas les coordonnées.
Cela importe particulièrement pour les soldes courants. Lorsque vous définissez une colonne « Solde », l'IA reconnaît que cette colonne est un champ dérivé — elle extrait la valeur telle quelle, mais la véritable vérification provient d'une colonne calculée (voir ci-dessous) qui valide l'arithmétique. Si l'on peut également demander à l'IA d'ignorer le solde imprimé et de le recalculer à partir des montants des transactions, vous obtenez une validation intégrée : toute divergence entre le solde calculé et le solde imprimé du relevé signale une ligne nécessitant une révision. Un tableau d'amortissement de prêt est le même type de chaîne — le solde final de chaque paiement doit devenir le solde initial du paiement suivant — de sorte qu'une seule ligne mal lue fausse le remboursement final.
Le mécanisme qui rend cela possible est la même chose qui rend un modèle de vision-langage fondamentalement différent d'un moteur OCR : il traite la page comme une scène visuelle globale, et non comme une grille de boîtes englobantes de caractères. Il voit que « le tableau a 5 colonnes, la cinquième est un solde courant, les données se poursuivent sur les sauts de page, et la section du milieu contient une ligne de sous-total qui n'est pas une transaction ». L'OCR traditionnel ne voit rien de tout cela — il voit des pixels disposés en grille.
Étape par étape : extraire les données de relevés bancaires dans Excel
Le chemin d'un relevé bancaire PDF vers une feuille de calcul propre et prête pour le rapprochement comporte quatre étapes. Sans modèles, sans configuration par banque, sans données d'entraînement sur les positions de colonnes.
Téléchargez votre relevé bancaire
Glissez un PDF, JPG ou PNG — n'importe quelle banque, n'importe quel nombre de pages, numérique ou scanné. Aucun pré-traitement de format requis.
Définissez vos colonnes
Saisissez les noms de colonnes souhaités : Date de transaction, Description, Montant débité, Montant crédité, Solde, Référence/N° de chèque, Type de transaction. Ils deviennent les en-têtes de colonnes de votre fichier Excel.
L'IA extrait chaque ligne de transaction
L'IA lit l'intégralité du document, identifie le tableau des transactions sur toutes les pages, extrait chaque ligne dans vos colonnes définies et préserve l'ordre des lignes. Les en-têtes, sous-totaux et pieds de page sont filtrés automatiquement.
Exportez et rapprochez
Téléchargez en Excel (XLSX) ou CSV. Les données sont structurées, propres et prêtes à être importées dans QuickBooks, Xero, Sage ou votre feuille de rapprochement.
Le flux de travail en quatre étapes ci-dessus — télécharger, définir les colonnes, extraire, exporter — est exactement ce que fait notre convertisseur de relevé bancaire en Excel en une seule passe, sans modèles et sans configuration par banque. Essayez-le gratuitement sur votre propre relevé : téléchargez un PDF, nommez vos colonnes, et les lignes extraites reviennent en quelques secondes, prêtes pour le contrôle de rapprochement.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Ce qui distingue ce workflow d'un analyseur basé sur un modèle, c'est que vous ne dites jamais au système où se trouvent les données — vous lui dites seulement ce que vous voulez. C'est ce qui le rend sans modèle : l'IA comprend la structure du document indépendamment de sa mise en page. Lorsque vous recevez un relevé d'une nouvelle banque — ou lorsque votre banque actuelle repense son format — il n'y a rien à reconfigurer. Les mêmes noms de colonnes trouvent les mêmes données, peu importe où elles apparaissent sur la page.
Gestion des relevés multipages et traitement par lots
Un rapprochement de fin de mois peut impliquer 12 PDF de 3 banques différentes. Le traitement par lots les gère tous en une seule passe, en fusionnant chaque transaction dans un seul tableur de sortie, avec l'ordre des lignes préservé par relevé.
L'extraction de relevés bancaires est rarement un problème de fichier à la fois. Un teneur de livres clôturant les livres du T1 peut faire face à 3 mois × 3 comptes bancaires = 9 PDF. Un cabinet comptable gérant 50 clients de tenue de livres peut traiter plus de 200 relevés par mois. L'approche manuelle — ouvrir chaque PDF, lire chaque ligne, taper dans Excel — évolue linéairement avec le nombre de transactions, et les données de l'AICPA confirment le résultat : 11,3 heures par client et par mois, 3,5 équivalents temps plein pour un cabinet de 50 clients, rien que pour le rapprochement bancaire.
Traitement par lots en priorité signifie que l'outil est conçu pour accepter plusieurs fichiers à la fois et les fusionner en un seul tableau de sortie. Vous pouvez téléverser Chase Janvier, Chase Février, Chase Mars, Wells Fargo Janvier, Wells Fargo Février et Wells Fargo Mars — six fichiers en un seul lot — et recevoir un seul tableur Excel contenant toutes les transactions des six relevés, chacun étiqueté avec son nom de fichier source pour la traçabilité. L'ordre des lignes au sein de chaque relevé est préservé, et la sortie peut éventuellement ajouter une colonne de fichier source afin que vous sachiez toujours quelle transaction provient de quel relevé.
Pour les relevés multipages, l'IA comprend que les pages 1 à 6 d'un même PDF représentent un tableau de transactions continu — et non six tableaux distincts. Le solde courant qui apparaît à la page 3, ligne 28, est reconnu comme la continuation de la séquence de transactions de la page 2. Les en-têtes, numéros de page, sous-totaux reportés et textes génériques bancaires qui se répètent sur chaque page sont filtrés avant d'atteindre votre sortie Excel.
C'est là que la combinaison lot + multipage crée un bénéfice composé par rapport à la saisie manuelle. Un relevé de compte professionnel de 12 pages avec 200 transactions, qui prendrait environ une heure à saisir (à 3 minutes par page de saisie manuelle), est traité en 5 à 10 secondes par page. Le rapport 2025 Accounting Technology Report de Sage a constaté que les cabinets ayant automatisé le rapprochement bancaire ont réduit le temps de traitement de 75 % tout en améliorant la précision de correspondance au premier passage de 94,2 % à 99,6 %. L'idée clé n'est pas seulement le gain de temps — c'est que passer de la saisie humaine à l'extraction par IA élimine la catégorie d'erreurs la plus courante : les erreurs de transposition où une personne lit « 2 847,31 » comme « 2 487,31 » ou saisit un montant dans la mauvaise ligne.
Pour les praticiens qui ont besoin des données directement dans Google Sheets plutôt que dans un fichier Excel téléchargé, le module complémentaire Google Sheets fournit une interface latérale qui téléverse les relevés et ajoute les lignes de transactions extraites directement dans la feuille active — pas de téléchargement de fichier, pas d'étape d'importation. Pour une vue plus complète de la comparaison avec la saisie manuelle sur une gamme de volumes de relevés, consultez notre comparaison saisie manuelle vs IA des relevés bancaires.
Rendre les données extraites prêtes pour le rapprochement
Importer des transactions dans Excel n'est que la première étape. Les faire se rapprocher automatiquement — vérifier que le solde d'ouverture + crédits − débits est égal au solde de clôture — c'est là que les colonnes calculées transforment des données extraites en données vérifiées.
Même avec des lignes de transactions parfaitement extraites, le rapprochement exige un contrôle arithmétique. Le relevé bancaire déclare un solde d'ouverture et un solde de clôture ; la somme de toutes les transactions intermédiaires doit faire le pont entre les deux. Un flux de travail manuel gère cela en effectuant le calcul dans une colonne Excel séparée après l'importation. Un flux de travail d'extraction par IA peut le gérer pendant l'extraction, à l'aide de colonnes calculées.
Colonnes calculées vous permettent de définir des calculs qui s'exécutent pendant que l'IA traite chaque relevé. Pour le rapprochement de relevés bancaires, deux colonnes calculées sont particulièrement utiles :
Vérification du solde courant : Vous pouvez définir une colonne calculée qui calcule le solde attendu après chaque transaction (solde d'ouverture + somme de tous les débits et crédits jusqu'à cette ligne) et le compare au solde imprimé sur le relevé. Toute divergence produit un indicateur — la ligne où l'arithmétique se rompt est celle qui nécessite une revue humaine.
Compensation débit/crédit : Pour les relevés avec des colonnes de débit et de crédit séparées, une colonne calculée peut calculer le montant net pour chaque ligne (Crédit − Débit) et le net cumulé sur toutes les lignes. Le net cumulé final, ajouté au solde d'ouverture, doit être égal au solde de clôture. Si ce n'est pas le cas, le montant de l'écart vous indique exactement à quel point l'extraction est décalée — et pointe généralement vers une ou deux lignes spécifiques qui ont été mal lues.
Ces contrôles calculés ne sont pas facultatifs pour quiconque effectue un rapprochement — ils font la différence entre « les données semblent correctes » et « les données sont prouvées correctes ». L'Association of Certified Fraud Examiners rapporte qu'environ 22 % des cas de fraude aux états financiers sont découverts grâce au rapprochement bancaire, soulignant pourquoi l'étape de validation arithmétique ne peut pas être sautée.
Après l'extraction et la validation, la sortie Excel structurée peut être intégrée à votre logiciel comptable — QuickBooks Online, Xero, Sage, NetSuite, ou toute plateforme acceptant les imports CSV/XLSX — avec les données de transaction déjà nettoyées, standardisées et vérifiées. Si vous évaluez quel outil utiliser pour l'ensemble de votre flux de travail de documents financiers, notre comparaison des outils d'extraction de relevés bancaires cartographie le paysage par précision, tarification et intégration comptable.
Relevés bancaires de différentes banques et pays
Un système d'extraction indépendant du format traite un relevé Chase, un relevé Deutsche Bank et un relevé Caixa comme un même problème — chacun est un tableau de transactions avec dates, descriptions et montants. Les différences de mise en page visuelle ne modifient pas la logique d'extraction.
L'un des coûts cachés de l'extraction basée sur des modèles est la maintenance par banque. Si votre outil d'analyse exige une formation ou la création d'un modèle pour chaque format bancaire, et que votre cabinet traite des relevés de 15 banques différentes parmi vos clients, vous maintenez 15 configurations d'analyse. Lorsque l'une de ces banques met à jour la mise en page de son relevé — un changement de police, une réorganisation des colonnes, un nouvel emplacement de logo — l'un de vos modèles cesse de fonctionner. Vous le découvrez lorsque vous essayez de traiter le relevé d'un client et que le résultat est illisible, généralement en fin de mois quand le temps manque.
L'extraction par IA indépendante du format contourne entièrement ce problème. Que la banque utilise une mise en page à deux colonnes (Date + Description suivies de Débit + Crédit), une mise en page à cinq colonnes (Date + Description + Débit + Crédit + Solde), ou une variante régionale avec une terminologie locale — « Retraits » au lieu de « Débits », « Versements » au lieu de « Crédits » dans les relevés français — l'IA identifie le tableau de transactions par sa structure : une séquence répétée de date, description textuelle et montants numériques. La disposition spécifique au sein de ce schéma n'a pas d'importance.
Cette indépendance du format gère également les relevés internationaux où la norme de données sous-jacente diffère. Les banques européennes émettent de plus en plus des relevés au format camt.053 — le format XML ISO 20022 pour les relevés bancaires aux clients — un format structuré et lisible par machine avec des métadonnées explicites au niveau des transactions. Mais de nombreuses banques publient encore des relevés PDF en complément ou à la place des fichiers camt.053, et certains pays sont à des années de l'adoption de l'ISO 20022. La réalité pour la plupart des équipes comptables est qu'elles reçoivent un mélange : certains clients fournissent des exports CSV, d'autres des PDF, et quelques-uns transmettent des relevés XML qu'ils ne peuvent pas analyser. Un outil unique qui gère les trois formats élimine le besoin d'un chemin de traitement distinct par format.
Même au sein d'un seul pays, la diversité des mises en page est considérable. Un relevé de compte professionnel Wells Fargo a une structure de tableau différente de celle d'un relevé de compte professionnel Chase, qui diffère elle-même de celle d'un relevé de caisse d'épargne locale. L'approche indépendante du format signifie que le teneur de livres définit les colonnes une seule fois — « Date de transaction, Description, Montant, Solde » — et utilise la même définition de colonnes pour les relevés de tous les clients, quelle que soit la banque émettrice. Pour un aperçu plus approfondi de la façon dont cela s'applique spécifiquement au rapprochement par lots sur une année entière, consultez notre guide sur le traitement par lots de 12 mois de relevés bancaires dans une seule feuille de calcul.
FAQ
Fonctionne-t-il avec les relevés bancaires multipages ?
Oui. L'IA lit le relevé comme un tableau de transactions continu, quel que soit le nombre de pages. Un relevé de 12 pages avec 250 transactions est traité comme un seul bloc — les en-têtes de page, les libellés de colonnes répétés, les sous-totaux reportés et les textes de pied de page sont automatiquement identifiés et filtrés pour ne pas contaminer votre export Excel. L'ordre des lignes est conservé entre les pages, exactement comme sur le relevé original.
Peut-il extraire des données de relevés bancaires scannés ou photographiés ?
Oui. Le modèle de langage visuel lit le texte des images, pas seulement des PDF numériques. Un relevé papier scanné — qu'il provienne d'un scanner à plat, d'une photo de téléphone ou du scan par une banque d'un ancien document papier — est traité de la même manière qu'un PDF natif. La qualité de l'image compte (un scan à 150 dpi avec une inclinaison visible donnera une précision moindre qu'un scan net à 300 dpi), mais aucun PDF généré numériquement avec texte sélectionnable n'est requis.
Comment gère-t-il la colonne du solde courant ?
L'IA extrait le solde courant tel qu'il apparaît sur le relevé. Cependant, comme les soldes imprimés peuvent contenir des erreurs ou que l'extraction peut mal lire un chiffre, la pratique recommandée est de définir une Colonne calculée qui recalcule le solde courant à partir des montants de débit et de crédit extraits. Si le solde calculé correspond au solde imprimé, vous obtenez une double vérification. S'ils divergent, vous savez exactement quelle ligne vérifier. Cela transforme le solde courant d'un champ extrait passif en un mécanisme de validation actif.
Cela fonctionne-t-il avec des relevés de différentes banques ayant des mises en page différentes ?
Oui — c'est l'avantage principal de l'extraction indépendante du format. Un relevé Chase, un relevé Wells Fargo, un relevé Barclays et un relevé d'une caisse locale partagent tous la même structure fondamentale : un tableau de transactions datées avec des descriptions textuelles et des montants numériques. L'IA identifie cette structure indépendamment de l'ordre des colonnes, de la police, de l'espacement ou de la mise en page. Vous utilisez les mêmes noms de colonnes (« Date de transaction », « Description », « Montant ») pour toutes les banques. Aucun modèle par banque à créer ou à maintenir.
Comment les débits et les crédits sont-ils gérés lorsque les banques les formatent différemment ?
Certaines banques utilisent des colonnes Débit et Crédit séparées avec des valeurs positives dans les deux. D'autres utilisent une colonne Montant unique avec des nombres négatifs pour les débits. D'autres encore ajoutent des suffixes « Dr » ou « Cr » aux montants. L'IA peut extraire la structure de colonnes existante sur le relevé, et vous pouvez éventuellement définir une colonne calculée qui normalise les valeurs en une seule colonne de montant signé (négatif pour les débits, positif pour les crédits) — produisant ainsi une sortie uniforme, quelle que soit la façon dont chaque banque formate son relevé.
Quelle est la précision de l'extraction des transactions sur relevé bancaire ?
Pour les PDF de relevés bancaires imprimés (numériques) avec une typographie claire, la précision au niveau des champs atteint jusqu'à 99 %. Pour les relevés scannés ou photographiés, la précision dépend de la qualité de l'image — un scan propre à 300 dpi donne des résultats similaires, tandis qu'une photo basse résolution d'un relevé papier froissé sera moins précise. La principale protection est le contrôle de rapprochement : comme chaque relevé bancaire a un solde de clôture vérifiable par rapport auquel les transactions extraites peuvent être validées, toute erreur d'extraction suffisamment importante pour affecter le rapprochement sera détectée par l'étape de vérification du solde avant que les données n'entrent dans votre système comptable.
L'essentiel
L'extraction de relevés bancaires se situe à l'intersection de deux problèmes que la plupart des outils de données résolvent séparément : la lecture précise des caractères et la compréhension structurelle des documents. L'OCR seule vous donne les caractères mais pas la structure — elle ne peut pas distinguer une ligne de transaction d'une ligne d'en-tête, un solde courant d'un montant de transaction, ou le tableau de la page un de la continuation du même tableau en page deux. L'analyse basée sur des modèles ajoute de la structure mais au prix d'une configuration par banque et d'une fragilité lorsque les mises en page changent.
L'extraction par IA via des modèles vision-langage fusionne ces deux étapes en une seule : l'IA lit le document dans son ensemble, comprend sa structure et extrait ce que vous demandez — en préservant l'ordre des lignes, en filtrant le bruit structurel et en permettant une vérification arithmétique avant que les données n'atteignent votre système comptable. Le résultat n'est pas « approximativement les bonnes données dans approximativement le bon ordre ». C'est un registre de transactions qui correspond au solde de clôture du relevé — la seule norme qui compte pour le rapprochement. Essayez-le sur votre propre relevé bancaire.
Extraire votre relevé bancaire maintenant →
Gratuit pour commencer — aucune carte de crédit requise