So extrahieren Sie Bankkontoauszugsdaten in Excel
– Warum herkömmliche OCR versagt und wie KI das Problem löst
Rechnungsextraktion ist für die meisten Datentools ein gelöstes Problem. Eine Rechnung ist ein einseitiges Dokument mit klar beschrifteten Feldern – Lieferantenname, Betrag, Datum – jedes in seiner eigenen Box. Ein Bankkontoauszug ist das Gegenteil: eine mehrseitige Transaktionstabelle, in der jede Zeile von der darüberliegenden abhängt, in der ein laufender Saldo von Seite eins bis Seite zwölf kontinuierlich bleiben muss, und in der die einzige Möglichkeit, die Extraktion zu verifizieren, der älteste Test der Buchhaltung ist – ergibt Eröffnungssaldo + Gutschriften − Belastungen = Schlusssaldo? Wenn das Tool eine Zeile verliert oder eine Spalte um eine Zeile verschiebt, stimmt der Auszug nicht mehr ab, und die Ausgabe ist schlimmer als nutzlos: Sie sieht richtig aus, besteht aber die Arithmetik nicht. Dieser Unterschied – zwischen dem Extrahieren beschrifteter Felder und dem Bewahren eines kontinuierlichen Transaktionsjournals – ist der Punkt, an dem die meisten OCR bei Bankkontoauszügen scheitert und wo semantische KI-Extraktion einen grundlegend anderen Ansatz verfolgt.
Wichtigste Erkenntnisse
- Die eigentliche Extraktionshürde bei Bankkontoauszügen ist nicht die Zeichengenauigkeit – sondern dass eine mehrseitige Transaktionstabelle eine verknüpfte Liste ist, bei der eine falsch platzierte Zeile die Abstimmung bricht, unabhängig davon, wie sauber jedes Zeichen gelesen wurde.
- Bei einem 12-seitigen Geschäftsauszug wiederholen sich Seitenkopfzeilen und Zwischensummen auf jeder Seite – eine 147-zeilige Transaktionstabelle wird zu einer 160-zeiligen Excel-Datei, in der 13 strukturelle Rauschzeilen von echten Daten nicht zu unterscheiden sind.
- Wenn die Extraktion die Dokumentstruktur statt Pixelkoordinaten liest, ist die Ausgabe ein verifiziertes Journal, in dem Eröffnungssaldo + Gutschriften − Belastungen dem Schlusssaldo entspricht – nachgewiesen, bevor es in Ihr Buchhaltungssystem gelangt.
Warum Kontoauszüge strukturell schwieriger sind als Rechnungen
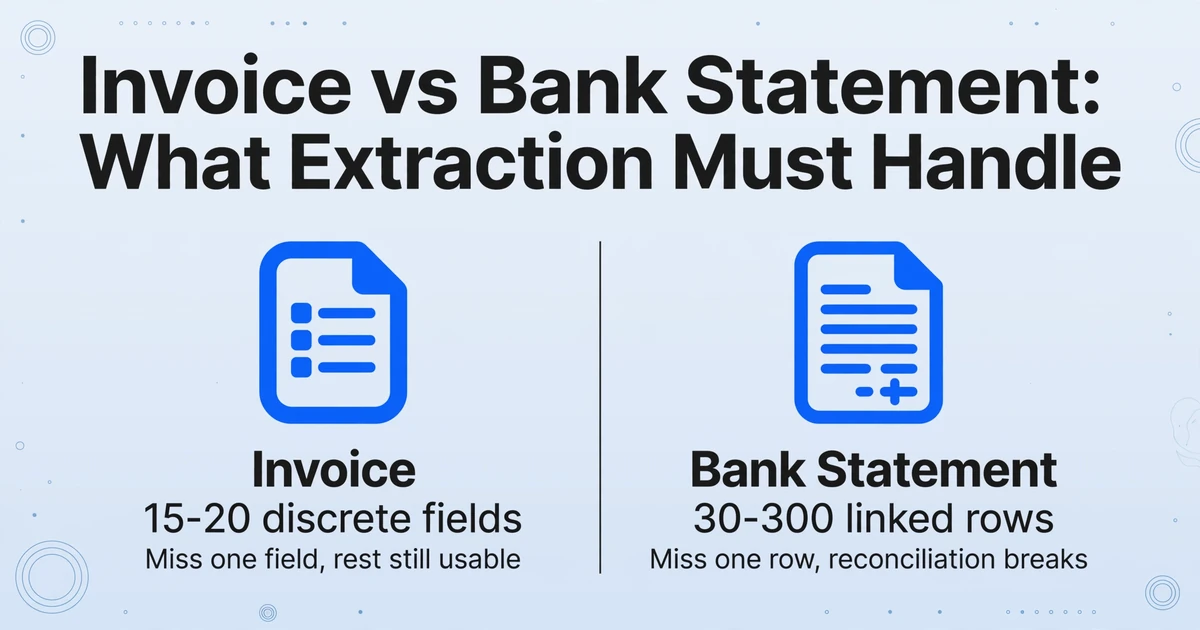
Ein Kontoauszug ist keine Sammlung von Feldern – er ist ein zeitlich geordnetes Hauptbuch, in dem die Position jeder Zeile zählt und die Arithmetik aufgehen muss. Ihn wie eine Rechnung zu behandeln, ist die häufigste Ursache für fehlgeschlagene Extraktionen.
Eine Rechnung hat vielleicht 15 bis 20 Datenpunkte, die über beschriftete Bereiche auf einer einzelnen Seite verteilt sind: hier eine Rechnungsnummer, dort ein Fälligkeitsdatum, unten eine Summe. Das sind einzelne Felder – ihre Extraktion ist eine Suchen-und-Abrufen-Operation. Verfehlt das Tool ein Feld, fehlt eine Information. Der Rest der Ausgabe bleibt nutzbar.
Ein Kontoauszug ist eine völlig andere Datenstruktur. Er enthält eine Transaktionstabelle – typischerweise 30 bis 300 Zeilen pro Monat –, in der jede Zeile ein Datum, eine Beschreibung, einen Soll- oder Haben-Betrag und einen laufenden Saldo aufweist. Die Saldospalte in Zeile 47 hängt vom Saldo in Zeile 46 ab, der wiederum von Zeile 45 – und so weiter bis zum Eröffnungssaldo. Das ist eine als gedruckte Tabelle dargestellte verkettete Listenstruktur. Verfehlt das Tool eine Zeile oder verschiebt eine Spalte um eine Position, bricht die arithmetische Kette und der gesamte Abgleich schlägt fehl – nicht nur ein Feld. Ein Investmentauszug legt zusätzlich eine Bestandstabelle über die Transaktionszeilen, in der Menge, Kurs und Marktwert innerhalb jeder Zeile konsistent bleiben müssen – eine Struktur, die die Spaltenbenennung ohne brokerspezifische Vorlage liest.
Hinzu kommt, dass Kontoauszüge regelmäßig mehrere Seiten umfassen (bei einem monatlichen Geschäftskonto oft 3 bis 12 Seiten) und die Transaktionstabelle mitten auf der Seite mit einem übertragenen Zwischensummenwert abbrechen kann – und schon wird klar, warum die Extraktion eines Kontoauszugs ein grundlegend anderes Problem ist. Es ist nicht „schwierigere OCR“. Es ist eine andere Klasse der Extraktion: kontinuierliche Hauptbuch-Rekonstruktion statt Feldextraktion.
Verstärkt wird dies durch die schiere Vielfalt der Kontoauszugsformate. Weltweit existieren schätzungsweise tausende verschiedene Kontoauszugs-Layouts – von Chase und Bank of America in den USA über HSBC und Barclays in Großbritannien, von der Deutschen Bank in Deutschland bis zur Caixa in Brasilien. Jede Bank ordnet ihre Transaktionsspalten anders an, verwendet unterschiedliche Begriffe für Soll und Haben und wendet unterschiedliche Seitenformatierungen an. Ein vorlagenbasiertes Tool, das für das PDF einer Bank funktioniert, benötigt für den Auszug einer anderen Bank eine völlig neue Vorlage. Für eine Buchhaltungsfirma, die Kunden mehrerer Banken betreut, bedeutet das, dutzende Vorlagen zu pflegen, nur um die gängigen Formate abzudecken – und jedes Mal, wenn eine Bank ihr Auszugsdesign aktualisiert, bricht eine weitere Vorlage.
Die meisten, die zum ersten Mal damit konfrontiert werden, nehmen an, die Lösung sei bessere OCR – höhere Zeichengenauigkeit. Aber das eigentliche Problem ist nicht das Lesen der Zeichen. Das Problem ist, zu verstehen, welche Zeichen eine Transaktionszeile bilden, welche eine Kopfzeile, welche einen Saldo – und wie sie alle über Seiten hinweg zusammenhängen. Das ist keine optische Erkennung. Das ist Dokumentverständnis.
Was generische OCR bei Kontoauszügen falsch macht
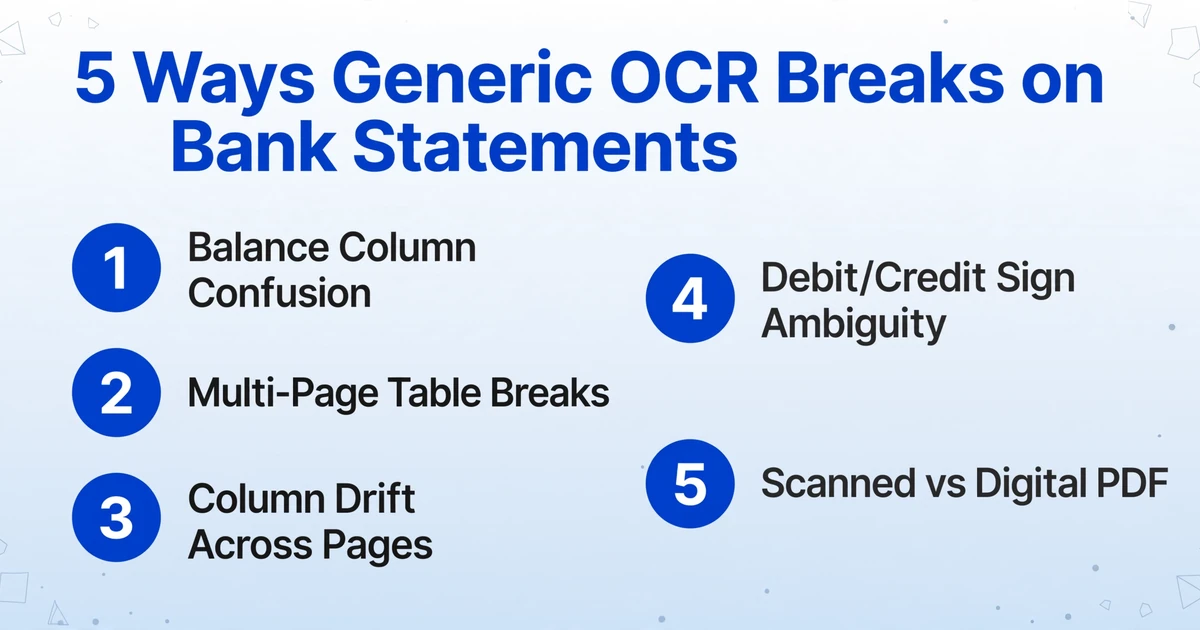
Generische OCR liest jedes Zeichen auf der Seite gleich – sie kann einen Transaktionsbetrag nicht von einem laufenden Saldo oder einer Seitenkopfzeile unterscheiden. Bei einem Kontoauszug bedeutet das, dass Ihre Excel-Ausgabe bereits ab der ersten Zeile mit strukturellem Rauschen verunreinigt ist.
Wenn Sie einen Kontoauszug-PDF durch Standard-OCR oder durch einen PDF-zu-Excel-Konverter wie den integrierten Export von Adobe schicken, erhalten Sie ungefähr korrekte Zeichen an ungefähr korrekten Positionen. Aber „ungefähr korrekte Positionen" scheitert bei Kontoauszügen auf fünf spezifische Arten:
1. Verwechslung der Saldenspalte. Eine Spalte mit laufendem Saldo sieht für OCR wie eine weitere Zahlenspalte aus. Die OCR-Engine versteht nicht, dass der Saldo in Zeile N ein abgeleiteter Wert ist – er sollte das Ergebnis der Addition oder Subtraktion des Transaktionsbetrags von Zeile N zum vorherigen Saldo sein, nicht eine unabhängig extrahierte Zahl. Wenn ein Kontoauszug ein vierspaltiges Layout hat (Datum | Beschreibung | Soll | Haben | Saldo), führt OCR oft Saldenwerte in die Soll-/Haben-Spalten zusammen oder umgekehrt. Die resultierende Tabelle scheint alle Daten zu enthalten, aber die Zahlen stimmen nicht – und der Nutzer verbringt mehr Zeit mit der Korrektur der Extraktion, als er für die manuelle Eingabe gebraucht hätte, wie ein Buchhalter auf r/Bookkeeping beschrieb: „Konvertieren sich Ihre Kontoauszug-PDFs sauber in Excel? Meine nicht…"
2. Tabellenbrüche über mehrere Seiten. Ein 6-seitiger Kontoauszug ist eine durchgehende Transaktionstabelle, die über mehrere Seiten verteilt ist. Seitenumbrüche führen wiederholte Spaltenüberschriften („Datum | Beschreibung | Soll | Haben | Saldo"), Seitenzahlen und oft eine übertragene Zwischensummenzeile ein. OCR behandelt jede Seite als unabhängige Tabelle. Das Ergebnis: Kopfzeilen und Zwischensummenzeilen werden in der Ausgabe zwischen Transaktionszeilen eingestreut, was die Zeilenreihenfolge bricht und die Daten verunreinigt. Ein Kontoauszug mit 147 echten Transaktionen kann in Excel als 160+ Zeilen enden – 13 davon sind Seitenkopfzeilen und Zwischensummen, die sich als Transaktionsdaten tarnen.
3. Spaltenverschiebung über Seiten hinweg. Selbst innerhalb derselben Bank können sich Transaktionsspalten von Seite zu Seite verschieben. Seite eins könnte Beschreibungsspalten haben, die 60 % der Seitenbreite einnehmen, weil es keine „Saldo"-Spalte gibt (sie erscheint nur als Eröffnungssaldo oben). Seite zwei führt den laufenden Saldo als fünfte Spalte ein und komprimiert die Beschreibungsbreite auf 40 %. OCR, die feste Spaltenkoordinaten verwendet (zonale OCR), liest jede Zeile nach der Spaltenverschiebung falsch – sie extrahiert Kontonummern, wo Beschreibungen sein sollten, oder Saldenbeträge, wo Transaktionsbeträge sein sollten.
4. Mehrdeutigkeit von Soll/Haben-Vorzeichen. Manche Banken verwenden getrennte Soll- und Haben-Spalten mit positiven Zahlen in beiden. Andere verwenden eine einzelne Betragsspalte mit negativen Zahlen für Sollbuchungen. Wieder andere verwenden eine einzelne Betragsspalte, bei der Sollbuchungen mit einem „Dr"-Suffix und Habenbuchungen mit „Cr" gekennzeichnet sind. OCR liest diese als Textzeichenfolgen, nicht als Buchungseinträge. Die Ausgabe erfordert manuelle Bereinigung – die Umwandlung von „500.00Dr" in -500,00 oder die Zusammenführung zweier Spalten in eine signierte Spalte – bevor ein Abgleich beginnen kann. Laut dem AICPA Practice Efficiency Benchmark 2025 verbringt die durchschnittliche Buchhaltungskanzlei 11,3 Stunden pro Monat und Kunde mit dem Kontoabgleich, wobei 78 % dieser Zeit für den Transaktionsabgleich aufgewendet werden, der vorhersehbaren, automatisierbaren Mustern folgt.
5. Verwechslung von gescannten und digitalen PDFs. Ein digitales PDF (direkt vom Banksystem erzeugt) enthält auswählbaren, maschinenlesbaren Text. Ein gescanntes PDF (ein physischer Kontoauszug, der fotografiert oder gescannt wurde) ist ein Textbild – nicht anders als ein Foto. Viele PDF-zu-Excel-Tutorials setzen digitale PDFs voraus und scheitern stillschweigend an gescannten Auszügen. OCR-Engines, die für sauberen digitalen Text entwickelt wurden, produzieren bei einem 150-dpi-Scan eines gefalteten Papierauszugs Unsinn. Dennoch sind gescannte Auszüge weiterhin verbreitet: ein aktueller r/Accounting-Thread mit 28 Upvotes diskutiert die anhaltende Realität von Kunden, die „für alles gescannte PDFs senden".
Wie KI-Extraktion Kontoauszüge anders liest
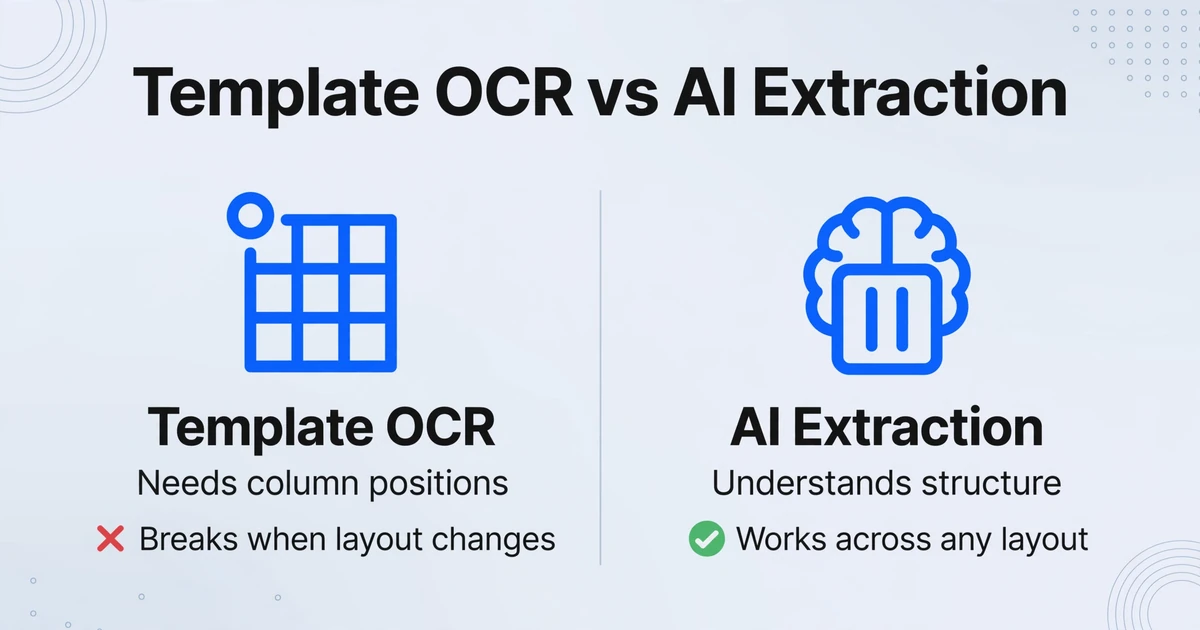
Der grundlegende Wandel von OCR zu KI-Extraktion ist der Übergang vom Lesen von Zeichen zum Verstehen der Dokumentstruktur – das Erkennen, dass eine Saldenspalte nicht nur eine Zahlenspalte ist und eine Transaktionszeile nicht nur eine Textzeile.
Traditionelle OCR beantwortet eine Frage: „Welche Zeichen befinden sich an diesen Koordinaten?" KI-Extraktion – insbesondere durch große Vision-Modelle – beantwortet eine andere Frage: „Was enthält dieses Dokument und wie ist es organisiert?"
Das ist der Unterschied zwischen positionsbasierter und semantikbasierter Extraktion. Ein positionsbasiertes Tool (zonale OCR, vorlagenbasierte Parser) muss wissen, wo sich jedes Feld auf der Seite befindet – „der Transaktionsbetrag steht immer in der vierten Spalte, beginnend 73 mm vom linken Rand." Wenn Chase sein Auszugsformat im nächsten Quartal ändert oder Sie einen Wells-Fargo-Auszug mit einer völlig anderen Spaltenanordnung erhalten, bricht diese Vorlage. Sie erstellen eine neue.
Benutzerdefinierte Spaltenextraktion — ImageToTable.ai's Kernmechanismus — verfolgt den gegenteiligen Ansatz. Statt dem System zu sagen, wo sich Daten auf der Seite befinden, sagen Sie ihm, welche Daten Sie möchten: Spaltennamen wie „Transaktionsdatum", „Beschreibung", „Sollbetrag", „Habenbetrag" und „Saldo". Die KI liest die gesamte Seite, versteht, welche Teile Kopfzeilen, welche Transaktionszeilen, welche Saldozeilen und welche Fußzeilen sind — und extrahiert dann jede Transaktionszeile in die von Ihnen definierten Spalten, wobei die Zeilenreihenfolge durchgängig erhalten bleibt. Es spielt keine Rolle, welche Spaltenposition jede Bank verwendet; die KI liest die semantische Bedeutung, nicht die Koordinaten.
Dies ist besonders wichtig für laufende Salden. Wenn Sie eine Spalte „Saldo" definieren, erkennt die KI, dass diese Spalte ein abgeleitetes Feld ist — sie extrahiert den Wert unverändert, aber die eigentliche Prüfung erfolgt über eine berechnete Spalte (siehe unten), die die Arithmetik verifiziert. Wenn die KI außerdem angewiesen werden kann, den gedruckten Saldo zu ignorieren und ihn aus den Transaktionsbeträgen neu zu berechnen, erhalten Sie eine integrierte Validierung: Jede Abweichung zwischen dem berechneten Saldo und dem gedruckten Saldo des Kontoauszugs markiert eine Zeile, die überprüft werden muss. Ein Tilgungsplan für ein Darlehen ist dieselbe Art von Kette — der Endsaldo jeder Zahlung muss der Anfangssaldo der nächsten Zahlung sein —, sodass eine einzige falsch gelesene Zeile die endgültige Ablösung durcheinanderbringt.
Der Mechanismus, der dies ermöglicht, ist derselbe, der ein Vision-Language-Modell grundlegend von einer OCR-Engine unterscheidet: Es verarbeitet die Seite als gesamte visuelle Szene, nicht als Raster von Zeichen-Bounding-Boxes. Es erkennt, dass „die Tabelle 5 Spalten hat, die fünfte ein laufender Saldo ist, die Daten über Seitenumbrüche hinweg fortgesetzt werden und der mittlere Abschnitt eine Zwischensummenzeile enthält, die keine Transaktion ist." Herkömmliche OCR erkennt nichts davon — sie sieht Pixel, die in einem Raster angeordnet sind.
Schritt für Schritt: Kontoauszugsdaten in Excel extrahieren
Der Weg vom PDF-Kontoauszug zu einer sauberen, abgleichsfähigen Tabelle umfasst vier Schritte. Keine Vorlagen, keine bankenspezifische Konfiguration, keine Trainingsdaten für Spaltenpositionen.
Kontoauszug hochladen
Ziehen Sie eine PDF-, JPG- oder PNG-Datei hinein – jede Bank, beliebig viele Seiten, digital oder gescannt. Keine Formatvorverarbeitung erforderlich.
Spalten definieren
Geben Sie die gewünschten Spaltennamen ein: Transaktionsdatum, Beschreibung, Sollbetrag, Habenbetrag, Saldo, Referenz-/Schecknummer, Transaktionstyp. Diese werden zu Ihren Excel-Spaltenüberschriften.
KI extrahiert jede Transaktionszeile
Die KI liest das gesamte Dokument, identifiziert die Transaktionstabelle über alle Seiten hinweg, extrahiert jede Zeile in Ihre definierten Spalten und bewahrt die Zeilenreihenfolge. Kopfzeilen, Zwischensummen und Seitenfüße werden automatisch herausgefiltert.
Exportieren und abgleichen
Laden Sie als Excel (XLSX) oder CSV herunter. Die Daten sind strukturiert, sauber und bereit für den Import in QuickBooks, Xero, Sage oder Ihre Abgleich-Tabelle.
Der vierstufige Arbeitsablauf oben – Hochladen, Spalten definieren, Extrahieren, Exportieren – ist genau das, was unser Kontoauszug-zu-Excel-Konverter in einem Durchgang erledigt, ohne Vorlagen und ohne bankspezifische Einrichtung. Testen Sie es kostenlos mit Ihrem eigenen Kontoauszug: Laden Sie eine PDF hoch, benennen Sie Ihre Spalten, und die extrahierten Zeilen kommen in Sekunden zurück, bereit für den Abgleich.
Dateien werden sicher verarbeitet und nicht gespeichert.
Was diesen Workflow von einem vorlagenbasierten Parser unterscheidet, ist, dass Sie dem System nie wo die Daten sitzen mitteilen — Sie sagen ihm nur was Sie möchten. Genau das macht ihn ohne Vorlage: Die KI versteht die Struktur des Dokuments unabhängig von seinem Layout. Wenn Sie eine Kontoauszug von einer neuen Bank erhalten — oder wenn Ihre bestehende Bank ihr Format neu gestaltet — gibt es nichts neu zu konfigurieren. Dieselben Spaltennamen finden dieselben Daten, unabhängig davon, wo auf der Seite sie erscheinen.
Mehrseitige Kontoauszüge und Batch-Verarbeitung
Ein einziger Monatsabschluss kann 12 PDFs von 3 verschiedenen Banken umfassen. Die Batch-Verarbeitung erledigt sie alle in einem Durchgang und führt jede Transaktion in einer einzigen Ausgabetabelle zusammen, wobei die Zeilenreihenfolge pro Kontoauszug erhalten bleibt.
Die Extraktion von Kontoauszügen ist selten ein Problem von einer Datei nach der anderen. Ein Buchhalter, der die Bücher für Q1 abschließt, könnte mit 3 Monaten × 3 Bankkonten = 9 PDFs konfrontiert sein. Eine Buchhaltungsfirma mit 50 Buchhaltungskunden könnte 200+ Kontoauszüge pro Monat verarbeiten. Der manuelle Ansatz — jede PDF öffnen, jede Zeile lesen, in Excel tippen — skaliert linear mit der Transaktionsanzahl, und die AICPA-Daten bestätigen das Ergebnis: 11,3 Stunden pro Kunde und Monat, 3,5 Vollzeitäquivalente für eine Firma mit 50 Kunden, allein für den Kontoabgleich.
Batch-First-Verarbeitung bedeutet, dass das Tool darauf ausgelegt ist, mehrere Dateien gleichzeitig anzunehmen und sie in einer Ausgabetabelle zusammenzuführen. Sie können Chase Januar, Chase Februar, Chase März, Wells Fargo Januar, Wells Fargo Februar und Wells Fargo März hochladen — sechs Dateien in einem Batch — und erhalten eine einzige Excel-Tabelle mit allen Transaktionen aus allen sechs Kontoauszügen, jede mit ihrem Quelldateinamen für die Rückverfolgbarkeit gekennzeichnet. Die Zeilenreihenfolge innerhalb jedes Kontoauszugs bleibt erhalten, und die Ausgabe kann optional eine Quelldatei-Spalte anhängen, sodass Sie immer wissen, welche Transaktion aus welchem Kontoauszug stammt.
Bei mehrseitigen Kontoauszügen versteht die KI, dass die Seiten 1 bis 6 einer einzelnen PDF eine durchgehende Transaktionstabelle darstellen — nicht sechs separate Tabellen. Der laufende Saldo, der auf Seite 3, Zeile 28 erscheint, wird als Fortsetzung der Transaktionssequenz von Seite 2 erkannt. Kopfzeilen, Seitenzahlen, übertragene Zwischensummen und Bank-Standardtexte, die sich auf jeder Seite wiederholen, werden herausgefiltert, bevor sie Ihre Excel-Ausgabe erreichen.
Hier entfaltet die Kombination aus Batch und Mehrseiten einen zusätzlichen Vorteil gegenüber der manuellen Eingabe. Ein 12-seitiger Geschäftskontoauszug mit 200 Transaktionen, der etwa eine Stunde Tipparbeit erfordern würde (bei 3 Minuten pro Seite manueller Eingabe), wird in 5–10 Sekunden pro Seite verarbeitet. Der Sage 2025 Accounting Technology Report fand heraus, dass Firmen, die den Kontoabgleich automatisiert haben, die Verarbeitungszeit um 75 % reduzierten und die Erstpass-Trefferquote von 94,2 % auf 99,6 % verbesserten. Die wichtigste Erkenntnis ist nicht nur die Zeitersparnis — sondern dass der Wechsel von manueller Eingabe zu KI-Extraktion die häufigste Fehlerkategorie eliminiert: Vertauschungsfehler, bei denen ein Mensch „2.847,31" als „2.487,31" liest oder einen Betrag in die falsche Zeile tippt.
Für Praktiker, die Daten direkt in Google Sheets statt in einer heruntergeladenen Excel-Datei benötigen, bietet das Google Sheets-Add-on eine Seitenleisten-Oberfläche, die Kontoauszüge hochlädt und extrahierte Transaktionszeilen direkt an das aktive Blatt anhängt — kein Dateidownload, kein Importschritt. Für ein vollständigeres Bild davon, wie sich dies im Vergleich zur manuellen Eingabe über eine Reihe von Kontoauszugsvolumen verhält, siehe unseren Vergleich manuelle vs. KI-Kontoauszugseingabe.
Extrahierte Daten für den Abgleich vorbereiten
Transaktionen in Excel zu bringen ist Schritt eins. Sie automatisch abzugleichen — also zu verifizieren, dass Anfangsbestand + Gutschriften − Belastungen dem Endbestand entspricht — ist der Punkt, an dem berechnete Spalten aus extrahierten Daten verifizierte Daten machen.
Selbst mit perfekt extrahierten Transaktionszeilen erfordert der Abgleich eine arithmetische Prüfung. Der Kontoauszug weist einen Anfangs- und einen Endbestand aus; die Summe aller dazwischenliegenden Transaktionen muss die beiden verbinden. Ein manueller Workflow erledigt das, indem die Berechnung nach dem Import in einer separaten Excel-Spalte durchgeführt wird. Ein KI-Extraktions-Workflow kann das während der Extraktion übernehmen — mithilfe von berechneten Spalten.
Berechnete Spalten ermöglichen es Ihnen, Berechnungen zu definieren, die ausgeführt werden, während die KI jeden Kontoauszug verarbeitet. Für den Kontoauszugsabgleich sind zwei berechnete Spalten besonders nützlich:
Laufende Saldenprüfung: Sie können eine berechnete Spalte definieren, die den erwarteten Saldo nach jeder Transaktion berechnet (Anfangsbestand + Summe aller Belastungen und Gutschriften bis zu dieser Zeile) und ihn mit dem ausgewiesenen Saldo des Kontoauszugs vergleicht. Jede Abweichung erzeugt eine Markierung — die Zeile, in der die Arithmetik nicht aufgeht, ist die Zeile, die einer manuellen Prüfung bedarf.
Belastungs-/Gutschrift-Saldierung: Bei Kontoauszügen mit getrennten Belastungs- und Gutschriftsspalten kann eine berechnete Spalte den Nettobetrag für jede Zeile (Gutschrift − Belastung) sowie den kumulierten Nettobetrag über alle Zeilen berechnen. Der finale kumulierte Nettobetrag, addiert zum Anfangsbestand, sollte dem Endbestand entsprechen. Ist das nicht der Fall, zeigt Ihnen der Abweichungsbetrag genau, wie weit die Extraktion danebenliegt — und weist meist auf ein oder zwei bestimmte Zeilen hin, die falsch gelesen wurden.
Diese berechneten Prüfungen sind für jeden, der Abgleiche durchführt, nicht optional — sie sind der Unterschied zwischen „die Daten sehen richtig aus" und „die Daten sind nachweislich richtig". Die Association of Certified Fraud Examiners berichtet, dass etwa 22 % der Fälle von Bilanzfälschung durch den Kontoabgleich aufgedeckt werden — ein Beleg dafür, dass der arithmetische Validierungsschritt nicht übersprungen werden darf.
Nach Extraktion und Validierung kann die strukturierte Excel-Ausgabe in Ihre Buchhaltungssoftware fließen — QuickBooks Online, Xero, Sage, NetSuite oder jede Plattform, die CSV/XLSX-Importe akzeptiert — wobei die Transaktionsdaten bereits bereinigt, standardisiert und verifiziert sind. Wenn Sie evaluieren, welches Tool Sie für Ihren gesamten Finanzdokument-Workflow einsetzen sollen, zeigt unser Vergleich der Kontoauszug-Extraktionstools die Landschaft nach Genauigkeit, Preisgestaltung und Buchhaltungsintegration auf.
Kontoauszüge von verschiedenen Banken und Ländern
Ein formatunabhängiges Extraktionssystem behandelt einen Chase-Auszug, einen Deutsche-Bank-Auszug und einen Caixa-Auszug als dasselbe Problem — jeder ist eine Transaktionstabelle mit Daten, Beschreibungen und Beträgen. Die visuellen Layoutunterschiede ändern nichts an der Extraktionslogik.
Eine der stillen Kosten der vorlagenbasierten Extraktion ist der Wartungsaufwand pro Bank. Wenn Ihr Parsing-Tool für jedes Bankformat ein Training oder die Erstellung einer Vorlage erfordert und Ihre Firma Auszüge von 15 verschiedenen Banken über Ihren Kundenstamm verarbeitet, pflegen Sie 15 Parsing-Konfigurationen. Wenn eine dieser Banken ihr Auszugsformat aktualisiert — eine Schriftartänderung, eine Spaltenumstellung, eine neue Logo-Platzierung — funktioniert eine Ihrer Vorlagen nicht mehr. Sie bemerken das, wenn Sie den Auszug eines Kunden verarbeiten wollen und die Ausgabe verstümmelt ist, meist zum Monatsende, wenn die Zeit am knappsten ist.
KI-Extraktion, die formatunabhängig ist, umgeht das vollständig. Ob die Bank ein zweispaltiges Layout verwendet (Datum + Beschreibung gefolgt von Soll + Haben), ein fünfspaltiges Layout (Datum + Beschreibung + Soll + Haben + Saldo) oder eine regionale Variante mit lokaler Terminologie — „Retraits" statt „Soll", „Versements" statt „Haben" in französischen Auszügen — die KI identifiziert die Transaktionstabelle anhand ihres strukturellen Musters: einer sich wiederholenden Abfolge von Datum, Textbeschreibung und numerischen Beträgen. Die spezifische Anordnung innerhalb dieses Musters spielt keine Rolle.
Diese Formatunabhängigkeit bewältigt auch internationale Auszüge, bei denen sich der zugrunde liegende Datenstandard unterscheidet. Europäische Banken geben Auszüge zunehmend im Format camt.053 aus — dem ISO-20022-XML-Format für Bank-zu-Kunde-Auszüge — einem strukturierten, maschinenlesbaren Format mit expliziten Transaktionsmetadaten. Viele Banken stellen jedoch weiterhin PDF-Auszüge zusätzlich zu oder anstelle von camt.053-Dateien aus, und einige Länder sind Jahre von der ISO-20022-Einführung entfernt. Die Realität für die meisten Buchhaltungsteams ist, dass sie eine Mischung erhalten: Einige Kunden liefern CSV-Exporte, einige PDFs, und wenige leiten XML-Auszüge weiter, die sie nicht parsen können. Ein einziges Tool, das alle drei Formate verarbeitet, macht einen separaten Verarbeitungspfad pro Format überflüssig.
Selbst innerhalb eines einzigen Landes ist die Layoutvielfalt erheblich. Ein Wells-Fargo-Geschäftskontoauszug hat eine andere Tabellenstruktur als ein Chase-Geschäftskontoauszug, der sich wiederum von einem lokalen Kreditgenossenschaftsauszug unterscheidet. Der formatunabhängige Ansatz bedeutet, dass der Buchhalter die Spalten einmal definiert — „Transaktionsdatum, Beschreibung, Betrag, Saldo" — und dieselbe Spaltendefinition für die Auszüge aller Kunden verwendet, unabhängig davon, welche Bank sie ausgestellt hat. Für einen tieferen Einblick, wie dies speziell auf die Batch-Abstimmung über ein ganzes Jahr angewendet wird, lesen Sie unseren Leitfaden zu Batch-Verarbeitung von 12 Monaten Kontoauszügen in eine Tabelle.
FAQ
Funktioniert das auch mit mehrseitigen Kontoauszügen?
Ja. Die KI liest den Auszug als eine durchgehende Transaktionstabelle, unabhängig von der Seitenzahl. Ein 12-seitiger Auszug mit 250 Transaktionen wird als Einheit verarbeitet – Seitenköpfe, wiederholte Spaltenbeschriftungen, übertragene Zwischensummen und Fußzeilen werden automatisch erkannt und herausgefiltert, sodass sie Ihre Excel-Ausgabe nicht verfälschen. Die Zeilenreihenfolge bleibt seitenübergreifend exakt so erhalten, wie sie im Originalauszug erscheint.
Kann es Daten aus gescannten oder fotografierten Kontoauszügen extrahieren?
Ja. Das visuelle Sprachmodell liest Text aus Bildern, nicht nur aus digitalen PDFs. Ein gescannter Papierauszug – egal ob von einem Flachbettscanner, einem Handyfoto oder einem bankeigenen Scan eines alten Papierbelegs – wird genauso verarbeitet wie ein natives PDF. Die Bildqualität spielt eine Rolle (ein Scan mit 150 dpi und sichtbarer Schräglage liefert eine geringere Genauigkeit als ein sauberer 300-dpi-Scan), aber es ist kein digital erzeugtes, textauswählbares PDF erforderlich.
Wie wird mit der Spalte „Saldo“ umgegangen?
Die KI extrahiert den Saldo so, wie er im Auszug erscheint. Da gedruckte Salden jedoch Fehler enthalten können oder die Extraktion eine Ziffer falsch lesen kann, empfiehlt es sich, eine Berechnete Spalte zu definieren, die den Saldo aus den extrahierten Soll- und Habenbeträgen neu berechnet. Stimmt der berechnete Saldo mit dem gedruckten überein, haben Sie eine Kreuzvalidierung. Weichen sie voneinander ab, wissen Sie genau, welche Zeile Sie überprüfen müssen. So wird der Saldo von einem passiv extrahierten Feld zu einem aktiven Validierungsmechanismus.
Funktioniert das mit Auszügen verschiedener Banken mit unterschiedlichen Layouts?
Ja – das ist der Kernvorteil der formatunabhängigen Extraktion. Ein Chase-Auszug, ein Wells-Fargo-Auszug, ein Barclays-Auszug und ein Auszug einer lokalen Kreditgenossenschaft haben alle die gleiche grundlegende Struktur: eine Tabelle mit datierten Transaktionen, Textbeschreibungen und numerischen Beträgen. Die KI erkennt diese Struktur unabhängig von Spaltenreihenfolge, Schriftart, Abständen oder Seitenlayout. Sie verwenden dieselben Spaltennamen („Buchungstag“, „Verwendungszweck“, „Betrag“) für alle Banken. Es muss keine bankenspezifische Vorlage erstellt oder gepflegt werden.
Wie werden Soll- und Haben-Buchungen behandelt, wenn Banken sie unterschiedlich formatieren?
Einige Banken verwenden separate Soll- und Haben-Spalten mit positiven Werten in beiden. Andere verwenden eine einzelne Betragsspalte mit negativen Zahlen für Soll-Buchungen. Wieder andere hängen "Dr"- oder "Cr"-Suffixe an Beträge an. Die KI kann jede Spaltenstruktur extrahieren, die auf dem Kontoauszug vorhanden ist, und Sie können optional eine berechnete Spalte definieren, die die Werte in eine einzelne Spalte mit signierten Beträgen normalisiert (negativ für Soll, positiv für Haben) – was unabhängig davon, wie jede Bank ihren Kontoauszug formatiert, eine einheitliche Ausgabe erzeugt.
Wie genau ist die Extraktion von Kontoauszugstransaktionen?
Bei gedruckten (digitalen) Kontoauszügen als PDF mit klarer Typografie erreicht die Feldgenauigkeit bis zu 99 %. Bei gescannten oder fotografierten Kontoauszügen hängt die Genauigkeit von der Bildqualität ab – ein sauberer 300-dpi-Scan erzielt ähnliche Ergebnisse, während ein niedrig aufgelöstes Handyfoto eines zerknitterten Papierauszugs niedriger ausfällt. Die wichtigste Sicherheitsmaßnahme ist der Abstimmungscheck: Da jeder Kontoauszug einen überprüfbaren Endsaldo hat, gegen den extrahierte Transaktionen validiert werden können, wird jeder Extraktionsfehler, der groß genug ist, um die Abstimmung zu beeinträchtigen, vom Saldenprüfungsschritt erkannt, bevor die Daten in Ihr Buchhaltungssystem gelangen.
Das Fazit
Die Kontoauszugsextraktion liegt an der Schnittstelle zweier Probleme, die die meisten Datentools getrennt lösen: genaues Zeichenlesen und strukturelles Dokumentverständnis. OCR allein liefert Ihnen die Zeichen, aber nicht die Struktur – sie kann eine Transaktionszeile nicht von einer Kopfzeile unterscheiden, einen laufenden Saldo nicht von einem Transaktionsbetrag oder die Tabelle von Seite eins nicht von der Fortsetzung derselben Tabelle auf Seite zwei. Vorlagenbasiertes Parsen fügt Struktur hinzu, jedoch auf Kosten der Konfiguration pro Bank und der Fragilität bei Layoutänderungen.
KI-Extraktion durch Vision-Language-Modelle fasst diese in einem Schritt zusammen: Die KI liest das Dokument als Ganzes, versteht seine Struktur und extrahiert, was Sie angefordert haben – unter Beibehaltung der Zeilenreihenfolge, Herausfiltern von strukturellem Rauschen und Ermöglichung arithmetischer Überprüfung, bevor die Daten Ihr Buchhaltungssystem erreichen. Die Ausgabe ist nicht "ungefähr die richtigen Daten in ungefähr der richtigen Reihenfolge". Es ist ein Transaktionshauptbuch, das mit dem Endsaldo des Kontoauszugs übereinstimmt – der einzige Standard, der für die Abstimmung zählt. Probieren Sie es mit Ihrem eigenen Kontoauszug aus.
Kontoauszug jetzt extrahieren →
Kostenlos starten – keine Kreditkarte erforderlich