手書き小切手をXeroへ、
OCRが読み飛ばすフィールドを再入力せずに
家族経営のCPA事務所を引き継いだBookkeeperがr/Bookkeepingコミュニティに、多くの事務所経営者が直面する質問を投稿しました。それは、顧客が今でも手書きで小切手を書いており、その手書き文字をXeroに取り込む信頼できるツールがないというものです。最も評価された回答は業界の現状を要約していました。「Hubdoc、AutoEntry、Dextなどのツールは画像の保存には優れているが、OCRは通常、手書き文字を読み取れない」。この一文が小切手の保存と読み取りを分けており、そのギャップが受取人名と金額の手入力が続く理由です。
重要なポイント
- スキャナーやドキュメントツールはすべての小切手を保存できるが、受取人名と金額は依然として手入力されている。
- OCRは銀行が機械用に設計した印字されたMICRラインは読み取るが、手書き文字は人間の目用に書かれているため、単語のエラー率は文字のエラー率の2〜4倍になる。
- 列を意味で一度定義すれば、各小切手のフィールドが1つのインポート可能なスプレッドシートにまとまり、任意の値は画像上の正確な位置にハイライト表示される。
小切手を保存することと読み取ることの違い
小切手は中小企業の簿記から消えていない。財務専門家協会(AFP)の調査によると、回答した組織の91%が今も小切手を使用しており、75%が2年以内に使用をやめる予定はないと回答している(AFP Payments Fraud and Control Survey)。連邦準備制度理事会の企業決済調査によると、小規模企業ほど小切手への依存度が高く、売上高100万ドル未満の極小企業の約8割が今も紙の小切手で支払いを行っている。小切手帳は自動で読み取ってくれないため、会計作業は紙の処理が終わったところから始まる。
クライアントが手書き小切手の束を渡してきた場合、会計事務所のドキュメントツールは画像を取り込むことができる。Hubdoc、Dext、AutoEntryはスキャンを保存し、取引に添付し、ファイルに保管してくれる。しかし、一貫して行えないのは、手書きの受取人、日付、小切手番号、金額をフィールドに変換することだ。OCRエンジンは印刷されたテキストの読み取りには優れているが、手書き文字になると精度が急激に低下する。このギャップはAutoEntryのヘルプセンターにも明確に記載されており、ペン書きのあるファイルは、ソフトウェアが「印刷テキストとペン書きの区別に苦労する」ため、即座に拒否される。実際の結果として、画像はアーカイブされるが、データは依然として手入力されることになる。
これこそが、簿記担当者が実際に試している核心的な違いだ。画像を保存するツールは保管の問題を解決する。フィールドを抽出するツールは入力の問題を解決する。中小企業の小切手処理のほとんどは、いまだに従来の方法で行われている。なぜなら、手書き文書に関しては、取り込みレイヤーと抽出レイヤーがこれまで接続されてこなかったからだ。
現在、手書き小切手が仕訳になるまでの流れ
手作業の流れは、ほとんどの小規模企業で一定の形をしている。クライアントが小切手を書き、紙のコピーかスマホの写真を渡す。簿記担当者は会計ソフトを開き、記載内容を見て、日付、受取人名、金額、小切手番号、メモを取引画面に入力する。その後、ファイルを添付し、銀行フィードで決済済みの項目が取り込まれた際に、同じ取引が再度照合される。
2つ目の部分である銀行フィードは、多くの簿記担当者が静かに問題の半分を解決してきた部分だ。小切手が決済されると、銀行明細フィードが金額と日付を取り込む。簿記担当者はそこから照合とカテゴリ分類を行い、元のスキャンは証憑として残る。このワークフローは現実的で機能しており、r/Bookkeepingのスレッド自体でも推奨されている回答だ。「証憑として小切手をスキャンし…決済されたら銀行フィードに頼る」というものだ。
しかし、銀行フィードには限界がある。到着は数日後になる。金額と日付は取り込めるが、銀行の窓口担当者が入力したクライアントの手書き文字の場合、受取人名は取得できない。メモ、目的、カテゴリについては、画像を確認するまで何もわからない。また、口座で決済されない小切手(入金待ちの受取小切手など)には対応できない。残る手入力の作業こそが、人間の目を必要としない作業なのだ。
OCRがMICR行は読み取れても手書き文字を読み飛ばす理由
小切手には、まったく異なる2種類の文字が隠れている。下端の数字の行、MICR行は、銀行が写真を撮るのではなく磁気信号を感知して読み取る磁気インクフォントで印刷されている。そのため、すべての小切手のルーティング番号と口座番号は確実に読み取れる。その標準はANSI X9.100-20に定められており、小切手ごとに一貫したE-13B文字を定義している。磁気層は機械向けに設計された部分だ。
小切手の他の部分はすべて人間向けに設計されており、手書きで記入される。受取人名、金額の文字表記、数字の金額、日付、メモは、書き手のスタイルに応じたボールペンのインクだ。ここでOCRが苦戦する理由は、構造的に3つある。手書き文字には固定フォントがないため、文字モデルとの照合が失敗する。レイアウトは小切手ごとに異なるため、「受取人は常にここ」というテンプレート位置が存在しない。そして、エラーのコストは非対称だ。手書き文字の場合、単語エラー率は通常、文字エラー率の2〜4倍になる。1文字の誤読が単語全体を失敗させるからだ。これは受取人名や金額にとってまさに最悪の失敗モードである(手書き文字認識の精度データを参照)。
簿記用に作られた取り込みツールは、意図的なトレードオフを取っている。印刷された請求書やレシートの抽出は非常に得意だが、手書き文字は空白のまま返すか、手動入力を促すフラグを立てることで回避している。Redditのスレッドはその共通認識を捉えている。「OCRは通常、印刷された請求書や明細書ではうまく機能するが、手書き文字はスタイルが大きく異なるため、さらに難易度が上がる」。簿記担当者が何か間違っているわけではない。与えられたツール群が、単に手書き文字のところで止まっているだけなのだ。
失敗の原因はドキュメントではない。テキストを読むOCRと、意味を抽出してドキュメントを読むデータ抽出が、同じ技術であるという前提が間違いなのだ。両者は異なる。
OCRが見落とす文字を読むワークフロー
手書きを理解する抽出は、人間と同じように小切手を読み取ります。「受取人」「日付」「金額」「小切手番号」を概念として扱い、それぞれがどこに現れても探し出します。カスタム列抽出を使えば、簿記担当者は必要な列を一度だけ、各フィールドを平易な言葉で指定して入力し、AIはスキャンされた小切手上の値をピクセル位置ではなく意味に基づいて特定します。列はユーザーが定義するため、同じ設定でどのクライアントの小切手でも同じスプレッドシート構造が生成されます。
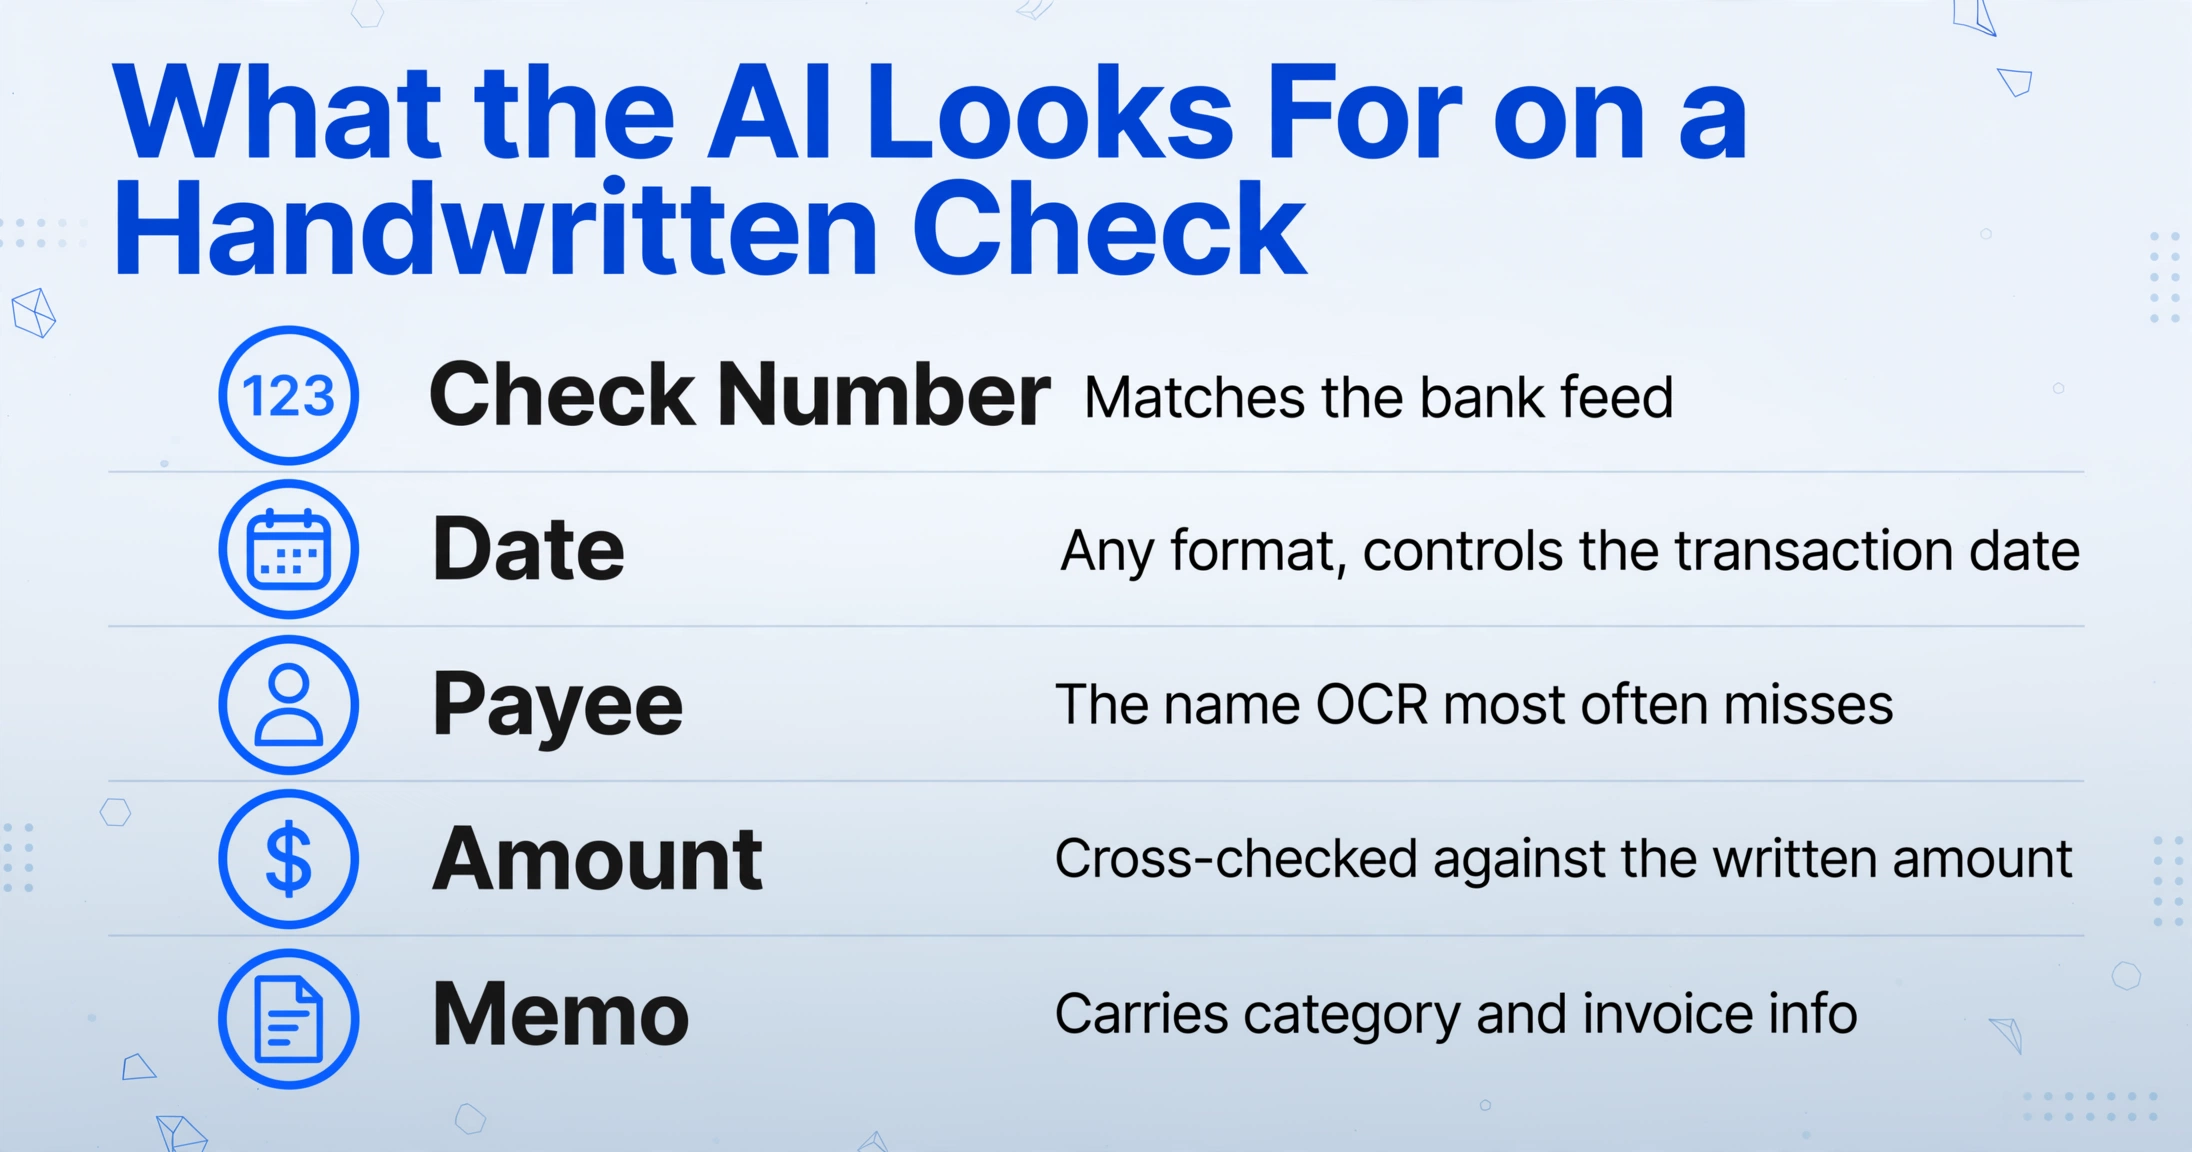
手書き小切手バッチ用の列テンプレートは、簿記担当者が現在入力しているフィールドに直接対応します。
| 列 | AIが探すもの | 重要な理由 |
|---|---|---|
| 小切手番号 | 小切手表面の連番 | 銀行フィードと照合し、重複を検出します |
| 日付 | 記載された日付(形式は問いません) | Xeroでの取引日を決定します |
| 受取人 | 「受取人」欄に記載された名前 | OCRが最も頻繁に空白で返すフィールドです |
| 金額 | 数字の金額。記載された金額は2列目として抽出し、レビュー担当者が両者を比較できます | 1桁の誤りが照合エラーになります |
| メモ | メモ欄に記載された目的または参照情報 | カテゴリと請求書情報を保持します |
2つの設定でバッチが現実的になります。より高いモデルティアは、密度の高い筆記体や続け字に対してより高度な視覚処理を提供し、クライアントの筆跡が乱れている場合に重要です。スタック全体が複数ファイルを同時に処理するため、1人のクライアントからの小切手の束は単一のバッチとして処理され、1ファイルずつではなく1つのスプレッドシートに統合されます。
出力はその後、ソフトウェアへの2つの経路のいずれかをたどります。列は、銀行または仕訳インポートと同様にXeroにインポートできるスプレッドシートに格納されるか、抽出された行が確認されて直接入力されます。重要なのは、手書きを2回入力する必要がなくなることです。入力はすでに抽出ツールが行っているからです。1枚の小切手で機能する同じフィールドレベルの読み取りについては、手書き台帳をExcelに変換するの記事で詳しく解説しており、より広範なパターンについては手書きレシートを税務申告対応のスプレッドシートに変換するをご覧ください。
入金前に金額を確認する
手書き文字の抽出は盲目的に信頼する作業ではありません。特に小切手の金額は、経理担当者が黙って読み間違いを許容できる場所ではありません。APQCのベンチマークによると、買掛金の処理にかかる中央値コストは請求書1件あたり$6(APQC)で、その大半が手入力によるものです。また、中央値の企業では今なお仕入先請求書の60%を手作業で入力しています。レビューのステップこそ、自動化の価値が発揮される場面です。抽出結果を確認する方が、再入力してからさらに確認するよりもコストがかからないからです。
手書き文字の場合、検証ツールは全体ではなくハイライト機能が重要です。レビューモードでは、経理担当者が抽出された任意のセルにホバーまたはクリックすると、元の小切手画像上のどこからその値が取得されたかを正確に確認でき、画像上の該当領域をクリックすると対応するセルに戻れます。金額の数字が曖昧な場合、どこからともなく現れた数字を信頼するのではなく、その数字を生み出した筆跡を確認できます。誤った読み取りは修正でき、AIの元の値もワンクリックで記録に残せるため、監査証跡は常に可視化されます。これが、レビュー機能を組み込んだツールと、CSVを出力して後は祈るだけのツールとの違いです。
同じ原則は、すでに銀行フィードで処理している小切手にも当てはまります。ここで紹介する機能はフィードを置き換えるものではなく、照合ステップを短縮するものです。清算済みの金額が届いたら、ご自身のバッチから抽出した行が受取人とメモを提供するため、各画像を開かずにスプレッドシートから分類・照合できます。
それでも人が必要な部分
抽出は手書き文字を読み取るものであり、魔法ではありません。かすれたインク、筆記体が多用された金額、斜めや暗い場所で撮影された小切手は、経理担当者がまだ確認しなければならない低信頼度フィールドを生み出します。誠実なワークフローは、例外ゼロではなく、すべてのバッチでレビューパスを計画します。だからこそ、上記の確認ステップは後付けではなく設計の一部なのです。
チェーン全体にも限界があります。決済されない小切手には照合する銀行フィードのエントリがないため、抽出された行が唯一の記録となり、正確性がより重要になります。また、保管も依然として重要です。IRS Publication 583は、事業者が保管すべき添付書類に決済済み小切手を挙げています(IRS Publication 583)。電子システムがこの義務を満たすには、記録が読み取り可能で検索可能な状態を保つ必要があります。画像の保存は保管を解決し、フィールドの抽出は入力を解決します。企業は両方を継続して行うため、まさにキャプチャ層と抽出層は、それぞれの役割を果たす別々のツールであるべきなのです。
小切手読み取りの銀行レベルの側面、MICR処理、小切手詐欺チェック、KYC検証については、銀行業務におけるOCRガイドで機関レベルのワークフローを解説しています。この記事はより小規模な場面を対象としています。経理担当者の机の上にある手書き小切手の束と、それによってXeroに入力される内容についてです。
手書き小切手と会計ソフト:よくある質問
Hubdocは手書き小切手を読み取れますか?
Hubdocは小切手画像を保存し、印刷されたドキュメントからヘッダー項目を抽出しますが、そのドキュメントとユーザーレポートによると、手書き文字は確実には読み取られず、受取人や金額が空白のまま返され、手動で入力されることがよくあります。Hubdocは引き続き堅牢なドキュメント保存・整理レイヤーであり、これは抽出とは別の役割です。
Xeroには手書き小切手用の組み込みOCRがありますか?
Xero自体はドキュメントのOCRを行いません。同梱の取り込みツールであるHubdocが読み取りを担当し、手書き小切手はそのギャップに該当します。Xeroはインポートされたデータと銀行フィードを受け入れるため、実際的な方法は、小切手の項目をスプレッドシートに抽出し、行をインポートすることです。CSVおよびIIFインポートを受け入れるQuickBooksにも同じロジックが適用されます。
小切手上の手書き文字抽出の精度はどのくらいですか?
クリーンなベンチマーク手書き文字では、最新のAIシステムは文字誤り率2%未満を達成しますが、実際のドキュメントでは範囲が広く、ツールや筆跡スタイルによって精度はおよそ46%から95%です。読みやすさ、インクの品質、スキャン解像度が結果を左右します。そのばらつきこそが、自信に満ちた精度の主張よりも、各値の出所を強調するレビューステップが重要である理由です。
小切手を抽出しても銀行フィードはまだ必要ですか?
はい、必要です。この2つは連携して機能します。銀行フィードは実際に決済されたものの信頼できる記録であり、抽出はフィードが保持しない受取人とメモの詳細を提供します。ワークフローは次のように短縮されます:バッチを抽出し、項目をレビューし、決済済みフィードと照合します。
手書き小切手にはどのようなスキャン品質が必要ですか?
平らで明るい画像を約300 DPIで使用すると最良の結果が得られます。小切手が平らで筆跡に焦点が合っていればスマートフォンの写真でも機能しますが、大量の束にはスキャナーが適しています。斜めのショットや金額欄にかかる影は避けてください。これらの条件は手書き文字を低信頼度の領域に押し戻すためです。
企業が手書き小切手を扱う際の有益な変化は、「画像を保存できるか」と尋ねるのをやめ、「列を定義できるか、受取人を読み取れるか、転記前に金額を検証できるか」と尋ね始めることです。スタック内のすべての取り込みツールはすでに最初の1つを実行しています。OCRが空白のまま残す項目こそ、自動化する価値があるものです。