Cheques Manuscritos no Xero,
Sem Redigitar os Campos que o OCR Ignora
Um contador que assumiu um escritório familiar de CPA perguntou à comunidade r/Bookkeeping a questão que a maioria dos proprietários de firmas acaba enfrentando: clientes ainda escrevem cheques à mão, e não havia uma ferramenta confiável para capturar essa escrita no Xero. A resposta mais votada resumiu o estado do setor: "Ferramentas como Hubdoc, AutoEntry ou Dext são boas para armazenar a imagem, mas o OCR geralmente perde a escrita manual." Essa frase separa armazenar um cheque de lê-lo, e essa lacuna é o que mantém nomes de beneficiários e valores sendo digitados à mão.
Principais Conclusões
- Scanners e ferramentas de documentos já armazenam todos os cheques, mas o beneficiário e o valor ainda são digitados à mão.
- O OCR lê a linha MICR impressa porque os bancos a projetaram para máquinas, mas a escrita manual foi projetada para olhos humanos, então os erros de palavras são de duas a quatro vezes maiores do que os erros de caracteres.
- Defina as colunas por significado uma vez e os campos de cada cheque caem em uma planilha importável, onde qualquer valor é destacado de volta ao ponto exato na imagem.
A diferença entre guardar um cheque e lê-lo
Os cheques não desapareceram da contabilidade de pequenas empresas. A Association for Financial Professionals descobriu que 91% das organizações pesquisadas ainda usam cheques, e 75% não planejan parar dentro de dois anos (AFP Payments Fraud and Control Survey). A pesquisa de pagamentos empresariales da Reserva Federal mostra que as pequenas empresas dependem mais deles: quase oito de cada dez empresas muito pequenas, aquelas com receita inferior a $1 milhão, ainda usam cheques em papel para pagamentos. Uma chequera não se lê sozinha, então o trabalho contable começa onde termina o papel.
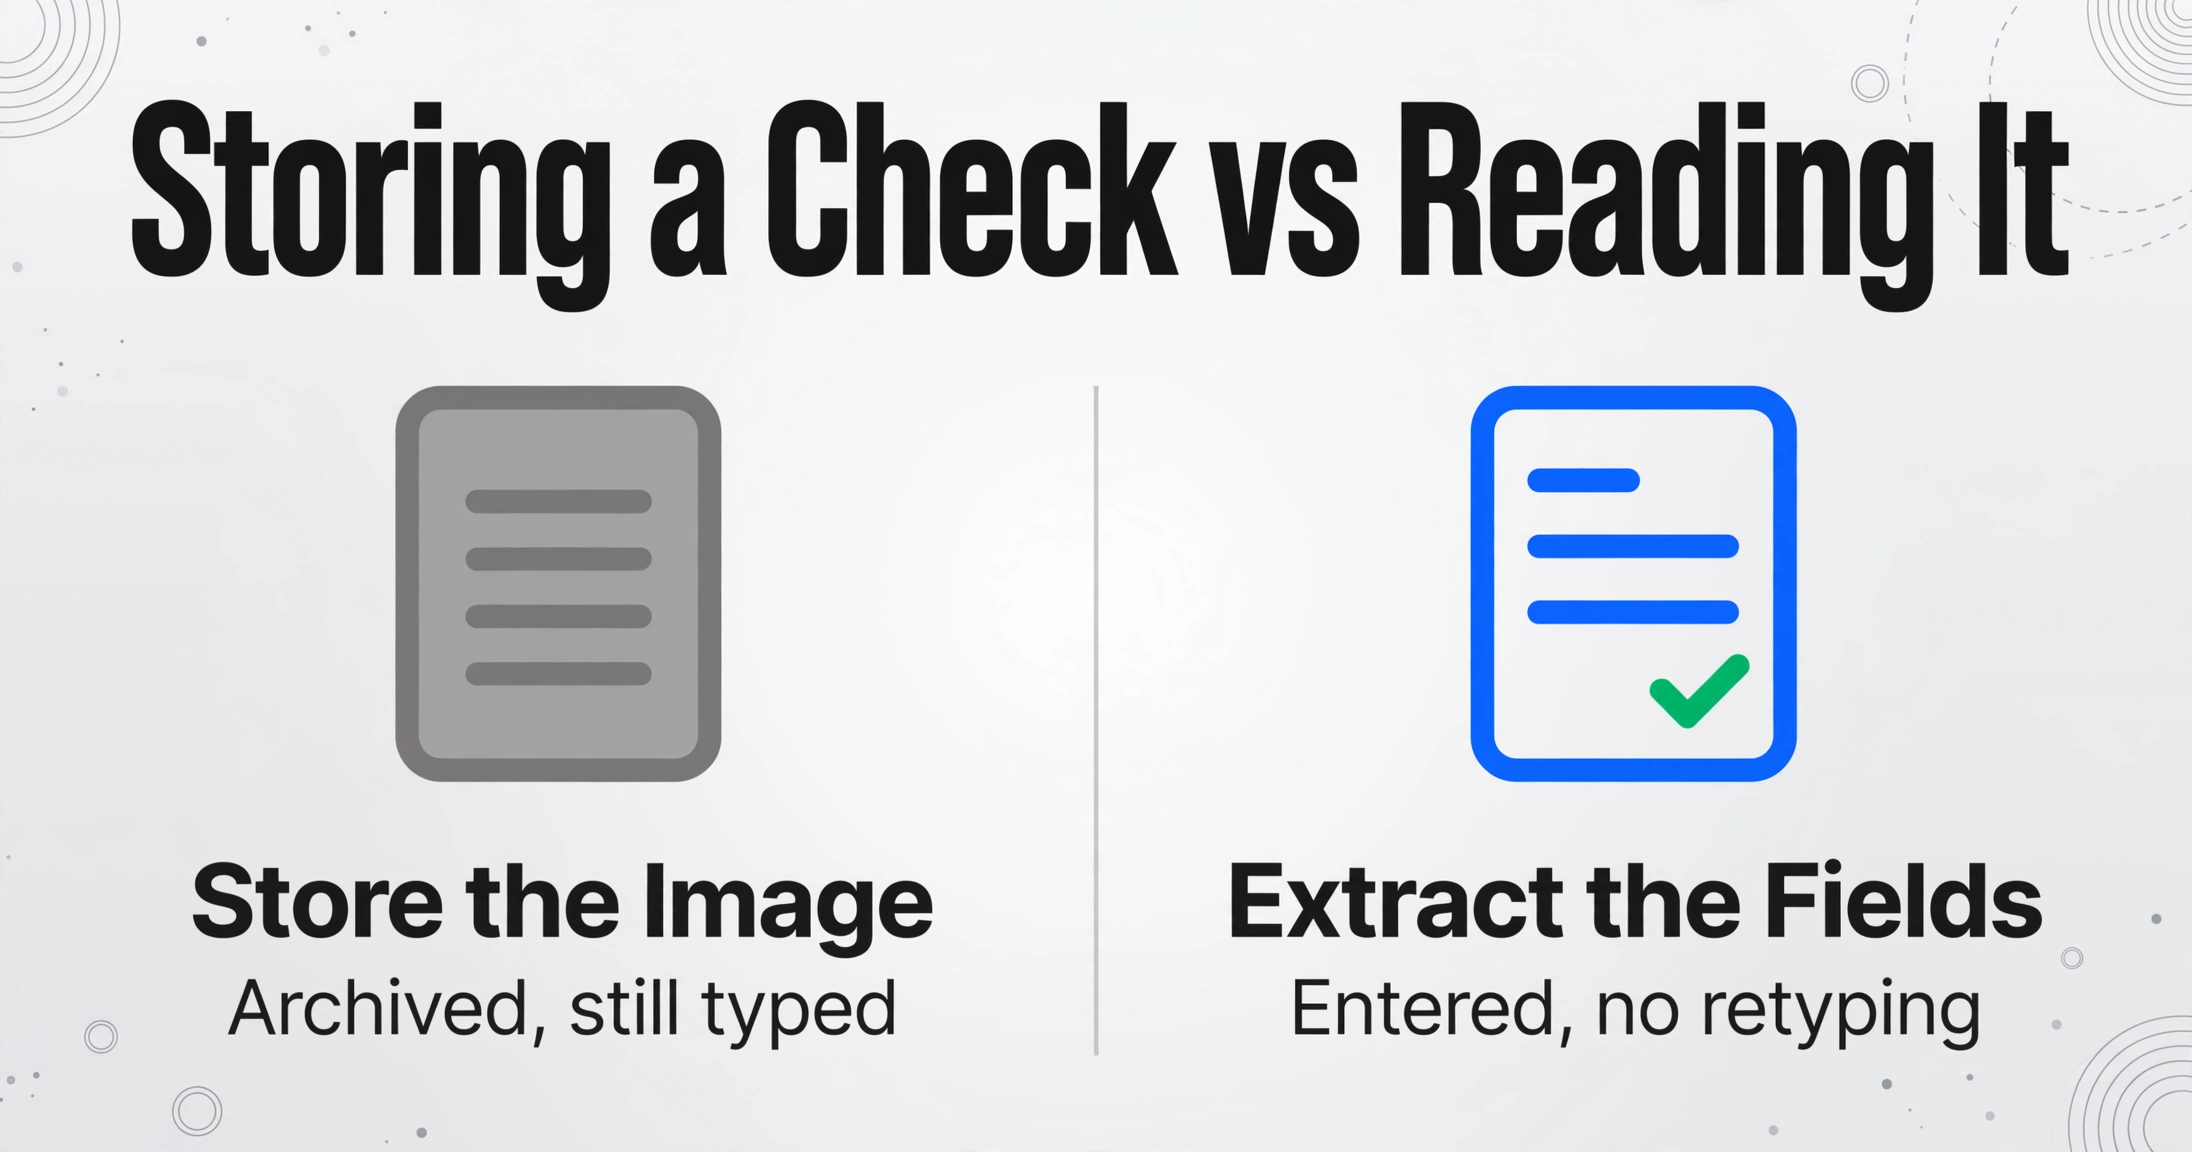
Quando um cliente entrega uma pilha de cheques manuscritos, as ferramentas de documentos da empresa capturan as imagens. Hubdoc, Dext e AutoEntry guardarán com prazer a digitalização, a anexarán a uma transação e a arquivarán. O que não fazem de forma consistente é converter o beneficiário manuscrito, a data, o número do cheque e o valor em campos. Os motores de OCR leen bem o texto impresso e degradan drasticamente com a escrita manual, uma lacuna que o centro de ajuda de AutoEntry documenta claramente: os arquivos com marcas de caneta são rejeitados diretamente porque o software "lucha para diferenciar entre texto impresso e uma marca de caneta". O resultado prático é que a imagem é arquivada e os dados ainda são digitados.
Essa é a diferença central que um contable realmente está testando. Uma ferramenta que guarda a imagem resolve o problema de retenção. Uma ferramenta que extrae os campos resolve o problema de entrada. A maioria do processamento de cheques em pequenas empresas ainda é feita da maneira antiga porque a capa de captura e a capa de extração nunca se conectaron para documentos manuscritos.
Como um Cheque Manuscrito Vira um Lançamento Hoje
O caminho manual tem um formato fixo na maioria das pequenas empresas. O cliente escreve o cheque e entrega a cópia em papel ou uma foto tirada pelo celular. O contador abre o software de contabilidade, olha a escrita e digita a data, o nome do beneficiário, o valor, o número do cheque e uma observação na tela da transação. Depois, o arquivo é anexado e a mesma transação é conciliada novamente quando o feed do banco importa o item compensado.
A segunda etapa, o feed do banco, é onde muitos contadores já resolveram silenciosamente metade do problema. Quando o cheque é compensado, o feed do extrato bancário traz o valor e a data. O contador concilia e categoriza a partir daí, e o scan original serve como comprovante de apoio. Esse fluxo de trabalho é real e funciona, e é a resposta recomendada no próprio tópico do r/Bookkeeping: "escaneie o cheque como comprovante... e depois confie no feed do banco quando ele for compensado."
Mas o feed do banco tem limites. Ele chega dias depois. Traz o valor e a data, mas não o nome do beneficiário quando a letra do seu cliente é o que o caixa do banco digitou. Não diz nada sobre a observação, a finalidade ou a categoria até você ir olhar a imagem. E não ajuda com cheques que nunca são compensados na conta, como um cheque recebido que aguarda depósito. A digitação manual que resta é exatamente o trabalho que não precisa de olhos humanos.
Por que o OCR Lê a Linha MICR, mas Ignora a Escrita Manual
Um cheque esconde dois tipos muito diferentes de texto. A linha de dígitos na parte inferior, a linha MICR, é impressa em uma fonte de tinta magnética que os bancos leem detectando o sinal magnético, não tirando uma foto dela. É por isso que o número de roteamento e o número da conta em todo cheque são lidos com confiabilidade: o padrão, definido em ANSI X9.100-20, define caracteres E-13B que permanecem consistentes de cheque para cheque. A camada magnética é a parte projetada para máquinas.
Todo o resto no cheque foi projetado para humanos e é escrito à mão. O nome do beneficiário, o valor por extenso, o valor numérico, a data e a observação são tinta de caneta esferográfica em qualquer estilo que o escritor use. O OCR tem dificuldades aqui por três razões estruturais. A escrita manual não tem fonte fixa, então a correspondência de caracteres contra um modelo de letra falha. O layout varia de cheque para cheque, então não há posição de modelo para "o beneficiário está sempre aqui". E o custo do erro é assimétrico: para escrita manual, as taxas de erro de palavra normalmente ficam duas a quatro vezes maiores do que as taxas de erro de caractere, porque um único caractere lido errado faz a palavra inteira falhar, que é exatamente o pior modo de falha para um nome de beneficiário ou um valor (veja os dados de precisão do reconhecimento de escrita manual).
As ferramentas de captura criadas para contabilidade fazem uma troca deliberada: elas extraem muito bem faturas e recibos impressos e contornam a escrita manual devolvendo-a em branco ou marcando o documento para entrada manual. O tópico do Reddit captura o consenso: "o OCR geralmente se sai bem com faturas e extratos digitados, mas a escrita manual adiciona outra camada de dificuldade, já que os estilos variam muito." O contador não está fazendo nada errado. A pilha de ferramentas que receberam simplesmente para na escrita manual.
A falha não é o documento. É a suposição de que OCR, que lê texto, e extração de dados por significado, que lê documentos, são a mesma técnica. Não são.
O Fluxo de Trabalho Que Lê o Que o OCR Ignora
A extração que entende caligrafia lê o cheque como uma pessoa lê: trata "beneficiário", "data", "valor" e "número do cheque" como conceitos e procura cada um onde quer que apareça. Com a Extração de Colunas Personalizadas, o contador digita as colunas desejadas uma vez, usando palavras simples para descrever cada campo, e a IA localiza os valores no cheque escaneado pelo significado, não pela posição dos pixels. Como as colunas são definidas pelo usuário, a mesma configuração produz a mesma estrutura de planilha para o cheque de cada cliente.
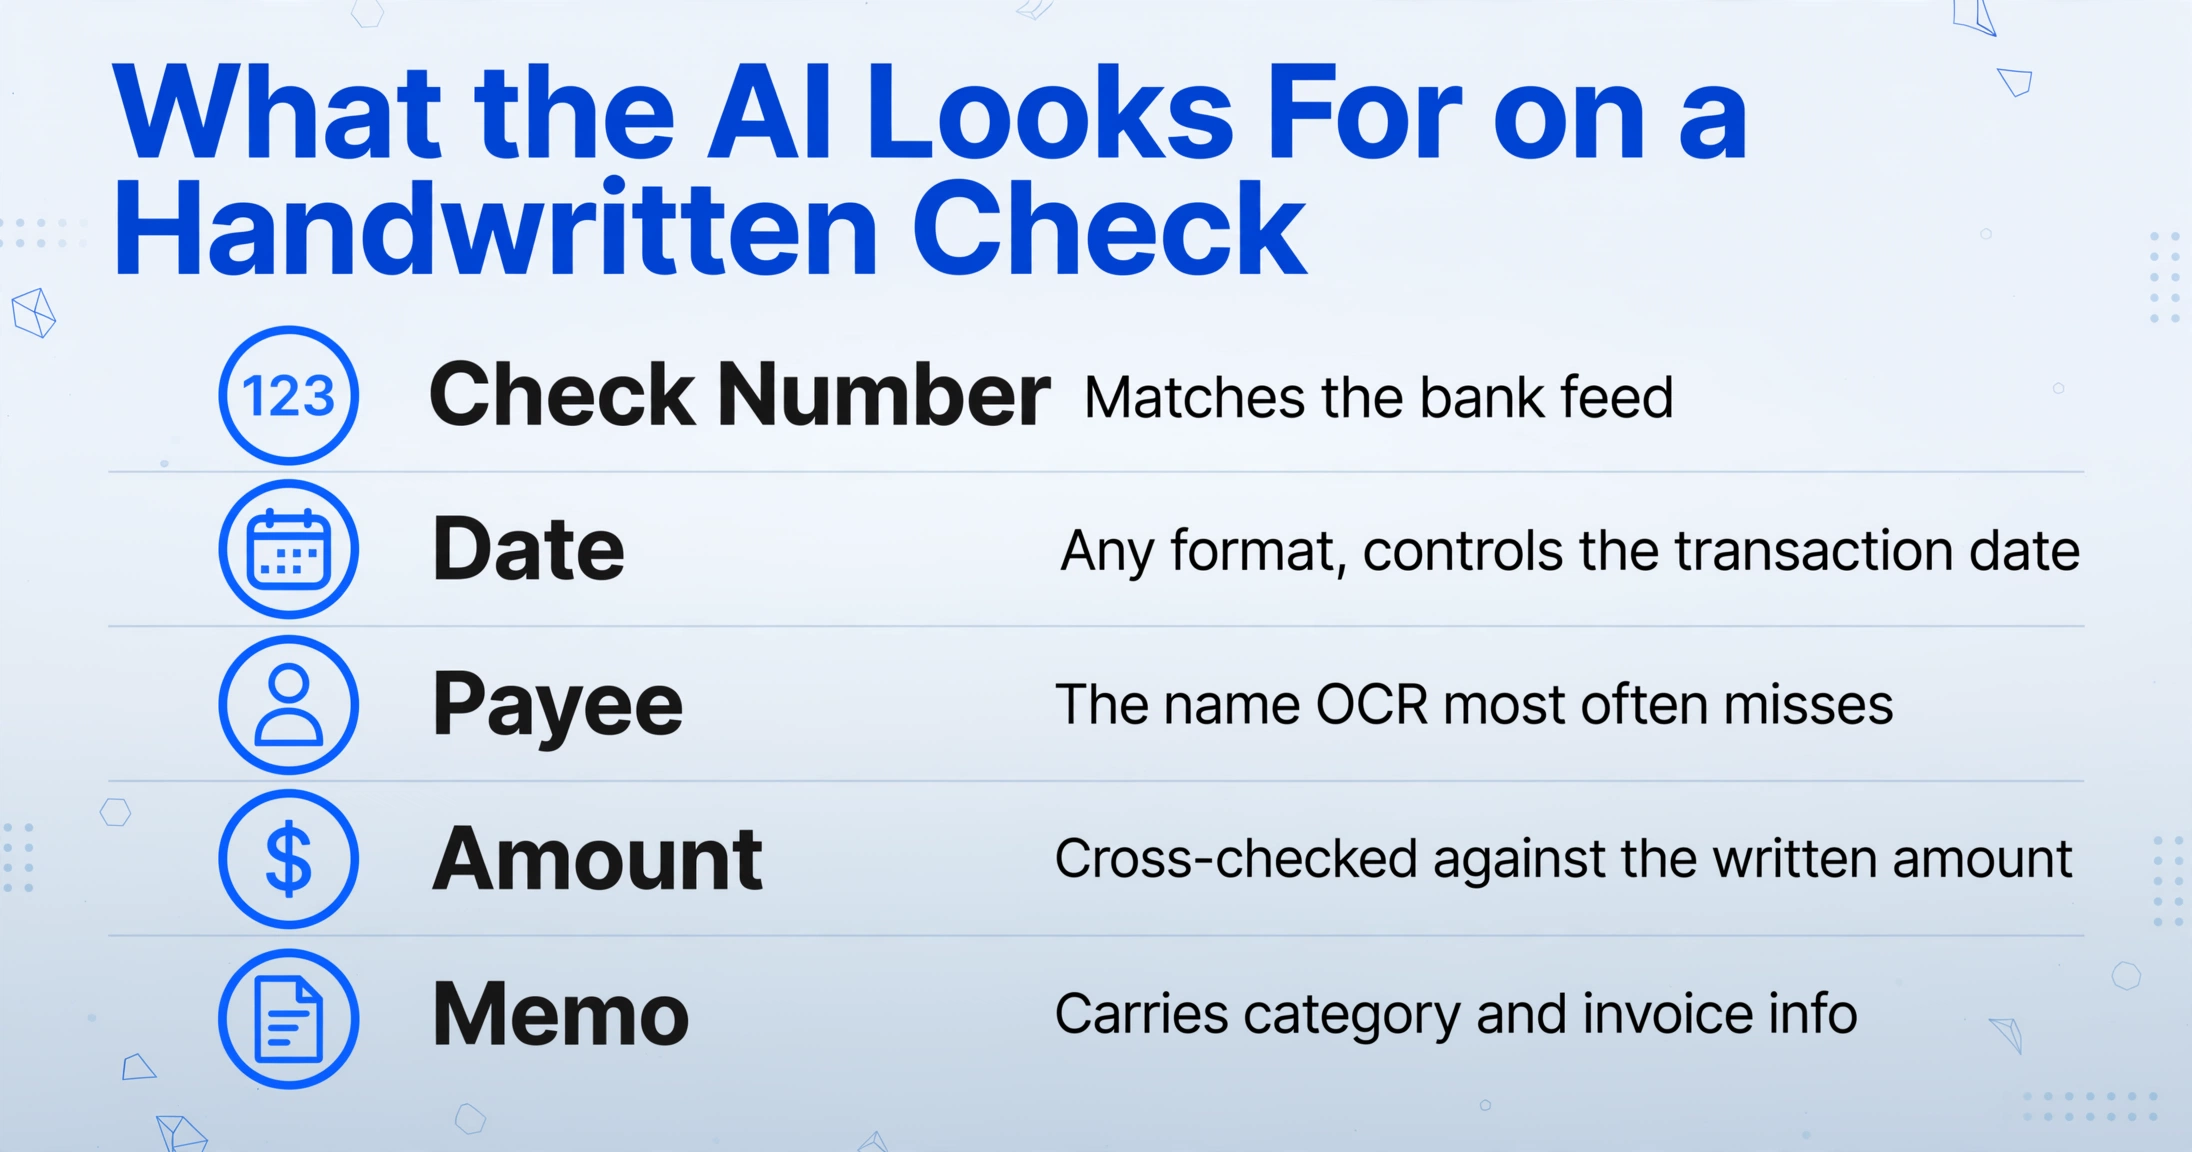
O modelo de colunas para um lote de cheques manuscritos mapeia diretamente os campos que um contador digita hoje:
| Coluna | O que a IA procura | Por que importa |
|---|---|---|
| Número do cheque | O número sequencial na face do cheque | Corresponde ao feed bancário e detecta duplicatas |
| Data | A data escrita, em qualquer formato | Controla a data da transação no Xero |
| Beneficiário | O nome escrito na linha "Pague a ordem de" | O campo que o OCR mais frequentemente retorna em branco |
| Valor | O valor numérico; o valor por extenso pode ser extraído como uma segunda coluna para que um revisor compare os dois | Um dígito errado é um erro de conciliação |
| Observação | O propósito ou referência escrito na linha de observação | Carrega informações de categoria e fatura |
Duas configurações tornam o lote realista. Um nível de modelo mais alto oferece processamento visual mais capaz para caligrafia densa e cursiva, o que importa quando os cheques vêm de clientes com letra pouco firme. Como toda a estrutura processa vários arquivos de uma vez, uma pilha de cheques de um cliente é processada como um único lote e mesclada em uma única planilha, em vez de um arquivo por vez.
A saída então segue um de dois caminhos para o software. As colunas vão para uma planilha que pode ser importada para o Xero como qualquer importação bancária ou de lançamento, ou as linhas extraídas são verificadas e inseridas diretamente. O ponto é que o lançamento não exige mais digitar a caligrafia uma segunda vez; a digitação já foi feita pelo extrator. A mesma leitura em nível de campo que funciona para um cheque já tem um detalhamento completo no artigo sobre conversão de livros contábeis manuscritos para Excel, e o padrão mais amplo para transformar recibos manuscritos em uma planilha pronta para impostos.
Verifique o valor antes de ele ser lançado
A extração de manuscritos nunca é um exercício de confiança cega, e o valor de um cheque é o último lugar onde um contador quer uma leitura incorreta silenciosa. O benchmark da APQC coloca o custo mediano de processamento de um pagamento em $6 por fatura (APQC), a maior parte em lançamento manual, e a empresa mediana ainda digita manualmente 60% das faturas de fornecedores. A etapa de revisão é onde a automação mostra seu valor: é mais barato verificar uma extração do que redigitar e depois verificar mesmo assim.
Para manuscritos, a ferramenta de verificação é o destaque, não o total. O modo de revisão permite que o contador passe o mouse ou clique em qualquer célula extraída e veja exatamente de onde veio aquele valor na imagem original do cheque, e clique na região localizada na imagem para voltar à célula correspondente. Quando um dígito de valor é ambíguo, a empresa vê a escrita que o produziu em vez de confiar em um número que veio do nada. Uma leitura incorreta pode ser corrigida e o valor original da IA mantido em registro com um clique, para que a trilha de auditoria permaneça visível. Essa é a diferença entre uma ferramenta com revisão integrada e uma ferramenta que gera um CSV e torce para dar certo.
O mesmo princípio se aplica aos cheques que você já processa com um feed bancário. Nada aqui substitui o feed; isso encurta a etapa de conciliação. Quando o valor compensado chega, a linha extraída do seu próprio lote fornece o beneficiário e a observação, então categorize e concilie a partir da planilha em vez de abrir cada imagem.
O que ainda precisa de uma pessoa
A extração lê manuscritos, e não é mágica. Tinta fraca, valores com caligrafia muito cursiva e cheques fotografados em ângulo ou com pouca luz produzirão campos de baixa confiança que um contador ainda precisa analisar. O fluxo de trabalho honesto prevê uma passada de revisão em cada lote, não zero exceções. É por isso que a etapa de verificação acima faz parte do design, e não um complemento.
Também há limites no restante da cadeia. Um cheque que nunca é compensado não tem lançamento no feed bancário para conciliar, então a linha extraída é o único registro e a precisão importa mais. E o armazenamento ainda importa: a IRS Publication 583 lista cheques cancelados entre os documentos de suporte que uma empresa deve manter (IRS Publication 583), e um sistema eletrônico só cumpre essa obrigação se seus registros permanecerem legíveis e recuperáveis. Armazenar a imagem resolve a retenção. Extrair os campos resolve o lançamento. A empresa continua fazendo ambos, o que é exatamente o motivo pelo qual as camadas de captura e extração devem ser ferramentas separadas, cada uma fazendo seu próprio trabalho.
Para o lado bancário da leitura de cheques, processamento MICR, verificações de fraude em cheques e verificação KYC, o guia de OCR em banking cobre o fluxo de trabalho institucional. Este artigo é sobre a escala menor: uma pilha de cheques manuscritos na mesa de um contador e o que é digitado no Xero por causa deles.
Cheques Manuscritos e Software de Contabilidade: FAQ
O Hubdoc lê cheques manuscritos?
O Hubdoc armazena imagens de cheques e extrai campos de cabeçalho de documentos impressos, mas sua documentação e relatos de usuários concordam que a caligrafia não é lida de forma confiável; beneficiário e valores frequentemente retornam em branco e são digitados manualmente. Ele continua sendo uma camada sólida de armazenamento e arquivamento de documentos, o que é uma função separada da extração.
O Xero tem OCR integrado para cheques manuscritos?
O Xero em si não faz OCR de documentos. Sua ferramenta de captura integrada, o Hubdoc, faz a leitura, e cheques manuscritos caem nessa lacuna. O Xero aceita dados importados e feeds bancários, então o caminho prático é extrair os campos do cheque para uma planilha e importar as linhas. A mesma lógica se aplica ao QuickBooks, que aceita importações CSV e IIF.
Qual é a precisão da extração de caligrafia em cheques?
Em caligrafia limpa de referência, sistemas modernos de IA atingem taxas de erro de caractere abaixo de 2%, mas em documentos reais a variação é ampla, aproximadamente 46% a 95% de precisão entre ferramentas e estilos de escrita. Legibilidade, qualidade da tinta e resolução do escaneamento determinam o resultado. Essa variação é exatamente o motivo pelo qual uma etapa de revisão que destaca de onde veio cada valor importa mais do que uma alegação de precisão que parece confiante.
Ainda preciso do feed bancário se eu extrair os cheques?
Sim, e os dois funcionam juntos. O feed bancário é o registro autoritativo do que realmente foi compensado, e a extração fornece detalhes de beneficiário e observação que o feed não contém. O fluxo de trabalho se reduz a: extrair o lote, revisar os campos e então conciliar com o feed compensado.
Qual qualidade de escaneamento preciso para cheques manuscritos?
Imagens planas e bem iluminadas em torno de 300 DPI dão os melhores resultados. Uma foto de celular funciona se o cheque estiver plano e a escrita estiver em foco; um scanner é melhor para uma pilha grande. Evite fotos em ângulo e sombras sobre a linha do valor, pois essas são as condições que empurram a caligrafia de volta para o território de baixa confiança.
A mudança útil na forma como uma empresa lida com cheques manuscritos é parar de perguntar "consegue armazenar a imagem" e começar a perguntar "posso definir as colunas, consegue ler o beneficiário e posso verificar o valor antes de lançar". Toda ferramenta de captura na pilha já faz a primeira coisa. Os campos que o OCR deixa em branco são os que valem a pena automatizar.