Cheques manuscritos en Xero,
sin volver a escribir los campos que el OCR omite
Un tenedor de libros que asumía una práctica familiar de CPA preguntó a la comunidad de r/Bookkeeping la pregunta que la mayoría de los dueños de firmas terminan enfrentando: los clientes todavía escriben cheques a mano, y no había una herramienta confiable para capturar esa escritura en Xero. La mejor respuesta resumió el estado de la industria: «Herramientas como Hubdoc, AutoEntry o Dext son buenas para guardar la imagen, pero el OCR generalmente no capta la escritura a mano». Esa frase separa guardar un cheque de leerlo, y esa brecha es lo que mantiene los nombres de beneficiarios y los importes siendo escritos a mano.
Conclusiones clave
- Los escáneres y las herramientas de documentos ya guardan cada cheque, pero el beneficiario y el importe todavía se escriben a mano.
- El OCR lee la línea MICR impresa porque los bancos la diseñaron para máquinas, pero la escritura a mano fue diseñada para ojos humanos, por lo que los errores de palabras son de dos a cuatro veces más altos que los errores de caracteres.
- Defina las columnas por significado una vez y los campos de cada cheque quedarán en una hoja de cálculo importable, donde cualquier valor se resalta de vuelta al punto exacto de la imagen.
La diferencia entre almacenar un cheque y leerlo
Los cheques no han desaparecido de la contabilidad de las pequeñas empresas. La Association for Financial Professionals descubrió que el 91% de las organizaciones encuestadas todavía usan cheques, y el 75% no tiene planes de dejar de hacerlo en dos años (AFP Payments Fraud and Control Survey). La investigación de pagos empresariales de la Reserva Federal muestra que las pequeñas empresas dependen de ellos más que nadie: casi ocho de cada diez empresas muy pequeñas, aquellas con ingresos inferiores a $1 millón, todavía usan cheques en papel para sus pagos. Una chequera no se lee sola, así que el trabajo contable comienza donde termina el papel.
Cuando un cliente entrega un montón de cheques manuscritos, las herramientas documentales de la firma sí capturan las imágenes. Hubdoc, Dext y AutoEntry almacenan el escaneo, lo adjuntan a una transacción y lo archivan. Lo que no hacen de manera consistente es convertir el beneficiario manuscrito, la fecha, el número de cheque y el importe en campos. Los motores de OCR leen bien el texto impreso y se degradan notablemente con la escritura a mano, una brecha que el centro de ayuda de AutoEntry documenta claramente: los archivos con marcas de bolígrafo se rechazan directamente porque el software "tiene dificultades para diferenciar entre texto impreso y una marca de bolígrafo". El resultado práctico es que la imagen se archiva y los datos todavía se escriben a mano.
Esa es la diferencia fundamental que un contable realmente está evaluando. Una herramienta que almacena la imagen resuelve el problema de retención. Una herramienta que extrae los campos resuelve el problema de registro. La mayor parte del procesamiento de cheques en las pequeñas empresas todavía se hace a la manera tradicional porque la capa de captura y la capa de extracción nunca se conectaron para documentos manuscritos.
Cómo un cheque manuscrito se convierte en un asiento hoy en día
La ruta manual tiene una forma fija en la mayoría de las pequeñas empresas. El cliente escribe el cheque y entrega la copia en papel o una foto tomada con el teléfono. El contable abre el software de contabilidad, observa la escritura y teclea la fecha, el nombre del beneficiario, el importe, el número de cheque y una nota en la pantalla de transacción. Luego se adjunta el archivo y la misma transacción se vuelve a cotejar cuando la alimentación del banco importa el artículo compensado.
La segunda parte, la alimentación del banco, es donde muchos contables han resuelto silenciosamente la mitad del problema. Una vez que un cheque se compensa, la alimentación del extracto bancario trae el importe y la fecha. El contable coteja y categoriza a partir de ahí, y el escaneo original sirve como evidencia de respaldo. Ese flujo de trabajo es real y funciona, y es la respuesta recomendada en el propio hilo de r/Bookkeeping: "escanea el cheque como respaldo... luego confía en la alimentación del banco una vez que se compense".
Pero la alimentación del banco tiene límites. Llega días después. Trae el importe y la fecha, pero no el nombre del beneficiario cuando la letra de tu cliente es lo que el cajero del banco tecleó. No te dice nada sobre la nota, el propósito o la categoría hasta que vas a mirar la imagen. Y no puede ayudar con cheques que nunca se compensan en la cuenta, como un cheque recibido que espera ser depositado. El tecleo manual que queda es exactamente el trabajo que no necesita un ojo humano.
Por qué el OCR lee la línea MICR pero omite la escritura a mano
Un cheque oculta dos tipos muy diferentes de texto. La línea de dígitos a lo largo de la parte inferior, la línea MICR, está impresa en una fuente de tinta magnética que los bancos leen detectando la señal magnética, no tomando una foto de ella. Por eso el número de ruta y el número de cuenta de cada cheque se leen de forma fiable: el estándar, establecido en ANSI X9.100-20, define caracteres E-13B que se mantienen consistentes de cheque a cheque. La capa magnética es la parte diseñada para máquinas.
Todo lo demás en el cheque fue diseñado para humanos y está escrito a mano. El nombre del beneficiario, el importe en palabras, el importe numérico, la fecha y la nota están en tinta de bolígrafo en el estilo que use el escritor. El OCR tiene dificultades aquí por tres razones estructurales. La escritura a mano no tiene una fuente fija, por lo que la comparación de caracteres contra un modelo de letras falla. El diseño varía de cheque a cheque, por lo que no hay una posición de plantilla para "el beneficiario siempre está aquí". Y el costo del error es asimétrico: para la escritura a mano, las tasas de error de palabras suelen ser de dos a cuatro veces más altas que las tasas de error de caracteres, porque un solo carácter mal leído hace fallar toda la palabra, que es exactamente el peor modo de fallo para un nombre de beneficiario o un importe (ver los datos de precisión del reconocimiento de escritura a mano).
Las herramientas de captura creadas para la contabilidad toman una decisión deliberada: extraen muy bien facturas y recibos impresos, y evitan la escritura a mano devolviéndola en blanco o marcando el documento para entrada manual. El hilo de Reddit captura el consenso: "El OCR generalmente funciona bien con facturas y extractos mecanografiados, pero la escritura a mano añade otra capa de dificultad ya que los estilos varían mucho". El contable no está haciendo nada mal. El conjunto de herramientas que le dieron simplemente se detiene en la escritura a mano.
El fallo no es el documento. Es la suposición de que el OCR, que lee texto, y la extracción de datos por significado, que lee documentos, son la misma técnica. No lo son.
El flujo de trabajo que lee lo que el OCR omite
La extracción que comprende la escritura manuscrita lee el cheque como lo haría una persona: trata «beneficiario», «fecha», «importe» y «número de cheque» como conceptos y luego busca cada uno dondequiera que aparezca. Con la Extracción de Columnas Personalizadas, el contador escribe las columnas que desea una sola vez, usando palabras sencillas para describir cada campo, y la IA localiza los valores en el cheque escaneado por significado, no por posición de píxeles. Dado que las columnas las define el usuario, la misma configuración produce la misma estructura de hoja de cálculo para los cheques de cada cliente.
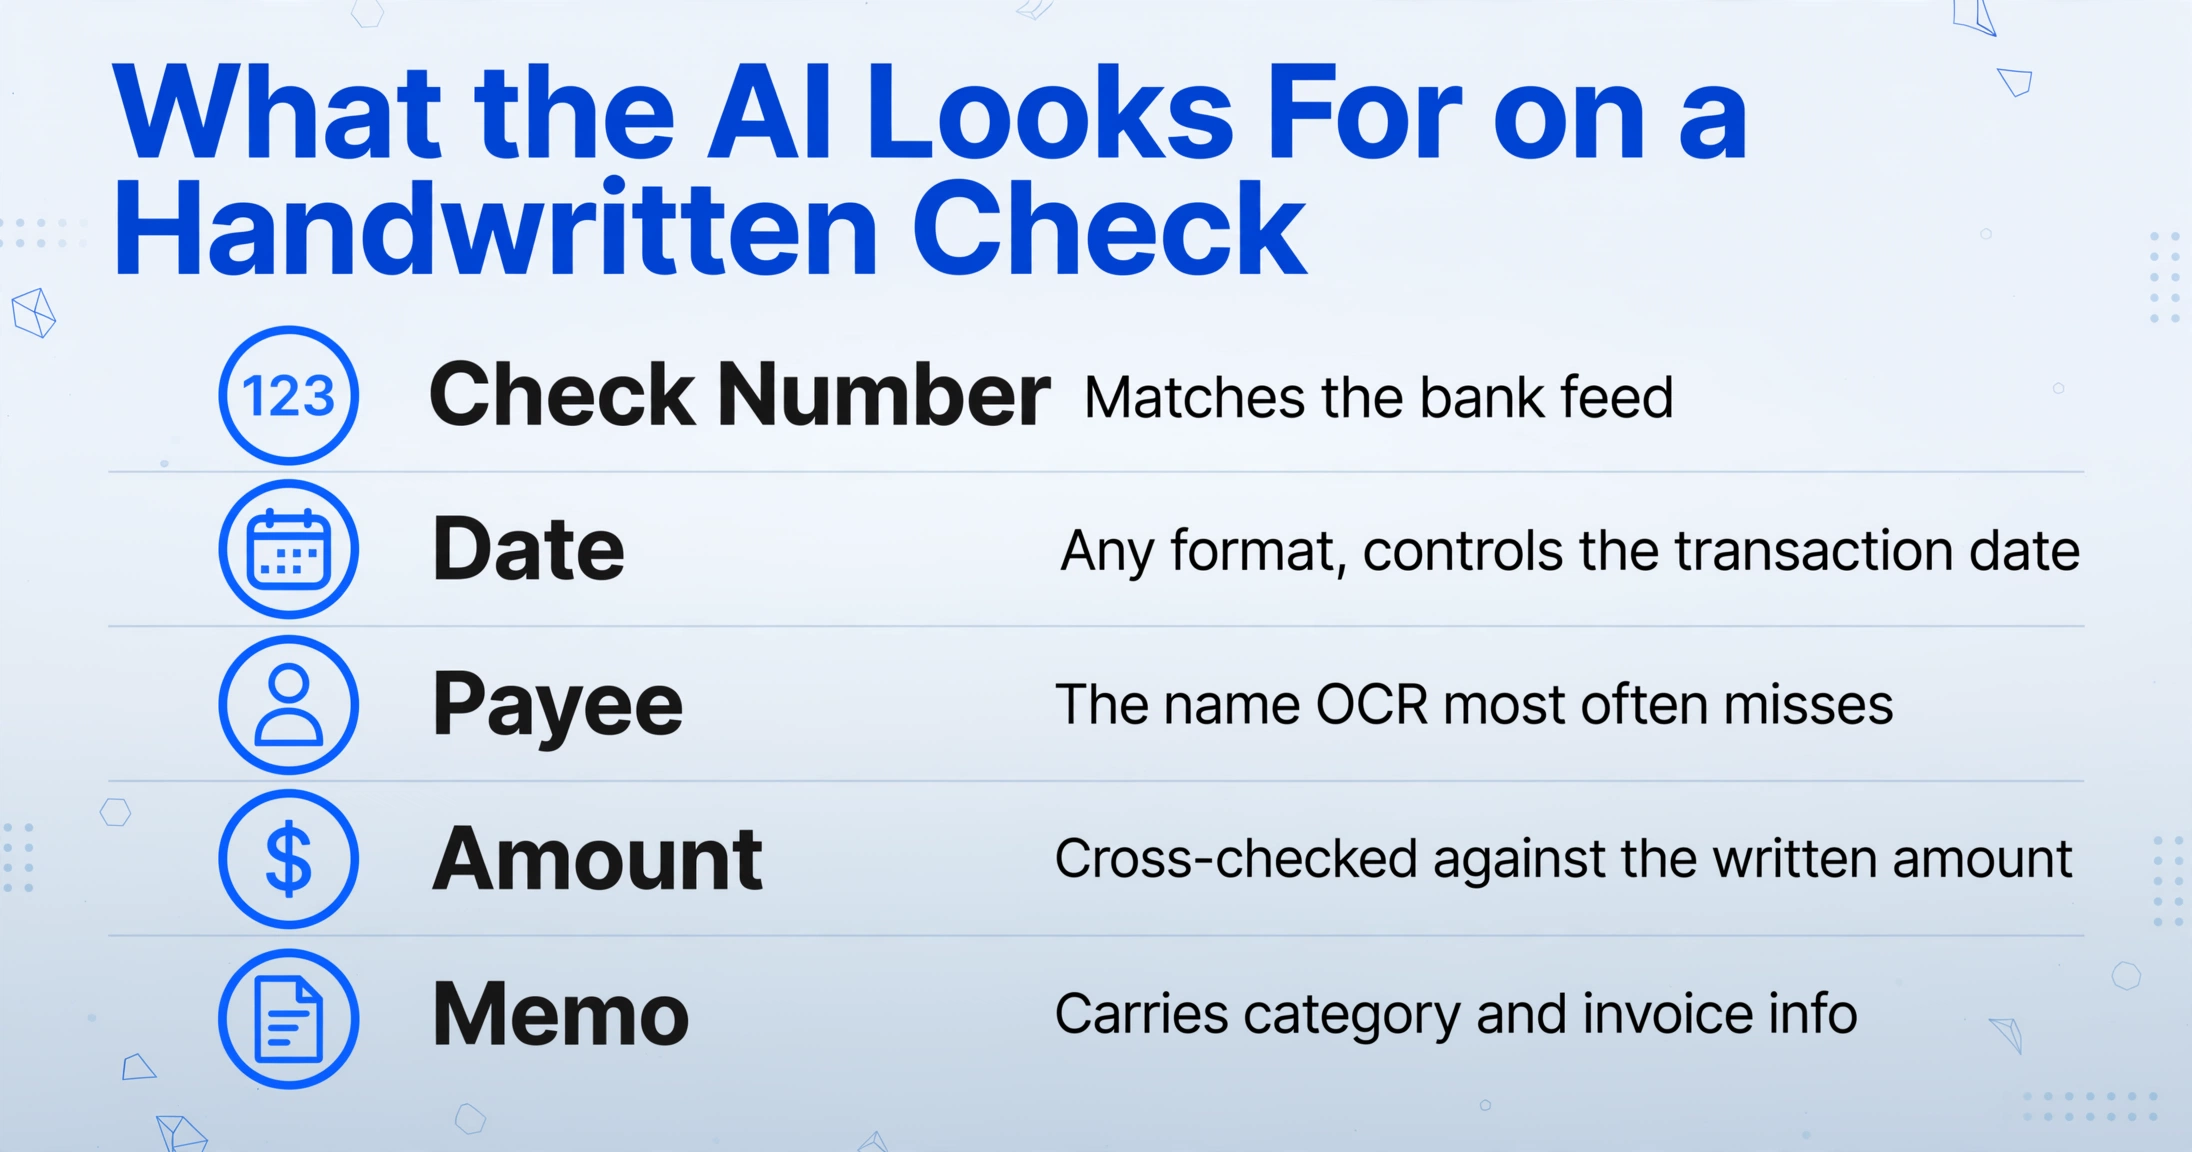
La plantilla de columnas para un lote de cheques manuscritos se corresponde directamente con los campos que el contador teclea hoy:
| Columna | Qué busca la IA | Por qué es importante |
|---|---|---|
| Número de cheque | El número de secuencia en el anverso del cheque | Coincide con el extracto bancario y detecta duplicados |
| Fecha | La fecha escrita, en cualquier formato | Controla la fecha de la transacción en Xero |
| Beneficiario | El nombre escrito en la línea «Páguese a la orden de» | El campo que el OCR devuelve en blanco con más frecuencia |
| Importe | El importe numérico; el importe escrito puede extraerse como segunda columna para que un revisor compare ambos | Un solo dígito erróneo es un error de conciliación |
| Nota | El propósito o la referencia escrita en la línea de nota | Contiene la categoría y la información de la factura |
Dos ajustes hacen que el lote sea realista. Un nivel de modelo más alto proporciona un procesamiento visual más capaz para la escritura densa y cursiva, lo cual importa cuando los cheques provienen de clientes cuya caligrafía es poco clara. Dado que todo el sistema procesa varios archivos a la vez, un montón de cheques de un cliente se procesa como un solo lote y se fusiona en una única hoja de cálculo, en lugar de un archivo a la vez.
El resultado sigue entonces una de dos vías hacia el software. Las columnas llegan a una hoja de cálculo que puede importarse a Xero como cualquier importación bancaria o de diario, o las filas extraídas se revisan y se registran directamente. La cuestión es que el registro ya no requiere teclear la escritura manuscrita una segunda vez; el tecleo ya lo hizo el extractor. La misma lectura a nivel de campo que funciona para un cheque ya tiene un desglose detallado en el artículo sobre cómo convertir libros de contabilidad manuscritos a Excel, y el patrón más amplio para cómo convertir recibos manuscritos en una hoja de cálculo lista para impuestos.
Verifique el importe antes de que se registre
La extracción de escritura manuscrita nunca es un ejercicio de confianza ciega, y el importe de un cheque es el último lugar donde un contador quiere una lectura errónea silenciosa. El punto de referencia de APQC sitúa el costo medio de procesar una cuenta por pagar en $6 por factura (APQC), la mayor parte en ingreso manual, y la firma mediana aún ingresa manualmente el 60 % de las facturas de proveedores. El paso de revisión es donde la automatización demuestra su valor: es más barato verificar una extracción que volver a escribirla y luego verificar de todos modos.
Para la escritura manuscrita, la herramienta de verificación es el resaltado, no el total. El modo de revisión permite al contador pasar el cursor o hacer clic en cualquier celda extraída y ver exactamente de dónde proviene ese valor en la imagen original del cheque, y hacer clic en la región localizada de la imagen para volver a la celda correspondiente. Cuando un dígito del importe es ambiguo, la firma ve la escritura que lo produjo en lugar de confiar en un número que no proviene de ningún lugar. Una lectura incorrecta puede corregirse y el valor original de la IA se conserva en el registro con un clic, de modo que el rastro de auditoría permanece visible. Esa es la diferencia entre una herramienta con revisión integrada y una herramienta que descarga un CSV y espera lo mejor.
El mismo principio se aplica a los cheques que ya procesa con un feed bancario. Nada aquí reemplaza el feed; acorta el paso de conciliación. Cuando llega el importe liquidado, la fila extraída de su propio lote proporciona el beneficiario y la nota, de modo que puede categorizar y conciliar desde la hoja de cálculo en lugar de abrir cada imagen.
Lo que aún requiere una persona
La extracción lee escritura manuscrita y no es magia. Tinta tenue, importes con caligrafía muy cursiva y cheques fotografiados en ángulo o con poca luz producirán campos de baja confianza que el contador aún debe revisar. El flujo de trabajo honesto contempla una pasada de revisión en cada lote, no cero excepciones. Por eso el paso de verificación anterior es parte del diseño y no una idea posterior.
También hay límites en el resto de la cadena. Un cheque que nunca se liquida no tiene entrada de feed bancario para conciliar, por lo que la fila extraída es el único registro y la precisión importa más. Y el almacenamiento sigue importando: la Publicación 583 del IRS enumera los cheques cancelados entre los documentos de respaldo que una empresa debe conservar (Publicación 583 del IRS), y un sistema electrónico solo cumple esa obligación si sus registros permanecen legibles y recuperables. Almacenar la imagen resuelve la retención. Extraer los campos resuelve el ingreso. La firma sigue haciendo ambas cosas, que es exactamente por qué las capas de captura y extracción deben ser herramientas separadas, cada una con su propia función.
Para el aspecto bancario de la lectura de cheques, el procesamiento MICR, la verificación de fraude en cheques y la verificación KYC, la guía de OCR en banca cubre el flujo de trabajo institucional. Este artículo trata sobre la escala más pequeña: una pila de cheques manuscritos en el escritorio de un contador y lo que se ingresa en Xero gracias a ellos.
Cheques manuscritos y software de contabilidad: preguntas frecuentes
¿Hubdoc lee cheques manuscritos?
Hubdoc almacena imágenes de cheques y extrae campos de encabezado de documentos impresos, pero su documentación y los informes de usuarios coinciden en que la escritura manuscrita no se lee de forma fiable; el beneficiario y los importes suelen devolverse en blanco y se escriben manualmente. Sigue siendo una capa sólida de almacenamiento y archivo de documentos, que es una tarea distinta de la extracción.
¿Xero tiene OCR integrado para cheques manuscritos?
Xero en sí no aplica OCR a los documentos. Su herramienta de captura incluida, Hubdoc, se encarga de la lectura, y los cheques manuscritos caen en ese vacío. Xero acepta datos importados y fuentes bancarias, por lo que la vía práctica es extraer los campos del cheque a una hoja de cálculo e importar las filas. La misma lógica aplica a QuickBooks, que acepta importaciones CSV e IIF.
¿Qué precisión tiene la extracción de escritura manuscrita en cheques?
Con escritura de referencia limpia, los sistemas modernos de IA alcanzan tasas de error de carácter inferiores al 2%, pero en documentos reales el rango es amplio: aproximadamente del 46% al 95% de precisión según la herramienta y el estilo de escritura. La legibilidad, la calidad de la tinta y la resolución del escaneo determinan el resultado. Esa variabilidad es precisamente la razón por la que un paso de revisión que resalta de dónde proviene cada valor importa más que una afirmación de precisión que suene convincente.
¿Sigo necesitando la fuente bancaria si extraigo los cheques?
Sí, y ambas cosas funcionan en conjunto. La fuente bancaria es el registro autoritativo de lo que realmente se compensó, y la extracción aporta el detalle del beneficiario y la nota que la fuente no incluye. El flujo de trabajo se reduce a: extraer el lote, revisar los campos y luego conciliar con la fuente compensada.
¿Qué calidad de escaneo necesito para cheques manuscritos?
Imágenes planas y bien iluminadas a unos 300 DPI dan los mejores resultados. Una foto de teléfono funciona si el cheque está plano y la escritura está enfocada; un escáner es mejor para un lote grande. Evite tomas en ángulo y sombras sobre la línea del importe, ya que esas son las condiciones que devuelven la escritura manuscrita a un territorio de baja confianza.
El cambio útil en cómo una firma maneja los cheques manuscritos es dejar de preguntar «¿puede almacenar la imagen?» y empezar a preguntar «¿puedo definir las columnas, puede leer el beneficiario y puedo verificar el importe antes de que se contabilice?». Toda herramienta de captura en la pila ya hace lo primero. Los campos que el OCR deja en blanco son los que vale la pena automatizar.