Des chèques manuscrits dans Xero,
sans ressaisir les champs que l'OCR ignore
Une comptable reprenant un cabinet familial d'expertise comptable a demandé à la communauté r/Bookkeeping la question que la plupart des dirigeants de cabinets finissent par se poser : les clients écrivent encore des chèques à la main, et aucun outil fiable ne permettait de capturer cette écriture dans Xero. La réponse la plus populaire résumait l'état de l'industrie : « Des outils comme Hubdoc, AutoEntry ou Dext sont efficaces pour stocker l'image, mais l'OCR rate généralement l'écriture manuscrite. » Cette phrase sépare le stockage d'un chèque de sa lecture, et c'est cet écart qui fait que les noms de bénéficiaires et les montants sont encore saisis à la main.
Points clés à retenir
- Les scanners et les outils documentaires stockent déjà chaque chèque, mais le bénéficiaire et le montant sont encore saisis à la main.
- L'OCR lit la ligne MICR imprimée parce que les banques l'ont conçue pour les machines, mais l'écriture manuscrite a été conçue pour les yeux humains, donc les erreurs sur les mots sont deux à quatre fois plus élevées que les erreurs sur les caractères.
- Définissez les colonnes par signification une seule fois et chaque champ de chèque arrive dans une feuille de calcul importable, où toute valeur renvoie à l'endroit exact sur l'image.
La différence entre stocker un chèque et le lire
Les chèques n'ont pas disparu de la comptabilité des petites entreprises. L'Association for Financial Professionals a constaté que 91 % des organisations interrogées utilisent encore des chèques, et 75 % déclarent ne pas prévoir d'arrêter dans les deux ans (AFP Payments Fraud and Control Survey). Les recherches sur les paiements des entreprises menées par la Réserve fédérale montrent que les petites structures y recourent le plus : près de huit très petites entreprises sur dix, celles dont le chiffre d'affaires est inférieur à 1 million de dollars, utilisent encore des chèques papier pour leurs paiements. Un carnet de chèques ne se lit pas tout seul, le travail comptable commence donc là où le papier s'arrête.
Lorsqu'un client remet une pile de chèques manuscrits, les outils documentaires du cabinet capturent bien les images. Hubdoc, Dext et AutoEntry stockent volontiers le scan, le rattachent à une transaction et le classent. Ce qu'ils ne font pas de manière fiable, c'est transformer le bénéficiaire manuscrit, la date, le numéro de chèque et le montant en champs. Les moteurs OCR lisent bien le texte imprimé mais se dégradent fortement sur l'écriture manuscrite, un écart que le centre d'aide AutoEntry documente clairement : les fichiers comportant des marques au stylo sont rejetés d'emblée, car le logiciel « a du mal à différencier le texte imprimé d'une marque au stylo ». Le résultat concret est que l'image est archivée et que les données sont toujours saisies manuellement.
C'est la différence fondamentale qu'un comptable teste réellement. Un outil qui stocke l'image résout le problème de conservation. Un outil qui extrait les champs résout le problème de saisie. La plupart du traitement des chèques dans les petites entreprises se fait encore à l'ancienne, car la couche de capture et la couche d'extraction n'ont jamais été connectées pour les documents manuscrits.
Comment un chèque manuscrit devient une écriture aujourd'hui
La voie manuelle suit un schéma fixe dans la plupart des petites entreprises. Le client rédige le chèque et remet soit la copie papier, soit une photo prise avec son téléphone. Le teneur de livres ouvre le logiciel de comptabilité, examine l'écriture et saisit la date, le nom du bénéficiaire, le montant, le numéro de chèque et un libellé dans l'écran de transaction. Ensuite, le fichier est joint et la même transaction est de nouveau rapprochée lorsque le flux bancaire importe l'élément compensé.
La deuxième étape, le flux bancaire, est l'endroit où de nombreux teneurs de livres ont discrètement résolu la moitié du problème. Une fois qu'un chèque est compensé, le flux de relevé bancaire apporte le montant et la date. Le teneur de livres rapproche et catégorise à partir de là, et la numérisation originale sert de preuve de sauvegarde. Ce flux de travail est réel et fonctionne, et c'est la réponse recommandée dans le fil r/Bookkeeping lui-même : « numériser le chèque pour sauvegarde... puis se fier au flux bancaire une fois qu'il est compensé. »
Mais le flux bancaire a des limites. Il arrive plusieurs jours plus tard. Il apporte le montant et la date, mais pas le nom du bénéficiaire lorsque l'écriture manuscrite du client est ce que le caissier de la banque a saisi. Il ne dit rien sur le libellé, le but ou la catégorie tant qu'on ne va pas regarder l'image. Et il ne peut pas aider avec les chèques qui ne sont jamais débités du compte, comme un chèque reçu en attente d'être déposé. La saisie manuelle qui reste est exactement le travail qui ne nécessite pas un œil humain.
Pourquoi l'OCR lit la ligne MICR mais ignore l'écriture manuscrite
Un chèque cache deux types de texte très différents. La ligne de chiffres en bas, la ligne MICR, est imprimée dans une police à encre magnétique que les banques lisent en détectant le signal magnétique, et non en en prenant une photo. C'est pourquoi le numéro d'acheminement et le numéro de compte sur chaque chèque sont lus de manière fiable : la norme, définie dans ANSI X9.100-20, définit des caractères E-13B qui restent cohérents d'un chèque à l'autre. La couche magnétique est la partie conçue pour les machines.
Tout le reste sur le chèque a été conçu pour les humains et est écrit à la main. Le nom du bénéficiaire, le montant en lettres, le montant numérique, la date et le libellé sont de l'encre de stylo à bille, quel que soit le style d'écriture de l'auteur. L'OCR échoue ici pour trois raisons structurelles. L'écriture manuscrite n'a pas de police fixe, donc la correspondance de caractères avec un modèle de lettre échoue. La mise en page varie d'un chèque à l'autre, donc il n'y a pas de position modèle pour « le bénéficiaire est toujours ici ». Et le coût de l'erreur est asymétrique : pour l'écriture manuscrite, les taux d'erreur de mots sont généralement deux à quatre fois plus élevés que les taux d'erreur de caractères, car un seul caractère mal lu fait échouer le mot entier, ce qui est exactement le pire mode de défaillance pour un nom de bénéficiaire ou un montant (voir les données de précision de la reconnaissance de l'écriture manuscrite).
Les outils de capture conçus pour la tenue de livres font un compromis délibéré : ils extraient très bien les factures et reçus imprimés, et ils contournent l'écriture manuscrite en la renvoyant vide ou en signalant le document pour une saisie manuelle. Le fil Reddit résume le consensus : « L'OCR fonctionne généralement bien avec les factures et relevés tapés, mais l'écriture manuscrite ajoute une autre couche de difficulté car les styles varient tellement. » Le teneur de livres ne fait rien de mal. La pile d'outils qui lui a été fournie s'arrête simplement à l'écriture manuscrite.
L'échec n'est pas le document. C'est l'hypothèse que l'OCR, qui lit le texte, et l'extraction de données par le sens, qui lit les documents, sont la même technique. Elles ne le sont pas.
Le flux de travail qui lit ce que l'OCR ignore
Une extraction qui comprend l'écriture manuscrite lit le chèque comme le ferait une personne : elle traite « bénéficiaire », « date », « montant » et « numéro de chèque » comme des concepts, puis cherche chacun d'eux où qu'il apparaisse. Avec l'Extraction de colonnes personnalisées, le comptable saisit une fois les colonnes souhaitées, en décrivant chaque champ avec des mots simples, et l'IA localise les valeurs sur le chèque scanné par le sens plutôt que par la position des pixels. Comme les colonnes sont définies par l'utilisateur, la même configuration produit la même structure de feuille de calcul pour les chèques de chaque client.
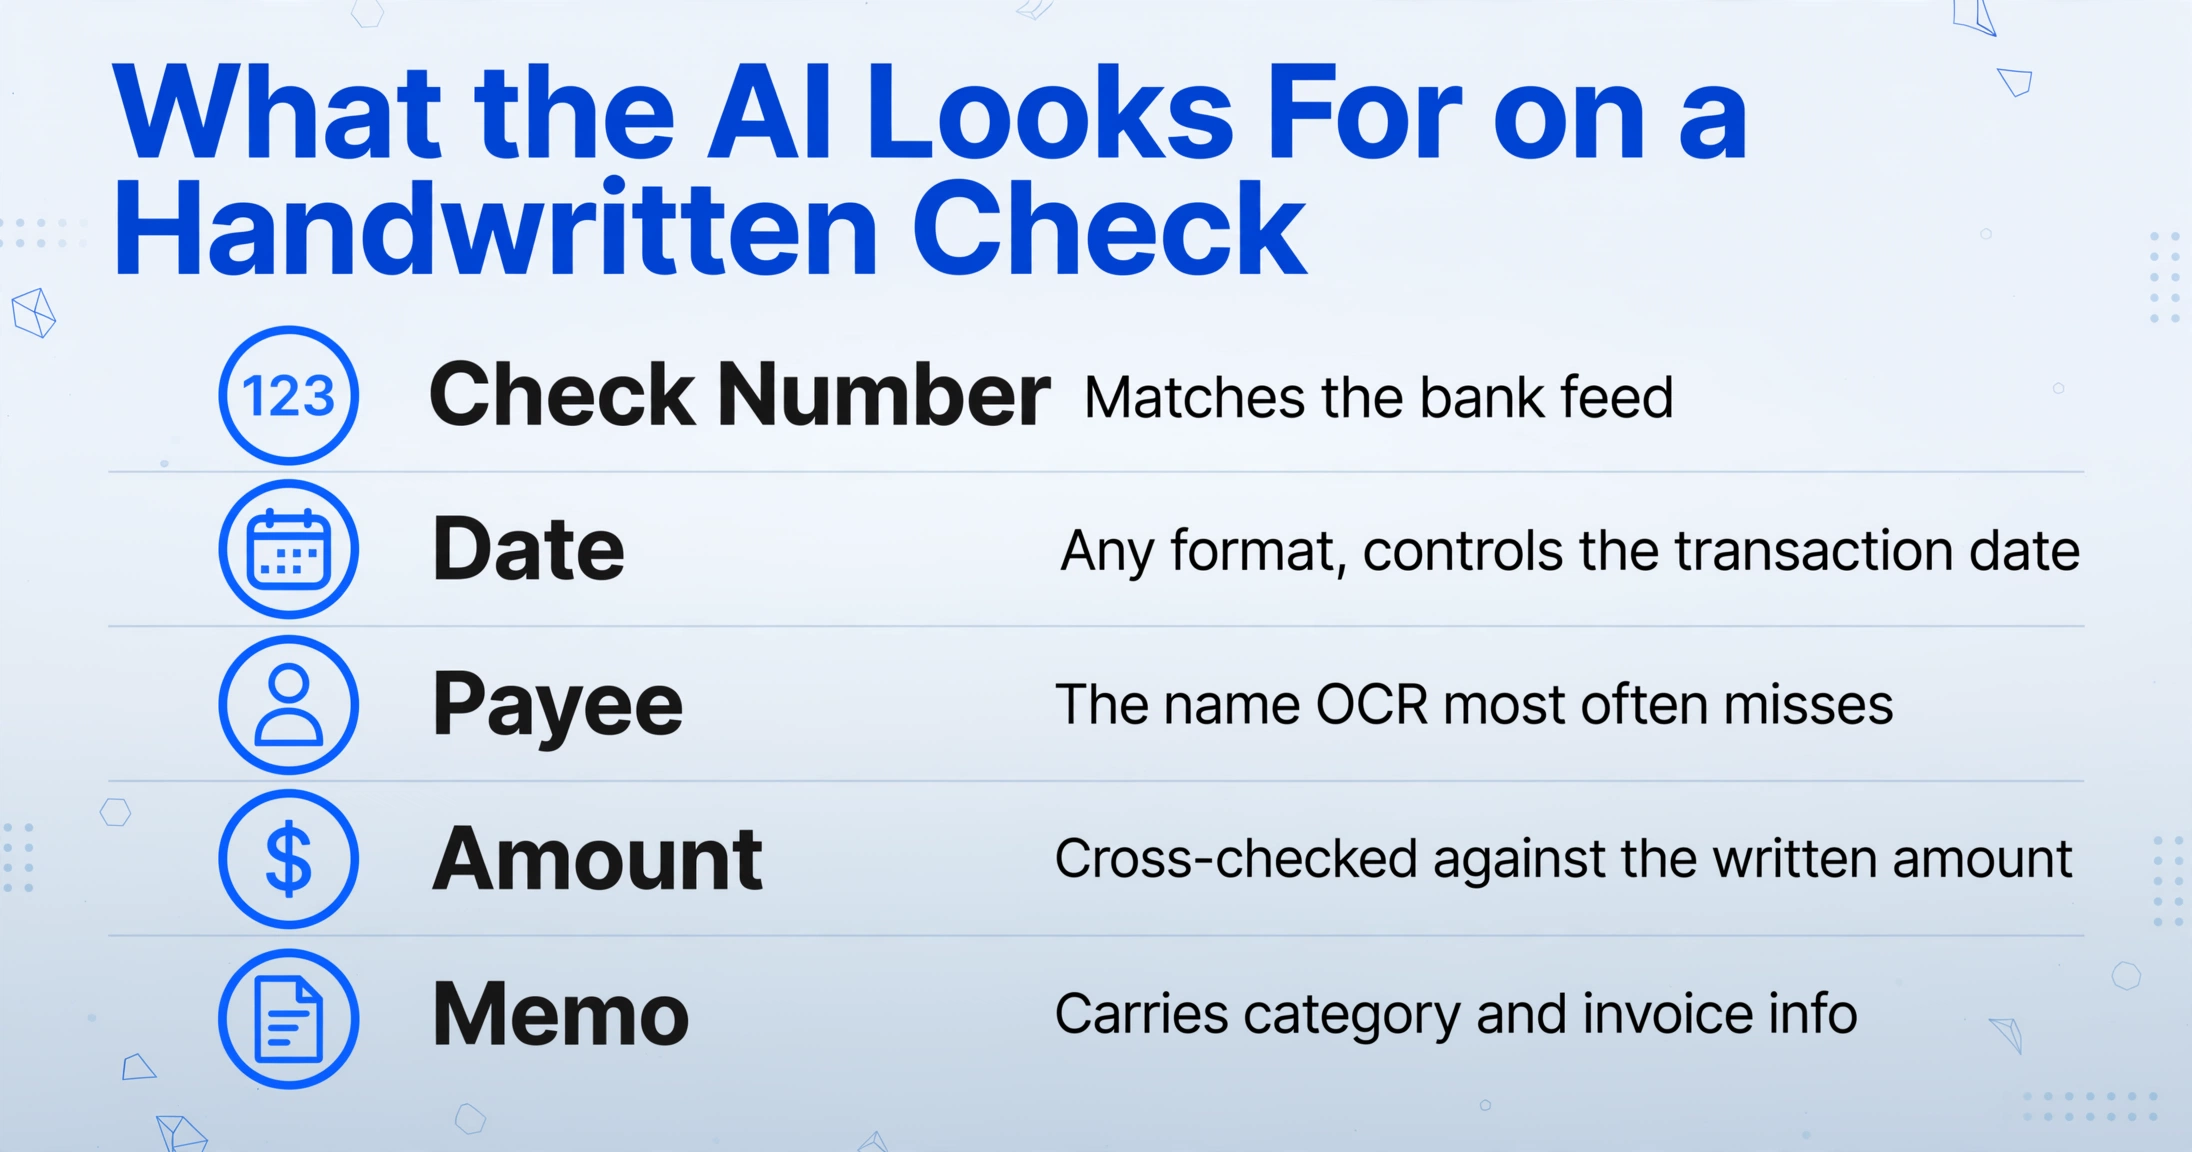
Le modèle de colonnes pour un lot de chèques manuscrits correspond directement aux champs qu'un comptable saisit aujourd'hui :
| Colonne | Ce que l'IA recherche | Pourquoi c'est important |
|---|---|---|
| Numéro de chèque | Le numéro de séquence sur le recto du chèque | Correspond au flux bancaire et détecte les doublons |
| Date | La date inscrite, quel que soit le format | Contrôle la date de transaction dans Xero |
| Bénéficiaire | Le nom inscrit sur la ligne « Payez à l'ordre de » | Le champ que l'OCR laisse le plus souvent vide |
| Montant | Le montant numérique ; le montant en lettres peut être extrait dans une seconde colonne afin qu'un vérificateur puisse comparer les deux | Un seul chiffre erroné constitue une erreur de rapprochement |
| Libellé | L'objet ou la référence inscrit sur la ligne de libellé | Contient les informations de catégorie et de facture |
Deux paramètres rendent le lot réaliste. Un niveau de modèle supérieur offre un traitement visuel plus performant pour l'écriture dense et cursive, ce qui importe lorsque les chèques proviennent de clients dont l'écriture est peu soignée. Comme l'ensemble de la chaîne traite plusieurs fichiers à la fois, une pile de chèques d'un même client est traitée comme un seul lot et fusionnée dans une seule feuille de calcul, plutôt que fichier par fichier.
Le résultat suit ensuite l'un des deux chemins vers le logiciel. Les colonnes aboutissent dans une feuille de calcul qui peut être importée dans Xero comme n'importe quel import bancaire ou de journal, ou les lignes extraites sont vérifiées et saisies directement. L'essentiel est que la saisie ne nécessite plus de retaper l'écriture manuscrite une seconde fois ; la frappe a déjà été effectuée par l'extracteur. La même lecture au niveau des champs qui fonctionne pour un seul chèque fait déjà l'objet d'une analyse détaillée dans l'article sur la conversion de registres manuscrits en Excel, ainsi que du schéma plus large pour obtenir des reçus manuscrits dans une feuille de calcul prête pour la déclaration fiscale.
Vérifier le montant avant qu'il ne soit comptabilisé
L'extraction de l'écriture manuscrite ne repose jamais sur une confiance aveugle, et le montant d'un chèque est le dernier endroit où un comptable souhaite une erreur de lecture silencieuse. Le benchmark APQC situe le coût médian de traitement d'une facture fournisseur à 6 $ par facture (APQC), dont l'essentiel est de la saisie manuelle, et le cabinet médian saisit encore manuellement 60 % des factures fournisseurs. L'étape de vérification est là où l'automatisation montre sa valeur : il est moins coûteux de vérifier une extraction que de la ressaisir puis de vérifier quand même.
Pour l'écriture manuscrite, l'outil de vérification est le point fort, pas l'ensemble. Le mode de vérification permet au comptable de survoler ou de cliquer sur n'importe quelle cellule extraite et de voir exactement d'où provient cette valeur sur l'image du chèque original, puis de cliquer sur la zone localisée de l'image pour revenir à la cellule correspondante. Lorsqu'un chiffre du montant est ambigu, le cabinet voit l'écriture qui l'a produit au lieu de se fier à un nombre venu de nulle part. Une lecture erronée peut être corrigée et la valeur originale de l'IA conservée au dossier en un clic, afin que la piste d'audit reste visible. C'est la différence entre un outil avec vérification intégrée et un outil qui exporte un CSV et espère.
Le même principe s'applique aux chèques déjà traités via un flux bancaire. Rien ici ne remplace le flux ; cela raccourcit l'étape de rapprochement. Lorsque le montant encaissé arrive, la ligne extraite de votre propre lot fournit le bénéficiaire et le libellé, ce qui permet de catégoriser et de rapprocher directement depuis le tableur au lieu d'ouvrir chaque image.
Ce qui nécessite encore une intervention humaine
L'extraction lit l'écriture manuscrite, et ce n'est pas de la magie. Une encre pâle, des montants très cursifs et des chèques photographiés en biais ou sous une faible luminosité produiront des champs à faible confiance qu'un comptable devra encore examiner. Le flux de travail honnête prévoit une passe de vérification sur chaque lot, pas zéro exception. C'est pourquoi l'étape de vérification ci-dessus fait partie de la conception plutôt que d'être une réflexion après coup.
Il existe aussi des limites dans le reste de la chaîne. Un chèque qui n'est jamais encaissé n'a aucune entrée de flux bancaire à rapprocher, donc la ligne extraite est le seul enregistrement et l'exactitude compte davantage. Et le stockage compte toujours : la publication IRS 583 énumère les chèques annulés parmi les documents justificatifs qu'une entreprise doit conserver (IRS Publication 583), et un système électronique ne satisfait à cette obligation que si ses enregistrements restent lisibles et récupérables. Stocker l'image résout la conservation. Extraire les champs résout la saisie. Le cabinet continue de faire les deux, ce qui explique précisément pourquoi les couches de capture et d'extraction devraient être des outils distincts qui remplissent chacun leur fonction.
Pour le volet bancaire de la lecture des chèques, le traitement MICR, les contrôles antifraude sur les chèques et la vérification KYC, le guide OCR dans le secteur bancaire couvre le flux de travail institutionnel. Cet article concerne une échelle plus réduite : une pile de chèques manuscrits sur le bureau d'un comptable et ce qui est saisi dans Xero grâce à eux.
Chèques manuscrits et logiciels de comptabilité : FAQ
Est-ce que Hubdoc lit les chèques manuscrits ?
Hubdoc stocke les images de chèques et extrait les champs d'en-tête des documents imprimés, mais sa documentation et les retours d'utilisateurs s'accordent sur le fait que l'écriture manuscrite n'est pas lue de manière fiable ; le bénéficiaire et les montants reviennent souvent vides et sont saisis manuellement. Il reste une couche solide de stockage et de classement de documents, ce qui est une tâche distincte de l'extraction.
Est-ce que Xero dispose d'une OCR intégrée pour les chèques manuscrits ?
Xero lui-même ne fait pas d'OCR sur les documents. Son outil de capture inclus, Hubdoc, se charge de la lecture, et les chèques manuscrits passent à travers cette lacune. Xero accepte les données importées et les flux bancaires, donc la voie pratique consiste à extraire les champs du chèque dans une feuille de calcul et à importer les lignes. La même logique s'applique à QuickBooks, qui accepte les importations CSV et IIF.
Quelle est la précision de l'extraction de l'écriture manuscrite sur les chèques ?
Sur des références d'écriture manuscrite propres, les systèmes d'IA modernes atteignent des taux d'erreur de caractères inférieurs à 2 %, mais sur des documents réels, la fourchette est large, environ 46 % à 95 % de précision selon les outils et les styles d'écriture. La lisibilité, la qualité de l'encre et la résolution de numérisation déterminent le résultat. Cette variance explique précisément pourquoi une étape de vérification qui met en évidence l'origine de chaque valeur importe plus qu'une affirmation de précision qui semble confiante.
Ai-je encore besoin du flux bancaire si j'extrais les chèques ?
Oui, et les deux fonctionnent ensemble. Le flux bancaire est l'enregistrement faisant foi de ce qui a réellement été débité, et l'extraction fournit le détail du bénéficiaire et du libellé que le flux ne contient pas. Le flux de travail se réduit à : extraire le lot, vérifier les champs, puis rapprocher avec le flux débité.
Quelle qualité de numérisation est nécessaire pour les chèques manuscrits ?
Des images plates et bien éclairées à environ 300 DPI donnent les meilleurs résultats. Une photo de téléphone fonctionne si le chèque est plat et l'écriture nette ; un scanner est préférable pour une grosse pile. Évitez les prises de vue en angle et les ombres sur la ligne du montant, car ce sont ces conditions qui font retomber l'écriture manuscrite dans une zone de faible confiance.
Le changement utile dans la façon dont un cabinet gère les chèques manuscrits est de cesser de se demander « peut-il stocker l'image » et de commencer à se demander « puis-je définir les colonnes, peut-il lire le bénéficiaire, et puis-je vérifier le montant avant la publication ». Chaque outil de capture de la pile fait déjà la première chose. Les champs que l'OCR laisse vides sont ceux qui valent la peine d'être automatisés.