Comment convertir des livres de comptes manuscrits
en Excel avec l'IA
Dans un fil r/Bookkeeping, un utilisateur décrivait avoir hérité du système de livres manuscrits d'un patron de 75 ans : chaque ticket, chaque transaction, consigné à la main dans des registres reliés — et un bureau qui « fonctionne toujours comme dans les années 1980 ». La question n'était pas de savoir s'il fallait numériser, mais comment. Voici le processus pour transformer une étagère de livres de comptes dessinés à la main en une seule feuille de calcul Excel rapprochée, sans ressaisir 6 000 lignes.
Points clés à retenir
- Un livre de comptes manuscrit de 200 pages prend 16 à 26 heures à ressaisir manuellement dans Excel — et ce délai suppose que vous ne lisiez jamais mal un seul débit ou solde courant parmi les 6 000 écritures individuelles.–26 heures à ressaisir manuellement dans Excel — et ce délai suppose que vous ne lisiez jamais mal un seul débit ou solde courant parmi les 6 000 écritures individuelles.
- L'OCR basé sur des modèles échoue sur les colonnes de livres manuscrits, car les lignes du quadrillage se décalent de quelques millimètres par page, brisant silencieusement chaque hypothèse de coordonnées fixes sur laquelle le modèle était construit., brisant silencieusement chaque hypothèse de coordonnées fixes sur laquelle le modèle était construit.
- Définissez sept colonnes sémantiques une seule fois et ImageToTable.ai lit chaque page en 5 à 10 secondes en comprenant ce qu'est un débit en contexte, et non en mesurant sa position sur le papier.
Avant de commencer : ce dont vous avez besoin et à quoi vous attendre
Vous avez besoin de trois éléments. Un grand livre — celui en papier dans lequel vous écrivez. Un moyen de capturer des images — un smartphone suffit, un scanner à plat est mieux. Et un modèle de colonnes — la liste des champs que vous souhaitez extraire de chaque page, que nous définirons à l'étape 1.
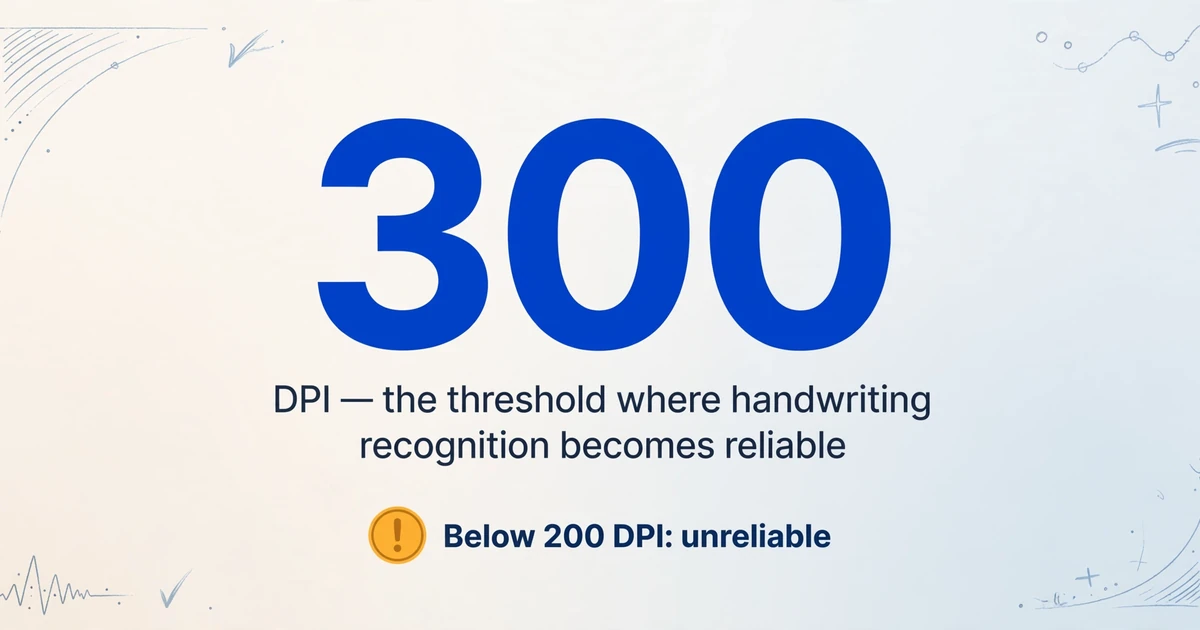
La qualité de numérisation est le facteur contrôlable le plus important pour la précision de l'extraction. Le benchmark OCR Sparkco 2025 confirme que 300 DPI est le seuil où la reconnaissance de l'écriture manuscrite passe de non fiable à fiable. Sous 200 DPI, la densité de pixels est insuffisante pour que l'IA distingue des caractères similaires — un « 3 » et un « 8 » manuscrits semblent presque identiques au modèle. Si vous utilisez un téléphone, une application de numérisation dédiée (Adobe Scan, Microsoft Lens ou similaire) qui applique une correction de perspective et un renforcement du contraste produira de meilleurs résultats que l'application appareil photo par défaut, car elle corrige la distorsion trapézoïdale et l'éclairage inégal — deux problèmes qui réduisent la précision de l'extraction de 10 à 15 points de pourcentage.
Pour les pages de grand livre non reliées (feuilles volantes), numérisez-les à plat, une à la fois. Pour les grands livres reliés, ouvrez le livre à plat et photographiez chaque double page séparément — l'IA traite chaque page indépendamment. Si la reliure est serrée et que le texte près de la reliure est déformé, envisagez de retirer soigneusement les pages de la reliure ou d'utiliser un scanner de livres capable de gérer la courbure. Le compromis : une page légèrement incurvée coûte 5 à 8 points de pourcentage de précision au niveau de la structure, car l'IA doit compenser le texte qui se courbe le long de la reliure. Si votre grand livre est assez ancien pour que le retrait des pages l'endommage, acceptez la courbure et prévoyez 1 à 2 minutes supplémentaires par page pour la correction manuelle à l'étape de vérification.
Estimation de temps : Pour un grand livre de 200 pages avec une écriture claire, des colonnes tracées à la main cohérentes et des numérisations à 300 DPI, prévoyez 20 à 30 minutes pour la capture (photographie/numérisation), 15 à 20 minutes pour le traitement IA et 30 à 45 minutes pour la révision/vérification. Total : environ 1 à 1,5 heure pour un grand livre complet — contre 16 à 26 heures de saisie manuelle. Pour la comparaison complète des coûts et du temps, voir la comparaison entre OCR et saisie manuelle des données.
Étape 1 : Définissez vos colonnes — les cinq minutes les plus importantes
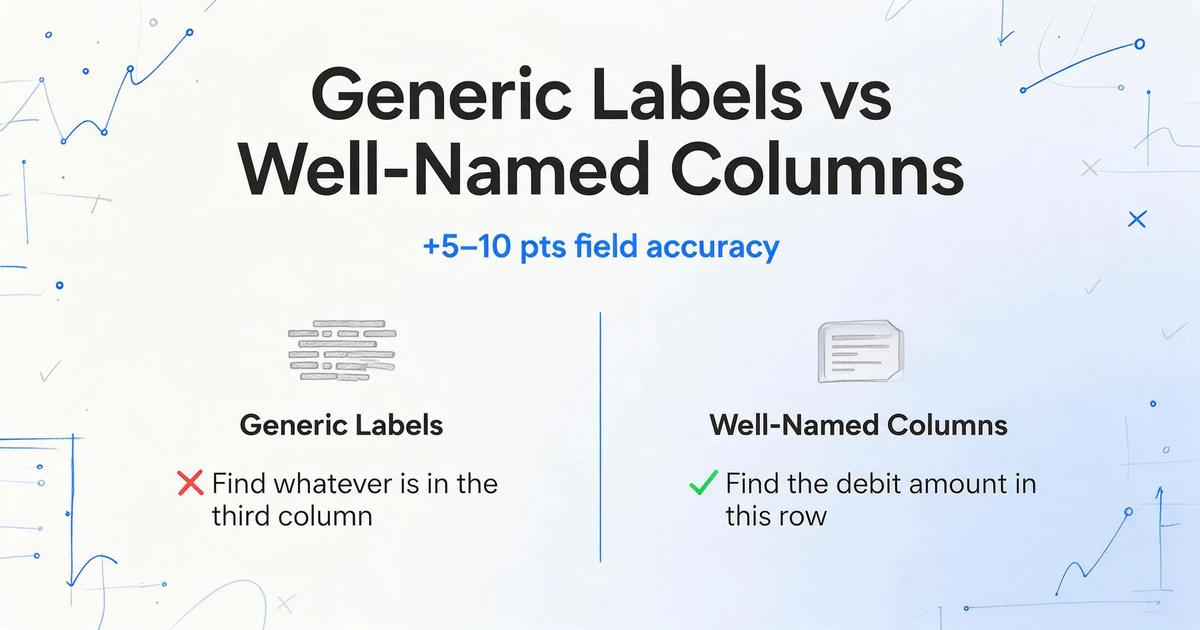
Les colonnes d'extraction que vous définissez ne sont pas de simples étiquettes. Ce sont des instructions données à l'IA sur ce qu'elle doit rechercher et comment interpréter ce qu'elle trouve. Une colonne bien nommée donne à l'IA une cible sémantique : « trouver le montant au débit dans cette ligne » au lieu de « trouver ce qui se trouve dans la troisième colonne ». La différence de précision entre un modèle de colonnes bien conçu et un modèle générique est de 5 à 10 points de pourcentage au niveau du champ — facilement les cinq minutes au meilleur rendement de tout le flux de travail.
Pour un grand livre manuscrit standard avec des colonnes tracées à la main, définissez ces sept champs :
| Nom de la colonne | Ce que l'IA recherche | Conseil de nommage |
|---|---|---|
| Date | Une chaîne de date courte, généralement au format AA/MM/JJ ou MM/JJ | Précisez le format : « Date (AAAA/MM/JJ) » pour plus de cohérence |
| Code de compte | Un code numérique ou alphanumérique, généralement de 3 à 6 chiffres | Si votre grand livre utilise des codes de compte chinois (科目编码), nommez-le « Account Code (科目编码) » |
| Nom du compte | Texte — peut être en chinois (应收账款), en anglais ou en abréviation | « Account Name » est plus clair que simplement « Account » |
| Description | Texte libre — les remarques/résumés pour chaque écriture | Gardez cette colonne simple ; les longues instructions brouillent les limites des champs |
| Montant au débit | Une valeur numérique dans la zone de la colonne débit (à gauche) | Utilisez « Debit Amount » et non « Debit » — le mot « Amount » signale une valeur numérique |
| Montant au crédit | Une valeur numérique dans la zone de la colonne crédit (à droite) | Même logique : « Credit Amount » plutôt que « Credit » |
| Solde | Le solde courant, généralement la colonne la plus à droite | « Ending Balance (running total) » si le grand livre comporte des sous-totaux |
Trois colonnes supplémentaires valent la peine d'être ajoutées lors de la définition, même si elles n'apparaissent pas sur la page du grand livre elle-même :
Balance Check — une colonne calculée. Définissez la règle sur Previous Balance + Debit Amount - Credit Amount. L'IA calcule le solde attendu pour chaque ligne lors de l'extraction et le compare au solde extrait. Toute ligne où les deux nombres ne correspondent pas est signalée. C'est l'étape de vérification la plus efficace du flux de travail, car elle détecte les erreurs qui survivent aux contrôles au niveau des caractères et des champs — une erreur de lecture d'un débit de 1 350 comme 1 530 passera les contrôles de caractères (les deux sont des nombres plausibles) mais échouera au contrôle du solde. Si vous débutez avec les colonnes calculées, sachez qu'elles vous permettent de définir des calculs exécutés lors de l'extraction, afin que votre sortie inclue à la fois les valeurs brutes extraites et l'arithmétique vérifiée — voir le guide de précision pour comprendre comment cela fonctionne sur les quatre dimensions de précision.
Catégorie de compte — une colonne déduite. Définissez la règle sur Catégorie de compte (options : Actif / Passif / Capitaux propres / Produits / Charges). L’IA lit le nom et la description du compte, puis classe l’entrée dans l’une de ces cinq catégories standard du plan comptable — même si le grand livre n’affiche jamais la colonne « Catégorie ». Cela vous donne un regroupement conforme aux PCGR pour les états financiers, sans codage manuel. Les colonnes déduites permettent à l’IA d’extraire des informations non explicitement écrites sur le document — ici, déduire qu’une écriture sur « 应收账款 » (créances clients) relève de l’Actif.
Numéro de page — une colonne d’extraction directe si vos pages de grand livre sont numérotées. Cela devient la piste d’audit : si une anomalie apparaît à la ligne 47, le numéro de page vous indique quelle page physique vérifier.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Étape 2 : Import et traitement — Gestion d’un grand livre complet
Une fois vos colonnes définies, importez toutes les images du grand livre en un seul lot. L’outil traite chaque page indépendamment — la page 3 avec son quadrillage net à la règle et la page 22 avec son écriture manuscrite sont analysées par la même logique : identifier chaque écriture comptable par ses composants structurels (date → description → débit → crédit → solde) plutôt que par des coordonnées de pixels.
Stratégie lot unique ou pages séparées. Importez l’intégralité du livre en un seul lot si le format du grand livre est cohérent — la même personne a tracé les mêmes colonnes dans le même ordre chaque mois. L’IA applique votre modèle de colonnes à chaque page du lot, et la sortie compile toutes les écritures dans un seul fichier Excel avec les lignes dans l’ordre des pages. Si le format du grand livre change en cours d’ouvrage (largeurs de colonnes différentes, écriture différente ou nouveau comptable), divisez le lot à la limite du changement de format et définissez un second modèle de colonnes pour le nouveau format. Le temps de traitement est à peu près linéaire par rapport au nombre de pages : 200 pages nécessitent environ 15 à 20 minutes de traitement IA.
Pages de qualité mixte. Un grand livre constitué sur plusieurs mois ou années présentera des variations : écritures matinales nettes page 3, écritures de fin de journée précipitées page 67, une tache de café page 112, un stylo à bille délavé page 180. L’IA n’a pas besoin d’une qualité uniforme — elle traite chaque page indépendamment — mais attendez-vous à une charge de vérification plus élevée sur les pages de moindre qualité. Traiter le tout en un seul lot puis trier la sortie par ligne permet de vérifier d’abord les pages les plus mauvaises lors de la validation.
Ce que fait l’outil pendant l’extraction : contrairement à une OCR basique qui convertit une image de texte en un paragraphe plat, l’extraction personnalisée de colonnes utilise les noms de colonnes que vous avez définis comme cibles de recherche sémantique. « Montant débit » indique à l’IA de trouver une valeur numérique dans la zone de la colonne débit de chaque ligne. « Nom du compte » lui indique de trouver du texte — potentiellement chinois, potentiellement anglais — qui fait office d’étiquette de compte du grand livre. Cette approche sémantique explique pourquoi le même modèle de colonnes fonctionne sur des pages avec des présentations visuelles différentes : l’IA lit le sens du document, pas sa disposition exacte en pixels. Le mécanisme complet est expliqué dans le guide d’extraction sans modèle.
Étape 3 : Vérifier et valider — là où se joue le vrai flux de travail
Le résultat est une feuille de calcul Excel avec une ligne par écriture du registre. Ne vous y fiez pas aveuglément. La vérification n'est pas une étape distincte qui intervient après l'extraction — elle fait partie intégrante du flux d'extraction, et les définitions de colonnes de l'étape 1 déterminent l'efficacité de cette vérification.
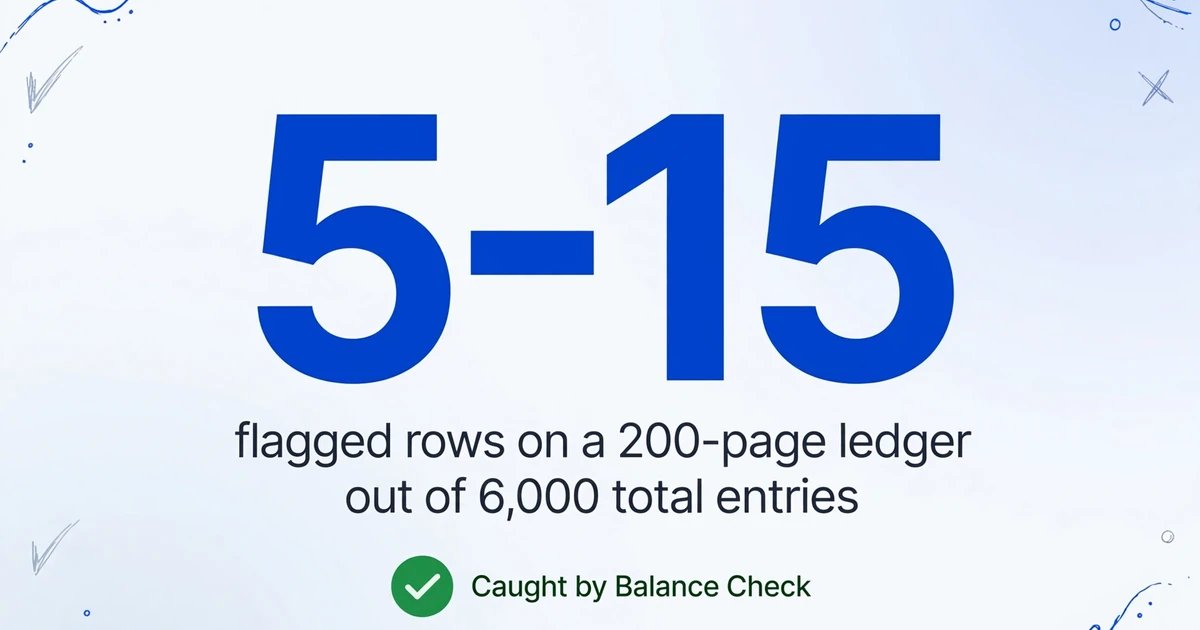
Premier passage : examinez la colonne de vérification du solde. Si vous avez défini une colonne calculée pour la vérification du solde à l'étape 1, triez le résultat par la colonne de vérification du solde. Chaque ligne où le solde calculé ne correspond pas au solde extrait est une ligne où au moins une des trois valeurs (débit, crédit ou solde) a été mal lue. Ce sont les lignes à vérifier en priorité, car elles contiennent des erreurs déjà détectées par algorithme. Sur un registre de 200 pages avec une précision de 90 % au niveau des champs, attendez-vous à 5 à 15 lignes signalées — une fraction des 6 000 entrées au total.
Deuxième passage : contrôlez par sondage un échantillon représentatif. Sélectionnez aléatoirement 10 % des pages — choisissez des pages du début (écriture fraîche), du milieu (écritures courantes) et de la fin (écritures de fatigue) de chaque mois. Pour chaque page sélectionnée, comparez les données extraites avec la page originale du registre. Comptez combien de champs nécessitent une correction par page. Si le taux de correction est de 2 à 3 champs par page de 30 lignes, la qualité d'extraction est bonne — les pages restantes présentent probablement une précision similaire. Si le taux est de 8 à 10 champs par page, retraitez ces pages avec des scans améliorés (DPI plus élevé, meilleur éclairage, renforcement du contraste) et un modèle de colonnes affiné.
Troisième passage : vérifiez les erreurs structurelles. Comptez le nombre de lignes dans le résultat extrait et comparez-le au nombre attendu. Si la page 47 contient 30 lignes manuscrites mais que l'extraction en a produit 31 ou 29, une erreur de délimitation de ligne s'est produite — l'IA a divisé une ligne en deux ou fusionné deux lignes en une. Ces erreurs structurelles sont faciles à repérer car le nombre de lignes ne correspond pas, mais elles nécessitent une correction manuelle dans la feuille de calcul. Les champs vides ou les dates dupliquées dans des lignes consécutives sont des signaux secondaires de problèmes de délimitation structurelle.
Pour mieux comprendre les types d'erreurs à prévoir et comment les classer, le guide des modes de défaillance d'extraction de documents manuscrits classe les erreurs en huit schémas prévisibles — savoir à quel schéma appartient une erreur donnée vous indique si la solution se trouve dans votre scan, dans le nommage de vos colonnes ou dans le document lui-même.
Étape 4 : Exportation et intégration — D'Excel vers votre système comptable
Téléchargez le résultat vérifié au format XLSX. Le tableur contient une ligne par écriture comptable, avec des colonnes correspondant à votre modèle de l'étape 1 : Date, Code Compte, Nom Compte, Description, Montant Débit, Montant Crédit, Solde, Vérification Solde (indicateur de vérification), Catégorie Compte (si vous avez utilisé une Colonne Déduite) et Numéro de Page.
Importez dans le logiciel comptable. La plupart des plateformes — QuickBooks, Xero, Wave, et les outils chinois comme 用友 (Yonyou) ou 金蝶 (Kingdee) — acceptent les imports CSV ou XLSX pour les écritures de journal et les transactions du grand livre. Faites correspondre vos colonnes extraites aux champs d'import du logiciel : Date → date de transaction, Code Compte → numéro de compte GL, Montant Débit et Montant Crédit → les champs de montant respectifs, Description → libellé de transaction. La colonne Catégorie Compte (si vous avez utilisé la Colonne Déduite) peut alimenter le regroupement du plan comptable.
Réutilisez le modèle chaque mois. Une fois le modèle de colonnes défini pour votre format de grand livre, sauvegardez-le. Le mois suivant, photographiez les nouvelles pages, importez-les en lot et réutilisez le même modèle. Les définitions de colonnes ne changent pas car le format du grand livre reste identique — le comptable trace la même grille, écrit dans les mêmes colonnes, mois après mois. La configuration initiale est un investissement unique ; les mois suivants se résument à : importer → traiter → vérifier → exporter.
Gestion des grands livres mixtes chinois-anglais
Si votre grand livre utilise le chinois pour les noms de comptes et les descriptions (科目名称, 摘要) mais des chiffres occidentaux pour les montants, les définitions de colonnes à l'étape 1 doivent tenir compte de ce mélange. Voici l'approche :
Nommez clairement les colonnes bilingues. « Nom Compte (科目名称) » indique à l'IA d'attendre du texte chinois dans ce champ. « Montant Débit » et « Montant Crédit » restent en anglais car l'IA s'attend déjà à des valeurs numériques. L'essentiel est de signaler le type de contenu attendu par colonne — les colonnes de texte reçoivent le libellé chinois correspondant au contenu réel du grand livre, les colonnes numériques restent dans la langue du résultat cible.
Ne scindez pas les cellules à écriture mixte. Si une cellule contient à la fois du chinois et de l'anglais (comme une description « 付款 to ABC Corp »), l'IA extrait les deux écritures dans le même champ. Les séparer en différentes colonnes lors de l'extraction n'est pas fiable car la frontière entre les écritures dans une même cellule est ambiguë. Extrayez plutôt dans un seul champ et scindez dans Excel à l'aide de la fonction Texte en colonnes ou de formules après extraction.
La vérification reste identique. La colonne calculée Vérification Solde fonctionne de la même manière quelle que soit l'écriture — l'arithmétique ne se soucie pas de la langue du nom de compte. La Colonne Déduite Catégorie Compte comprend à la fois les noms de comptes chinois (应收账款 → Actifs) et leurs équivalents anglais (Accounts Receivable → Actifs).
Collecte des pages de grand livre depuis plusieurs succursales ou services
Si vos grands livres sont tenus par différentes personnes dans différents lieux — agences, comptoirs de vente, sites terrain — vous devez collecter les pages avant de pouvoir les traiter. La fonctionnalité Lien de collecte gère cela sans que chaque succursale ait besoin d'installer un logiciel ou de créer un compte.
Générez un lien, partagez-le avec chaque responsable de succursale, et ils téléchargent les photos de leurs pages de grand livre directement via un navigateur — sans connexion requise. Les fichiers téléchargés atterrissent dans votre file d'attente de traitement, et vous lancez l'extraction par lot une fois que toutes les succursales ont soumis leurs pages. Un court code de vérification empêche les téléchargements anonymes. Cela est particulièrement utile pour les cycles de fin de mois ou de trimestre lorsque vous devez consolider les écritures de grand livre de plusieurs sites en un seul rapport financier.
FAQ
Que faire si mes pages de grand livre sont photographiées sous différents angles et conditions d'éclairage ?
L'IA gère mieux les variations que l'OCR basé sur des modèles, mais une variation extrême réduira la précision. Pour de meilleurs résultats, photographiez toutes les pages dans des conditions cohérentes : même éclairage, surface plane, angle approximativement perpendiculaire, pas de flash (le flash crée des zones surbrillantes qui effacent l'encre). Si différentes personnes ont photographié différentes pages sous différentes conditions, attendez-vous à une perte de précision supplémentaire de 5 à 10 points de pourcentage sur les pages les moins bien éclairées. Standardisez le processus de capture avec une brève instruction : « placez le grand livre à plat, désactivez le flash, tenez le téléphone directement au-dessus de la page, assurez-vous que toute la page est dans le cadre. »
Combien de pages de grand livre puis-je traiter en un seul lot ?
Jusqu'à 200–300 pages par lot est pratique. Au-delà, l'étape de vérification devient le goulot d'étranglement — même à 30 secondes de vérification par page, 500 pages représentent plus de 4 heures de vérification. Pour les grands livres plus volumineux, divisez en lots d'environ un mois d'écritures (30–60 pages) ou d'un livre physique (150–200 pages). Traiter par lots signifie également que vous pouvez détecter et corriger les problèmes de modèle de colonne tôt : si les 50 premières pages révèlent un schéma d'erreur récurrent, vous pouvez ajuster le modèle avant de traiter les 150 restantes.
L'IA peut-elle traiter du texte chinois vertical (écriture de haut en bas) ?
La plupart des registres manuscrits utilisent une écriture horizontale (de gauche à droite), même en chinois, car la structure en colonnes du registre est naturellement horizontale. Si votre registre utilise du texte chinois vertical traditionnel, la précision de reconnaissance diminue considérablement — la compréhension de la structure du tableau par l'IA est optimisée pour les dispositions de lignes horizontales. Pour les registres à texte vertical, essayez de faire pivoter l'image de la page de 90 degrés avant de la télécharger, afin que le texte apparaisse horizontal pour l'IA. Les résultats varient selon la qualité de l'écriture manuscrite.
Que deviennent les données de mon registre après traitement ? Sont-elles stockées ?
Les fichiers sont traités puis supprimés — ils ne sont ni stockés ni utilisés pour l'apprentissage. Le seul fichier conservé est le résultat Excel extrait, qui reste sur votre machine après téléchargement.
Dois-je faire quelque chose de différent pour les registres avec des en-têtes de colonnes imprimés mais des entrées manuscrites ?
Non — c'est le cas idéal. Les en-têtes de colonnes imprimés fournissent à l'IA des libellés de champs non ambigus, ce qui améliore la précision au niveau de la structure de 3 à 5 points de pourcentage par rapport à des en-têtes dessinés à la main ou absents. L'IA lit le texte d'en-tête imprimé et l'utilise pour valider ses affectations de colonnes : trouver « Date » imprimé au-dessus d'une colonne et une chaîne courte ressemblant à une date dans la zone de cette colonne confirme l'affectation. Les registres entièrement manuscrits (grille et entrées manuscrites) sont toujours traités correctement par correspondance sémantique de champs, mais l'absence d'en-têtes imprimés supprime un signal de vérification.