So konvertieren Sie handschriftliche
Hauptbücher mit KI in Excel
In einem r/Bookkeeping-Thread beschreibt ein Nutzer, wie er das handschriftliche Hauptbuchsystem eines 75-jährigen Chefs übernommen hat: Jeder Beleg, jede Transaktion, von Hand in gebundenen Büchern festgehalten – und ein Büro, das „immer noch so arbeitet wie in den 1980ern.“ Die Frage war nicht, ob digitalisiert werden soll, sondern wie. Dies ist der Workflow, um ein Regal voller handgezeichneter Hauptbücher in eine einzige abgeglichene Excel-Tabelle zu verwandeln – ohne 6.000 Zeilen neu abzutippen.
Wichtige Erkenntnisse
- Ein 200-seitiges handschriftliches Hauptbuch benötigt 16–26 Stunden manuelles Neuabtippen in Excel – und diese Zeitangabe setzt voraus, dass Sie bei 6.000 einzelnen Einträgen nie eine Soll- oder laufende Saldo-Position falsch lesen.–26 Stunden manuelles Neuabtippen in Excel – und diese Zeitangabe setzt voraus, dass Sie bei 6.000 einzelnen Einträgen nie eine Soll- oder laufende Saldo-Position falsch lesen.
- Vorlagenbasierte OCR scheitert an handgezeichneten Hauptbuchspalten, weil sich die Gitterlinien pro Seite um einige Millimeter verschieben und damit still jede feste Koordinatenannahme der Vorlage zerstören., wodurch still jede feste Koordinatenannahme der Vorlage zerstört wird.
- Definieren Sie einmal sieben semantische Spalten und ImageToTable.ai liest jede Seite in 5–10 Sekunden, indem es versteht, wie eine Soll-Position im Kontext aussieht – nicht durch Messen ihrer Position auf dem Papier.
Bevor Sie beginnen: Was Sie benötigen und was Sie erwartet
Sie benötigen drei Dinge. Ein Hauptbuch – das physische Exemplar, in das Sie bisher geschrieben haben. Eine Möglichkeit, Bilder zu erfassen – ein Smartphone ist ausreichend, ein Flachbettscanner ist besser. Und eine Spaltenvorlage – die Liste der Felder, die Sie aus jeder Seite extrahieren möchten und die wir in Schritt 1 definieren.
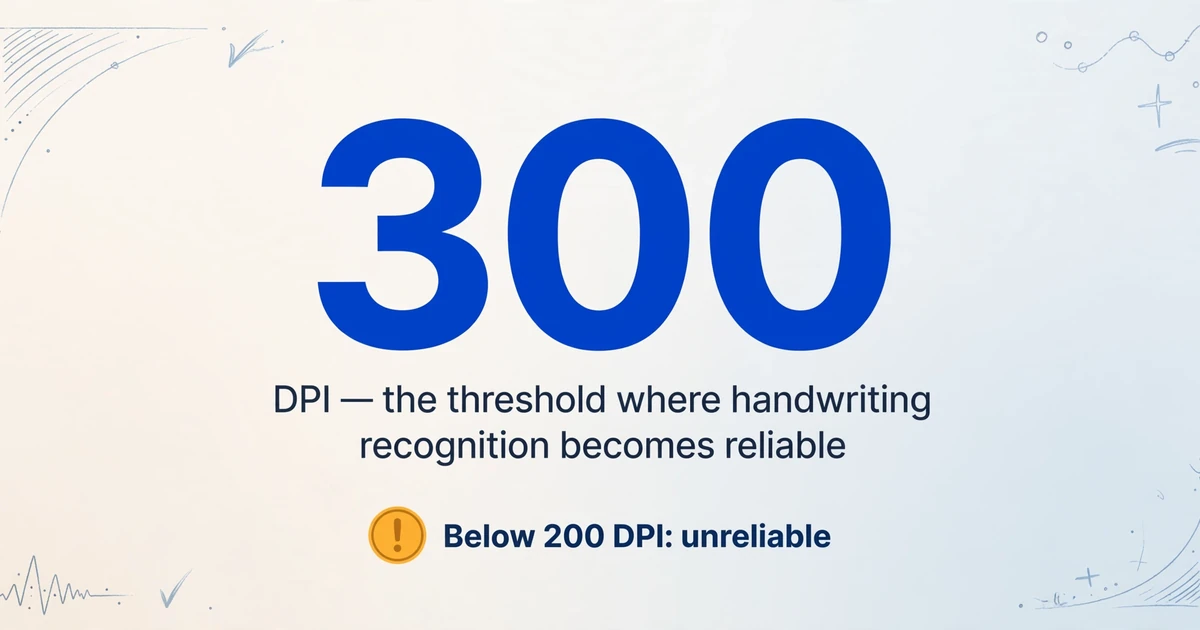
Die Scanqualität ist der größte kontrollierbare Faktor für die Extraktionsgenauigkeit. Der Sparkco-OCR-Benchmark 2025 bestätigt, dass 300 DPI die Schwelle ist, ab der Handschrifterkennung von unzuverlässig zu zuverlässig wechselt. Unter 200 DPI reicht die Pixeldichte nicht aus, damit die KI ähnliche Zeichen unterscheiden kann – eine handschriftliche „3“ und „8“ sehen für das Modell nahezu identisch aus. Wenn Sie ein Telefon verwenden, liefert eine spezielle Scan-App (Adobe Scan, Microsoft Lens oder ähnliche) mit Perspektivkorrektur und Kontrastverstärkung bessere Ergebnisse als die Standard-Kamera-App, da sie Trapezkorrektur und ungleichmäßige Beleuchtung ausgleicht – zwei Probleme, die die Extraktionsgenauigkeit um 10–15 Prozentpunkte verringern.
Scannen Sie ungebundene Hauptbuchseiten (lose Blätter) flach und einzeln. Bei gebundenen Hauptbüchern öffnen Sie das Buch flach und fotografieren Sie jede Doppelseite separat – die KI verarbeitet jede Seite unabhängig. Wenn die Bindung eng ist und Text in der Nähe des Buchrückens verzerrt ist, sollten Sie erwägen, Seiten vorsichtig aus der Bindung zu lösen oder einen Buchscanner zu verwenden, der die Krümmung verarbeiten kann. Der Kompromiss: Eine leicht gekrümmte Seite kostet 5–8 Prozentpunkte an Strukturgenauigkeit, da die KI Text kompensieren muss, der sich entlang des Buchrückens biegt. Wenn Ihr Hauptbuch so alt ist, dass das Entfernen von Seiten es beschädigen würde, akzeptieren Sie die Krümmung und planen Sie zusätzlich 1–2 Minuten pro Seite für manuelle Korrekturen im Prüfschritt ein.
Zeitaufwand: Für ein 200-seitiges Hauptbuch mit klarer Handschrift, konsistenten handgezeichneten Spalten und 300-DPI-Scans rechnen Sie mit 20–30 Minuten für die Erfassung (Fotografieren/Scannen), 15–20 Minuten für die KI-Verarbeitung und 30–45 Minuten für Prüfung/Verifizierung. Gesamt: etwa 1–1,5 Stunden für ein vollständiges Hauptbuch – verglichen mit 16–26 Stunden manueller Eingabe. Den vollständigen Kosten- und Zeitvergleich finden Sie unter dem OCR- vs. manuellen Dateneingabe-Vergleich.
Schritt 1: Definieren Sie Ihre Spalten – die wichtigsten fünf Minuten
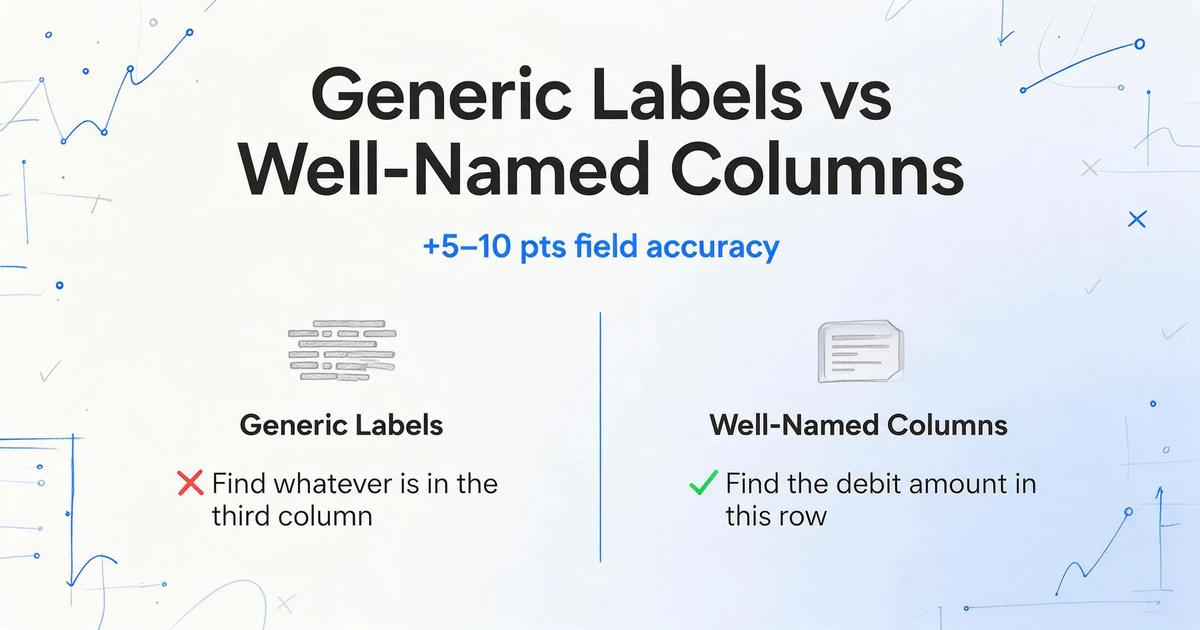
Die Extraktionsspalten, die Sie definieren, sind nicht nur Beschriftungen. Sie sind Anweisungen an die KI, wonach sie suchen und wie sie das Gefundene interpretieren soll. Eine gut benannte Spalte gibt der KI ein semantisches Ziel: „Finden Sie den Sollbetrag in dieser Zeile“ statt „Finden Sie, was in der dritten Spalte steht“. Der Genauigkeitsunterschied zwischen einer gut gestalteten Spaltenvorlage und einer generischen beträgt 5–10 Prozentpunkte auf Feldebene – das sind leicht die fünf Minuten mit der höchsten Rendite im gesamten Workflow.
Für ein standardmäßiges handschriftliches Hauptbuch mit handgezeichneten Spalten definieren Sie diese sieben Felder:
| Spaltenname | Wonach die KI sucht | Benennungstipp |
|---|---|---|
| Datum | Eine kurze Datumszeichenfolge, typischerweise JJ/MM/TT oder MM/TT-Format | Format angeben: „Datum (JJJJ/MM/TT)“ für Konsistenz |
| Kontonummer | Ein numerischer oder alphanumerischer Code, typischerweise 3–6 Ziffern | Wenn Ihr Hauptbuch chinesische 科目编码 (Kontonummern) verwendet, nennen Sie es „Kontonummer (科目编码)“ |
| Kontoname | Text – kann Chinesisch (应收账款), Englisch oder Kurzform sein | „Kontoname“ ist klarer als nur „Konto“ |
| Beschreibung | Freitext – die 摘要/Bemerkungen für jeden Eintrag | Halten Sie diese Spalte einfach; lange Prompts verwirren Feldgrenzen |
| Sollbetrag | Ein numerischer Wert im Soll-Bereich (linke Spaltenzone) | Verwenden Sie „Sollbetrag“ statt „Soll“ – das Wort „Betrag“ signalisiert numerisch |
| Habenbetrag | Ein numerischer Wert im Haben-Bereich (rechte Spaltenzone) | Gleiche Logik: „Habenbetrag“ statt „Haben“ |
| Saldo | Der laufende Saldo, typischerweise die rechteste Spalte | „Endsaldo (laufende Summe)“, wenn das Hauptbuch Zwischensummen hat |
Drei zusätzliche Spalten, die sich während der Definition lohnen, auch wenn sie nicht auf der Hauptbuchseite selbst erscheinen:
Saldenprüfung – eine berechnete Spalte. Setzen Sie die Regel auf Vorheriger Saldo + Sollbetrag - Habenbetrag. Die KI berechnet den erwarteten Saldo für jede Zeile während der Extraktion und vergleicht ihn mit dem extrahierten Saldo. Jede Zeile, in der die beiden Zahlen nicht übereinstimmen, wird markiert. Dies ist der effektivste Verifizierungsschritt im Workflow, weil er Fehler erfasst, die Zeichen- und Feldprüfungen überstehen – ein falsch gelesener Sollbetrag von 1.350 als 1.530 besteht Zeichenprüfungen (beides sind plausible Zahlen), scheitert aber an der Saldenprüfung. Wenn Sie neu bei berechneten Spalten sind: Sie ermöglichen es Ihnen, Berechnungen zu definieren, die während der Extraktion laufen, sodass Ihre Ausgabe sowohl die rohen extrahierten Werte als auch die verifizierte Arithmetik enthält – siehe den Genauigkeitsleitfaden für Details, wie dies über alle vier Genauigkeitsdimensionen funktioniert.
Kontokategorie – eine abgeleitete Spalte. Legen Sie die Regel auf Kontokategorie (Optionen: Aktiva/ Passiva/ Eigenkapital/ Erlöse/ Aufwendungen) fest. Die KI liest den Kontonamen und die Beschreibung und ordnet den Eintrag einer dieser fünf Standard-Kontenrahmen-Kategorien zu – auch wenn die Spalte „Kategorie“ im Hauptbuch selbst nie erscheint. So erhalten Sie eine GAAP-konforme Gliederung des Jahresabschlusses ohne manuelle Codierung. Abgeleitete Spalten ermöglichen der KI, Informationen abzuleiten, die nicht explizit im Dokument stehen – in diesem Fall, dass ein Eintrag zu „应收账款“ (Forderungen aus Lieferungen und Leistungen) unter Aktiva fällt.
Seitenzahl – eine Spalte zur direkten Extraktion, falls Ihre Hauptbuchseiten nummeriert sind. Dies wird zum Prüfpfad: Wenn in Zeile 47 eine Abweichung auftritt, zeigt die Seitenzahl, welche physische Seite zu prüfen ist.
Dateien werden sicher verarbeitet und nicht gespeichert.
Schritt 2: Hochladen und Verarbeiten — Umgang mit einem vollständigen Hauptbuch
Sobald Ihre Spalten definiert sind, laden Sie alle Hauptbuchseiten in einem einzigen Batch hoch. Das Tool verarbeitet jede Seite unabhängig — Seite 3 mit ihrem sauberen, mit Lineal gezeichneten Raster und Seite 22 mit ihrer freihändigen Kritzelei werden nach derselben Logik analysiert: Identifizierung jedes Buchungssatzes anhand seiner strukturellen Bestandteile (Datum → Beschreibung → Soll → Haben → Saldo) statt anhand von Pixelkoordinaten.
Batch- vs. Einzelseiten-Strategie. Laden Sie das gesamte Buch in einem Batch hoch, wenn das Hauptbuchformat einheitlich ist — dieselbe Person hat jeden Monat dieselben Spalten in derselben Reihenfolge gezeichnet. Die KI wendet Ihre Spaltenvorlage auf jede Seite im Batch an, und die Ausgabe fasst alle Einträge in einer einzigen Excel-Tabelle mit Zeilen in Seitenreihenfolge zusammen. Wenn sich das Hauptbuchformat im Laufe des Buches ändert (andere Spaltenbreiten, andere Handschrift oder ein neuer Buchhalter übernommen hat), teilen Sie den Batch an der Formatänderungsgrenze auf und definieren Sie eine zweite Spaltenvorlage für das neue Format. Die Verarbeitungszeit skaliert in etwa linear mit der Seitenzahl: 200 Seiten benötigen etwa 15–20 Minuten KI-Verarbeitungszeit.
Seiten mit gemischter Qualität. Ein über Monate oder Jahre gesammeltes Hauptbuch weist Schwankungen auf: saubere Morgeneinträge auf Seite 3, hastige Tagesabschluss-Einträge auf Seite 67, ein Kaffeefleck auf Seite 112, verblasster Kugelschreiber auf Seite 180. Die KI benötigt keine gleichmäßige Qualität — sie verarbeitet jede Seite unabhängig —, aber Sie sollten damit rechnen, dass der Prüfaufwand bei den Seiten geringerer Qualität höher ist. Wenn Sie alles in einem Batch verarbeiten und die Ausgabe dann nach Zeilen sortieren, können Sie bei der Prüfung zuerst die schlechtesten Seiten stichprobenartig kontrollieren.
Was das Tool während der Extraktion tut: Im Gegensatz zu einfacher OCR, die ein Textbild in einen flachen Absatz umwandelt, verwendet die benutzerdefinierte Spaltenextraktion die von Ihnen definierten Spaltennamen als semantische Suchziele. „Sollbetrag“ weist die KI an, einen numerischen Wert in der Sollspaltenzone jeder Zeile zu finden. „Kontoname“ weist sie an, Text zu finden — potenziell Chinesisch, potenziell Englisch — der als Hauptbuchkontobezeichnung fungiert. Dieser semantische Ansatz ist der Grund, warum dieselbe Spaltenvorlage über Seiten mit unterschiedlichen visuellen Layouts hinweg funktioniert: Die KI liest die Bedeutung des Dokuments, nicht sein exaktes Pixellayout. Der vollständige Mechanismus wird in der Anleitung zur vorlagenfreien Extraktion erläutert.
Schritt 3: Prüfen und Verifizieren — hier findet die eigentliche Arbeit statt
Das Ergebnis ist eine Excel-Tabelle mit einer Zeile pro Hauptbucheintrag. Verlassen Sie sich nicht blind darauf. Die Verifizierung ist kein separater Schritt nach der Extraktion — sie ist Teil des Extraktions-Workflows, und die Spaltendefinitionen aus Schritt 1 bestimmen, wie effizient diese Verifizierung ist.
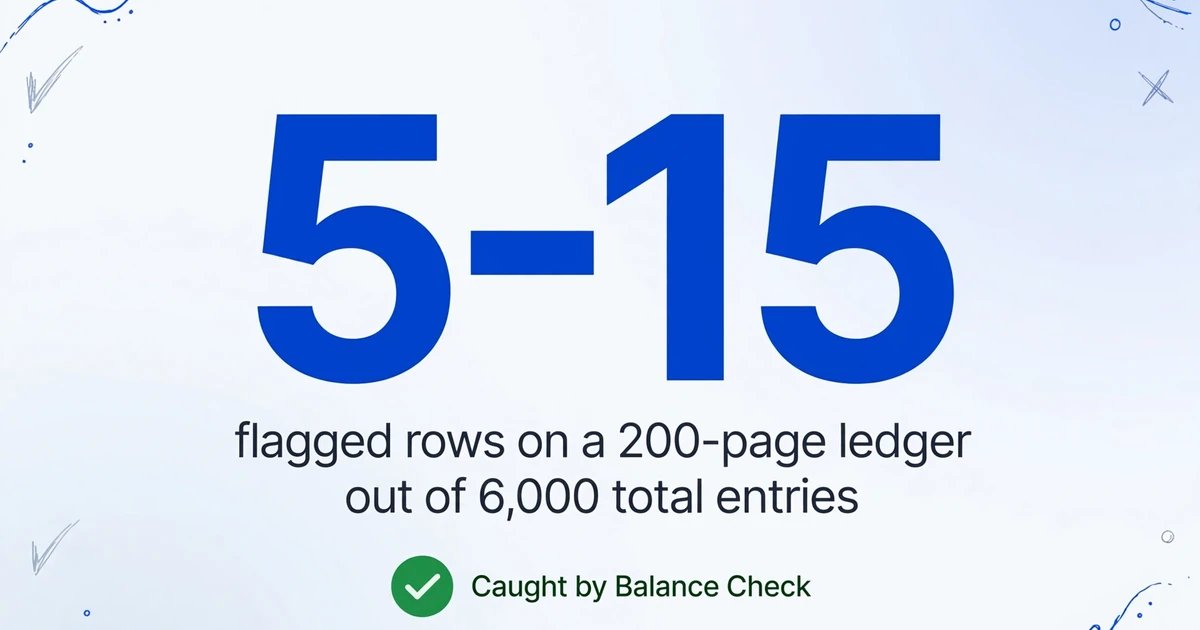
Erster Durchgang: Die Saldenprüf-Spalte durchsehen. Wenn Sie in Schritt 1 eine berechnete Spalte für die Saldenprüfung definiert haben, sortieren Sie die Ausgabe nach der Saldenprüf-Spalte. Jede Zeile, in der der berechnete Saldo nicht dem extrahierten Saldo entspricht, ist eine Zeile, in der mindestens einer von drei Werten (Soll, Haben oder Saldo) falsch gelesen wurde. Dies sind die Zeilen mit höchster Priorität für die Prüfung, da sie Fehler enthalten, die bereits algorithmisch erkannt wurden. Bei einem 200-seitigen Hauptbuch mit 90 % Feldgenauigkeit sind 5–15 markierte Zeilen zu erwarten — ein Bruchteil der insgesamt 6.000.
Zweiter Durchgang: Stichprobenartige Prüfung einer repräsentativen Auswahl. Wählen Sie zufällig 10 % der Seiten aus — wählen Sie Seiten vom Anfang (frische Handschrift), aus der Mitte (Routineeinträge) und vom Ende (Ermüdungseinträge) jedes Monats. Vergleichen Sie für jede ausgewählte Seite die extrahierten Daten mit der Original-Hauptbuchseite. Zählen Sie, wie viele Felder pro Seite korrigiert werden müssen. Liegt die Korrekturrate bei 2–3 Feldern pro 30-Zeilen-Seite, ist die Extraktionsqualität gut — die übrigen Seiten haben wahrscheinlich eine ähnliche Genauigkeit. Liegt die Rate bei 8–10 Feldern pro Seite, verarbeiten Sie diese Seiten mit verbesserten Scans (höhere DPI, bessere Beleuchtung, Kontrastverstärkung) und einer verfeinerten Spaltenvorlage neu.
Dritter Durchgang: Prüfung auf strukturelle Fehler. Zählen Sie die Anzahl der Zeilen in der extrahierten Ausgabe und vergleichen Sie sie mit der erwarteten Anzahl. Wenn Seite 47 30 handschriftliche Zeilen hat, die Extraktion aber 31 oder 29 ergibt, ist ein Zeilengrenzenfehler aufgetreten — die KI hat eine Zeile in zwei geteilt oder zwei Zeilen zu einer zusammengeführt. Diese strukturellen Fehler sind leicht zu erkennen, weil die Zeilenanzahl nicht übereinstimmt, erfordern aber eine manuelle Korrektur in der Tabelle. Leere Felder oder doppelte Daten in aufeinanderfolgenden Zeilen sind sekundäre Anzeichen für strukturelle Grenzprobleme.
Für ein tieferes Verständnis darüber, welche Fehlertypen zu erwarten sind und wie man sie klassifiziert, finden Sie im Leitfaden zu Fehlermodi bei der Extraktion handschriftlicher Dokumente eine Kategorisierung der Fehler in acht vorhersehbare Muster — wenn Sie wissen, zu welchem Muster ein bestimmter Fehler gehört, wissen Sie, ob die Lösung in Ihrem Scan, Ihrer Spaltenbenennung oder dem Dokument selbst liegt.
Schritt 4: Export und Integration — Von Excel in Ihre Buchhaltungssoftware
Laden Sie die geprüfte Ausgabe als XLSX herunter. Die Tabelle enthält eine Zeile pro Buchungssatz, mit Spalten, die Ihrer Vorlage aus Schritt 1 entsprechen: Datum, Kontonummer, Kontoname, Beschreibung, Sollbetrag, Habenbetrag, Saldo, Saldenprüfung (Prüfmarkierung), Kontokategorie (falls Sie eine abgeleitete Spalte verwendet haben) und Seitenzahl.
Import in die Buchhaltungssoftware. Die meisten Buchhaltungsplattformen — QuickBooks, Xero, Wave und chinesische Tools wie 用友 (Yonyou) oder 金蝶 (Kingdee) — akzeptieren CSV- oder XLSX-Importe für Buchungssätze und Hauptbuchtransaktionen. Ordnen Sie Ihre extrahierten Spalten den Importfeldern der Software zu: Datum → Buchungsdatum, Kontonummer → Sachkontonummer, Sollbetrag und Habenbetrag → die jeweiligen Betragsfelder, Beschreibung → Buchungstext. Die Spalte Kontokategorie (falls Sie die abgeleitete Spalte verwendet haben) kann die Kontenrahmen-Gruppierung befüllen.
Vorlage jeden Monat wiederverwenden. Sobald Sie die Spaltenvorlage für Ihr Buchungsformat definiert haben, speichern Sie sie. Im nächsten Monat fotografieren Sie die neuen Seiten, laden sie als Stapel hoch und verwenden dieselbe Vorlage. Die Spaltendefinitionen ändern sich nicht, da sich das Buchungsformat nicht ändert — der Buchhalter zeichnet dasselbe Raster, schreibt in dieselben Spalten, Monat für Monat. Der Einrichtungsaufwand ist eine einmalige Investition; die Folgemonate sind: Hochladen → Verarbeiten → Prüfen → Exportieren.
Umgang mit gemischt chinesisch-englischen Buchungen
Wenn Ihr Buchungsformat für Kontonamen und Beschreibungen (科目名称, 摘要) Chinesisch, aber westliche Ziffern für Beträge verwendet, müssen die Spaltendefinitionen in Schritt 1 die gemischte Schrift berücksichtigen. So gehen Sie vor:
Benennen Sie zweisprachige Spalten klar. „Kontoname (科目名称)" teilt der KI mit, dass in diesem Feld chinesischer Text zu erwarten ist. „Sollbetrag" und „Habenbetrag" bleiben auf Englisch, da die KI bereits numerische Werte erwartet. Entscheidend ist die Angabe des erwarteten Inhaltstyps pro Spalte — Textspalten erhalten die chinesische Bezeichnung, die dem tatsächlichen Inhalt der Buchung entspricht, numerische Spalten bleiben in der Sprache der Zielausgabe.
Zellen mit gemischter Schrift nicht aufteilen. Enthält eine einzelne Zelle sowohl Chinesisch als auch Englisch (z. B. eine Beschreibung wie „付款 an ABC Corp"), extrahiert die KI beide Schriften in dasselbe Feld. Eine Trennung in verschiedene Spalten während der Extraktion ist unzuverlässig, da die Schriftgrenze innerhalb einer Zelle mehrdeutig ist. Extrahieren Sie stattdessen in ein Feld und teilen Sie es nach der Extraktion in Excel mit „Text in Spalten" oder Formeln auf.
Die Prüfung bleibt gleich. Die berechnete Spalte Saldenprüfung funktioniert unabhängig von der Schrift identisch — Arithmetik kümmert sich nicht um die Sprache des Kontonamens. Die abgeleitete Spalte Kontokategorie versteht sowohl chinesische Kontonamen (应收账款 → Assets) als auch englische Entsprechungen (Accounts Receivable → Assets).
Sammeln von Hauptbuchseiten aus mehreren Filialen oder Abteilungen
Wenn Ihre Hauptbücher von verschiedenen Personen an unterschiedlichen Standorten geführt werden – Filialen, Ladentheken, Außendienststellen – müssen Sie die Seiten vor der Verarbeitung einsammeln. Die Funktion „Sammellink“ erledigt dies, ohne dass jede Filiale Software installieren oder Konten anlegen muss.
Erstellen Sie einen Link, teilen Sie ihn mit jedem Filialleiter, und dieser lädt Fotos seiner Hauptbuchseiten direkt über einen Browser hoch – ohne Anmeldung. Die hochgeladenen Dateien landen in Ihrer Verarbeitungswarteschlange, und Sie führen die Stapelverarbeitung durch, sobald alle Filialen ihre Seiten eingereicht haben. Ein kurzer Verifizierungscode verhindert anonyme Uploads. Dies ist besonders nützlich für Monats- oder Quartalsabschlüsse, wenn Sie Hauptbucheinträge mehrerer Standorte in einem einzigen Finanzbericht zusammenführen müssen.
FAQ
Was ist, wenn meine Hauptbuchseiten aus verschiedenen Winkeln und unter unterschiedlichen Lichtverhältnissen fotografiert werden?
Die KI kommt mit Abweichungen besser zurecht als vorlagenbasierte OCR, aber extreme Abweichungen verringern die Genauigkeit. Für beste Ergebnisse fotografieren Sie alle Seiten unter gleichbleibenden Bedingungen: gleiche Beleuchtung, flache Unterlage, etwa senkrechter Winkel, kein Blitz (Blitz erzeugt Überstrahlungen, die Tinte auswaschen). Wenn verschiedene Personen Seiten unter unterschiedlichen Bedingungen fotografiert haben, ist bei den am schlechtesten ausgeleuchteten Seiten mit einem zusätzlichen Genauigkeitsverlust von 5–10 Prozentpunkten zu rechnen. Standardisieren Sie den Aufnahmeprozess mit einer kurzen Anweisung: „Legen Sie das Hauptbuch flach hin, schalten Sie den Blitz aus, halten Sie das Telefon direkt über die Seite, stellen Sie sicher, dass die gesamte Seite im Bild ist.“
Wie viele Hauptbuchseiten kann ich in einem Durchgang verarbeiten?
Bis zu 200–300 Seiten pro Stapel sind praktikabel. Darüber hinaus wird der Prüfschritt zum Engpass – selbst bei 30 Sekunden Prüfzeit pro Seite sind 500 Seiten über 4 Stunden Prüfzeit. Bei größeren Hauptbüchern teilen Sie die Seiten in Stapel von etwa einem Monat (30–60 Seiten) oder einem physischen Buch (150–200 Seiten) auf. Die Verarbeitung in Stapeln hat auch den Vorteil, dass Sie Probleme mit Spaltenvorlagen frühzeitig erkennen und beheben können: Wenn die ersten 50 Seiten ein wiederkehrendes Fehlermuster zeigen, können Sie die Vorlage anpassen, bevor Sie die restlichen 150 Seiten verarbeiten.
Kann die KI vertikale chinesische Schrift (von oben nach unten) verarbeiten?
Die meisten handschriftlichen Tabellen verwenden auch auf Chinesisch horizontale Schrift (von links nach rechts), da die Spaltenstruktur der Tabelle von Natur aus horizontal ist. Wenn Ihre Tabelle traditionelle vertikale chinesische Schrift verwendet, sinkt die Erkennungsgenauigkeit erheblich – die Tabellenstrukturanalyse der KI ist für horizontale Zeilenlayouts optimiert. Bei vertikalen Schrift-Tabellen versuchen Sie, das Seitenbild vor dem Hochladen um 90 Grad zu drehen, damit der Text für die KI horizontal erscheint. Die Ergebnisse variieren je nach Handschriftqualität.
Was passiert mit meinen Tabellendaten nach der Verarbeitung? Werden sie gespeichert?
Dateien werden verarbeitet und dann gelöscht – sie werden weder gespeichert noch für das Training verwendet. Die extrahierte Excel-Ausgabe ist die einzige aufbewahrte Daten und verbleibt nach dem Herunterladen auf Ihrem Rechner.
Muss ich bei Tabellen mit gedruckten Spaltenüberschriften, aber handschriftlichen Einträgen etwas beachten?
Nein – dies ist der Idealfall. Gedruckte Spaltenüberschriften geben der KI eindeutige Feldbezeichnungen, was die Strukturgenauigkeit um 3–5 Prozentpunkte im Vergleich zu handgezeichneten oder fehlenden Überschriften verbessert. Die KI liest den gedruckten Überschriftentext und validiert damit ihre Spaltenzuordnungen: Wenn "Datum" über einer Spalte gedruckt ist und sich in dieser Spaltenzone eine kurze datumsähnliche Zeichenfolge befindet, bestätigt dies die Zuordnung. Reine Handschrift-Tabellen (sowohl das Raster als auch die Einträge sind handschriftlich) werden weiterhin durch semantischen Feldabgleich korrekt verarbeitet, aber das Fehlen gedruckter Überschriften entfernt ein Verifikationssignal.