手書きの
帳簿をAIでExcelに変換する方法
r/Bookkeepingのスレッドで、あるユーザーが75歳の上司から引き継いだ手書きの帳簿システムについて語っていました。すべての伝票、すべての取引が、綴じられた帳簿に手書きで記録され、オフィスは「まるで1980年代のまま」だというのです。問題はデジタル化するかどうかではなく、どうやって行うかでした。ここで紹介するのは、棚に並んだ手書きの帳簿を、6,000行を打ち直すことなく、1つの照合済みExcelスプレッドシートに変換するワークフローです。
重要なポイント
- 200ページの手書き帳簿をExcelに手入力で打ち直すには16〜26時間かかります。しかも、その時間は6,000件の取引で借方や残高を一度も読み間違えないという前提での話です。
- テンプレートベースのOCRは、手書きの帳簿の列では機能しません。なぜなら、罫線がページごとに数ミリずれるため、テンプレートが前提とする固定座標がすべて静かに崩れてしまうからです。
- 7つの意味論的な列を一度定義すれば、ImageToTable.aiは紙の上の位置を測定するのではなく、文脈から借方の見た目を理解することで、各ページを5〜10秒で読み取ります。
始める前に:必要なものと期待できること
必要なものは3つです。帳簿 — 実際に書き込んできた紙の帳簿。画像を撮影する手段 — スマートフォンで十分ですが、フラットベッドスキャナーの方がより適しています。そして列テンプレート — 各ページから抽出したいフィールドのリストで、ステップ1で定義します。
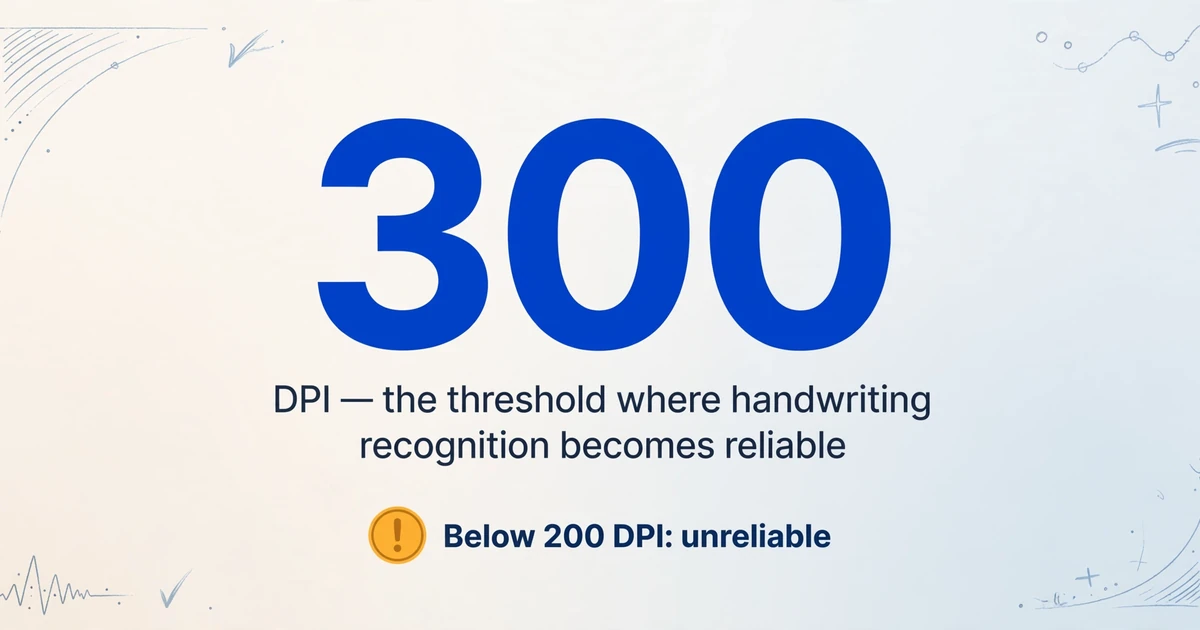
スキャン品質は、抽出精度に影響する中で最も大きく制御可能な要素です。Sparkco 2025 OCRベンチマークによると、300 DPIが手書き認識が信頼できない状態から信頼できる状態に変わる閾値であることが確認されています。200 DPI未満では、画素密度が不足しており、AIが類似した文字を区別できません — 手書きの「3」と「8」はモデルにとってほぼ同一に見えます。スマートフォンを使用する場合、遠近補正とコントラスト強調を適用する専用のスキャンアプリ(Adobe Scan、Microsoft Lensなど)を使用すると、デフォルトのカメラアプリよりも良い結果が得られます。台形歪みと不均一な照明という、抽出精度を10〜15パーセントポイント低下させる2つの問題を補正するためです。
綴じられていない帳簿ページ(バラ紙)の場合は、1枚ずつ平らにスキャンしてください。綴じられた帳簿の場合は、本を平らに開き、各見開き2ページを個別に撮影してください — AIは各ページを独立して処理します。綴じがきつく、背表紙付近の文字が歪んでいる場合は、ページを綴じから慎重に取り外すか、湾曲に対応できるブックスキャナーの使用を検討してください。トレードオフは次のとおりです:わずかに湾曲したページは、構造レベルの精度を5〜8パーセントポイント低下させます。AIが背表紙に沿って曲がる文字を補正する必要があるためです。帳簿が古く、ページの取り外しが破損につながる場合は、湾曲を受け入れ、検証ステップで手動修正にページあたり1〜2分の追加時間を確保してください。
所要時間の目安: 200ページの帳簿で、手書きが明瞭で、手書きの列が一貫しており、300 DPIでスキャンした場合、撮影(写真撮影/スキャン)に20〜30分、AI処理に15〜20分、確認・検証に30〜45分かかると想定してください。合計:帳簿1冊全体でおよそ1〜1.5時間 — 手動入力の16〜26時間と比較して大幅に短縮されます。コストと時間の完全な比較については、OCRと手動データ入力の比較をご覧ください。
ステップ1: 列を定義する — 最も重要な5分間
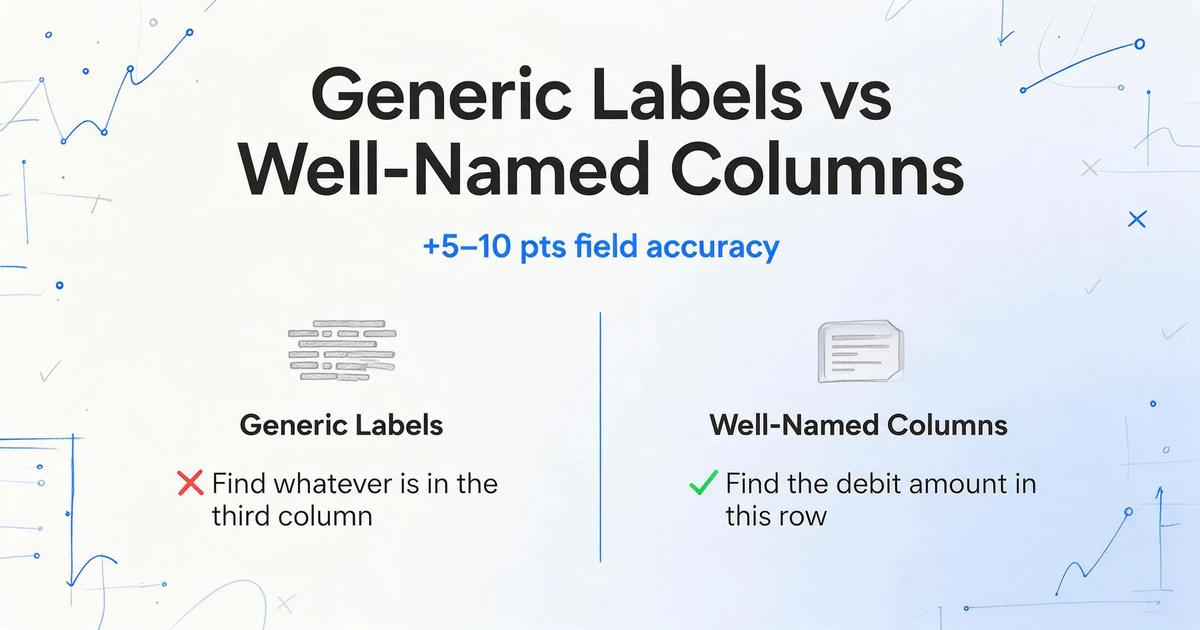
定義する抽出列は単なるラベルではありません。AIにとって、何を探し、見つけたものをどう解釈するかという指示です。適切に命名された列はAIに意味的なターゲットを与えます。「この行の借方金額を探す」という指示は「3番目の列にあるものを探す」という指示とは異なります。適切に設計された列テンプレートと一般的なテンプレートの精度の差は、フィールドレベルで5〜10ポイントです。これはワークフロー全体の中で最も効果の高い5分間です。
手書きの罫線が引かれた標準的な手書き元帳の場合、次の7つのフィールドを定義します。
| 列名 | AIが探すもの | 命名のヒント |
|---|---|---|
| 日付 | 短い日付文字列。通常はYY/MM/DDまたはMM/DD形式 | 一貫性のため形式を指定:「日付(YYYY/MM/DD)」 |
| 勘定科目コード | 数値または英数字コード。通常は3〜6桁 | 元帳が中国語の科目编码(勘定科目コード)を使用している場合は、「勘定科目コード(科目编码)」と名付けます |
| 勘定科目名 | テキスト — 中国語(应收账款)、英語、または略称の場合があります | 「勘定科目名」は単なる「勘定科目」よりも明確です |
| 摘要 | フリーテキスト — 各エントリの摘要/備考 | この列はシンプルに保ちます。長いプロンプトはフィールド境界を曖昧にします |
| 借方金額 | 借方(左)列ゾーン内の数値 | 「借方」ではなく「借方金額」を使用します。「金額」という言葉が数値を示します |
| 貸方金額 | 貸方(右)列ゾーン内の数値 | 同じ論理:「貸方」ではなく「貸方金額」 |
| 残高 | 累計残高。通常は一番右の列 | 元帳に小計がある場合は「期末残高(累計)」 |
元帳ページ自体には表示されなくても、定義中に追加する価値のある列がさらに3つあります。
残高チェック — 計算列。ルールを前回残高 + 借方金額 - 貸方金額に設定します。AIは抽出中に各行の期待残高を計算し、抽出された残高と比較します。2つの数値が一致しない行はフラグが立てられます。これはワークフロー全体で最も効果的な検証ステップです。文字レベルおよびフィールドレベルのチェックをすり抜けるエラーを検出できるためです。1,350の借方の誤読が1,530になった場合、文字チェックは通過します(どちらも妥当な数値)が、残高チェックは失敗します。計算列に慣れていない場合、抽出中に実行される計算を定義できるため、出力には生の抽出値と検証済みの算術結果の両方が含まれます。これが4つの精度ディメンションすべてでどのように機能するかについては、精度ガイドを参照してください。
勘定科目区分 — 推論列です。勘定科目区分(選択肢:資産/負債/純資産/収益/費用)にルールを設定します。AIが勘定科目名と説明を読み取り、元帳に「区分」列がなくても、5つの標準的な勘定科目区分のいずれかに自動分類します。これにより、手作業でのコード化なしでGAAP準拠の財務諸表グループ化が可能になります。推論列を使うと、AIが文書に明示されていない情報を導き出せます。例えば、「应收账款」(売掛金)の仕訳を資産に分類するといった具合です。
ページ番号 — 元帳のページに番号が振られている場合の直接抽出列です。監査証跡として機能し、47行目に不一致が見つかった場合、どの物理ページを確認すべきかがわかります。
ファイルは安全に処理され、保存されません。
ステップ2:アップロードと処理 — 元帳全体の取り扱い
列を定義したら、元帳ページの画像を一度にすべてアップロードします。このツールは各ページを独立して処理します。3ページ目の定規で引かれた整然としたグリッドも、22ページ目の手書きの走り書きも、同じロジックで解析されます。つまり、ピクセル座標ではなく、構造的な構成要素(日付→摘要→借方→貸方→残高)によって各仕訳を識別します。
一括処理と単一ページ戦略。 元帳の形式が一貫している場合(同じ人物が毎月同じ順序で同じ列を記入している場合)は、全ページを一度にアップロードします。AIはバッチ内のすべてのページに列テンプレートを適用し、出力はページ順に並んだすべてのエントリを1つのExcelスプレッドシートにまとめます。元帳の形式が途中で変わる場合(列幅の変更、筆跡の変更、新しい帳簿係の引き継ぎなど)は、形式変更の境界でバッチを分割し、新しい形式用に2つ目の列テンプレートを定義します。処理時間はページ数にほぼ比例します。200ページの場合、AI処理に約15~20分かかります。
品質が混在するページ。 数ヶ月または数年かけて収集された元帳にはばらつきがあります。3ページ目の鮮明な朝の記入、67ページ目の慌ただしい終業時の記入、112ページ目のコーヒーの染み、180ページ目の薄れたボールペン。AIは均一な品質を必要としません。各ページを独立して処理しますが、品質の低いページほど検証の負担が大きくなると予想してください。すべてを1つのバッチで処理し、出力を行順に並べ替えると、検証時に最も状態の悪いページを最初にスポットチェックできます。
抽出中にツールが行っていること:基本的なOCRが画像のテキストをフラットな段落に変換するのとは異なり、カスタム列抽出は、定義した列名を意味検索のターゲットとして使用します。「借方金額」は、各行の借方列ゾーンにある数値を見つけるようAIに指示します。「勘定科目名」は、元帳の勘定科目ラベルとして機能するテキスト(中国語の場合も英語の場合もあります)を見つけるよう指示します。この意味論的なアプローチにより、同じ列テンプレートが異なる視覚的レイアウトのページでも機能します。AIはドキュメントの正確なピクセルレイアウトではなく、その意味を読み取るからです。完全なメカニズムについては、テンプレート不要の抽出ガイドで説明しています。
ステップ3:確認と検証 — 実際のワークフローの中心
出力は、元帳の各エントリが1行に対応するExcelスプレッドシートです。盲目的に信頼しないでください。検証は抽出後の別のステップではなく、抽出ワークフローの一部であり、ステップ1で定義した列定義がこの検証の効率を左右します。
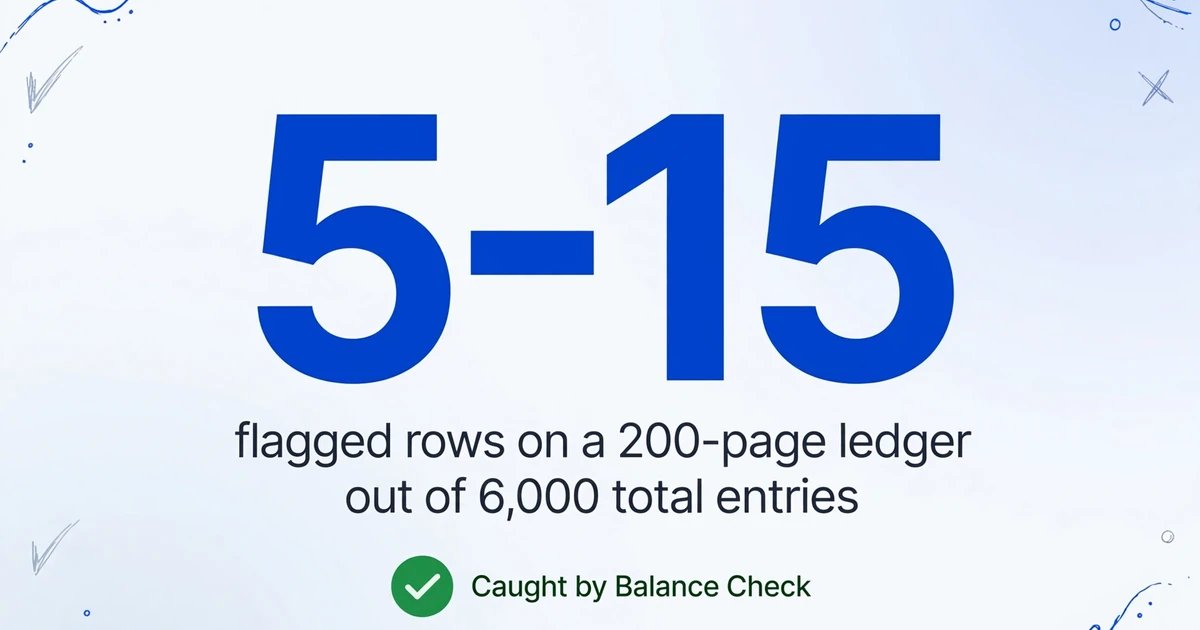
最初のパス:残高チェック列をスキャンします。ステップ1で残高検証用の計算列を定義した場合は、出力を残高チェック列で並べ替えます。計算された残高が抽出された残高と一致しない行はすべて、借方・貸方・残高の3つの値のうち少なくとも1つが誤って読み取られた行です。これらはアルゴリズムによってすでに検出されたエラーを含むため、最優先で検証すべき行です。200ページの元帳でフィールド精度90%の場合、フラグが付けられる行は5〜15件と予想され、6,000件の総数のごく一部です。
2番目のパス:代表的なサンプルをスポットチェックします。ページの10%をランダムに選択します — 各月の最初(新しい筆跡)、中間(日常的なエントリ)、最後(疲労時のエントリ)からページを選びます。選択した各ページについて、抽出されたデータを元の元帳ページと比較します。ページごとに修正が必要なフィールド数を数えます。修正率が30行のページあたり2〜3フィールドであれば、抽出品質は良好です — 残りのページも同様の精度である可能性が高いです。率がページあたり8〜10フィールドの場合は、改善されたスキャン(高DPI、良好な照明、コントラスト強調)と改良された列テンプレートを使用して、それらのページを再処理します。
3番目のパス:構造エラーをチェックします。抽出された出力の行数を数え、期待される数と比較します。47ページに手書きの行が30行あるのに、抽出結果が31行または29行だった場合、行境界エラーが発生しています — AIが1行を2つに分割したか、2行を1つに結合したことになります。これらの構造エラーは行数が一致しないため簡単に気づきますが、スプレッドシートでの手動修正が必要です。連続する行の空フィールドや重複した日付は、構造的な境界問題の二次的なシグナルです。
予想されるエラーの種類とその分類方法についてより深く理解するには、手書き文書抽出の失敗モードガイドがエラーを8つの予測可能なパターンに分類しています — 特定のエラーがどのパターンに属するかを知ることで、修正がスキャン、列名、またはドキュメント自体のいずれにあるかがわかります。
ステップ4:エクスポートと連携 — Excelから会計システムへ
検証済みの出力をXLSXとしてダウンロードします。スプレッドシートには、ステップ1のテンプレートに対応する列(日付、勘定科目コード、勘定科目名、摘要、借方金額、貸方金額、残高、残高チェック(検証フラグ)、勘定科目区分(推測列を使用した場合)、ページ番号)が含まれ、1行が1つの仕訳に対応します。
会計ソフトにインポートします。 QuickBooks、Xero、Wave、および用友や金蝶などの中国市場向けツールを含むほとんどの会計プラットフォームは、仕訳や総勘定元帳トランザクションのCSVまたはXLSXインポートに対応しています。抽出した列をソフトウェアのインポートフィールドにマッピングします。日付→取引日、勘定科目コード→GL勘定番号、借方金額と貸方金額→それぞれの金額フィールド、摘要→取引メモ。勘定科目区分の列(推測列を使用した場合)は、勘定科目表のグループ化に使用できます。
毎月テンプレートを再利用します。元帳フォーマットの列テンプレートを定義したら、それを保存します。翌月は新しいページを撮影し、バッチでアップロードして、同じテンプレートを再利用します。元帳のフォーマットが変わらない限り、列定義は変わりません。経理担当者は毎月同じグリッドを描き、同じ列に記入します。初期設定は一度きりの投資であり、以降の月はアップロード→処理→確認→エクスポートの流れになります。
中国語・英語混在の元帳の扱い方
元帳で勘定科目名や摘要に中国語(科目名称、摘要)を使用し、金額に欧米の数字を使用している場合、ステップ1の列定義で混在表記を考慮する必要があります。以下がその方法です。
バイリンガル列には明確に名前を付けます。「Account Name (科目名称)」とすることで、AIにそのフィールドが中国語テキストであることを伝えます。「Debit Amount」と「Credit Amount」は英語のままにします。AIはすでに数値を期待しているからです。重要なのは、列ごとに期待されるコンテンツタイプを明示することです。テキスト列には元帳の実際の内容に合った中国語ラベルを付け、数値列はターゲット出力の言語のままにします。
混在表記のセルは分割しません。「付款 to ABC Corp」のような摘要など、1つのセルに中国語と英語の両方が含まれている場合、AIは両方の表記を同じフィールドに抽出します。抽出段階で異なる列に分離するのは、セル内の表記の境界が不明瞭なため信頼性が低くなります。代わりに、1つのフィールドに抽出し、抽出後にExcelのテキストを列に分割する機能や数式を使用して分割します。
検証は同じです。残高チェックの計算列は、表記に関係なく同じように機能します。算術は勘定科目名の言語を気にしません。勘定科目区分の推測列は、中国語の勘定科目名(应收账款→資産)と英語の同等のもの(Accounts Receivable→資産)の両方を理解します。
複数拠点・部門からの台帳ページ収集
台帳が支店、売り場、現場など異なる場所で別々の担当者によって管理されている場合、処理前にページを収集する必要があります。収集リンク機能を使えば、各拠点にソフトウェアのインストールやアカウント作成を求めることなく対応できます。
リンクを生成して各拠点の責任者に共有するだけで、担当者はブラウザから直接、ログイン不要で台帳ページの写真をアップロードできます。アップロードされたファイルは処理キューに追加され、全拠点からページが揃った時点で一括抽出を実行します。短い確認コードにより匿名アップロードを防止します。これは、複数拠点の台帳エントリを1つの財務レポートに統合する必要がある月末や四半期末のサイクルで特に有用です。
よくある質問
台帳ページが異なる角度や照明条件で撮影されている場合はどうなりますか?
AIはテンプレートベースのOCRよりもバリエーションに対応できますが、極端な差異は精度を低下させます。最良の結果を得るには、すべてのページを同じ条件(同じ照明、平らな面、ほぼ垂直の角度、フラッシュなし(フラッシュはハイライトを生みインクを飛ばします))で撮影してください。異なる人物が異なる条件下で撮影した場合、最も照明の悪いページではさらに5~10%の精度低下が予想されます。「台帳を平らに置き、フラッシュをオフにし、ページ全体がフレームに収まるようにスマートフォンを真上から構えてください」という簡単な指示で撮影プロセスを標準化してください。
1回のバッチで処理できる台帳ページ数は?
1バッチあたり200~300ページが実用的です。それを超えると、確認作業がボトルネックになります。1ページあたり30秒の確認でも、500ページでは4時間以上の確認時間になります。より大きな台帳の場合は、約1ヶ月分(30~60ページ)または1冊分(150~200ページ)のバッチに分割してください。バッチ処理により、列テンプレートの問題を早期に発見・修正できる利点もあります。最初の50ページで繰り返し発生するエラーパターンが見つかれば、残りの150ページを処理する前にテンプレートを調整できます。
AIは縦書き中国語(上から下への筆記)に対応できますか?
ほとんどの手書き帳簿は、帳簿の列構造が本質的に横書きであるため、中国語でも横書き(左から右)を使用します。帳簿が伝統的な縦書き中国語を使用している場合、認識精度は大幅に低下します。AIのテーブル構造理解は横書きの行レイアウトに最適化されているためです。縦書きの帳簿の場合は、アップロード前にページ画像を90度回転させて、テキストがAIに対して横書きになるようにしてください。結果は手書きの品質によって異なります。
処理後の帳簿データはどうなりますか?保存されますか?
ファイルは処理後に削除されます。保存されたり、トレーニングに使用されることはありません。抽出されたExcel出力のみが保持されるデータであり、ダウンロード後はお客様のマシンに保存されます。
印刷された列見出しと手書きのエントリがある帳簿の場合、何か特別な操作は必要ですか?
いいえ。これは理想的なケースです。印刷された列見出しがあると、AIは明確なフィールドラベルを利用できるため、手書きや見出しがない場合と比較して、構造レベルの精度が3〜5パーセントポイント向上します。AIは印刷された見出しテキストを読み取り、それを列の割り当て検証に使用します。列の上に「日付」と印刷され、その列のゾーンに短い日付のような文字列がある場合、割り当てが確定します。手書きのみの帳簿(グリッドとエントリの両方が手書き)でも、セマンティックフィールドマッチングによって正しく処理されますが、印刷された見出しがないと、検証シグナルの一つが失われます。