手書きの勤怠表
と出勤簿をAIでExcelに変換
建設業界は、勤務時間の水増しによって毎年数十億ドルの損失を出しています。勤怠管理プラットフォームのTrueinによると、1日あたりわずか30分の水増しでも、時給22ドルで計算すると従業員1人あたり年間4,000ドル以上になります。しかし、すべての従業員が正直であっても、毎週の儀式は同じです。金曜の午後、事務長の机の上に積まれた紙のタイムカードの山、そして3時間後に迫った給与計算の締め切り。きれいにブロック体で記入されたカードもあれば、折りたたまれてコーヒーで汚れ、シフト終了間際に急いで走り書きされたカードもあります。日付が抜けているものもあれば、退勤時間に「8時くらい」と書かれているものもあります。そしてそのすべて——きちんとしたものも、乱雑なものも——午後5時までに給与計算スプレッドシートの行になる必要があります。
重要なポイント
- 事務長がデータ入力に時間がかかっているわけではありません。読みにくい手書き文字を解読し、ニックネームを給与計算用の正式名前に照合し、「標準」とラベル付けされた同じ山に届いた5種類の異なる勤怠表フォーマットを照合しているのです。
- レイアウトベース抽出のOCRソフトウェアは、最もきれいな公式テンプレート以外の勤怠表フォーマットでは失敗します。固定されたグリッド位置でデータを探すためです。だからこそ、事務長は結局、残りの4つのフォーマットを手入力しているのです。
- ImageToTable.aiでは、カラム名ベース抽出が各フィールドを位置ではなく意味で読み取ります。公式グリッド、ノートのリスト、出勤簿のすべてを1つのバッチに入れると、1枚あたり5〜10秒で1つの給与計算スプレッドシートとして出力されます。
金曜午後の儀式:手書きカード20枚と給与計算の締切
摩擦は単なるデータ入力だけではない。その上に積み重なる判断疲れだ。「8時頃」は8:00なのか、8:15なのか、その間なのか?「J. Martinez」と先週のカードにあった「Jose M.」は同一人物か?この会社で4年間働くオフィスマネージャーは、それらの答えを知っている。問題は、彼女が金曜の午後を、それらの質問に一枚一枚答え、給与システムに時間を打ち直すことに費やし、本来雇われた仕事ができていないことだ。
r/Constructionでは、15人のチームを率いる建設業者が状況を正確に描写している。「うちの連中の半分がタイムシートを提出し忘れる。今は紙の書式を使っているが、カオスだ。書類は紛失するし、字は読めないし、オフィスマネージャーは何が起こったのかを解明するだけで毎日何時間も費やしている」。別のユーザーがr/smallbusinessで「まだ手作業のデータ入力に何時間も費やしている」のは自分だけかと尋ねると、回答は自助グループのようだ — 請求書の仕分け、タイムシート入力、領収書の突き合わせ、収益を生み出さずに管理業務の時間を消費するすべての手作業について。
この記事では、手書きのタイムシートやスキャンした出勤簿の写真を、フォーマットされた給与計算用スプレッドシートに変換する方法を解説する — 標準的な表形式のタイムカード、即席のサインインシート、その間のあらゆる形式 — 出退勤時刻を一つも手で打ち直すことなく。
勤怠表に実際に含まれるもの — そしてレイヤーが重要な理由
データを抽出する方法を考える前に、その構造を理解することが役立ちます。標準的な手書きの勤怠表 — 給与計算プロバイダーから提供された印刷テンプレート、誰かが記入して印刷したExcelシート、または現場監督が各現場で使用するカスタムフォーム — には、2つの異なる情報レイヤーが含まれています:
ヘッダーフィールド — タイムシートごとに1回表示され、作業者と報告コンテキストを特定します
| フィールド | 一般的なラベルバリエーション | 給与計算に必要な理由 |
|---|---|---|
| 従業員名 | 作業者、スタッフ、請負業者、クルーメンバー | 時間を正しい人物にマッピングし、賃金計算を行います |
| 従業員ID / バッジ番号 | 給与番号、タイムクロック番号、人事コード | 名前が曖昧な場合(重複、ニックネーム)に給与システムと連携します |
| 週終了日 / 給与期間 | 週の開始日、ステートメント日付、対象期間 | すべての日次エントリを特定の給与サイクルに結び付けます |
| プロジェクト / 作業現場 | ジョブ名、場所、原価コード、作業指示書 | 人件費を正しいプロジェクトに割り当て、ジョブ原価計算を行います |
| 監督者 / 現場監督 | 承認者、署名者、確認者 | 時間が現場でレビューおよび承認されたことを確認します |
日次エントリフィールド — 給与期間の各日について繰り返され、タイムシートごとに複数行あります
| 項目 | よくある表記 | 給与計算に必要な理由 |
|---|---|---|
| 日付 | 日、勤務日、シフト日 | 該当する勤務日を確認するため |
| 開始時間/出勤 | 入り、到着、AM | 時給計算のためのシフト開始時刻 |
| 終了時間/退勤 | 出、退社、PM | シフト終了時刻。開始時刻と合わせて労働時間を算出 |
| 休憩時間 | 昼休み、休憩(分) | 総労働時間から差し引き、正確な実働時間を求めるため |
| 総労働時間 | 勤務時間、日次合計 | 給与計算の核となる数値。手計算または事務所で算出 |
| 残業/深夜割増 | OT、DT、割増時間 | 通常時間と割増時間を分け、適切な賃金を適用するため |
2列目のラベルバリエーションは単なる例外ではなく、4つの異なる現場の6人の現場監督が3つの異なるテンプレートバージョンの勤怠表を記入したときに起こることです。ある列ヘッダーには「出勤」と書かれています。別のものには「開始」とあります。3つ目は列の上部に空白セルがあり、その横に手書きで「AM」と記入されています。人間にとって、これらはすべて同じ意味です。正確なラベル一致を期待するテンプレートベースの抽出ツールにとっては、これらは3つの異なる認識不能なフィールドです。
レイアウトのバリエーションが問題をさらに複雑にします。給与計算プロバイダーからの標準的な週次勤怠表は、上部に従業員情報がある月曜から日曜までのグリッドを使用します — クリーンで一貫性があり、予測可能です。しかし、現場の現実は他の形式を導入します:トレーラー入口のクリップボードに挟まれた出勤簿で、各作業員が新しい行に名前を書き、その横に到着時間を走り書きします。現場監督が「ガルシア — 6:45から3:30、ロドリゲス — 7:00から4:00」と連続リストに書き留めるノートページ。ボランティアがサインインするが退勤時間を記録しないイベント出勤簿 — コーディネーターが後で余白にメモします。特定のXY座標でデータを見つけることに依存するテンプレートベースのツールは、最初の形式以外ではすべて壊れます。同じ仕組みがトレーニング出席をExcelに変換する場合にも対応します。そこでは、サインインシートが印刷されたトレーニングトピックの横に従業員名、部署、完了ステータスを記録します。
AIが手書きの勤怠表をどう読み取るか:スペースベース抽出と意味ベース抽出
勤怠表の画像からデータを抽出する方法には、根本的に異なる2つのアプローチがあります。この違いを理解することで、なぜ一部のツールがある形式では機能し、別の形式では機能しないのかがわかります。
レイアウトベース抽出は、ページ上の位置によってデータを識別します。このツールは予測可能な表構造を想定しています — 氏名はA列、日付はB列、時間は残りの列 — そして各セルにあるものを読み取ります。NoteOCRは自社のドキュメントでこのアプローチを説明しています:「当社のエンジンは、空間的な整列に基づいて暗黙のテーブルを検出します。氏名が左側にあり、時間が右側にある場合、[ツール]はそれらを自動的に正しいExcelの列にフォーマットします。」これは、勤怠表がきれいで一貫性のあるグリッドである場合にうまく機能します。データがそのように配置されていない場合 — 氏名が縦に並んでいる出勤簿、散文形式で時間が記録されているノートページ、またはスペースが足りずに時間を斜めに書いたフォーム — には機能しません。
カラム名ベース抽出 — ImageToTable.aiが採用しているアプローチ — は、データがどこにあるかではなく、何を意味するかによってデータを識別します。出力に必要な列を指定します:従業員名、日付、出勤、退勤、総労働時間、プロジェクト、残業時間。AIは画像全体 — 手書き、印刷されたラベル、チェックボックス、欄外のメモ — を読み取り、ページの視覚的・意味的なコンテキストを理解して各値を特定します。タイムカードのグリッドの上部にある名前は従業員名です。出勤簿の行の末尾にある名前も従業員名です。AIは、従業員名がコンテキスト上どのように見えるかを理解しているため、両方を認識します — 通常は時間の記録の近くにある氏名 — 特定のグリッドセルに入っているからではありません。
これが、カラム名ベース抽出が従来のOCRでは苦労する手書き文字を処理できる理由でもあります。文字ベースのOCRエンジンは「J」という文字を見て、Jがあるべき姿のテンプレートに一致させようとします — これは手書き文字がさまざまに異なる場合に失敗します。ビジョンAIはページ全体を見て、時間の記録の近くの文脈上期待される位置に氏名が現れることを理解し、全体的に読み取ります。手書きの品質は依然として重要です — 極端に読みにくい文字は精度を低下させます — しかし、このツールは文字テンプレートを照合しているのではなく、意味を解釈しているのです。
写真から給与計算スプレッドシートへ:ステップバイステップ
金曜午後の手作業によるデータ入力をAI抽出に置き換えるワークフローは、4つのステップで構成されています。列を一度定義すれば、その設定は以降のすべての給与期間で再利用できます。
すべての勤怠表を撮影またはスキャンする
タイムカード、出勤簿、ノートのページなど、どのような形式でもデジタル化します。クリップボードの用紙をスマホで撮影するのでも構いません。対応形式:JPG、PNG、PDF、WebP。同じバッチ内で形式が混在していても問題ありません。
「テーブルに変換」モードに切り替えて一括アップロードする
すべての勤怠表ファイルを一度に選択します。カード5枚でも20枚でも、各現場からの出勤簿のフォルダでも構いません。AIがそれらを並列処理用にキューに入れます。
列名を一度入力する
給与計算スプレッドシートで使用するフィールドを入力します:従業員名、日付、出勤、退勤、休憩、総労働時間、プロジェクト、残業時間。これらが出力の正確な列ヘッダーになります。同じ列リストは毎週使用できます。保存して毎給与期間に再利用しましょう。
確認してExcelにエクスポートする
処理は勤怠表1枚あたり5〜10秒で実行されます。各日次のエントリが1行になり、従業員ヘッダーデータが繰り返されます。XLSX、CSV、またはJSONでエクスポートでき、ADP、Gusto、QuickBooks Payroll、または構造化された勤怠データを受け入れる任意のシステムにインポートできます。
勤怠表のバッチからの出力は、給与計算対応のテーブルとしてデータを構造化します。各行には、従業員の識別情報と日次の勤怠エントリが含まれます。VLOOKUPや従業員IDの手動照合は不要です。
| 従業員名 | 日付 | 出勤 | 退勤 | 休憩 | 総労働時間 | 残業時間 | プロジェクト |
|---|---|---|---|---|---|---|---|
| Jose Martinez | 2026-05-12 | 6:45 AM | 3:30 PM | 30分 | 8.25 | 0.25 | Elm Street Retail |
| Jose Martinez | 2026-05-13 | 7:00 AM | 3:45 PM | 30分 | 8.25 | 0.25 | Elm Street Retail |
| David Garcia | 2026-05-12 | 6:30 AM | 2:30 PM | — | 8.00 | — | Oakview Residence |
| David Garcia | 2026-05-13 | 6:30 AM | 4:00 PM | 30分 | 9.00 | 1.00 | Oakview Residence |
ファイルは安全に処理され、保存されることはありません。
計算列:抽出時に計算される勤務時間と残業
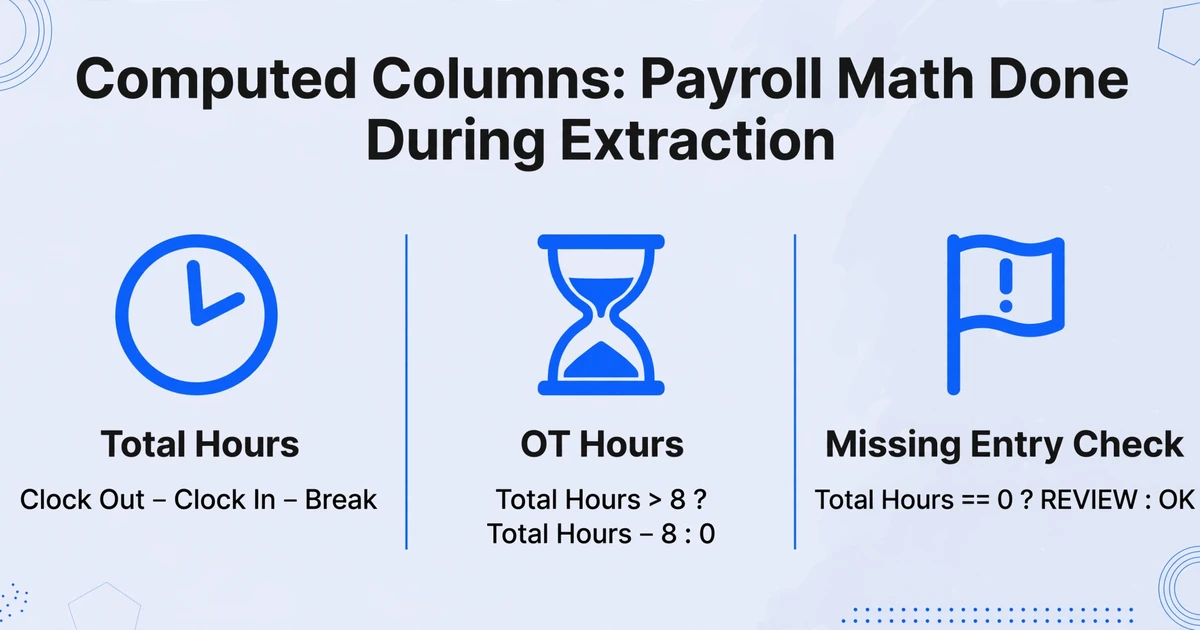
勤怠表に書かれた内容を抽出するのは第一歩です。しかし、給与計算には生の出勤・退勤時刻だけでは不十分で、実際の勤務時間の算出や、残業に該当するかどうかの判定が別途必要になります。この計算作業は通常、抽出後にExcelで行う別タスクです。終了時刻から開始時刻を引き、休憩時間を差し引き、8時間または40時間の基準と比較し、残業行にタグを付ける。これは数式作業であり、抽出ツールが処理中に代行できる数式作業なのです。
計算列を使用すると、抽出中に実行される計算を定義し、導出値を出力テーブルに直接生成できます。生の出勤・退勤時刻を抽出して後からすべて計算する代わりに、列リストに計算列を追加すれば、給与計算に使えるスプレッドシートが一度の処理で完成します。
| 計算列 | 計算内容 | 出力例 |
|---|---|---|
Total Hours (Clock Out - Clock In - Break) | 勤怠表に記載された休憩時間を考慮した、1日あたりの正味勤務時間 | 8.25 |
OT Hours (Total Hours > 8 ? Total Hours - 8 : 0) | 8時間の基準を超えた1日あたりの時間を残業としてタグ付け | 1.25 |
Overtime Flag (OT Hours > 0 ? "OT" : "Regular") | 給与計算担当者が確認しやすい人に読めるラベル | "OT" |
Missing Entry Check (Total Hours == 0 ? "REVIEW" : "OK") | 出勤・退勤時刻の記載漏れや不整合がある日をフラグ付け | "REVIEW" — ガルシア、5/14 |
計算列は、算術演算、条件ロジック、集計、固定パラメータ参照に対応しています。Weekly Total (sum of Total Hours for this employee across all dates in this batch)のような列を使用すると、Excelで別途ピボットテーブルを作成することなく、従業員ごとの週次合計を生成できます。これは、勤怠表カード自体には自己計算された合計が含まれていないことが多いため重要です。作業員は出勤・退勤時刻を記録し、計算はオフィス側に任せます。計算列は抽出中にこのギャップを埋めるため、出力されるスプレッドシートには給与計算に実際に必要な数値がすでに含まれています。
収集リンク:現場から直接、クルーに提出してもらう
抽出部分を自動化しても、勤怠表を実際にシステムに取り込むという問題は残ります。金曜午後の慌ただしさは、実は週の早い段階から始まっていることが多いのです。現場監督がカードを回収し忘れる、作業員がカードを紛失する、現場のトレーラーにカードが山積みになり、誰かがオフィスまで持ち帰るまで放置される。こうした遅延が1つあるごとに、給与計算の締め切りは迫ってきます。
収集リンク — ImageToTable.aiアカウントから生成する共有可能なアップロードページ — を使えば、物理的な受け渡しのプロセスを完全に排除できます。リンクを作成し、クルーのリーダーや作業員にテキストやメールで直接共有するだけで、リンクを持っている人は誰でもスマートフォンから勤怠表の写真をアップロードできます。相手側のアカウント登録は不要です。インストールするアプリもありません。短い認証コードで、アップロード者が権限を持つことを確認します。ファイルは処理キューに直接届き、整理され、タイムスタンプが付き、バッチ抽出の準備が整います。
複数の現場にまたがるクルーの場合、現場監督が金曜の朝に各トレーラーでその週の勤怠表を撮影し、リンクからアップロードすれば、事務長がダッシュボードを開いたときにはキューに並んでいます。封筒も不要。宅配便も不要。「カルロスが回収したと思ってた」という事態もありません。
「標準」勤怠表が、まったく標準ではないとき
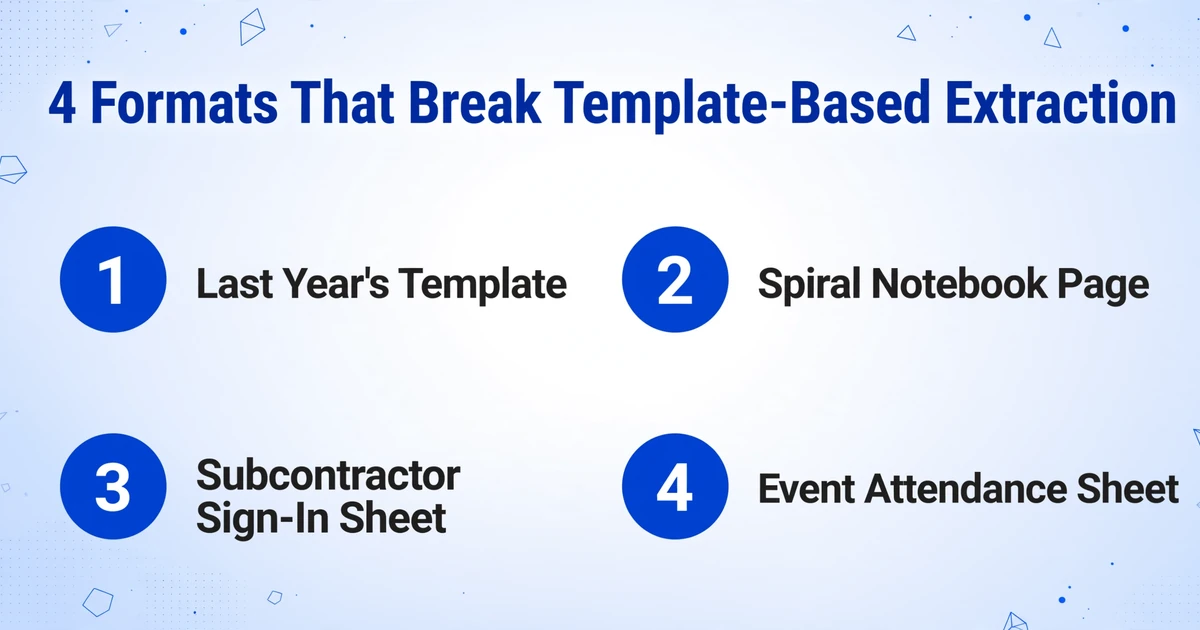
「勤怠表」という言葉は標準化された文書を連想させます。そして理論上は、標準は存在します。建設会社は同じ印刷用PDFテンプレートを全現場監督に配布します。しかし実際に金曜日にオフィスに届くものは、次のようなものです:
- 公式の週次タイムカードテンプレート — クルーの約3分の2が正しく記入したもの
- 昨年の別のテンプレート — ある現場監督が好んで、自分のデスクトップのファイルから印刷し続けているもの
- スパイラルノートのページに時間がリスト形式で走り書きされたもの — 「テンプレートが切れたから、オフィスまで戻る気はなかった」
- まったく異なるレイアウトを使用する下請け業者のクルーのサインインシート — 名前が縦に並び、右余白に手書きの到着時刻が記入されている
- 研修日のイベント出欠表 — 15人の作業員がサインインしたが、退社時刻を記録した人は誰もおらず、トレーナーが後から2回目のパスとして記入したもの
テンプレートベースの抽出は、最初のフォーマット以外ではすべて失敗します。定義済みの位置にデータがあることを前提としているからです。「従業員名」が左上、「総労働時間」が右端の列にあることを想定したツールでは、それらの値が連続した文章の中に現れるノートのページを処理する方法がありません。カラム名ベース抽出は、各ドキュメントを個別に読み取り、要求されたフィールドがどこにあっても特定するため、混合バッチ全体を処理できます。公式テンプレートとノートのページは同じバッチに入り、同じ出力テーブルから出てきます。
ここでは手書きの品質が実際的な意味で重要です。明確なブロック体は、走り書きの筆記体よりも確実に抽出できます。また、ひどく汚れたり薄い鉛筆の跡はエラーを生む可能性があります。しかし、AIは活字体、筆記体、混在ケース、行や列に並んだ手書きの数字など、一般的なすべてのスタイルの読みやすい手書き文字を認識します。また、現場での一般的な紙の状態(折り目、コーヒーの輪染み、泥の汚れ)も、下のテキストが視覚的に判別できる範囲で処理します。
よくある質問
同じシートに複数の作業員の手書き文字がある場合(例:20名の署名欄がある出勤簿)でも読み取れますか?
はい — これは、レイアウトベースのツールでは対応が難しい、カラム名ベース抽出が得意とする主要なシナリオの1つです。各作業員が自分の名前と到着時刻を異なる手書きスタイルで記入する出勤簿も、1つのドキュメントとして処理されます。AIは各行を独立して読み取り、各人の名前と時刻を抽出します。出力テーブルには、出勤簿1枚につき作業員ごとに1行が生成されます。この複数行の読み取りは、研修の出席管理をExcelに移行する場合にも活用されています。研修の出席簿には、各参加者が部署と完了マークとともに別々の行で記載されるためです。
同じバッチ内で、ある勤怠表が24時間表記(1400)で、別の人がAM/PM表記を使っている場合はどうなりますか?
AIは両方の形式を解釈します。「2:00 PM」「14:00」「2p」はすべて同じ時刻値として認識されます。出力は選択した形式に標準化されます — 列名に希望の形式を指定してください(例:「退勤(24時間表記)」や「退勤(12時間AM/PM表記)」)。AIはそれに応じて正規化します。同じバッチ内の異なる勤怠表で形式が混在していても問題なく処理されます。
作業員が合計時間を記入し忘れた勤怠表にも対応できますか?
はい — ここで算出カラムが特に役立ちます。作業員が退勤時刻と出勤時刻は記入したものの、合計時間欄が空白だった場合、合計時間(退勤 - 出勤 - 休憩)のような算出カラムが、抽出時に利用可能なデータから計算します。元の勤怠表に合計時間がなくても、出力スプレッドシートには計算された合計が含まれます。出勤/退勤時刻自体が欠落している、または判読できないカードについては、AIはそれらのフィールドを空白のままにします — 推測はしません — そして欠落チェック(合計時間 == 0 または空白 ? 「要確認」 : 「OK」)のような算出カラムが、手動でのフォローアップが必要なものをフラグ付けします。
英語以外の言語の勤怠表でも機能しますか?
はい。AIはスペイン語、フランス語、ポルトガル語、ドイツ語、日本語、韓国語など、主要な言語の勤怠表を読み取ります。「Nombre del Empleado」や「Heures Travaillées」のようなフィールドラベルも理解され、英語の列名にマッチングされます。作業員が異なる現場で複数の言語の勤怠表を提出する場合でも、すべて同じバッチに入れることができます — AIは1回の処理実行で多言語認識を処理します。日本語の勤怠プラットフォームを使用している場合は、日本語の勤怠アプリのスクリーンショットから出勤・残業データを抽出するガイド(King of Time、Freee、SmartHR、Jobcan)をご覧ください。
毎回の給与計算期間で同じ列設定を再利用できますか?
はい。列リスト(従業員名、日付、出勤、退勤、休憩、総労働時間、プロジェクト、残業時間)を一度定義すれば、保存して毎週再読み込みできます。同じ列名は、異なるチーム、異なる現場、異なる勤怠表フォーマットでも機能します。AIがラベルではなく意味で照合するためです。新しいプロジェクトコードを追加したり、現場監督の名前を変更したりする場合は、列リストの値を更新するだけで、抽出ロジック自体の再設定は不要です。
手書きの勤怠表で現実的な精度はどのくらいですか?
はっきり書かれた活字や読みやすい筆記体の場合、標準的な勤怠表の印刷された表データは、数字と名前で最大99%の精度を達成します。精度は手書きの質によって低下します。終業間際の急いだ走り書き、非常に薄い鉛筆書き、ひどく汚れた紙、または個々の文字が本当に曖昧な手書きは、精度が低くなり、手動での確認が必要になる場合があります。このツールは、実験室レベルのきれいな手書きではなく、現場の勤怠表の平均的な実世界の状態を処理するように設計されています。重要な給与計算用途では、簡単な確認パスをお勧めしますが、確認はフラグが付けられたエントリをスキャンするだけで、すべてのフィールドをゼロから再入力する必要はありません。
今週の勤怠表を撮影し、給与計算の列を一度入力するだけで、金曜日の締め切り前にスプレッドシートを取得できます。
抽出を開始