手書き文書抽出が失敗する理由 — 各失敗モードの背後にある予防可能な原因
手書き抽出は、走り書き、かすれた印、印刷と手書きの混在、文脈上の判読不能、機械的劣化という5つの予防可能な次元で失敗します。どの失敗を未然に防げるかを学びましょう。
主なポイント
- これまでに見たすべての手書き抽出の失敗は、既知の修正方法がある正確に8つの分類可能なパターンのいずれかに起因します。
- 抽出エラーの20〜40%は、正しく見えるものの、ページに書かれていないデータを含む出力を生成します。
- 本記事の失敗フレームワークを使って50件の文書の抽出エラーを1時間分類すれば、どの具体的な修正が精度を最も向上させるかがわかります。
抽出失敗の3つのカテゴリー
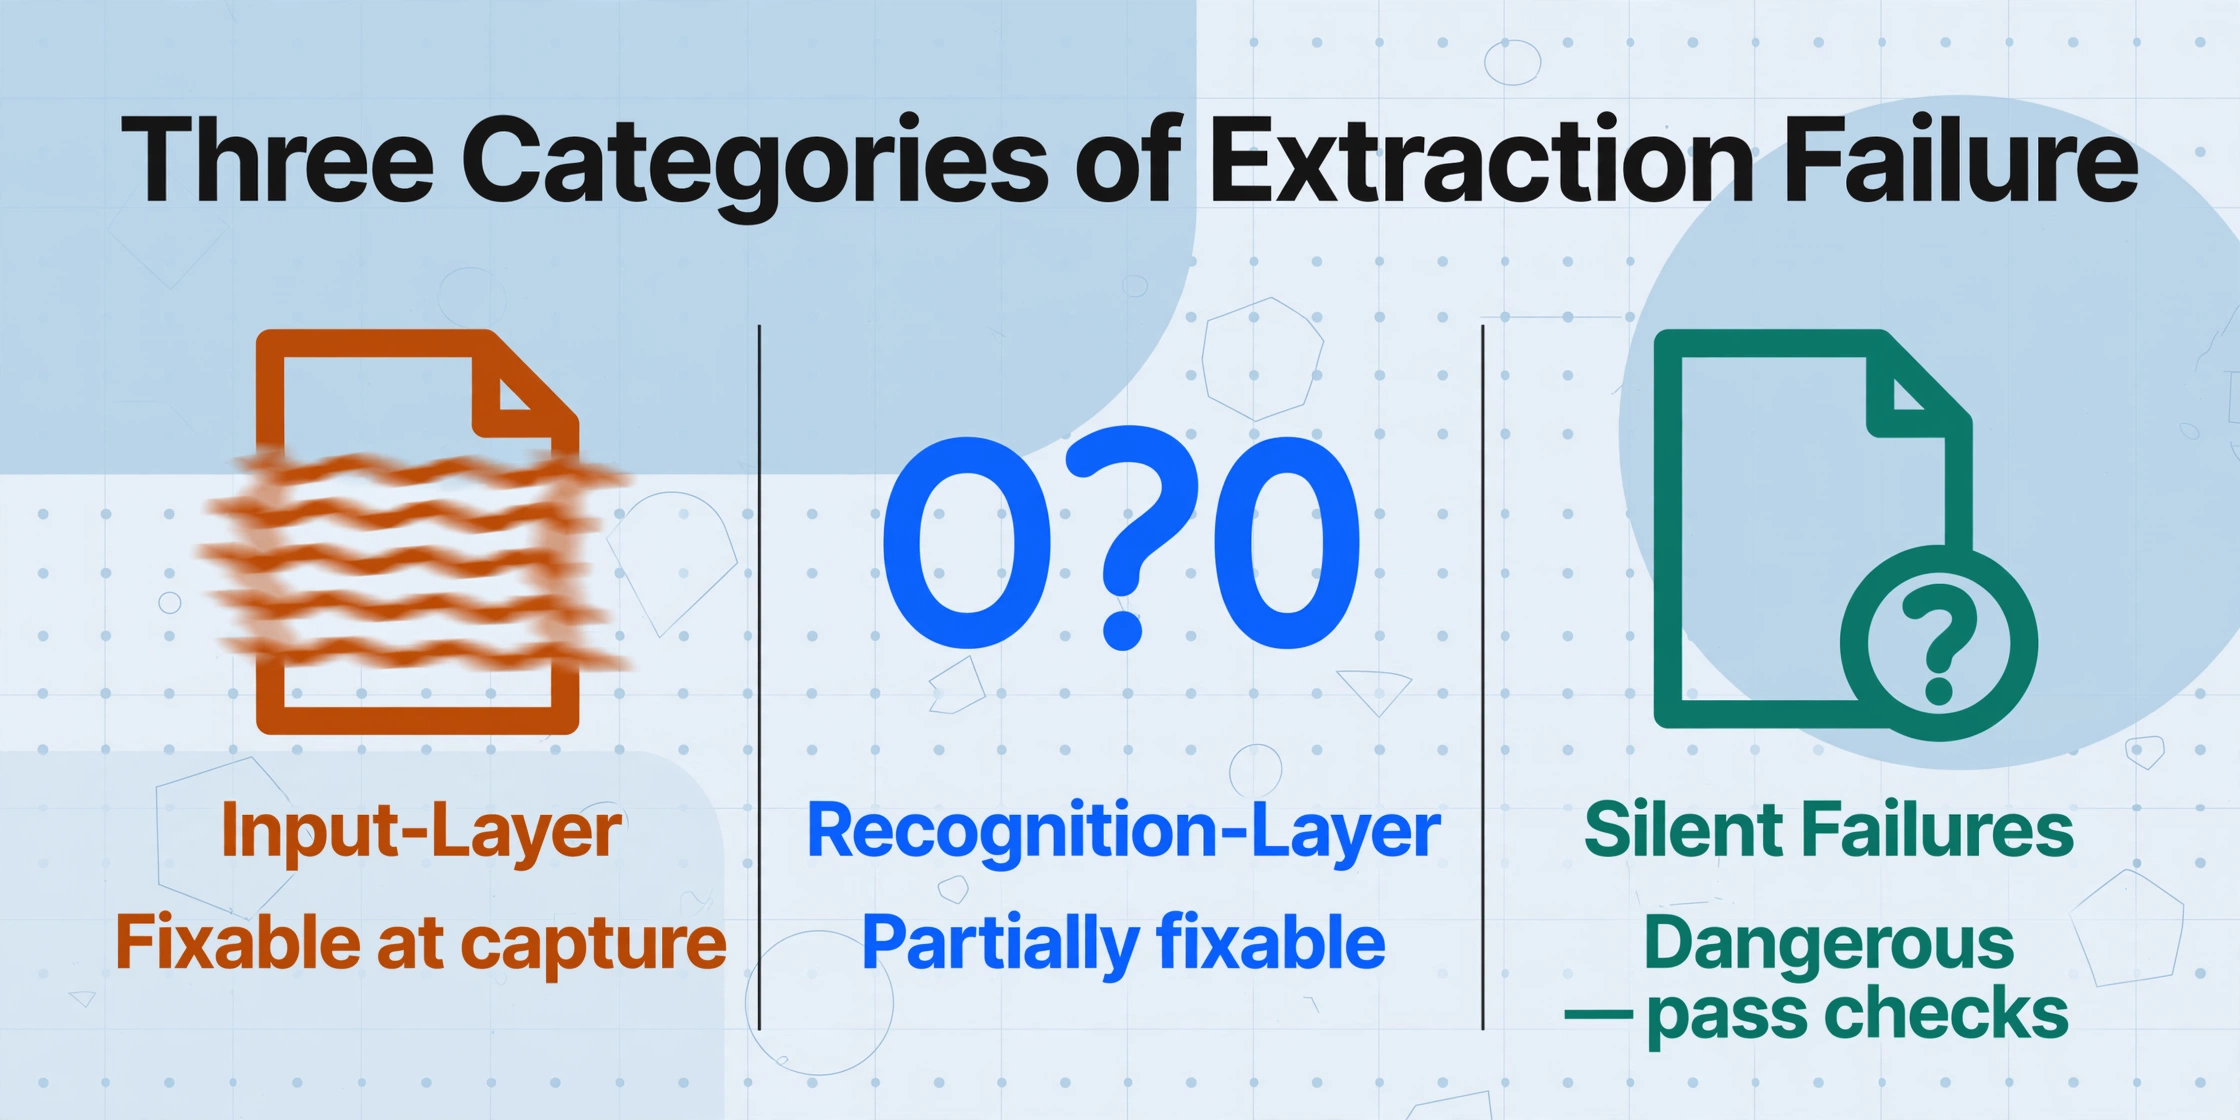
手書き文字の抽出エラーはランダムではありません。それらは3つのカテゴリーに分類され、自分のエラーがどのカテゴリーに属するかを知ることが、修正への第一歩となります。あるいは、修正がツールではなく入力の変更を必要とする場合を見極める手がかりにもなります。
入力レイヤーの失敗は、AIモデルがドキュメントを見る前に発生します。正しい抽出に必要な情報が、画像に存在しないか、撮影方法によって損なわれている状態です。これは最も一般的な失敗であり、最も自分でコントロールしやすいものです。
認識レイヤーの失敗は、抽出中に発生します。モデルは入力を見ていますが、それを誤って解釈します。似た文字を混同したり、続け字を正しく処理できなかったり、テキストを正しいフィールドに割り当てられなかったりします。これらの失敗は、入力品質とフィールド設計によって部分的にコントロールできますが、一部は技術の現時点での限界に起因します。
サイレント失敗は危険なカテゴリーです。出力は正しく見えます。フィールドは埋まり、形式は有効で、信頼スコアも高くなっています。しかしデータは間違っています。モデルが存在しない値をハルシネーションしたか、上流の単一のエラーが依存するフィールドに連鎖し、検証が一切発動しなかったかのどちらかです。
これらの失敗は自動チェックを通過し、下流のシステムに検知されないまま到達します。経験則:抽出が「大きな音を立てて」失敗する場合 — フィールドの欠落、文字化け、形式エラー — は入力層または認識層の問題です。抽出が「静かに」失敗する場合 — もっともらしく見えるが誤ったデータ — はサイレント障害の問題です。2つ目のカテゴリは検出が難しく、本番システムに到達したときのコストがより大きくなります。
カテゴリ1 — 入力層の失敗
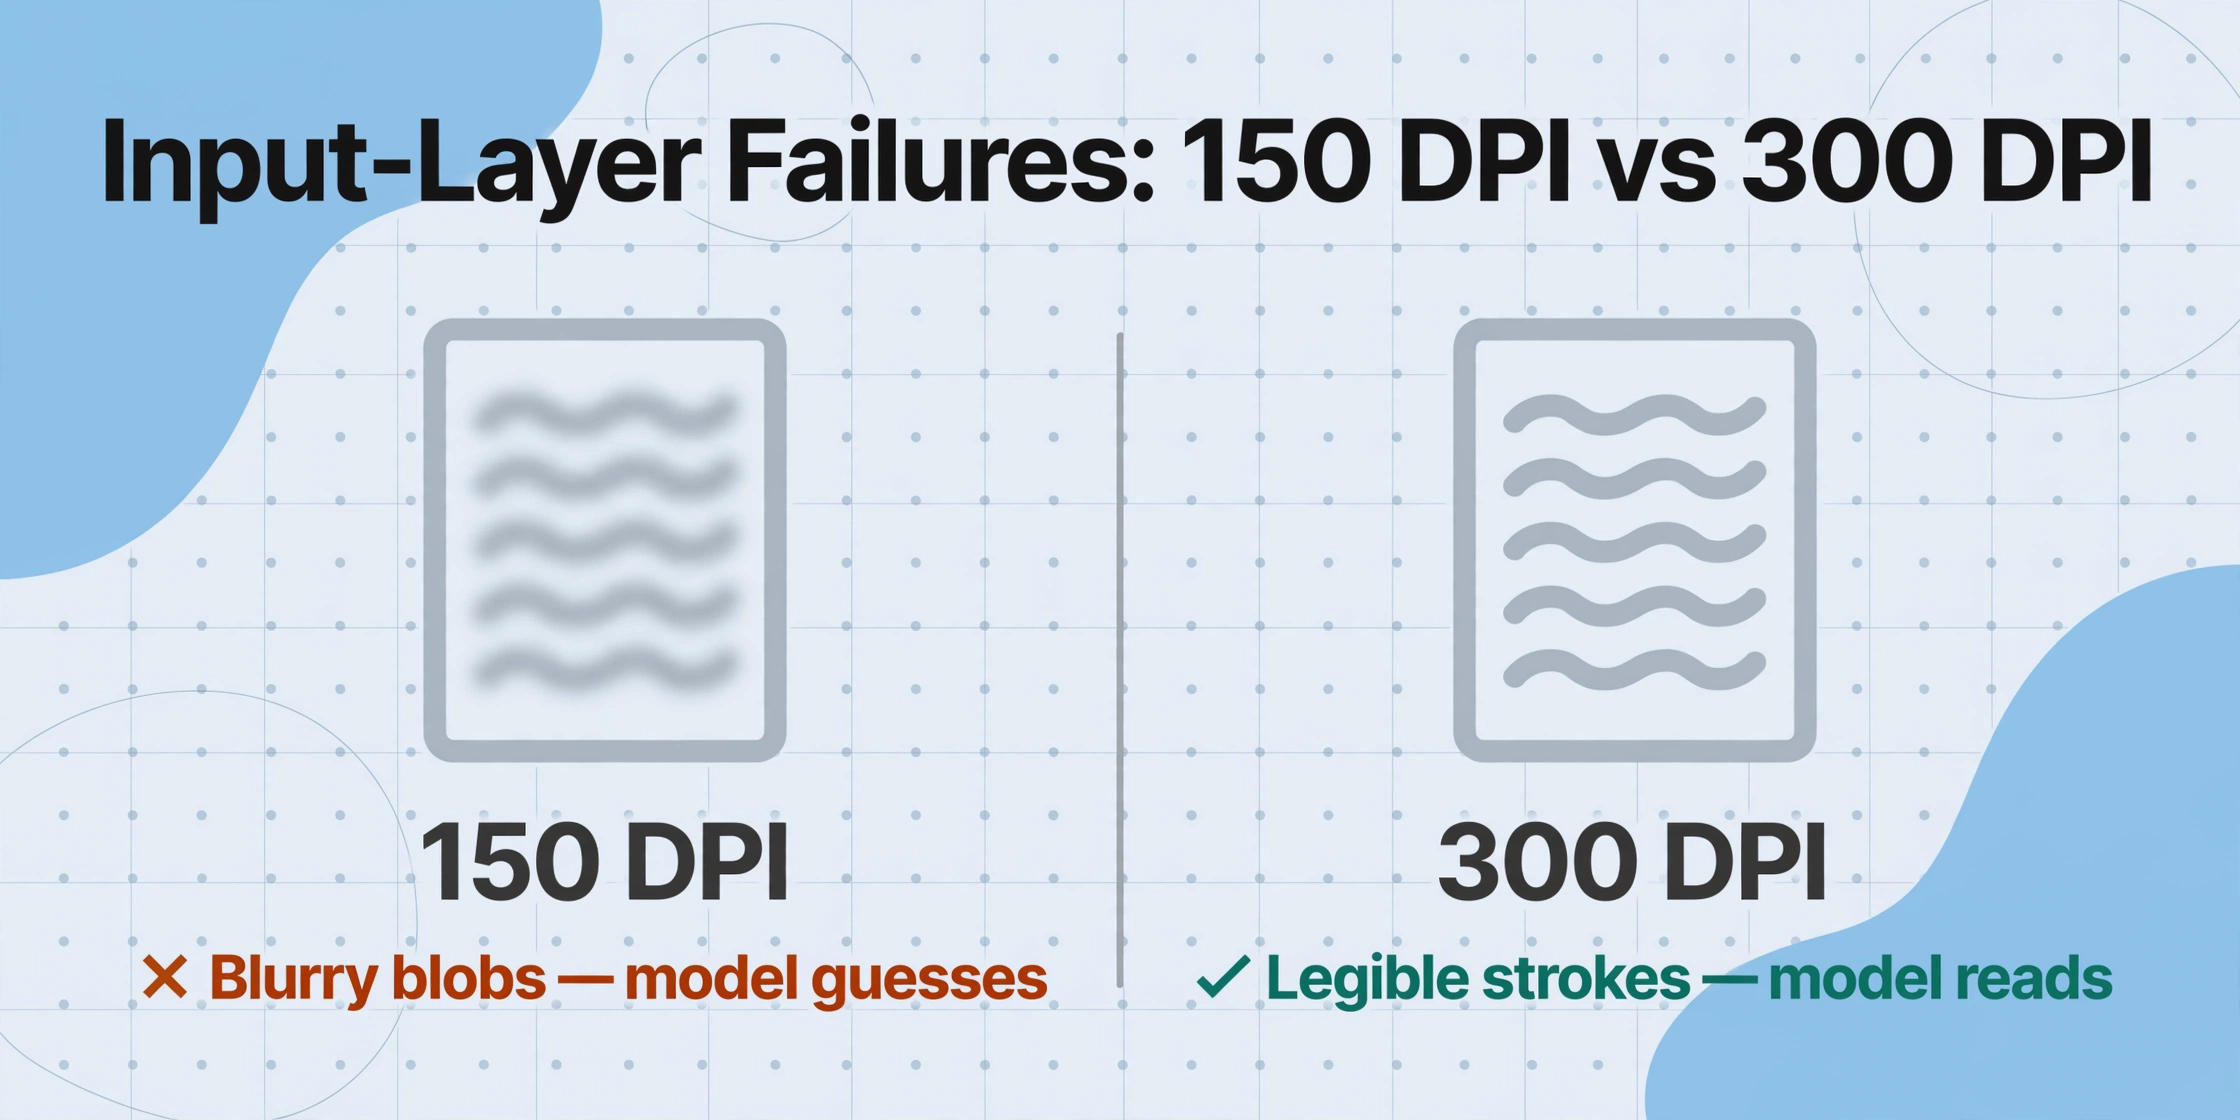
失敗 #1:画面上では問題なく見えるぼやけたスキャン
見分け方:抽出結果の半分のフィールドには妥当なテキストが含まれ、残りの半分には意味不明な内容が含まれる — 明確なパターンがない。ドキュメントを開いたときは読めるように見えたのに、抽出出力を見るとAIが別の画像を見ていたかのようである。
実際に起きていること:標準的なモニターで100%ズームにしたときに鮮明に見えるドキュメントでも、文字レベルの認識には解像度が低すぎる場合があります。人間の視覚システムは文脈から欠落を補完しますが、AIモデルは実際のピクセルデータに基づいて処理します。手書きの「8」と「6」を150 DPIでスキャンした場合、人間が形で区別するには十分なピクセルがあっても、モデルが下部ループの決定的な違いを解像するには足りないことがあります。モデルは曖昧な塊を見て推測し、フラグが立てられずに通過するほど高い信頼度でフィールドレベルのエラーを生み出します。
修正方法:手書きを含むドキュメントには最低300 DPIを設定してください。スマートフォンで撮影するドキュメントには、デフォルトのカメラアプリではなく、遠近補正とコントラスト強調を適用するスキャンアプリを使用してください。同じドキュメントを150 DPI、300 DPI、600 DPIでテストしてください — 300から600への引き上げは通常、収穫逓減になりますが、150から300への引き上げは、手書き認識が運任せではなく実用的になる閾値です。
失敗例2:印刷文字の下に埋もれた手書きメモ
見分け方: あるフィールドの抽出値が、手書きの記入内容ではなく印刷されたフォームラベルの断片になっている。あるいは、両方の文字が混ざったような値になっている — フォームラベル「Customer Name:」が印刷され、その下に「John」が手書きされているのに、「Customer NamJohn」と抽出されるなど。
実際に起きていること: 手書き文字が印刷されたフォームラベルと重なったり、すぐ上または下に位置したりすると、抽出エンジンは同じ視覚領域を占める2つのテキストストリームを分離しなければなりません。従来のOCRエンジンはここで壊滅的に失敗します — 領域内のすべてのピクセルを1行のテキストとして読み取ってしまうのです。VLMベースのシステムは文書構造を理解するため、重なったテキストをより適切に処理できますが、それでも精度は5〜8ポイント低下します。賃貸登録フォームで手書きの入居者名が印刷されたフィールドラベルと重なっていたUiPathコミュニティの事例は、この失敗クラスの典型例です(UiPath Community Forum、2024年)。
修正方法: 抽出用にフォームを設計する際は、印刷ラベルと手書きエリアの間に明確な垂直方向の間隔を設けてください。最低6mmの間隔があれば、重なりによるエラーが大幅に減ります。既存のフォームについては、画像を前処理して、印刷文字(通常はより濃く均一)と手書き文字(通常はより薄く多様)のコントラストを高めます。前処理が難しい場合は、これらのドキュメントをVLMベースのパイプラインに回してください — 完全ではないにせよ、従来のOCRよりも混在コンテンツの分離をうまく処理できます。
失敗例3:予告なく変更されたフォーム
見分け方: 数週間は完璧に抽出できていたのに、あるバッチで突然失敗する — これまで一貫して正しく抽出されていたフィールドが、空または誤った値を返すようになります。ドキュメントは一見すると同じに見えます。
実際に起きていること: サプライヤー、クライアント、または部署がフォームのレイアウトを変更したのです — フィールドを半インチ移動した、ラベルの名前を変えた、テキスト領域に食い込むロゴを追加した、など。抽出設定が固定座標のテンプレートや厳格なフィールド名マッチングに依存している場合、わずかなレイアウト変更でもパイプライン全体が壊れてしまいます。 これはテンプレートベースの抽出で最もよくある失敗モードであり、精度の問題ではなく構造的な問題です — 抽出エンジンは設定どおりに正確に動作していますが、その設定が新しい入力に対して無効になっただけなのです。
修正方法: 位置ベースのテンプレートに頼るのではなく、フィールドの意味を理解する抽出手法を使用してください。Custom Column Extraction — フィールドをその意味(「Invoice Total」「Delivery Date」など)で定義し、AIがドキュメントの内容を理解してそれらを見つけ出す手法 — は、テンプレートの脆さを完全に排除します。同じ列定義が、異なるソースの異なるフォームレイアウトでも機能します。AIはピクセル座標ではなく意味を探しているからです。これは、両アプローチの比較で解説しているように、従来のOCRパイプラインと最新のAIベース抽出の根本的なアーキテクチャの違いの一つです。
カテゴリ2 — 認識レイヤーの失敗
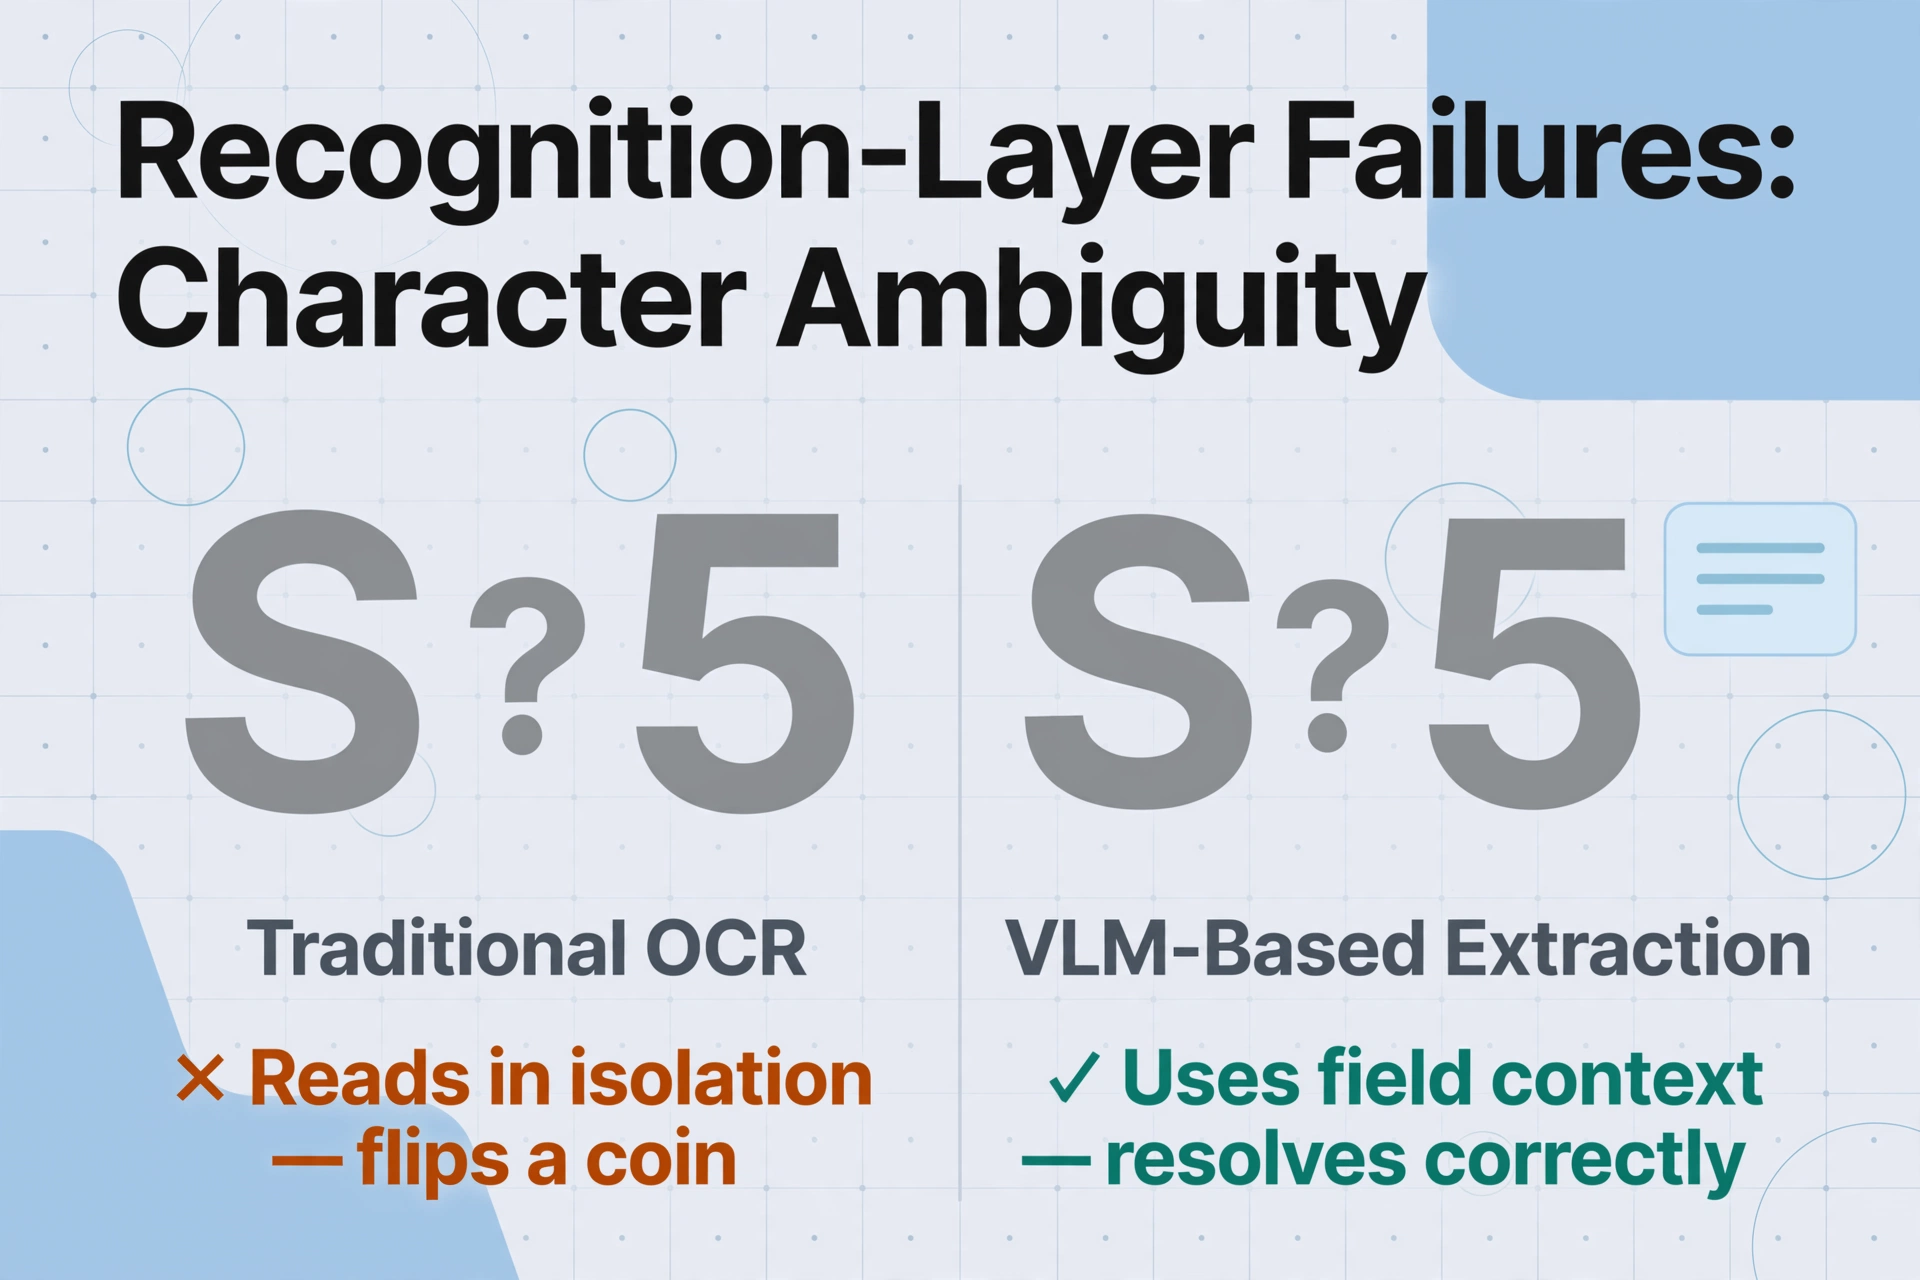
失敗#4:「0」が「O」になる — 文字の曖昧さの罠
見分け方: 抽出されたテキストで、数字であるべき箇所に英字が、英字であるべき箇所に数字が入ります — 「5」の代わりに「S」、「0」の代わりに「O」、「1」の代わりに「l」、「8」の代わりに「B」。エラーのパターンは一貫しており、すべての誤りは単独で見ると視覚的に似通った文字同士です。
実際に起きていること: 従来のOCRのように文字を単独で読み取ると、曖昧な形状はエンジンの学習データにおいて最もピクセルが近い文字にデフォルトで割り当てられます。上部が平らで下部が開いた手書きの「5」は、手書きの「S」とほぼ同じピクセルパターンを持ちます。文脈の手がかり(このフィールドには数字が入るはず)がないため、エンジンはコイントスのように判定します。手書きの数値フィールド(配送数量、請求金額、メーターの読み取り値)を含むフォームでは、この単一の失敗クラスが抽出エラーの大半を占めます。 複数のOCRツールをレビューしたあるRedditユーザーは、洗練されたUIを備えたシステムでさえ、英数字が混在する表で「多数の手書き文字起こしミス」を生じたと報告しています (r/computervision, 2024)。
修正方法: 解決策は抽出アプローチによって異なります。従来のOCRでは、「このフィールドは数値でなければならない」といった後処理の検証ルールが、抽出後にほとんどの文字の曖昧さを捕捉します。VLMベースの抽出では、モデルが「合計金額」フィールドには数値が入ることを理解しているため、文脈に基づく解釈によって通常は自動的に解決されます。VLMバックエンドでカスタム列抽出を使用している場合、列名に想定される形式(「合計金額(数値)」)を指定することで、値が出力に入る前に曖昧さを解決する明示的な制約をモデルに与えられます。
失敗例5:「手書き」— 単語が分割・結合されるとき
見分け方: 抽出されたテキストに存在しない単語境界が現れます。「handwriting」が「hand writing」に、「the man」が「them an」に、「invoice number」が「invoicen umber」になるといった具合です。逆のケースもあり、筆記具が隙間をまたいで動いたために、別々の手書きフィールドが1つに結合してしまいます。
実際に起きていること: 単語分割 — どこで1つの単語が終わり次が始まるかを知ること — は、字間が一定している機械印刷のテキストでは簡単です。手書きの場合、字間は書き手の裁量で決まり、ばらつきます。単語内の文字間に大きな隙間を空ける書き手もいれば、1つの文のすべての文字をペンを離さずつなげて書く書き手もいます。抽出エンジンは平均的な手書きで調整された字間しきい値を適用しますが、あなたの書き手は平均的ではありません。その結果、まとまりのあるテキストが意味不明な単語の羅列になる分割エラーが生じます。
解決策: VLMベースのシステムは、言語理解を使って単語境界を再構築するため、従来のOCRよりも分割エラーにうまく対処します。「them an」は意味のあるフレーズではなく、モデルの言語知識がテキスト生成段階で「the man」に修正します。これはAIの文脈推論が認識エラーを積極的に修正するケースです。ドキュメント設計側の解決策としては、可能な場合は自由記述用の罫線ではなく、文字ごとの個別ボックス(1文字に1ボックス)を使ったフォームを使用してください。政府の税務フォームがこの設計を採用しているのは、まさに分割の曖昧さを排除するためであり、この制約は人間の読み手と機械抽出の両方に利益をもたらします。
失敗例6:別のアルファベットのように読める筆記体
見分け方: 活字体のテキストフィールドは完璧に抽出されます。筆記体のフィールド — 特に連結したループ、傾いた文字、詰まった書き方 — は、同じ単語とはほとんど分からない出力を返します。「world」のような単純な筆記体の単語が「wriod」として返ってきます。
実際に起きていること: 筆記体は、個別の文字形状を連続したストロークに置き換えます。筆記体の単語の途中にある文字「e」は、単独の活字体の「e」とはまったく似ていません。前後の文字につながったループなのです。従来のOCRの文字分割優先アプローチでは、そもそも別々に書かれていない文字を分離できません。2025~2026年世代のVLMは、文字を組み立てるのではなく単語の形状を全体的に処理するため、筆記体をよりうまく扱えますが、精度の上限は活字体やブロック体の手書きよりも依然として大幅に低くなります。独立系ベンチマークでは、完全な筆記体でフィールド精度75~88%、ブロック体で85~93%を示しており、この差は入力の本質的な難しさを反映したもので、特定のモデルの欠陥ではありません(Suparse, 2026)。
解決策: 筆記体をブロック体と同じ精度にする技術的な解決策はありません — これは真の精度の上限です。実用的な緩和策は2段階のアプローチです。筆記体フィールドが情報提供的なもの(メモ、コメント、説明)であるドキュメントでは、低い精度を受け入れ、信頼度ベースのルーティングを使って低信頼度の抽出を人間のレビュー用にフラグ立てします。筆記体フィールドが取引的なもの(金額、口座番号、法的識別子)であるドキュメントでは、それらのフィールドをブロック体の大文字で印刷することを必須にします — これはプロセスのルールであり、技術的な解決策ではありません。「はっきりと印刷してください」という指示と書き込み領域の制約を加えたフォームの再設計は、筆記体フィールドの量を根本から減らします。入力品質と列設計によって可能になる精度向上については、総合的な精度ガイドで解説しています。
カテゴリ3 — 静かな失敗
失敗 #7: 存在しなかったデータ — AIハルシネーション
見分け方: 最も厄介な症状です。抽出結果のすべてのフィールドに値が入っています。値の形式も正しいです。検証エラーは何も発生しません。しかし、出力を元のドキュメントと照合すると、1つ以上のフィールドに、記入者が入力していないデータが含まれていることが判明します — 空欄だったフィールドに日付が入っている、正しそうに見えるが元データと一致しない金額、ページの別の箇所の文脈からモデルが推測したサプライヤー名などです。
実際に起きていること: VLMベースの抽出モデルは、文字を認識するだけでなくテキストを生成します。フィールドが本当に空欄だったり、手書き文字が判読不能だったりすると、モデルは「そこにあるべき」値をもっともらしく生成してしまうことがあります — VLMが乱雑な手書き文字の曖昧さを解消するのに非常に有効な、その同じ推論能力が、曖昧さの解消から捏造に踏み込むと弱点になります。これは、AIベースの抽出と従来のOCRを最も鮮明に分ける失敗モードです。従来のOCRは空欄や判読不能なフィールドに対して何も返さないか意味不明な文字列を返します(検出可能な失敗)が、VLM抽出は説得力のある虚構のデータを返すことがあります(検出不可能な失敗)。複数のツールをレビューしたRedditの投稿者は、これを明確に指摘しています。「ChatGPTは手書き文字からテキストへの変換で非常に印象的な結果を出せますが、ハルシネーションの問題もあり、構造化データを確実に抽出することはできませんでした」(r/computervision, 2024)。
対策: ハルシネーションは排除できません — 生成モデルに本質的に備わるものです。ただし、封じ込めることはできます。3層の防御があります。第一に、フィールドごとの信頼スコアを提供する抽出システムを使い、エラーのコストが高いフィールドには高い信頼しきい値(0.90以上)を設定します。第二に、フィールド間の検証ルールを実装します — 「合計金額」フィールドに値が入っているなら、それを合計する明細フィールドにも値が入っているはずです。明細フィールドが空欄なのに合計に値が入っているのは、ハルシネーションの危険信号です。第三に、ミッションクリティカルなワークフローでは、高信頼度の出力のサンプルに対して人間によるレビュー工程を維持します — システムがフラグを立てたエラーを修正するためではなく、システムが自信を持っていたエラーを捕捉するためです。これは従来のOCRエラー修正とは異なるレビュー戦略であり、VLMベースのパイプラインには不可欠です。
失敗例8:すべてを左右するチェックボックス
見分け方:本来空であるべきフィールドにデータが抽出されている — 「既往歴なし」にチェックが入っているフォームに患者の病歴の詳細が入っていたり、親条件が偽とされているのに依存フィールドが入力されていたりする。個々の抽出結果だけを見ると正しく見えるが、誤りはフィールド間の構造的な関係にある。
実際に起きていること:条件付きロジックを持つフォーム — このボックスにチェックを入れると追加セクションが表示される、「はい」と答えると展開される、あるオプションを選ぶと他が非表示になる — は、フィールド間に構造的な依存関係を生み出す。チェックボックスを抽出し損ねたり、「はい」を「いいえ」と誤読したりすると、個々の文字が完璧に読み取られていようと、依存するすべてのフィールドが誤りになる。単一の二値の誤りが、複数のフィールドの失敗へと連鎖する。これは高次の失敗モードである:抽出は文字単位では正確だが、構造的に誤っている。ベンダーのベンチマークで最も議論されない失敗モードでもある。ベンチマークは通常、フィールド間の依存関係ではなく、個々のフィールドを単独で評価するからだ(ImageToTable.ai, 2025)。
修正方法:条件のトリガーとなるフィールドを明示的に取得するよう、抽出列セットを設計する。医療問診フォームに「既往歴(はい/いいえ)」があるなら、それを独立した列にする。次に検証ルールを作成する:「既往歴」が「いいえ」なら、「病歴の詳細」フィールドは空でなければならない。「既往歴」が「はい」で「病歴の詳細」が空なら、レビュー対象としてフラグを立てる。これにより、サイレントな構造的失敗が検出可能な検証エラーに変わる。条件付きロジックが多用されたフォームでは、より高い割合の抽出を人によるレビューに回す — 条件の連鎖を見落とすコストは、正しく抽出されたかもしれないフォームをレビューするコストよりも高い。
抽出結果を自分で監査する方法
上記の失敗モードは診断フレームワークです。ここでは、何時間も手作業でレビューすることなく、自分のドキュメントに適用する方法を説明します。
ステップ1:本番の受付から50件のドキュメントを無作為に抽出します。きれいなものではなく、余白のメモ、取り消し線のある値、混在した筆跡スタイルを含むドキュメントを含めてください。失敗が集中するのはこうしたドキュメントです。
ステップ2:各ドキュメントの各フィールドについて、次のいずれかに分類します:正しい、誤りで明白(文字化け、値の欠落、形式エラー)、誤りだがもっともらしい(正しく見えるが誤り)。誤りで明白なものと誤りだがもっともらしいものの比率から、失敗プロファイルが主に入力/認識(明白なエラー)なのか、サイレント(もっともらしいエラー)なのかがわかります。ほとんどのチームは、エラーの20~40%が誤りだがもっともらしいもの——これまで追跡していなかったカテゴリ——であることに気づきます。
ステップ3:誤った抽出ごとに、上記の8つのパターンを使って失敗モードを分類します。カテゴリを把握していれば、1件あたり約30秒で済みます。50件のドキュメントを分類すると、失敗プロファイルが得られます:40%が入力レイヤー(キャプチャプロセスを修正)、35%が認識レイヤー(フィールド設計と列名を改善)、25%がサイレント(検証ルールと人によるレビューのチェックポイントを追加)。このプロファイルは、どこに投資すべきかを示します——一般的な「精度向上」の取り組みではなく、実際の失敗パターンに合致する具体的な介入です。
ステップ4:上位の失敗カテゴリに合致する修正を適用します。入力レイヤーの失敗が支配的なら、他の何かに手を付ける前にスキャンプロセスを改善してください。サイレント失敗が予想より多いなら、検証ルールを追加し、人によるレビューのサンプル率を上げてください。修正後、新たに50件のドキュメントのサンプルで再度測定します。失敗プロファイルの変化——絶対的な精度の数値ではなく——が、その介入が効果的だったかどうかを示します。
FAQ
抽出エラーがツールの問題かドキュメントの問題かを見分けるには?
同じドキュメントを2つの異なる抽出方法で処理してみてください。たとえば、従来のOCRパイプラインとVLMベースの抽出ツールです。両方が同じフィールドで失敗するなら、問題はドキュメント側です(入力品質か、そもそも判読不能な手書き文字である可能性が高いです)。一方が正しく抽出でき、もう一方ができないなら、ツールまたはその設定がボトルネックです。この差分テストなら、数分で原因を切り分けられます。
AIのハルシネーションを完全に防ぐことはできますか?
いいえ。ハルシネーションは生成AIモデルに本質的に備わったもので、設定や入力品質の改善では排除できません。できるのは封じ込めることです。信頼度スコアリングで低信頼度の抽出を特定し、あり得ない出力を検出するフィールド間検証ルールを実装し、高信頼度の出力をサンプリングする人間のレビュー工程を維持してください。これは特に、システムが自信を持っていたエラー、つまりハルシネーションである可能性が最も高いものを捕捉するためです。
テストドキュメントでは完璧に抽出できるのに、本番では失敗するのはなぜですか?
これはほとんどの場合、ドキュメントの多様性の問題です。テストドキュメントはクリーンで新しく、平均的なケースを代表する傾向があります。本番ドキュメントにはロングテールが含まれます。2018年のFAX、走行中のトラックでボールペンで記入されたフォーム、コーヒーの染みや余白の書き込みがあるドキュメントなどです。本記事で挙げた失敗モードは、受け取るドキュメントの最悪の10~15%に集中しています。テストセットにそうしたドキュメントが含まれていなければ、重要なものを測定できていません。直近の本番バッチから最も乱雑な20件のドキュメントをテストセットに追加して、再実行してください。
最もよく見られる単一の失敗モードは何ですか?
手書きの数値フィールドにおける文字の曖昧さ、つまり「5」が「S」、「0」が「O」、「1」が「l」と読まれる問題は、他のどの単一の原因よりも多くの抽出エラーを引き起こします。これは認識層の失敗であり、入力品質の改善(高解像度化、照明の改善)で減らせますが、排除はできません。最も効果的な緩和策は、フィールドレベルのフォーマット制約です。つまり、特定の列には数値のみが含まれるべきだと抽出システムに指示することです。これは、システムがフォーマットヒントに対応していれば、列の定義自体で行えます。
抽出を試す前に、すべてのフォームを再設計すべきですか?
自分で管理できるフォーム(社内フォーム、自分で設計する受付書類など)については、はい — 抽出を前提に再設計する(文字ごとの枠、明確なラベルとフィールドの分離、記入領域の制限、「はっきりと活字で記入」の指示)ことが、最も効果の高い投資です。管理できないフォーム(仕入先の請求書、顧客が提出する書類、行政のフォーム)については、代わりに入力品質とフィールド設計に注力してください — フォーム自体を変えられないときに変えられる変数は、そこにあります。
推測をやめて、診断を始めましょう
抽出の失敗は、分類するまではランダムに感じられます。上記の8つのパターンは、診断のための言葉を与えてくれます — 誤った結果を見て「これは失敗#4の文字の曖昧さで、修正方法は列定義のフォーマット制約だ」と言えるようになるのです。「うまくいかなかった、手書きが乱れすぎていたのだろう」ではなく。50ドキュメントの監査は1時間で終わります。そこから得られる洞察 — 抽出パイプラインが実際にどこで失敗しているのか、思い込んでいる場所ではなく — が、次の1時間の改善作業で精度が1桁上がるのか2桁上がるのかを決めます。
監査を実行しましょう。最初の10件のエラーを分類しましょう。終わる前にパターンが見えてきます。