Pourquoi l'extraction de documents manuscrits échoue — et les raisons évitables derrière chaque mode de défaillance
L'extraction de manuscrits échoue selon cinq dimensions évitables : gribouillis, marques pâles, mélange imprimé-manuscrit, illisibilité contextuelle et dégradation mécanique. Découvrez quelles défaillances vous pouvez anticiper.
Points clés à retenir
- Chaque défaillance d'extraction manuscrite que vous avez rencontrée remonte à l'un des huit schémas classifiables exactement, avec une solution connue.
- Vingt à quarante pour cent de vos erreurs d'extraction produisent un résultat qui semble correct mais contient des données qui n'ont jamais été écrites sur la page.
- Une heure de classification des erreurs d'extraction sur cinquante documents avec le cadre de défaillance de cet article vous indique quelle solution spécifique améliore le plus votre précision.
Les trois catégories d'échec d'extraction
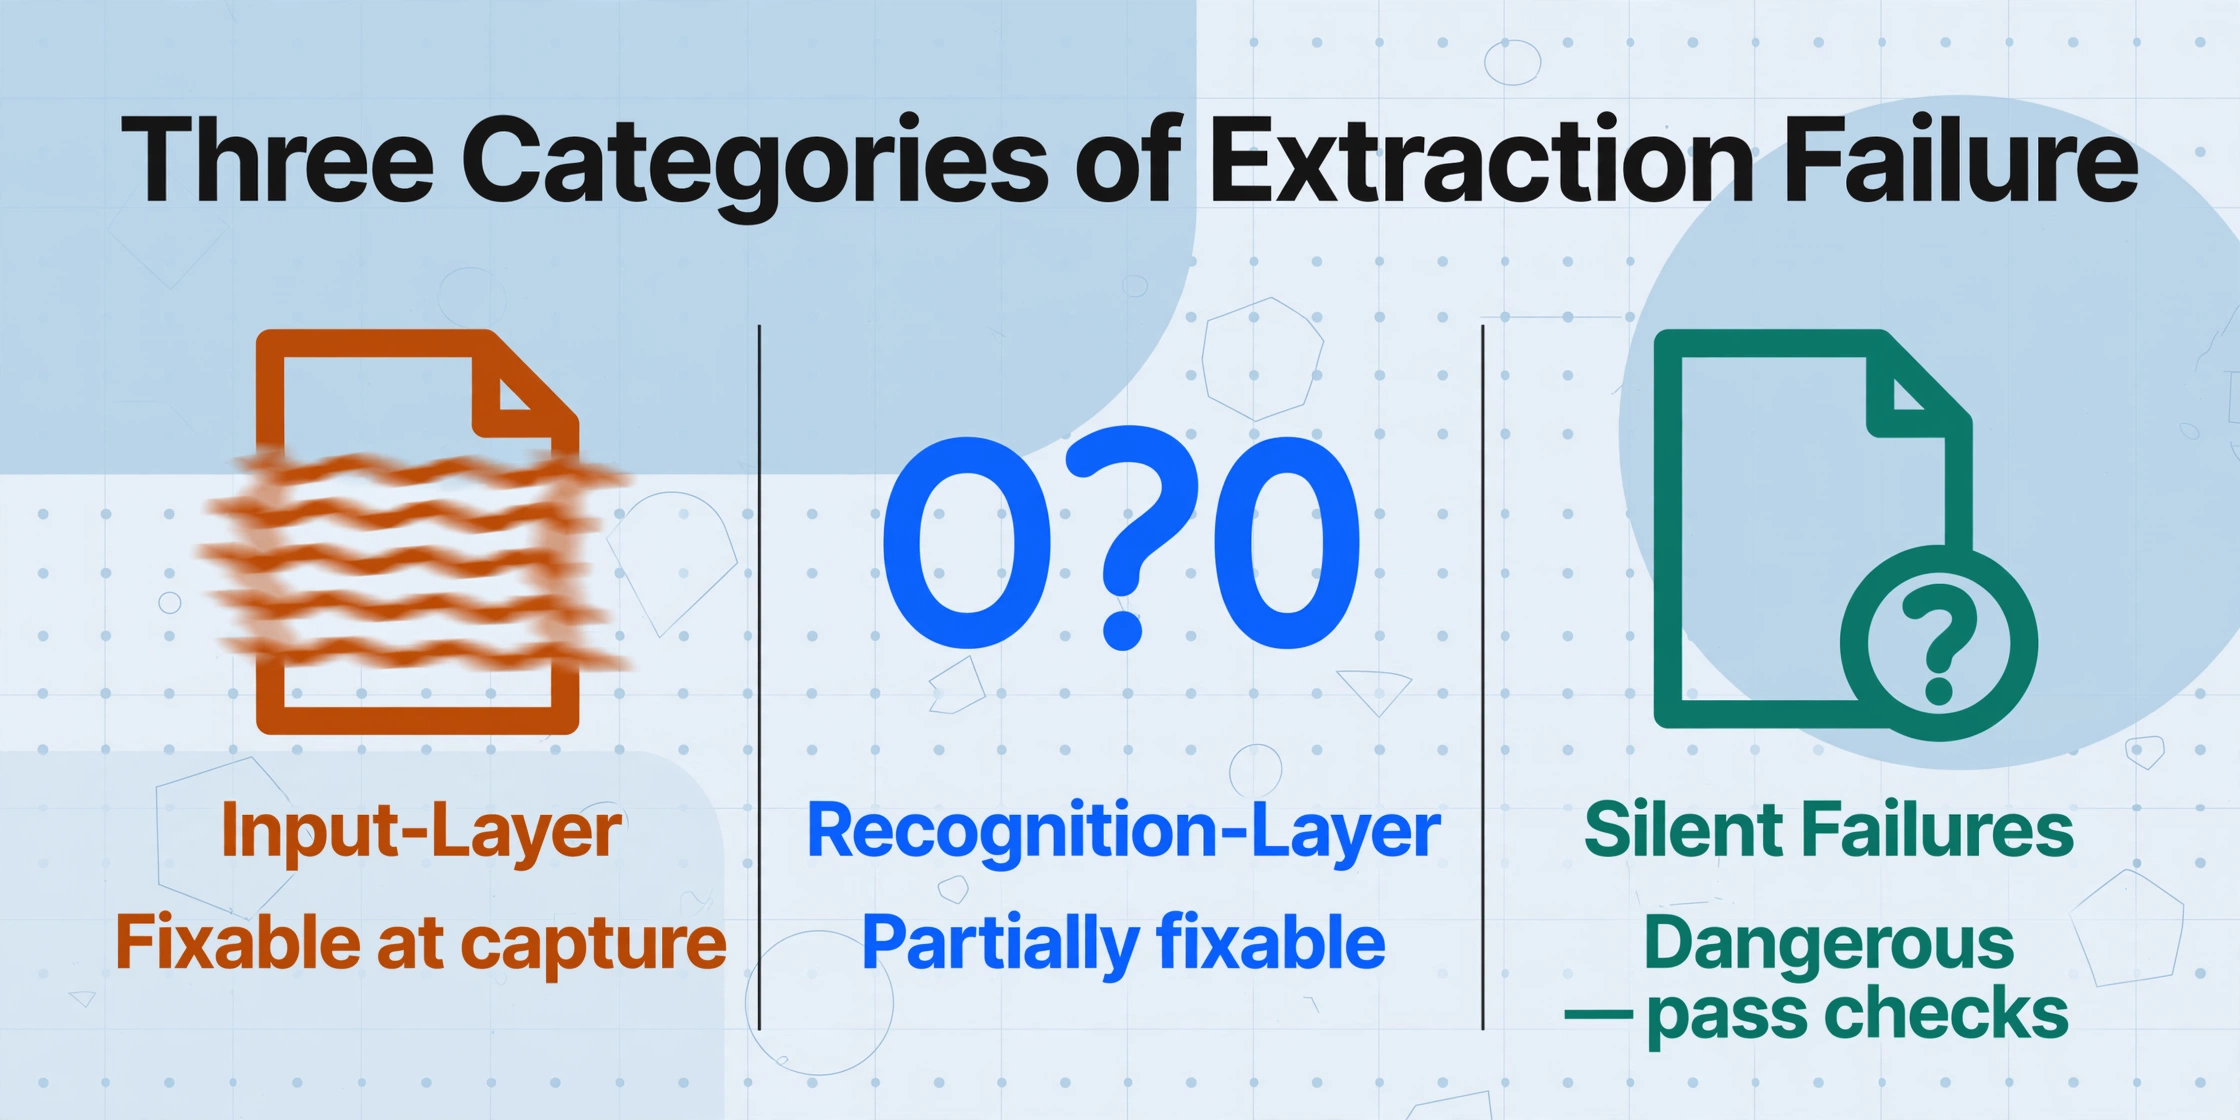
Les erreurs d'extraction de l'écriture manuscrite ne sont pas aléatoires. Elles se répartissent en trois catégories, et savoir à laquelle vos erreurs appartiennent est la première étape pour les corriger — ou pour savoir quand la correction nécessite de modifier vos entrées, et non votre outil.
Les échecs au niveau de l'entrée surviennent avant que le modèle d'IA ne voie le document. Les informations nécessaires à une extraction correcte sont soit absentes de l'image, soit altérées par la manière dont elles ont été capturées. Ce sont les échecs les plus courants et ceux sur lesquels vous avez le plus de contrôle.
Les échecs au niveau de la reconnaissance surviennent pendant l'extraction. Le modèle voit l'entrée mais l'interprète mal — confondant des caractères similaires, gérant mal l'écriture cursive liée, ou n'attribuant pas le texte au bon champ. Ces échecs sont partiellement contrôlables grâce à la qualité des entrées et à la conception des champs, et partiellement inhérents aux limites actuelles de la technologie.
Les échecs silencieux constituent la catégorie dangereuse. La sortie semble correcte. Les champs sont remplis, les formats sont valides, les scores de confiance sont élevés. Mais les données sont erronées — soit parce que le modèle a halluciné une valeur qui n'existait pas, soit parce qu'une seule erreur en amont a eu un effet en cascade sur les champs dépendants sans déclencher aucune validation.
Ces échecs passent les contrôles automatisés et atteignent les systèmes en aval sans être détectés.Règle empirique : si vos extractions échouent de manière visible — champs manquants, texte déformé, erreurs de format — vous avez un problème de couche d'entrée ou de couche de reconnaissance. Si vos extractions échouent silencieusement — des données plausibles mais incorrectes — vous avez un problème d'échec silencieux. La deuxième catégorie est plus difficile à détecter et coûte plus cher lorsqu'elle atteint les systèmes de production.
Catégorie 1 — Défaillances de la couche d'entrée
Défaillance n°1 : le scan flou qui semble net à l'écran
Comment le reconnaître : Les résultats d'extraction contiennent un texte raisonnable pour la moitié des champs et un texte absurde pour l'autre moitié — sans schéma clair. Le document semblait lisible lorsque vous l'avez ouvert, mais la sortie d'extraction suggère que l'IA regardait une image différente.
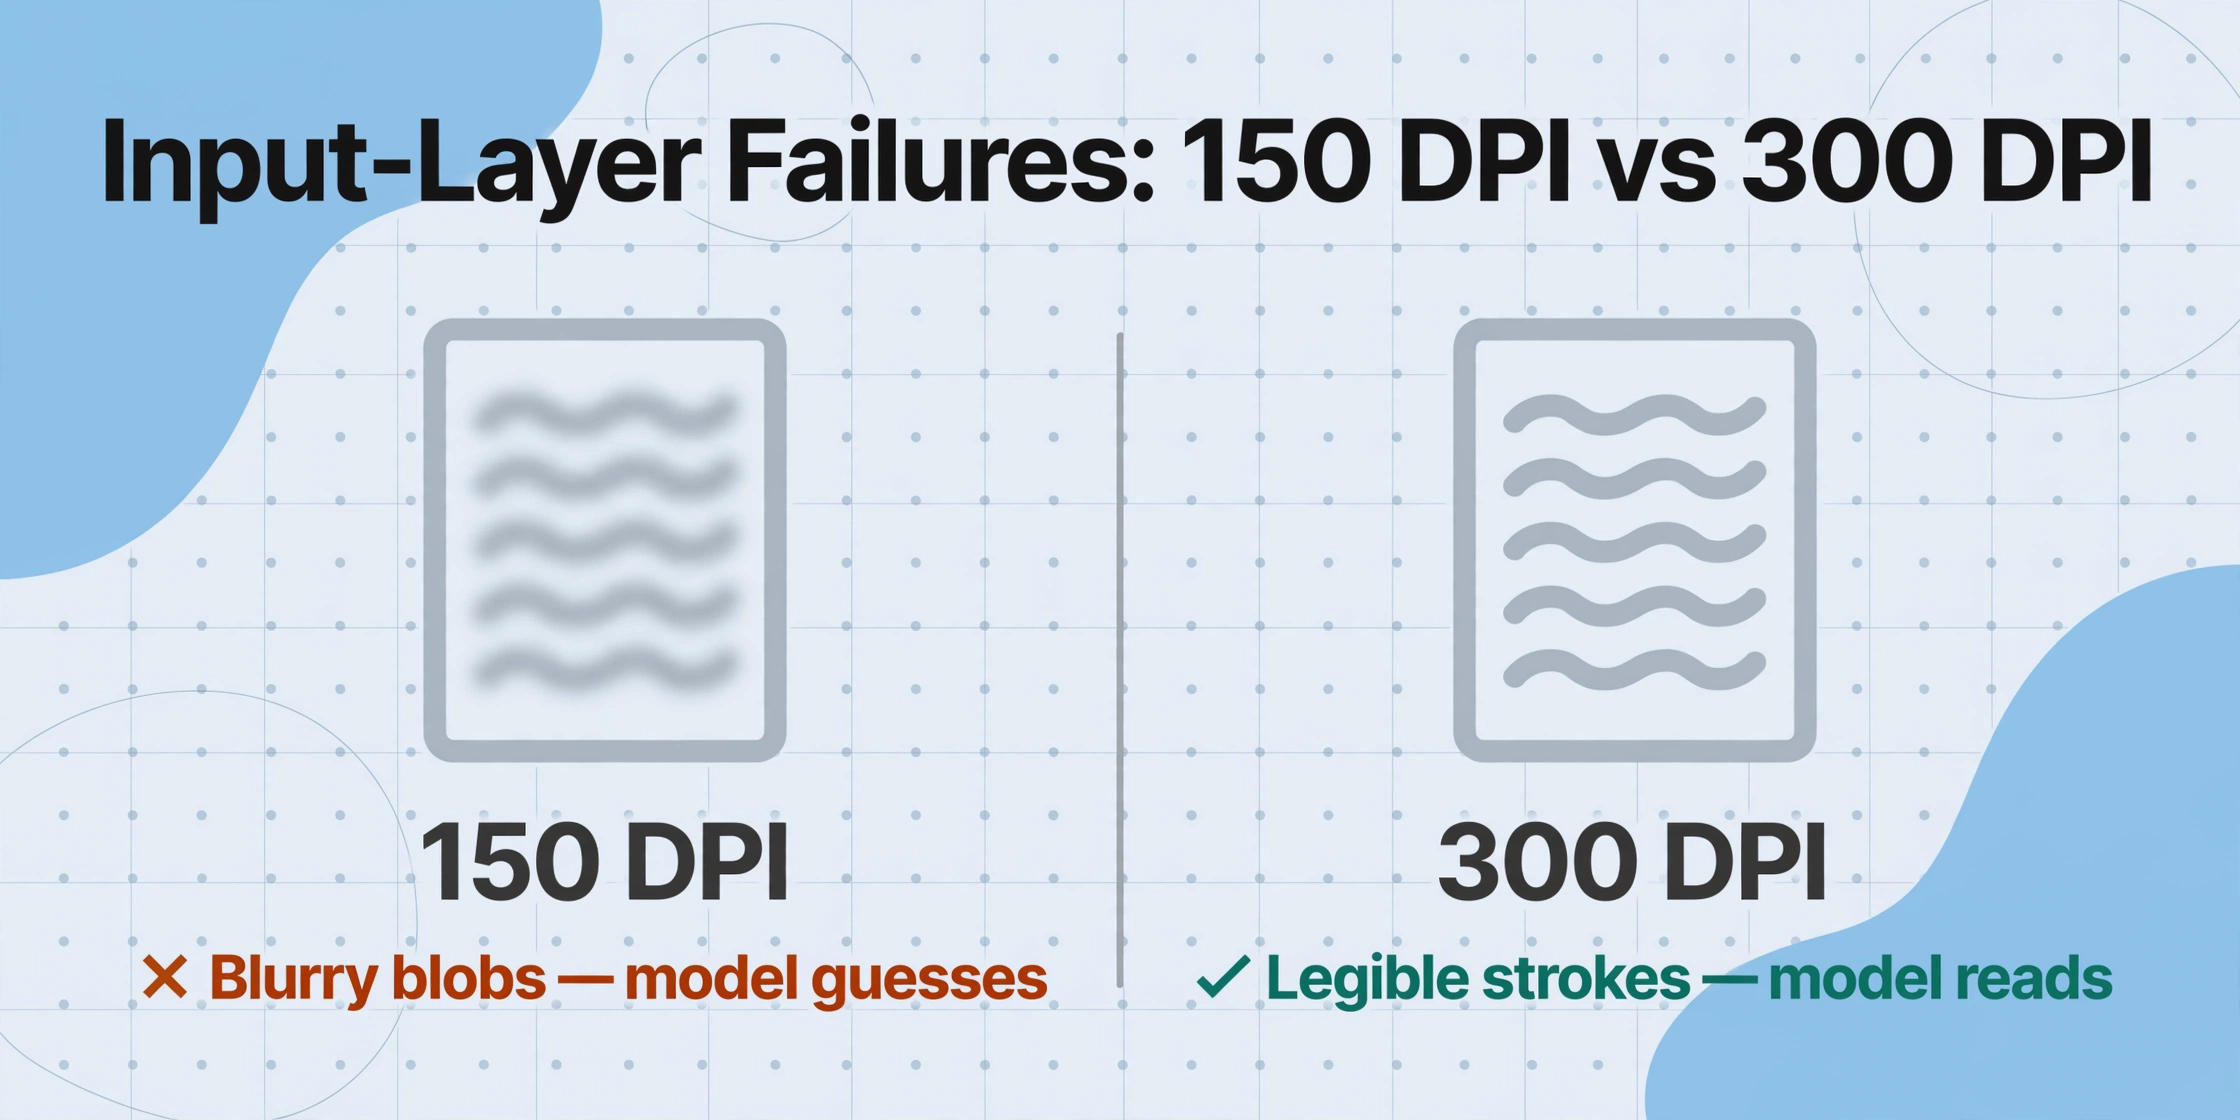
Ce qui se passe réellement : Un document qui semble net sur un moniteur standard à 100 % de zoom peut être trop basse résolution pour une reconnaissance au niveau des caractères. Le système visuel humain comble les lacunes à partir du contexte ; le modèle d'IA travaille à partir des données de pixels réelles. Un scan à 150 DPI d'un « 8 » et d'un « 6 » manuscrits peut contenir suffisamment de pixels pour qu'une personne les distingue par leur forme, mais pas assez pour que le modèle résolve la différence critique dans la boucle inférieure. Le modèle voit une tache ambiguë et devine — produisant une erreur au niveau du champ avec une confiance suffisamment élevée pour passer sans être signalée.
Correctif : Définissez 300 DPI comme minimum pour tout document contenant de l'écriture manuscrite. Pour les documents capturés par téléphone, utilisez une application de numérisation qui applique une correction de perspective et un renforcement du contraste, et non l'application appareil photo par défaut. Testez le même document à 150 DPI, 300 DPI et 600 DPI — le passage de 300 à 600 donne généralement des rendements décroissants, mais le passage de 150 à 300 est le seuil où la reconnaissance de l'écriture manuscrite devient viable plutôt que chanceuse.
Échec n°2 : La note manuscrite enfouie sous le texte imprimé
Comment le reconnaître : La valeur extraite pour un champ est un fragment de l'étiquette imprimée du formulaire, et non la saisie manuscrite. Ou la valeur extraite semble combiner des caractères des deux — « NomClient Jean » où l'étiquette « Nom du client : » est imprimée et « Jean » est écrit à la main en dessous.
Ce qui se passe réellement : Lorsque le texte manuscrit chevauche ou se trouve directement au-dessus/en dessous des étiquettes imprimées, le moteur d'extraction doit séparer deux flux de texte occupant la même zone visuelle. Les moteurs OCR traditionnels échouent ici de manière catastrophique — ils lisent tous les pixels de la zone comme une seule ligne de texte. Les systèmes basés sur VLM gèrent mieux le texte superposé car ils comprennent la structure du document, mais la précision diminue encore de 5 à 8 points de pourcentage. Le cas de la communauté UiPath — où les noms de locataires manuscrits chevauchaient les étiquettes de champs imprimées sur un formulaire d'enregistrement de location — est un exemple typique de cette classe d'échec (Forum communautaire UiPath, 2024).
Correctif : Lors de la conception de formulaires pour l'extraction, laissez un espace vertical clair entre les étiquettes imprimées et les zones d'écriture manuscrite. Un écart minimum de 6 mm réduit considérablement les erreurs de chevauchement. Pour les formulaires existants, prétraitez l'image pour augmenter le contraste entre le texte imprimé (généralement plus foncé/plus uniforme) et le texte manuscrit (généralement plus clair/plus varié). Si le prétraitement n'est pas possible, acheminez ces documents vers un pipeline basé sur VLM — il gère mieux la séparation du contenu mixte que l'OCR traditionnel, même imparfaitement.
Échec n°3 : Le formulaire modifié sans préavis
Comment le reconnaître : L'extraction fonctionne parfaitement pendant des semaines, puis échoue soudainement sur un lot — les champs qui étaient extraits correctement et systématiquement renvoient désormais des valeurs vides ou erronées. Les documents semblent identiques à première vue.
Ce qui se passe réellement : Un fournisseur, un client ou un service a modifié la mise en page de son formulaire — a déplacé un champ d'un centimètre, renommé une étiquette, ajouté un logo empiétant sur la zone de texte. Si votre configuration d'extraction repose sur des modèles avec des coordonnées fixes ou une correspondance rigide des noms de champs, même un changement de mise en page mineur casse l'ensemble du pipeline. C'est le mode d'échec le plus courant dans l'extraction basée sur des modèles, et c'est un problème structurel, pas un problème de précision — le moteur d'extraction fonctionne exactement comme configuré ; la configuration est devenue invalide pour la nouvelle entrée.
Correctif : Utilisez des méthodes d'extraction qui comprennent la sémantique des champs plutôt que de se fier à des modèles positionnels. L'extraction par colonne personnalisée — où vous définissez les champs par leur signification (« Total facture », « Date de livraison ») et l'IA les localise en comprenant le contenu du document — élimine complètement la fragilité des modèles. La même définition de colonne fonctionne sur différentes mises en page de formulaires provenant de sources différentes car l'IA recherche un sens sémantique, et non des coordonnées de pixels. C'est l'une des différences architecturales fondamentales entre les pipelines OCR traditionnels et l'extraction moderne basée sur l'IA, comme exploré dans notre comparaison des deux approches.
Catégorie 2 — Défaillances de la couche de reconnaissance
Défaillance n° 4 : « 0 » devient « O » — le piège de l'ambiguïté des caractères
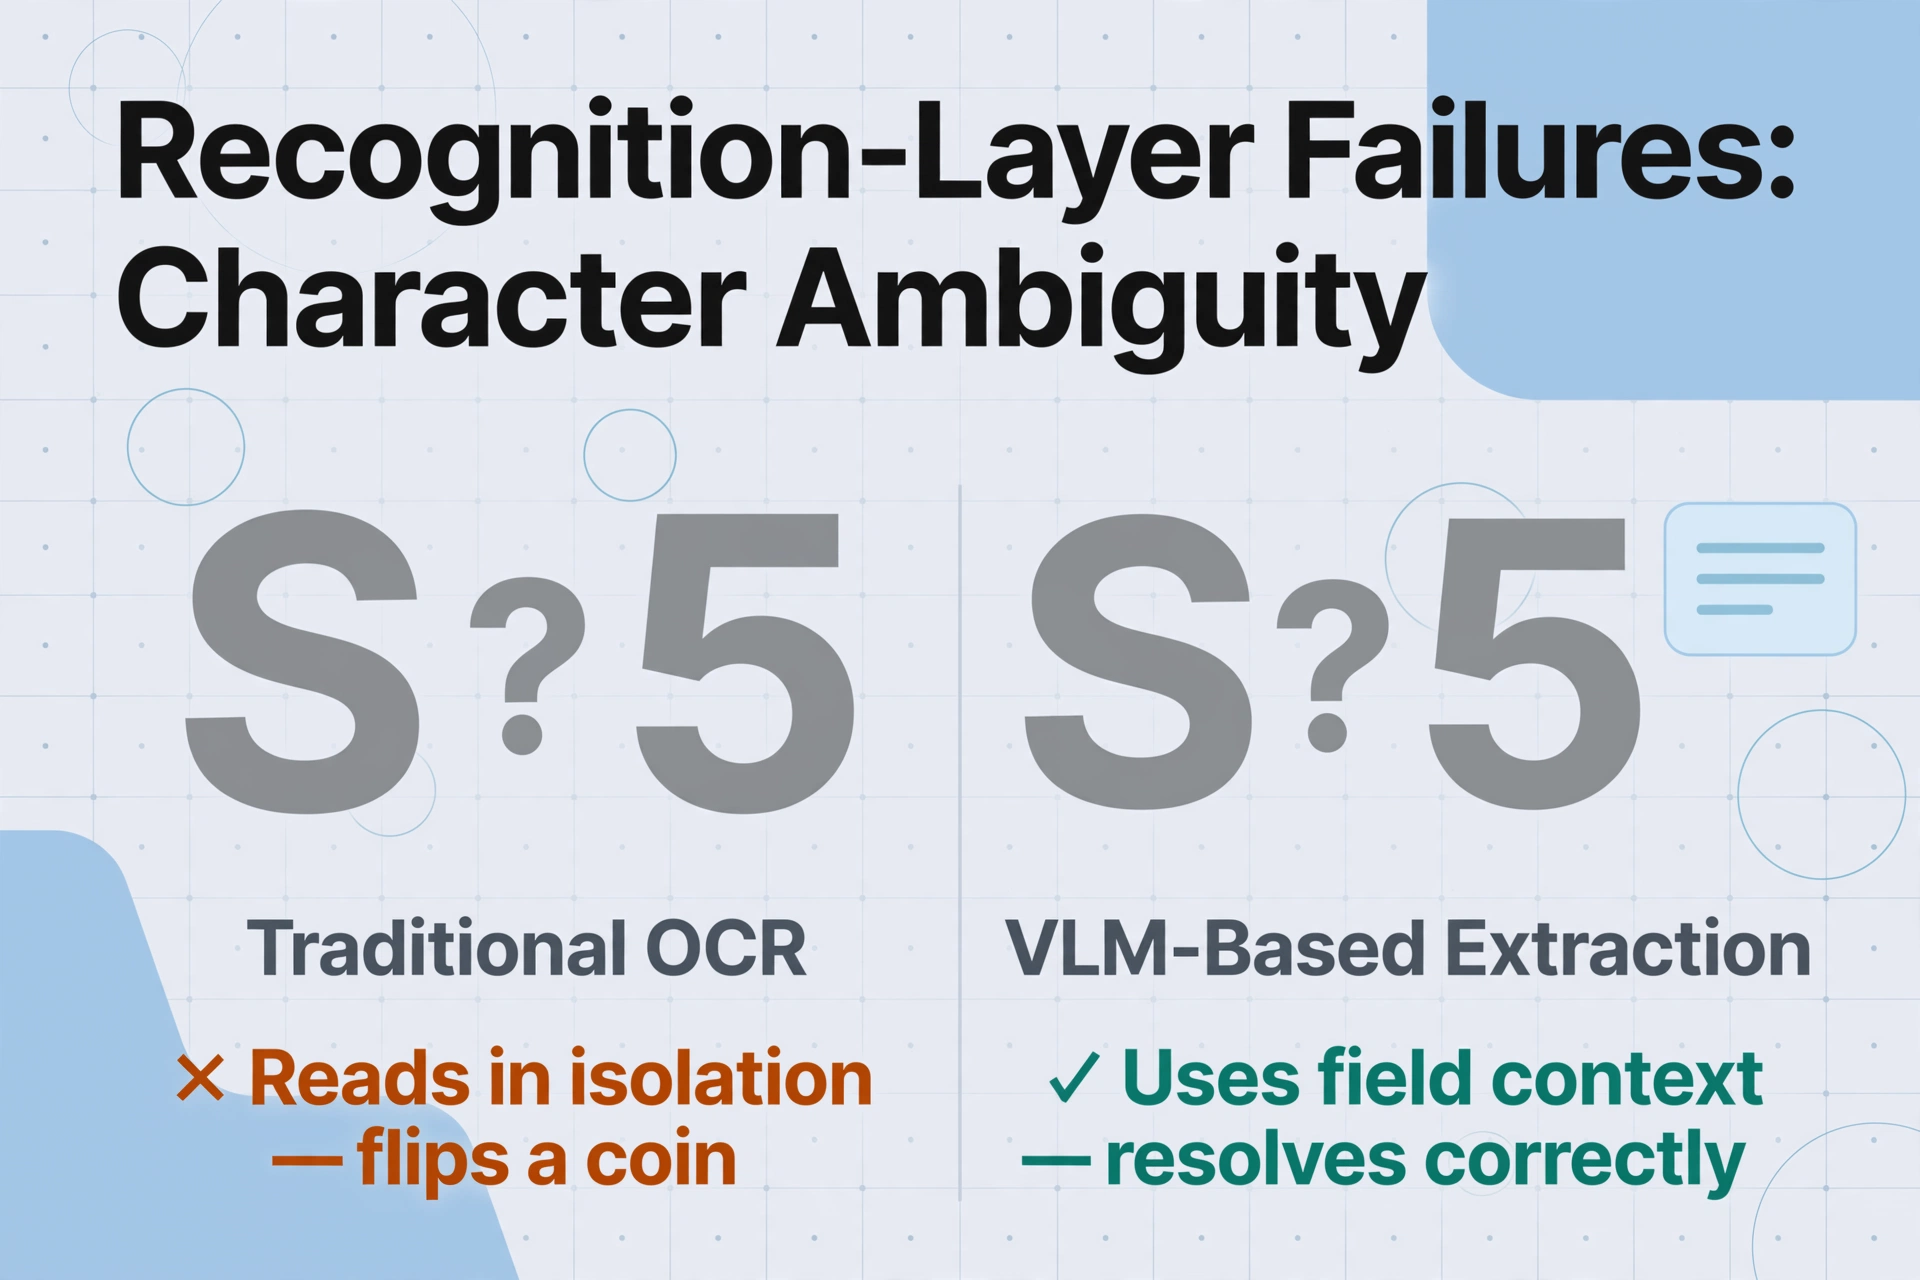
Comment la reconnaître : Le texte extrait contient des lettres là où des chiffres devraient se trouver, et inversement — « S » au lieu de « 5 », « O » au lieu de « 0 », « l » au lieu de « 1 », « B » au lieu de « 8 ». Le schéma d'erreur est cohérent : toutes les erreurs sont des quasi-voisins visuels en isolation.
Ce qui se passe réellement : Lorsque les caractères sont lus en isolation — comme le fait le ROC traditionnel — les formes ambiguës correspondent par défaut au caractère dont le motif de pixels est le plus proche dans les données d'entraînement du moteur. Un « 5 » manuscrit avec un sommet plat et une base ouverte présente presque le même motif de pixels qu'un « S » manuscrit. Sans indices contextuels (ce champ doit contenir un nombre), le moteur tire à pile ou face. Sur les formulaires comportant des champs numériques manuscrits — quantités livrées, montants de factures, relevés de compteurs — cette seule classe de défaillance représente la majorité des erreurs d'extraction. Un utilisateur de Reddit ayant évalué plusieurs outils de ROC a constaté que même les systèmes dotés d'interfaces soignées produisaient de « nombreuses erreurs de transcription manuscrite » sur des tableaux à contenu alphanumérique mixte (r/computervision, 2024).
Correctif : La solution dépend de votre approche d'extraction. Pour le ROC traditionnel, des règles de validation en post-traitement — « ce champ doit être numérique » — permettent de détecter la plupart des ambiguïtés de caractères après l'extraction. Pour l'extraction basée sur VLM, la compréhension contextuelle du modèle résout généralement ces ambiguïtés automatiquement, car il sait qu'une valeur numérique appartient à un champ « Montant total ». Si vous utilisez l'Extraction de colonnes personnalisées avec un backend VLM, préciser le format attendu dans le nom de la colonne (« Montant total (numérique) ») donne au modèle une contrainte explicite qui résout l'ambiguïté avant que la valeur n'entre dans votre sortie.
Échec n°5 : « Hand Writing » — Quand les mots se coupent et se mélangent
Comment le reconnaître : Le texte extrait contient des coupures de mots fantômes — « handwriting » devient « hand writing », « the man » devient « them an », « invoice number » devient « invoicen umber ». Ou l'inverse : deux champs manuscrits distincts fusionnent parce que la plume a dérivé par-dessus l'espace.
Ce qui se passe réellement : La segmentation des mots — savoir où un mot se termine et où le suivant commence — est triviale pour le texte imprimé dont l'espacement est régulier. Pour l'écriture manuscrite, l'espacement est un choix de l'auteur, et il varie. Certains laissent de grands écarts entre les lettres d'un même mot et de petits écarts entre les mots ; d'autres relient chaque lettre d'une phrase sans lever le stylo. Le moteur d'extraction applique un seuil d'espacement calibré sur une écriture moyenne — mais votre auteur n'est pas dans la moyenne. Le résultat : des erreurs de segmentation qui transforment un texte cohérent en salade de mots.
Solution : Les systèmes basés sur VLM gèrent mieux les erreurs de segmentation que l'OCR traditionnel, car ils utilisent la compréhension du langage pour reconstruire les limites des mots — « them an » n'est pas une phrase significative, et la connaissance linguistique du modèle la corrige en « the man » lors de la génération du texte. C'est un cas où le raisonnement contextuel de l'IA corrige activement une erreur de reconnaissance. La solution côté conception du document : lorsque c'est possible, utilisez des formulaires avec des cases individuelles pour les caractères (une case par lettre) plutôt que des lignes ouvertes pour le texte libre. Les formulaires fiscaux gouvernementaux utilisent cette conception précisément parce qu'elle élimine l'ambiguïté de segmentation — une contrainte qui profite à la fois aux lecteurs humains et à l'extraction automatique.
Échec n°6 : Une cursive qui ressemble à un alphabet différent
Comment le reconnaître : Les champs de texte imprimé s'extraient parfaitement. Les champs en cursive — surtout ceux avec des boucles connectées, des caractères inclinés ou une écriture serrée — renvoient des résultats à peine reconnaissables comme les mêmes mots. Un mot simple en cursive comme « world » revient sous la forme « wriod ».
Ce qui se passe réellement : L'écriture cursive remplace les formes de lettres distinctes par des traits continus. La lettre « e » au milieu d'un mot en cursive ne ressemble en rien à un « e » imprimé isolé — c'est une boucle attachée à la lettre précédente et suivante. L'approche de l'OCR traditionnel, qui segmente d'abord les caractères, ne peut pas séparer des caractères qui n'ont jamais été écrits séparément. La génération 2025-2026 des VLM gère mieux la cursive car ils traitent les formes des mots de manière holistique plutôt que d'assembler des caractères, mais le plafond de précision reste nettement inférieur à celui du texte imprimé ou de l'écriture en script. Des benchmarks indépendants montrent une précision de 75 à 88 % sur la cursive complète contre 85 à 93 % sur le script — un écart qui reflète la difficulté inhérente à la saisie, et non une déficience d'un modèle particulier (Suparse, 2026).
Solution : Il n'existe pas de solution technologique pour rendre la cursive aussi précise que le script — c'est un véritable plafond de précision. L'atténuation pratique est une approche à deux niveaux : pour les documents où les champs en cursive sont informatifs (notes, commentaires, descriptions), acceptez la précision moindre et utilisez un routage basé sur la confiance pour signaler les extractions à faible confiance pour révision humaine. Pour les documents où les champs en cursive sont transactionnels (montants, numéros de compte, identifiants légaux), exigez que ces champs soient écrits en majuscules script — c'est une règle de processus, pas une solution technologique. La refonte du formulaire qui ajoute des instructions « ÉCRIRE EN MAJUSCULES » et des zones d'écriture contraintes réduit le volume de champs en cursive à la source. Les améliorations de précision possibles grâce à la qualité de la saisie et à la conception des colonnes sont couvertes dans notre guide complet de précision.
Catégorie 3 — Les échecs silencieux
Échec n°7 : Les données qui n'ont jamais existé — Hallucination de l'IA
Comment le reconnaître : Les symptômes les plus insidieux. Chaque champ de la sortie d'extraction est renseigné. Les valeurs sont correctement formatées. Rien ne déclenche d'erreur de validation. Mais en recoupant la sortie avec le document original, on découvre qu'un ou plusieurs champs contiennent des données que l'auteur n'a jamais saisies — une date remplie là où le champ était vide, un montant en dollars qui semble correct mais ne correspond pas à la source, un nom de fournisseur que le modèle a déduit du contexte sur une autre partie de la page.
Ce qui se passe réellement : Les modèles d'extraction basés sur VLM génèrent du texte, ils ne se contentent pas de reconnaître des caractères. Lorsqu'un champ est réellement vide ou que l'écriture est illisible, le modèle peut produire une valeur plausible basée sur ce qui « devrait » s'y trouver — la même capacité de raisonnement qui rend les VLM si efficaces pour lever l'ambiguïté d'une écriture manuscrite brouillonne devient un inconvénient lorsqu'elle passe de la désambiguïsation à la fabrication. C'est ce mode d'échec qui distingue le plus nettement l'extraction basée sur l'IA de la ROC traditionnelle : la ROC traditionnelle ne renvoie rien ou des données inexploitables pour les champs vides ou illisibles (échec détectable), tandis que l'extraction par VLM peut renvoyer des données convaincantes mais fictives (échec indétectable). Un utilisateur de Reddit ayant testé plusieurs outils l'a noté explicitement : « ChatGPT peut fournir une conversion d'écriture manuscrite en texte très impressionnante, mais il souffre aussi d'hallucinations et ne parvient pas à extraire de manière fiable des données structurées » (r/computervision, 2024).
Correctif : L'hallucination ne peut pas être éliminée — elle est inhérente aux modèles génératifs. Elle peut être contenue. Trois niveaux de défense : premièrement, utilisez des systèmes d'extraction qui fournissent des scores de confiance par champ et définissez un seuil de confiance élevé (0,90+) pour les champs où les erreurs sont coûteuses. Deuxièmement, mettez en place des règles de validation croisée entre champs — si le champ « Montant total » est renseigné, les champs de lignes qui s'y additionnent devraient également l'être. Un champ de ligne vide avec un total renseigné est un signal d'alarme d'hallucination. Troisièmement, pour les flux de travail critiques, maintenez une étape de revue humaine sur un échantillon de sorties à haute confiance — non pas pour corriger les erreurs signalées par le système, mais pour détecter les erreurs dont le système était confiant. Il s'agit d'une stratégie de revue différente de la correction d'erreurs de la ROC traditionnelle, et elle est essentielle pour les pipelines basés sur VLM.
Échec n°8 : La case à cocher qui contrôle tout
Comment le reconnaître : Les données extraites contiennent des informations dans des champs qui devraient être vides — des détails d'antécédents médicaux sur un formulaire où « Aucun antécédent » a été coché, des champs dépendants renseignés alors que la condition parente était marquée comme fausse. Les extractions individuelles semblent correctes isolément ; l'erreur réside dans la relation structurelle entre les champs.
Ce qui se passe réellement : Les formulaires à logique conditionnelle — cochez cette case pour afficher des sections supplémentaires, répondez « Oui » pour développer, sélectionnez une option pour en masquer d'autres — créent des dépendances structurelles entre les champs. Si l'extraction manque la case à cocher, ou interprète « Oui » comme « Non », chaque champ dépendant devient incorrect, même si les caractères individuels ont été lus parfaitement. Une seule erreur binaire se propage en de multiples échecs de champs. C'est un mode d'échec d'ordre supérieur : l'extraction est exacte au niveau des caractères mais structurellement erronée. C'est le mode d'échec le moins discuté dans les benchmarks des fournisseurs, car ceux-ci évaluent généralement les champs individuellement, sans tenir compte des dépendances croisées (ImageToTable.ai, 2025).
Correctif : Concevez votre ensemble de colonnes d'extraction pour capturer explicitement les champs déclencheurs conditionnels. Si votre formulaire médical comporte « Antécédents (Oui/Non) », faites-en une colonne distincte. Créez ensuite des règles de validation : si « Antécédents » est égal à « Non », le champ « Détails des antécédents » doit être vide. Si « Antécédents » est égal à « Oui » et que « Détails des antécédents » est vide, signalez-le pour révision. Cela transforme une défaillance structurelle silencieuse en une erreur de validation détectable. Pour les formulaires avec une logique conditionnelle étendue, orientez un pourcentage plus élevé d'extractions vers une révision humaine — le coût d'une cascade conditionnelle manquée est plus élevé que celui de la révision d'un formulaire peut-être correctement extrait.
Comment auditer vos propres résultats d'extraction
Les modes de défaillance ci-dessus constituent un cadre de diagnostic. Voici comment l'appliquer à vos propres documents sans passer des heures en relecture manuelle.
Étape 1 : Prélevez un échantillon aléatoire de 50 documents issus de votre flux de production. Pas les plus propres — incluez ceux avec des annotations en marge, des valeurs barrées, des écritures manuscrites mélangées. C'est là que les défaillances se concentrent.
Étape 2 : Pour chaque champ de chaque document, notez-le comme : correct, erroné-et-évident (texte illisible, valeurs manquantes, erreurs de format), ou erroné-mais-plausible (semble correct, mais est faux). Le ratio entre erroné-et-évident et erroné-mais-plausible vous indique si votre profil de défaillance est principalement lié à la saisie/reconnaissance (erreurs évidentes) ou silencieux (erreurs plausibles). La plupart des équipes découvrent que 20 à 40 % de leurs erreurs sont erronées-mais-plausibles — la catégorie qu'elles ne suivaient pas.
Étape 3 : Pour chaque extraction erronée, classez le mode de défaillance à l'aide des huit schémas ci-dessus. Cela prend environ 30 secondes par erreur une fois les catégories maîtrisées. Après avoir classé 50 documents, vous obtiendrez un profil de défaillance : 40 % couche de saisie (corrigez votre processus de capture), 35 % couche de reconnaissance (améliorez la conception des champs et le nommage des colonnes), 25 % silencieux (ajoutez des règles de validation et des points de contrôle de relecture humaine). Ce profil vous indique où investir — pas dans des efforts généraux d'« amélioration de la précision », mais dans l'intervention spécifique qui correspond à votre schéma de défaillance réel.
Étape 4 : Appliquez la correction qui correspond à votre catégorie de défaillance principale. Si les défaillances de la couche de saisie dominent, améliorez d'abord votre processus de numérisation avant de toucher à quoi que ce soit d'autre. Si les défaillances silencieuses représentent une part plus importante que prévu, ajoutez des règles de validation et augmentez le taux d'échantillonnage de votre relecture humaine. Mesurez à nouveau après la correction sur un nouvel échantillon de 50 documents. L'évolution du profil de défaillance — et non le chiffre absolu de précision — vous indique si l'intervention a fonctionné.
FAQ
Comment savoir si mes erreurs d'extraction viennent de l'outil ou de mes documents ?
Exécutez le même document via deux méthodes d'extraction différentes — par exemple, une chaîne OCR classique et un outil d'extraction basé sur un VLM. Si les deux échouent sur les mêmes champs, le document est en cause (probablement une qualité d'entrée médiocre ou une écriture manuscrite illisible). Si l'un extrait correctement et l'autre non, l'outil ou sa configuration est le goulot d'étranglement. Ce test différentiel isole la variable en quelques minutes.
Puis-je empêcher complètement l'hallucination de l'IA ?
Non. L'hallucination est inhérente aux modèles d'IA générative et ne peut être éliminée par la configuration ou une meilleure qualité d'entrée. Ce que vous pouvez faire, c'est la contenir : utilisez un score de confiance pour identifier les extractions à faible confiance, mettez en place des règles de validation croisée des champs qui détectent les résultats invraisemblables, et maintenez une étape de relecture humaine qui échantillonne les extractions à haute confiance — spécifiquement pour détecter les erreurs dont le système était confiant, qui sont les plus susceptibles d'être des hallucinations.
Pourquoi mes extractions fonctionnent-elles parfaitement sur des documents de test mais échouent-elles en production ?
C'est presque toujours un problème de variété de documents. Les documents de test ont tendance à être propres, récents et représentatifs du cas moyen. Les documents de production incluent la longue traîne — des fax de 2018, des formulaires remplis au stylo à bille dans un camion en mouvement, des documents avec des taches de café et des notes en marge. Les modes de défaillance de cet article se concentrent dans les 10 à 15 % les plus mauvais de votre flux d'entrée. Si votre ensemble de test n'inclut pas ces documents, il ne mesure pas ce qui compte. Ajoutez les 20 documents les plus désordonnés de votre dernier lot de production à votre ensemble de test et relancez.
Quel est le mode de défaillance le plus courant que vous observez ?
L'ambiguïté des caractères dans les champs numériques manuscrits — "5" lu comme "S", "0" comme "O", "1" comme "l" — est responsable de plus d'erreurs d'extraction que toute autre cause unique. C'est une défaillance de la couche de reconnaissance que les améliorations de la qualité d'entrée (résolution plus élevée, meilleur éclairage) réduisent mais n'éliminent pas. L'atténuation la plus efficace est l'utilisation de contraintes de format au niveau du champ : indiquer au système d'extraction qu'une colonne donnée ne doit contenir que des valeurs numériques. Cela peut être fait dans la définition de la colonne elle-même lorsque le système prend en charge les indications de format.
Dois-je repenser tous mes formulaires avant d'extraire ?
Pour les formulaires que vous contrôlez (formulaires internes, documents de collecte que vous concevez), oui — les repenser en vue de l'extraction (cases individuelles, séparation claire étiquette-champ, zones d'écriture limitées, consignes « ÉCRIRE EN MAJUSCULES ») est l'investissement le plus rentable. Pour les formulaires que vous ne contrôlez pas (factures fournisseurs, documents clients, formulaires administratifs), concentrez-vous plutôt sur la qualité des entrées et la conception des champs — ce sont les variables sur lesquelles vous pouvez agir quand vous ne pouvez pas modifier le formulaire lui-même.
Arrêtez de deviner, commencez à diagnostiquer
Les échecs d'extraction semblent aléatoires jusqu'à ce que vous les classiez. Les huit schémas ci-dessus vous donnent un langage de diagnostic — une façon de regarder un résultat erroné et de dire : « C'est l'échec n°4, ambiguïté de caractère, et la solution est une contrainte de format sur la définition de colonne », au lieu de : « Ça n'a pas marché, l'écriture était trop illisible. » L'audit de 50 documents prend une heure. L'information qu'il produit — là où votre pipeline d'extraction échoue réellement, et non là où vous supposez qu'il échoue — détermine si votre prochaine heure d'amélioration fera progresser la précision de quelques points ou de plusieurs dizaines.
Réalisez l'audit. Classez vos dix premières erreurs. Le schéma sera visible avant même d'avoir terminé.