Por qué falla la extracción de documentos manuscritos — y las razones prevenibles detrás de cada modo de fallo
La extracción de manuscritos falla en cinco dimensiones prevenibles: garabatos, marcas tenues, mezcla de imprenta y manuscrito, ilegibilidad contextual y degradación mecánica. Aprenda qué fallos puede anticipar.
Puntos clave
- Cada fallo de extracción de manuscritos que usted ha visto se remonta a uno de exactamente ocho patrones clasificables con una solución conocida.
- Entre el veinte y el cuarenta por ciento de sus errores de extracción producen resultados que parecen correctos pero contienen datos que nunca se escribieron en la página.
- Una hora clasificando errores de extracción en cincuenta documentos con el marco de fallos de este artículo le indica qué solución específica mejora más su precisión.
Las tres categorías de fallos de extracción
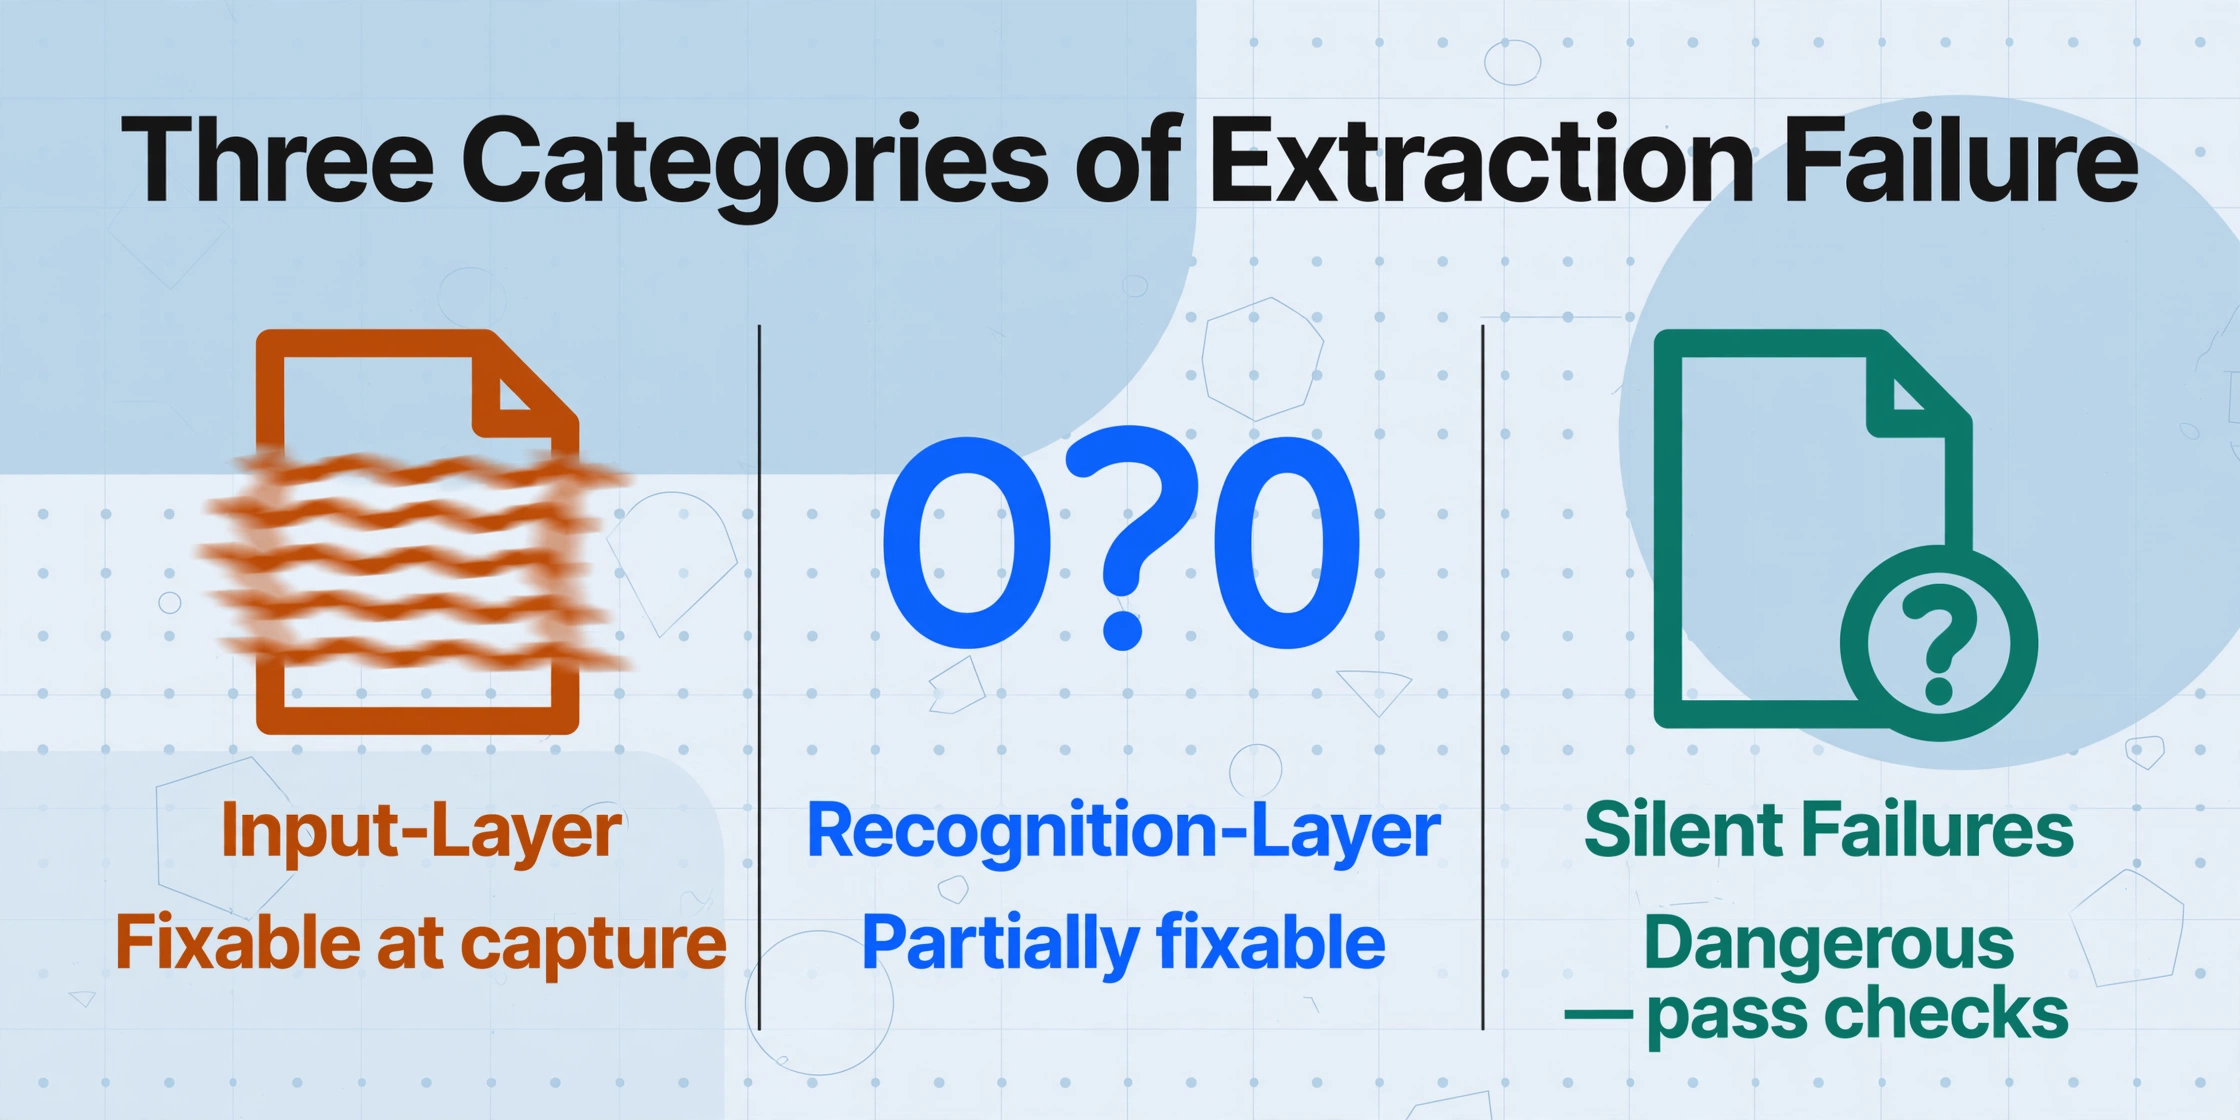
Los errores de extracción de escritura a mano no son aleatorios. Se dividen en tres categorías, y saber a cuál pertenecen sus errores es el primer paso para corregirlos, o para saber cuándo la solución exige cambiar sus entradas, no su herramienta.
Los fallos de capa de entrada ocurren antes de que el modelo de IA vea el documento. La información necesaria para una extracción correcta falta en la imagen o está corrompida por la forma en que se capturó. Son los fallos más comunes y los que más están bajo su control.
Los fallos de capa de reconocimiento ocurren durante la extracción. El modelo ve la entrada, pero la interpreta mal: confunde caracteres similares, maneja mal la escritura conectada o no logra atribuir el texto al campo correcto. Estos fallos son parcialmente controlables mediante la calidad de la entrada y el diseño de campos, y parcialmente inherentes a los límites actuales de la tecnología.
Los fallos silenciosos son la categoría peligrosa. La salida parece correcta. Los campos están completos, los formatos son válidos, las puntuaciones de confianza son altas. Pero los datos son incorrectos, ya sea porque el modelo alucinó un valor que no existía o porque un único error anterior se propagó por campos dependientes sin activar ninguna validación.
Estos fallos superan las comprobaciones automáticas y llegan a los sistemas posteriores sin ser detectados.Regla general: si sus extracciones fallan de forma evidente — campos faltantes, texto distorsionado, errores de formato — tiene un problema en la capa de entrada o en la capa de reconocimiento. Si sus extracciones fallan en silencio — datos que parecen plausibles pero son incorrectos — tiene un problema de fallo silencioso. La segunda categoría es más difícil de detectar y cuesta más cuando llega a los sistemas de producción.
Categoría 1 — Fallos en la capa de entrada
Fallo n.º 1: El escaneo borroso que se ve bien en pantalla
Cómo reconocerlo: Los resultados de la extracción contienen texto razonable en la mitad de los campos y sinsentidos en la otra mitad — sin un patrón claro. El documento se veía legible cuando lo abrió, pero el resultado de la extracción sugiere que la IA estaba mirando una imagen diferente.
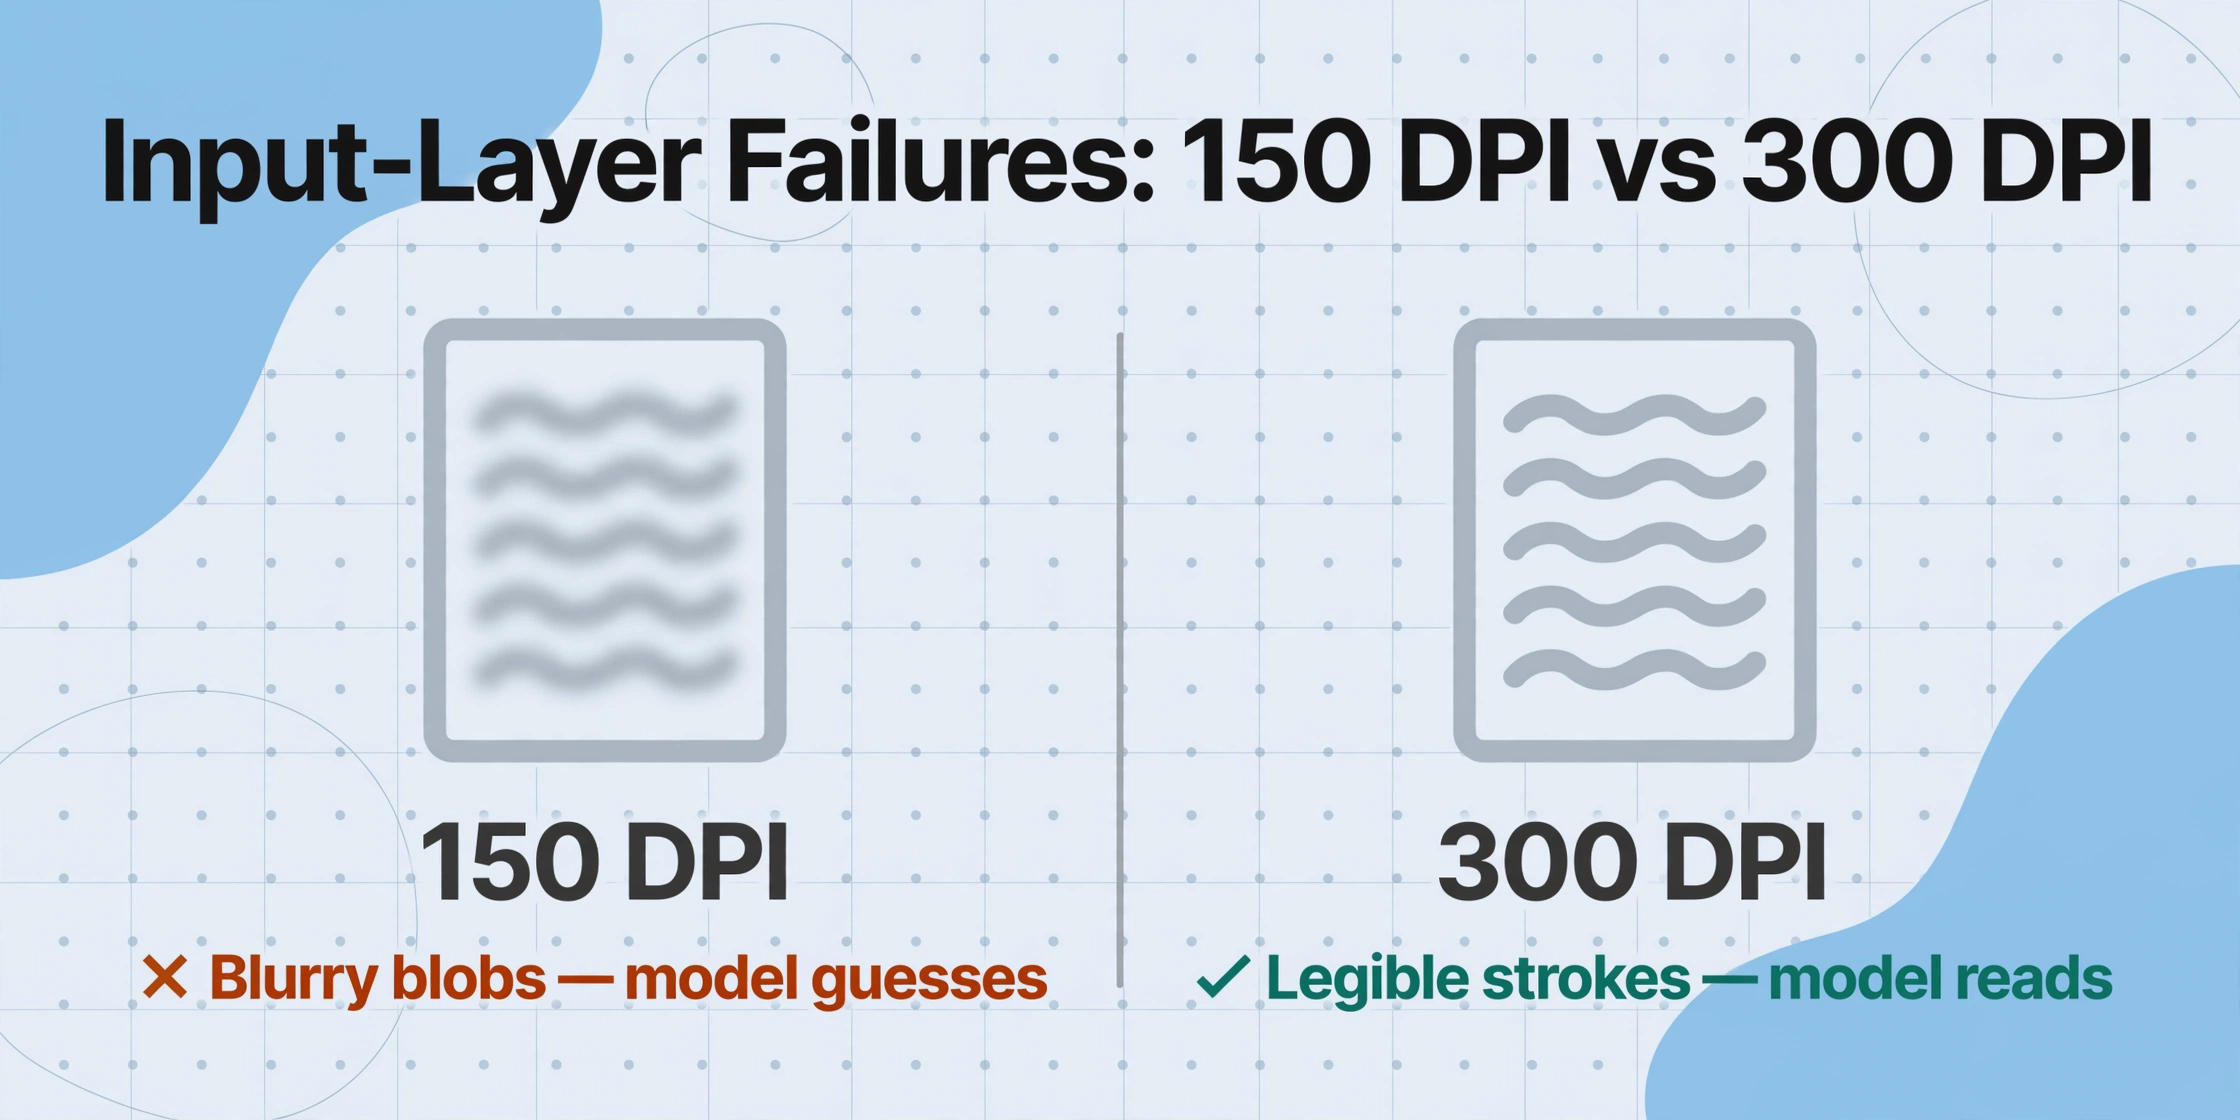
Qué está pasando en realidad: Un documento que se ve nítido en un monitor estándar al 100 % de zoom puede tener una resolución demasiado baja para el reconocimiento a nivel de carácter. El sistema visual humano rellena los huecos a partir del contexto; el modelo de IA trabaja con los datos de píxeles reales. Un escaneo a 150 DPI de un "8" y un "6" manuscritos puede contener suficientes píxeles para que una persona los distinga por su forma, pero no los suficientes para que el modelo resuelva la diferencia crítica en el bucle inferior. El modelo ve una mancha ambigua y adivina — produciendo un error a nivel de campo con una confianza lo bastante alta como para pasar sin ser señalado.
Solución: Establezca 300 DPI como mínimo para cualquier documento con escritura a mano. Para documentos capturados con el teléfono, use una aplicación de escaneo que aplique corrección de perspectiva y mejora del contraste, no la aplicación de cámara predeterminada. Pruebe el mismo documento a 150 DPI, 300 DPI y 600 DPI — el salto de 300 a 600 suele dar rendimientos decrecientes, pero el salto de 150 a 300 es el umbral en el que el reconocimiento de escritura a mano se vuelve viable en lugar de afortunado.
Fallo n.º 2: La nota manuscrita enterrada bajo el texto impreso
Cómo reconocerlo: El valor extraído de un campo es un fragmento de la etiqueta impresa del formulario, no la entrada manuscrita. O el valor extraído parece combinar caracteres de ambos: «Customer NamJohn», donde la etiqueta del formulario «Customer Name:» está impresa y «John» está manuscrito debajo.
Qué está ocurriendo en realidad: Cuando el texto manuscrito se superpone o queda directamente encima o debajo de las etiquetas impresas del formulario, el motor de extracción debe separar dos flujos de texto que ocupan la misma región visual. Los motores OCR tradicionales fallan catastróficamente en este punto: leen todos los píxeles de la región como una sola línea de texto. Los sistemas basados en VLM manejan mejor el texto superpuesto porque comprenden la estructura del documento, pero la precisión aún se degrada entre 5 y 8 puntos porcentuales. El caso de la comunidad de UiPath —donde los nombres manuscritos de los inquilinos se superponían con las etiquetas impresas de los campos en un formulario de registro de alquiler— es un ejemplo de manual de este tipo de fallo (UiPath Community Forum, 2024).
Solución: Al diseñar formularios para extracción, deje una separación vertical clara entre las etiquetas impresas y las áreas de escritura a mano. Un espacio mínimo de 6 mm reduce significativamente los errores de superposición. Para formularios existentes, preprocese la imagen para aumentar el contraste entre el texto impreso (normalmente más oscuro y uniforme) y el texto manuscrito (normalmente más claro y variado). Si el preprocesamiento no es una opción, dirija estos documentos a un flujo de trabajo basado en VLM: maneja mejor la separación de contenido mixto que el OCR tradicional, aunque de forma imperfecta.
Fallo n.º 3: El formulario que cambió sin aviso
Cómo reconocerlo: La extracción funciona perfectamente durante semanas y, de repente, falla en un lote: los campos que se extraían correctamente de forma constante ahora devuelven valores vacíos o incorrectos. Los documentos parecen iguales a simple vista.
Qué está ocurriendo en realidad: Un proveedor, cliente o departamento cambió el diseño de su formulario: movió un campo media pulgada, renombró una etiqueta, añadió un logotipo que invadía el área de texto. Si su configuración de extracción depende de plantillas con coordenadas fijas o de una coincidencia rígida de nombres de campo, incluso un cambio menor de diseño rompe todo el flujo de trabajo. Este es el modo de fallo más común en la extracción basada en plantillas, y es un problema estructural, no de precisión: el motor de extracción funciona exactamente como está configurado; la configuración ha dejado de ser válida para la nueva entrada.
Solución: Utilice métodos de extracción que comprendan la semántica de los campos en lugar de depender de plantillas posicionales. Custom Column Extraction —donde usted define los campos por lo que significan («Invoice Total», «Delivery Date») y la IA los localiza comprendiendo el contenido del documento— elimina por completo la fragilidad de las plantillas. La misma definición de columna funciona con distintos diseños de formulario de distintas fuentes porque la IA busca significado semántico, no coordenadas de píxeles. Esta es una de las diferencias arquitectónicas fundamentales entre los flujos de trabajo de OCR tradicionales y la extracción moderna basada en IA, como se explora en nuestra comparación de ambos enfoques.
Categoría 2 — Fallos en la capa de reconocimiento
Fallo n.º 4: «0» se convierte en «O» — la trampa de la ambigüedad de caracteres
Cómo reconocerlo: El texto extraído contiene letras donde debería haber números y viceversa: «S» en lugar de «5», «O» en lugar de «0», «l» en lugar de «1», «B» en lugar de «8». El patrón de error es consistente: todos los fallos son vecinos visuales cercanos de forma aislada.
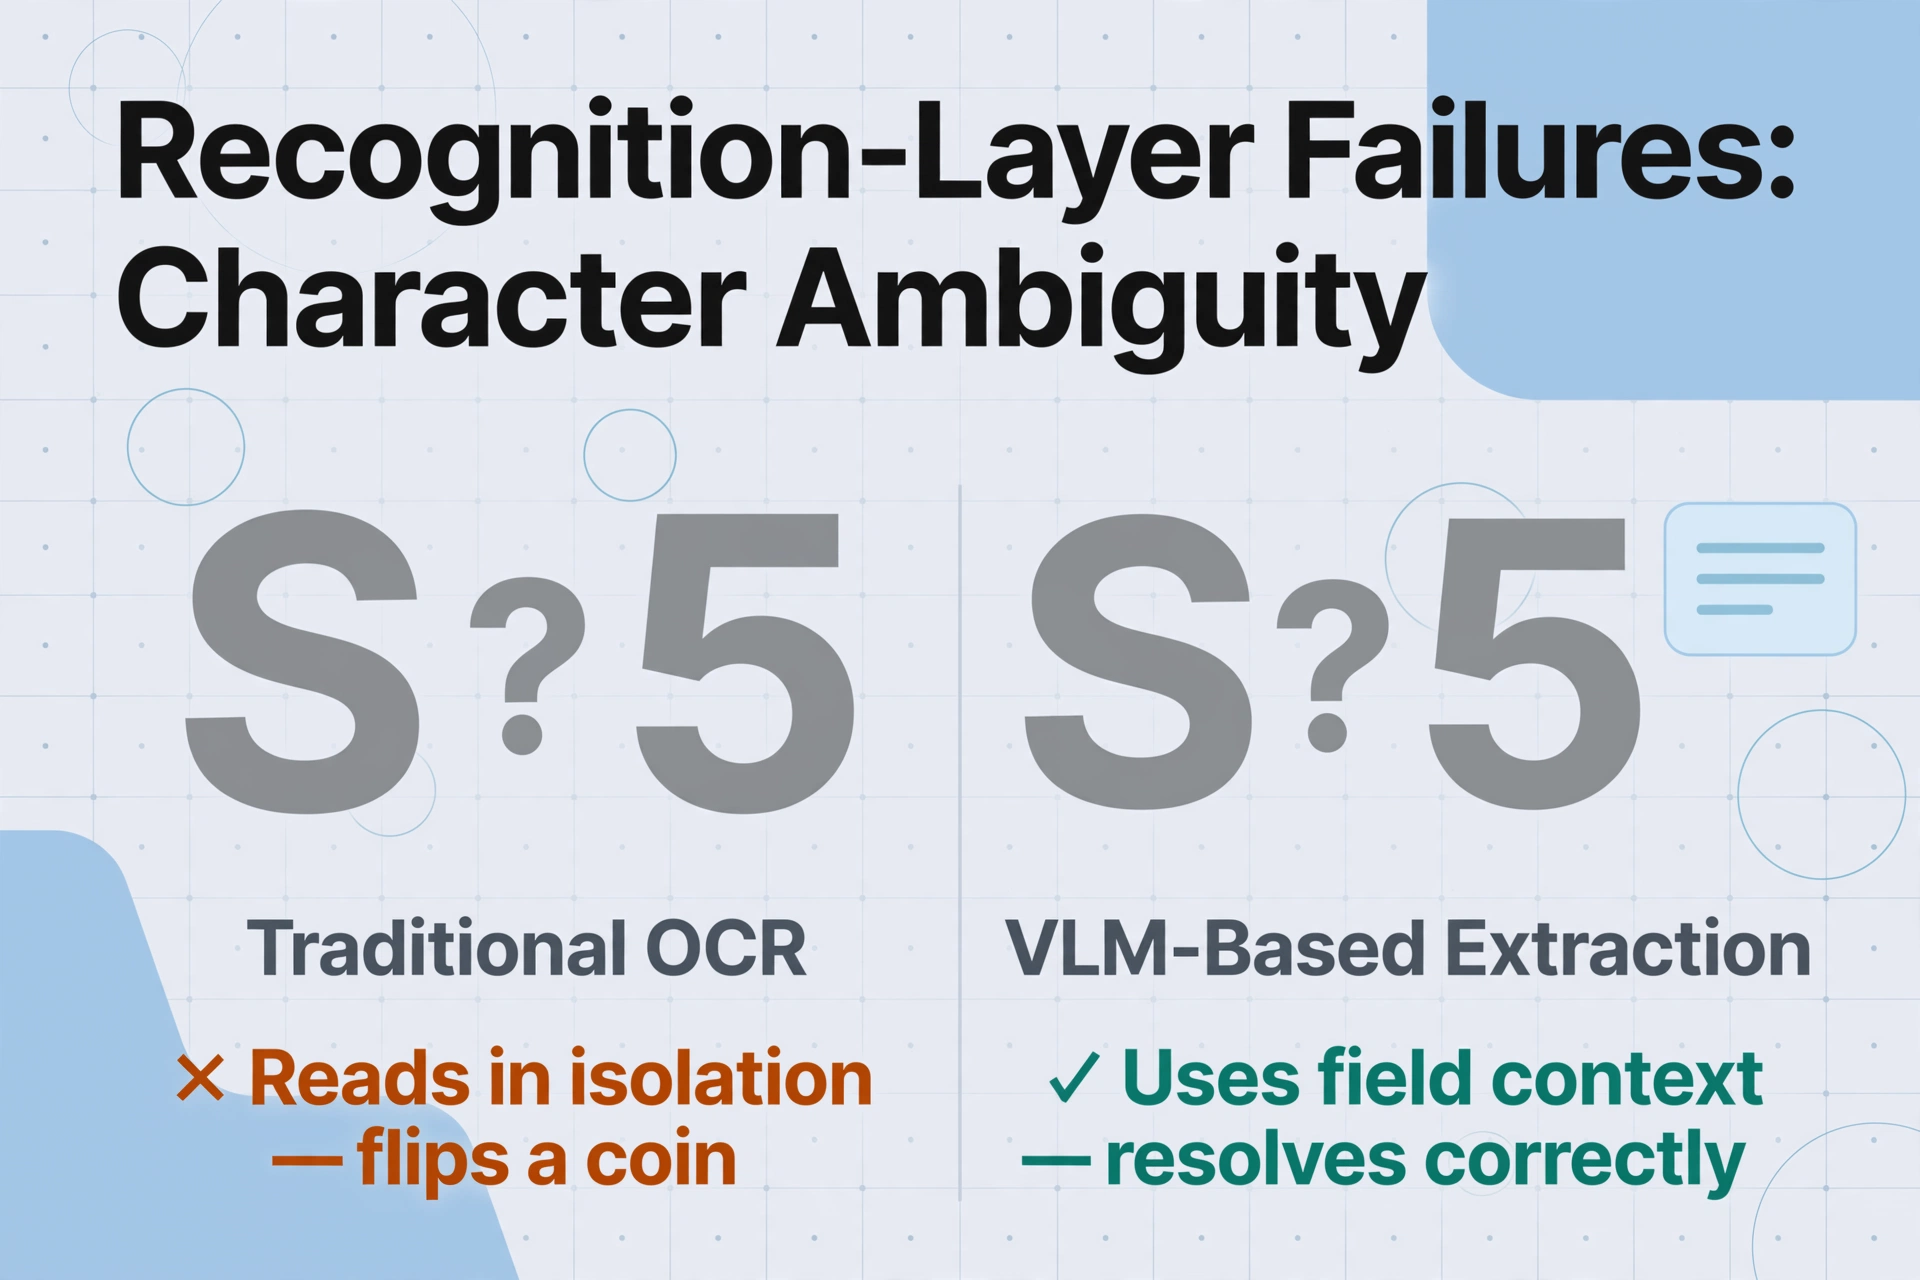
Qué ocurre en realidad: Cuando los caracteres se leen de forma aislada —como hace el OCR tradicional—, las formas ambiguas se asignan por defecto al carácter con la coincidencia de píxeles más cercana en los datos de entrenamiento del motor. Un «5» manuscrito con la parte superior plana y la inferior abierta tiene casi el mismo patrón de píxeles que una «S» manuscrita. Sin pistas contextuales (este campo debería contener un número), el motor decide al azar. En formularios con campos numéricos manuscritos —cantidades de entrega, importes de facturas, lecturas de contadores—, esta única clase de fallo representa la mayoría de los errores de extracción. Un usuario de Reddit que revisó varias herramientas de OCR descubrió que incluso los sistemas con interfaces cuidadas producían «numerosos errores de transcripción de escritura a mano» en tablas con contenido alfanumérico mixto (r/computervision, 2024).
Solución: La solución depende de su enfoque de extracción. Para el OCR tradicional, las reglas de validación posteriores al procesamiento —«este campo debe ser numérico»— detectan la mayoría de las ambigüedades de caracteres después de la extracción. Para la extracción basada en VLM, la comprensión contextual del modelo suele resolverlas automáticamente porque sabe que un valor numérico corresponde a un campo «Total Amount». Si utiliza Custom Column Extraction con un backend de VLM, especificar el formato esperado en el nombre de la columna («Total Amount (numeric)») proporciona al modelo una restricción explícita que resuelve la ambigüedad antes de que el valor llegue a su resultado.
Fallo n.º 5: «Hand Writing» — cuando las palabras se separan y se fusionan
Cómo reconocerlo: El texto extraído contiene límites de palabra fantasma: «handwriting» se convierte en «hand writing», «the man» en «them an», «invoice number» en «invoicen umber». O lo contrario: dos campos manuscritos separados se fusionan en uno porque la pluma del escritor se desplazó sobre el espacio.
Qué está ocurriendo en realidad: La segmentación de palabras —saber dónde termina una palabra y empieza la siguiente— es trivial para texto impreso por máquina, donde el espaciado es uniforme. En la escritura a mano, el espaciado es decisión del escritor y varía. Algunos escritores dejan grandes espacios entre las letras de una palabra y pequeños entre palabras; otros conectan todas las letras de una frase sin levantar la pluma. El motor de extracción aplica un umbral de espaciado calibrado sobre una escritura promedio, y su escritor no es promedio. El resultado son errores de segmentación que convierten un texto coherente en una ensalada de palabras.
Solución: Los sistemas basados en VLM manejan mejor los errores de segmentación que el OCR tradicional porque usan la comprensión del lenguaje para reconstruir los límites de palabra: «them an» no es una frase con sentido, y el conocimiento lingüístico del modelo la corrige a «the man» en la fase de generación de texto. Este es un caso en el que el razonamiento contextual de la IA corrige activamente un error de reconocimiento. La solución desde el diseño del documento: cuando sea posible, use formularios con casillas individuales por carácter (una casilla por letra) en lugar de líneas abiertas para texto libre. Los formularios fiscales gubernamentales usan este diseño precisamente porque elimina la ambigüedad de segmentación, una restricción que beneficia tanto a los lectores humanos como a la extracción automática.
Fallo n.º 6: cursiva que se lee como un alfabeto distinto
Cómo reconocerlo: Los campos de texto impreso se extraen perfectamente. Los campos en cursiva —especialmente los que tienen bucles conectados, caracteres inclinados o escritura comprimida— devuelven resultados apenas reconocibles como las mismas palabras. Una palabra sencilla en cursiva como «world» vuelve como «wriod».
Qué está ocurriendo en realidad: La escritura cursiva sustituye las formas discretas de las letras por trazos continuos. La letra «e» en medio de una palabra en cursiva no se parece en nada a una «e» impresa aislada: es un bucle unido a las letras anterior y siguiente. El enfoque tradicional del OCR, que segmenta primero los caracteres, no puede separar caracteres que nunca se escribieron por separado. La generación 2025–2026 de VLM maneja mejor la cursiva porque procesa las formas de las palabras de manera holística en lugar de ensamblar caracteres, pero el techo de precisión sigue siendo sustancialmente inferior al del texto impreso o la escritura en letra de molde. Los benchmarks independientes muestran una precisión por campo del 75–88 % en cursiva completa frente al 85–93 % en letra de molde, una brecha que refleja la dificultad inherente de la entrada, no una deficiencia de ningún modelo concreto (Suparse, 2026).
Solución: No existe ninguna solución tecnológica que haga la cursiva tan precisa como la letra de molde: es un techo de precisión real. La mitigación práctica es un enfoque de dos niveles: para documentos donde los campos en cursiva son informativos (notas, comentarios, descripciones), acepte la menor precisión y use el enrutamiento basado en confianza para marcar las extracciones de baja confianza y revisarlas manualmente. Para documentos donde los campos en cursiva son transaccionales (importes, números de cuenta, identificadores legales), exija que esos campos se impriman en mayúsculas de molde: es una regla de proceso, no una solución tecnológica. El rediseño de formularios que añade instrucciones de «ESCRIBA CON CLARIDAD» y áreas de escritura delimitadas reduce el volumen de campos en cursiva desde el origen. Las mejoras de precisión posibles mediante la calidad de la entrada y el diseño de columnas se tratan en nuestra guía completa de precisión.
Categoría 3 — Los fallos silenciosos
Fallo n.º 7: Los datos que nunca estuvieron ahí — alucinación de la IA
Cómo reconocerlo: Los síntomas más insidiosos. Todos los campos de la salida de extracción están completados. Los valores tienen el formato correcto. Nada activa un error de validación. Pero al contrastar la salida con el documento original se descubre que uno o más campos contienen datos que el autor nunca introdujo: una fecha rellenada donde el campo estaba en blanco, un importe en dólares que parece correcto pero no coincide con la fuente, un nombre de proveedor que el modelo infirió del contexto de otra parte de la página.
Qué está ocurriendo en realidad: Los modelos de extracción basados en VLM generan texto, no solo reconocen caracteres. Cuando un campo está realmente en blanco o la letra es ilegible, el modelo puede producir un valor plausible basándose en lo que "debería" haber: la misma capacidad de razonamiento que hace que los VLM sean tan eficaces para desambiguar letra desordenada se convierte en un riesgo cuando pasa de la desambiguación a la fabricación. Este es el modo de fallo que separa más radicalmente la extracción basada en IA del OCR tradicional: el OCR tradicional devuelve nada o basura en campos en blanco o ilegibles (fallo detectable), mientras que la extracción con VLM puede devolver datos convincentes pero ficticios (fallo indetectable). Un reseñador de Reddit que evaluó varias herramientas lo señaló explícitamente: "ChatGPT puede ofrecer una conversión de letra a texto muy impresionante, pero también sufría de alucinaciones y no podía extraer datos estructurados de forma fiable" (r/computervision, 2024).
Solución: La alucinación no se puede eliminar: es inherente a los modelos generativos. Sí se puede contener. Tres capas de defensa: primero, utilice sistemas de extracción que proporcionen puntuaciones de confianza por campo y establezca un umbral de confianza alto (0,90+) para los campos donde los errores son costosos. Segundo, implemente reglas de validación entre campos: si el campo "Importe total" está completado, los campos de líneas de detalle que suman ese total también deberían estarlo. Un campo de línea de detalle vacío con un total completado es una señal de alarma de alucinación. Tercero, para flujos de trabajo críticos, mantenga un paso de revisión humana sobre una muestra de salidas de alta confianza, no para corregir errores que el sistema señaló, sino para detectar errores sobre los que el sistema tenía confianza. Esta es una estrategia de revisión distinta de la corrección de errores del OCR tradicional, y es esencial para los flujos de trabajo basados en VLM.
Fallo n.º 8: La casilla que lo controla todo
Cómo reconocerlo: La salida de extracción contiene datos en campos que deberían estar vacíos — detalles del historial médico del paciente en un formulario donde se marcó «Sin afecciones previas», campos dependientes rellenados cuando la condición principal se marcó como falsa. Las extracciones individuales parecen correctas de forma aislada; el error está en la relación estructural entre los campos.
Qué está ocurriendo en realidad: Los formularios con lógica condicional — marque esta casilla para mostrar secciones adicionales, responda «Sí» para expandir, seleccione una opción para ocultar otras — crean dependencias estructurales entre los campos. Si la extracción omite la casilla, o lee mal «Sí» como «No», todos los campos dependientes quedan incorrectos, independientemente de si los caracteres individuales se leyeron perfectamente. Un único error binario se propaga a múltiples fallos de campo. Este es un modo de fallo de orden superior: la extracción es precisa a nivel de carácter pero estructuralmente incorrecta. Es el modo de fallo menos comentado en los benchmarks de proveedores, porque los benchmarks suelen evaluar campos individuales de forma aislada, no las dependencias entre campos (ImageToTable.ai, 2025).
Solución: Diseñe su conjunto de columnas de extracción para capturar explícitamente los campos que activan la condición. Si su formulario de admisión médica tiene «Afecciones previas (Sí/No)», haga que sea su propia columna. Luego cree reglas de validación: si «Afecciones previas» es igual a «No», el campo «Detalles de la afección» debe estar vacío. Si «Afecciones previas» es igual a «Sí» y «Detalles de la afección» está vacío, márquelo para revisión. Esto convierte un fallo estructural silencioso en un error de validación detectable. Para formularios con lógica condicional extensa, derive un porcentaje mayor de extracciones a revisión humana — el coste de omitir una cascada condicional es mayor que el coste de revisar un formulario que podría haberse extraído correctamente.
Cómo auditar sus propios resultados de extracción
Los modos de fallo anteriores son un marco de diagnóstico. Así es como puede aplicarlo a sus propios documentos sin pasar horas en revisión manual.
Paso 1: Extraiga una muestra aleatoria de 50 documentos de su entrada de producción. No los limpios: incluya los documentos con notas al margen, valores tachados, estilos de escritura mixtos. Estos son los que concentran los fallos.
Paso 2: Para cada campo de cada documento, márquelo como: correcto, incorrecto y obvio (texto distorsionado, valores faltantes, errores de formato), o incorrecto pero plausible (parece correcto, pero es erróneo). La proporción entre incorrecto y obvio e incorrecto pero plausible le indica si su perfil de fallos es mayoritariamente de entrada/reconocimiento (errores obvios) o silencioso (errores plausibles). La mayoría de los equipos descubre que entre el 20 y el 40 % de sus errores son incorrectos pero plausibles, la categoría que no habían estado rastreando.
Paso 3: Para cada extracción incorrecta, clasifique el modo de fallo usando los ocho patrones anteriores. Esto toma aproximadamente 30 segundos por error una vez que conoce las categorías. Tras clasificar 50 documentos, tendrá un perfil de fallos: 40 % de capa de entrada (mejore su proceso de captura), 35 % de capa de reconocimiento (mejore el diseño de campos y el nombre de las columnas), 25 % silenciosos (añada reglas de validación y puntos de control de revisión humana). El perfil le indica dónde invertir, no en esfuerzos generales de «mejorar la precisión», sino en la intervención específica que coincide con su patrón de fallos real.
Paso 4: Aplique la solución que coincida con su categoría de fallo principal. Si dominan los fallos de capa de entrada, mejore su proceso de escaneo antes de tocar cualquier otra cosa. Si los fallos silenciosos representan una proporción mayor de lo esperado, añada reglas de validación y aumente su tasa de muestreo de revisión humana. Vuelva a medir tras la solución con una nueva muestra de 50 documentos. El cambio en el perfil de fallos, no el número absoluto de precisión, le indica si la intervención funcionó.
Preguntas frecuentes
¿Cómo sé si mis errores de extracción son culpa de la herramienta o de mis documentos?
Procese el mismo documento con dos métodos de extracción distintos — por ejemplo, un pipeline OCR tradicional y una herramienta de extracción basada en VLM. Si ambos fallan en los mismos campos, el problema es el documento (probablemente la calidad de entrada o una escritura a mano intrínsecamente ilegible). Si uno extrae correctamente y el otro no, el cuello de botella es la herramienta o su configuración. Esta prueba diferencial aísla la variable en minutos.
¿Puedo evitar por completo la alucinación de la IA?
No. La alucinación es inherente a los modelos de IA generativa y no puede eliminarse mediante configuración ni una mejor calidad de entrada. Lo que sí puede hacer es contenerla: use la puntuación de confianza para identificar extracciones de baja confianza, implemente reglas de validación entre campos que detecten resultados inverosímiles y mantenga un paso de revisión humana que muestree las salidas de alta confianza — específicamente para detectar los errores sobre los que el sistema tenía confianza, que son los más propensos a ser alucinaciones.
¿Por qué mis extracciones funcionan perfectamente en documentos de prueba pero fallan en producción?
Esto casi siempre es un problema de variedad de documentos. Los documentos de prueba tienden a ser limpios, recientes y representativos del caso promedio. Los documentos de producción incluyen la cola larga — faxes de 2018, formularios rellenados con bolígrafo sobre un camión en movimiento, documentos con manchas de café y notas al margen. Los modos de fallo de este artículo se concentran en el peor 10–15% de su entrada. Si su conjunto de prueba no incluye esos documentos, no mide lo que importa. Añada los 20 documentos más desordenados de su último lote de producción a su conjunto de prueba y vuelva a ejecutarlo.
¿Cuál es el modo de fallo más común que ve?
La ambigüedad de caracteres en campos numéricos escritos a mano — "5" leído como "S", "0" como "O", "1" como "l" — representa más errores de extracción que cualquier otra causa individual. Es un fallo de la capa de reconocimiento que las mejoras en la calidad de entrada (mayor resolución, mejor iluminación) reducen pero no eliminan. La mitigación más eficaz son las restricciones de formato a nivel de campo: indicar al sistema de extracción que una columna determinada solo debe contener valores numéricos. Esto puede hacerse en la propia definición de la columna cuando el sistema admite sugerencias de formato.
¿Debería rediseñar todos mis formularios antes de intentar la extracción?
Para los formularios que usted controla (formularios internos, documentos de admisión que usted diseña), sí: rediseñarlos pensando en la extracción (casillas individuales por carácter, separación clara entre etiqueta y campo, áreas de escritura delimitadas, instrucciones como «ESCRIBA CON CLARIDAD») es la inversión de mayor impacto que puede hacer. Para los formularios que no controla (facturas de proveedores, documentos enviados por clientes, formularios gubernamentales), céntrese en la calidad de la entrada y el diseño de los campos: esas son las variables que puede cambiar cuando no puede cambiar el formulario en sí.
Deje de adivinar, empiece a diagnosticar
Los fallos de extracción parecen aleatorios hasta que usted los clasifica. Los ocho patrones anteriores le dan un lenguaje de diagnóstico: una forma de mirar un resultado incorrecto y decir «Ese es el fallo n.º 4, ambigüedad de caracteres, y la solución es una restricción de formato en la definición de la columna», en lugar de «Eso no funcionó, supongo que la letra era demasiado ilegible». La auditoría de 50 documentos lleva una hora. La conclusión que produce —dónde está fallando realmente su flujo de extracción, no dónde usted supone que falla— determina si su siguiente hora de esfuerzo de mejora aumenta la precisión en un solo dígito o en dos dígitos.
Ejecute la auditoría. Clasifique sus primeros diez errores. El patrón será visible antes de que termine.