Handschriftliche Schecks in Xero,
ohne die Felder abzutippen, die OCR überspringt
Ein Buchhalter, der eine familiengeführte CPA-Kanzlei übernahm, stellte der r/Bookkeeping-Community die Frage, die die meisten Kanzleiinhaber irgendwann erreicht: Kunden schreiben weiterhin Schecks von Hand, und es gab kein zuverlässiges Tool, um diese Handschrift in Xero zu erfassen. Die Top-Antwort fasste den Stand der Branche zusammen: „Tools wie Hubdoc, AutoEntry oder Dext eignen sich gut zum Speichern des Bildes, aber OCR übersieht die Handschrift meist.“ Dieser eine Satz trennt das Speichern eines Schecks vom Lesen – und genau diese Lücke führt dazu, dass Zahlungsempfänger und Beträge weiterhin von Hand getippt werden.
Die wichtigsten Erkenntnisse
- Scanner und Dokumenttools speichern bereits jeden Scheck, doch Zahlungsempfänger und Betrag werden trotzdem von Hand getippt.
- OCR liest die gedruckte MICR-Zeile, weil Banken sie für Maschinen entworfen haben, aber die Handschrift wurde für menschliche Augen entworfen – daher sind Worterkennungsfehler zwei- bis viermal höher als Zeichenfehler.
- Die Spalten einmal nach Bedeutung definieren, und jedes Scheckfeld landet in einer importierbaren Tabelle, in der jeder Wert direkt auf die genaue Stelle im Bild verweist.
Der Unterschied zwischen dem Speichern eines Schecks und dem Lesen
Schecks sind aus der Buchhaltung kleiner Unternehmen nicht verschwunden. Die Association for Financial Professionals hat festgestellt, dass 91% der befragten Organisationen weiterhin Schecks verwenden und 75% angeben, innerhalb von zwei Jahren nicht damit aufhören zu wollen (AFP Payments Fraud and Control Survey). Die Zahlungsforschung der Federal Reserve zeigt, dass kleine Firmen am stärksten darauf angewiesen sind: Fast acht von zehn sehr kleinen Firmen mit einem Umsatz unter $1 Million verwenden weiterhin Papierschecks für Zahlungen. Ein Scheckbuch liest sich nicht von selbst, daher beginnt die Buchhaltungsarbeit dort, wo das Papier endet.
Wenn ein Kunde einen Stapel handschriftlicher Schecks übergibt, erfassen die Dokumenttools der Kanzlei die Bilder durchaus. Hubdoc, Dext und AutoEntry speichern den Scan bereitwillig, hängen ihn an eine Transaktion an und archivieren ihn. Was sie nicht durchgängig tun, ist, den handschriftlichen Zahlungsempfänger, das Datum, die Schecknummer und den Betrag in Felder umzuwandeln. OCR-Engines lesen gedruckten Text gut und lassen bei Handschrift stark nach – eine Lücke, die das AutoEntry-Hilfecenter deutlich dokumentiert: Dateien mit Stiftmarkierungen werden rundweg abgelehnt, weil die Software „Schwierigkeiten hat, zwischen gedrucktem Text und einer Stiftmarkierung zu unterscheiden". Das praktische Ergebnis ist, dass das Bild archiviert wird und die Daten weiterhin manuell eingegeben werden.
Das ist der Kernunterschied, den ein Buchhalter wirklich testet. Ein Tool, das das Bild speichert, löst das Aufbewahrungsproblem. Ein Tool, das die Felder extrahiert, löst das Erfassungsproblem. Die meisten Scheckverarbeitungen in kleinen Firmen laufen noch auf die alte Weise ab, weil die Erfassungsebene und die Extraktionsebene für handschriftliche Dokumente nie verbunden wurden.
So wird aus einem handschriftlichen Scheck heute ein Buchungseintrag
Der manuelle Weg hat in den meisten kleinen Firmen eine feste Form. Der Kunde schreibt den Scheck und übergibt entweder das Papieroriginal oder ein Handyfoto. Der Buchhalter öffnet die Buchhaltungssoftware, betrachtet die Schrift und tippt Datum, Zahlungsempfänger, Betrag, Schecknummer und Verwendungszweck in die Transaktionsmaske. Danach wird die Datei angehängt, und dieselbe Transaktion wird erneut abgeglichen, wenn der Bankfeed den eingelösten Posten importiert.
Der zweite Teil, der Bankfeed, ist der Punkt, an dem viele Buchhalter die halbe Lösung bereits stillschweigend gefunden haben. Sobald ein Scheck eingelöst ist, liefert der Kontoauszug-Feed Betrag und Datum. Der Buchhalter gleicht ab und kategorisiert von dort aus, und der ursprüngliche Scan dient als Belegnachweis. Dieser Workflow ist real und funktioniert, und er ist genau die Antwort, die im r/Bookkeeping-Thread selbst empfohlen wird: „Den Scheck als Beleg scannen … und sich dann auf den Bankfeed verlassen, sobald er eingelöst ist.“
Aber der Bankfeed hat Grenzen. Er kommt erst Tage später. Er liefert Betrag und Datum, aber nicht den Zahlungsempfänger, wenn die Handschrift des Kunden das ist, was der Bankschalter erfasst hat. Er sagt nichts über Verwendungszweck, Zweck oder Kategorie aus, bis man sich das Bild ansieht. Und er hilft nicht bei Schecks, die das Konto gar nicht erst belasten, etwa bei einem erhaltenen Scheck, der noch auf die Einzahlung wartet. Das verbleibende manuelle Tippen ist genau die Arbeit, die kein menschliches Auge braucht.
Warum OCR die MICR-Zeile liest, aber die Handschrift überspringt
Ein Scheck verbirgt zwei sehr unterschiedliche Arten von Text. Die Ziffernzeile am unteren Rand, die MICR-Zeile, ist in einer magnetischen Tintenschrift gedruckt, die Banken durch Erfassen des Magnetsignals lesen, nicht durch ein Foto davon. Deshalb werden Bankleitzahl und Kontonummer auf jedem Scheck zuverlässig gelesen: Der Standard, festgelegt in ANSI X9.100-20, definiert E-13B-Zeichen, die von Scheck zu Scheck konsistent bleiben. Die Magnetschicht ist der Teil, der für Maschinen entwickelt wurde.
Alles andere auf dem Scheck wurde für Menschen entwickelt und ist von Hand geschrieben. Zahlungsempfänger, Betrag in Worten, numerischer Betrag, Datum und Verwendungszweck sind Kugelschreibertinte in welchem Stil auch immer der Schreiber verwendet. OCR scheitert hier aus drei strukturellen Gründen. Handschrift hat keine feste Schriftart, daher schlägt der Zeichenabgleich gegen ein Buchstabenmodell fehl. Das Layout variiert von Scheck zu Scheck, daher gibt es keine Vorlagenposition für „der Zahlungsempfänger ist immer hier“. Und die Fehlerkosten sind asymmetrisch: Bei Handschrift liegen die Wortfehlerraten typischerweise zwei bis vier Mal höher als die Zeichenfehlerraten, weil ein einziges falsch gelesenes Zeichen das ganze Wort scheitern lässt, was genau die schlimmste Fehlerart für einen Zahlungsempfänger oder einen Betrag ist (siehe die Daten zur Genauigkeit der Handschrifterkennung).
Die für die Buchhaltung entwickelten Erfassungstools treffen einen bewussten Kompromiss: Sie extrahieren gedruckte Rechnungen und Belege sehr gut und umgehen Handschrift, indem sie sie leer zurückgeben oder das Dokument für die manuelle Erfassung markieren. Der Reddit-Thread fasst den Konsens zusammen: „OCR funktioniert normalerweise gut bei getippten Rechnungen und Kontoauszügen, aber Handschrift fügt eine weitere Schwierigkeitsebene hinzu, da die Stile stark variieren.“ Der Buchhalter macht nichts falsch. Der Werkzeug-Stack, den sie bekommen haben, endet schlicht an der Handschrift.
Das Problem ist nicht das Dokument. Es ist die Annahme, dass OCR, das Text liest, und die Extraktion von Daten nach Bedeutung, die Dokumente liest, dieselbe Technik sind. Das sind sie nicht.
Der Workflow, der das liest, was OCR übersieht
Eine Extraktion, die Handschrift versteht, liest den Scheck so, wie es ein Mensch tut: Sie behandelt „Zahlungsempfänger“, „Datum“, „Betrag“ und „Schecknummer“ als Konzepte und sucht dann überall nach jedem einzelnen. Mit Benutzerdefinierte Spaltenextraktion tippt der Buchhalter die gewünschten Spalten einmal ein, beschreibt jedes Feld mit einfachen Worten, und die KI findet die Werte auf dem gescannten Scheck über die Bedeutung statt über die Pixelposition. Da die Spalten vom Benutzer definiert werden, erzeugt dasselbe Setup für jeden Kundenscheck dieselbe Tabellenstruktur.
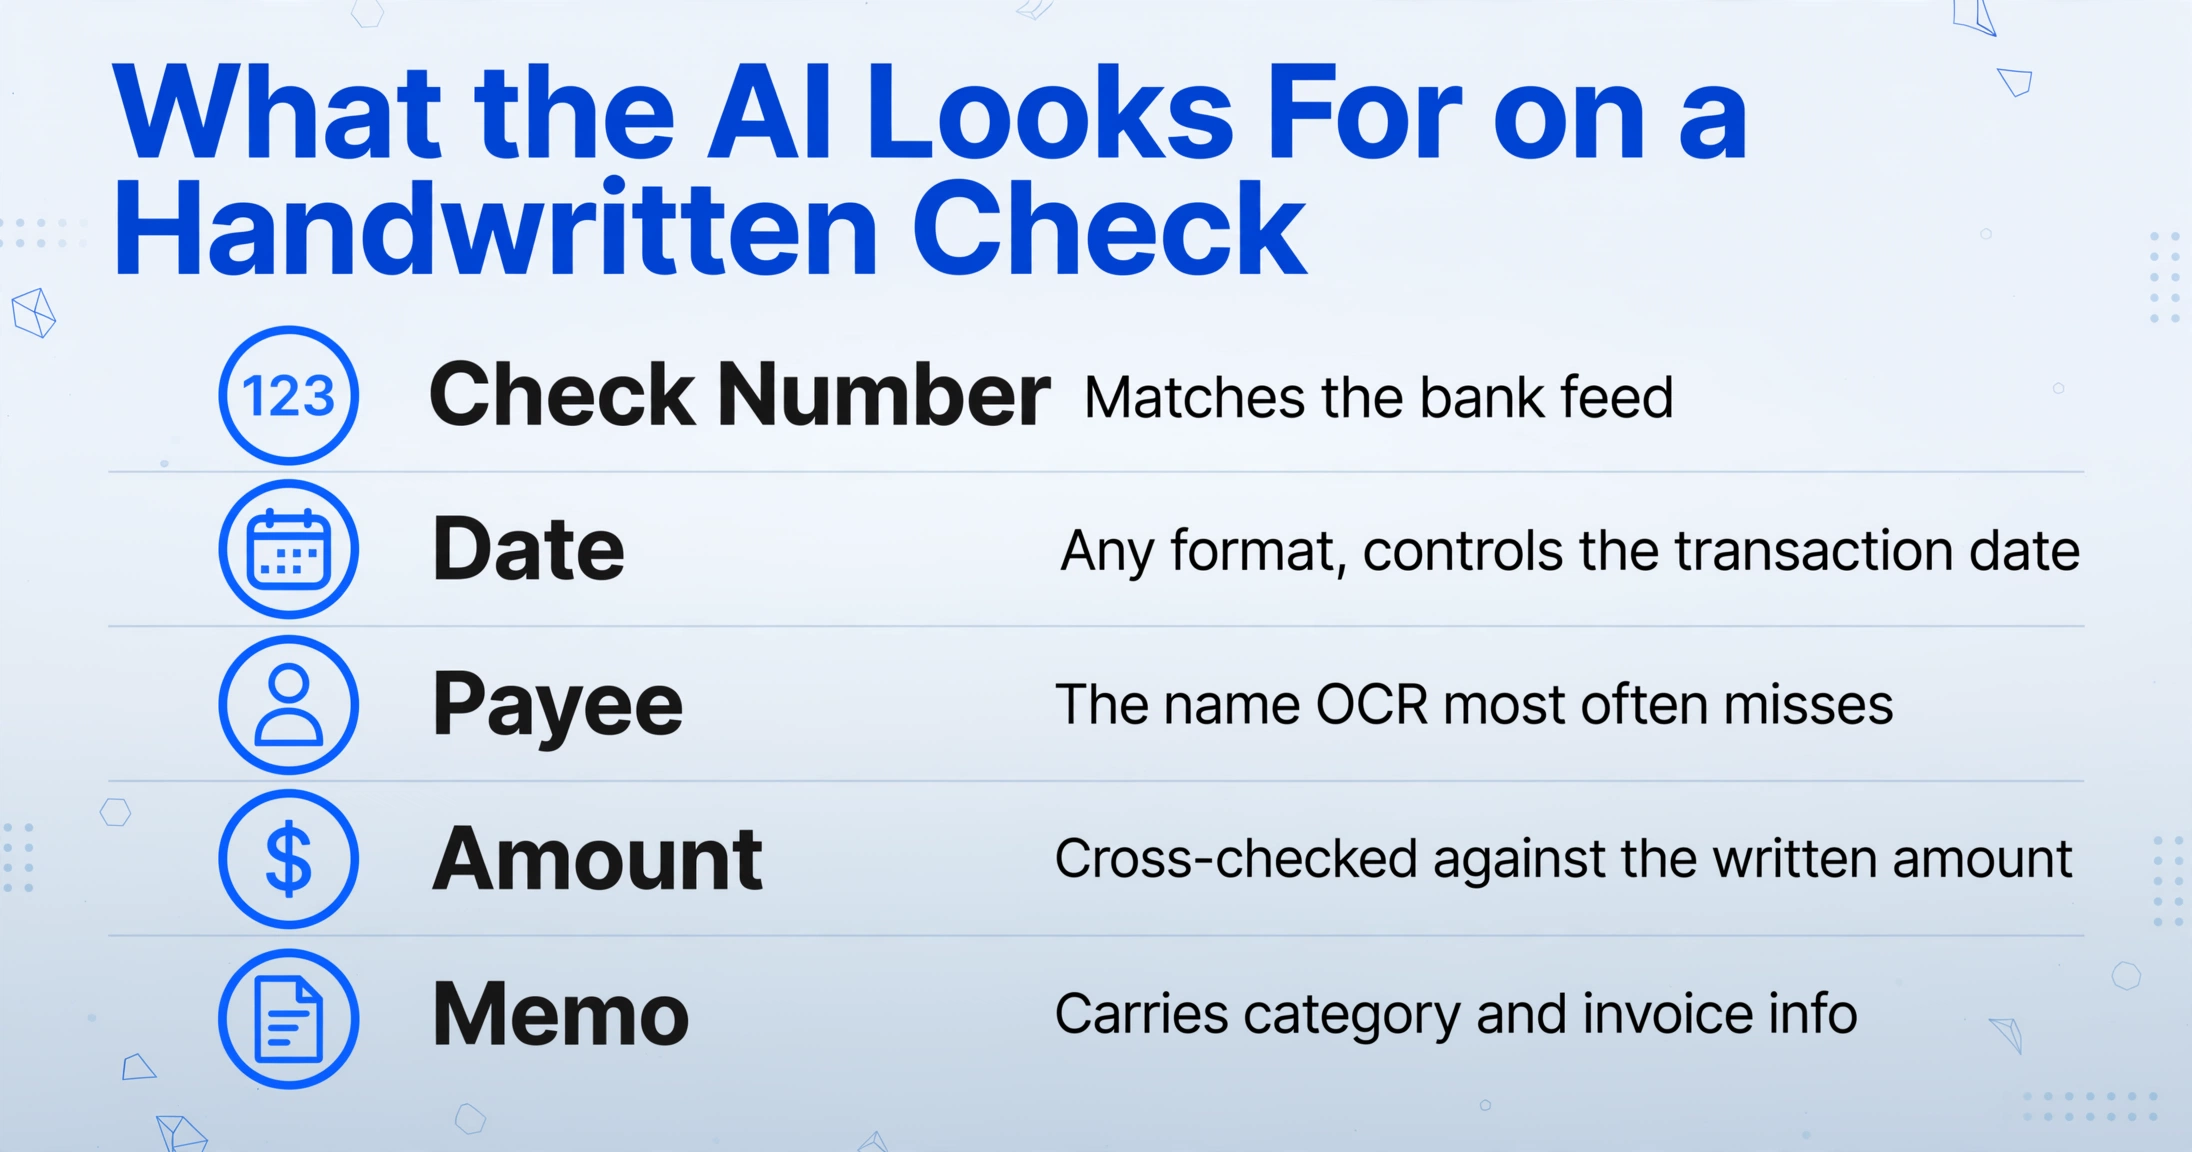
Die Spaltenvorlage für einen Batch handschriftlicher Schecks entspricht direkt den Feldern, die Buchhalter heute eintippen:
| Spalte | Wonach die KI sucht | Warum das wichtig ist |
|---|---|---|
| Schecknummer | Die Sequenznummer auf dem Scheck | Stimmt mit dem Bankfeed überein und erkennt Duplikate |
| Datum | Das geschriebene Datum in jedem Format | Steuert das Transaktionsdatum in Xero |
| Zahlungsempfänger | Der Name auf der Zeile „Zahlen Sie an die Order von“ | Das Feld, das OCR am häufigsten leer zurückgibt |
| Betrag | Der numerische Betrag; der ausgeschriebene Betrag kann als zweite Spalte gezogen werden, damit ein Prüfer beide vergleichen kann | Eine falsche Ziffer ist ein Abstimmungsfehler |
| Verwendungszweck | Der Zweck oder die Referenz auf der Verwendungszweck-Zeile | Überträgt Kategorie- und Rechnungsinformationen |
Zwei Einstellungen machen den Batch realistisch. Eine höhere Modellstufe bietet dichterer und kursiver Handschrift leistungsfähigere Bildverarbeitung, was wichtig ist, wenn die Schecks von Kunden mit lockerer Handschrift stammen. Da der gesamte Stapel mehrere Dateien gleichzeitig verarbeitet, wird ein Stapel Schecks von einem Kunden als ein Batch verarbeitet und in einer Tabelle zusammengeführt, statt Datei für Datei.
Die Ausgabe folgt dann einem von zwei Wegen in die Software. Die Spalten landen in einer Tabelle, die wie jeder Bank- oder Buchungsimport in Xero importiert werden kann, oder die extrahierten Zeilen werden geprüft und direkt eingegeben. Der Punkt ist, dass die Eingabe nicht mehr erfordert, die Handschrift ein zweites Mal abzutippen; das Abtippen wurde bereits vom Extraktor erledigt. Dasselbe feldbezogene Lesen, das für einen Scheck funktioniert, hat bereits eine detaillierte Aufschlüsselung im Artikel zum Konvertieren handschriftlicher Hauptbücher in Excel sowie das breitere Muster zum Überführen handschriftlicher Belege in eine steuerfertige Tabelle.
Betrag vor der Verbuchung prüfen
Die Extraktion von Handschrift ist nie eine reine Vertrauenssache, und ein Scheckbetrag ist der letzte Ort, an dem ein Buchhalter ein stilles Fehllesen möchte. Der APQC-Benchmark beziffert die medianen Kosten für die Verarbeitung einer Verbindlichkeit auf $6 pro Rechnung (APQC), größtenteils manuelle Eingabe, und das mediane Unternehmen erfasst weiterhin manuell 60 % der Lieferantenrechnungen. Der Prüfschritt ist der Punkt, an dem sich Automatisierung auszahlt: Es ist günstiger, eine Extraktion zu verifizieren, als sie neu einzutippen und dann trotzdem zu prüfen.
Bei Handschrift ist das Verifikationstool das Herzstück, nicht die Gesamtlösung. Der Prüfmodus ermöglicht es dem Buchhalter, über jede extrahierte Zelle zu fahren oder sie anzuklicken und genau zu sehen, woher dieser Wert auf dem ursprünglichen Scheckbild stammt, und auf den markierten Bereich im Bild zu klicken, um zur passenden Zelle zurückzuspringen. Wenn eine Betragsziffer mehrdeutig ist, sieht das Unternehmen die Schrift, die sie erzeugt hat, anstatt einer Zahl zu vertrauen, die aus dem Nichts kam. Eine falsche Lesart kann korrigiert und der ursprüngliche KI-Wert mit einem Klick in den Aufzeichnungen behalten werden, sodass der Prüfpfad sichtbar bleibt. Das ist der Unterschied zwischen einem Tool mit integrierter Prüfung und einem Tool, das eine CSV ausgibt und hofft.
Dasselbe Prinzip gilt für Schecks, die bereits über einen Bankfeed verarbeitet werden. Nichts hier ersetzt den Feed; es verkürzt den Abgleichsschritt. Wenn der eingelöste Betrag eintrifft, liefert die extrahierte Zeile aus dem eigenen Batch den Zahlungsempfänger und den Verwendungszweck, sodass direkt aus der Tabelle kategorisiert und abgeglichen werden kann, statt jedes Bild zu öffnen.
Was weiterhin eine Person braucht
Die Extraktion liest Handschrift und ist keine Magie. Blasse Tinte, stark verschnörkelte Beträge sowie schräg oder bei schwachem Licht fotografierte Schecks erzeugen Felder mit geringer Konfidenz, die ein Buchhalter weiterhin ansehen muss. Der ehrliche Workflow plant bei jedem Batch einen Prüfdurchlauf ein, nicht null Ausnahmen. Deshalb ist der obige Prüfschritt Teil des Designs und kein nachträglicher Einfall.
Es gibt auch Grenzen in der restlichen Kette. Ein Scheck, der nie eingelöst wird, hat keinen Bankfeed-Eintrag zum Abgleichen, sodass die extrahierte Zeile der einzige Beleg ist und die Genauigkeit umso wichtiger wird. Und die Aufbewahrung zählt weiterhin: IRS Publication 583 listet eingelöste Schecks unter den Belegen, die ein Unternehmen aufbewahren sollte (IRS Publication 583), und ein elektronisches System erfüllt diese Pflicht nur, wenn seine Aufzeichnungen lesbar und abrufbar bleiben. Das Speichern des Bildes löst die Aufbewahrung. Das Extrahieren der Felder löst die Erfassung. Das Unternehmen macht beides weiter, genau deshalb sollten Erfassungs- und Extraktionsebene getrennte Tools sein, die jeweils ihre eigene Aufgabe erfüllen.
Für die bankseitige Seite der Schecklesung, MICR-Verarbeitung, Scheckbetrugsprüfungen und KYC-Verifizierung behandelt der OCR-Leitfaden für Banken den institutionellen Workflow. Dieser Artikel befasst sich mit dem kleineren Maßstab: einem Stapel handschriftlicher Schecks auf dem Schreibtisch eines Buchhalters und dem, was davon in Xero eingegeben wird.
Handschriftliche Schecks und Buchhaltungssoftware: FAQ
Kann Hubdoc handschriftliche Schecks lesen?
Hubdoc speichert Scheckbilder und extrahiert Kopffelder aus gedruckten Dokumenten, aber Dokumentation und Nutzerberichte stimmen darin überein, dass Handschrift nicht zuverlässig gelesen wird; Zahlungsempfänger und Beträge bleiben oft leer und werden manuell eingegeben. Es bleibt eine solide Dokumentenspeicher- und Ablageebene, was eine separate Aufgabe von der Extraktion ist.
Hat Xero eine integrierte OCR für handschriftliche Schecks?
Xero selbst führt keine OCR-Dokumentenverarbeitung durch. Das gebündelte Erfassungstool Hubdoc übernimmt das Lesen, und handschriftliche Schecks fallen durch diese Lücke. Xero akzeptiert importierte Daten und Bankfeeds, daher ist der praktische Weg, die Scheckfelder in eine Tabelle zu extrahieren und die Zeilen zu importieren. Dieselbe Logik gilt für QuickBooks, das CSV- und IIF-Importe akzeptiert.
Wie genau ist die Handschriftextraktion bei Schecks?
Bei sauberen Benchmark-Handschriften erreichen moderne KI-Systeme Zeichenfehlerraten unter 2 %, aber bei echten Dokumenten ist die Spanne breit, etwa 46 % bis 95 % Genauigkeit je nach Tool und Schreibstil. Leserlichkeit, Tintenqualität und Scanauflösung bestimmen das Ergebnis. Genau diese Varianz ist der Grund, warum ein Prüfschritt, der zeigt, woher jeder Wert stammt, wichtiger ist als eine selbstbewusst klingende Genauigkeitsangabe.
Brauche ich den Bankfeed trotzdem, wenn ich die Schecks extrahiere?
Ja, und beide arbeiten zusammen. Der Bankfeed ist die maßgebliche Aufzeichnung dessen, was tatsächlich verrechnet wurde, und die Extraktion liefert Zahlungsempfänger- und Verwendungszweckdetails, die der Feed nicht enthält. Der Arbeitsablauf verkürzt sich auf: Batch extrahieren, Felder prüfen, dann gegen den verrechneten Feed abgleichen.
Welche Scanqualität brauche ich für handschriftliche Schecks?
Flache, gut beleuchtete Bilder mit etwa 300 DPI liefern die besten Ergebnisse. Ein Handyfoto funktioniert, wenn der Scheck flach liegt und die Schrift scharf ist; ein Scanner ist besser für einen großen Stapel. Vermeiden Sie schräge Aufnahmen und Schatten über der Betragszeile, da diese Bedingungen die Handschrift wieder in den Bereich geringer Zuverlässigkeit drücken.
Die sinnvolle Veränderung darin, wie eine Kanzlei handschriftliche Schecks behandelt, besteht darin, nicht mehr zu fragen „kann es das Bild speichern“, sondern „kann ich die Spalten definieren, kann es den Zahlungsempfänger lesen und kann ich den Betrag prüfen, bevor er gebucht wird“. Jedes Erfassungstool im Stack erledigt bereits das Erste. Die Felder, die OCR leer lässt, sind die, die sich zu automatisieren lohnen.