処方データ入力が
50秒ではなく5秒になったら?
50秒。これは、薬局技術者が自身の指標を記録したところによると、大手チェーン薬局での処方箋1件あたりの標準的なデータ入力時間です。1日200件の処方箋——忙しい個人薬局にとっては控えめな量——を処理する場合、薬剤名、規格、NDCの桁、用法(SIG)コードを薬局管理システム(PMS)に入力するだけで、ほぼ3時間かかります。検証ではなく、カウンセリングでもなく、ただのタイピングです。そして、薬局の外ではほとんど語られない重要な点があります:米国薬剤師会は、調剤された処方箋全体の1.5%にエラーが含まれると推定しています——1年間で約6,750万件のミスに相当し、その多くはデータ入力時のキーボード操作に起因するものです。
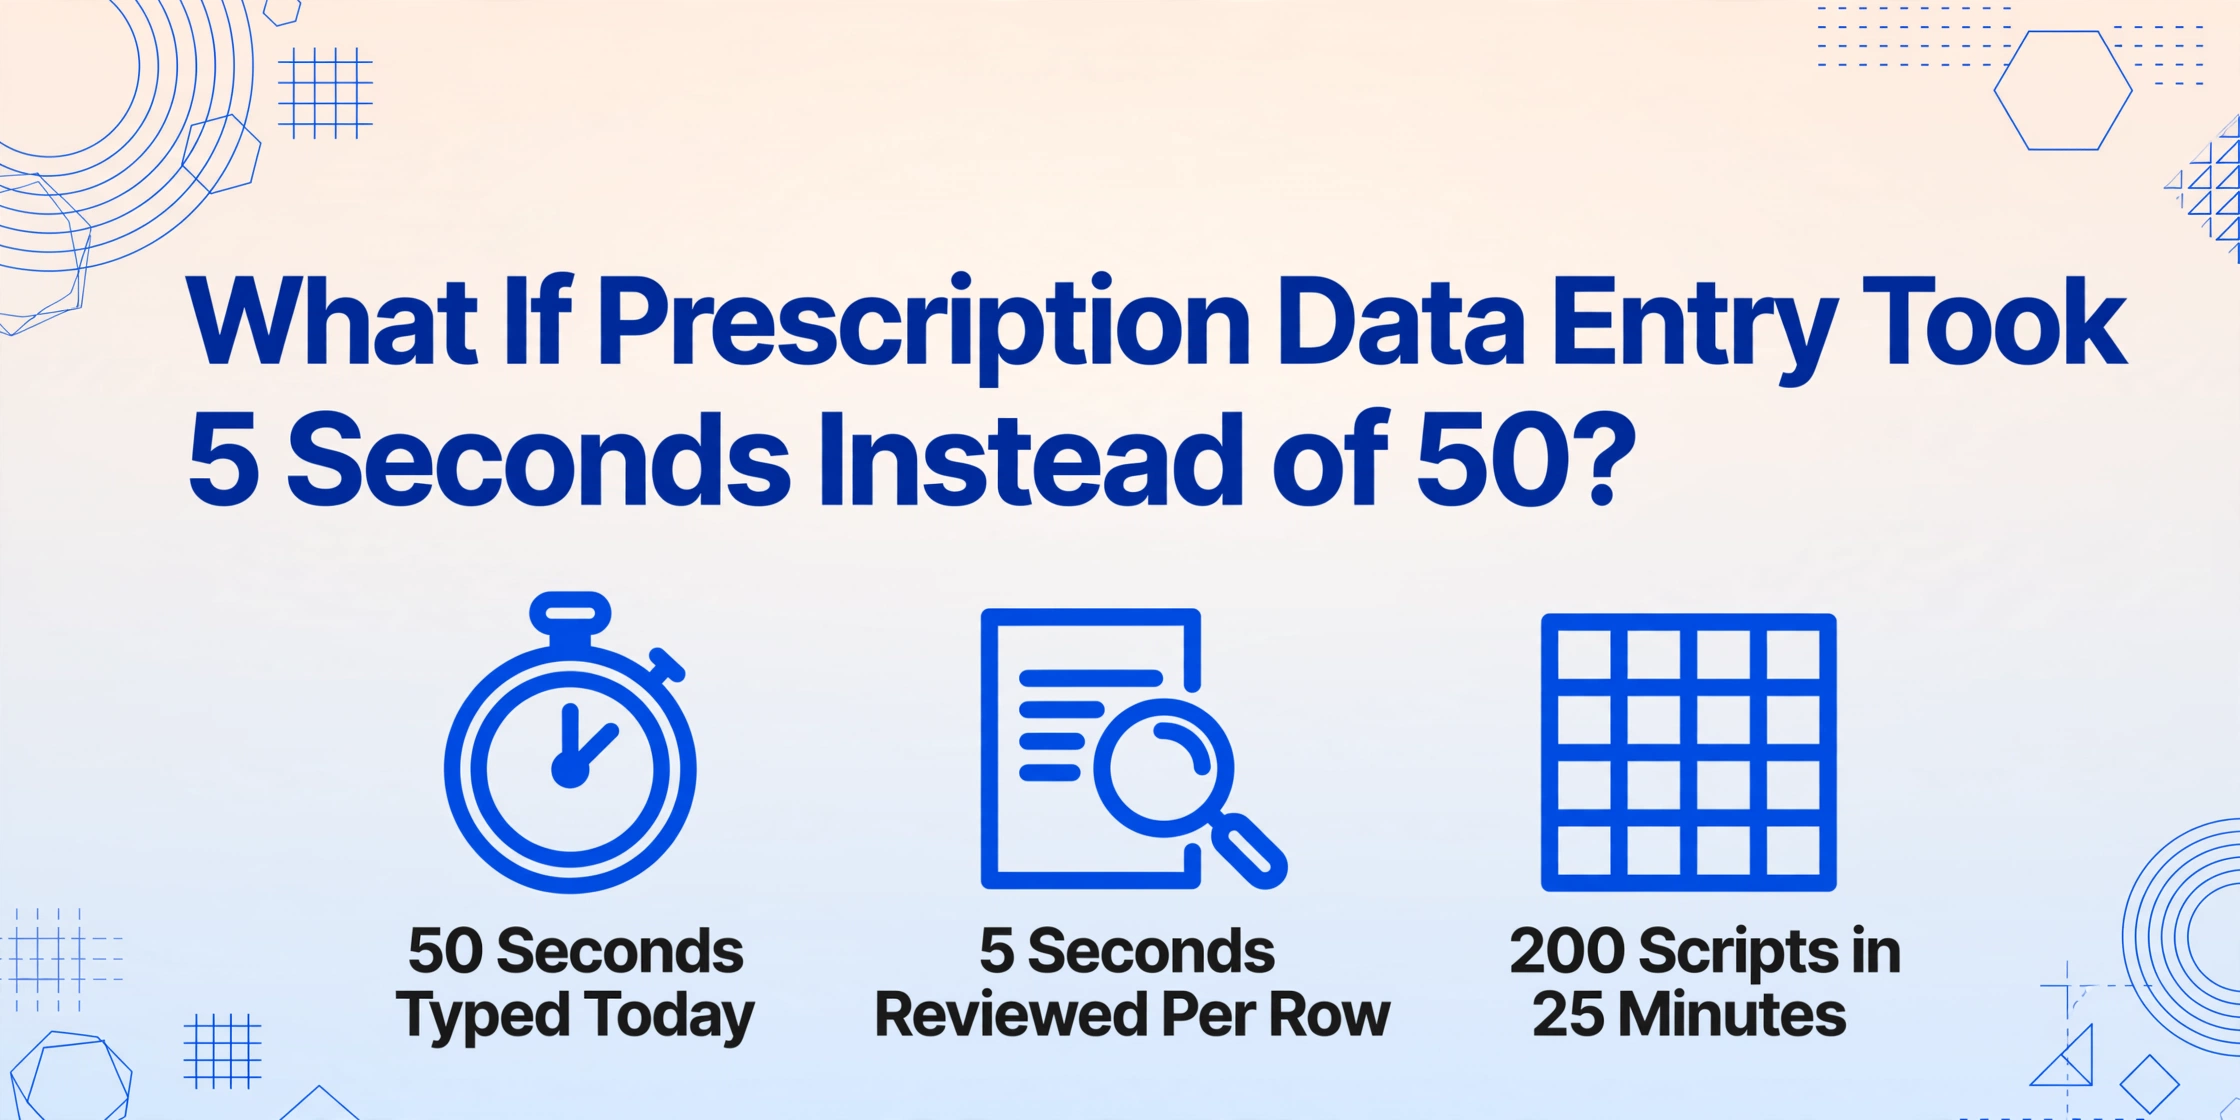
重要なポイント
- 2か月時点でのデータ入力精度43%は、薬局技術者が遅いとか不注意だからではありません——人間に、あらゆる処方箋レイアウトと単一の固定データベースの間のリアルタイム形式変換を求めるとこうなるのです。
- 1つのNDCを11桁のHIPAA(医療保険の相互運用性と説明責任に関する法律)請求形式にするには、3つのゼロ埋めルールのいずれかが必要で、1桁でも間違えると請求が拒否されます——タイピング速度を上げても、形式変換の問題は解決できません。
- AIが処方箋をページ上の位置ではなくデータの意味に基づいて読み取ると、技術者の3時間の転記作業は20分の検証作業に短縮されます。
キーストローク1回に隠されたコスト
調剤ミスにより、毎年少なくとも150万人のアメリカ人が被害を受けており、その経済的損失は推定770億ドルに上ります。そして、そのかなりの割合が、調剤台ではなく、データ入力画面から始まっています。
AMCP(マネージドケア薬局アカデミー)は、最も一般的な調剤ミスの種類として、誤った薬剤の調剤、投与量の誤り、薬物相互作用の見落としの3つを挙げています。これらはすべて、薬局管理システム(PMS)へのたった1桁の入力ミスに起因する可能性があります。
薬局技術者はこの問題を痛感しています。Redditのr/PharmacyTechnicianでは、入社2ヶ月のWalmartの技術者が入力精度が43%だったと報告しています。大手チェーンでは、データ入力1件あたり50秒、1時間あたり17件の処理がベンチマークとされており、これは経験豊富なスタッフの目標です。2018年にResearch in Social and Administrative Pharmacyに掲載された62件の調剤ミス研究のメタアナリシスでは、世界的な調剤ミス率は1.6%と推定され、手動データ入力の負担が大きい環境ほどミス率が高いことが確認されています。
これは、薬局スタッフの努力が足りないという問題ではありません。構造的なミスマッチです。つまり、処方箋はそれぞれ異なる形式で届くのに、どのPMSも同じ構造化されたフィールドを期待しているのです。
薬局のデータ入力の実態
薬が1錠も数えられる前に、技術者は、紙、FAX、電話、電子処方箋など、届いた処方箋の形式を、薬局管理システム内の一連の構造化フィールドに変換しなければなりません。
このワークフローは、ほとんどの薬局ソフトウェア(PioneerRx、QS/1、Computer-Rx、Rx30)で共通しており、ボタンの配置が異なるだけです。処方箋は、次の4つの経路のいずれかで届きます。
- 紙の処方箋 — カウンター越しに手渡されるか、FAXで送られます。技術者は手書きの薬剤名、用量、医師の署名を読み取ります。
- 電子処方箋(e-Script) — NCPDP SCRIPT標準を通じてSurescriptsからデジタルで届きます(年間19億件の取引)。すでに構造化されていますが、フィールドマッピングのエラーがないか手動での確認が必要なことがよくあります。
- 電話処方箋 — 処方元の医療機関から電話で伝えられます。技術者は、他の業務をこなしながらリアルタイムで書き起こします。
- FAX — 特に小規模な診療所や専門医療機関からの処方箋送信において、依然として驚くほど多くの割合を占めています。
処方箋が届くと、技術者はPMSを開き、データ入力を開始します。PioneerRxでは、これはIntake StationまたはData Entryキューで行われます。通常、入力が必要なフィールドは以下の通りです。
| フィールド | 例 | 重要な理由 |
|---|---|---|
| 薬剤名 | リシノプリル | フォーミュラリのエントリと一致する必要あり。一般名とブランド名の混同がよく発生 |
| 含量 | 10 mg | 含量の誤りは、AMCPが報告するエラーのトップ3の一つ |
| 剤形 | 錠剤 | 錠剤とカプセルの代替には薬剤師の判断が必要 |
| NDC | 68180-0981-03 | 請求のためには11桁のHIPAA形式(5-4-2)に変換する必要あり |
| 用法(SIG) | 1T PO QD | SIGコードは患者ラベル用に正しく展開する必要あり |
| 数量 | 30 | 保険審査のための日数計算に直結 |
| リフィル | 3 | スケジュールII薬物:法律によりリフィル0回(21 CFR 1306.12) |
| 処方者 | NPI / DEA番号 | 請求提出に必須。NPIの誤りは却下の原因 |
入力後、処方箋は薬剤師による事前検証に進みます。薬剤師がデータ入力の誤り(含量の誤り、NDCの誤り、SIGの誤訳など)を発見した場合、修正のためにテクニシャンに差し戻されます。修正が発生するたびに、秒単位で計測されるプロセスに数分の手戻り工数が加わります。Redditのr/pharmacyに投稿されたあるコメントにはこうあります:「もう1ヶ月やってるけど、すごく退屈。調剤も配合もなくて、電話とコンピューターばかり。」
「速くタイピングするだけ」では解決しない理由
ボトルネックはタイピング速度ではありません。問題は形式変換です。どんなにキーボードショートカットを駆使しても、すべての処方箋が異なるデータ言語で届くという事実は変わりません。
その50秒間に薬局技術者が実際に何をしているか考えてみましょう。彼らは単に転記しているのではなく、解釈して変換しているのです:
手書きの処方箋に「Lisinopril 10mg 1 tab daily #30」と書かれているかもしれません。技術者はこれを個別のデータベースフィールドに解析し、用法(SIG)を患者向けの言葉に展開し、在庫にある特定の製造元とパッケージサイズに対応する正しい国民医薬品コード(NDC)を調べ、HIPAA(医療保険の相互運用性と説明責任に関する法律)の請求形式(5-4-2)の11桁が先頭ゼロで正しく埋められているかを確認する必要があります。FDAのNDCディレクトリには、現在使用されている3種類の10桁形式(4-4-2、5-3-2、5-4-1)が記載されており、それぞれがCMSがすべてのHIPAA対象取引に要求する11桁形式にするために異なるゼロ埋めルールを必要とします。
| パッケージラベル(10桁) | HIPAA 11桁(5-4-2) | 変換ルール |
|---|---|---|
| 1234-5678-91 (4-4-2) | 01234-5678-91 | ラベラー区分に先頭ゼロ |
| 12345-678-91 (5-3-2) | 12345-0678-91 | 製品区分に先頭ゼロ |
| 12345-6789-1 (5-4-1) | 12345-6789-01 | パッケージ区分に先頭ゼロ |
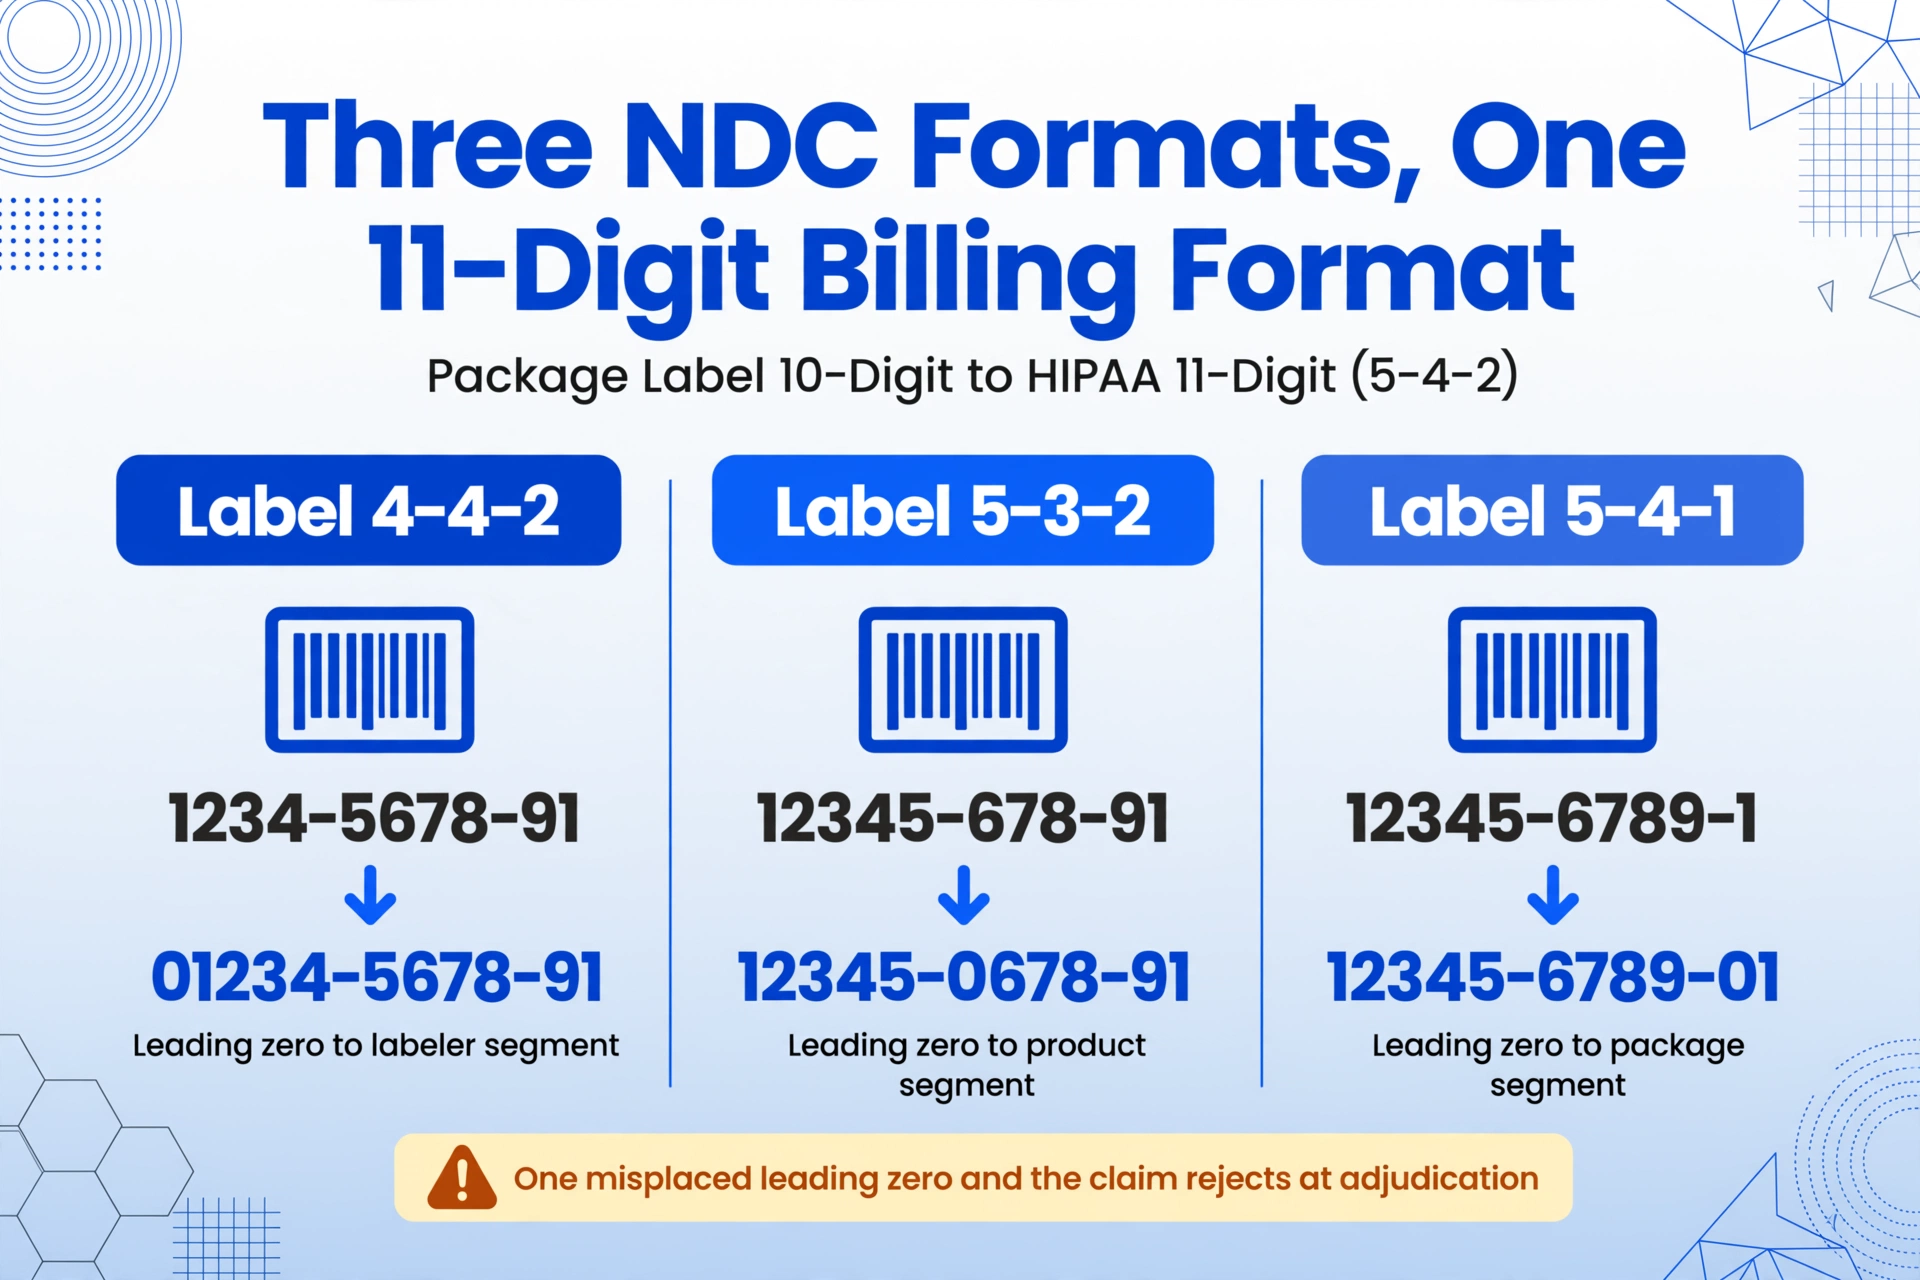
1桁でも間違えると(先頭ゼロが1つずれるだけでも)、請求は審査時に拒否されます。技術者は引き返して、ボトルを読み直し、再入力します。さらに30秒。これを毎日、すべての処方箋のすべてのNDCで繰り返します。
さらにRxNormレイヤーもあります。薬局の薬局管理システム(PMS)がある薬語彙(たとえばFirst Databank)を使用し、病院のEHRが別の薬語彙(たとえばMultum)を使用している場合、国立医学図書館が管理するRxNormが、それらの間を仲介する標準化された臨床薬名を提供します。しかし、手動入力を行う技術者はRxNormを直接操作するわけではありません。必要なのは、下流のシステムがマッピングできるようにデータが正しいことだけです。
本当の問題は、手動データ入力が人間に形式変換器の役割を求めていることです。これはコンピューターのために作られた仕事です。 問題なのは処方箋ではありません。キーボードなのです。
AIに薬局技術者のように読むことを教える
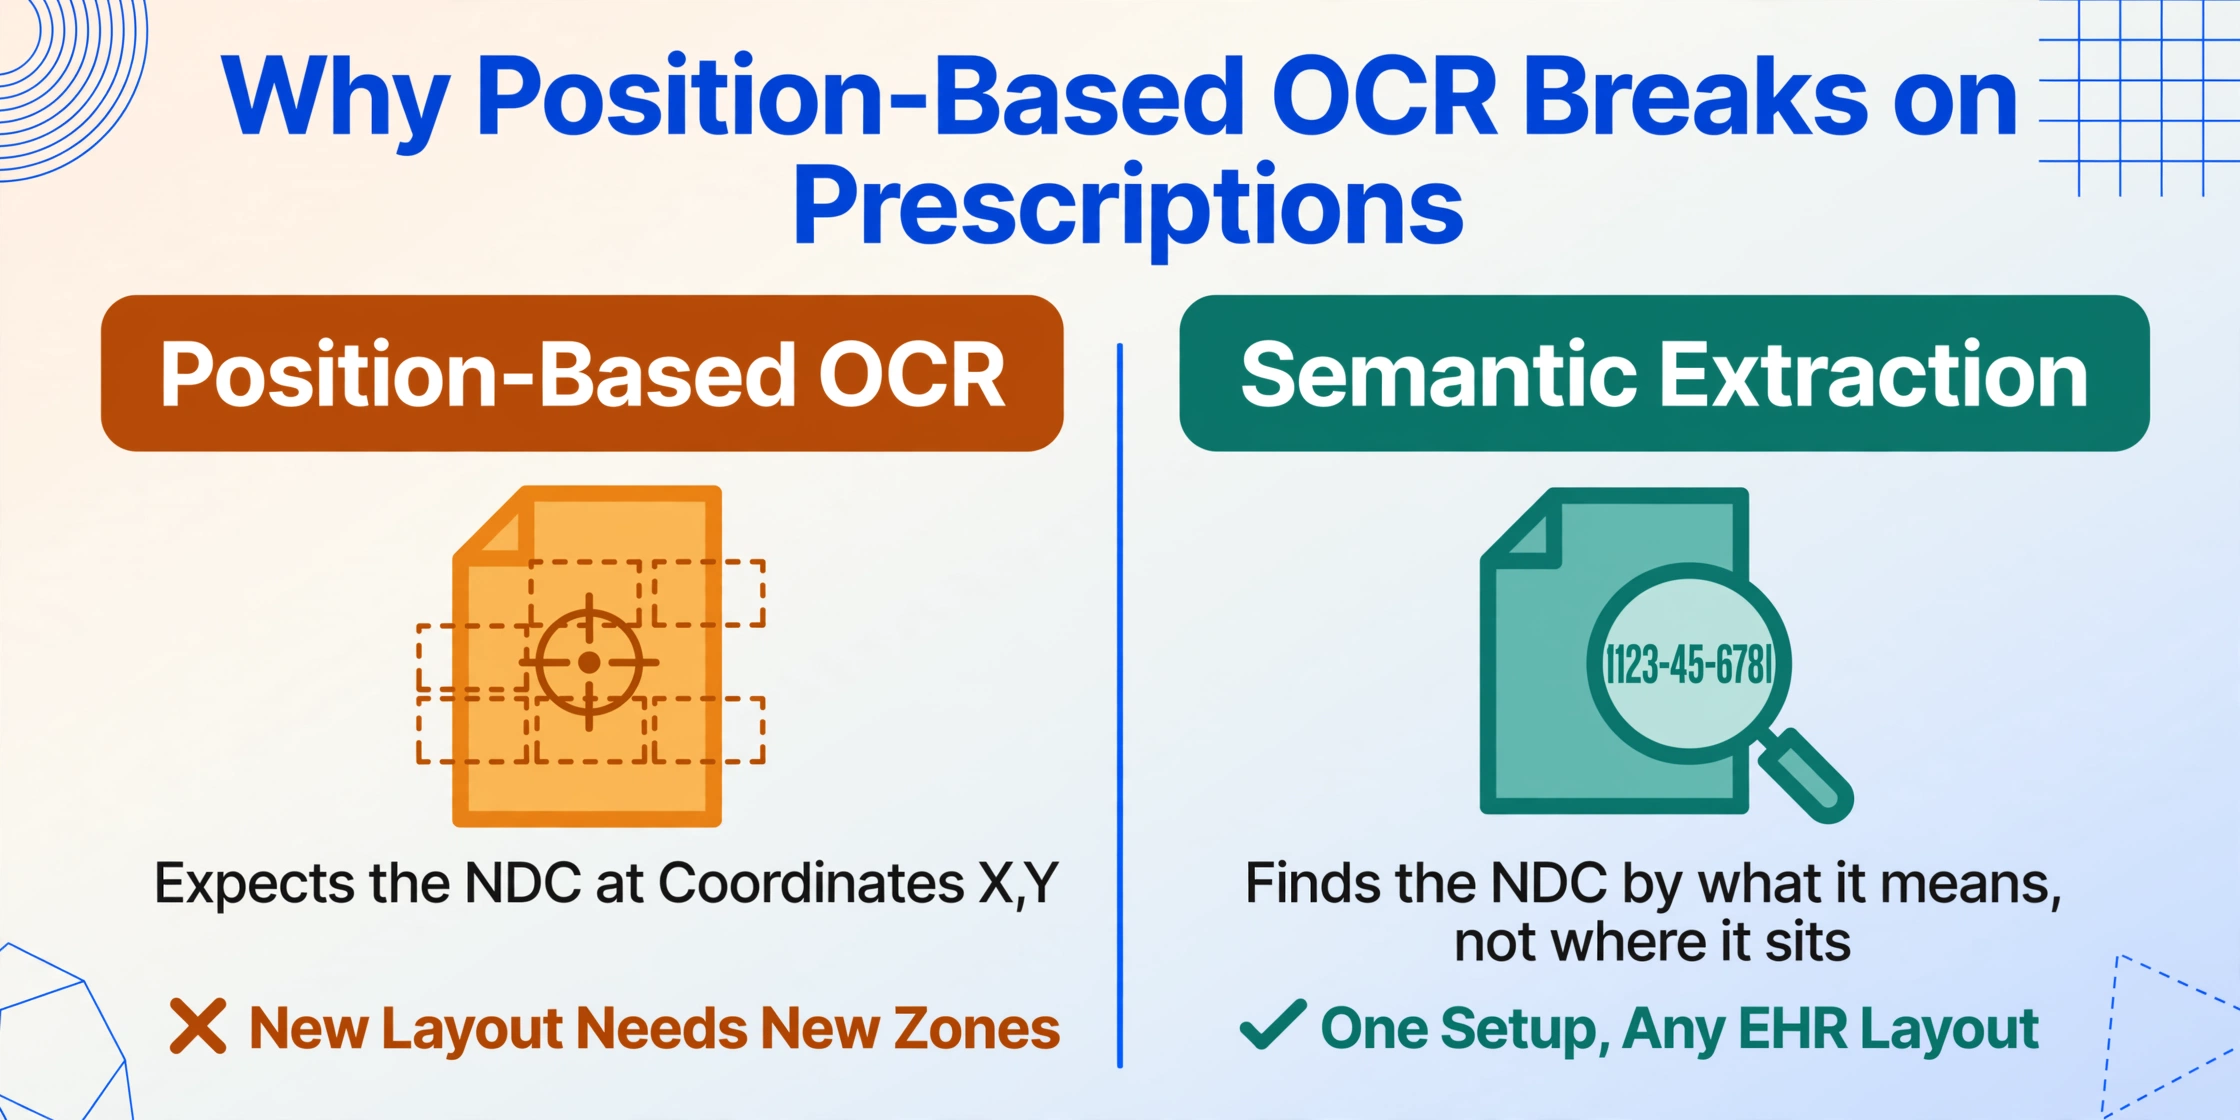
計算を変えるシフトは、タイピングの速さではありません。翻訳ステップを完全に取り除くことです——AIが薬局技術者のように処方箋を読み、数字を書き間違えることがないようにすることです。
ほとんどの文書抽出ツールはテンプレートベースのアプローチを採用しています。ページ上の特定フィールドが存在するゾーンを定義し、そのゾーンをOCRで読み取ります。これは標準化されたフォームには有効ですが、処方箋は標準化の正反対です。ヒューストンのChen医師のオフィスからの処方箋は、シカゴのMinuteClinicからのものとはまったく異なります。手書きはさまざまで、EHRベンダーごとにe-script PDFのレイアウトも異なり、FAXの品質は送信元の機器によって異なります。
ImageToTable.aiは、カスタム列抽出と呼ばれる根本的に異なるアプローチを採用しています。AIにデータがページのどこにあるかを伝える代わりに、フィールドの位置ではなく意味によって何を見つけたいかを伝えます。「薬剤名」「規格」「NDC」「用法(SIG)」などの列名を定義すると、AIは文書全体を読み取り、セマンティックな文脈を理解して各値を特定し、構造化された行を返します。フォーマットは関係ありません。レイアウトも関係ありません。AIはデータがどこにあるかではなく、何を意味するかを探しています。
これが位置ベース抽出(従来のOCR:「NDCは座標X,Yにあるはず」)とセマンティックベース抽出(AI:「ラベラー・製品・パッケージ構造を持つ10桁の医薬品識別子をページ上のどこでも認識する」)の違いです。処方箋が鮮明なe-script PDFでも、薬局スタンプがかろうじて読めるほど色あせたFAXでも、AIのアプローチは同じです。
このシステムは推論列もサポートしています。これは、ページに印刷された情報を見つけるのではなく、文脈からAIが導き出すフィールドです。たとえば、「規制区分(II/III/IV/V)」のような列は、AIに薬剤を特定させ、DEAの規制物質スケジュールを照合させ、分類を記入させます——「スケジュールII」が処方箋自体のどこにも記載されていなくてもです。同じアプローチは、治療クラス、先発品か後発品かのフラグ付け、フォーミュラリ層の予測にも機能します。
ステップバイステップ:処方箋画像から構造化スプレッドシートへ
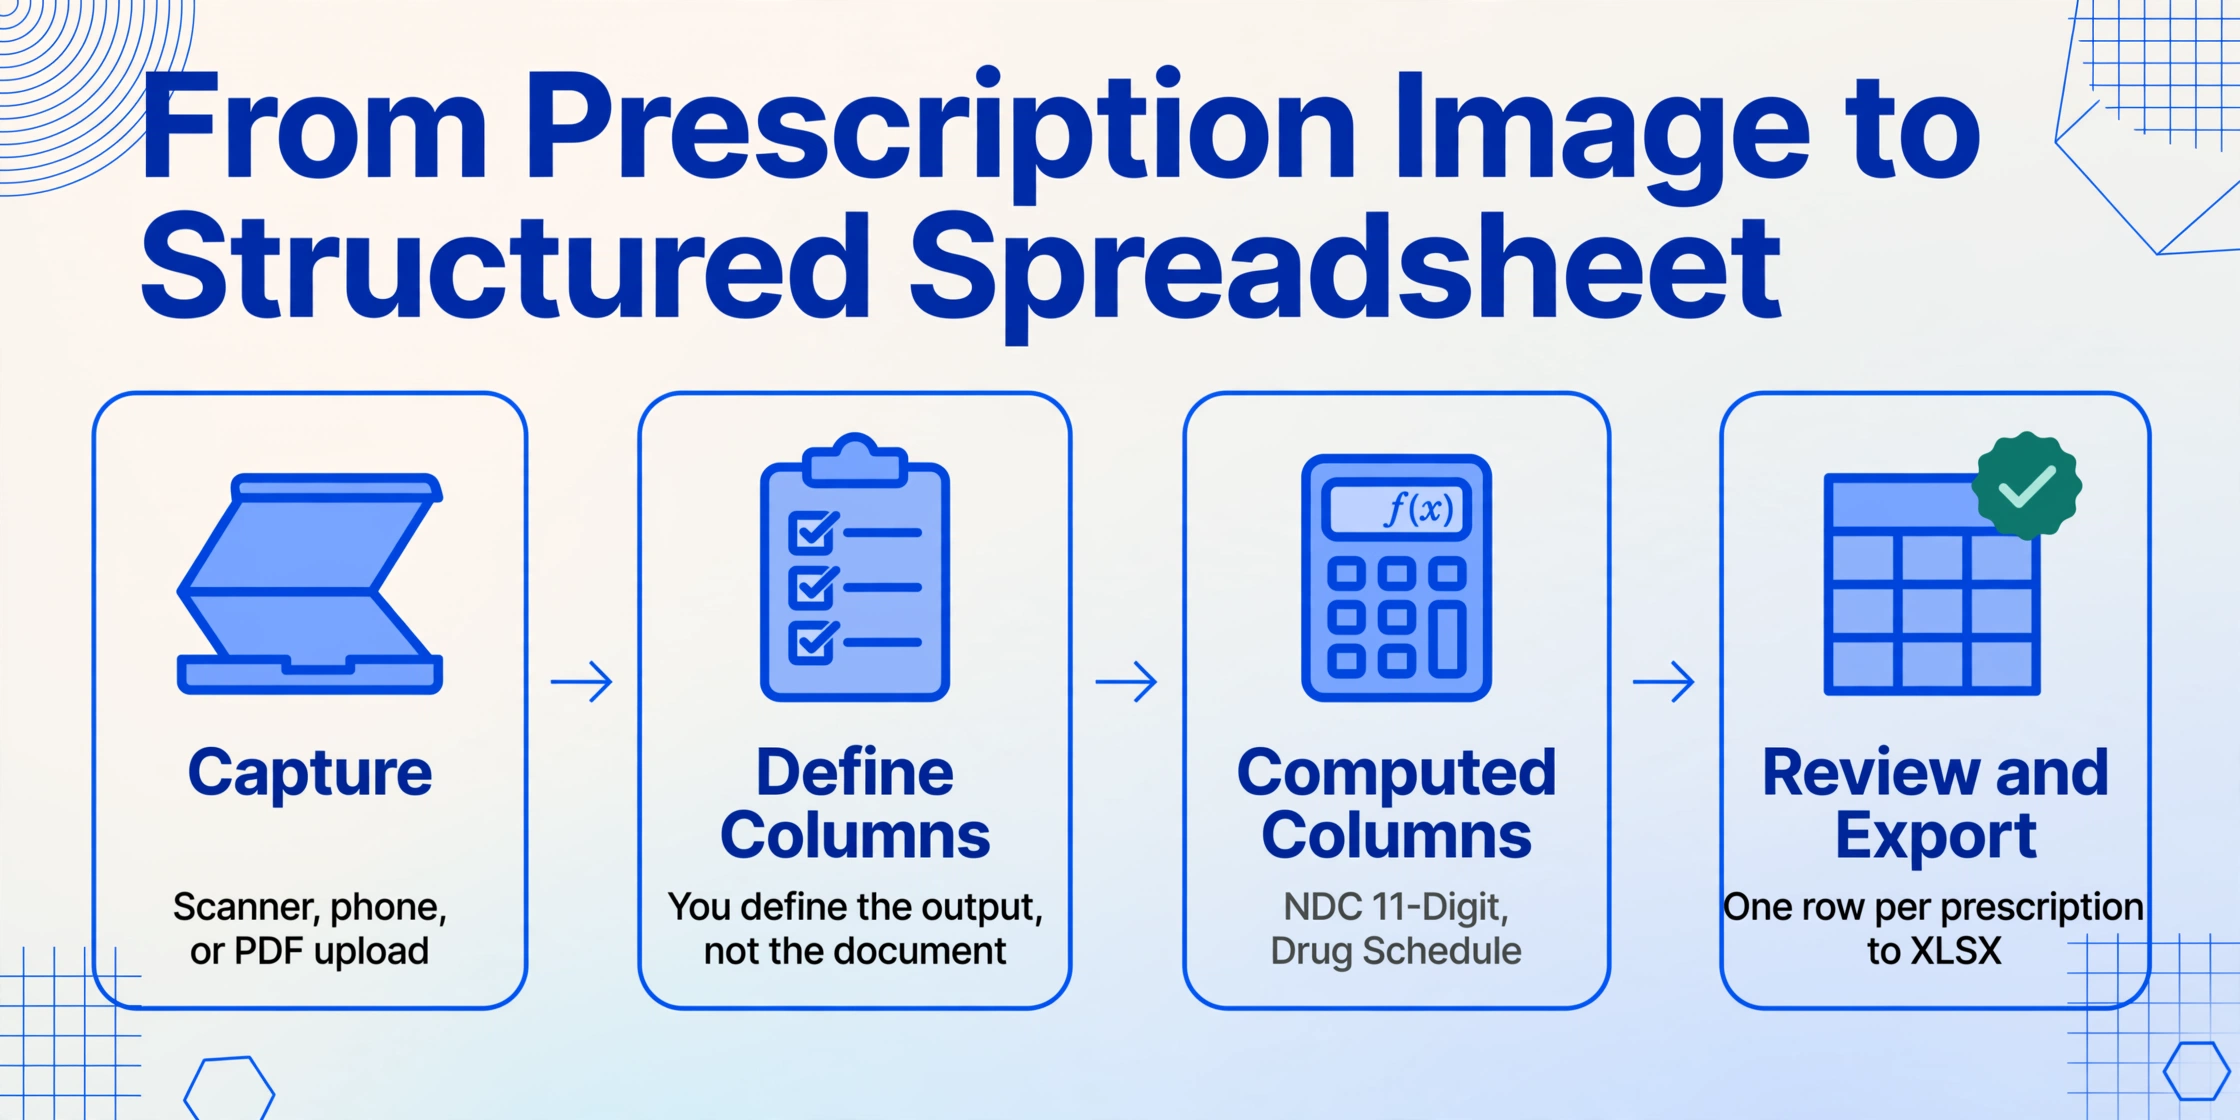
実際のワークフローをご紹介します。理論もデモのごまかしもありません。紙の処方箋の束や、デスクトップにあるe-script PDFフォルダがあれば、これが画像からExcelへの道筋です。
処方箋を取り込む
紙の処方箋はフラットベッドスキャナーでスキャンするか、スマホのカメラで撮影します。e-Script PDFは直接アップロード可能です。印刷は不要です。バッチアップロードにも対応しており、一度に50枚の処方箋をドロップすれば、すべて処理キューに入ります。また、原本の処方箋ではなく、患者さんが薬局のボトルをスマホで撮影した写真がソースの場合(自宅でのリフィル管理ではよくあるケースです)、同じ列で処方箋ラベルの写真も同様にきれいに読み取れます。
出力列を定義する
必要なフィールド名を入力します。処方箋の場合、一般的な列セットは次のとおりです:薬剤名、用量強度、剤形、NDC、用法(SIG)、数量、日数、リフィル回数、処方医名、処方医NPI。これらが出力スプレッドシートのヘッダーになります。出力を定義するのはあなたであり、ドキュメントではありません。
計算列と推論列を追加する(任意)
印刷されている内容を超えて活用できます。「NDC 11桁(必要に応じて10桁から変換)」のような計算列を追加して、請求用にNDCを自動整形できます。または「薬剤スケジュール(選択肢:II/III/IV/V/非管理)」のような推論列を追加して、規制薬物を自動分類できます。AIが抽出と計算の両方を1回のパスで処理します。
確認してエクスポートする
AIが構造化テーブルを返します。処方箋ごとに1行、列はあなたの定義に一致します。結果をWebインターフェースで確認するか、Excel(XLSX)に直接エクスポートできます。Google Sheetsユーザーは、Sheetsアドオンを使用すると、Sheetsから離れることなく結果をスプレッドシートに直接書き込めます。
ファイルは安全に処理され、保存されることはありません。
HIPAAと患者データについては?
AI抽出ツールを検討する薬局は、まず「これはHIPAAコンプライアンス上の問題を引き起こすか?」という問いから始める必要があります。答えは、そのツールがビジネスアソシエイトに該当するかどうか、そして適切な契約が締結されているかどうかにかかっています。
薬局はHIPAA(45 CFR § 160.103)の下で対象事業者に該当します。患者の氏名と薬剤名を含む処方箋画像は保護対象医療情報(PHI)であり、これを代行処理する第三者サービスと共有する場合、そのサービスはビジネスアソシエイトとなります。45 CFR § 164.504(e)に基づき、対象事業者はPHIをベンダーに開示する前に、署名済みのビジネスアソシエイト契約(BAA)を締結していなければなりません。
これは任意の書類手続きではなく、法的に義務付けられた契約です。BAAはビジネスアソシエイトがPHIに対してできること・できないことを規定し、指定された期間内での漏えい通知を義務付け、ベンダーをHIPAAのセキュリティ規則および漏えい通知規則の対象とします。文書処理にAIツールを使用する薬局は、事前に2点を確認すべきです:(1) ベンダーがBAAに署名するか、(2) ベンダーのデータ取り扱い(保持、暗号化、サーバーの所在地)がBAAの要件に適合しているか。
ImageToTable.aiはファイルを一時的に処理します。ドキュメントが読み取られ、データが抽出され、処理完了後はサーバーにファイルは保存されません。正式なHIPAA文書が必要な薬局向けに、BAAを提供しています。同じ枠組みは、薬局の文脈で使用されるあらゆる文書抽出ツールにも適用されます。(医療文書タイプ別のHIPAA考慮事項の詳細については、HIPAA医療文書抽出ガイドをご覧ください。)
既存の薬局ワークフローにおける位置づけ
これはPioneerRx、QS/1、その他の薬局管理システム(PMS)の代替ではありません。PMSの上流で動作する前処理ツールであり、データ入力ステップをワークフローで最も遅い部分から最も速い部分へと変えます。
実際の薬局の日常業務にAI抽出が組み込まれる具体的な連携ポイントは、次の3つです。
1. 朝のバッチ処理:FAXと紙のキューを解消
技術者が最初の90分間をFAXされた処方箋の束の入力に費やす代わりに、すべてをスキャンまたは撮影し、バッチアップロードし、列を一度定義すれば、数分で完成したスプレッドシートが得られます。その後、技術者は各行を元の画像と照合します。これは転記ステップではなく検証ステップであり、データをPMSにコピーします。手動のコピー&ペーストでも、レビューと検証は、読み取りと入力よりも劇的に速くなります。
2. 卸売業者データとの在庫照合
主要な医薬品卸売業者3社 — McKesson、Cencora(旧AmerisourceBergen)、Cardinal Health — は、米国内の全処方薬の90%以上をまとめて流通させています(Commonwealth Fund(2022年)によると)。複数の卸売業者の価格表にわたって在庫を照合する際、サプライヤーのPDFからNDCと医薬品名を抽出して比較用スプレッドシートにまとめることで、何時間にも及ぶ手作業の並行照合を排除できます。
3. 保険請求サポート
請求に処方箋の文書提出が必要な場合 — Surescriptsを通じた事前承認、Medicaid監査への対応、NDC明細項目を含むCMS-1500請求書フォームなど — 関連フィールドをクリーンなスプレッドシートに抽出することで、紙のファイルを探して入力するという作業を迅速化します。(請求処理に特化したワークフローについては、CMS-1500請求書フォームデータの抽出に関するガイドをご覧ください。)
これらの各シナリオにおいて、PMSは引き続き記録のシステムとして機能します。AI抽出は変換ステップ — 画像やPDFを構造化フィールドに変換する作業 — を処理し、技術者の役割は転記から検証へと移行します。それが、3時間の入力作業と20分の確認作業の違いです。
AI抽出が役立つ場面と、そうでない場面
正直に限界をお伝えします。薬局業界では過剰な約束は禁物です。
AI抽出が得意なもの:印刷された電子処方箋PDF、タイプされたFAX処方箋、標準的な薬剤名が書かれた比較的読みやすい手書き処方箋、包装に印刷されたNDC、標準化された用法コード(1T PO QD、2 puffs QID PRNなど)。FDA NDCディレクトリは毎日更新され、市販されている全医薬品の有効なリストが掲載されています。AIはこれを参照フレームとして、抽出したNDCを検証できます。
依然として人間の判断が必要なもの:極度に読みにくい手書き文字(ベテラン薬剤師でも目を凝らすようなもの)、曖昧な薬剤名の略語(HCTZ vs. ヒドロクロロチアジド — 文脈依存)、非標準的な調剤指示、矛盾した指示が含まれる処方箋。AIは不確かな場合は推測せずにフラグを立てます。薬剤師の臨床的判断は代替できません。このツールは入力を減らすものであって、思考を減らすものではありません。
このツールが行わないこと:請求の裁定(それはPMSとPBMの役割です)、薬剤使用評価、患者IDや保険資格の確認は行いません。これはデータ抽出ステップであり、その役割に正確で、できないことについては正直です。
よくある質問
手書きの処方箋でも使えますか?
はい、ある程度読みやすい手書き文字であれば問題ありません。ビジュアルAIモデルは多様な手書きスタイルでトレーニングされています。ただし、破れたメモ帳の端に走り書きされたような、ベテラン薬剤師でも解読に苦しむ処方箋は、どんなAIにとっても困難です。人間が読めるならAIも通常は読めます。人間が読めないなら、AIもおそらく読めません。
異なるEHRシステムからの電子処方箋PDFにも対応できますか?
はい — ここでフォーマット非依存の抽出が真価を発揮します。Epic、Cerner、小規模診療所のEHRのいずれから来た電子処方箋でも、レイアウトは異なりますがデータフィールドは意味的に同じです。AIは位置ではなく意味で読み取るため、異なるEHR出力ごとに設定を変える必要はありません。
NDCフォーマットの変換はどのように行いますか?
計算列を設定することで、任意の10桁NDCフォーマット(4-4-2、5-3-2、または5-4-1)を、正しいゼロ埋めルールを適用して11桁のHIPAA請求フォーマット(5-4-2)に自動変換できます。AIはラベルに印刷されたNDCを読み取り、請求対応の11桁バージョンを別の列として出力します。手動変換は不要です。
薬局管理ソフトウェアと連携できますか?
ImageToTable.aiはPioneerRx、QS/1、Rx30などのPMSプラットフォームに直接接続するわけではありません。これは前処理ツールです。出力はExcelスプレッドシート(またはアドオン経由のGoogle Sheets)で、それをPMSへのデータ入力ソースとして使用します。スプレッドシートをPMS入力前の確認チェックリストとして使う薬局もあれば、行をコピーペーストする薬局もあります。ワークフローの改善は連携自体ではなく、3時間のタイピングを確認ステップに置き換える点にあります。
これはHIPAA準拠ですか?
ImageToTable.aiはファイルを一時的に処理し、抽出完了後に保存することはありません。45 CFR § 164.504(e)に基づきBAA(ビジネスアソシエイト契約)が必要な薬局向けに提供しています。PHIを扱う他の第三者ツールと同様に、患者を特定できる処方箋画像をアップロードする前に、薬局はBAAが締結されていることを確認する必要があります。医療文書抽出におけるHIPAAのより広い視点については、医療文書抽出のためのHIPAA準拠ガイドをご覧ください。
処方箋データ抽出の精度はどのくらいですか?
印刷された明確な処方箋データの場合、精度は99%に達します。これは、印刷された表データに関するツールの全体的なベンチマークと一致しています。手書きの処方箋や画質の低いFAXはばらつきが生じます。重要な行動の変化:困難な入力でも95%の精度であれば、5%の項目を確認・修正するテクニシャンの方が、100%を手入力するよりもはるかに速いのです。精度の議論は完璧さではなく、検証中に検出されたエラーを修正する時間が、ゼロからの手入力より少ないかどうかが重要です。
すべてを変える計算
1枚50秒の処方箋で、1日200枚は167分のデータ入力時間 — ほぼ3時間です。AI抽出により、その50秒が1行あたり5秒の確認時間に変わり、初期バッチ処理時間を加えても、同じ200枚は合計約25分で完了します。
これは小幅な改善ではありません。テクニシャンがシフトの半分を入力に費やすか、元の画像との照合、臨床フラグの確認、在庫管理、患者対応など、実際に人間の判断が必要なタスクにほぼすべての時間を費やすかの違いです。
そして、数字を見ている薬局経営者にとって:1日3時間のテクニシャン時間は、控えめに見積もって時給$18で、手動データ入力のみに費やされる人件費は年間約$14,000 — 1人のテクニシャン、控えめな処方箋量での話です。忙しい個人薬局でテクニシャン2人に拡大すると、キー入力のコストは削除に値する項目になります。
これは薬局管理システムがなくなるという意味ではありません。それを支えるデータ入力ステップ — タイピング、NDC形式変換、SIG翻訳 — に、ようやく高速化の道ができたということです。紙とデータベースの間でテクニシャンが人間APIになる必要のない道です。