Et si la saisie des données d'ordonnance
prenait 5 secondes au lieu de 50 ?
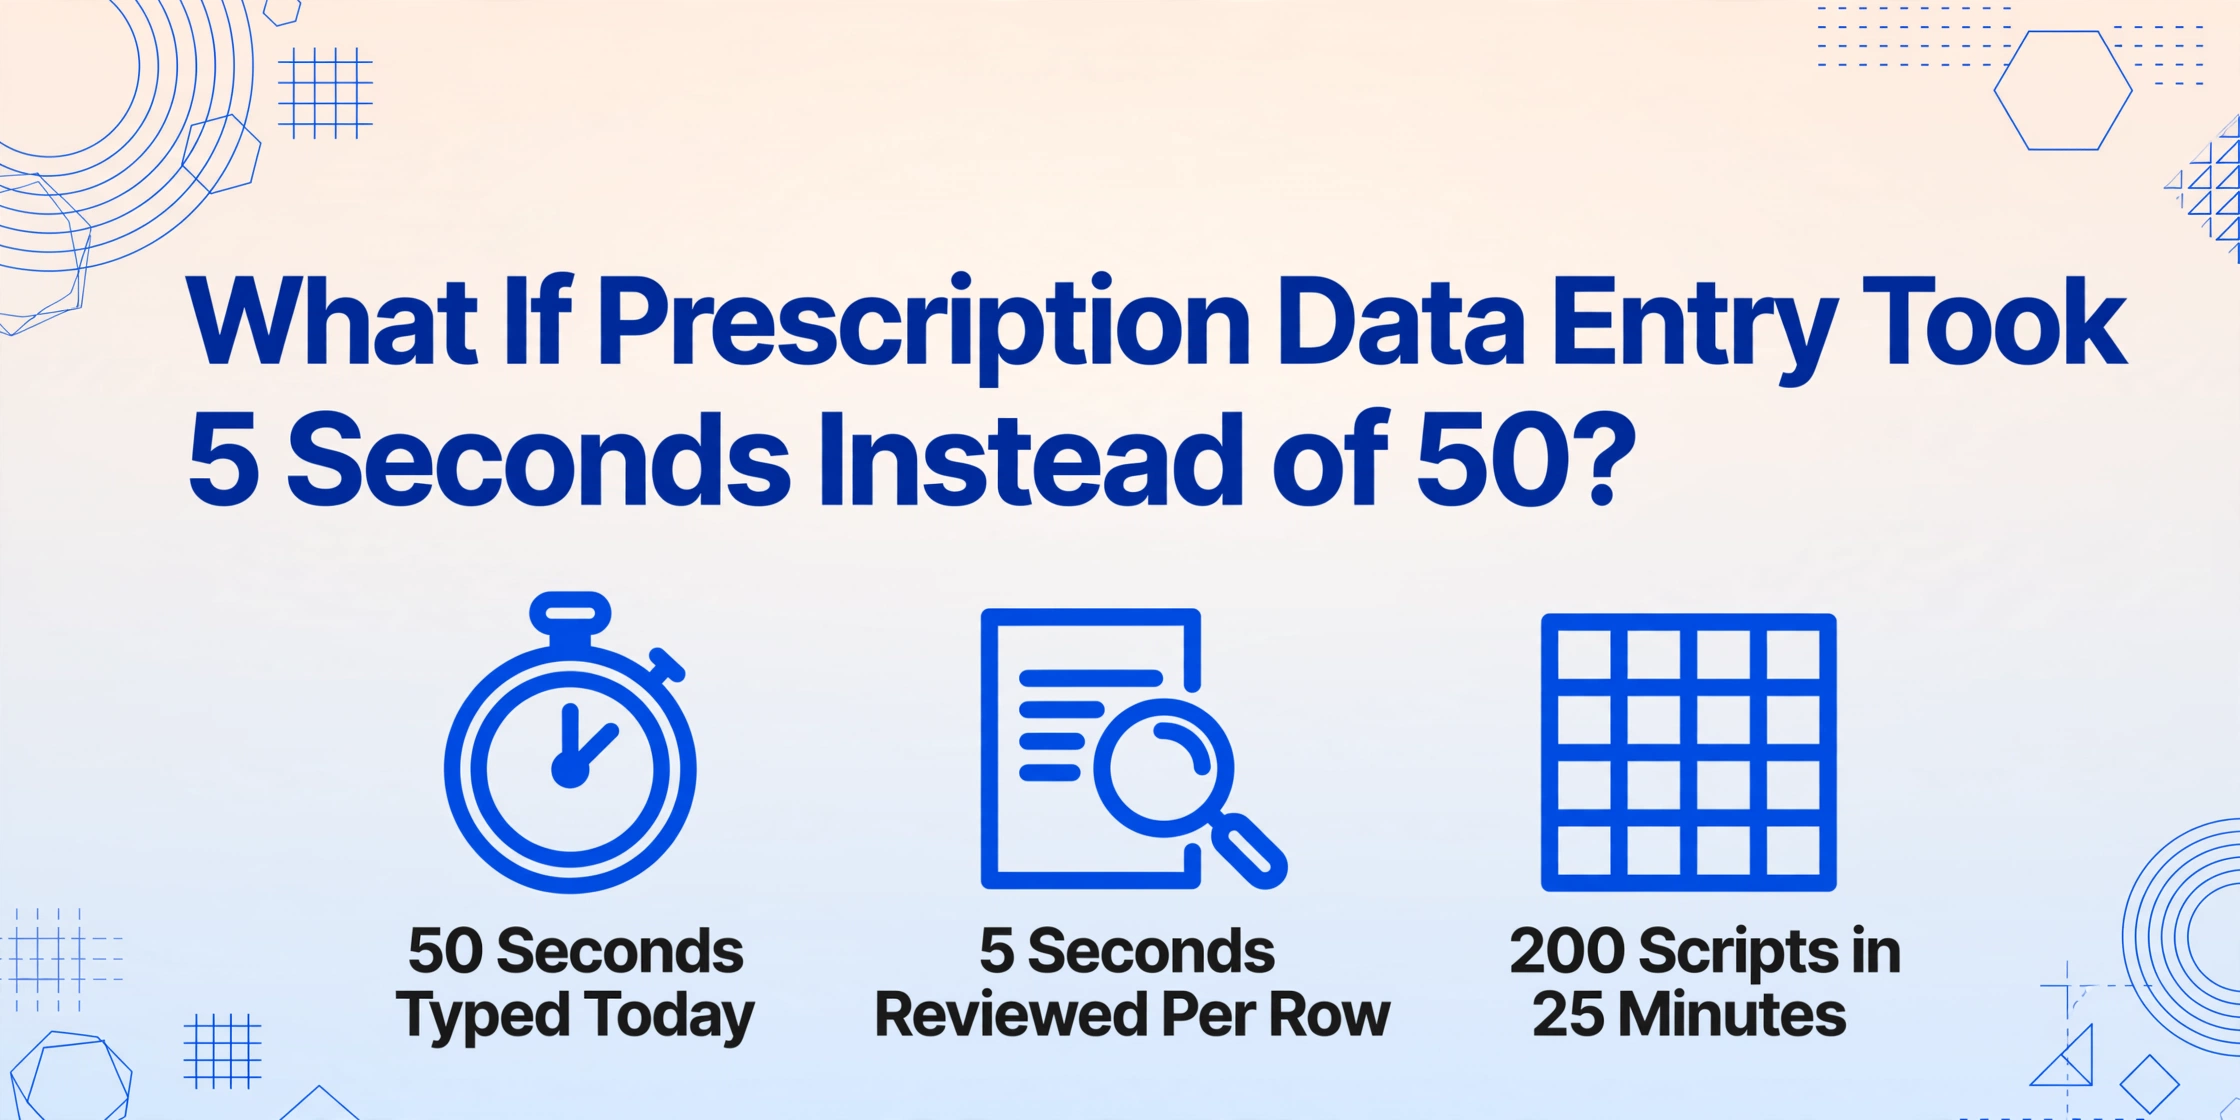
Cinquante secondes. C'est le temps de saisie standard par ordonnance dans la plupart des chaînes de pharmacies, selon les techniciens qui suivent leurs propres indicateurs. À 200 ordonnances par jour — un volume modeste pour une pharmacie indépendante occupée — cela représente près de trois heures passées à taper les noms de médicaments, les dosages, les chiffres NDC et les codes de posologie (SIG) dans un système de gestion de pharmacie. Pas de vérification. Pas de conseil. Juste de la saisie. Et voici ce dont peu de gens hors du milieu pharmaceutique parlent : l'American Pharmacists Association estime que 1,5 % de toutes les ordonnances délivrées contiennent une erreur — soit environ 67,5 millions d'erreurs en une seule année, dont beaucoup sont attribuables à ce qui s'est passé au clavier pendant la saisie.
Points clés à retenir
- Une précision de saisie de 43 % à deux mois n'est pas le signe d'un technicien en pharmacie lent ou négligent — c'est ce qui se produit lorsqu'on demande à un humain d'être un convertisseur de format en temps réel entre chaque présentation d'ordonnance et une base de données unique et rigide.
- Un seul NDC nécessite l'une de trois règles de remplissage par zéros pour atteindre le format de facturation HIPAA à 11 chiffres, et un seul chiffre erroné fait rejeter la réclamation — aucune vitesse de frappe ne résout un problème de traduction de format.
- Lorsque l'IA lit les ordonnances selon ce que signifient les données plutôt que selon leur position sur la page, les trois heures de transcription du technicien se réduisent à vingt minutes de vérification.
Le coût caché de chaque frappe
Les erreurs médicamenteuses touchent au moins 1,5 million d'Américains chaque année, pour un coût économique estimé à 77 milliards de dollars — et une part significative commence à l'écran de saisie, pas au comptoir de préparation.
L'Academy of Managed Care Pharmacy (AMCP) identifie trois des types d'erreurs de délivrance les plus courants : délivrer le mauvais médicament, se tromper de dosage, et ne pas détecter les interactions médicamenteuses. Ces trois erreurs peuvent provenir d'un seul chiffre mal saisi dans le système de gestion de pharmacie (PMS).
Les techniciens en pharmacie en sont douloureusement conscients. Sur le subreddit r/PharmacyTechnician, un technicien Walmart avec deux mois d'expérience a signalé un taux de précision de saisie de 43 %. Dans les grandes chaînes, la référence est de 50 secondes par tâche de saisie avec un objectif de 17 tâches par heure — et ce, pour du personnel expérimenté. Une méta-analyse de 2018 portant sur 62 études d'erreurs de délivrance publiée dans Research in Social and Administrative Pharmacy a révélé un taux d'erreur de délivrance global de 1,6 %, les taux les plus élevés étant systématiquement liés à des environnements où la charge de saisie manuelle est plus lourde.
Ce n'est pas un problème de manque d'implication du personnel de pharmacie. C'est une inadéquation structurelle : chaque ordonnance arrive dans un format différent, mais chaque PMS attend les mêmes champs structurés.
À quoi ressemble vraiment la saisie en pharmacie
Avant qu'un seul comprimé ne soit compté, un technicien doit traduire le format dans lequel l'ordonnance est arrivée — papier, fax, téléphone ou e-prescription — en une série de champs structurés dans le système de gestion de pharmacie.
Le flux de travail est cohérent dans la plupart des logiciels de pharmacie — PioneerRx, QS/1, Computer-Rx, Rx30 — même si la disposition des boutons diffère. Une ordonnance arrive par l'un des quatre canaux suivants :
- Ordonnance papier — Remise au comptoir ou reçue par fax. Le technicien lit les noms de médicaments, les dosages et les signatures du médecin manuscrits.
- e-Prescription — Arrive numériquement via Surescripts selon la norme NCPDP SCRIPT (1,9 milliard de transactions par an). Déjà structurée, mais nécessite souvent une vérification manuelle pour les erreurs de correspondance des champs.
- Par téléphone — Appelée par le cabinet du prescripteur. Un technicien retranscrit en temps réel, souvent tout en gérant d'autres tâches.
- Fax — Représente encore une part surprenante des transmissions d'ordonnances, en particulier de la part des petits cabinets et des prestataires spécialisés.
Une fois l'ordonnance arrivée, le technicien ouvre le PMS et commence la saisie. Dans PioneerRx, cela se fait au poste de réception ou dans la file d'attente de saisie. Les champs qui doivent être renseignés incluent généralement :
| Champ | Exemple | Pourquoi c'est important |
|---|---|---|
| Nom du médicament | Lisinopril | Doit correspondre à l'entrée du formulaire ; confusion générique/marque fréquente |
| Dosage | 10 mg | Mauvais dosage = l'un des trois types d'erreurs les plus courants (AMCP) |
| Forme galénique | Comprimé | La substitution comprimé/gélule nécessite le jugement du pharmacien |
| NDC | 68180-0981-03 | Doit être converti au format HIPAA à 11 chiffres (5-4-2) pour la facturation |
| Posologie (SIG) | 1T PO QD | Les codes SIG doivent être correctement développés pour les étiquettes patient |
| Quantité | 30 | Liée au calcul de la durée du traitement pour l'adjudication de l'assurance |
| Renouvellements | 3 | Substances de l'annexe II : 0 renouvellement par la loi (21 CFR 1306.12) |
| Prescripteur | NPI / DEA # | Requis pour la soumission de la réclamation ; mauvais NPI = rejet |
Après la saisie, l'ordonnance passe au pharmacien pour une pré-vérification. Si le pharmacien détecte une erreur de saisie — mauvais dosage, mauvais NDC, SIG mal interprété — elle est renvoyée au technicien pour correction. Chaque correction est un cycle de reprise qui ajoute des minutes à un processus déjà mesuré en secondes. Comme l'a dit un commentateur Reddit sur r/pharmacy : « Je fais ça depuis un mois et c'est tellement ennuyeux. Pas de délivrance, pas de préparation, juste des téléphones et des ordinateurs. »
Pourquoi « tapez simplement plus vite » ne résoudra pas le problème
Le goulot d'étranglement n'est pas la vitesse de frappe. C'est la traduction de format — et aucun raccourci clavier ne résout le fait que chaque ordonnance arrive en parlant un langage de données différent.
Réfléchissez à ce qu'un technicien fait réellement pendant ces 50 secondes. Il ne transcrit pas simplement — il interprète et convertit :
Une ordonnance manuscrite peut indiquer « Lisinopril 10 mg, 1 comprimé par jour, #30 ». Le technicien doit décomposer cela en champs de base de données distincts, développer la posologie dans un langage compréhensible pour le patient, rechercher le code national des médicaments (NDC) correct pour le fabricant et la taille de conditionnement spécifiques en stock, et vérifier que le format de facturation HIPAA à 11 chiffres (5-4-2) est correctement complété par des zéros non significatifs. Le répertoire NDC de la FDA répertorie trois formats à 10 chiffres actuellement utilisés — 4-4-2, 5-3-2 et 5-4-1 — chacun exigeant une règle de complétion par zéros différente pour atteindre le format à 11 chiffres exigé par CMS pour toutes les transactions couvertes par HIPAA.
| Étiquette du conditionnement (10 chiffres) | HIPAA 11 chiffres (5-4-2) | Règle de conversion |
|---|---|---|
| 1234-5678-91 (4-4-2) | 01234-5678-91 | Zéro non significatif au segment fabricant |
| 12345-678-91 (5-3-2) | 12345-0678-91 | Zéro non significatif au segment produit |
| 12345-6789-1 (5-4-1) | 12345-6789-01 | Zéro non significatif au segment conditionnement |
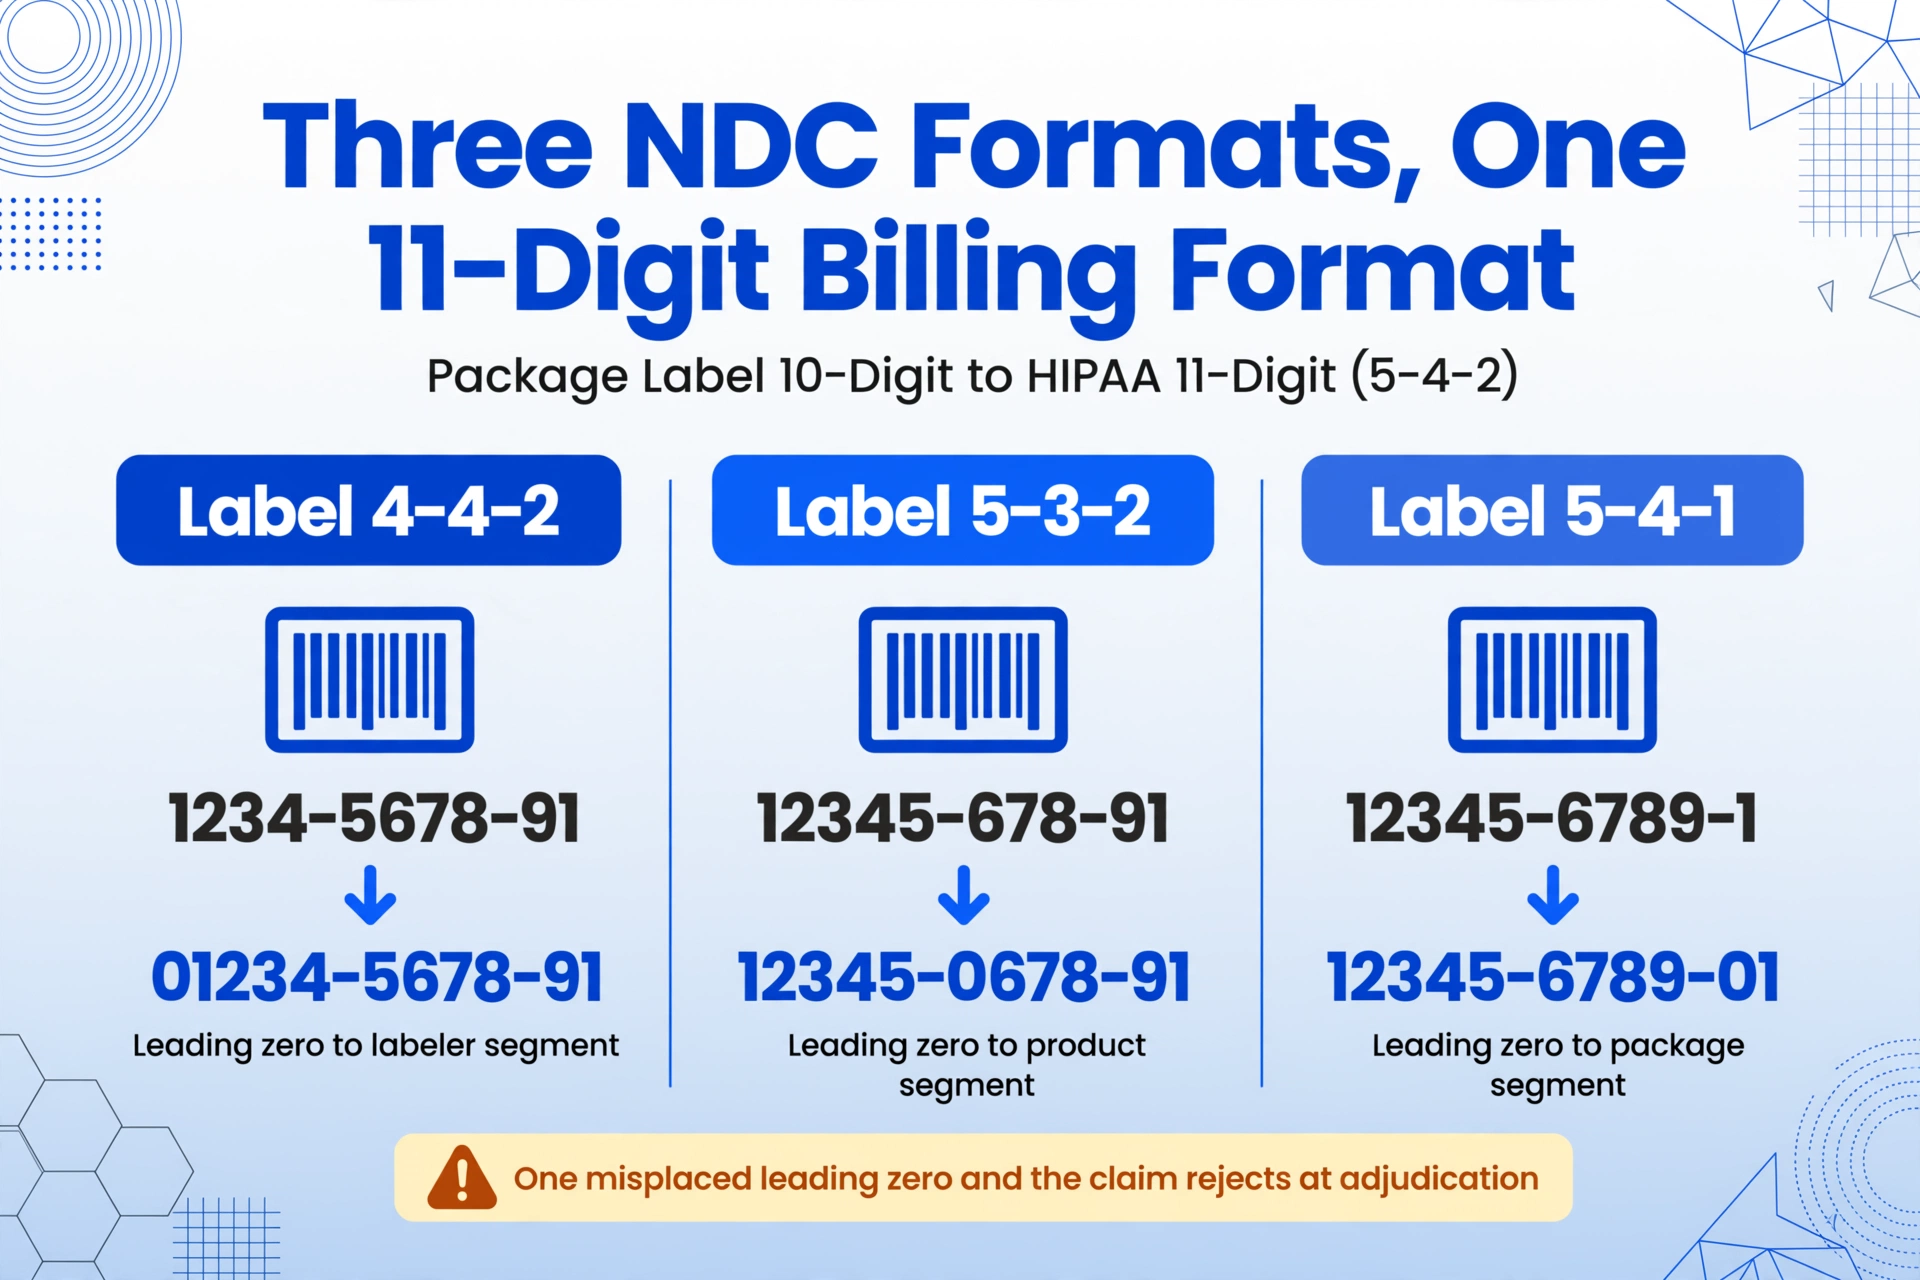
Faites une erreur sur un chiffre — un seul zéro non significatif mal placé — et la réclamation est rejetée lors de l'adjudication. Le technicien revient en arrière, relit le flacon, ressaisit les données. Encore 30 secondes. Multipliez cela par chaque NDC sur chaque ordonnance, chaque jour.
Ensuite, il y a la couche RxNorm. Lorsque le système de gestion de pharmacie (PMS) utilise un vocabulaire de médicaments (par exemple, First Databank) et que le dossier de santé électronique d'un hôpital en utilise un autre (par exemple, Multum), RxNorm — maintenu par la National Library of Medicine — fournit les noms cliniques normalisés des médicaments qui servent d'intermédiaire entre eux. Mais un technicien qui saisit manuellement les données n'interagit pas directement avec RxNorm. Il a simplement besoin que les données soient correctes pour que les systèmes en aval puissent les mapper.
Le vrai problème est que la saisie manuelle des données demande à un humain de jouer le rôle de convertisseur de format — un travail pour lequel les ordinateurs ont été conçus. L'ordonnance n'est pas le problème. Le clavier l'est.
Apprendre à l'IA à lire comme un technicien en pharmacie
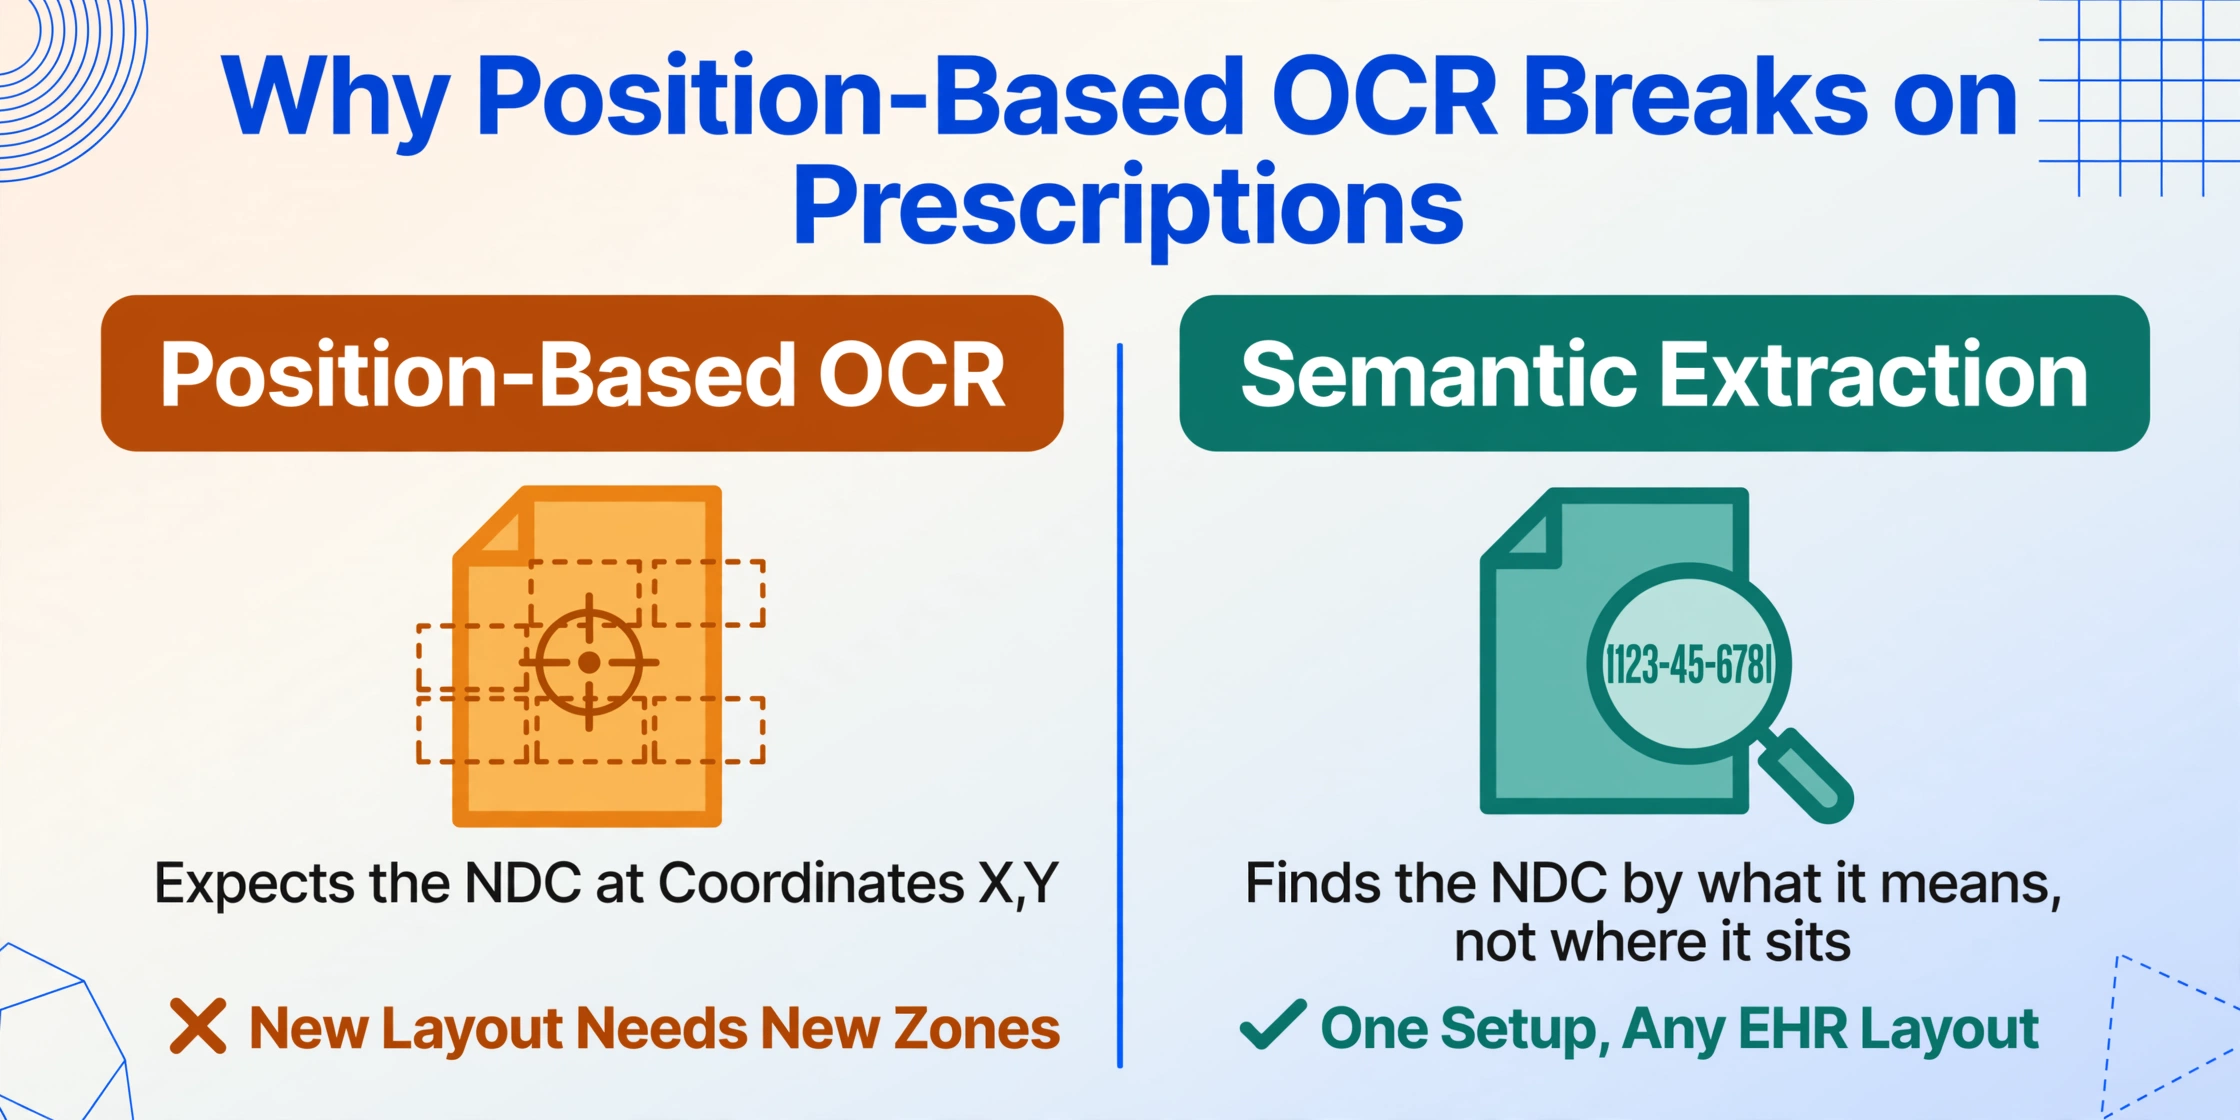
Le changement qui modifie l'équation n'est pas une frappe plus rapide. C'est la suppression complète de l'étape de traduction — et laisser l'IA lire l'ordonnance comme le ferait un technicien, sauf qu'elle ne transpose jamais un chiffre.
La plupart des outils d'extraction de documents utilisent une approche basée sur des modèles : vous définissez des zones sur une page où se trouvent des champs spécifiques, et le logiciel OCR ces zones. Cela fonctionne très bien pour les formulaires standardisés — mais les ordonnances sont tout le contraire de standardisées. Une ordonnance du cabinet du Dr Chen à Houston ne ressemble en rien à celle d'une MinuteClinic à Chicago. L'écriture manuscrite varie. Les mises en page des PDF d'e-prescription varient selon le fournisseur de DSE. La qualité des télécopies varie selon la machine de l'expéditeur.
ImageToTable.ai adopte une approche fondamentalement différente appelée Extraction de colonnes personnalisées. Au lieu de dire à l'IA où se trouvent les données sur la page, vous lui dites ce que vous voulez trouver — par le sens du champ, et non par sa position. Vous définissez des noms de colonnes comme « Nom du médicament », « Dosage », « NDC » et « Posologie (SIG) », et l'IA lit l'intégralité du document, localise chaque valeur en comprenant son contexte sémantique, et renvoie une ligne structurée. Le format n'a pas d'importance. La mise en page n'a pas d'importance. L'IA cherche ce que signifient les données, pas où elles se trouvent.
C'est la différence entre l'extraction basée sur la position (OCR traditionnel : « Je m'attends à ce que le NDC soit aux coordonnées X,Y ») et l'extraction basée sur la sémantique (IA : « Je reconnais un identifiant de médicament à 10 chiffres avec une structure fabricant-produit-conditionnement n'importe où sur cette page »). L'ordonnance peut être un PDF d'e-prescription net ou une télécopie si délavée que le tampon de la pharmacie est à peine lisible — l'approche de l'IA est la même.
Le système prend également en charge les colonnes inférées : des champs que l'IA déduit du contexte plutôt que de les trouver imprimés sur la page. Par exemple, une colonne comme « Classe (II/III/IV/V) » invite l'IA à identifier le médicament, à recouper son calendrier de substances contrôlées de la DEA, et à remplir la classification — même si « Classe II » n'apparaît nulle part sur l'ordonnance elle-même. La même approche fonctionne pour la classe thérapeutique, le signalement marque vs générique, et la prédiction de palier de formulaire.
Étape par étape : de l'image d'ordonnance au tableur structuré
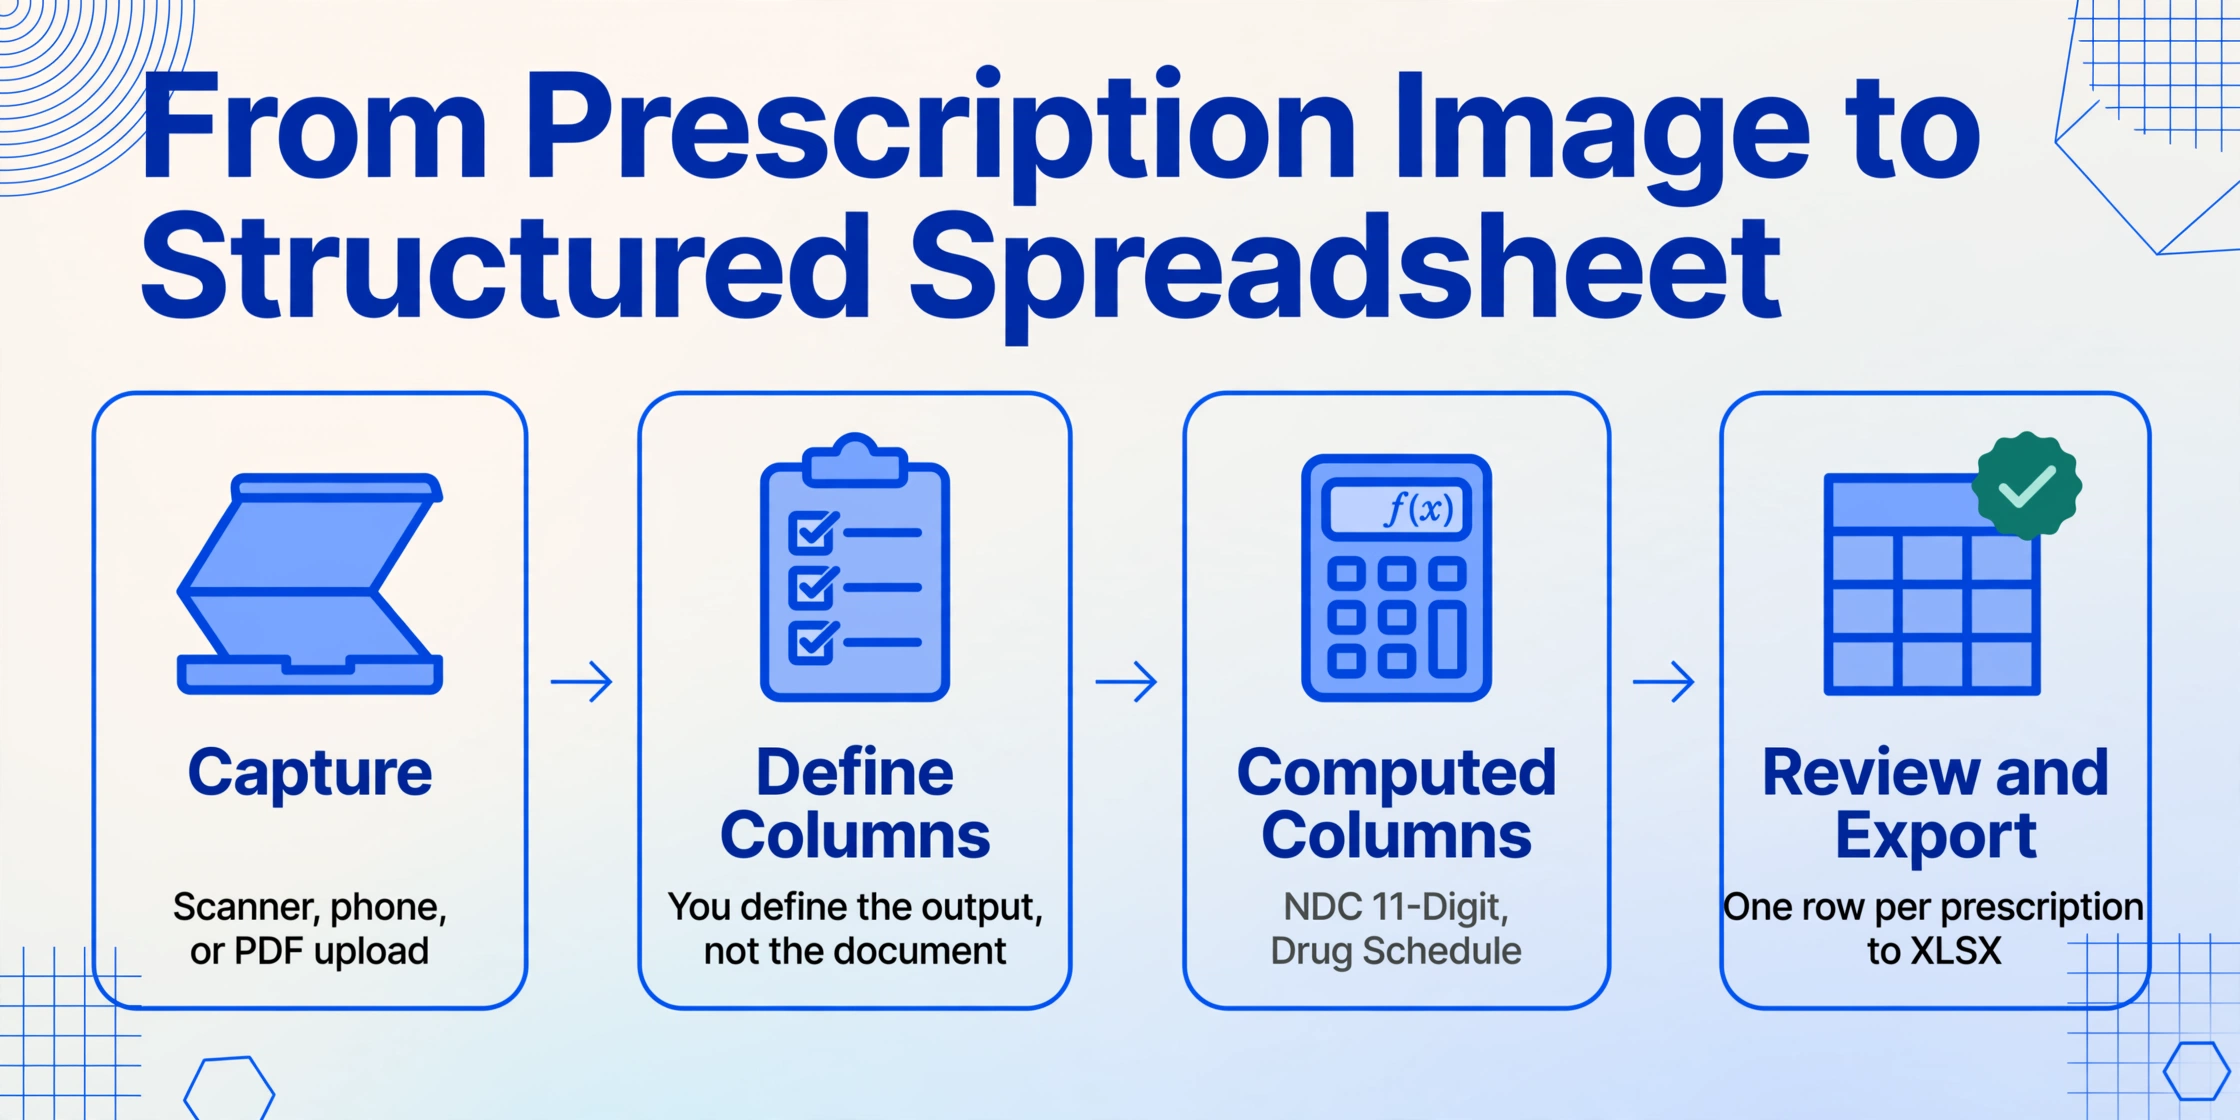
Voici le flux de travail réel — pas de théorie, pas de démo trompeuse. Si vous avez une pile d'ordonnances papier ou un dossier de PDF d'e-scripts sur votre bureau en ce moment, voici le chemin de l'image vers Excel.
Capturez l'ordonnance
Numérisez les ordonnances papier avec un scanner à plat, ou photographiez-les avec l'appareil photo d'un téléphone. Les PDF d'e-scripts peuvent être téléchargés directement — aucune impression requise. Le téléchargement par lot fonctionne aussi : déposez 50 ordonnances d'un coup et elles sont toutes mises en file d'attente pour traitement. Et lorsque la source est une photo prise par le patient du flacon de pharmacie plutôt que l'ordonnance originale — le cas habituel pour le suivi des renouvellements à domicile — les mêmes colonnes lisent la photo d'étiquette d'ordonnance tout aussi proprement.
Définissez vos colonnes de sortie
Saisissez les noms de champs dont vous avez besoin. Pour les ordonnances, un ensemble de colonnes typique est : Nom du médicament, Dosage, Forme galénique, NDC, SIG/Directions, Quantité, Jours de traitement, Renouvellements, Nom du prescripteur, NPI du prescripteur. Ceux-ci deviennent les en-têtes de votre tableur de sortie — vous définissez la sortie, pas le document.
Ajoutez des colonnes calculées et inférées (facultatif)
Allez au-delà de ce qui est imprimé. Ajoutez une colonne calculée comme « NDC à 11 chiffres (conversion depuis le format à 10 chiffres si nécessaire) » pour formater automatiquement les NDC pour la facturation. Ou ajoutez une colonne inférée comme « Classification du médicament (options : II/III/IV/V/non contrôlé) » pour classer automatiquement les substances contrôlées. L'IA gère à la fois l'extraction et le calcul en une seule passe.
Vérifiez et exportez
L'IA renvoie un tableau structuré — une ligne par ordonnance, des colonnes correspondant à vos définitions. Vérifiez les résultats dans l'interface web ou exportez directement vers Excel (XLSX). Pour les utilisateurs de Google Sheets, le module complémentaire Sheets écrit les résultats directement dans votre tableur sans quitter Sheets.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Qu'en est-il de la HIPAA et des données des patients ?
Toute pharmacie qui évalue un outil d'extraction IA doit commencer par une question : cela crée-t-il un problème de conformité HIPAA ? La réponse dépend de savoir si l'outil est un partenaire commercial — et si les bons accords sont en place.
Les pharmacies sont des entités couvertes au titre de la HIPAA (45 CFR § 160.103). Lorsque vous partagez des informations de santé protégées (PHI) — et une image d'ordonnance contenant le nom d'un patient et le nom d'un médicament est une PHI — avec un service tiers qui les traite en votre nom, ce service devient un partenaire commercial. En vertu de 45 CFR § 164.504(e), une entité couverte doit avoir signé un accord de partenaire commercial (BAA) avant de divulguer des PHI à un fournisseur.
Ce n'est pas une formalité facultative — c'est un contrat juridiquement requis. Un BAA stipule ce que le partenaire commercial peut et ne peut pas faire avec les PHI, exige une notification de violation dans des délais précis, et soumet le fournisseur à la règle de sécurité et à la règle de notification de violation de la HIPAA. Les pharmacies qui utilisent des outils d'IA pour le traitement de documents devraient confirmer deux choses dès le départ : (1) le fournisseur signera un BAA, et (2) la gestion des données du fournisseur — conservation, chiffrement, localisation des serveurs — est conforme à ce que le BAA exige.
ImageToTable.ai traite les fichiers de manière transitoire : le document est lu, les données sont extraites, et le fichier n'est pas stocké sur ses serveurs une fois le traitement terminé. Pour les pharmacies qui exigent une documentation HIPAA formelle, un BAA est disponible. Le même cadre s'applique à tout outil d'extraction de documents utilisé dans un contexte pharmaceutique. (Pour une analyse plus approfondie des considérations HIPAA concernant les types de documents médicaux, consultez notre guide d'extraction de documents médicaux HIPAA.)
Où cela s'intègre dans votre flux de travail de pharmacie existant
Ce n'est pas un remplacement pour PioneerRx, QS/1 ou tout autre système de gestion de pharmacie. C'est un outil de prétraitement qui se situe en amont de votre PMS — transformant l'étape de saisie des données de la partie la plus lente du flux de travail en la plus rapide.
Voici trois points d'intégration concrets où l'extraction par IA s'insère dans la journée d'une pharmacie active :
1. Lot du matin : traiter la file de fax et de papier
Au lieu qu'un technicien passe les 90 premières minutes à saisir une pile d'ordonnances faxées, scannez ou photographiez-les toutes, téléversez-les en lot, définissez les colonnes une fois, et recevez une feuille de calcul complète en quelques minutes. Le technicien examine ensuite chaque ligne par rapport aux images originales — une étape de vérification, pas de transcription — et copie les données dans le PMS. Même avec un copier-coller manuel, la vérification est nettement plus rapide que la lecture et la saisie.
2. Rapprochement des stocks avec les données des grossistes
Les trois principaux grossistes pharmaceutiques — McKesson, Cencora (anciennement AmerisourceBergen) et Cardinal Health — distribuent collectivement plus de 90 % de tous les médicaments sur ordonnance aux États-Unis, selon le Commonwealth Fund (2022). Lors du rapprochement des stocks entre plusieurs listes de prix de grossistes, l'extraction des NDC et des noms de médicaments à partir des PDF des fournisseurs dans une feuille de calcul comparative élimine des heures de recoupement manuel côte à côte.
3. Gestion des réclamations d'assurance
Lorsqu'une réclamation exige la soumission de la documentation de l'ordonnance — pour une autorisation préalable via Surescripts, pour une réponse à un audit Medicaid, ou pour des formulaires de réclamation CMS-1500 avec des lignes NDC — l'extraction des champs pertinents dans une feuille de calcul propre accélère ce qui serait autrement un exercice de recherche de dossier papier et de saisie. (Voir notre guide sur l'extraction des données des formulaires de réclamation CMS-1500 pour le flux de travail spécifique à la facturation.)
Dans chacun de ces scénarios, le PMS reste le système de référence. L'extraction par IA gère l'étape de traduction — transformant une image ou un PDF en champs structurés — et le rôle du technicien passe de la transcription à la vérification. C'est la différence entre passer trois heures à saisir et 20 minutes à vérifier.
Là où l'extraction par IA aide — et là où elle ne sert à rien
Soyons directs sur les limites, car la pharmacie est le mauvais secteur pour faire des promesses excessives.
Ce que l'extraction par IA gère bien : les PDF d'e-prescriptions imprimés, les ordonnances par fax dactylographiées, les ordonnances manuscrites claires avec des noms de médicaments standard, les codes NDC imprimés sur les emballages, les codes de posologie (SIG) standardisés (1T PO QD, 2 bouffées QID PRN). Le répertoire des codes nationaux des médicaments (NDC) de la FDA est mis à jour quotidiennement et contient les listes actives de tous les médicaments commercialisés — l'IA peut l'utiliser comme cadre de référence pour valider les NDC extraits.
Là où vous avez encore besoin du jugement humain : une écriture manuscrite très illisible (le genre qui fait plisser les yeux même à un pharmacien expérimenté), des abréviations de noms de médicaments ambiguës (HCTZ vs. hydrochlorothiazide — dépend du contexte), des instructions de préparation non standard, des ordonnances avec des directives contradictoires. L'IA signalera l'incertitude plutôt que de deviner. Le jugement clinique d'un pharmacien n'est pas remplaçable — l'outil réduit la frappe, pas la réflexion.
Ce que cela ne fait pas : Cela ne gère pas les réclamations (c'est le travail de votre PMS et du gestionnaire de prestations pharmaceutiques). Cela n'effectue pas de revue d'utilisation des médicaments. Cela ne vérifie pas l'identité du patient ni l'éligibilité à l'assurance. Il s'agit d'une étape d'extraction de données — précise sur ce qu'elle fait, honnête sur ce qu'elle ne fait pas.
Foire aux questions
Cela fonctionne-t-il avec les ordonnances manuscrites ?
Oui, pour une écriture manuscrite raisonnablement lisible. Le modèle d'IA visuelle est entraîné sur divers styles d'écriture manuscrite. Mais une ordonnance écrite en cursive rapide sur un coin de bloc-notes déchiré — le genre qui déroute un pharmacien expérimenté — mettra n'importe quelle IA au défi. Si un humain peut la lire, l'IA le peut généralement aussi. Si un humain ne le peut pas, l'IA ne le peut probablement pas non plus.
Peut-elle gérer les PDF d'e-prescriptions provenant de différents systèmes de dossiers de santé électroniques (DSE) ?
Oui — c'est là que l'extraction indépendante du format brille. Que l'e-prescription provienne d'Epic, de Cerner ou du DSE d'un petit cabinet, la mise en page varie mais les champs de données sont sémantiquement les mêmes. L'IA lit par le sens, pas par la position, donc les différentes sorties des DSE ne nécessitent pas de configurations différentes.
Comment gère-t-elle la conversion du format NDC ?
Vous pouvez configurer une colonne calculée qui convertit automatiquement tout format NDC à 10 chiffres (4-4-2, 5-3-2 ou 5-4-1) au format de facturation HIPAA à 11 chiffres (5-4-2) en appliquant la règle de remplissage par zéros correcte. L'IA lit le NDC tel qu'imprimé sur l'étiquette et produit la version à 11 chiffres prête pour la facturation dans une colonne séparée — aucune conversion manuelle requise.
S'intègre-t-il à mon logiciel de gestion de pharmacie ?
ImageToTable.ai ne se branche pas directement sur PioneerRx, QS/1, Rx30 ou d'autres plateformes PMS — c'est un outil de prétraitement. La sortie est un fichier Excel (ou Google Sheets via le module complémentaire) que vous utilisez ensuite comme source pour la saisie de données dans votre PMS. Certaines pharmacies utilisent le tableur comme liste de vérification avant la saisie dans le PMS ; d'autres copient-collent des lignes. L'amélioration du flux de travail ne réside pas dans l'intégration — elle consiste à remplacer trois heures de frappe par une étape de révision.
Est-ce conforme à la HIPAA ?
ImageToTable.ai traite les fichiers de manière transitoire et ne les stocke pas après l'extraction. Un accord de partenaire commercial (BAA) est disponible pour les pharmacies qui en ont besoin en vertu du 45 CFR § 164.504(e). Comme pour tout outil tiers traitant des PHI, les pharmacies doivent confirmer que le BAA est signé avant de téléverser des images d'ordonnances identifiables. Pour une vue d'ensemble de la HIPAA dans l'extraction de documents médicaux, consultez notre guide de conformité HIPAA pour l'extraction de documents médicaux.
Quel est le taux de précision pour l'extraction des données d'ordonnances ?
Pour les données d'ordonnances imprimées et clairement tapées, la précision atteint 99 % — conformément à la référence globale de l'outil pour les données de tableaux imprimés. Les ordonnances manuscrites et les télécopies de mauvaise qualité introduisent de la variabilité. Le changement de comportement clé : même avec une précision de 95 % sur des entrées difficiles, un technicien qui vérifie et corrige 5 % des champs est nettement plus rapide que de saisir manuellement 100 % d'entre eux. La question de la précision ne porte pas sur la perfection — elle porte sur le fait de savoir si les erreurs détectées lors de la vérification coûtent moins de temps que la saisie manuelle à partir de zéro.
Le calcul qui change tout
À 50 secondes par ordonnance, 200 ordonnances par jour équivalent à 167 minutes de saisie de données — près de trois heures. Si l'extraction par IA transforme ces 50 secondes en une vérification de 5 secondes par ligne, plus le temps de traitement initial du lot, les mêmes 200 ordonnances pourraient prendre 25 minutes au total.
Ce n'est pas une amélioration marginale. C'est la différence entre un technicien qui passe la moitié de son quart de travail à taper et un technicien qui consacre presque tout son temps à des tâches qui exigent réellement un jugement humain — vérifier les images originales, repérer les alertes cliniques, gérer les stocks, parler aux patients.
Et pour le propriétaire de pharmacie qui examine les chiffres : trois heures de temps de technicien par jour, à un taux prudent de 18 $/heure, représentent environ 14 000 $ par an en salaires consacrés uniquement à la saisie manuelle de données — pour un seul technicien, à un volume d'ordonnances modeste. Multipliez cela par deux techniciens dans une pharmacie indépendante très active, et le coût des frappes clavier devient une ligne de dépenses qui mérite d'être éliminée.
Rien de tout cela ne signifie que le système de gestion de pharmacie est sur le point de disparaître. Cela signifie que l'étape de saisie de données qui l'alimente — la frappe, la conversion du format NDC, la traduction de la posologie (SIG) — a enfin une voie plus rapide. Une voie qui ne demande pas à un technicien d'être une API humaine entre un morceau de papier et une base de données.