Was, wenn die Rezeptdateneingabe
5 Sekunden statt 50 dauert?
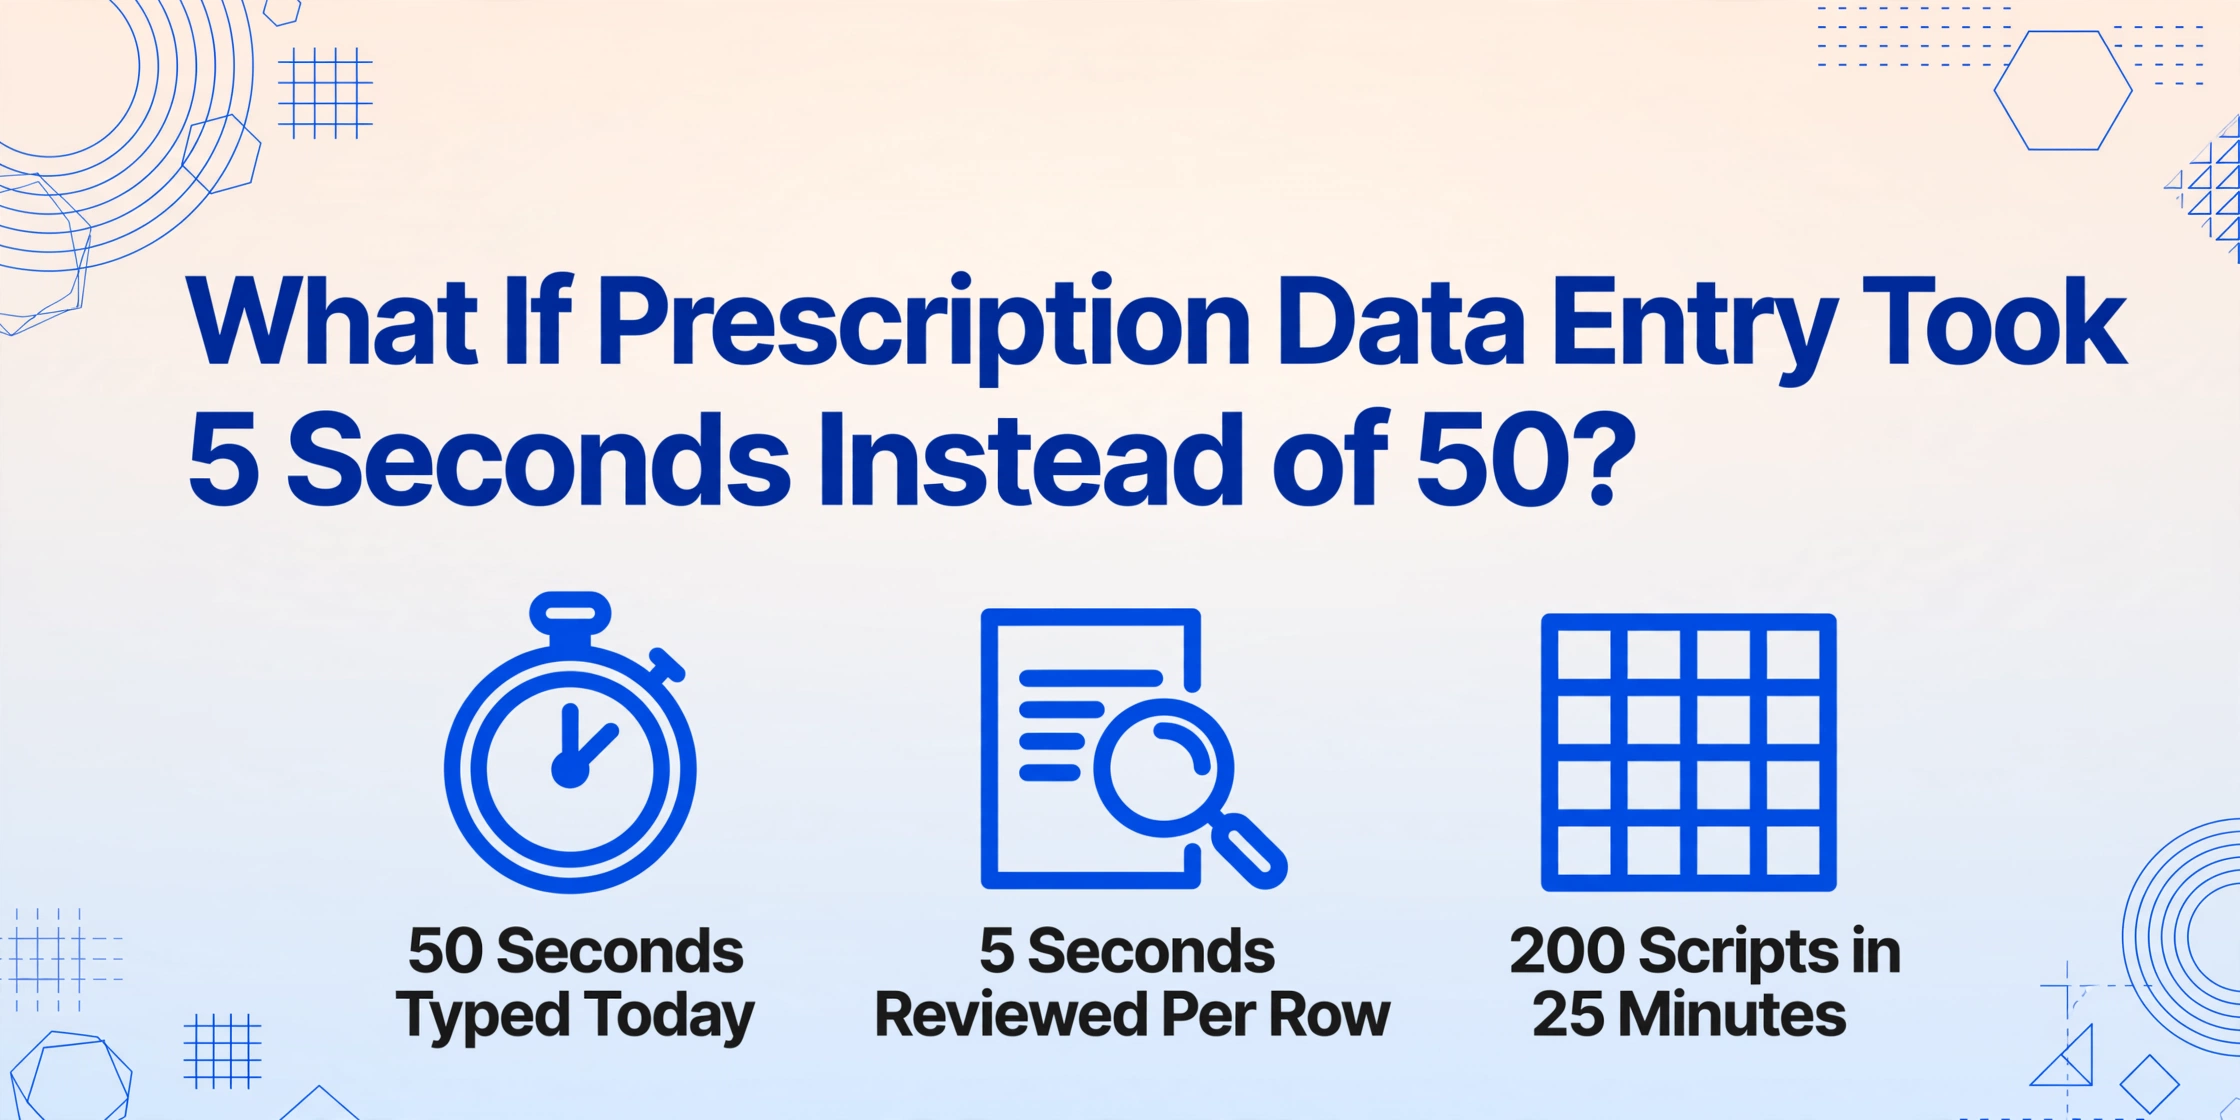
Fünfzig Sekunden. Das ist die Standardzeit für die Dateneingabe pro Rezept in den meisten Filialapotheken, wie Apothekenmitarbeiter anhand ihrer eigenen Kennzahlen feststellen. Bei 200 Rezepten pro Tag – ein moderates Volumen für eine gut besuchte Einzelapotheke – sind das fast drei Stunden, die damit verbracht werden, Medikamentennamen, Wirkstärken, NDC-Ziffern und SIG-Codes in ein Apothekenverwaltungssystem einzutippen. Nicht prüfen. Nicht beraten. Nur tippen. Und hier ist der Teil, über den außerhalb der Apotheke nur wenige sprechen: Die American Pharmacists Association schätzt, dass 1,5 % aller abgegebenen Rezepte einen Fehler enthalten – rund 67,5 Millionen Fehler in einem einzigen Jahr, von denen viele auf die Tastatureingabe während der Dateneingabe zurückzuführen sind.
Die wichtigsten Erkenntnisse
- Eine Dateneingabegenauigkeit von 43 % nach zwei Monaten bedeutet nicht, dass ein Apothekenmitarbeiter langsam oder nachlässig ist – das passiert, wenn man einen Menschen als Echtzeit-Formatkonverter zwischen jedem Rezeptlayout und einer einzigen starren Datenbank einsetzt.
- Eine einzelne NDC benötigt eine von drei verschiedenen Null-Auffüllregeln, um das 11-stellige HIPAA-Abrechnungsformat zu erreichen, und eine falsche Ziffer führt zur Ablehnung des Anspruchs – keine noch so hohe Tippgeschwindigkeit löst ein Formatübersetzungsproblem.
- Wenn KI Rezepte danach liest, was die Daten bedeuten, statt wo sie auf der Seite stehen, schrumpfen die drei Stunden Transkription des Mitarbeiters auf zwanzig Minuten Prüfung.
Die versteckten Kosten jedes Tastendrucks
Medikationsfehler schaden jährlich mindestens 1,5 Millionen Amerikanern, mit geschätzten wirtschaftlichen Kosten von 77 Milliarden Dollar – und ein erheblicher Teil beginnt am Dateneingabebildschirm, nicht am Zähltablett.
Die Academy of Managed Care Pharmacy (AMCP) identifiziert drei der häufigsten Abgabefehler: Abgabe des falschen Medikaments, falsche Dosierungsstärke und Übersehen von Arzneimittelwechselwirkungen. Alle drei können durch eine einzige falsch eingegebene Ziffer im Apothekenverwaltungssystem (PMS) entstehen.
Apothekenmitarbeiter sind sich dessen schmerzlich bewusst. Auf Reddits r/PharmacyTechnician berichtete ein Walmart-Techniker zwei Monate nach Arbeitsbeginn von einer Eingabegenauigkeit von 43 %. Bei großen Ketten liegt der Richtwert bei 50 Sekunden pro Dateneingabeaufgabe mit einem Durchsatz von 17 Aufgaben pro Stunde – und das für erfahrene Mitarbeiter. Eine Metaanalyse von 62 Studien zu Abgabefehlern aus dem Jahr 2018, veröffentlicht in Research in Social and Administrative Pharmacy, ergab eine globale gepoolte Abgabefehlerrate von 1,6 %, wobei die höchsten Raten zuverlässig mit Umgebungen mit höherer manueller Dateneingabelast verbunden waren.
Dies ist kein Problem mangelnder Sorgfalt des Apothekenpersonals. Es ist ein strukturelles Missverhältnis: Jedes Rezept kommt in einem anderen Format an, aber jedes PMS erwartet dieselben strukturierten Felder.
Wie die Dateneingabe in der Apotheke tatsächlich aussieht
Bevor auch nur eine einzige Tablette gezählt wird, muss ein Techniker das eingegangene Rezept – egal ob Papier, Fax, telefonisch oder als E-Rezept – in eine Reihe strukturierter Felder im Apothekenverwaltungssystem übersetzen.
Der Arbeitsablauf ist in den meisten Apothekensoftwares konsistent – PioneerRx, QS/1, Computer-Rx, Rx30 – auch wenn sich die Schaltflächenlayouts unterscheiden. Ein Rezept trifft über einen von vier Kanälen ein:
- Papierrezept – Über den Tresen gereicht oder per Fax eingegangen. Der Techniker liest handschriftliche Medikamentennamen, Stärken und Unterschriften des Arztes.
- E-Rezept – Kommt digital über Surescripts via NCPDP SCRIPT Standard (1,9 Milliarden solcher Transaktionen pro Jahr). Bereits strukturiert, erfordert aber dennoch oft eine manuelle Überprüfung auf Feldzuordnungsfehler.
- Telefonische Bestellung – Von der Praxis des Verschreibers telefonisch durchgegeben. Ein Techniker transkribiert in Echtzeit, oft während er andere Aufgaben erledigt.
- Fax – Macht immer noch einen überraschend großen Anteil der Rezeptübermittlungen aus, insbesondere von kleineren Praxen und Fachärzten.
Sobald das Rezept eingegangen ist, öffnet der Techniker das PMS und beginnt mit der Dateneingabe. In PioneerRx geschieht dies an der Annahmestation oder in der Dateneingabe-Warteschlange. Die Felder, die in der Regel ausgefüllt werden müssen, umfassen:
| Feld | Beispiel | Warum es wichtig ist |
|---|---|---|
| Arzneimittelname | Lisinopril | Muss mit dem Formulareintrag übereinstimmen; Verwechslung von Generika und Marken ist häufig |
| Stärke | 10 mg | Falsche Stärke = einer der drei häufigsten Fehlertypen (AMCP) |
| Darreichungsform | Tablette | Ersatz von Tabletten durch Kapseln erfordert pharmazeutisches Urteilsvermögen |
| NDC | 68180-0981-03 | Muss für die Abrechnung in das 11-stellige HIPAA-Format (5-4-2) umgewandelt werden |
| SIG / Einnahmehinweise | 1T PO QD | SIG-Codes müssen für Patientenaufkleber korrekt erweitert werden |
| Menge | 30 | Hängt mit der Berechnung der Tageversorgung für die Versicherungsabrechnung zusammen |
| Wiederholungen | 3 | Betäubungsmittel der Liste II: gesetzlich 0 Wiederholungen (21 CFR 1306.12) |
| Verschreiber | NPI / DEA-Nr. | Erforderlich für die Abrechnung; falscher NPI = Ablehnung |
Nach der Eingabe geht das Rezept zur Vorabprüfung an einen Apotheker. Stellt der Apotheker einen Dateneingabefehler fest – falsche Stärke, falscher NDC, falsch übersetzte SIG – geht es zur Korrektur zurück an den Techniker. Jede Korrektur ist ein Nachbearbeitungszyklus, der Minuten zu einem Prozess hinzufügt, der bereits in Sekunden gemessen wird. Wie ein Reddit-Kommentator in r/pharmacy sagte: „Ich mache das jetzt seit einem Monat und es ist so langweilig. Kein Ausgeben, kein Herstellen, nur Telefone und Computer.“
Warum „Einfach schneller tippen“ das Problem nicht löst
Der Engpass ist nicht die Tippgeschwindigkeit. Es ist die Formatübersetzung – und keine noch so gute Tastenkombination ändert etwas daran, dass jedes Rezept in einer anderen Datensprache ankommt.
Überlegen Sie, was ein Techniker in diesen 50 Sekunden tatsächlich tut. Er transkribiert nicht nur – er interpretiert und konvertiert:
Ein handschriftliches Rezept könnte „Lisinopril 10mg 1 Tablette täglich #30“ lauten. Der Techniker muss dies in einzelne Datenbankfelder zerlegen, die SIG in patientenverständliche Sprache erweitern, die korrekte NDC für den jeweiligen Hersteller und die Packungsgröße auf Lager nachschlagen und prüfen, ob das 11-stellige HIPAA-Abrechnungsformat (5-4-2) korrekt mit führenden Nullen aufgefüllt ist. Das NDC-Verzeichnis der FDA listet derzeit drei verschiedene 10-stellige Formate auf – 4-4-2, 5-3-2 und 5-4-1 –, die jeweils eine andere Null-Auffüllregel erfordern, um das 11-stellige Format zu erreichen, das CMS für alle HIPAA-abgedeckten Transaktionen verlangt.
| Packungsetikett (10-stellig) | HIPAA 11-stellig (5-4-2) | Umrechnungsregel |
|---|---|---|
| 1234-5678-91 (4-4-2) | 01234-5678-91 | Führende Null im Labeler-Segment |
| 12345-678-91 (5-3-2) | 12345-0678-91 | Führende Null im Produktsegment |
| 12345-6789-1 (5-4-1) | 12345-6789-01 | Führende Null im Packungssegment |
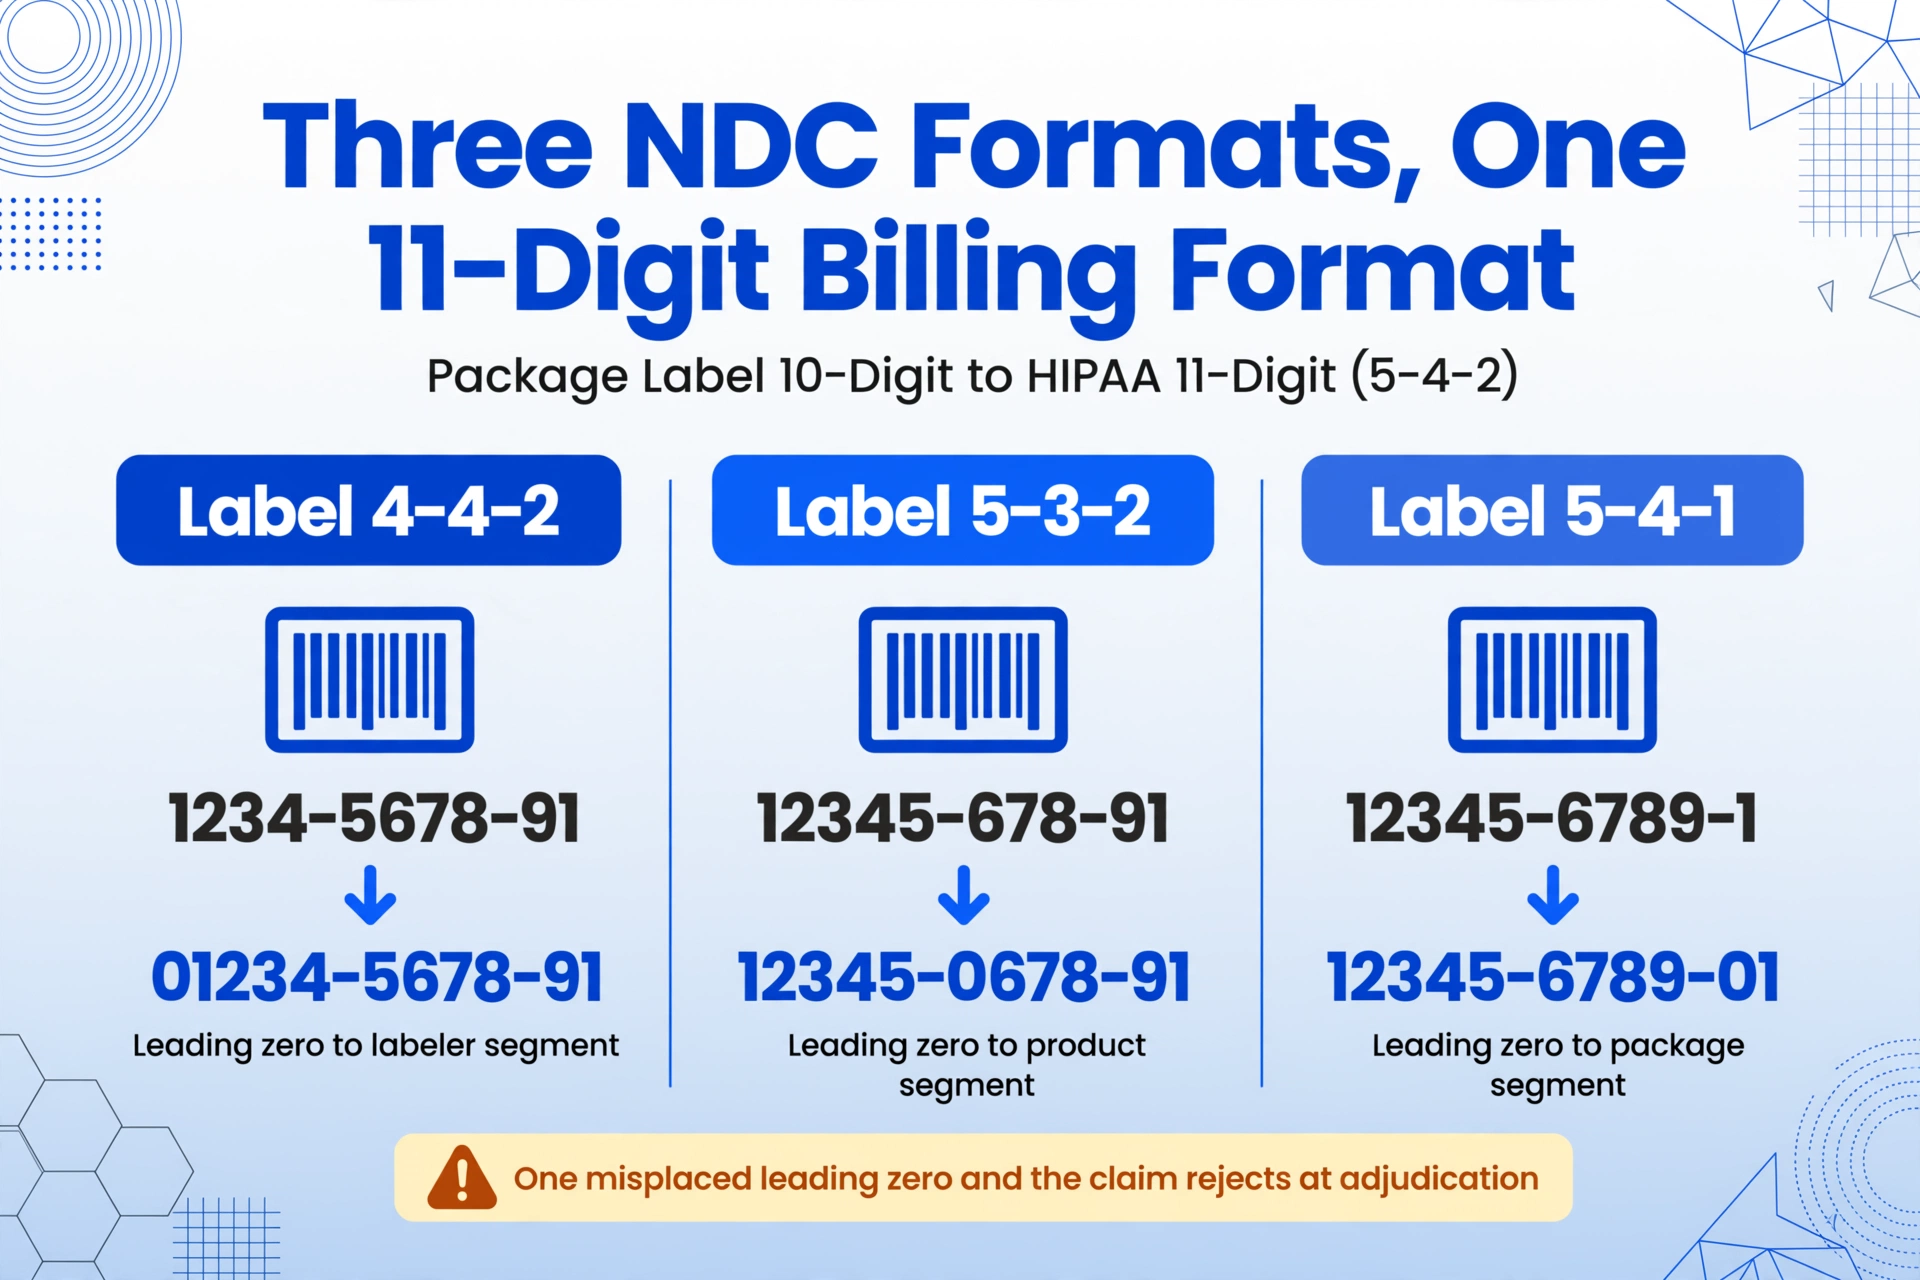
Wenn auch nur eine Ziffer falsch ist – eine einzige falsch platzierte führende Null – wird der Anspruch bei der Abrechnungsprüfung abgelehnt. Der Techniker geht zurück, liest die Flasche erneut, gibt die Daten neu ein. Weitere 30 Sekunden. Multiplizieren Sie das mit jeder NDC auf jedem Rezept an jedem Tag.
Dann gibt es noch die RxNorm-Ebene. Wenn das Apothekenverwaltungssystem (PMS) eine Arzneimittelterminologie verwendet (z. B. First Databank) und das Krankenhaus-KIS eine andere (z. B. Multum), liefert RxNorm – gepflegt von der National Library of Medicine – die normalisierten klinischen Arzneimittelnamen, die zwischen ihnen vermitteln. Ein Techniker, der manuelle Eingaben vornimmt, interagiert jedoch nicht direkt mit RxNorm. Er braucht nur korrekte Daten, damit die nachgelagerten Systeme sie zuordnen können.
Das eigentliche Problem ist, dass die manuelle Dateneingabe einen Menschen als Formatkonverter einsetzt – eine Aufgabe, für die Computer gebaut wurden. Das Rezept ist nicht das Problem. Die Tastatur ist es.
KI beibringen, wie ein Apothekertechniker zu lesen
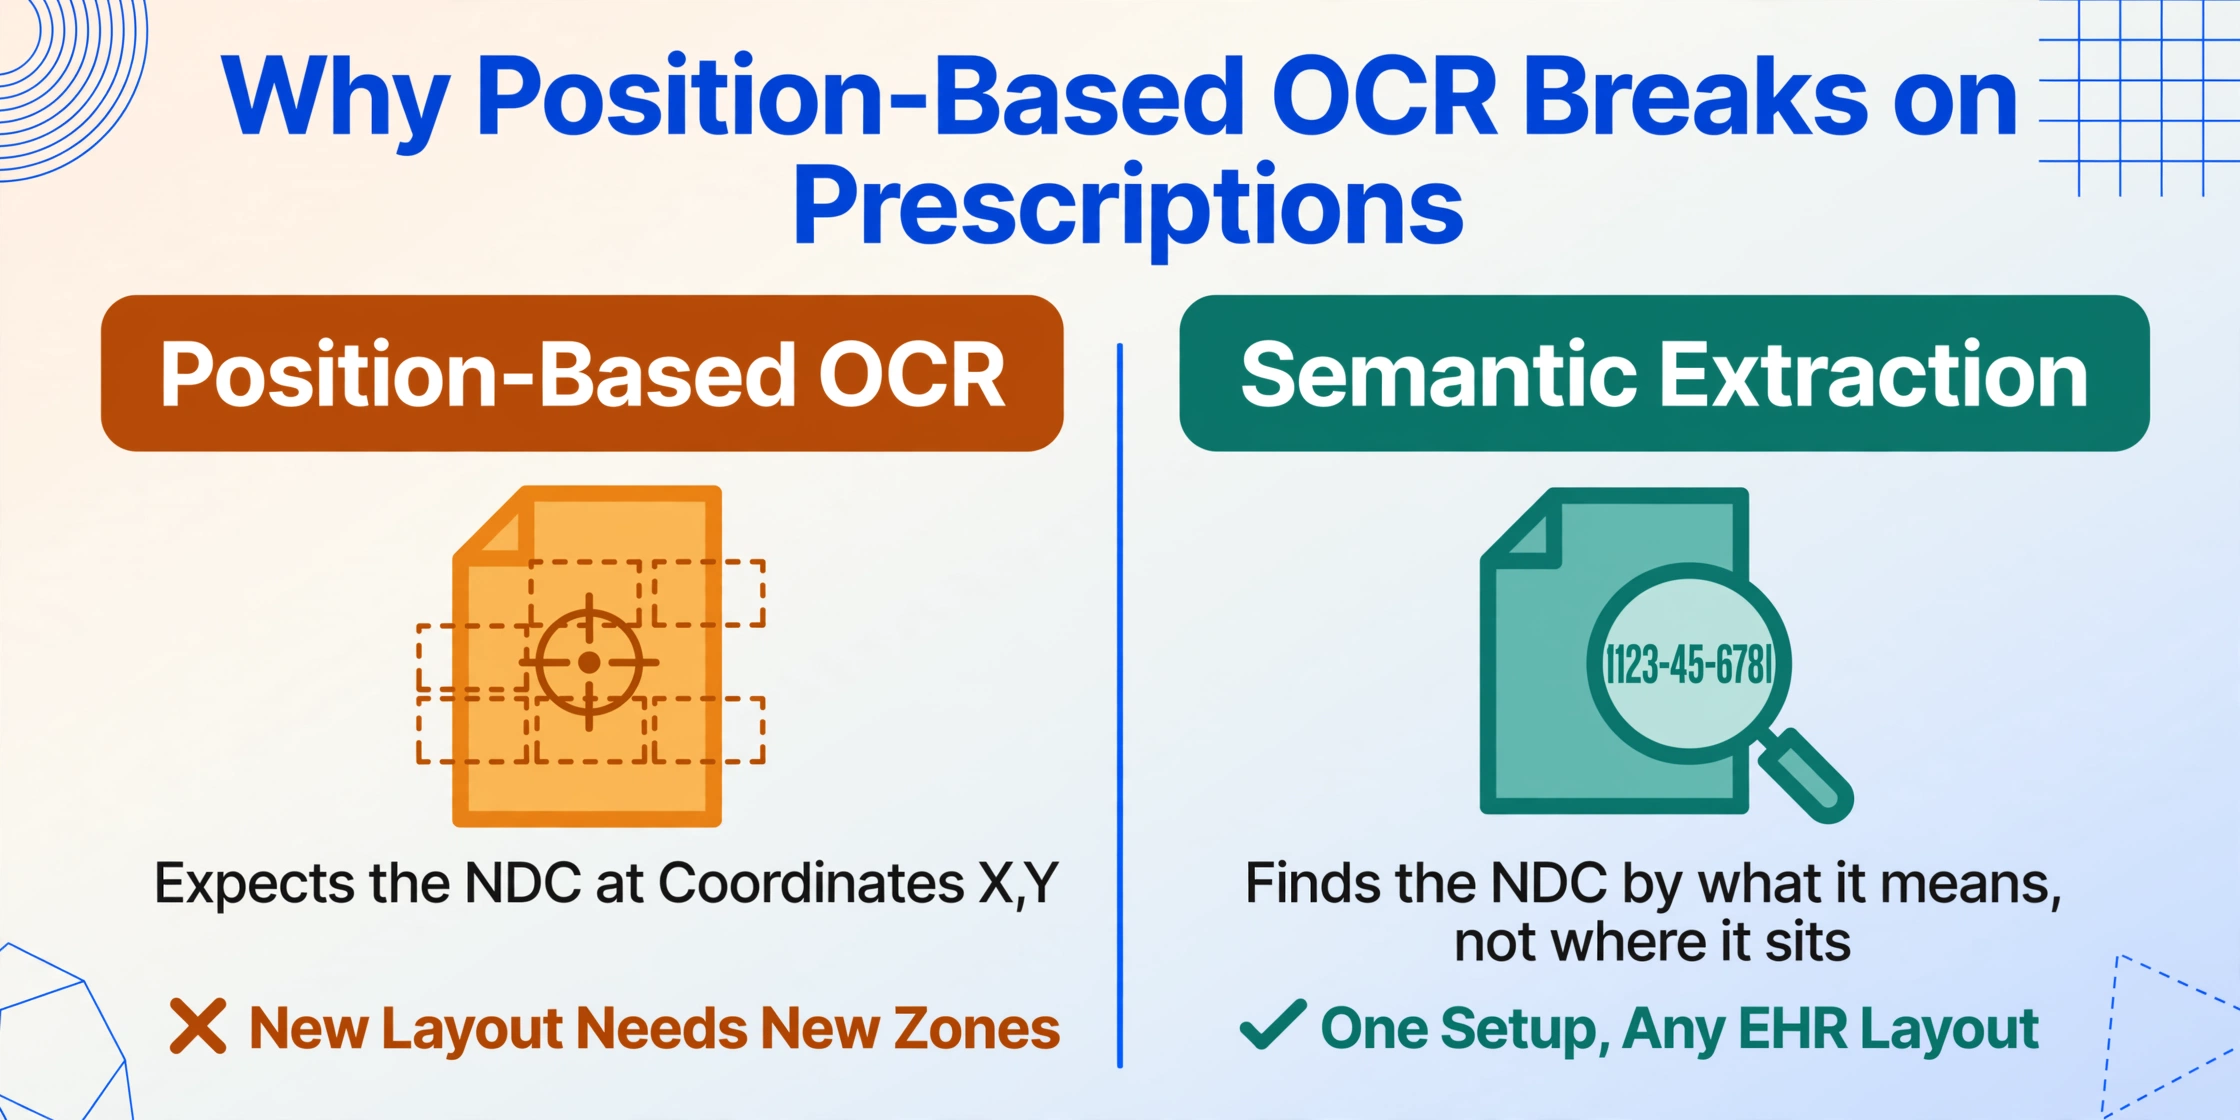
Der entscheidende Unterschied ist nicht schnelleres Tippen. Es ist das vollständige Entfernen des Übersetzungsschritts – und die KI liest das Rezept so, wie es ein Techniker tut, nur dass sie nie eine Ziffer vertauscht.
Die meisten Dokumentextraktionstools verwenden einen vorlagenbasierten Ansatz: Sie definieren Zonen auf einer Seite, in denen bestimmte Felder liegen, und die Software führt in diesen Zonen eine OCR durch. Das funktioniert gut bei standardisierten Formularen – aber Rezepte sind das Gegenteil von standardisiert. Ein Rezept aus Dr. Chens Praxis in Houston sieht ganz anders aus als eines von einer MinuteClinic in Chicago. Die Handschrift variiert. Die PDF-Layouts von E-Skripten variieren je nach EHR-Anbieter. Die Faxqualität variiert je nach Sendegerät.
ImageToTable.ai verfolgt einen grundlegend anderen Ansatz namens Benutzerdefinierte Spaltenextraktion. Statt der KI zu sagen, wo sich Daten auf der Seite befinden, sagen Sie ihr, was Sie finden möchten – anhand der Bedeutung des Feldes, nicht seiner Position. Sie definieren Spaltennamen wie „Arzneimittelname“, „Stärke“, „NDC“ und „SIG“, und die KI liest das gesamte Dokument, lokalisiert jeden Wert anhand seines semantischen Kontexts und gibt eine strukturierte Zeile zurück. Das Format spielt keine Rolle. Das Layout spielt keine Rolle. Die KI sucht nach der Bedeutung der Daten, nicht nach ihrer Position.
Dies ist der Unterschied zwischen positionsbasierter Extraktion (traditionelle OCR: „Ich erwarte den NDC an den Koordinaten X,Y“) und semantischer Extraktion (KI: „Ich erkenne eine 10-stellige Arzneimittelkennung mit Labeler-Produkt-Paket-Struktur überall auf dieser Seite“). Das Rezept kann ein klares E-Skript-PDF oder ein so verblasstes Fax sein, dass der Apothekenstempel kaum lesbar ist – der Ansatz der KI ist derselbe.
Das System unterstützt außerdem abgeleitete Spalten: Felder, die die KI aus dem Kontext ableitet, statt sie auf der Seite gedruckt zu finden. Beispielsweise fordert eine Spalte wie „Betäubungsmittelkategorie (II/III/IV/V)“ die KI auf, das Arzneimittel zu identifizieren, seine DEA-Einstufung als kontrollierte Substanz abzugleichen und die Klassifizierung auszufüllen – obwohl „Kategorie II“ nirgendwo auf dem Rezept selbst erscheint. Derselbe Ansatz funktioniert für therapeutische Klasse, Marken- vs. Generikum-Kennzeichnung und Vorhersage der Formulartarifstufe.
Schritt für Schritt: Vom Rezeptbild zur strukturierten Tabelle
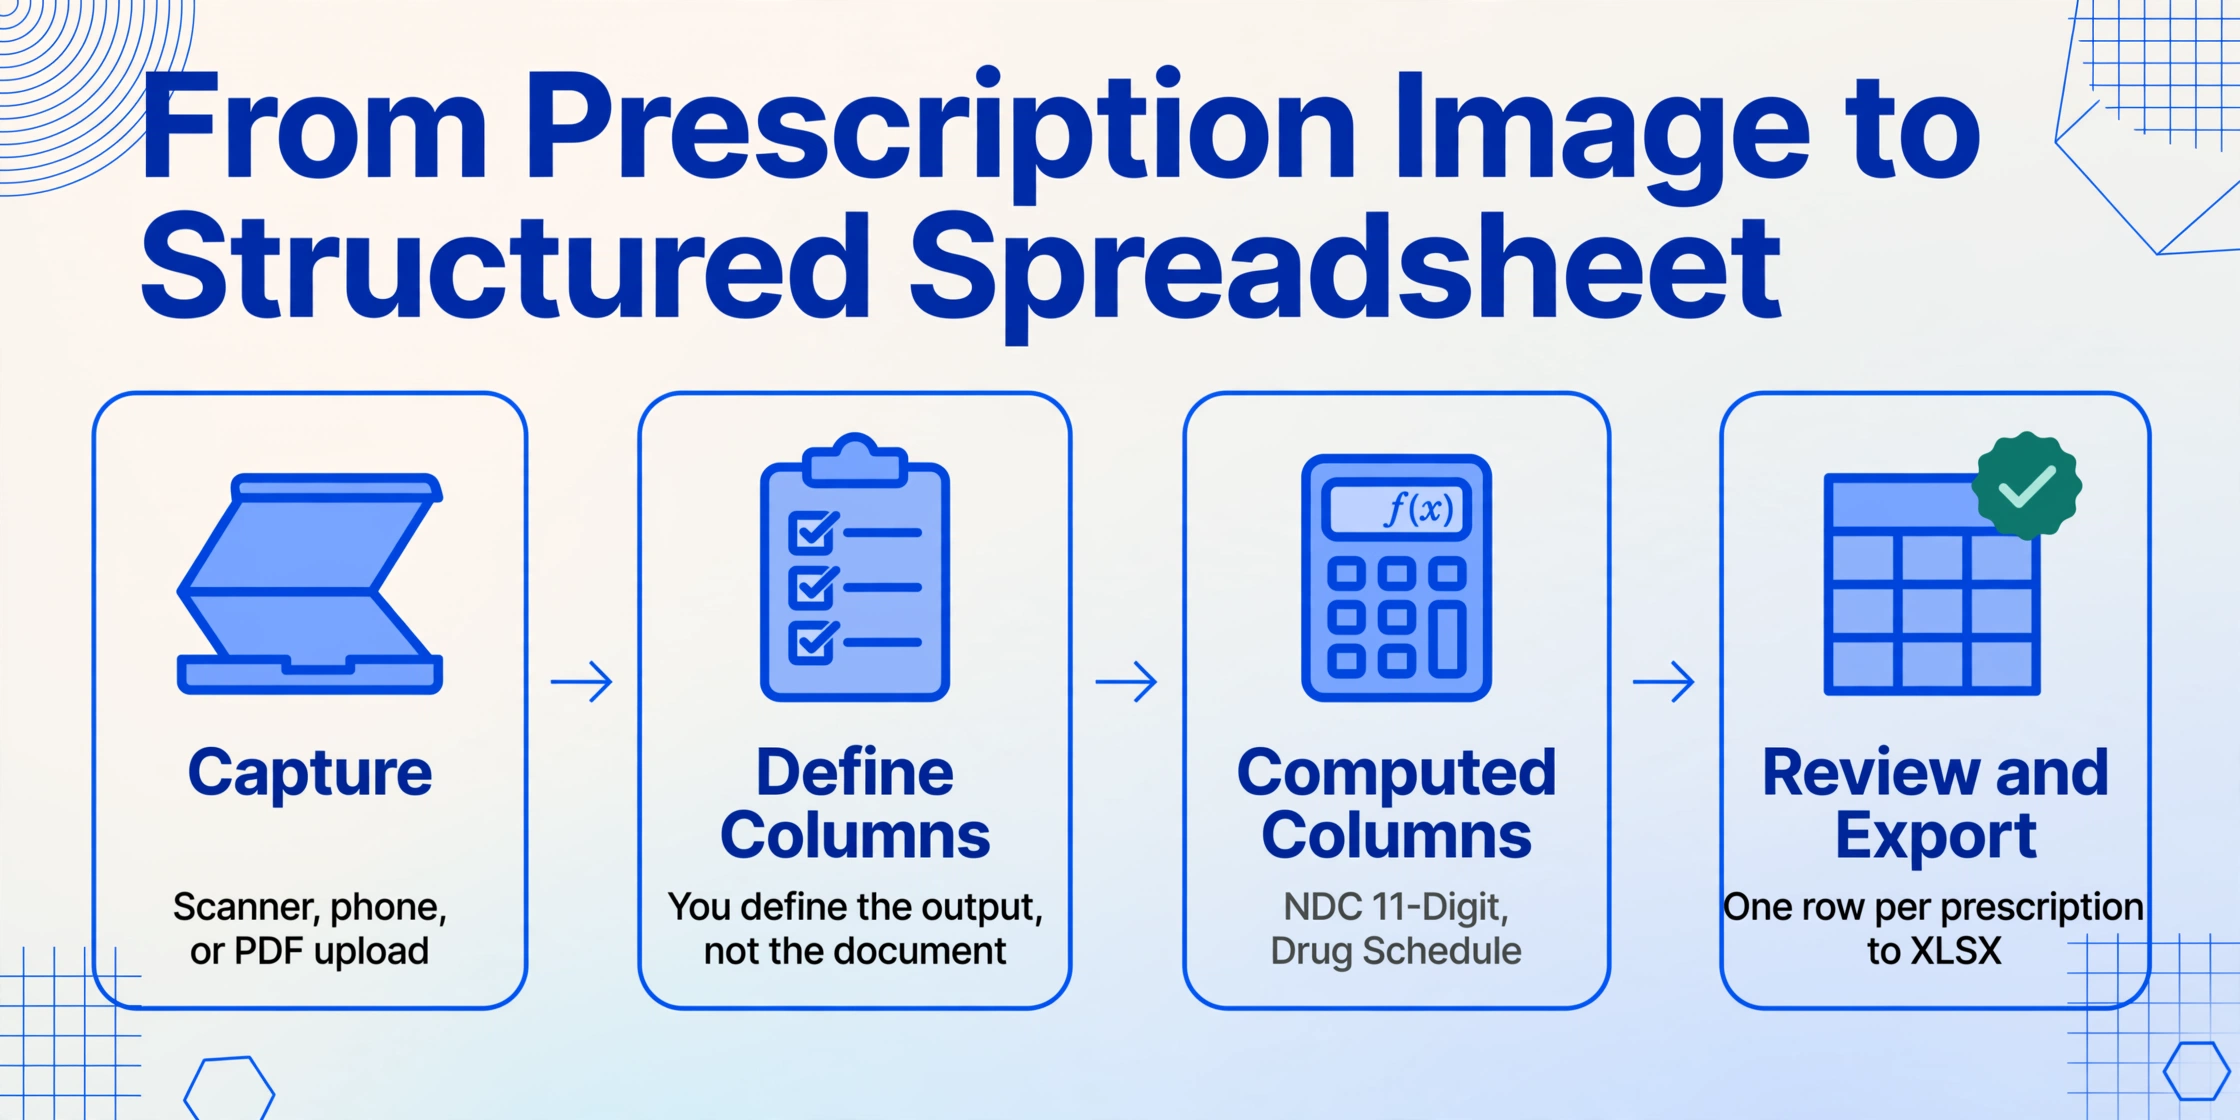
So sieht der tatsächliche Workflow aus – keine Theorie, keine Demo-Spielereien. Wenn Sie gerade einen Stapel Papierrezepte oder einen Ordner mit E-Script-PDFs auf Ihrem Desktop haben, ist dies der Weg vom Bild zur Excel-Tabelle.
Rezept erfassen
Scannen Sie Papierrezepte mit einem Flachbettscanner oder fotografieren Sie sie mit der Handykamera. E-Script-PDFs können direkt hochgeladen werden – kein Ausdrucken erforderlich. Batch-Upload funktioniert ebenfalls: 50 Rezepte auf einmal ablegen, und alle werden zur Verarbeitung eingereiht. Und wenn die Quelle ein Handyfoto des Patientenfotos der Apothekenflasche ist und nicht der Originalbeleg – der übliche Fall beim Refill-Tracking zu Hause – lesen dieselben Spalten das Foto des Rezepteetiketts genauso sauber.
Ausgabespalten definieren
Geben Sie die benötigten Feldnamen ein. Für Rezepte ist ein typischer Spaltensatz: Medikamentenname, Dosierungsstärke, Darreichungsform, NDC, SIG/Einnahmehinweise, Menge, Tageversorgung, Nachfüllungen, Name des Verschreibers, NPI des Verschreibers. Diese werden zu den Kopfzeilen Ihrer Ausgabetabelle – Sie definieren die Ausgabe, nicht das Dokument.
Berechnete und abgeleitete Spalten hinzufügen (optional)
Gehen Sie über das hinaus, was gedruckt ist. Fügen Sie eine berechnete Spalte wie „NDC 11-stellig (bei Bedarf aus 10-stellig konvertieren)“ hinzu, um NDCs für die Abrechnung automatisch zu formatieren. Oder fügen Sie eine abgeleitete Spalte wie „Betäubungsmittelkategorie (Optionen: II/III/IV/V/nicht kontrolliert)“ hinzu, um kontrollierte Substanzen automatisch zu klassifizieren. Die KI übernimmt Extraktion und Berechnung in einem einzigen Durchgang.
Prüfen und exportieren
Die KI liefert eine strukturierte Tabelle – eine Zeile pro Rezept, Spalten entsprechend Ihren Definitionen. Prüfen Sie die Ergebnisse in der Weboberfläche oder exportieren Sie sie direkt nach Excel (XLSX). Für Google-Sheets-Nutzer schreibt das Sheets-Add-on die Ergebnisse direkt in Ihre Tabelle, ohne Sheets zu verlassen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Was ist mit HIPAA und Patientendaten?
Jede Apotheke, die ein KI-Extraktionstool bewertet, sollte mit einer Frage beginnen: Schafft dies ein HIPAA-Compliance-Problem? Die Antwort hängt davon ab, ob das Tool ein Business Associate ist – und ob die richtigen Vereinbarungen getroffen wurden.
Apotheken sind Covered Entities im Sinne von HIPAA (45 CFR § 160.103). Wenn Sie geschützte Gesundheitsinformationen (PHI) – und ein Rezeptbild mit Patientenname und Medikamentenname ist PHI – an einen Drittanbieter weitergeben, der diese in Ihrem Auftrag verarbeitet, wird dieser Dienst zu einem Business Associate. Gemäß 45 CFR § 164.504(e) muss eine Covered Entity vor der Offenlegung von PHI an einen Anbieter eine unterzeichnete Business Associate Agreement (BAA) abgeschlossen haben.
Das ist kein optionales Papierkram – es ist ein rechtlich vorgeschriebener Vertrag. Eine BAA legt fest, was der Business Associate mit PHI tun darf und was nicht, verlangt eine Benachrichtigung bei Datenschutzverletzungen innerhalb bestimmter Fristen und unterwirft den Anbieter der Security Rule und der Breach Notification Rule von HIPAA. Apotheken, die KI-Tools zur Dokumentverarbeitung nutzen, sollten zwei Dinge im Voraus klären: (1) Der Anbieter unterzeichnet eine BAA, und (2) die Datenverwaltung des Anbieters – Aufbewahrung, Verschlüsselung, Serverstandort – entspricht den Anforderungen der BAA.
ImageToTable.ai verarbeitet Dateien transient: Das Dokument wird gelesen, Daten werden extrahiert, und die Datei wird nach Abschluss der Verarbeitung nicht auf den Servern gespeichert. Für Apotheken, die eine formelle HIPAA-Dokumentation benötigen, ist eine BAA verfügbar. Derselbe Rahmen gilt für jedes Dokumentextraktionstool, das im Apothekenkontext verwendet wird. (Für einen tieferen Einblick in HIPAA-Überlegungen zu verschiedenen medizinischen Dokumenttypen finden Sie in unserem Leitfaden zur HIPAA-Extraktion medizinischer Dokumente.)
Wo dies in Ihren bestehenden Apotheken-Workflow passt
Dies ist kein Ersatz für PioneerRx, QS/1 oder ein anderes Apothekenverwaltungssystem. Es ist ein Vorverarbeitungstool, das vorgelagert zu Ihrem PMS arbeitet – und den Dateneingabeschritt vom langsamsten Teil des Workflows in den schnellsten verwandelt.
Hier sind drei konkrete Integrationspunkte, an denen KI-Extraktion in den Alltag einer funktionierenden Apotheke passt:
1. Morgen-Batch: Fax- und Papierwarteschlange abarbeiten
Statt dass ein Techniker die ersten 90 Minuten damit verbringt, einen Stapel gefaxten Rezepte abzutippen, können Sie alle einscannen oder fotografieren, per Batch hochladen, Spalten einmal definieren und innerhalb von Minuten eine fertige Tabelle erhalten. Der Techniker prüft dann jede Zeile anhand der Originalbilder – ein Verifizierungsschritt, kein Transkriptionsschritt – und überträgt die Daten in das PMS. Selbst mit manuellem Kopieren und Einfügen ist Prüfen-und-Verifizieren deutlich schneller als Lesen-und-Tippen.
2. Inventarabgleich mit Großhändlerdaten
Die drei großen Pharmagroßhändler – McKesson, Cencora (ehemals AmerisourceBergen) und Cardinal Health – vertreiben gemeinsam über 90 % aller verschreibungspflichtigen Medikamente in den USA, laut Commonwealth Fund (2022). Beim Abgleich von Inventar über mehrere Großhändler-Preislisten hinweg spart das Extrahieren von NDCs und Medikamentennamen aus Lieferanten-PDFs in eine Vergleichstabelle stundenlanges manuelles Querverweisen.
3. Unterstützung bei Versicherungsansprüchen
Wenn ein Anspruch die Einreichung von Verschreibungsunterlagen erfordert – für die Vorabgenehmigung über Surescripts, für die Beantwortung von Medicaid-Prüfungen oder für CMS-1500-Formulare mit NDC-Positionen – beschleunigt das Extrahieren der relevanten Felder in eine saubere Tabelle, was sonst eine Papierakte-heraussuchen-und-tippen-Übung wäre. (Siehe unseren Leitfaden zum Extrahieren von CMS-1500-Formulardaten für den abrechnungsspezifischen Workflow.)
In jedem dieser Szenarien bleibt das PMS das System of Record. KI-Extraktion übernimmt den Übersetzungsschritt – ein Bild oder PDF in strukturierte Felder verwandeln – und die Rolle des Technikers verschiebt sich von Transkription zu Verifizierung. Das ist der Unterschied zwischen drei Stunden Tippen und 20 Minuten Prüfen.
Wo KI-Extraktion hilft – und wo nicht
Lassen Sie uns direkt über die Grenzen sprechen, denn in der Apotheke ist Überversprechen fehl am Platz.
Was KI-Extraktion gut kann: gedruckte E-Rezept-PDFs, getippte Faxrezepte, klar lesbare handschriftliche Rezepte mit üblichen Medikamentennamen, auf Verpackungen aufgedruckte NDCs, standardisierte SIG-Codes (1T PO QD, 2 Hübe QID PRN). Das FDA NDC-Verzeichnis wird täglich aktualisiert und enthält aktive Listungen aller vermarkteten Arzneimittel – die KI kann dies als Referenzrahmen zur Validierung extrahierter NDCs nutzen.
Wo Sie weiterhin menschliches Urteilsvermögen brauchen: stark unleserliche Handschrift (die Art, bei der selbst ein erfahrener Apotheker schmunzelt), mehrdeutige Medikamentennamen-Abkürzungen (HCTZ vs. Hydrochlorothiazid – kontextabhängig), nicht standardgemäße Rezepturanweisungen, Rezepte mit widersprüchlichen oder sich widersprechenden Anweisungen. Die KI kennzeichnet Unsicherheiten, anstatt zu raten. Das klinische Urteilsvermögen eines Apothekers ist nicht ersetzbar – das Werkzeug reduziert das Tippen, nicht das Denken.
Was dies nicht tut: Es wickelt keine Abrechnungsansprüche ab (das ist Aufgabe Ihres PMS und des PBM). Es führt keine Arzneimitteltherapieprüfung durch. Es überprüft weder die Patientenidentität noch den Versicherungsstatus. Es ist ein Schritt der Datenextraktion – präzise in dem, was es tut, ehrlich in dem, was es nicht tut.
Häufig gestellte Fragen
Funktioniert das mit handschriftlichen Rezepten?
Ja, bei einigermaßen leserlicher Handschrift. Das visuelle KI-Modell ist auf verschiedene Handschriftstile trainiert. Aber ein Rezept, das in hastiger Schreibschrift auf einen zerrissenen Notizblockrand gekritzelt wurde – die Art, die selbst einen erfahrenen Apotheker ins Grübeln bringt – wird jede KI herausfordern. Wenn ein Mensch es lesen kann, kann die KI es normalerweise auch. Wenn ein Mensch es nicht kann, kann die KI es wahrscheinlich auch nicht.
Kann es E-Rezept-PDFs aus verschiedenen Krankenhausinformationssystemen verarbeiten?
Ja – hier zeigt sich die Stärke der formatunabhängigen Extraktion. Ob das E-Rezept von Epic, Cerner oder dem System einer kleinen Praxis stammt, das Layout variiert, aber die Datenfelder sind semantisch gleich. Die KI liest nach Bedeutung, nicht nach Position, sodass unterschiedliche Systemausgaben keine unterschiedlichen Konfigurationen erfordern.
Wie handhabt es die NDC-Formatkonvertierung?
Sie können eine berechnete Spalte einrichten, die jedes 10-stellige NDC-Format (4-4-2, 5-3-2 oder 5-4-1) automatisch in das 11-stellige HIPAA-Abrechnungsformat (5-4-2) umwandelt, indem die korrekte Nullauffüllungsregel angewendet wird. Die KI liest den NDC, wie er auf dem Etikett aufgedruckt ist, und gibt die abrechnungsfertige 11-stellige Version als separate Spalte aus – keine manuelle Konvertierung erforderlich.
Integriert es sich in meine Apothekenverwaltungssoftware?
ImageToTable.ai lässt sich nicht direkt in PioneerRx, QS/1, Rx30 oder andere PMS-Plattformen einbinden – es ist ein Vorverarbeitungswerkzeug. Die Ausgabe ist eine Excel-Tabelle (oder Google Sheets über das Add-on), die Sie dann als Quelle für die Dateneingabe in Ihr PMS verwenden. Einige Apotheken nutzen die Tabelle als Prüfliste vor der PMS-Eingabe; andere kopieren und fügen Zeilen ein. Die Verbesserung des Arbeitsablaufs liegt nicht in der Integration – sondern darin, drei Stunden Tipparbeit durch einen Prüfschritt zu ersetzen.
Ist das HIPAA-konform?
ImageToTable.ai verarbeitet Dateien nur vorübergehend und speichert sie nach Abschluss der Extraktion nicht. Eine Business Associate Agreement (BAA) ist für Apotheken verfügbar, die eine gemäß 45 CFR § 164.504(e) benötigen. Wie bei jedem Drittanbieter-Tool, das PHI verarbeitet, sollten Apotheken sicherstellen, dass die BAA ausgeführt ist, bevor sie patientenidentifizierbare Rezeptbilder hochladen. Für einen umfassenderen Überblick über HIPAA bei der medizinischen Dokumentextraktion lesen Sie unseren HIPAA-Konformitätsleitfaden für die medizinische Dokumentextraktion.
Wie hoch ist die Genauigkeitsrate bei der Rezeptdatenextraktion?
Bei gedruckten und klar getippten Rezeptdaten erreicht die Genauigkeit 99 % – konsistent mit der Gesamtbenchmark des Tools für gedruckte Tabellendaten. Handschriftliche Rezepte und Faxe in schlechter Qualität führen zu Abweichungen. Die entscheidende Verhaltensänderung: Selbst bei 95 % Genauigkeit bei schwierigen Eingaben ist ein Techniker, der 5 % der Felder prüft und korrigiert, deutlich schneller als jemand, der 100 % manuell eintippt. Bei der Genauigkeitsdiskussion geht es nicht um Perfektion – sondern darum, ob Fehler, die bei der Überprüfung erkannt werden, weniger Zeit kosten als die manuelle Eingabe von Grund auf.
Die Mathematik, die alles verändert
Bei 50 Sekunden pro Rezept entsprechen 200 Verordnungen pro Tag 167 Minuten Dateneingabe – fast drei Stunden. Wenn die KI-Extraktion diese 50 Sekunden in eine 5-Sekunden-Überprüfung pro Zeile plus die anfängliche Batch-Verarbeitungszeit umwandelt, könnten dieselben 200 Verordnungen insgesamt 25 Minuten dauern.
Das ist keine marginale Verbesserung. Es ist der Unterschied zwischen einem Techniker, der die halbe Schicht mit Tippen verbringt, und einem, der fast die gesamte Zeit mit Aufgaben verbringt, die tatsächlich menschliches Urteilsvermögen erfordern – Abgleich mit Originalbildern, Erkennen klinischer Warnhinweise, Bestandsverwaltung, Gespräche mit Patienten.
Und für den Apothekeninhaber, der die Zahlen betrachtet: Drei Stunden Technikerzeit pro Tag, bei konservativen 18 $/Stunde, sind etwa 14.000 $ pro Jahr an Löhnen, die nur für manuelle Dateneingabe ausgegeben werden – für einen einzelnen Techniker bei einem moderaten Verordnungsvolumen. Skaliert man das auf zwei Techniker in einer gut besuchten unabhängigen Apotheke, werden die Kosten für Tastatureingaben zu einem Posten, den es sich zu eliminieren lohnt.
Nichts davon bedeutet, dass das Apothekenverwaltungssystem verschwinden wird. Es bedeutet, dass der Dateneingabeschritt, der es speist – das Tippen, die NDC-Formatkonvertierung, die SIG-Übersetzung – endlich einen schnelleren Weg hat. Einen, der von einem Techniker nicht verlangt, eine menschliche API zwischen einem Blatt Papier und einer Datenbank zu sein.