¿Y si la entrada de datos de recetas
tomara 5 segundos en lugar de 50?
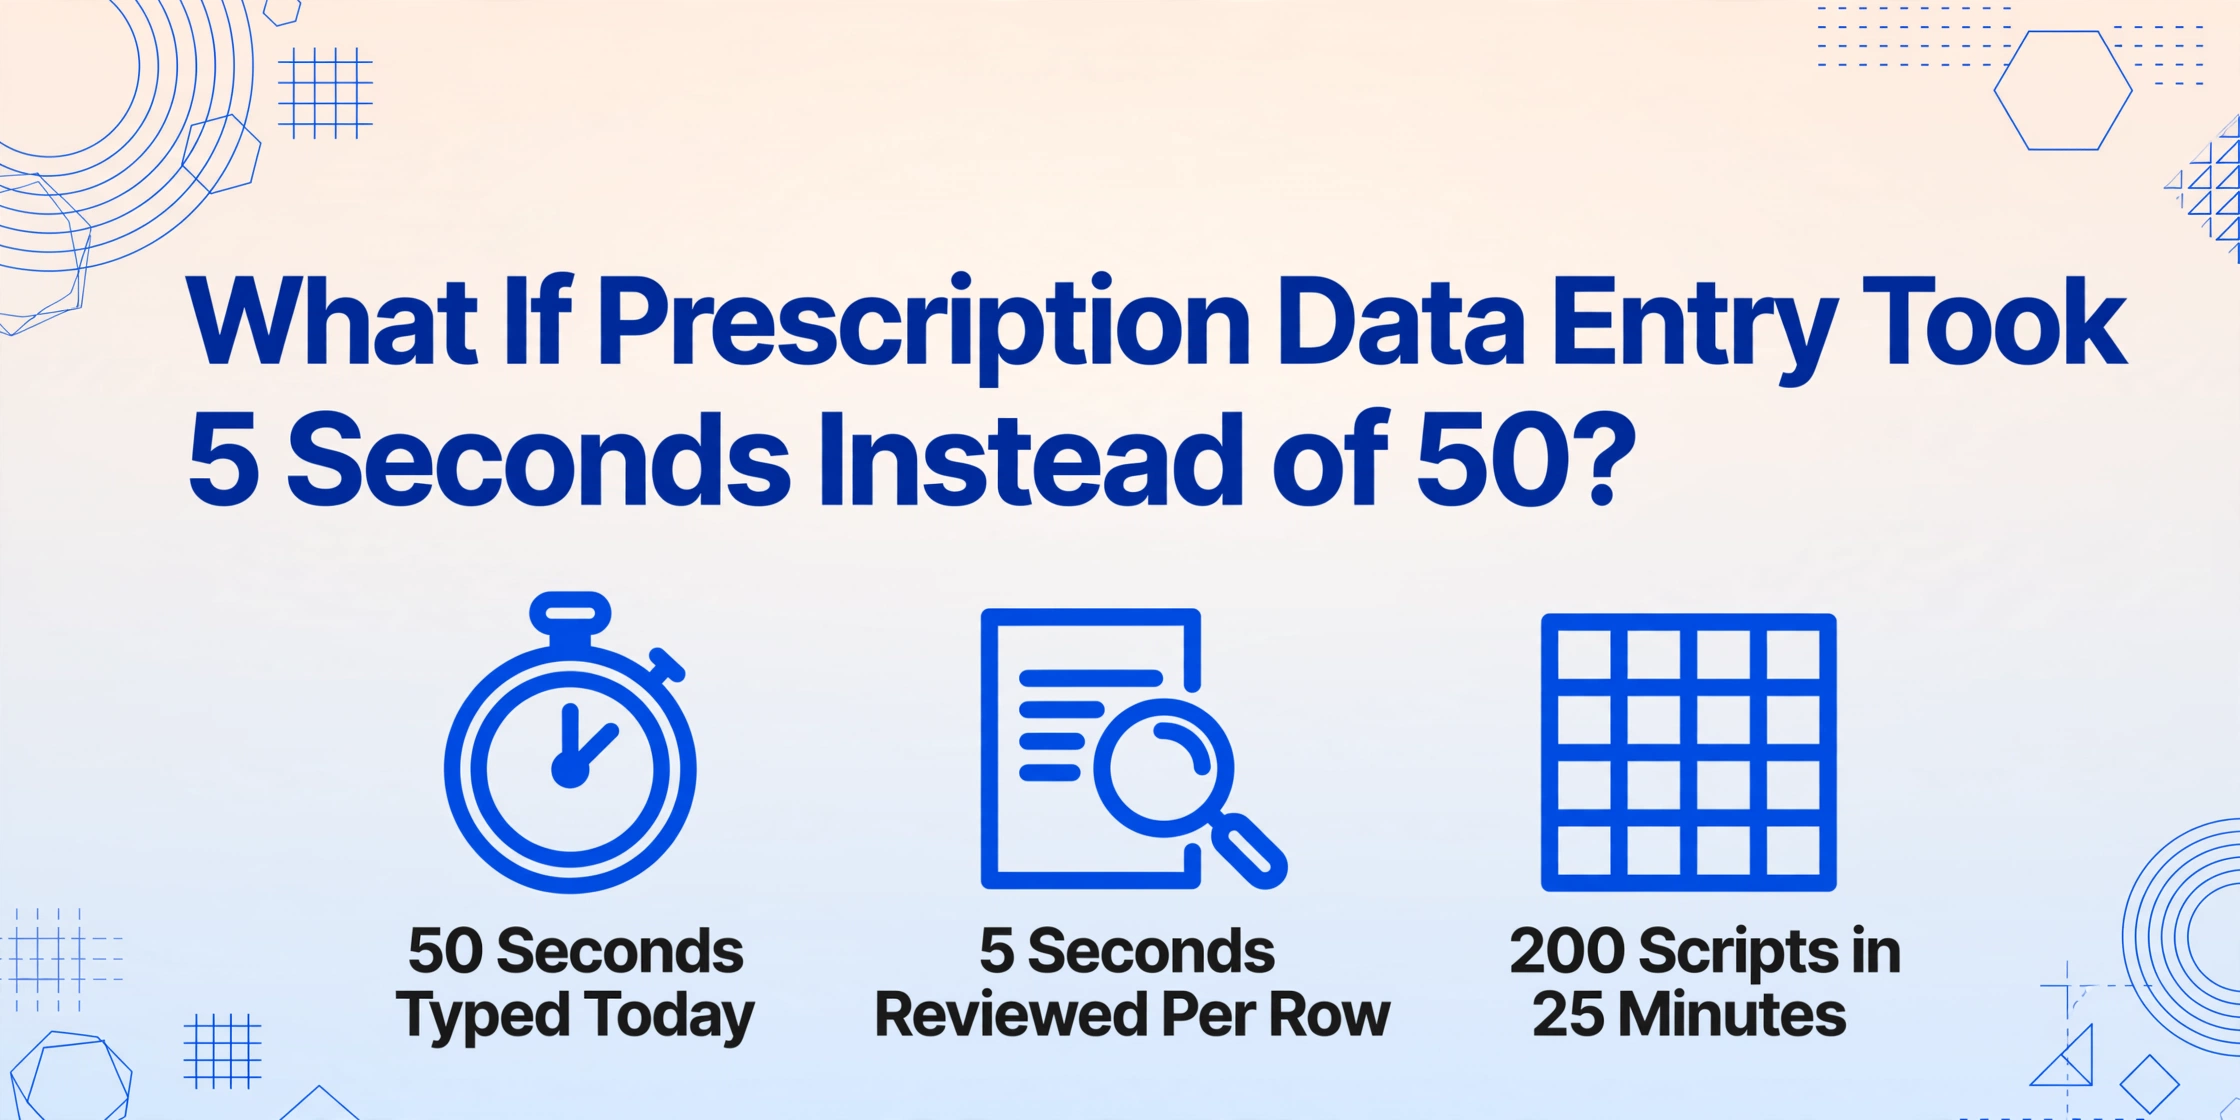
Cincuenta segundos. Ese es el tiempo estándar de entrada de datos por receta en la mayoría de las cadenas de farmacias, según los técnicos de farmacia que registran sus propias métricas. Con 200 recetas al día —un volumen modesto para una farmacia independiente concurrida—, eso equivale a casi tres horas escribiendo nombres de medicamentos, concentraciones, dígitos del NDC y códigos SIG en un sistema de gestión de farmacia. No verificar. No asesorar. Solo escribir. Y aquí está la parte que pocos fuera de la farmacia mencionan: la Asociación Estadounidense de Farmacéuticos estima que el 1.5% de todas las recetas dispensadas contienen un error —aproximadamente 67.5 millones de errores en un solo año, muchos de ellos atribuibles a lo que ocurrió en el teclado durante la entrada de datos.
Conclusiones Clave
- Una precisión de entrada de datos del 43% a los dos meses no significa que el técnico de farmacia sea lento o descuidado — es lo que ocurre cuando se le pide a un humano que actúe como convertidor de formato en tiempo real entre cada diseño de receta y una única base de datos rígida.
- Un solo NDC requiere una de tres reglas de relleno con ceros para alcanzar el formato de facturación HIPAA de 11 dígitos, y un solo dígito incorrecto rechaza el reclamo — ninguna velocidad de escritura resuelve un problema de traducción de formato.
- Cuando la IA lee las recetas según lo que significan los datos en lugar de dónde están ubicados en la página, las tres horas de transcripción del técnico se reducen a veinte minutos de verificación.
El Costo Oculto de Cada Tecla Presionada
Los errores de medicación afectan al menos a 1.5 millones de estadounidenses cada año, con un costo económico estimado de $77 mil millones — y una parte significativa se origina en la pantalla de ingreso de datos, no en la bandeja de conteo.
La Academy of Managed Care Pharmacy (AMCP) identifica tres de los tipos de errores de dispensación más comunes: dispensar el medicamento incorrecto, equivocarse en la concentración de la dosis y no detectar interacciones medicamentosas. Los tres pueden originarse a partir de un solo dígito mal escrito en el sistema de gestión de farmacia (PMS).
Los técnicos de farmacia son dolorosamente conscientes de esto. En el subreddit r/PharmacyTechnician, un técnico de Walmart con dos meses en el puesto reportó una tasa de precisión de ingreso del 43%. En grandes cadenas, el punto de referencia es de 50 segundos por tarea de ingreso de datos con un objetivo de rendimiento de 17 tareas por hora — y eso para personal experimentado. Un metaanálisis de 2018 de 62 estudios sobre errores de dispensación publicado en Research in Social and Administrative Pharmacy encontró una tasa global de error de dispensación agrupada del 1.6%, con las tasas más altas vinculadas de manera confiable a entornos con mayores cargas de ingreso manual de datos.
Este no es un problema de que el personal de farmacia no se preocupe lo suficiente. Es un desajuste estructural: cada receta llega en un formato diferente, pero cada PMS espera los mismos campos estructurados.
Cómo es Realmente el Ingreso de Datos en Farmacia
Antes de que se cuente una sola pastilla, un técnico debe traducir la forma en que llegó la receta — papel, fax, llamada telefónica o receta electrónica — a una serie de campos estructurados dentro del sistema de gestión de farmacia.
El flujo de trabajo es consistente en la mayoría del software de farmacia — PioneerRx, QS/1, Computer-Rx, Rx30 — incluso si la disposición de los botones difiere. Una receta llega a través de uno de cuatro canales:
- Receta en papel — Entregada en el mostrador o enviada por fax. El técnico lee nombres de medicamentos escritos a mano, concentraciones y firmas del médico.
- Receta electrónica (e-Script) — Llega digitalmente a través de Surescripts mediante el Estándar NCPDP SCRIPT (1900 millones de transacciones de este tipo por año). Ya está estructurada, pero a menudo aún requiere revisión manual para detectar errores de mapeo de campos.
- Llamada telefónica — La realiza la oficina del prescriptor. Un técnico transcribe en tiempo real, a menudo mientras gestiona otras tareas.
- Fax — Todavía representa una parte sorprendente de las transmisiones de recetas, especialmente de consultorios pequeños y proveedores especializados.
Una vez que llega la receta, el técnico abre el PMS y comienza el ingreso de datos. En PioneerRx, esto ocurre en la Estación de Admisión o en la cola de Ingreso de Datos. Los campos que normalmente deben completarse incluyen:
| Campo | Ejemplo | Por qué es importante |
|---|---|---|
| Nombre del medicamento | Lisinopril | Debe coincidir con la entrada del formulario; es común la confusión entre genérico y marca |
| Concentración | 10 mg | Concentración incorrecta = uno de los tres principales tipos de error (AMCP) |
| Forma farmacéutica | Tableta | Las sustituciones de tableta por cápsula requieren criterio farmacéutico |
| NDC | 68180-0981-03 | Debe convertirse al formato HIPAA de 11 dígitos (5-4-2) para facturación |
| SIG / Instrucciones | 1T PO QD | Los códigos SIG deben expandirse correctamente para las etiquetas del paciente |
| Cantidad | 30 | Se vincula al cálculo de días de suministro para la adjudicación del seguro |
| Repeticiones | 3 | Fármacos de la Lista II: 0 repeticiones por ley (21 CFR 1306.12) |
| Prescriptor | NPI / DEA # | Requerido para el envío de reclamaciones; NPI incorrecto = rechazo |
Tras la entrada, la receta pasa a un farmacéutico para su verificación previa. Si el farmacéutico detecta un error de ingreso de datos — concentración incorrecta, NDC incorrecto, SIG mal traducido — la receta vuelve al técnico para su corrección. Cada corrección es un ciclo de retrabajo que añade minutos a un proceso que ya se mide en segundos. Como lo expresó un comentarista de Reddit en r/pharmacy en su publicación: "Llevo un mes haciéndolo y es muy aburrido. Sin dispensación, sin preparación, solo teléfonos y computadoras."
Por qué «simplemente escribir más rápido» no lo solucionará
El cuello de botella no es la velocidad de escritura. Es la traducción de formatos — y ningún atajo de teclado resuelve el hecho de que cada receta llega hablando un lenguaje de datos diferente.
Considere lo que un técnico realmente hace durante esos 50 segundos. No solo está transcribiendo — está interpretando y convirtiendo:
Una receta manuscrita podría decir «Lisinopril 10 mg, 1 tableta al día, #30». El técnico necesita desglosar esto en campos discretos de la base de datos, expandir el SIG a un lenguaje comprensible para el paciente, buscar el NDC correcto para el fabricante específico y el tamaño de empaque en existencia, y verificar que el formato de facturación HIPAA de 11 dígitos (5-4-2) esté correctamente rellenado con ceros a la izquierda. El Directorio NDC de la FDA enumera tres formatos diferentes de 10 dígitos actualmente en uso — 4-4-2, 5-3-2 y 5-4-1 — cada uno requiriendo una regla diferente de relleno con ceros para alcanzar el formato de 11 dígitos exigido por CMS para todas las transacciones cubiertas por HIPAA.
| Etiqueta del Empaque (10 Dígitos) | HIPAA 11 Dígitos (5-4-2) | Regla de Conversión |
|---|---|---|
| 1234-5678-91 (4-4-2) | 01234-5678-91 | Cero a la izquierda en el segmento del etiquetador |
| 12345-678-91 (5-3-2) | 12345-0678-91 | Cero a la izquierda en el segmento del producto |
| 12345-6789-1 (5-4-1) | 12345-6789-01 | Cero a la izquierda en el segmento del empaque |
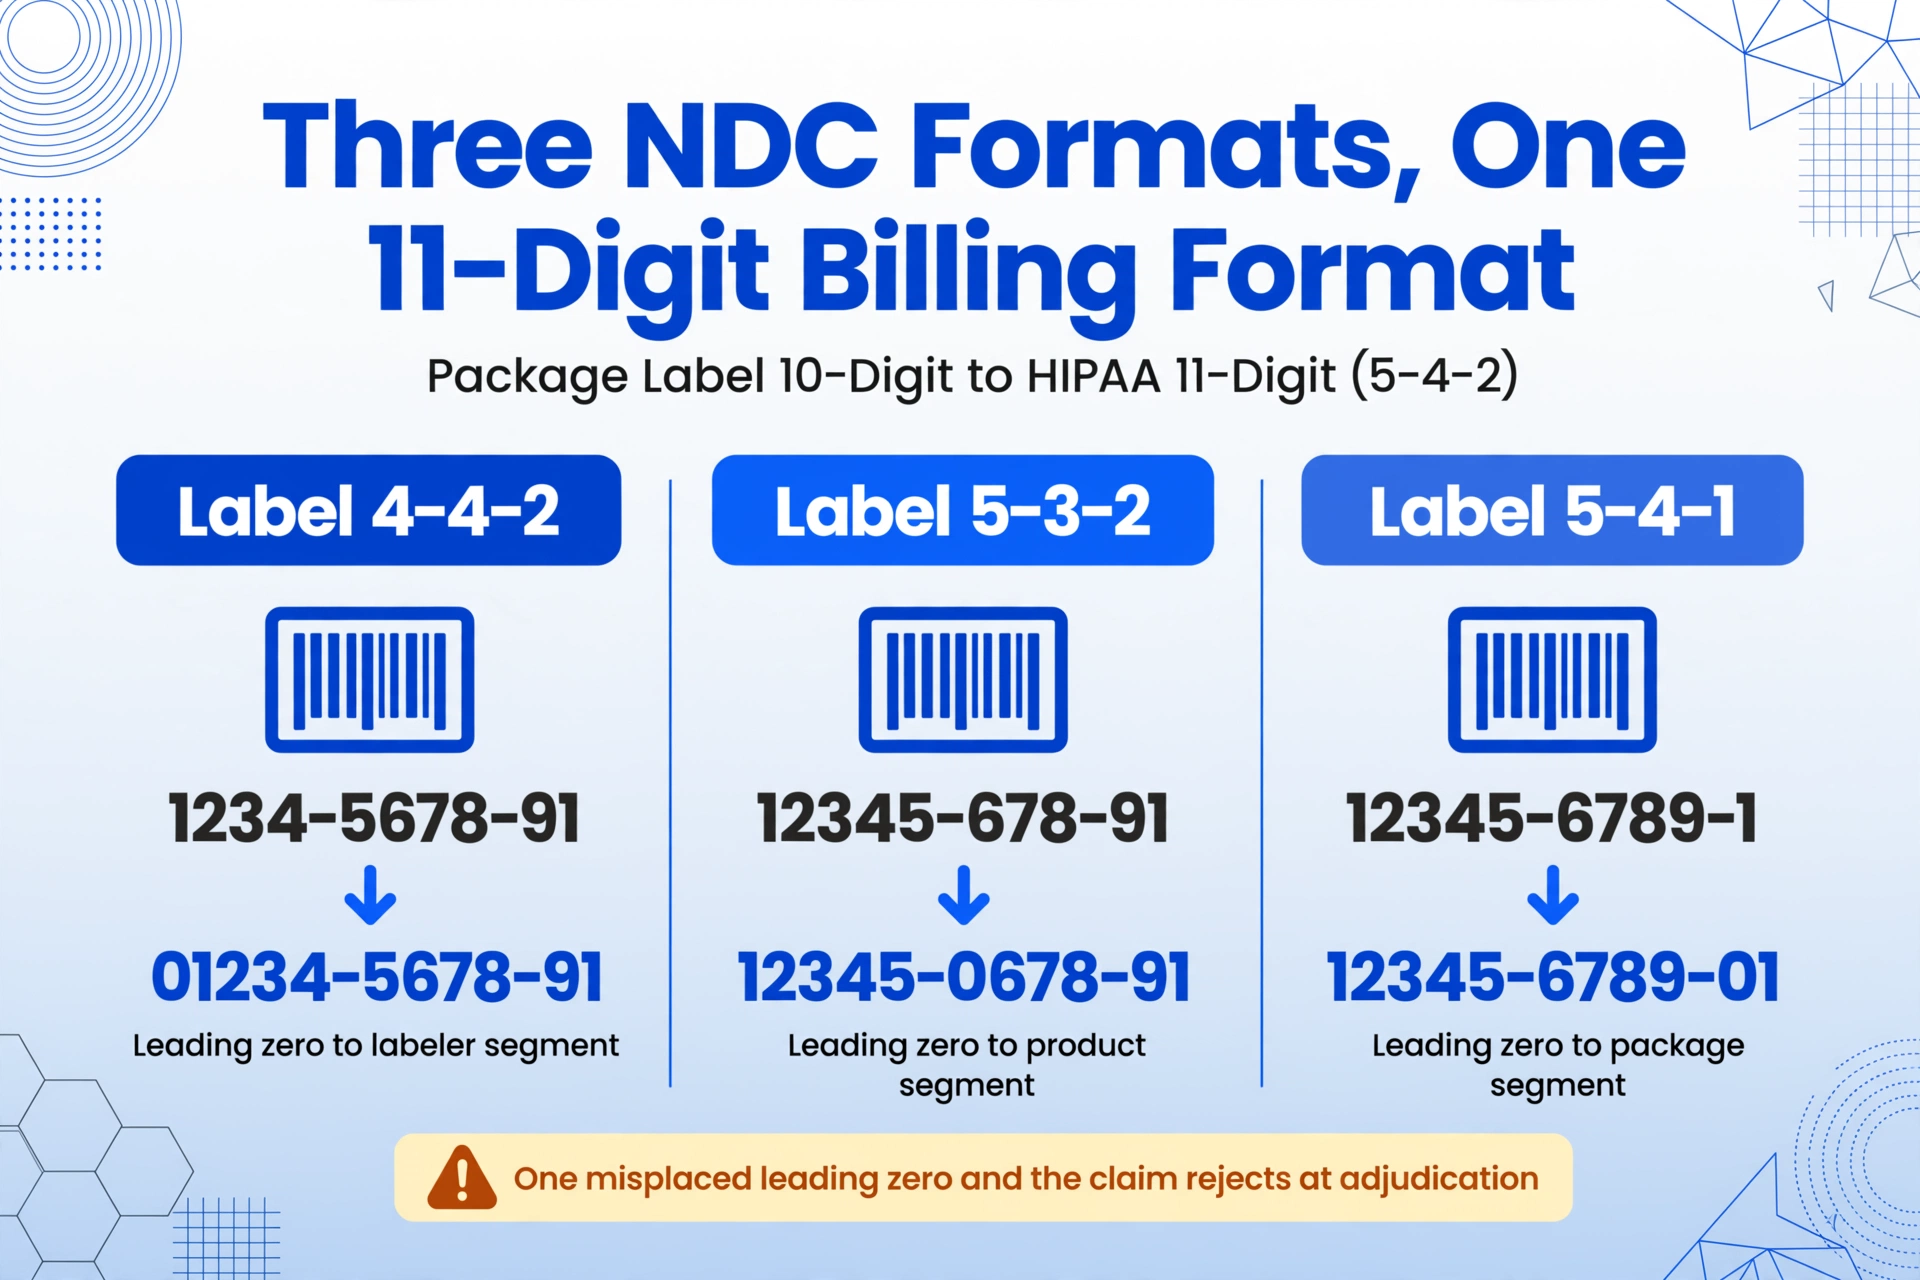
Si se equivoca en cualquier dígito — un solo cero a la izquierda mal colocado — la reclamación se rechaza en la adjudicación. El técnico retrocede, relee el frasco, vuelve a ingresar. Otros 30 segundos. Multiplique eso por cada NDC en cada receta todos los días.
Luego está la capa de RxNorm. Cuando el sistema de gestión de farmacia (PMS) usa un vocabulario de medicamentos (por ejemplo, First Databank) y el EHR de un hospital usa otro (por ejemplo, Multum), RxNorm — mantenido por la Biblioteca Nacional de Medicina — proporciona los nombres clínicos normalizados de medicamentos que actúan como intermediarios entre ambos. Pero un técnico que hace entrada manual no interactúa directamente con RxNorm. Solo necesita que los datos sean correctos para que los sistemas posteriores puedan mapearlos.
El problema real es que la entrada manual de datos le pide a un humano actuar como convertidor de formatos — un trabajo para el que las computadoras fueron creadas. La receta no es el problema. El teclado lo es.
Enseñar a la IA a leer como un técnico de farmacia
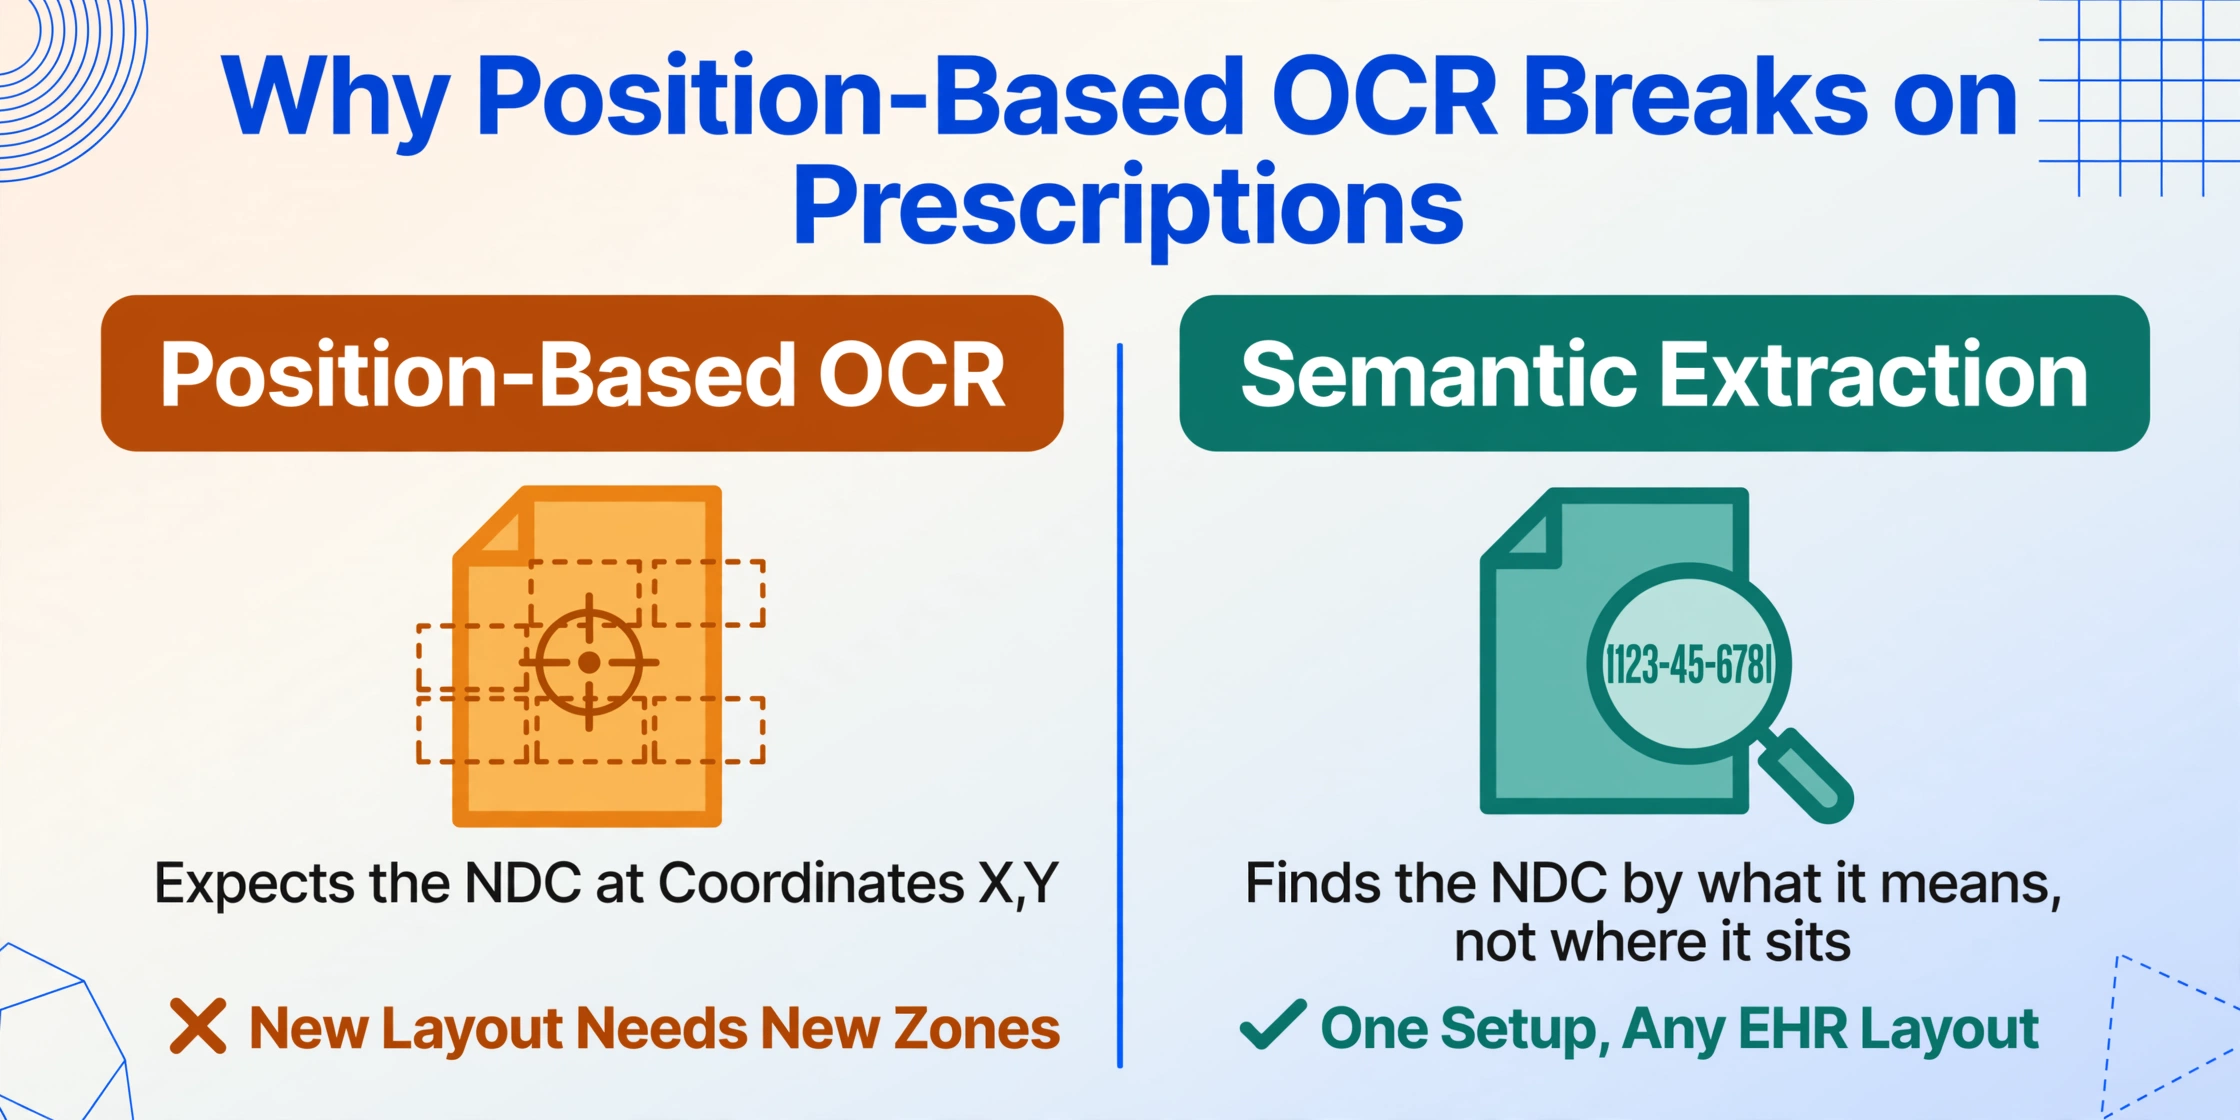
El cambio que altera las matemáticas no es escribir más rápido. Es eliminar el paso de traducción por completo — y dejar que la IA lea la receta como lo haría un técnico, excepto que nunca transpone un dígito.
La mayoría de las herramientas de extracción de documentos utilizan un enfoque basado en plantillas: usted define zonas en una página donde residen campos específicos, y el software aplica OCR a esas zonas. Eso funciona muy bien para formularios estandarizados — pero las recetas son lo opuesto a estandarizadas. Una receta de la consulta de la Dra. Chen en Houston no se parece en nada a una de un MinuteClinic en Chicago. La escritura varía. Los diseños de los PDF de e-script varían según el proveedor de EHR. La calidad del fax varía según la máquina del remitente.
ImageToTable.ai adopta un enfoque fundamentalmente diferente llamado Extracción de Columnas Personalizadas. En lugar de decirle a la IA dónde viven los datos en la página, usted le dice qué quiere encontrar — por el significado del campo, no por su posición. Usted define nombres de columna como "Nombre del Medicamento," "Concentración," "NDC" y "SIG," y la IA lee el documento completo, localiza cada valor comprendiendo su contexto semántico y devuelve una fila estructurada. El formato no importa. El diseño no importa. La IA busca qué significan los datos, no dónde se encuentran.
Esta es la diferencia entre la extracción basada en posición (OCR tradicional: "espero el NDC en las coordenadas X,Y") y la extracción basada en semántica (IA: "reconozco un identificador de medicamento de 10 dígitos con una estructura etiquetador-producto-empaque en cualquier parte de esta página"). La receta puede ser un PDF de e-script nítido o un fax tan desvaído que el sello de la farmacia apenas es legible — el enfoque de la IA es el mismo.
El sistema también admite columna inferida: campos que la IA deriva del contexto en lugar de encontrarlos impresos en la página. Por ejemplo, una columna como "Programa (II/III/IV/V)" incita a la IA a identificar el medicamento, cotejar su programa de sustancias controladas de la DEA y completar la clasificación — aunque "Programa II" no aparezca en ningún lugar de la receta. El mismo enfoque funciona para la clase terapéutica, el marcado de marca frente a genérico y la predicción del nivel de formulario.
Paso a paso: de la imagen de la receta a la hoja de cálculo estructurada
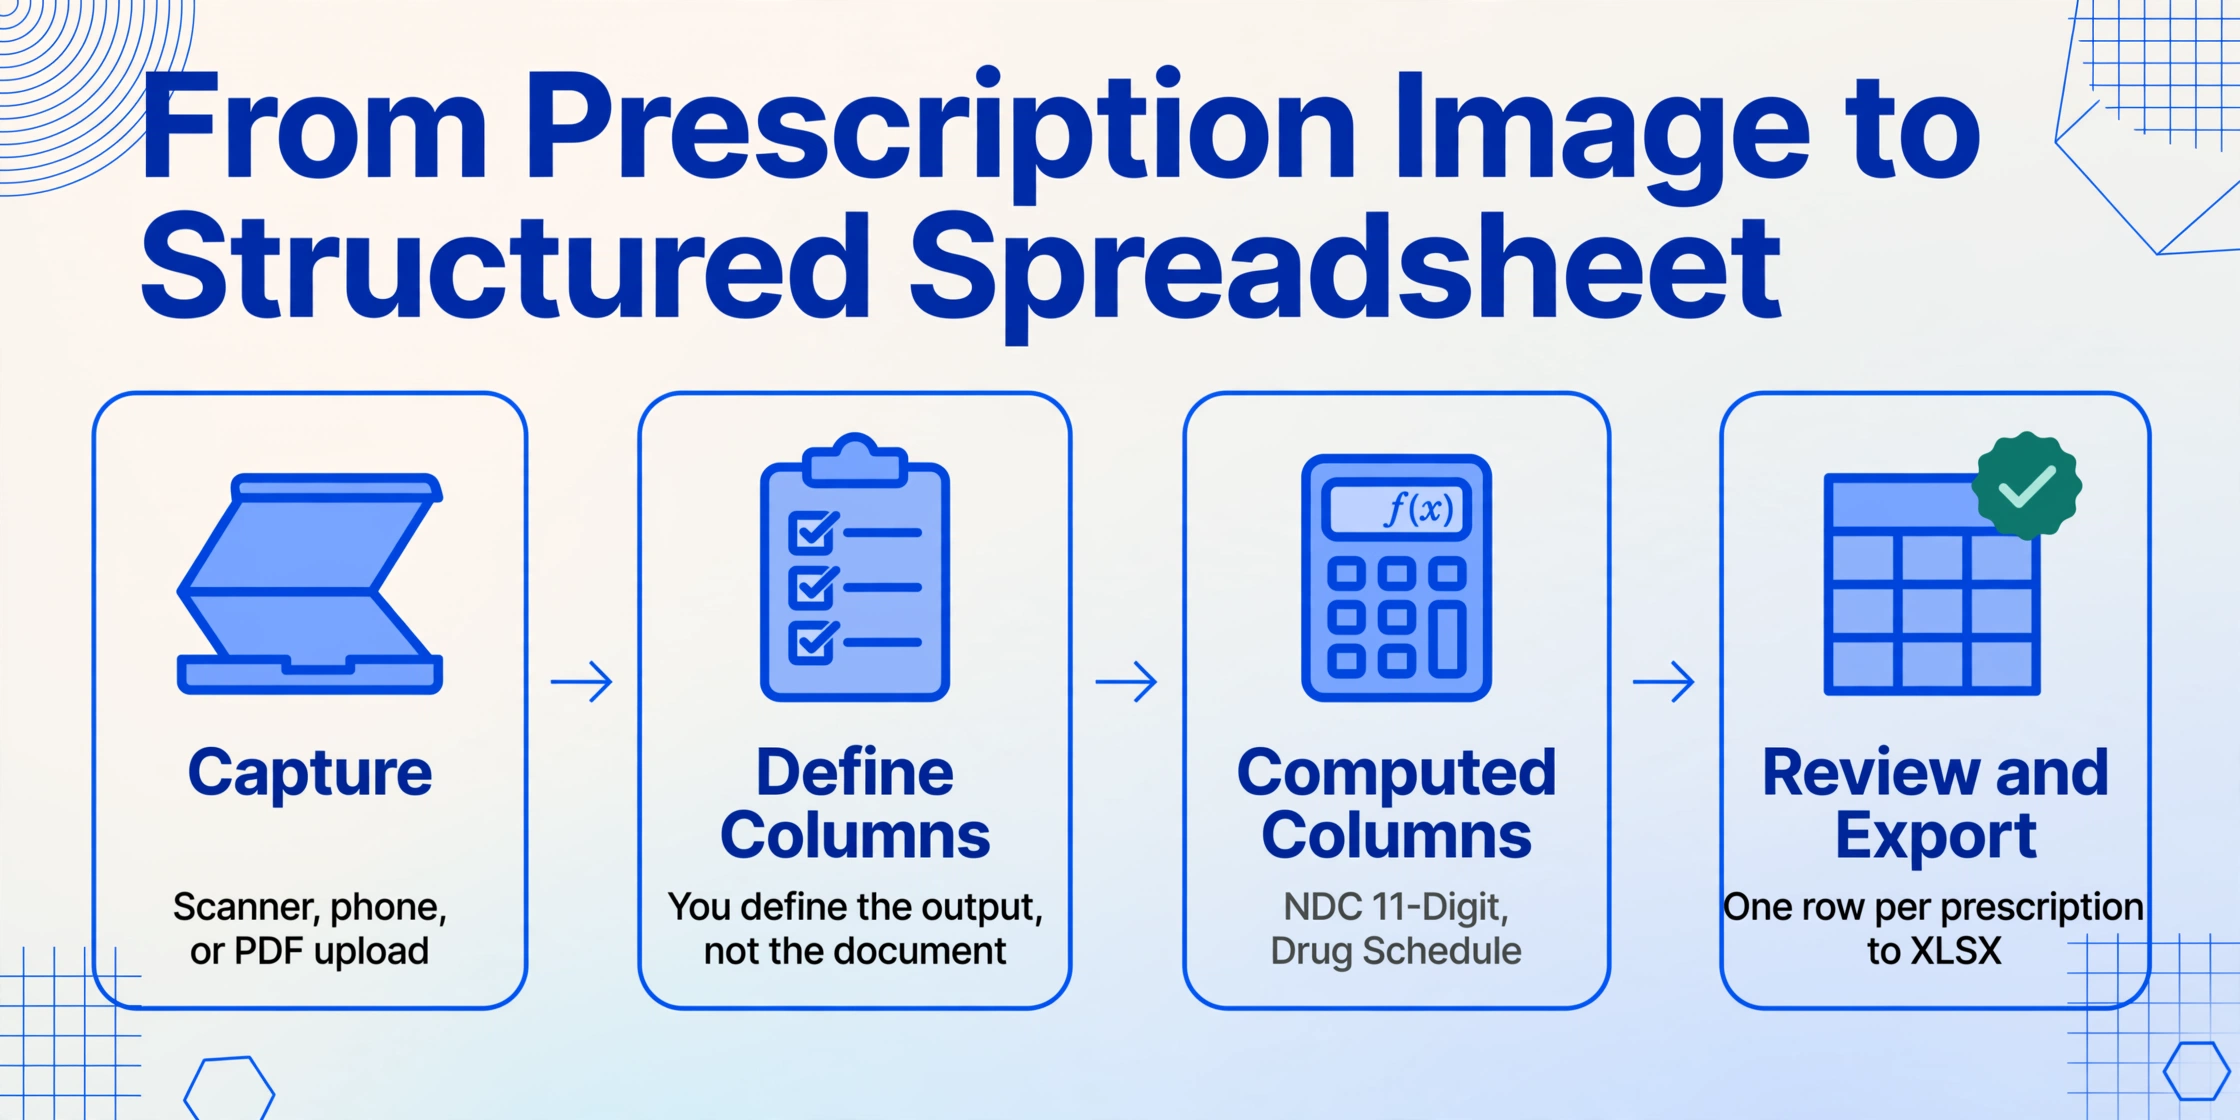
Este es el flujo de trabajo real, sin teoría ni trucos de demostración. Si tiene una pila de recetas en papel o una carpeta de PDF de recetas electrónicas en su escritorio ahora mismo, este es el camino de la imagen a Excel.
Capture la receta
Escanee las recetas en papel con cualquier escáner de superficie plana o fotográfielas con la cámara del teléfono. Los PDF de recetas electrónicas se pueden subir directamente, sin necesidad de imprimirlos. La carga por lotes también funciona: suba 50 recetas a la vez y todas se pondrán en cola para procesarse. Y cuando la fuente es la foto del frasco de farmacia tomada por el paciente en lugar del comprobante original —el caso habitual para el seguimiento de resurtidos en casa—, las mismas columnas leen la foto de la etiqueta de la receta con la misma claridad.
Defina sus columnas de salida
Escriba los nombres de los campos que necesita. Para recetas, un conjunto de columnas típico es: Nombre del medicamento, Concentración, Forma farmacéutica, NDC, SIG/Instrucciones, Cantidad, Días de suministro, Resurtidos, Nombre del prescriptor, NPI del prescriptor. Estos se convierten en los encabezados de su hoja de cálculo de salida: usted define la salida, no el documento.
Añada columnas calculadas e inferidas (opcional)
Vaya más allá de lo impreso. Añada una columna calculada como "NDC de 11 dígitos (convertir desde 10 dígitos si es necesario)" para formatear automáticamente los NDC para facturación. O añada una columna inferida como "Clasificación del medicamento (opciones: II/III/IV/V/no controlado)" para clasificar sustancias controladas automáticamente. La IA maneja tanto la extracción como el cálculo en una sola pasada.
Revise y exporte
La IA devuelve una tabla estructurada: una fila por receta, con columnas que coinciden con sus definiciones. Revise los resultados en la interfaz web o exporte directamente a Excel (XLSX). Para usuarios de Google Sheets, el complemento de Sheets escribe los resultados directamente en su hoja de cálculo sin salir de Sheets.
Los archivos se procesan de forma segura y no se almacenan.
¿Qué pasa con HIPAA y los datos de los pacientes?
Cualquier farmacia que evalúe una herramienta de extracción con IA debe comenzar con una pregunta: ¿esto crea un problema de cumplimiento de HIPAA? La respuesta depende de si la herramienta es un Socio Comercial — y de si se han firmado los acuerdos correspondientes.
Las farmacias son Entidades Cubiertas según HIPAA (45 CFR § 160.103). Cuando usted comparte Información de Salud Protegida (PHI) — y una imagen de receta que contiene el nombre del paciente y del medicamento es PHI — con un servicio de terceros que la procesa en su nombre, ese servicio se convierte en un Socio Comercial. Según 45 CFR § 164.504(e), una Entidad Cubierta debe tener un Acuerdo de Socio Comercial (BAA) firmado antes de divulgar PHI a cualquier proveedor.
Esto no es papeleo opcional — es un contrato legalmente exigible. Un BAA estipula qué puede y qué no puede hacer el Socio Comercial con la PHI, exige la notificación de violaciones dentro de plazos específicos y somete al proveedor a la Regla de Seguridad y a la Regla de Notificación de Violaciones de HIPAA. Las farmacias que utilizan herramientas de IA para el procesamiento de documentos deben confirmar dos cosas de antemano: (1) que el proveedor firmará un BAA y (2) que el manejo de datos del proveedor — retención, cifrado, ubicación de servidores — se alinea con lo que exige el BAA.
ImageToTable.ai procesa los archivos de forma transitoria: el documento se lee, se extraen los datos y el archivo no se almacena en sus servidores después de completarse el procesamiento. Para las farmacias que requieren documentación formal de HIPAA, hay un BAA disponible. El mismo marco se aplica a cualquier herramienta de extracción de documentos utilizada en un contexto de farmacia. (Para un análisis más profundo de las consideraciones de HIPAA en distintos tipos de documentos médicos, consulte nuestra guía de extracción de documentos médicos de HIPAA).
Dónde encaja en su flujo de trabajo de farmacia existente
Esto no reemplaza a PioneerRx, QS/1 ni a ningún sistema de gestión de farmacia. Es una herramienta de preprocesamiento que opera antes de su PMS, convirtiendo el paso de entrada de datos de la parte más lenta del flujo de trabajo en la más rápida.
Aquí tiene tres puntos de integración concretos donde la extracción con IA se inserta en el día a día de una farmacia activa:
1. Lote matutino: despejando la cola de faxes y papel
En lugar de que un técnico pase los primeros 90 minutos tecleando una pila de recetas por fax, escanéelas o fotografíelas todas, súbalas en lote, defina las columnas una vez y obtenga una hoja de cálculo completa en minutos. Luego, el técnico revisa cada fila contra las imágenes originales — un paso de verificación, no de transcripción — y copia los datos al PMS. Incluso con copiar y pegar manual, revisar y verificar es drásticamente más rápido que leer y teclear.
2. Conciliación de inventario con datos de mayoristas
Los tres principales mayoristas farmacéuticos — McKesson, Cencora (antes AmerisourceBergen) y Cardinal Health — distribuyen colectivamente más del 90% de todos los medicamentos recetados en los Estados Unidos, según el Commonwealth Fund (2022). Al conciliar inventario entre múltiples listas de precios de mayoristas, extraer NDC y nombres de medicamentos de los PDF de proveedores a una hoja de cálculo comparativa elimina horas de referencias cruzadas manuales lado a lado.
3. Soporte para reclamaciones de seguros
Cuando una reclamación requiere el envío de documentación de la receta — para autorización previa a través de Surescripts, para responder a una auditoría de Medicaid o para formularios de reclamación CMS-1500 con partidas de NDC — extraer los campos relevantes a una hoja de cálculo limpia acelera lo que de otro modo es un ejercicio de buscar el archivo en papel y teclear. (Consulte nuestra guía sobre extracción de datos de formularios de reclamación CMS-1500 para el flujo de trabajo específico de facturación).
En cada uno de estos escenarios, el PMS sigue siendo el sistema de registro. La extracción con IA maneja el paso de traducción — convirtiendo una imagen o PDF en campos estructurados — y el rol del técnico pasa de transcripción a verificación. Esa es la diferencia entre pasar tres horas tecleando y pasar 20 minutos revisando.
Dónde ayuda la extracción con IA — y dónde no
Seamos directos sobre las limitaciones, porque la farmacia es el sector equivocado para prometer de más.
Lo que la extracción con IA maneja bien: PDFs de recetas electrónicas impresas, recetas por fax mecanografiadas, recetas manuscritas claramente legibles con nombres de medicamentos estándar, NDC impresos en el empaque, códigos SIG estandarizados (1T PO QD, 2 inhalaciones QID PRN). El Directorio de NDC de la FDA se actualiza a diario y contiene listados activos de todos los medicamentos comercializados; la IA puede usarlo como marco de referencia para validar los NDC extraídos.
Dónde aún se necesita el juicio humano: escritura a mano extremadamente ilegible (de la que incluso un farmacéutico experimentado entrecierra los ojos), abreviaturas ambiguas de nombres de medicamentos (HCTZ vs. hidroclorotiazida — depende del contexto), instrucciones de preparación no estándar, recetas con indicaciones contradictorias o en conflicto. La IA marcará la incertidumbre en lugar de adivinar. El juicio clínico de un farmacéutico es insustituible: la herramienta reduce el tipeo, no el pensamiento.
Lo que esto no hace: No adjudica reclamos (esa es tarea de su PMS y la PBM). No realiza una revisión de utilización de medicamentos. No verifica la identidad del paciente ni la elegibilidad del seguro. Es un paso de extracción de datos — preciso en lo que hace, honesto en lo que no hace.
Preguntas Frecuentes
¿Funciona con recetas manuscritas?
Sí, para escritura a mano que sea razonablemente legible. El modelo de IA visual está entrenado con diversos estilos de escritura. Pero una receta escrita en cursiva apresurada en la esquina de un bloc roto —del tipo que desconcierta a un farmacéutico experimentado— desafiará a cualquier IA. Si un humano puede leerla, la IA normalmente también puede. Si un humano no puede, la IA probablemente tampoco.
¿Puede manejar PDFs de recetas electrónicas de diferentes sistemas EHR?
Sí — aquí es donde brilla la extracción independiente del formato. Ya sea que la receta electrónica provenga de Epic, Cerner o del EHR de un consultorio pequeño, el diseño varía pero los campos de datos son semánticamente los mismos. La IA lee por significado, no por posición, por lo que diferentes salidas de EHR no requieren configuraciones distintas.
¿Cómo maneja la conversión del formato NDC?
Puede configurar una columna calculada que convierta automáticamente cualquier formato NDC de 10 dígitos (4-4-2, 5-3-2 o 5-4-1) al formato de facturación HIPAA de 11 dígitos (5-4-2) aplicando la regla de relleno con ceros correcta. La IA lee el NDC tal como está impreso en la etiqueta y genera la versión de 11 dígitos lista para facturación como una columna separada — sin necesidad de conversión manual.
¿Se integra con mi software de gestión de farmacia?
ImageToTable.ai no se conecta directamente con PioneerRx, QS/1, Rx30 u otras plataformas PMS — es una herramienta de preprocesamiento. El resultado es una hoja de cálculo de Excel (o Google Sheets mediante el complemento) que luego se usa como fuente para la entrada de datos en su PMS. Algunas farmacias usan la hoja de cálculo como lista de verificación antes de ingresar al PMS; otras copian y pegan filas. La mejora en el flujo de trabajo no está en la integración — está en reemplazar tres horas de tipeo con un paso de revisión.
¿Esto cumple con HIPAA?
ImageToTable.ai procesa los archivos de forma transitoria y no los almacena después de completar la extracción. Hay disponible un Acuerdo de Socio Comercial (BAA) para las farmacias que lo requieran según 45 CFR § 164.504(e). Al igual que con cualquier herramienta de terceros que maneje PHI, las farmacias deben confirmar que el BAA esté firmado antes de subir imágenes de recetas que identifiquen al paciente. Para obtener una visión más amplia sobre HIPAA en la extracción de documentos médicos, lea nuestra guía de cumplimiento de HIPAA para la extracción de documentos médicos.
¿Cuál es la tasa de precisión en la extracción de datos de recetas?
Para datos de recetas impresos y claramente mecanografiados, la precisión alcanza el 99 %, en línea con el punto de referencia general de la herramienta para datos tabulares impresos. Las recetas manuscritas y los faxes de baja calidad introducen variabilidad. El cambio de comportamiento clave: incluso con una precisión del 95 % en entradas difíciles, un técnico que verifica y corrige el 5 % de los campos es significativamente más rápido que escribir manualmente el 100 % de ellos. La conversación sobre la precisión no se trata de la perfección, sino de si los errores detectados durante la verificación cuestan menos tiempo que la entrada manual desde cero.
Las Matemáticas Que Lo Cambian Todo
A 50 segundos por receta, 200 recetas al día equivalen a 167 minutos de entrada de datos, casi tres horas. Si la extracción con IA convierte esos 50 segundos en una revisión de 5 segundos por fila, más el tiempo inicial de procesamiento por lotes, las mismas 200 recetas podrían tomar 25 minutos en total.
Eso no es una mejora marginal. Es la diferencia entre un técnico que pasa la mitad de su turno escribiendo y uno que pasa casi todo ese tiempo en tareas que realmente requieren juicio humano: verificar contra las imágenes originales, detectar alertas clínicas, gestionar el inventario, hablar con los pacientes.
Y para el propietario de la farmacia que mira los números: tres horas de tiempo de técnico al día, a un costo conservador de $18/hora, representan alrededor de $14,000 al año en salarios dedicados únicamente a la entrada manual de datos, para un solo técnico, con un volumen de recetas modesto. Escale eso a dos técnicos en una independiente concurrida, y el costo de las pulsaciones de teclas se convierte en una partida que vale la pena eliminar.
Nada de esto significa que el sistema de gestión de farmacia vaya a desaparecer. Significa que el paso de entrada de datos que lo alimenta (la escritura, la conversión del formato NDC, la traducción de SIG) finalmente tiene una vía más rápida. Una que no le pide a un técnico ser una API humana entre un papel y una base de datos.