E se a entrada de dados de prescrições
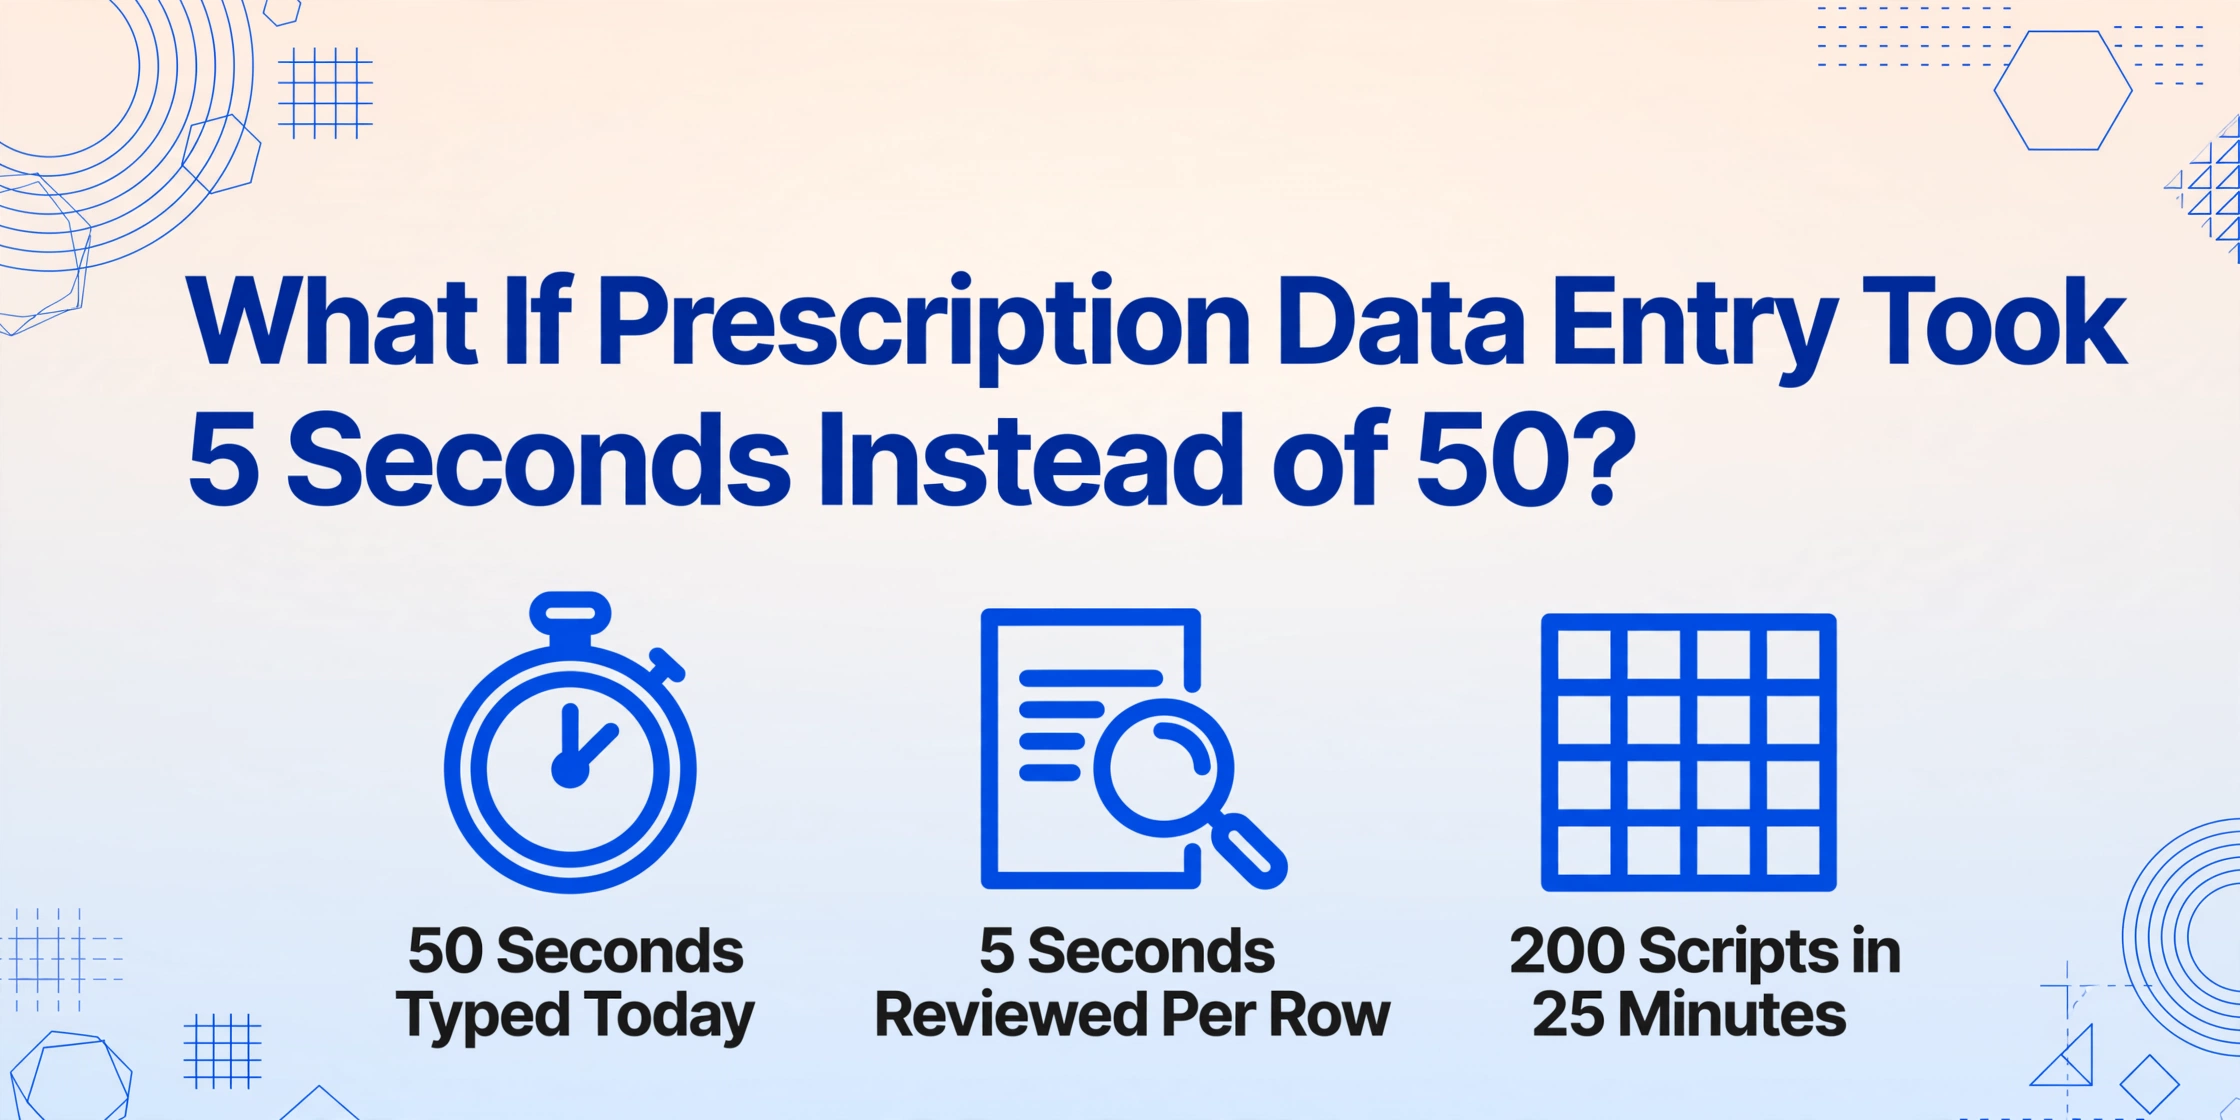
levasse 5 segundos em vez de 50?
Cinquenta segundos. Esse é o tempo padrão de entrada de dados por prescrição na maioria das farmácias de rede, de acordo com técnicos de farmácia que acompanham suas próprias métricas. Com 200 receitas por dia — um volume modesto para uma farmácia independente movimentada — são quase três horas gastas digitando nomes de medicamentos, dosagens, dígitos NDC e códigos SIG em um sistema de gestão de farmácia. Não verificando. Não aconselhando. Apenas digitando. E aqui está a parte que poucas pessoas fora da farmácia comentam: a American Pharmacists Association estima que 1,5% de todas as prescrições dispensadas contêm um erro — cerca de 67,5 milhões de erros em um único ano, muitos deles rastreáveis ao que aconteceu no teclado durante a entrada de dados.
Principais Conclusões
- A precisão de 43% na entrada de dados em dois meses não é um técnico de farmácia lento ou descuidado — é o que acontece quando você pede a um humano para ser um conversor de formato em tempo real entre cada layout de prescrição e um único banco de dados rígido.
- Um único NDC precisa de uma de três regras diferentes de preenchimento com zeros para atingir o formato de cobrança HIPAA de 11 dígitos, e um dígito errado rejeita a reivindicação — nenhuma velocidade de digitação resolve um problema de tradução de formato.
- Quando a IA lê as prescrições pelo que os dados significam em vez de onde estão na página, as três horas de transcrição do técnico se reduzem a vinte minutos de verificação.
O Custo Oculto de Cada Toque no Teclado
Erros de medicação prejudicam pelo menos 1,5 milhão de americanos por ano, com um custo econômico estimado em US$ 77 bilhões — e uma parcela significativa começa na tela de entrada de dados, não na bandeja de contagem.
A Academy of Managed Care Pharmacy (AMCP) identifica três dos tipos mais comuns de erros de dispensação: dispensar o medicamento errado, errar a dosagem e não detectar interações medicamentosas. Todos os três podem ter origem em um único dígito digitado incorretamente no sistema de gestão de farmácia (PMS).
Os técnicos de farmácia estão dolorosamente cientes disso. No subreddit r/PharmacyTechnician, um técnico do Walmart com dois meses de trabalho relatou uma taxa de precisão de entrada de 43%. Em grandes redes, a referência é de 50 segundos por tarefa de entrada de dados, com uma meta de 17 tarefas por hora — e isso para funcionários experientes. Uma meta-análise de 2018 de 62 estudos sobre erros de dispensação publicada no Research in Social and Administrative Pharmacy encontrou uma taxa global de erro de dispensação de 1,6%, com as taxas mais altas consistentemente ligadas a ambientes com maior carga de entrada manual de dados.
Isso não é um problema de falta de cuidado da equipe da farmácia. É um descompasso estrutural: cada receita chega em um formato diferente, mas todo PMS espera os mesmos campos estruturados.
Como a Entrada de Dados na Farmácia Realmente Funciona
Antes que um único comprimido seja contado, o técnico deve traduzir qualquer formato em que a receita chegou — papel, fax, telefone ou e-script — em uma série de campos estruturados dentro do sistema de gestão de farmácia.
O fluxo de trabalho é consistente na maioria dos softwares de farmácia — PioneerRx, QS/1, Computer-Rx, Rx30 — mesmo que os layouts dos botões sejam diferentes. Uma receita chega por um de quatro canais:
- Receita em papel — Entregue no balcão ou enviada por fax. O técnico lê nomes de medicamentos, dosagens e assinaturas de médicos escritos à mão.
- e-Script — Chega digitalmente via Surescripts através do Padrão NCPDP SCRIPT (1,9 bilhão de transações por ano). Já estruturado, mas ainda frequentemente exige revisão manual para corrigir erros de mapeamento de campos.
- Por telefone — Ligado pelo consultório do prescritor. Um técnico transcreve em tempo real, muitas vezes enquanto gerencia outras tarefas.
- Fax — Ainda representa uma parcela surpreendente das transmissões de receitas, especialmente de clínicas menores e provedores especializados.
Quando a receita chega, o técnico abre o PMS e inicia a entrada de dados. No PioneerRx, isso acontece na Estação de Triagem ou na fila de Entrada de Dados. Os campos que devem ser preenchidos normalmente incluem:
| Campo | Exemplo | Por que é importante |
|---|---|---|
| Nome do Medicamento | Lisinopril | Deve corresponder à entrada do formulário; confusão entre genérico e marca é comum |
| Dosagem | 10 mg | Dosagem errada = um dos três principais tipos de erro (AMCP) |
| Forma Farmacêutica | Comprimido | Substituição de comprimido por cápsula exige julgamento do farmacêutico |
| NDC | 68180-0981-03 | Deve ser convertido para o formato HIPAA de 11 dígitos (5-4-2) para faturamento |
| SIG / Modo de Usar | 1T PO QD | Os códigos SIG devem ser expandidos corretamente para os rótulos dos pacientes |
| Quantidade | 30 | Relaciona-se ao cálculo de dias de tratamento para adjudicação do seguro |
| Renovações | 3 | Substâncias da Lista II: 0 renovações por lei (21 CFR 1306.12) |
| Prescritor | NPI / DEA # | Obrigatório para envio da solicitação; NPI errado = rejeição |
Após a entrada, a prescrição segue para um farmacêutico para pré-verificação. Se o farmacêutico detectar um erro de digitação — dosagem errada, NDC errado, SIG mal interpretado — ela volta para o técnico para correção. Cada correção é um ciclo de retrabalho que adiciona minutos a um processo já medido em segundos. Como um comentarista do Reddit no r/pharmacy disse: "Estou fazendo isso há um mês e é muito chato. Nada de dispensar, nada de manipular, só telefones e computadores."
Por que "Apenas Digite Mais Rápido" Não Vai Resolver
O gargalo não é a velocidade de digitação. É a tradução de formato — e nenhum atalho de teclado resolve o fato de que cada receita chega falando uma linguagem de dados diferente.
Considere o que um técnico realmente faz durante esses 50 segundos. Ele não está apenas transcrevendo — está interpretando e convertendo:
Uma receita manuscrita pode dizer "Lisinopril 10mg 1 comprimido ao dia #30." O técnico precisa analisar isso em campos discretos do banco de dados, expandir o SIG para uma linguagem voltada ao paciente, procurar o NDC correto para o fabricante específico e o tamanho do pacote em estoque, e verificar se o formato de cobrança HIPAA de 11 dígitos (5-4-2) está corretamente preenchido com zeros à esquerda. O Diretório NDC da FDA lista três formatos diferentes de 10 dígitos atualmente em uso — 4-4-2, 5-3-2 e 5-4-1 — cada um exigindo uma regra diferente de preenchimento com zeros para alcançar o formato de 11 dígitos exigido pelo CMS para todas as transações cobertas pela HIPAA.
| Rótulo do Pacote (10 Dígitos) | HIPAA 11 Dígitos (5-4-2) | Regra de Conversão |
|---|---|---|
| 1234-5678-91 (4-4-2) | 01234-5678-91 | Zero à esquerda no segmento do fabricante |
| 12345-678-91 (5-3-2) | 12345-0678-91 | Zero à esquerda no segmento do produto |
| 12345-6789-1 (5-4-1) | 12345-6789-01 | Zero à esquerda no segmento do pacote |
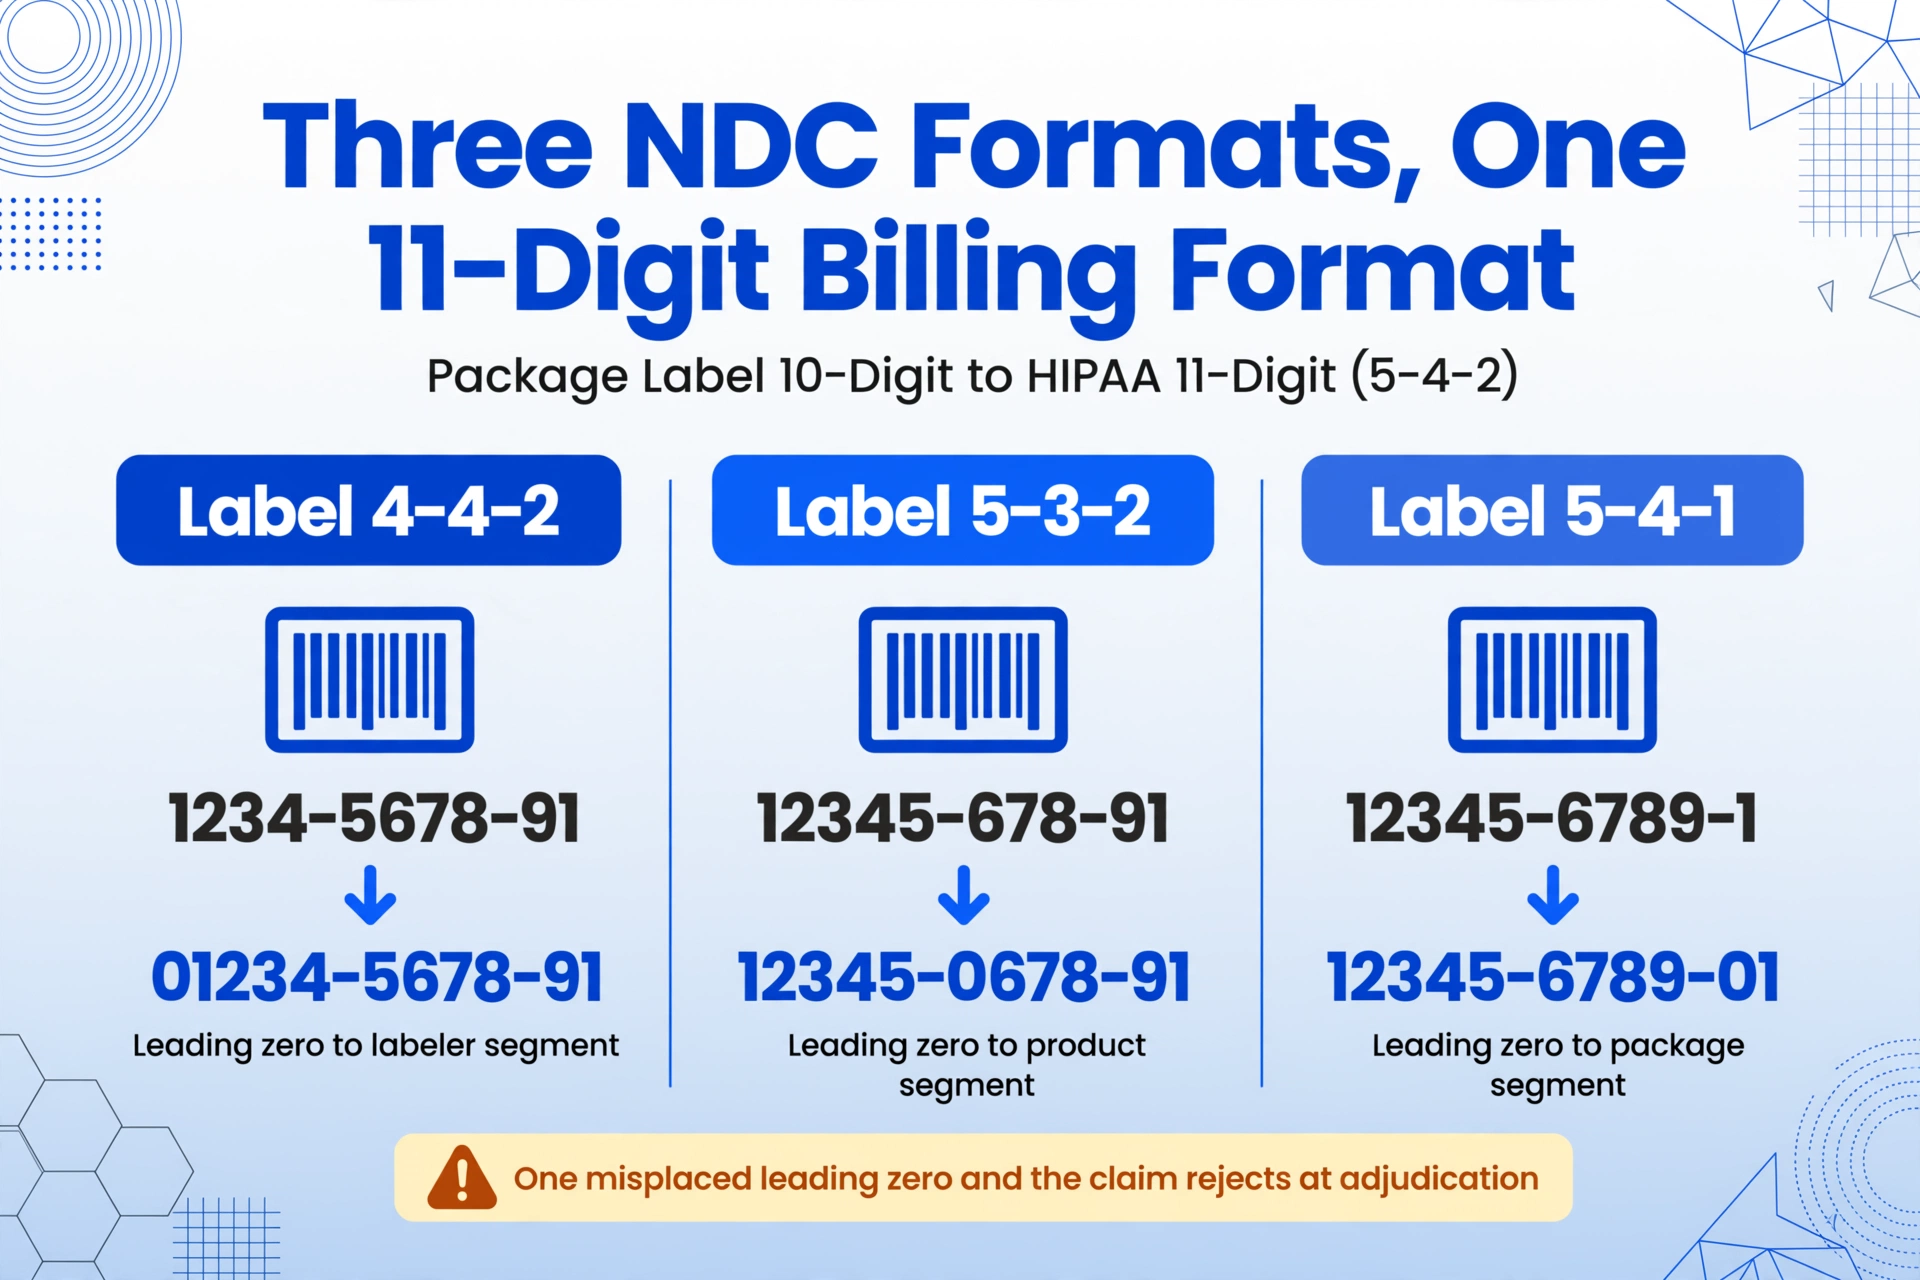
Erre qualquer dígito — um único zero à esquerda mal colocado — e a reivindicação é rejeitada na adjudicação. O técnico volta, relê o frasco, reinsere. Mais 30 segundos. Multiplique por cada NDC em cada receita todos os dias.
Depois, há a camada RxNorm. Quando o PMS de uma farmácia usa um vocabulário de medicamentos (digamos, First Databank) e o EHR de um hospital usa outro (digamos, Multum), o RxNorm — mantido pela Biblioteca Nacional de Medicina — fornece os nomes clínicos normalizados de medicamentos que fazem a mediação entre eles. Mas um técnico fazendo entrada manual não interage diretamente com o RxNorm. Ele só precisa que os dados estejam corretos para que os sistemas downstream possam mapeá-los.
O problema real é que a entrada manual de dados pede que um humano atue como conversor de formato — um trabalho para o qual os computadores foram feitos. A receita não é o problema. O teclado é.
Ensinando a IA a Ler Como um Técnico de Farmácia
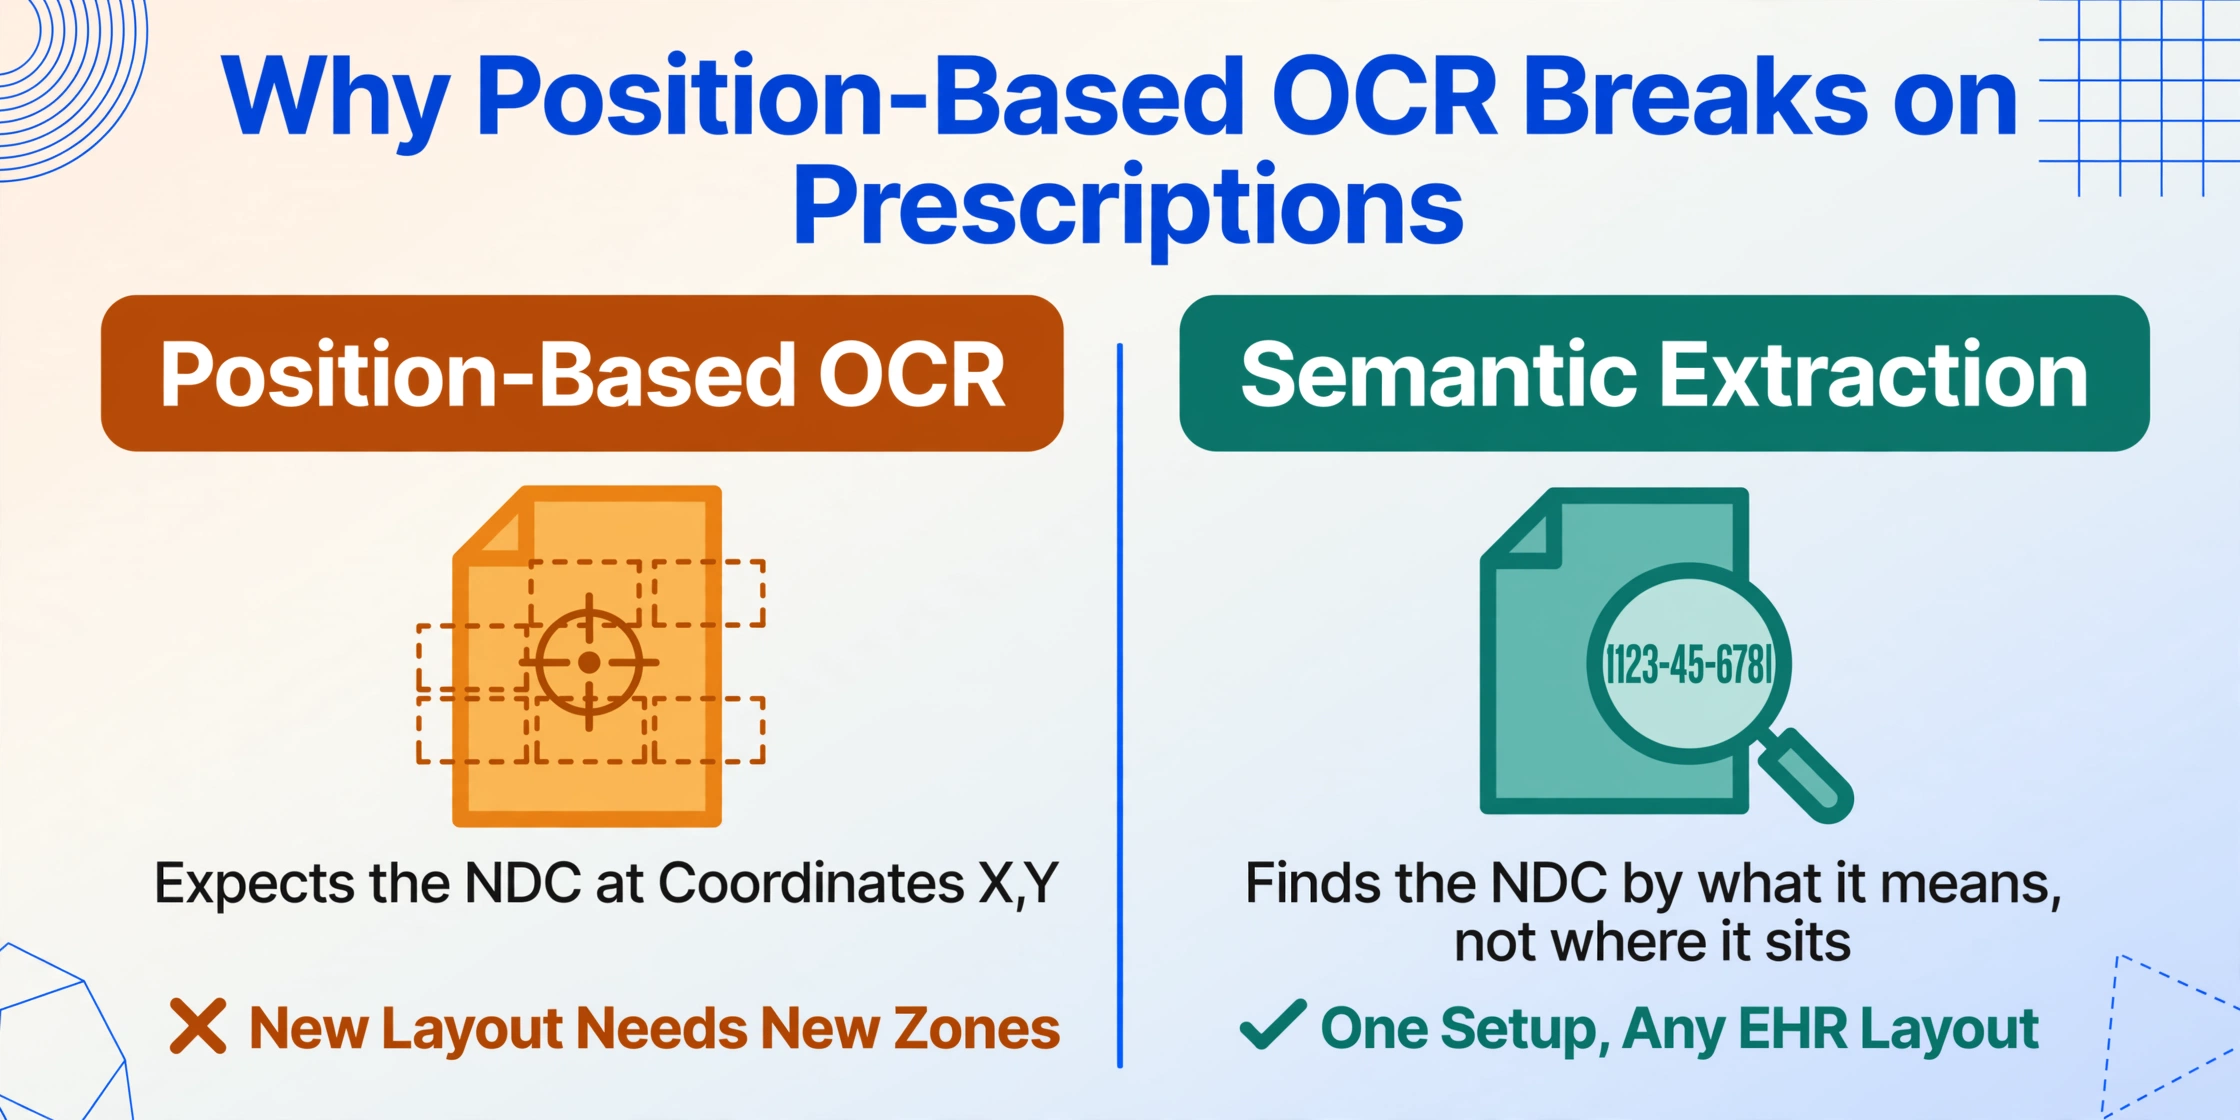
A mudança que altera a matemática não é digitar mais rápido. É eliminar completamente a etapa de tradução — e deixar que a IA lea a receita do mesmo modo que um técnico, só que ela nunca transponha um dígito.
A maioria das ferramentas de extração de documentos usa uma abordagem baseada em modelos: você define zonas na página onde campos específicos estão localizados, e o software aplica OCR nessas zonas. Isso funciona muito bem para formulários padronizados — mas as receitas são o oposto de padronizadas. Uma receita do consultório da Dra. Chen em Houston não se parece em nada com uma de uma MinuteClinic em Chicago. A caligrafia varia. Os layouts de PDF de e-script variam por fornecedor de EHR. A qualidade do fax varia pela máquina do remitente.
ImageToTable.ai adota uma abordagem fundamentalmente diferente chamada Extraction de Colunas Personalizadas. Em vez de dizer à IA onde os dados estão na página, você diz o que deseja encontrar — pelo significado do campo, não pela sua posição. Você define nomes de colunas como "Nome do Medicamento", "Dosagem", "NDC" e "SIG", e a IA lê todo o documento, localiza cada valor entendendo seu contexto semântico e retorna uma linha estruturada. O formato não importa. O layout não importa. A IA procura o que os dados significam, não onde estão.
Esta é a diferença entre extração baseada em posição (OCR tradicional: "Espero que o NDC esteja nas coordenadas X,Y") e extração baseada em semântica (IA: "Reconozco um identificador de medicamento de 10 dígitos com uma estrutura de etiqueta-produto-pacote em qualquer lugar desta página"). A receita pode ser um PDF de e-script nítido ou um fax tão desbotado que o carimbo da farmacia é quase ilegible — a abordagem da IA é a mesma.
O sistema também suporta colunas inferidas: campos que a IA deriva do contexto em vez de encontrar impressos na página. Por exemplo, uma coluna como "Agenda (II/III/IV/V)" leva a IA a identificar o medicamento, cruzar referências com sua agenda de substancias controladas da DEA e preencher a classificação — mesmo que "Agenda II" não apareça em nenhum lugar da receita. A mesma abordagem funciona para classe terapéutica, marcación de marca vs. genérico e predicción de nível de formulário.
Passo a Passo: Da Imagem da Receita à Planilha Estruturada
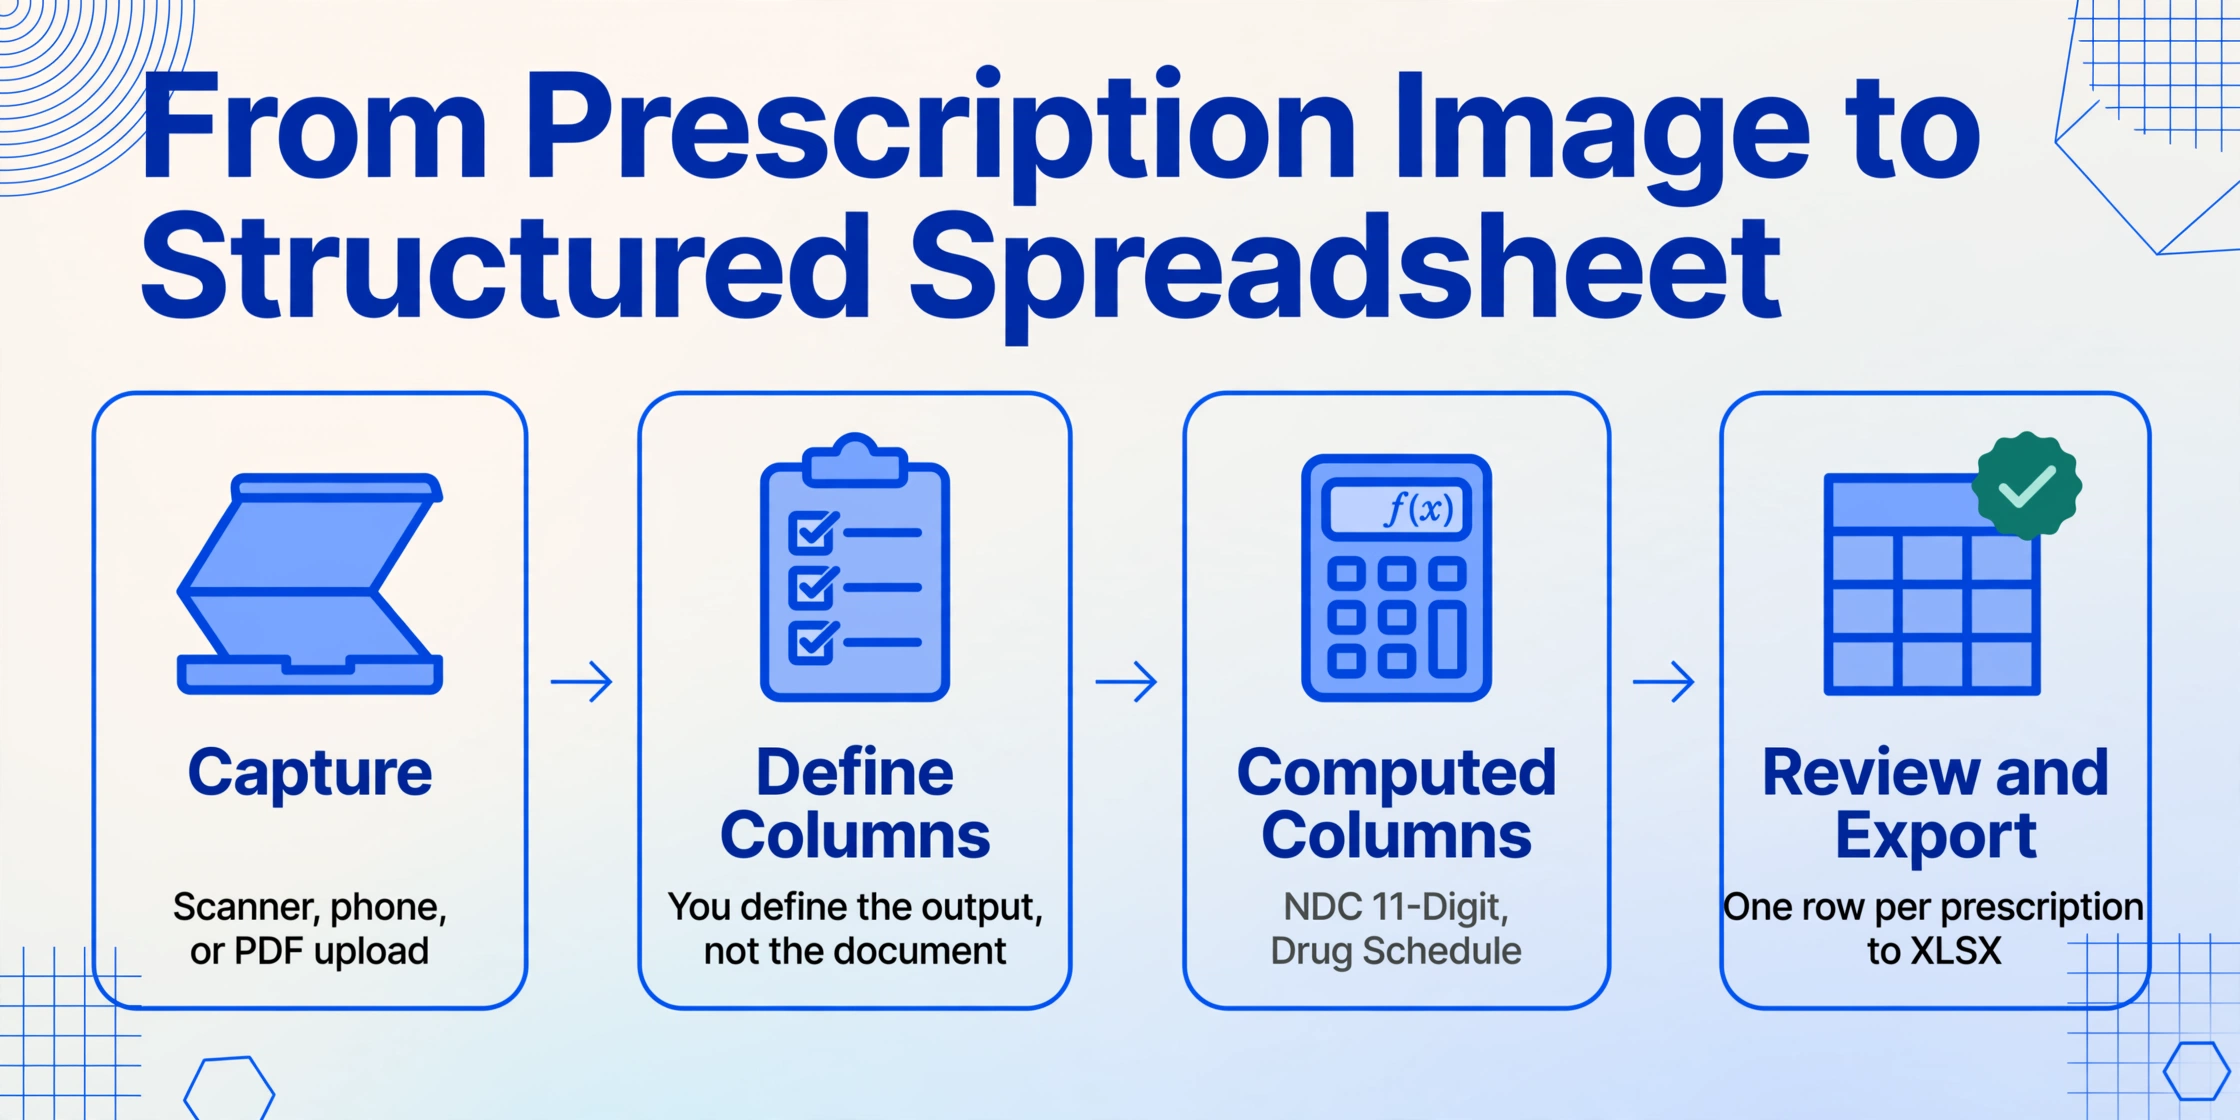
Este é o fluxo de trabalho real — sem teoria, sem truques de demonstração. Se você tem uma pilha de receitas em papel ou uma pasta de PDFs de e-scripts na sua área de trabalho agora, este é o caminho da imagem para o Excel.
Capture a receita
Digitalize receitas em papel com qualquer scanner de mesa ou fotografe-as com a câmera do celular. PDFs de e-scripts podem ser enviados diretamente — sem necessidade de impressão. O upload em lote também funciona: envie 50 receitas de uma vez e todas entram na fila de processamento. E quando a fonte é a foto do frasco de farmácia tirada pelo paciente, em vez do papel original — o caso comum para acompanhamento de reabastecimento em casa — as mesmas colunas leem a foto do rótulo da receita com a mesma clareza.
Defina suas colunas de saída
Digite os nomes dos campos que você precisa. Para receitas, um conjunto típico de colunas é: Nome do Medicamento, Dosagem, Forma Farmacêutica, NDC, SIG / Modo de Usar, Quantidade, Dias de Suprimento, Renovações, Nome do Prescritor, NPI do Prescritor. Eles se tornam os cabeçalhos da sua planilha de saída — você define a saída, não o documento.
Adicione colunas calculadas e inferidas (opcional)
Vá além do que está impresso. Adicione uma coluna calculada como "NDC de 11 Dígitos (converter de 10 dígitos, se necessário)" para formatar automaticamente os NDCs para cobrança. Ou adicione uma coluna inferida como "Classificação do Medicamento (opções: II/III/IV/V/não controlado)" para classificar substâncias controladas automaticamente. A IA lida com extração e cálculo em uma única passada.
Revise e exporte
A IA retorna uma tabela estruturada — uma linha por receita, colunas correspondendo às suas definições. Revise os resultados na interface web ou exporte diretamente para o Excel (XLSX). Para usuários do Google Sheets, o add-on do Sheets grava os resultados diretamente na sua planilha sem sair do Sheets.
Os arquivos são processados com segurança e não são armazenados.
E Sobre a HIPAA e os Dados dos Pacientes?
Qualquer farmácia que avalie uma ferramenta de extração por IA precisa começar com uma pergunta: isso cria um problema de conformidade com a HIPAA? A resposta depende de a ferramenta ser um Associado de Negócios — e de os acordos corretos estarem em vigor.
As farmácias são Entidades Cobertas sob a HIPAA (45 CFR § 160.103). Quando você compartilha Informações de Saúde Protegidas (PHI) — e uma imagem de prescrição contendo o nome do paciente e o nome do medicamento é PHI — com um serviço terceirizado que as processa em seu nome, esse serviço se torna um Associado de Negócios. De acordo com 45 CFR § 164.504(e), uma Entidade Coberta deve ter um Contrato de Associado de Negócios (BAA) assinado antes de divulgar PHI a qualquer fornecedor.
Isso não é papelada opcional — é um contrato legalmente exigido. Um BAA estipula o que o Associado de Negócios pode e não pode fazer com a PHI, exige notificação de violação dentro de prazos específicos e sujeita o fornecedor à Regra de Segurança e à Regra de Notificação de Violação da HIPAA. Farmácias que usam ferramentas de IA para processamento de documentos devem confirmar duas coisas antecipadamente: (1) o fornecedor assinará um BAA e (2) o manuseio de dados do fornecedor — retenção, criptografia, localização do servidor — está alinhado com o que o BAA exige.
O ImageToTable.ai processa arquivos de forma transitória: o documento é lido, os dados são extraídos e o arquivo não é armazenado em seus servidores após a conclusão do processamento. Para farmácias que exigem documentação formal da HIPAA, um BAA está disponível. O mesmo framework se aplica a qualquer ferramenta de extração de documentos usada em um contexto de farmácia. (Para um mergulho mais profundo nas considerações da HIPAA em vários tipos de documentos médicos, consulte nosso guia de extração de documentos médicos da HIPAA.)
Onde Isso Se Encaixa no Seu Fluxo de Trabalho de Farmácia Atual
Isso não substitui o PioneerRx, QS/1 ou qualquer sistema de gestão de farmácia. É uma ferramenta de pré-processamento que atua antes do seu PMS — transformando a etapa de entrada de dados da parte mais lenta do fluxo de trabalho na mais rápida.
Aqui estão três pontos de integração concretos onde a extração por IA se encaixa no dia a dia de uma farmácia em funcionamento:
1. Lote matinal: limpando a fila de fax e papel
Em vez de um técnico gastar os primeiros 90 minutos digitando uma pilha de receitas enviadas por fax, digitalize ou fotografe todas elas, faça o upload em lote, defina as colunas uma vez e receba uma planilha completa em minutos. O técnico então revisa cada linha comparando com as imagens originais — uma etapa de verificação, não de transcrição — e copia os dados para o PMS. Mesmo com copiar e colar manual, revisar e verificar é dramaticamente mais rápido do que ler e digitar.
2. Reconciliação de inventário com dados de atacadistas
Os três principais atacadistas farmacêuticos — McKesson, Cencora (anteriormente AmerisourceBergen) e Cardinal Health — distribuem coletivamente mais de 90% de todos os medicamentos prescritos nos Estados Unidos, de acordo com o Commonwealth Fund (2022). Ao reconciliar o inventário em várias listas de preços de atacadistas, extrair NDCs e nomes de medicamentos de PDFs de fornecedores para uma planilha de comparação elimina horas de referência cruzada manual lado a lado.
3. Suporte a reivindicações de seguro
Quando uma reivindicação exige o envio de documentação de prescrição — para autorização prévia através da Surescripts, para resposta a auditoria do Medicaid ou para formulários de reivindicação CMS-1500 com itens de linha NDC — extrair os campos relevantes para uma planilha limpa acelera o que de outra forma seria um exercício de puxar o arquivo de papel e digitar. (Consulte nosso guia sobre extração de dados de formulários de reivindicação CMS-1500 para o fluxo de trabalho específico de cobrança.)
Em cada um desses cenários, o PMS permanece como o sistema de registro. A extração por IA cuida da etapa de tradução — transformando uma imagem ou PDF em campos estruturados — e o papel do técnico muda de transcrição para verificação. Essa é a diferença entre gastar três horas digitando e gastar 20 minutos conferindo.
Onde a Extração por IA Ajuda — e Onde Não Ajuda
Vamos ser diretos sobre as limitações, porque farmácia é o setor errado para promessas exageradas.
O que a extração por IA lida bem: PDFs de e-scripts impressos, receitas por fax digitadas, receitas manuscritas legíveis com nomes de medicamentos padrão, NDCs impressos em embalagens, códigos SIG padronizados (1T PO QD, 2 puffs QID PRN). O Diretório de NDCs da FDA é atualizado diariamente e contém listagens ativas de todos os medicamentos comercializados — a IA pode usar isso como referência para validar os NDCs extraídos.
Onde você ainda precisa do julgamento humano: caligrafia severamente ilegível (daquelas que até um farmacêutico experiente aperta os olhos), abreviações ambíguas de nomes de medicamentos (HCTZ vs. hidroclorotiazida — depende do contexto), instruções de manipulação não padronizadas, receitas com orientações conflitantes ou contraditórias. A IA sinalizará a incerteza em vez de adivinhar. O julgamento clínico de um farmacêutico não é substituível — a ferramenta reduz a digitação, não o raciocínio.
O que isso não faz: Não processa a adjudicação de sinistros (essa é a função do seu PMS e da operadora). Não realiza revisão de utilização de medicamentos. Não verifica a identidade do paciente ou a elegibilidade do seguro. É uma etapa de extração de dados — precisa sobre o que faz, honesta sobre o que não faz.
Perguntas Frequentes
Funciona com receitas manuscritas?
Sim, para caligrafia razoavelmente legível. O modelo de IA visual é treinado em diversos estilos de escrita. Mas uma receita escrita com letra cursiva apressada no canto de um bloco de notas rasgado — daquelas que confundem um farmacêutico experiente — desafiará qualquer IA. Se um humano consegue ler, a IA geralmente também consegue. Se um humano não consegue, a IA provavelmente também não conseguirá.
Consegue lidar com PDFs de e-scripts de diferentes sistemas EHR?
Sim — é aqui que a extração independente de formato se destaca. Quer o e-script venha do Epic, Cerner ou do EHR de uma pequena clínica, o layout varia, mas os campos de dados são semanticamente os mesmos. A IA lê pelo significado, não pela posição, portanto, diferentes saídas de EHR não exigem configurações diferentes.
Como lida com a conversão do formato NDC?
Você pode configurar uma coluna calculada que converte automaticamente qualquer formato NDC de 10 dígitos (4-4-2, 5-3-2 ou 5-4-1) para o formato de faturamento HIPAA de 11 dígitos (5-4-2) aplicando a regra de preenchimento com zeros correta. A IA lê o NDC impresso no rótulo e gera a versão de 11 dígitos pronta para faturamento como uma coluna separada — sem necessidade de conversão manual.
Integra-se com meu software de gestão de farmácia?
O ImageToTable.ai não se conecta diretamente ao PioneerRx, QS/1, Rx30 ou outras plataformas PMS — é uma ferramenta de pré-processamento. A saída é uma planilha do Excel (ou Google Sheets via o complemento) que você então usa como fonte para a entrada de dados no seu PMS. Algumas farmácias usam a planilha como uma lista de verificação antes da entrada no PMS; outras copiam e colam linhas. A melhoria no fluxo de trabalho não está na integração — está em substituir três horas de digitação por uma etapa de revisão.
Isso está em conformidade com HIPAA?
ImageToTable.ai processa arquivos de forma transitória e não os armazena após a conclusão da extração. Um Contrato de Associado de Negócios (BAA) está disponível para farmacias que o exigem sob 45 CFR § 164.504(e). Como acontece com qualquer ferramenta de terceiros que manusea PHI, as farmacias devem confirmar que o BAA foi executado antes de enviar imagens de receitas que identifiquem pacientes. Para uma visão mais ampla sobre HIPAA na extração de documentos médicos, leia nosso guia de conformidade com HIPAA para extração de documentos médicos.
Qual é a taxa de precisão para a extração de dados de receitas?
Para dados de receitas impressos e claramente digitados, a precisão chega a 99% — consistente com o benchmark geral da ferramenta para dados de tabelas impressas. Receitas manuscritas e faxes de baixa qualidade introducen variabilidade. A mudança comportamental clave: mesmo com 95% de precisão em entradas difífíciles, um técnico que verifica e corrige 5% dos campos é significativamente mais rápido que digitar manualmente 100% deles. A conversa sobre precisão não trata de perfección — trata de si os erros detectados durante a verificação custam menos tempo que a entrada manual do zero.
A Matemática Que Cambia Todo
A 50 segundos por receita, 200 receitas por dia equivalen a 167 minutos de entrada de dados — quase três horas. Se a extração com IA converte esses 50 segundos em uma revisão de 5 segundos por linha, mais o tempo inicial de processamento em lote, as mesmas 200 receitas poderían levar 25 minutos no total.
Isso não é uma melhora marginal. É a diferença entre um técnico passando metade de seu turno digitando e passando quase todo o tempo em tarefas que realmente requerem julgamento humano — verificar contra imagens originais, detectar alertas clínicos, gestionar inventário, falar com pacientes.
E para o proprietário da farmacia que observa os números: três horas de tempo de técnico por dia, a um custo conservador de $18/hora, são cerca de $14.000 por ano em salários gastos apenas em entrada manual de dados — para um único técnico, com um volume modesto de receitas. Escale isso a dois técnicos em uma independente movimentada, e o custo das teclas se converte em uma partida que vale a pena eliminar.
Nada disso significa que o sistema de gestão de farmácia vai desaparecer. Significa que a etapa de entrada de dados que o alimenta — a digitação, a conversão de formato NDC, a tradução SIG — finalmente tem um caminho mais rápido. Um que não pede a um técnico ser uma API humana entre um pedazo de papel e uma base de dados.