海運・貨物書類のデータ抽出
完全ガイド
1件の国際輸送では、5〜7種類の書類一式が発生します——B/L(船荷証券)、貨物マニフェスト、梱包明細書、商業送り状、原産地証明書、運賃請求書、場合によっては配達証明書です。各書類は異なる当事者(運送会社、フォワーダー、倉庫、輸出者)が異なる目的(運送契約、貨物目録、税関評価、請求)で作成します。しかし抽出時には、それらのデータは整合していなければなりません——梱包明細書の個数はB/Lの個数と一致し、商業送り状のHSコードはマニフェストの申告内容と一致し、書類一式のすべてに記載されたコンテナ番号は同一でなければなりません。これが海運書類抽出の根本的な課題です——単一の書類を読み取ることではなく、共有フィールドが一致するよう、すべての書類をまとめて読み取ることです。本ガイドでは、各海運書類が保持するデータ、他の書類とのデータ重複箇所、そして書類一式全体を1つの統合データセットに抽出する方法を解説します。
重要ポイント
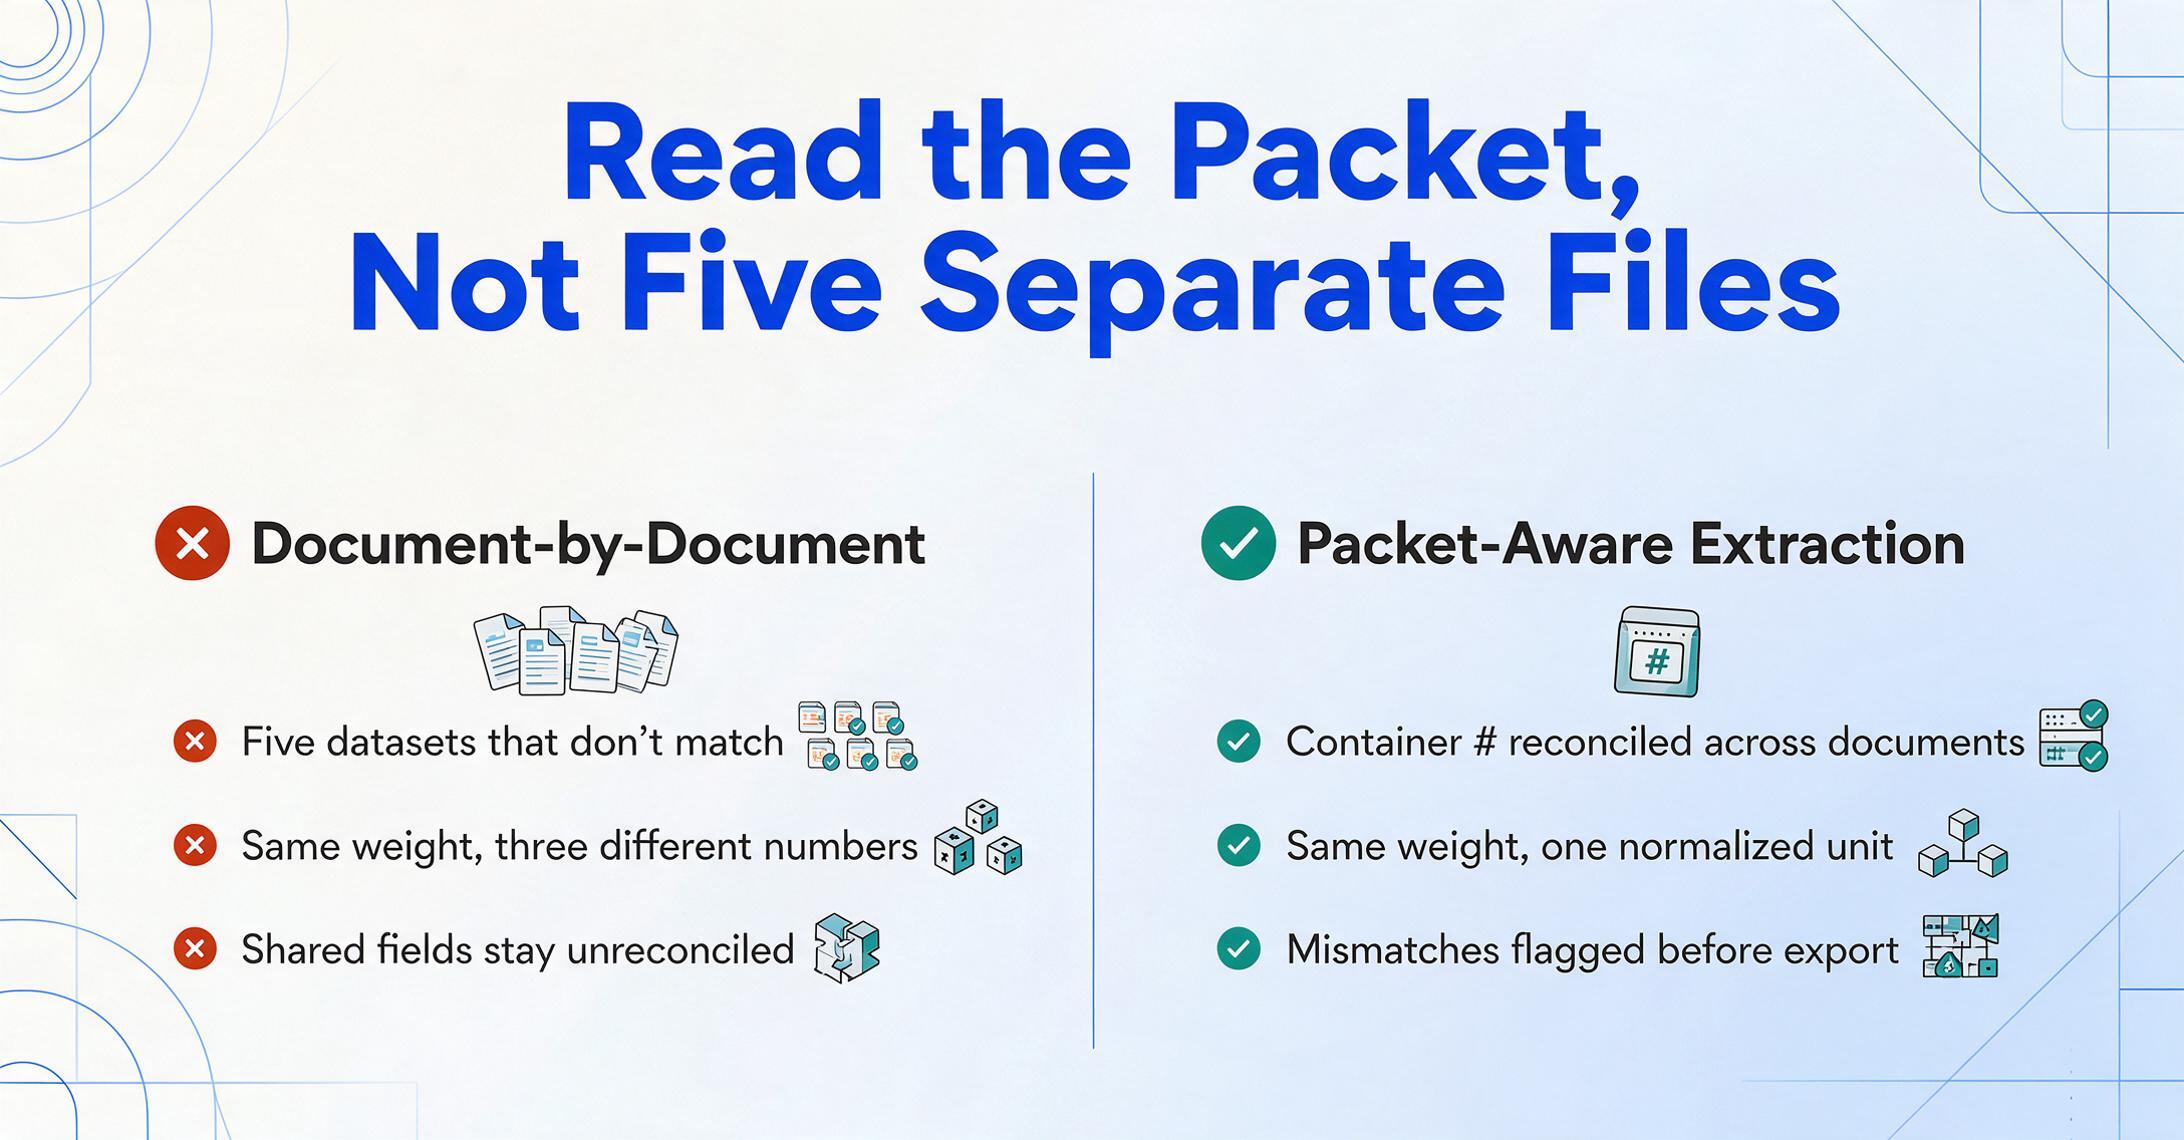
- 国際輸送1件につき、5つの異なる当事者から5〜7種類の書類が発行されます——そしてコンテナ番号、重量、個数はすべての書類間で一致している必要があります。
- しかし生の抽出結果では一致しないことがほとんどです。B/Lは重量をキログラムで、マニフェストはポンドで、梱包明細書はハンドレッドウェイトで記録するため——同じ貨物なのに3つの異なる数値になり、発覚が遅れると税関修正ペナルティとして$5,000のコストが発生します。
- 単一の列定義で書類一式全体を1バッチで処理すれば、AIが共有フィールドを正規化し、書類間の値を照合し、税関ブローカーが申告する前に不一致をフラグ付けします。
船積書類エコシステム — 1つの貨物に5つの書類
抽出を始める前に、物流チームは何を抽出するのか、書類同士がどのように関連しているのかを把握する必要があります。典型的なFCL(フルコンテナロード)海上貨物では、以下の5つの主要書類が作成されます:
| 書類 | 発行元 | 主な目的 | 主要な共通フィールド |
|---|---|---|---|
| Bill of Lading (BOL) | 運送会社またはフォワーダー | 運送契約+貨物引渡証券 | コンテナ番号、港コード、荷送人/荷受人、重量、個数 |
| Cargo Manifest | 運送会社または船舶代理店 | 航海全体の完全な貨物目録 | B/L番号、コンテナ番号、HSコード、総重量、梱包数 |
| Packing List | 荷送人/輸出者 | 貨物の品目別内訳 | コンテナ番号、PO番号、品目説明、数量、正味/総重量、寸法 |
| Commercial Invoice | 輸出者/売り手 | 税関評価+支払い記録 | HSコード、インコタームズ、総額、原産国、出荷参照番号 |
| Freight Invoice | 運送会社 | 輸送サービスの請求 | B/L番号、コンテナ番号、料金、付帯費用、支払条件 |
共通フィールドの問題はすぐに明らかです:コンテナ番号はB/L、マニフェスト、パッキングリスト、フレートインボイスに記載されています。B/L番号はマニフェスト、コマーシャルインボイス、フレートインボイスを結び付けます。総重量はB/L、マニフェスト、パッキングリストに記載されていますが、単位が揃っていることはほとんどありません(B/Lはキログラム、パッキングリストはポンド、マニフェストはメトリックトンで表示される場合があります)。各書類を単独で読み取る抽出プロセスでは、一致しない5つのデータセットが生成されます。船積書類一式を前提に設計された抽出プロセスでは、それらをまとめて読み取り、不一致を検出します。
セマンティックAI抽出がこれらの書類を従来のOCRとどのように異なる方法で処理するかについて詳しくは、物流向けOCRガイドおよびAI OCRの基礎をご覧ください。
B/L(船荷証券)— 基本文書
船荷証券は、輸送書類一式の中で最も法的に複雑な文書です。これは同時に、貨物の受取証、運送契約書、そして— 譲渡可能な形式の場合— 貨物の権原証書でもあります。フィールド数だけを見ても、ここでの抽出が簡単でない理由がわかります。一般的な海上B/Lには30〜40のデータフィールドが3〜5ページにわたって含まれ、複数の国際規格に準拠しています。
当社は、BOLデータ抽出に関する専用の完全ガイドを公開しており、BOLの種類(ストレート vs 海上 vs 複合一貫、マスター vs ハウス)、抽出パイプライン、検証について詳細に解説しています。また、BOLデータをExcelに抽出する手順も紹介しています。ここでは、文書間の連携に重要な点、つまり他のすべての輸送書類が参照するフィールドに焦点を当てます。
| フィールド | 例 | 検証基準 | 他の記載書類 |
|---|---|---|---|
| コンテナ番号 | MSCU 234781 6 | ISO 6346 — 英字4文字+数字7桁、11桁目にチェックデジット | マニフェスト、梱包明細書、運賃請求書 |
| 封印番号 | SH-789012 | 国際規格なし。船会社・ターミナルが付番 | マニフェスト、梱包明細書 |
| 積込港 / 揚荷港 | CN SHA / NL RTM | UN/LOCODE — 5文字(国2文字+地点3文字) | マニフェスト、商業送り状(ルーティング欄) |
| SCACコード | MAEU (Maersk) | NMFTA — 船会社識別用の英字2〜4文字 | マニフェスト(米国向けACE申告の場合) |
| 総重量 | 15,420 KGS | SOLAS第VI章規則2に基づくVGM(検証済み総重量) | マニフェスト、梱包明細書 |
| 個数 / 梱包形態 | 500 CTNS on 10 PLTs | NMFC / 業界慣行 | マニフェスト、梱包明細書 |
| HSコード(品目) | 6305.33 | WCO(世界税関機構)— 最低6桁、米国輸入は10桁 | 商業送り状、マニフェスト |
SCACコードは、物流業界で最も誤抽出されやすいフィールドであるため、詳しく見る価値があります。B/Lに船会社名が「Maersk Line」と印刷されていても、TMSが期待するのはMAEUかもしれません。別の船会社が、参照番号のように見えるSCACコードを社名と一緒に記載している場合もあります。セマンティックAI抽出は、標準的なコードパターン(英大文字2〜4文字、多くの場合船会社名またはSCACラベルの近くに表示)を認識し、完全な船会社名とは別のフィールドとして抽出することで、この問題に対処します。しかし、すべての抽出ツールがSCACコードを探すように設計されているわけではありません。多くのツールは船会社フィールドを自由テキストとして扱い、システムがMAEUを必要としているのに「Maersk Line」を出力します。
配送ラベルとそのデータポイントのフィールド別精度の詳細については、関連記事AIは配送ラベルとマニフェストデータを抽出できますか?をご覧ください。
カーゴマニフェスト — 船積みレベルの在庫リスト
カーゴマニフェストとは、船舶、トラック、航空機、列車などの輸送手段に積載された全貨物の完全なリストです。個別の船積み契約であるBOLとは異なり、マニフェストは複数貨物の在庫リストであり、主に税関当局、港湾運営者、ターミナルハンドラーによって使用されます。
海上マニフェストは通常、船舶上のBOLごとに1行が割り当てられ、以下の主要な列で構成されます:
- マスターBOL番号 — 混載貨物をカバーする運送会社発行のBOL
- ハウスBOL番号 — 該当する場合、各荷主向けにフォワーダーが発行したBOL
- コンテナ番号 — 各BOLに関連するすべてのコンテナ
- 商品説明 — 多くの場合、省略またはグループ化(例:混載コンテナの「百貨店雑貨」)
- HSコード — 税関用の6~10桁の分類コード
- 総重量と容積 — BOLごとの合計
- 積港と揚港 — UN/LOCODE形式
- 荷主と荷受人 — 名称と住所
- 船舶名と航海番号 — 海上マニフェスト用
マニフェストの形式上の課題は、根本的に異なる2つの構造が存在することです。米国向け貨物のCBP準拠ACEマニフェストは、CBP 1301(入国カーゴマニフェスト)またはCBP 1302(出国)形式に従い、ISF申告に必要な特定のフィールドがあります。フォワーダーが内部で使用する商業マニフェストは、まったく異なるレイアウトを使用し、BOL単位ではなくコンテナ単位でフィールドをグループ化する場合があります。航空貨物マニフェスト(AWBマニフェスト)は、海上マニフェストとは異なるヘッダー構造(船舶名の代わりにフライト番号、MBL/HBLの代わりにMAWB/HAWB)を使用します。
抽出の課題は、マニフェストデータがコンテナレベルでBOLデータと整合する必要があることです。マニフェストにコンテナ MSCU 234781 6 が500カートンを運ぶと記載され、BOLが480カートンと記載されている場合、その20カートンの差はマニフェストの入力エラーかBOLのエラーのいずれかであり、税関または荷受人によって指摘されます。両方の文書を読み取り、処理中に共通フィールドを比較するセマンティック抽出により、この不一致が税関保留になる前に検出されます。
パッキングリスト — 品目レベルの明細
パッキングリストは、出荷書類の中で最も詳細な書類です。船荷証券(BOL)が総重量と総個数を示すのに対し、パッキングリストは各パッケージの中身をカートン単位、パレット単位で明らかにします。LCL(コンテナ未満混載)貨物の場合、パッキングリストはフォワーダーが複数の荷主からの貨物をどのように混載するかを示す書類です。
標準的なパッキングリストの項目は以下の通りです。
| フィールドグループ | フィールド | 抽出時の注意点 |
|---|---|---|
| 出荷識別子 | パッキングリスト番号、PO番号、インボイス番号、BOL番号、コンテナ番号 | PO番号は重要です。パッキングリストと注文書、商業送り状を結びつけるクロスリファレンスキーです |
| 当事者情報 | 荷主、荷受人、通知先、輸出者 | BOLと一致する必要があります。不一致は出荷途中のフォワーディング指示変更を示唆します |
| パッケージレベルの詳細 | カートン/パレットのマークと番号、パッケージタイプ(CTN、PLT、BNDL)、パッケージ数 | パッケージマークは手書きやスタンプの場合が多く、パッキングリスト抽出で最もエラー率の高いフィールドです |
| 品目レベルの詳細 | 品目説明、HSコード、パッケージあたり数量、単位(PCS、KGS、LBS)、正味重量、パッケージあたり総重量 | パッキングリストの品目説明はBOLよりも詳細です。「婦人用綿ニットセーター、色混在」とBOLの略称「婦人用セーター」の違いなど |
| 寸法 | パッケージあたりの縦×横×高さ、総容積 | 形式は様々です。「48x40x36 in」「120x100x90 cm」、または単一のCBM数値。容積重量計算(国内はDIM係数139、国際は6000)は正確な値に依存します |
パッキングリストは品目レベルの真実の書類として、出荷における最も重要なクロスドキュメントチェックの一つ、数量照合の基盤となります。商業送り状には2,000個、単価12.50ドルと記載されています。パッキングリストには2,000個、50個入りカートン40箱と記載されています。BOLにはカートン40箱と記載されています。これらの数値が一致しない場合、税関ブローカーはどの書類を信頼するか判断しなければなりません。3つの書類すべてを読み取る抽出ツールは、単一の照合列で不一致をフラグできます。
パッキングリストの形式は驚くほど多様です。メーカーのパッキングリストは、コンテナあたり50行の品目がある複数ページのExcelエクスポートの場合があります。フォワーダーのハウスパッキングリストは、同じ情報を商品ごとに1行にまとめる場合があります。混載コンテナのパッキングリストは、複数の注文書を1つのコンテナにマッピングする必要があります。これは、明細行の境界がPOの境界をまたぐため、従来のOCRツールでは困難な形式です。
商業送り状 — 税関評価書類
商業送り状は、税関が関税や税金を評価するために使用する書類です。梱包明細書(物理的な貨物に焦点を当てる)や船荷証券(運送に焦点を当てる)とは異なり、商業送り状は価値に関するものです。つまり、何が、いくらで、どのような取引条件で、どこで原産されたかが記載されます。
項目構成は標準的な売上請求書に近いですが、国際取引に特化した追加項目があります。
- 売り手と買い手 — 名称と住所(第三者物流業者が関与する場合、船荷証券の荷送人/荷受人と異なることがあります)
- 送り状番号と日付 — 輸出者の参照番号で、梱包明細書と相互参照されることが多い
- 出荷参照情報 — 注文番号、船荷証券番号、コンテナ番号、ブッキング番号
- 明細行 — 品名、HSコード、数量、単価、行ごとの合計金額
- インコタームズ — 運送料、保険料、関税の支払い責任者を決定する取引条件(FOB上海、CIFロッテルダム、EXW工場渡し、DDP買い手倉庫渡し)
- 原産国 — 商品が製造された国、または実質的な加工が行われた国
- 申告総額 — 関税計算の基準
- 通貨と支払条件 — USD、EUR、JPY;Net 30、T/T、L/C
商業送り状からのHSコード抽出は特に注意が必要です。なぜなら、これが誤っていると税関手続きの遅延を引き起こす最も可能性の高い項目だからです。6桁のHSコード(国際統一システムの最小単位)は、製品を特定の類、項、号に分類します。HSコードが誤っていると、誤った関税率が適用されたり、さらに悪い場合には、コードが品名と一致しないために貨物が検査対象としてフラグが立てられる可能性があります。HSコードを単なる英数字フィールドとして扱う抽出ツールは、WCO分類の最初の6桁に対して検証する機会を逃しています。HSコードのパターン(XXXX.XXまたはXXXXXX.XX)を認識し、それを商品の品名と相互検証する意味論的な抽出設定は、税関ブローカーが確認する前にこの問題を捕捉します。
商業送り状には、書類間で最も重要な参照フィールドであるインコタームも含まれています。インコタームは、船荷証券上の運送料が前払いか着払いか、誰が保険を手配するか、そして売り手から買い手へのリスクの移転地点を決定します。商業送り状から「FOB上海」を読み取り、船荷証券から「運送料着払い」を読み取りながら、その矛盾(ほとんどの運送会社の解釈ではFOBは着払い)をフラグ付けしない抽出は、税関で時間を浪費する調整を見逃すことになります。
運送請求書と配送ラベル
さらに2つの書類が輸送書類一式を構成します。
運送請求書(フレートインボイス)は、運送会社による輸送サービスの請求書です。B/L番号とコンテナ番号を参照し、運賃、燃料サーチャージ、シャーシレンタル料、留置料、滞船料、集荷・配送料、付帯サービス料などの項目を明細化します。運送請求書の抽出における課題は、請求額を読み取ることではなく、各請求を正しいB/Lに照合し、契約上合意されたものかを確認することです。運送会社が、依頼されていないリフトゲートサービスに対して250ドルを請求する場合があります。運送請求書の抽出では、APチームがレート確認書や予約情報と照合できるよう、十分な参照データ(B/L番号、コンテナ番号、日付)を保持する必要があります。抽出設定に計算列を追加し、運賃額を既知の契約レートと比較して5%以上の差異をフラグ付けすることで、受動的な抽出結果を能動的な監査ツールに変えることができます。
配送ラベルは、ラストマイルの接点です。運送会社が印刷したラベルには、追跡番号、バーコード、送り主と受取人の住所、サービスレベル、荷物重量、参照フィールドが含まれます。当社の配送ラベルとマニフェスト抽出の記事では、サーマルラベル、インクジェットラベル、手書き修正のフィールド別精度を詳しく解説しています。パケット抽出の重要なポイントは、配送ラベルの追跡番号がB/L番号またはマニフェストの相互参照に解決されることです。解決されない場合、配送のラストマイル追跡が途切れます。
完全な輸送書類のバッチ処理
単一のB/Lや梱包明細書を読み取ることは基本です。効率性の向上は、輸送書類一式(5つ以上の書類)を1回の操作でバッチ処理し、文書間のフィールドを同じ出力列にマッピングすることから得られます。
典型的な輸送書類のバッチ処理ワークフローは次のとおりです。
重量一致?列、または個数カウントを相互参照する数量一致?列などです。結果は単なる抽出データではなく、事前監査済みの船積み記録です。このワークフローは、バッチファースト処理のために設計されたものです:5〜15枚の書類からなる混在形式のパケットをアップロードし、列スキーマを一度定義すれば、検証済みで相互参照されたデータを含む単一の出力テーブルが得られます。キャリアごとのテンプレート設定も、書類タイプごとの再構成も不要です。
ファイルは安全に処理され、保存されることはありません。
フィールド検証 — 生テキストからTMS対応データへ
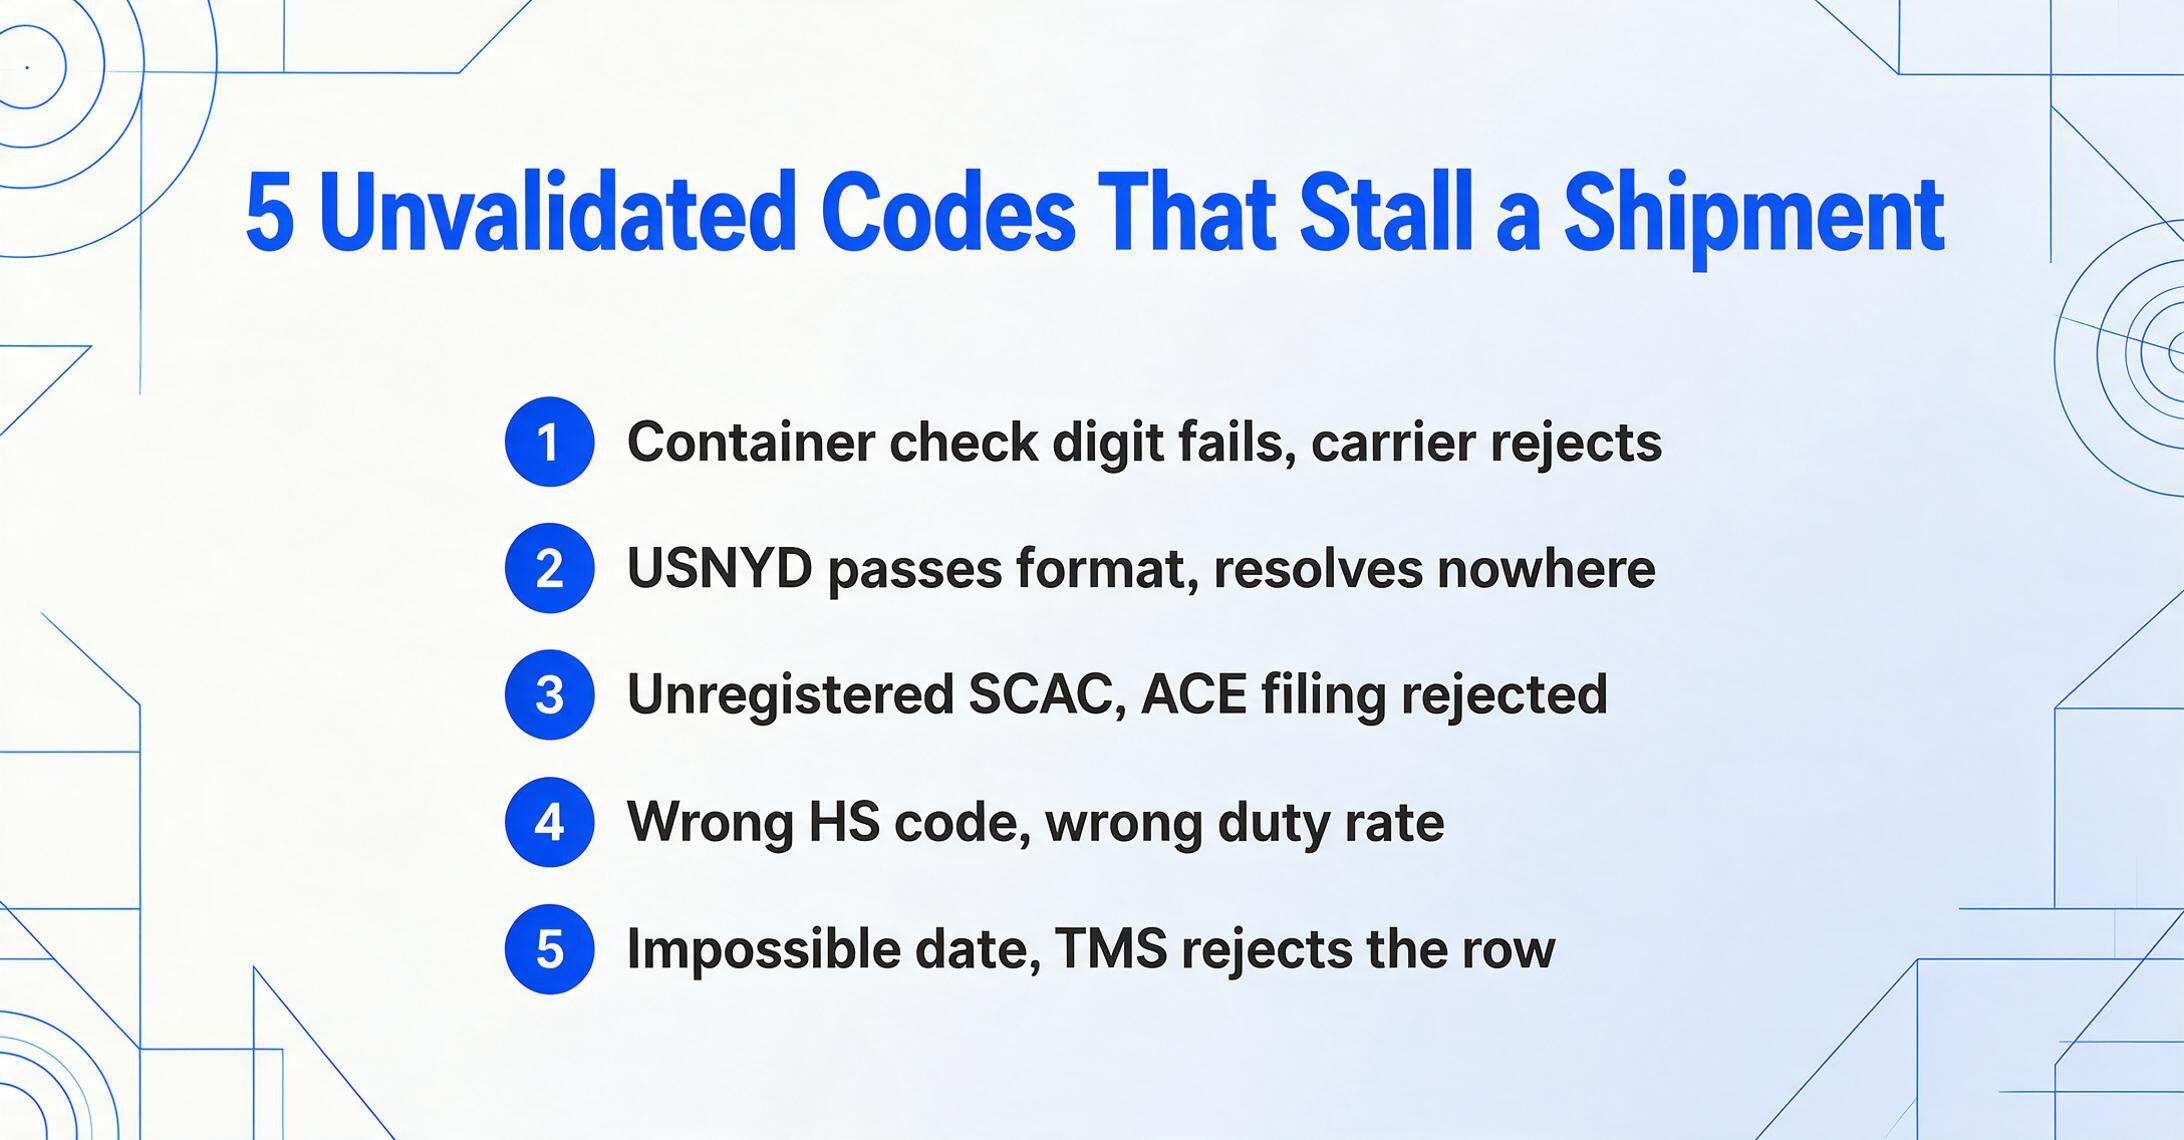
有用な抽出結果と単なるテキスト出力の違いは、検証レイヤーにあります。輸送書類は組み込みの検証ルールを持つコード体系を使用しており、これらのルールを適用する抽出ツールは、TMSや税関申告に到達する前にエラーを検出できます。
| コード体系 | フォーマットパターン | 検証ルール | 誤りがあった場合の影響 |
|---|---|---|---|
| コンテナ番号(ISO 6346) | AAAA-NNNNNN-N英字4文字、数字6桁、チェックデジット1桁 | チェックデジットアルゴリズム:オーナーコード×位置重み、mod 11 | 運送会社の追跡システムが番号を拒否。3日間「コンテナが見つからない」状態となり、その間誰かが正しい数字を再入力する |
| UN/LOCODE | XX-YYY国コード2文字+地点コード3文字 | 国コードはISO 3166準拠、地点コードはUNECEマスターデータベースに存在する必要あり | "USNYC"は解決されるが、"USNYD"(文字入れ替え)はフォーマットチェックは通るものの、別の地点に解決されるか、まったく解決されない |
| SCACコード | AAAA英大文字2~4文字 | NMFTAに登録済みであること。アクティブな運送会社データベースと照合 | ACE eManifest申請が却下。CBPシステムで運送会社を特定できない |
| HSコード(統一システム) | XXXX.XX または XXXX.XX.XXXX | 最初の6桁はWCO分類に一致。7~10桁目は国別 | 誤った関税率が適用。税関検査が発生。貨物は再分類のため保留 |
| 日付(各種形式) | 06/30/2026、30-JUN-2026、2026-06-30 | ISO 8601に正規化。ありえない日付(月>12、出発日が未来など)を検出 | TMSが日付フィールドを拒否。日付形式の修正中に貨物のリリースが遅延 |
抽出時にこれらのルールを適用する検証パイプラインは、単にエラーを検出するだけではありません。手動でのクリーンアップを必要とせず、下流システムでそのまま使用できるデータセットを構築します。ISO 6346のチェックデジット検証を通過したコンテナ番号は、運送会社の追跡APIに直接送信できます。UNECEルックアップを通過したUN/LOCODEは、TMSのルーティングテーブルに読み込めます。商品説明と一致するHSコードは、自信を持って税関に提出できます。
検証なしでは、抽出は一見正しく見える生テキストのスプレッドシートを生成します。しかし、7桁目と11桁目が入れ替わっていたために運送会社の追跡APIが「コンテナが見つからない」と返すまで、その誤りに気づきません。この遅延により、1日あたり100~500ドルのデマレージ(延滞料)が発生します。これが、コスト削減につながる抽出と、別の種類のコストを生み出す抽出との違いです。
エクスポート戦略 — 最終スプレッドシートに含まれるもの
データが利用可能な形式になるまで、輸送書類の抽出は完了しません。出力戦略は、誰が使用するか、どのシステムに供給するかによって異なります。
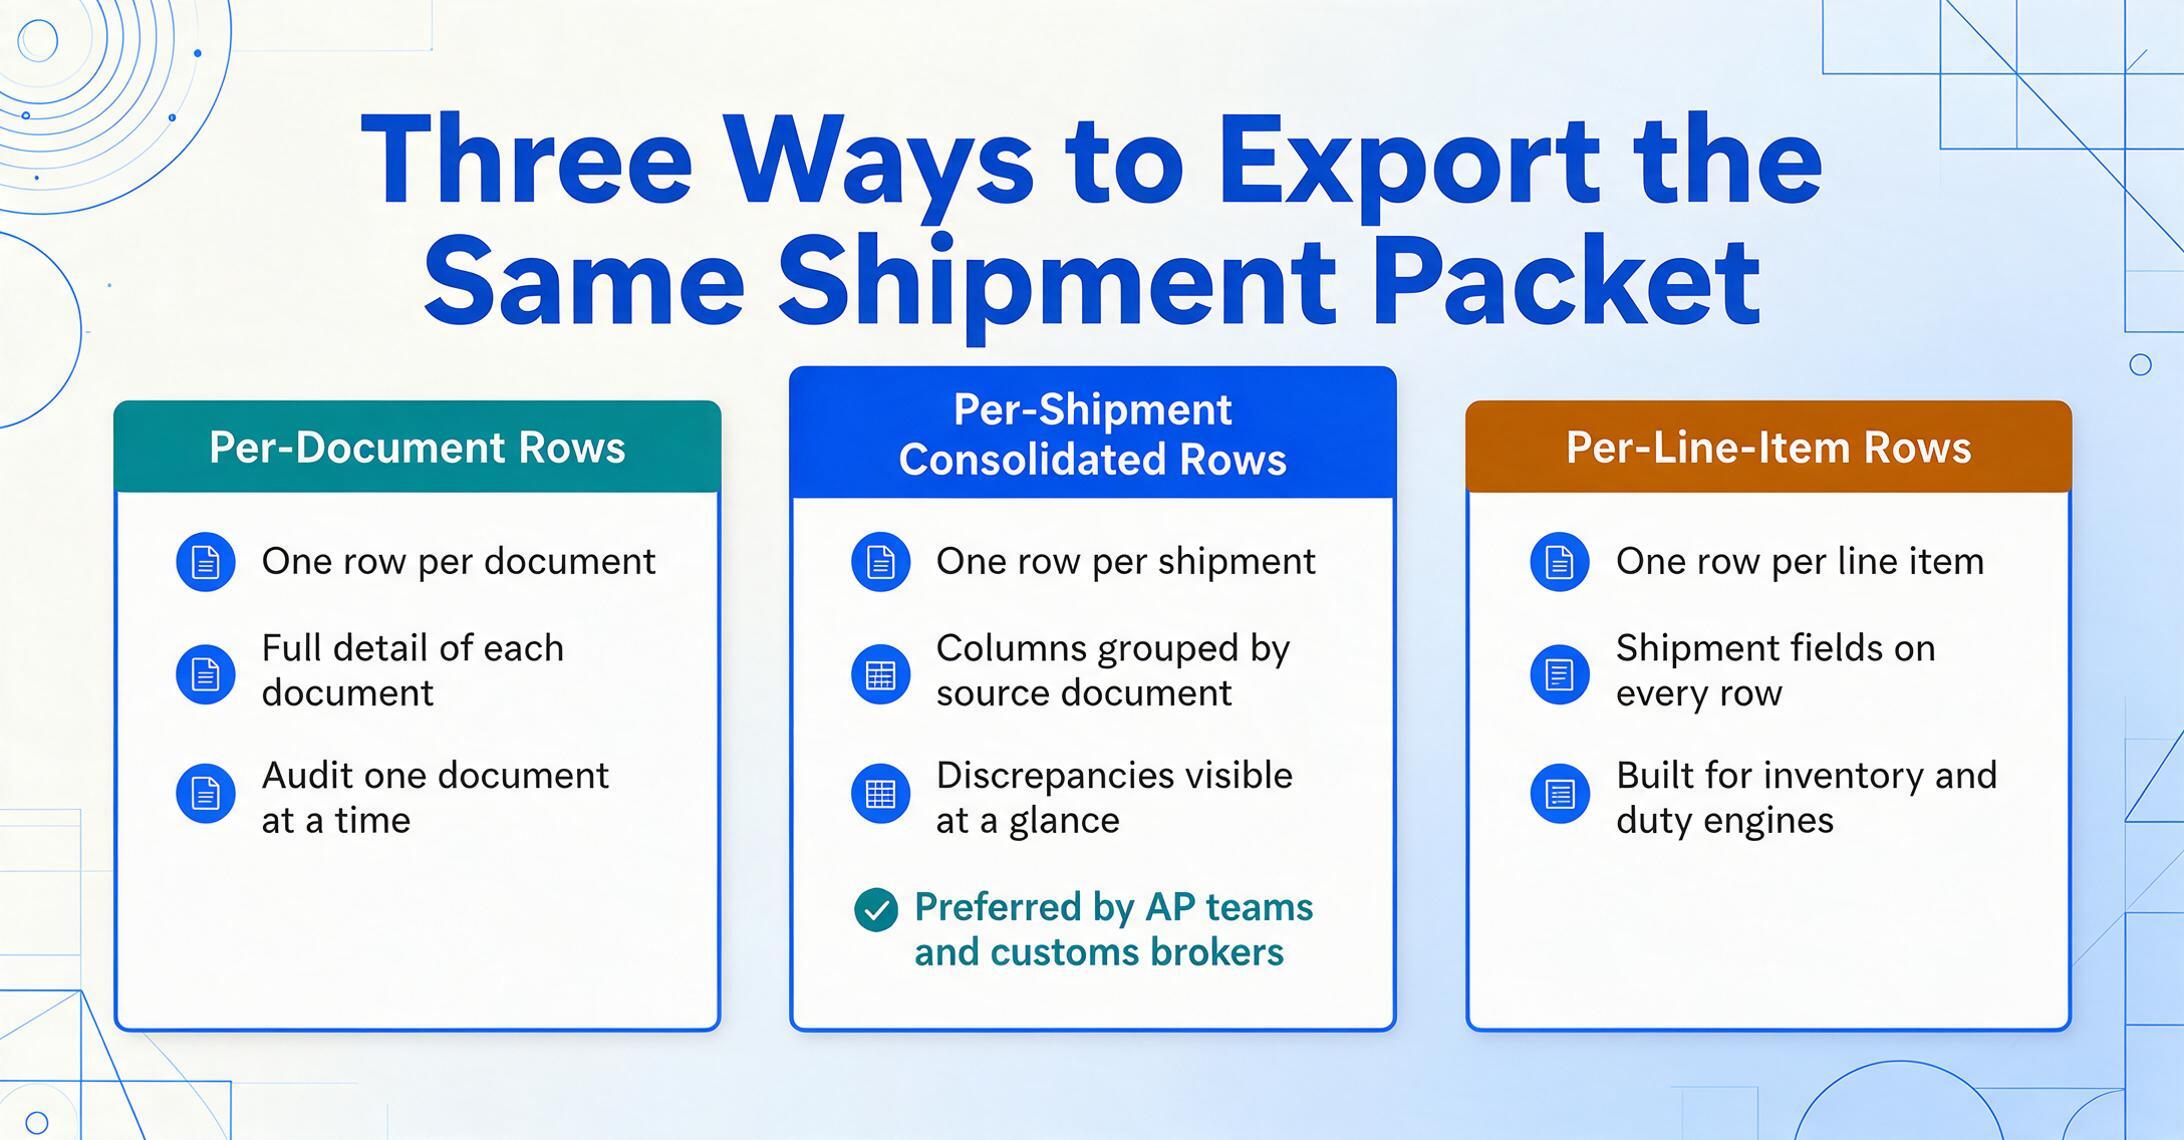
書類ごとの行。パケット内の各書類が1つの出力行を生成します。B/L(船荷証券)の行には、B/Lのすべてのフィールドが含まれます。パッキングリストの行には、パッキングリストのすべてのフィールドが含まれます。これにより、各書類の完全な詳細が保持されますが、行間での手動クロスリファレンスが必要です。各書類を個別に監査する必要があるチームに最適です。
出荷ごとの統合行。出荷ごとに1行で、列はソース書類ごとにグループ化されます: BOL_Container_Number、Manifest_Container_Number、PL_Container_Number、その後に照合列が続きます。これは、APチームと通関業者が好む形式です — 出荷のすべてのデータが1か所にあり、差異が一目で確認できます。
明細項目ごとの行。パッキングリストまたは商業送り状の明細項目ごとに1行で、出荷レベルのフィールド(コンテナ番号、B/L番号、港コード)が各行に繰り返されます。これは、品目レベルの詳細を必要とする在庫管理システムや関税計算エンジン向けの形式です。
ImageToTable.aiは、バッチ処理パイプラインを介してこれら3つの出力形式すべてをサポートしています。エクスポートトークンシステムを使用すると、Excelファイルをオンデマンドで生成し、アカウントを持たないチームメンバーと共有できます — 受信者はリンクを開いて出力をダウンロードします。これは、クライアントにツール自体へのアクセスを許可せずに、出荷データをクライアントと共有する必要があるフォワーダーにとって特に便利です。
運送書類抽出におけるよくある落とし穴
正しいアプローチを取っていても、運送書類の抽出には、自動処理に不慣れな物流チームを陥れる罠があります。
すべてのBOLを同一の書類として扱うこと。 ストレートBOL、オーシャンBOL、マルチモーダルBOL、ハウスBOL、マスターボルは同じ名前を共有していますが、フィールド構造と法的効力が異なります。ストレートBOL(荷主1社、荷受人1社、単純な経路)で機能する抽出設定では、ハウスBOLのHBL参照番号やマルチモーダルBOLの継続運送条件を見落とします。解決策は、遭遇する最も複雑な書類タイプに合わせて列スキーマを設計し、より単純な書類では入力されるフィールドを少なくすることです。
連結レイヤーを無視すること。 フォワーダーが5社の荷主からの貨物を1つのコンテナに連結する場合、パッキングリストは単一の書類ではなく、荷主レベルのパッキングリストと連結マニフェストの集合体です。抽出設定は、コンテナ MSCU 234781 6 に5社の輸出業者からの15件の個別の発注書が含まれ、それぞれに独自のPO番号、HSコード、原産国があることを理解する必要があります。コンテナごとに1行を出力するツールでは、税関が要求する品目レベルの詳細がすべて欠落します。
重量の正規化をスキップすること。 BOLには15,420 KGSと表示されているかもしれません。マニフェストには34,000 LBSと表示されています。パッキングリストには340 CWT(ハンドレッドウェイト)と表示されています。これらは異なる単位での同じ重量ですが、生のテキスト抽出では3つの異なる数値として出力されます。すべての重量を単一の単位(キログラム)に正規化し、(単位換算後の)実際の不一致をフラグする計算列は、重量関連の税関保留や運送会社の請求書紛争を防ぎます。
抽出時にコードを検証しないこと。 無効なコンテナチェックディジット、存在しないUN/LOCODE、または不一致のHSコードは、抽出時に検出されれば修正コストはかかりません。同じエラーが48時間後に検出された場合 — ISF申告が提出された後、貨物が積み込まれた後 — 米国CBP規制(19 CFR 149.3)に基づき、$5,000の修正罰金が発生します。リアルタイム検証のない抽出は抽出ではなく、高速なタイピングに過ぎません。
よくある質問
1つの抽出ツールで、すべての種類の船積書類(BOL、マニフェスト、パッキングリスト、商業送り状)を処理できますか?
はい、ただしツールがテンプレートベースのOCRではなく、セマンティック抽出を使用している場合に限ります。テンプレートツールでは、書類の種類とキャリアのフォーマットごとに個別の設定が必要であり、50以上のテンプレートを管理することになります。セマンティック抽出は、フィールドの位置ではなく意味に基づいて識別するため、「コンテナ番号」という同じ列定義が、フォーマットごとの設定なしに、マースクのBOL、MSCのマニフェスト、荷主のパッキングリストで機能します。重要な前提条件は、ツールのAIモデルが物流書類で学習されていることです。請求書のみで学習された汎用的な書類抽出モデルでは、SCACコードやコンテナ番号のパターンを見逃します。
レイアウトが異なる複数のキャリアの書類をどのように処理しますか?
セマンティックAI抽出により、キャリアごとのテンプレート問題は完全に解消されます。各キャリア(マースク、MSC、CMA CGM、COSCO、ハパックロイド)のBOLにバウンディングボックスを描く代わりに、「コンテナ番号」「積出港」「SCACコード」といったフィールドの意味で列を定義します。AIは、船積書類上のフィールドラベルとデータ値の意味的な関係を理解することで、あらゆるキャリアのレイアウト上の各値を特定します。キャリアが帳票を再設計しても、テンプレートを更新することなく抽出は新しいレイアウトで機能します。
AIは手書きのパッキングリストやBOLの手書きフィールドを読み取れますか?
最新のビジョンAIは、適切な品質の画像に対して85~95%の精度で手書き文字を読み取ります。これは、同じ手書き入力に対する従来のOCRの50~70%の範囲よりも大幅に高い精度です。ただし、精度はフィールドの種類によって異なります。構造化された手書きの数字(個数、重量、日付)は、筆記体の荷受人名よりも信頼性が高くなります。特に船積書類では、パッキングリストの手書きの荷印や、BOLの手書きの個数修正が最も一般的な手書き文字の課題であり、これらはキャリアの請求書紛争の原因となるフィールドであるため、正確に処理することが最も重要です。実用的なアプローチは、信頼度スコアが低い手書きフィールドを盲目的に信頼するのではなく、手動レビュー用にフラグを立てることです。
5ページの海上BOLのように、明細が2~4ページにまたがる複数ページの書類はどのように処理しますか?
適切に設計された抽出パイプラインは、複数ページの書類を1つの論理単位として扱います。AIは全ページを順次読み取り、出荷レベルのコンテキスト(1ページ目のBOL番号、荷主、船名)を明細ページに引き継ぎます。2ページ目から始まり3~4ページに続く貨物記述テーブルは、4つの個別の抽出ジョブに分割されることなく、1つの出力ブロックに統合されます。これには、書類とページの関係を理解するツールが必要です。これはすべての抽出ツールがサポートする機能ではなく、物流チームがBOLに請求書向けツールを使用する際の主な失敗要因の1つです。
運送書類抽出の標準的な出力形式は、Excel、CSV、JSONのどれですか?
物流チームにとって最も一般的な出力形式はExcel(.xlsx)です。計算列(照合数式)、複数シートのワークブック(書類タイプごとに1シート)をサポートし、ほとんどのTMSやERPシステムに直接インポートできるためです。CSVは軽量な代替形式で、EDIフィードやレガシーシステムへのインポートに適しています。JSONは、抽出データがAPIやカスタムアプリケーションに供給される場合に推奨されます。最適な抽出ツールは3つの形式すべてをサポートし、バッチごとに選択できます。このガイドで説明する出荷単位のワークフローでは、計算照合列を含むExcelが推奨形式です。
抽出時にコンテナ番号を検証するにはどうすればよいですか?
コンテナ番号はISO 6346形式に従います。大文字4文字(所有者コード+カテゴリ識別子)の後に7桁の数字が続き、7桁目は特定のアルゴリズムで計算されたチェックデジットです。検証パイプラインは、抽出されたすべてのコンテナ番号にチェックデジットアルゴリズムを適用します。計算されたチェックデジットが抽出されたチェックデジットと一致しない場合、その値は検証警告付きでフラグが立てられます。これにより、最も一般的なコンテナ番号入力エラー(数字の転記ミス)がTMSに到達する前に捕捉されます。チェックデジット検証に合格したコンテナ番号が正しいとは限りません(誤った所有者コードでも有効なチェックデジットが存在する可能性があります)が、入力エラーの95%以上を排除できます。
再現可能な輸送書類ワークフローの構築
輸送書類の抽出は、一度きりのデジタル化プロジェクトではありません。毎日繰り返される運用プロセスです。毎日、B/L(船荷証券)、マニフェスト、パッキングリスト、商業送り状、運賃請求書がPDFや画像として届き、そのデータは手作業による入力なしでTMS、通関業者、APシステムに届ける必要があります。機能する抽出と、新たな作業を生み出す抽出の違いは、ツールが書類一式をまとめて処理できるかどうかです。つまり、文書間のフィールドマッピング、コード検証、バッチエクスポートを備えているか、それとも各書類タイプを個別に抽出し、結果を手作業で結合しなければならないか、という違いです。
B/Lを読んで止まってしまうツールは、マニフェストもパッキングリストも文書間の照合も行わず、1枚の書類を読んだにすぎません。貨物を処理したことにはなりません。完全な抽出は、書類一式を捕捉し、共通フィールドを検証し、不一致がすでにフラグ付けされ、コードがすでに標準化されたデータセットを出力します。それが、書類を読むだけのツールと、輸送書類ワークフローの違いです。