Guía completa de
Extracción de documentos de envío y carga
Un solo envío transfronterizo genera un paquete de cinco a siete documentos: un conocimiento de embarque, un manifiesto de carga, una lista de empaque, una factura comercial, un certificado de origen, una factura de flete y, a veces, una prueba de entrega. Cada documento fue diseñado por una parte distinta (transportista, agente de carga, almacén, exportador) para un propósito distinto (contrato de transporte, inventario de carga, valoración aduanera, facturación). Sin embargo, al momento de la extracción, sus datos deben coincidir: el número de piezas en la lista de empaque debe coincidir con el número de piezas en el B/L, el código SH en la factura comercial debe coincidir con lo que declara el manifiesto, y el número del contêiner en cada documento del paquete debe ser idéntico. Este es el desafío fundamental de la extracción de documentos de envío: no leer un solo documento, sino leerlos todos juntos para que sus campos compartidos coincidan. Esta guía cubre qué contiene cada documento de envío, dónde se superponen sus datos con los demás y cómo extraer el paquete completo en un solo conjunto de datos unificado.
Conclusiones clave
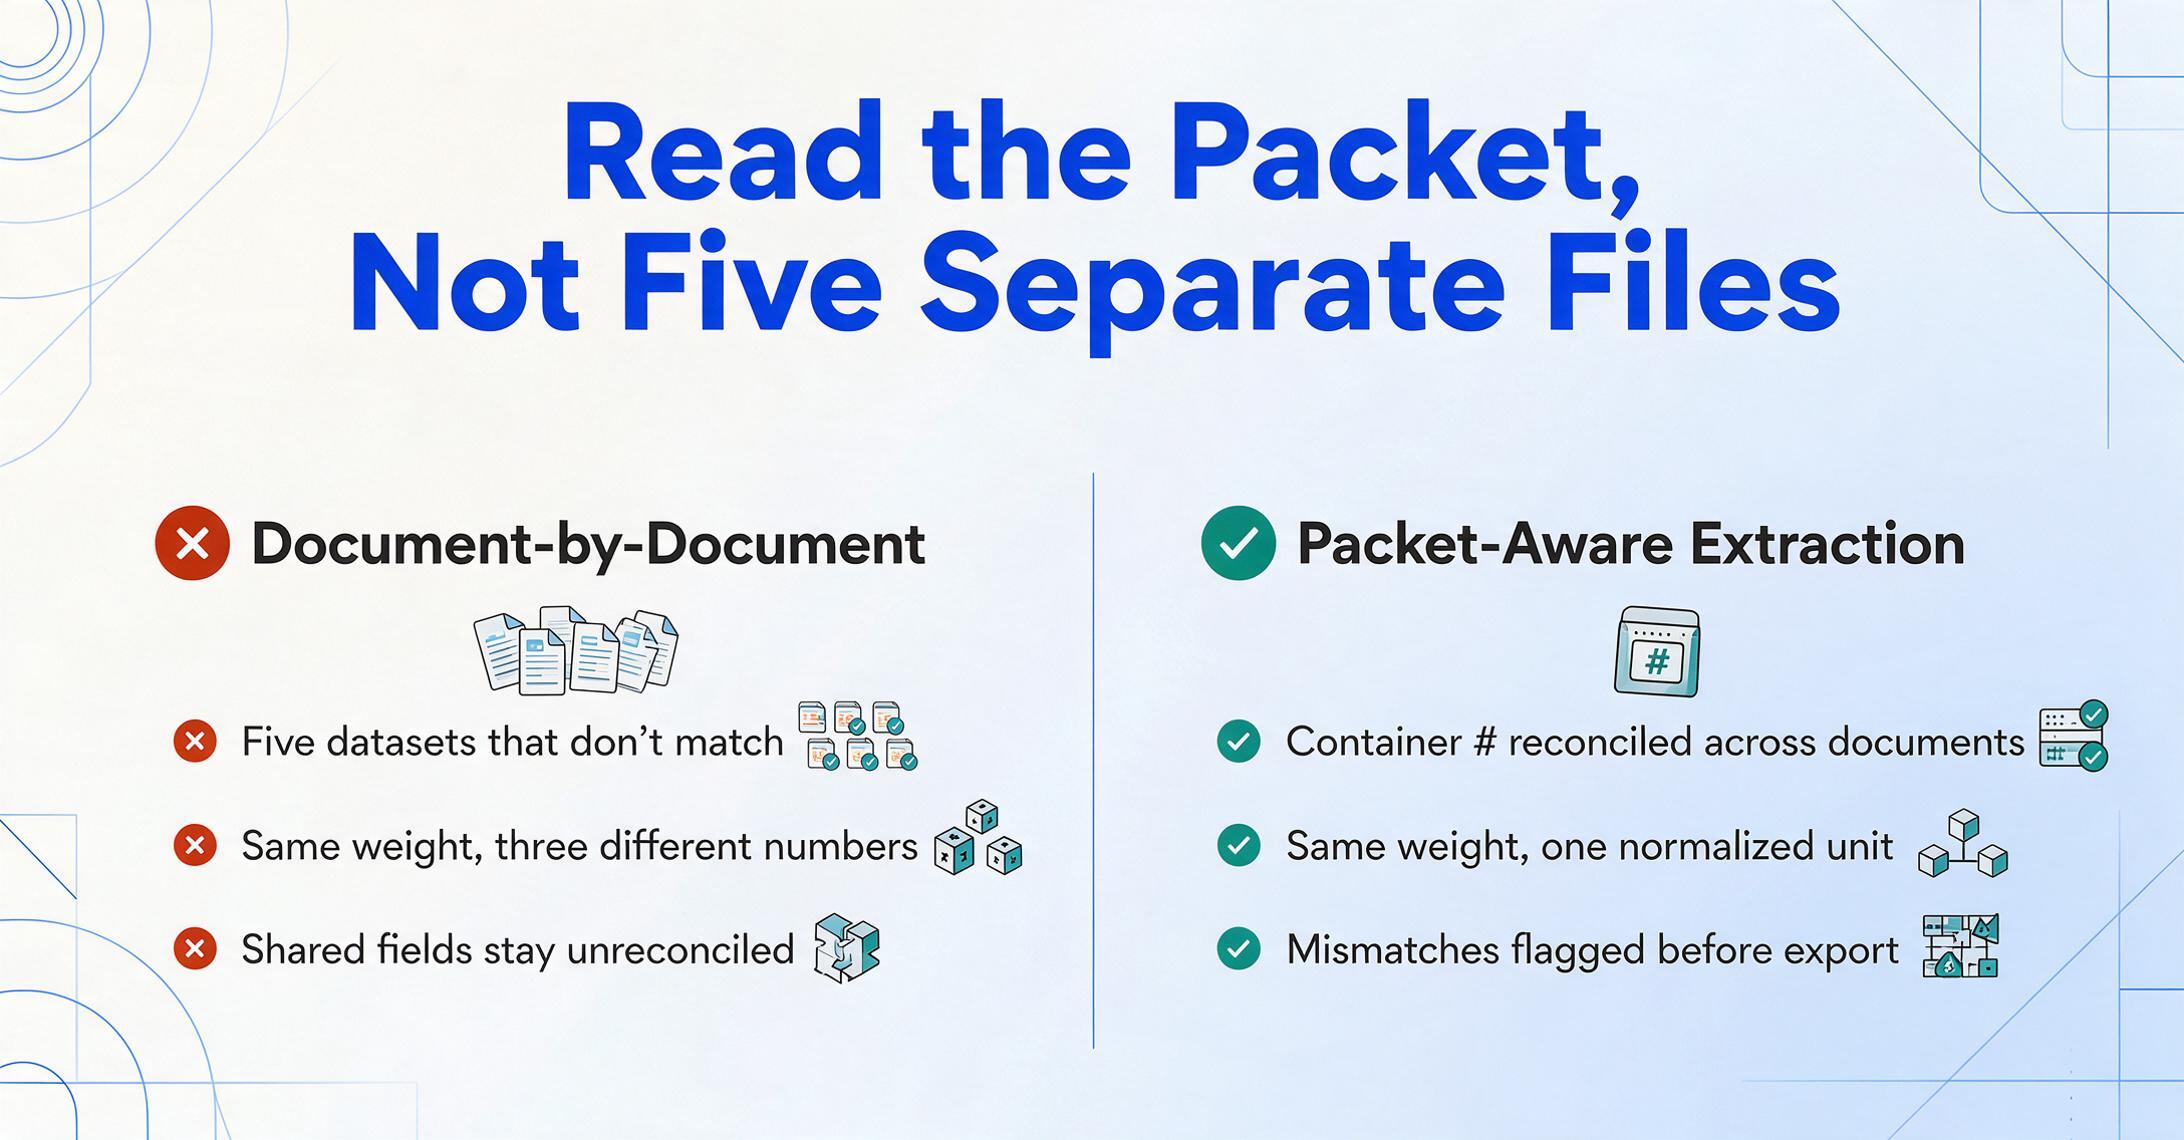
- Cada envío transfronterizo genera de cinco a siete documentos de cinco partes distintas, y el número del contêiner, el peso y el número de piezas deben coincidir en todos ellos.
- Rara vez coinciden en la extracción en bruto, porque el B/L registra el peso en kilogramos, el manifiesto en libras y la lista de empaque en quintales: la misma carga, tres números diferentes, y una discrepancia que cuesta $5,000 en multas por enmienda aduanera si se detecta tarde.
- Procese el paquete completo de documentos en un solo lote con una única definición de columnas, y la IA normaliza los campos compartidos, concilia los valores entre documentos y señala las discrepancias, antes de que su agente de aduanas presente la declaración.
O Ecossistema de Documentos de Embarque — Cinco Documentos, Um Embarque
Antes de iniciar a extração, a equipe de logística precisa de um mapa do que está extraindo e de como os documentos se relacionam. Um embarque marítimo típico de FCL (Full Container Load) gera estes cinco documentos principais:
| Documento | Emitido Por | Finalidade Principal | Campos Compartilhados Principais |
|---|---|---|---|
| Bill of Lading (BOL) | Transportadora ou agente de carga | Contrato de transporte + título de propriedade | Nº do contêiner, códigos de porto, embarcador/consignatário, peso, quantidade de peças |
| Manifesto de Carga | Transportadora ou agente do navio | Inventário completo da carga para a viagem | Nº do B/L, nº do contêiner, código SH, massa bruta, quantidade de pacotes |
| Lista de Embalagem | Embarcador / exportador | Detalhamento item a item da carga | Nº do contêiner, nº do PO, descrição do item, quantidade, peso líquido/bruto, dimensões |
| Fatura Comercial | Exportador / vendedor | Valoração aduaneira + registro de pagamento | Código SH, Incoterms, valor total, país de origem, referência do embarque |
| Fatura de Frete | Transportadora | Cobrança pelos serviços de transporte | Nº do B/L, nº do contêiner, encargos, acessórios, condições de pagamento |
O problema dos campos compartilhados fica visível imediatamente: o número do contêiner aparece no B/L, no manifesto, na lista de embalagem e na fatura de frete. O número do B/L vincula o manifesto, a fatura comercial e a fatura de frete. O peso bruto é declarado no B/L, no manifesto e na lista de embalagem — mas raramente na mesma unidade (o B/L pode mostrar quilogramas, a lista de embalagem libras e o manifesto toneladas métricas). Um processo de extração que lê cada documento isoladamente produz cinco conjuntos de dados que não se correspondem. Um processo de extração projetado para o pacote de embarque os lê em conjunto e sinaliza as discrepâncias.
Para uma análise mais aprofundada de como a extração semântica com IA trata esses documentos de forma diferente do OCR tradicional, consulte nosso guia de OCR para logística e os fundamentos do que é OCR com IA.
Bills of Lading — O Documento Mestre
O conhecimento de embarque é o documento mais complexo juridicamente no pacote de remessa. Ele é simultaneamente um recibo de mercadorias, um contrato de transporte e — em sua forma negociável — um documento de título. Somente a contagem de campos explica por que a extração aqui não é trivial: um B/L oceânico típico carrega 30-40 campos de dados distribuídos em 3-5 páginas, regidos por múltiplos padrões internacionais.
Publicamos um guia completo dedicado à extração de dados de B/L que cobre tipos de B/L (direto vs oceânico vs multimodal, master vs house), pipelines de extração e validação em profundidade total, e um passo a passo detalhado de extração de dados de B/L para Excel. Aqui, focamos no que importa para o pacote entre documentos: os campos que todos os outros documentos de remessa referenciam.
| Campo | Exemplo | Padrão de Validação | Também Aparece Em |
|---|---|---|---|
| Número do contêiner | MSCU 234781 6 | ISO 6346 — 4 letras + 7 dígitos, dígito verificador na posição 11 | Manifesto, lista de embalagem, fatura de frete |
| Número do lacre | SH-789012 | Sem padrão global; atribuído pela transportadora/terminal | Manifesto, lista de embalagem |
| Porto de Embarque / Descarga | CN SHA / NL RTM | UN/LOCODE — 5 caracteres (2 país + 3 localidade) | Manifesto, fatura comercial (seção de roteamento) |
| Código SCAC | MAEU (Maersk) | NMFTA — identificador de transportadora de 2-4 letras | Manifesto (se arquivamento ACE com destino aos EUA) |
| Peso bruto | 15.420 KGS | VGM (massa bruta verificada) conforme SOLAS Capítulo VI Reg 2 | Manifesto, lista de embalagem |
| Contagem de peças / Tipo de embalagem | 500 CTNS em 10 PLTs | NMFC / prática do setor | Manifesto, lista de embalagem |
| Código SH (mercadoria) | 6305.33 | OMA (Organização Mundial das Aduanas) — mínimo de 6 dígitos, 10 dígitos para importações nos EUA | Fatura comercial, manifesto |
O código SCAC merece uma análise mais detalhada porque é o campo mais comumente extraído incorretamente na logística. Um B/L pode imprimir o nome da transportadora como "Maersk Line" enquanto o TMS espera MAEU. Outra transportadora pode listar seu nome junto a um SCAC que parece um número de referência. A extração com IA semântica lida com isso reconhecendo o padrão de código padrão (2-4 letras maiúsculas, frequentemente próximas ao nome da transportadora ou a um rótulo SCAC) e extraindo-o como um campo separado do nome completo da transportadora — mas nem todas as ferramentas de extração são projetadas para procurar códigos SCAC. Muitas tratam o campo da transportadora como texto livre e geram "Maersk Line" quando o sistema precisava de MAEU.
Para uma análise detalhada da precisão em nível de campo em etiquetas de remessa e seus pontos de dados, consulte nosso artigo complementar A IA consegue extrair dados de etiquetas de remessa e manifestos?
Manifestos de Carga — O Inventário em Nível de Embarque
Um manifesto de carga é uma lista completa de todos os embarques carregados em um meio de transporte — navio, caminhão, aeronave ou trem. Diferentemente do BOL, que é um contrato de embarque único, o manifesto é um inventário de múltiplos embarques usado principalmente por autoridades aduaneiras, operadores portuários e terminais.
Um manifesto marítimo normalmente contém uma linha por BOL no navio, com estas colunas principais:
- Número do Master BOL — o BOL emitido pela transportadora que cobre o embarque consolidado
- Número(s) do House BOL — BOLs emitidos pelo forwarder para cada embarcador subjacente, se aplicável
- Número(s) do contêiner — todos os contêineres associados a cada BOL
- Descrição da mercadoria — geralmente abreviada ou agrupada (ex.: "Mercadorias Gerais de Loja de Departamento" para um contêiner consolidado)
- Código SH — classificação de 6 a 10 dígitos para a alfândega
- Peso bruto e volume — total por BOL
- Porto de embarque e porto de descarga — no formato UN/LOCODE
- Embarcador e consignatário — nomes e endereços
- Nome do navio e número da viagem — para manifestos marítimos
O desafio de formato com manifestos é que eles vêm em duas estruturas fundamentalmente diferentes. Manifestos ACE em conformidade com a CBP para embarques com destino aos EUA seguem o formato CBP 1301 (Manifesto de Carga de Entrada) ou CBP 1302 (Saída), com campos obrigatórios específicos para declarações ISF. Manifestos comerciais usados internamente por freight forwarders podem usar layouts completamente diferentes, agrupando campos por contêiner em vez de por BOL. Um manifesto de carga aérea (manifesto AWB) usa uma estrutura de cabeçalho diferente de um manifesto marítimo — número do voo em vez de nome do navio, MAWB/HAWB em vez de MBL/HBL.
O desafio de extração é que os dados do manifesto devem ser reconciliados com os dados do BOL no nível do contêiner. Se o manifesto diz que o contêiner MSCU 234781 6 transporta 500 caixas e o BOL diz 480, essa diferença de 20 caixas é um erro de entrada no manifesto ou um erro no BOL — e será sinalizada pela alfândega ou pelo receptor. A extração semântica que lê ambos os documentos e compara seus campos compartilhados durante o processamento detecta essa incompatibilidade antes que ela se torne uma retenção alfandegária.
Listas de Embalagem — O Detalhamento por Item
A lista de embalagem é o documento mais granular do pacote de embarque. Enquanto o BOL mostra o peso total e a contagem total de peças, a lista de embalagem detalha o que está dentro de cada pacote — caixa por caixa, palete por palete. Para embarques LCL (carga fracionada), a lista de embalagem é o documento que informa ao agente de carga como consolidar a carga de vários embarcadores.
Os campos padrão da lista de embalagem incluem:
| Grupo de Campos | Campos | Notas de Extração |
|---|---|---|
| Identificadores do embarque | Número da lista de embalagem, número do pedido, número da fatura, número do BOL, número do contêiner | O número do pedido é essencial — é a chave de referência cruzada que vincula a lista de embalagem ao pedido de compra e à fatura comercial |
| Informações das partes | Embarcador, consignatário, parte notificada, exportador | Deve coincidir com o BOL; discrepâncias sugerem uma alteração na instrução de encaminhamento durante o embarque |
| Detalhes do pacote | Marcas e números da caixa/palete, tipo de pacote (CTN, PLT, BNDL), número de pacotes | As marcas dos pacotes são frequentemente escritas à mão ou carimbadas — o campo com maior taxa de erro na extração da lista de embalagem |
| Detalhes do item | Descrição do item, código NCM, quantidade por pacote, unidade de medida (PCS, KGS, LBS), peso líquido, peso bruto por pacote | As descrições dos itens nas listas de embalagem são mais detalhadas do que nos BOLs — "Suéteres femininos de malha de algodão, cores sortidas" vs o "Suéteres Fem." abreviado do BOL |
| Dimensões | Comprimento × largura × altura por pacote, volume cúbico total | O formato varia muito: "48x40x36 pol" vs "120x100x90 cm" vs um único número de m³. O cálculo do peso dimensional (fator DIM 139 para doméstico nos EUA, 6000 para internacional) depende de acertar isso |
O papel da lista de embalagem como o documento de verdade no nível do item significa que ela é a âncora para uma das verificações entre documentos mais importantes no embarque: a reconciliação de quantidades. A fatura comercial indica 2.000 unidades a US$ 12,50 cada. A lista de embalagem indica 2.000 unidades em 40 caixas de 50. O BOL indica 40 caixas. Se algum desses números discordar, o despachante aduaneiro deve decidir em qual documento confiar — e uma ferramenta de extração que lê todos os três pode sinalizar a divergência em uma única coluna de reconciliação.
Os formatos das listas de embalagem são surpreendentemente variáveis. A lista de embalagem de um fabricante pode ser uma exportação de Excel com várias páginas e 50 itens por contêiner. A lista de embalagem doméstica de um agente de carga pode condensar a mesma informação em uma única linha por mercadoria. Uma lista de embalagem de contêiner consolidado deve mapear vários pedidos de compra em um único contêiner — um formato com o qual as ferramentas tradicionais de OCR têm dificuldade porque as bordas dos itens cruzam os limites dos pedidos.
Faturas Comerciais — O Documento de Valoração Aduaneira
A fatura comercial é o documento que as autoridades aduaneiras usam para avaliar impostos e taxas. Diferente do packing list (que foca na carga física) ou do conhecimento de embarque (que foca no transporte), a fatura comercial trata do valor: o que foi vendido, por quanto, sob quais termos comerciais e onde foi originado.
A estrutura de campos é semelhante a uma fatura de venda padrão, mas com acréscimos específicos do comércio internacional:
- Vendedor e comprador — nome e endereço (podem diferir do remetente/destinatário no conhecimento de embarque se houver um operador logístico terceirizado)
- Número e data da fatura — referência do exportador, frequentemente referenciada no packing list
- Referência do embarque — número do pedido, número do conhecimento de embarque, número do contêiner, número da reserva
- Itens da linha — descrição, código NCM, quantidade, preço unitário, valor total por linha
- Incoterms — o termo comercial (FOB Xangai, CIF Roterdã, EXW Fábrica, DDP Armazém do Comprador) que determina quem paga frete, seguro e impostos
- País de origem — onde as mercadorias foram fabricadas ou substancialmente transformadas
- Valor declarado total — a base para o cálculo dos tributos
- Moeda e condições de pagamento — USD, EUR, JPY; Net 30, T/T, L/C
A extração do código NCM em faturas comerciais merece atenção especial, pois é o campo que mais provoca atrasos alfandegários se estiver incorreto. Um código NCM de seis dígitos (o mínimo no Sistema Harmonizado) classifica um produto em um capítulo, posição e subposição específicos. Um código NCM incorreto pode resultar na aplicação da alíquota errada — ou pior, as mercadorias podem ser sinalizadas para inspeção porque o código não corresponde à descrição. Ferramentas de extração que tratam o código NCM como um campo alfanumérico genérico perdem a oportunidade de validá-lo contra os primeiros seis dígitos da classificação da OMA. Uma configuração de extração semântica que conhece o padrão do código NCM (XXXX.XX ou XXXXXX.XX) e o valida cruzadamente com a descrição da mercadoria detecta isso antes que o despachante aduaneiro veja.
A fatura comercial também carrega o campo de referência cruzada mais importante entre documentos: o Incoterm. O Incoterm determina se as despesas de frete são pré-pagas ou a pagar no conhecimento de embarque, quem contrata o seguro e onde o risco é transferido do vendedor para o comprador. Uma extração que lê "FOB Xangai" da fatura comercial e "Frete a Pagar" do conhecimento de embarque sem sinalizar a inconsistência (FOB é a pagar na maioria das interpretações das transportadoras) perde uma reconciliação que custa tempo na alfândega.
Faturas de Frete e Etiquetas de Envio
Dois documentos adicionais completam o pacote de embarque.
Faturas de frete são a cobrança da transportadora pelos serviços de transporte. Elas referenciam o número do B/L e o número do contêiner e detalham os encargos: tarifa de transporte principal, sobretaxa de combustível, aluguel de chassis, estadia, sobrestadia, taxas de coleta e entrega e acessórios. O desafio de extração com faturas de frete não é ler os encargos — é associar cada encargo ao B/L correto e verificar se foi contratualmente acordado. Uma transportadora pode cobrar US$ 250 por um serviço de elevador de caçamba que não foi solicitado. A extração da fatura de frete deve preservar dados de referência suficientes (número do B/L, número do contêiner, datas) para permitir que a equipe de contas a pagar faça a verificação cruzada com a confirmação de tarifa ou reserva. Uma coluna calculada na configuração de extração — comparando o encargo de transporte principal com uma tarifa contratual conhecida e sinalizando qualquer variação acima de 5% — transforma uma saída de extração passiva em uma ferramenta de auditoria ativa.
Etiquetas de envio são o ponto de contato da última milha. Uma etiqueta impressa pela transportadora contém número de rastreamento, código de barras, endereços de remetente e destinatário, nível de serviço, peso do pacote e campos de referência. Nosso artigo sobre extração de etiquetas de envio e manifestos detalha as taxas de precisão campo a campo para etiquetas térmicas vs etiquetas a jato de tinta vs correções manuscritas. O ponto-chave para a extração do pacote é que o número de rastreamento na etiqueta de envio deve corresponder ao número do B/L ou a uma referência cruzada no manifesto. Quando isso não acontece, o rastreamento da última milha da remessa falha.
Processamento em Lote do Pacote de Embarque Completo
Ler um único B/L ou lista de embalagem é o básico. O ganho de eficiência vem do processamento em lote do pacote de documentos de uma remessa completa — todos os cinco (ou mais) documentos — em uma única operação, com campos entre documentos mapeados para as mesmas colunas de saída.
Veja como um fluxo de trabalho típico de processamento em lote de pacote de embarque se parece:
Peso confere? que compara o peso bruto do B/L com o do packing list, ou uma coluna Qtd. confere? que cruza as contagens de peças. O resultado não é apenas dado extraído — é um registro de remessa pré-auditado.Este fluxo de trabalho é o que o Processamento Prioritário em Lote foi criado para fazer: a capacidade de enviar um pacote de formato misto com 5 a 15 documentos, definir o esquema de colunas uma única vez e obter uma tabela de saída única com dados validados e referenciados entre si. Sem configuração de modelo por transportadora, sem reconfiguração por tipo de documento.
Os arquivos são processados com segurança e não são armazenados.
Validação de Campos — De Texto Bruto a Dados Prontos para TMS
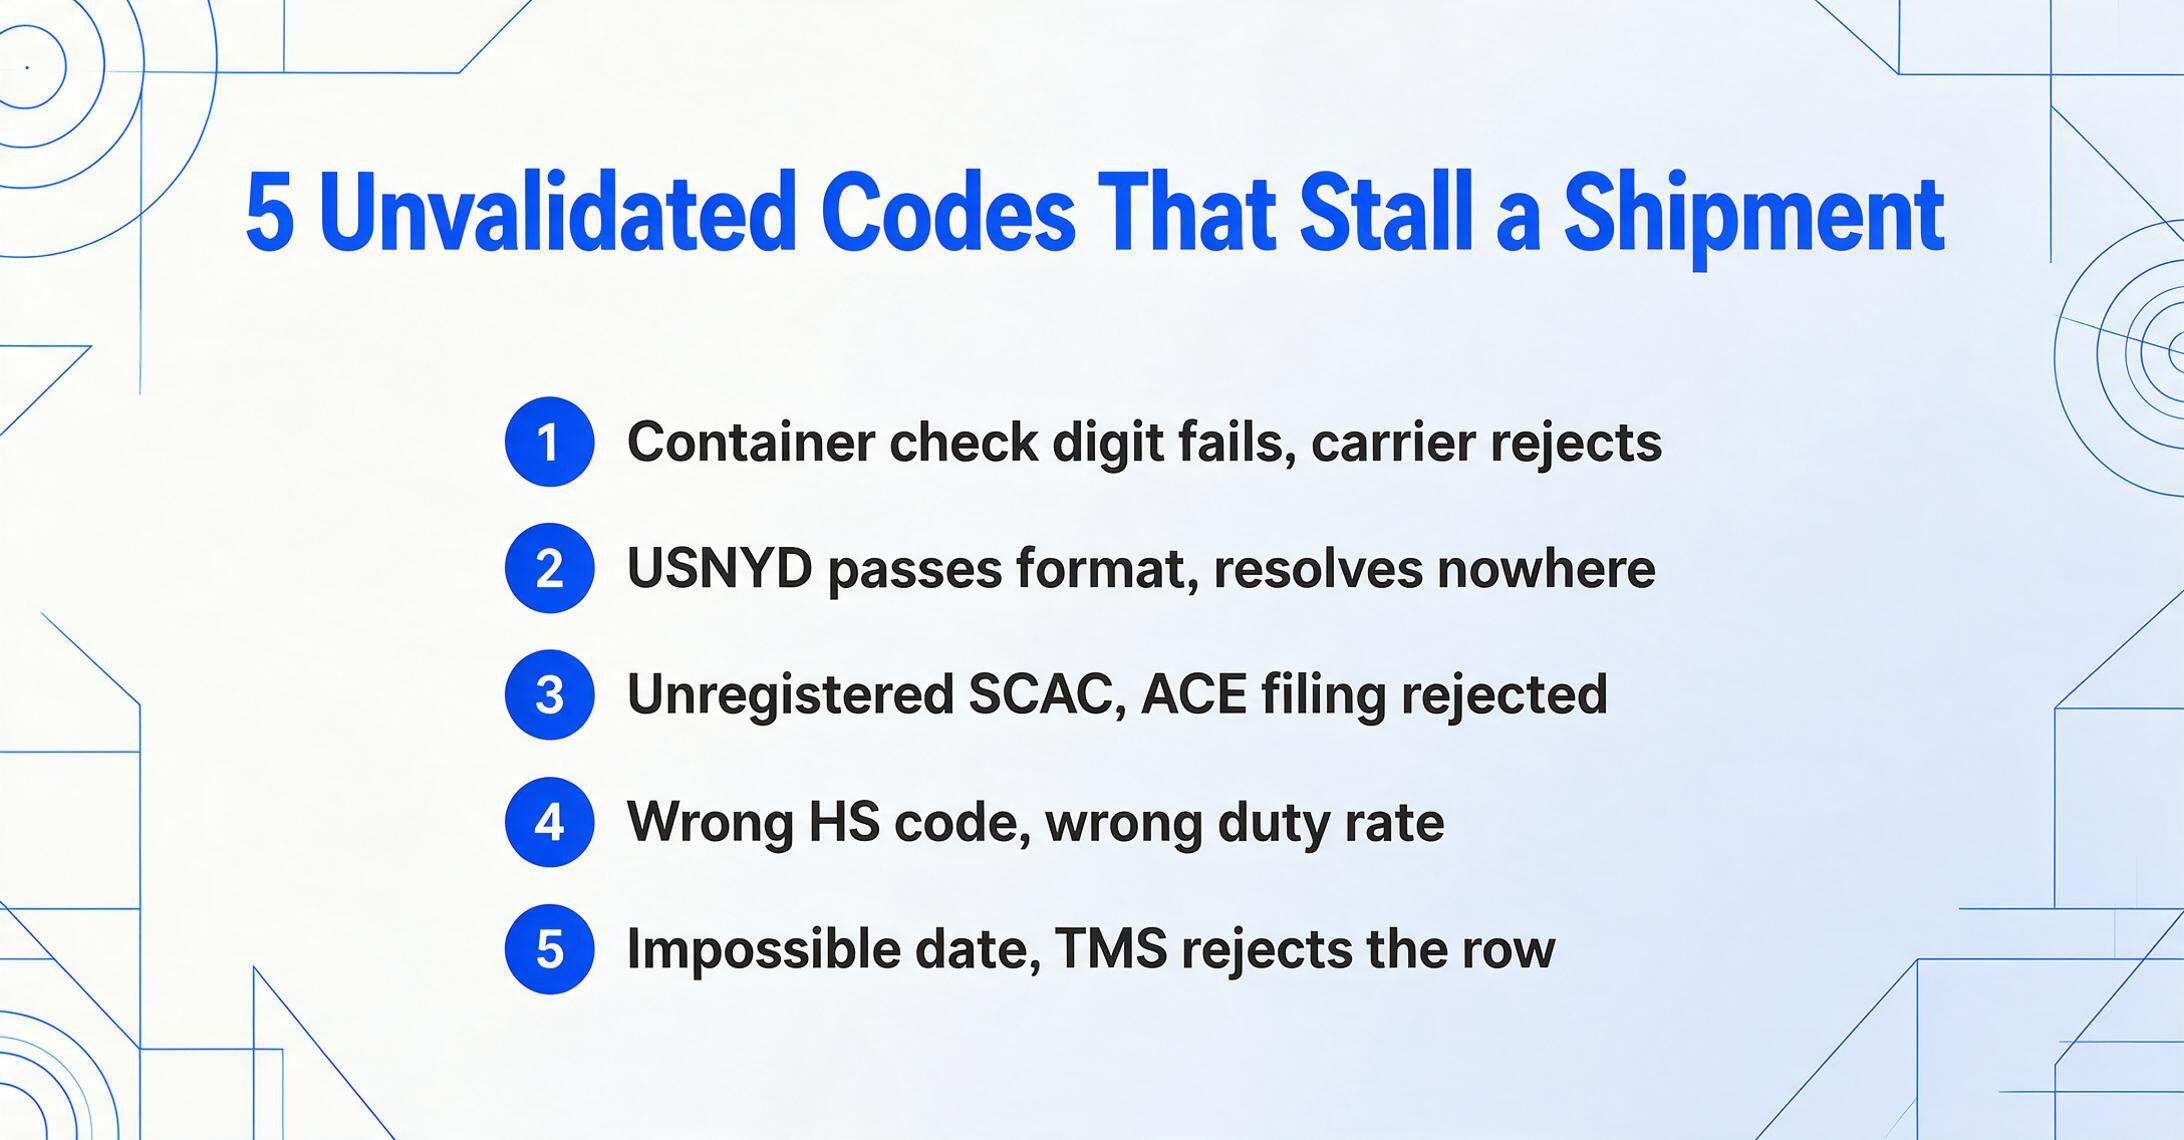
A diferença entre uma extração útil e um despejo de texto genérico é a camada de validação. Documentos de remessa usam sistemas de código com regras de validação integradas — uma ferramenta de extração que aplica essas regras detecta erros que, de outra forma, chegariam ao seu TMS ou ao envio alfandegário.
| Sistema de Código | Padrão de Formato | Regra de Validação | O que Acontece se Estiver Errado |
|---|---|---|---|
| Número do contêiner (ISO 6346) | AAAA-NNNNNN-N4 letras, 6 dígitos, 1 dígito verificador | Algoritmo do dígito verificador: código do proprietário × pesos da posição, mod 11 | O sistema de rastreamento da transportadora rejeita o número; o contêiner aparece como "não encontrado" por 3 dias enquanto alguém redigita os dígitos corretos |
| UN/LOCODE | XX-YYY2 letras do país + 3 letras da localidade | O código do país deve ser ISO 3166 válido; o código da localidade deve existir no banco de dados mestre da UNECE | "USNYC" é resolvido; "USNYD" (transposto) passa na verificação de formato, mas resolve para uma localidade diferente — ou nenhuma |
| Código SCAC | AAAA2-4 letras maiúsculas | Deve estar registrado na NMFTA; consulta à base de transportadoras ativas | Arquivamento ACE eManifest rejeitado; transportadora não identificada nos sistemas CBP |
| Código SH (Sistema Harmonizado) | XXXX.XX ou XXXX.XX.XXXX | Os primeiros 6 dígitos devem corresponder à classificação da OMA; dígitos 7-10 são específicos do país | Alíquota de imposto incorreta aplicada; inspeção aduaneira acionada; carga retida para reclassificação |
| Data (vários formatos) | 30/06/2026, 30-JUN-2026, 2026-06-30 | Normalizar para ISO 8601; sinalizar datas impossíveis (mês >12, datas futuras para partida) | TMS rejeita o campo de data; liberação da carga atrasada enquanto o formato da data é corrigido |
Um pipeline de validação que aplica essas regras durante a extração faz mais do que capturar erros — ele constrói um conjunto de dados pronto para sistemas downstream sem uma etapa manual de limpeza. O número do contêiner que passa na validação do dígito verificador ISO 6346 pode ser enviado diretamente para a API de rastreamento de uma transportadora. O UN/LOCODE que passa na consulta UNECE pode ser carregado em uma tabela de roteamento TMS. O código SH que corresponde à descrição da mercadoria pode ser submetido à alfândega com confiança.
Sem validação, a extração produz uma planilha de texto bruto que parece correta — até que a API de rastreamento da transportadora retorne "contêiner não encontrado" porque os dígitos 7 e 11 foram trocados. Esse atraso, a US$ 100-500 por dia em taxas de estadia, faz a diferença entre uma extração que economiza dinheiro e uma que cria um tipo diferente de custo.
Estrategias de Exportação — O que Entra na Planilha Final
A extração de documentos de envio não está completa até que os dados estejam em um formato utilizável. A estratégia de saída depende de quem a utiliza e de qual sistema ela alimenta.
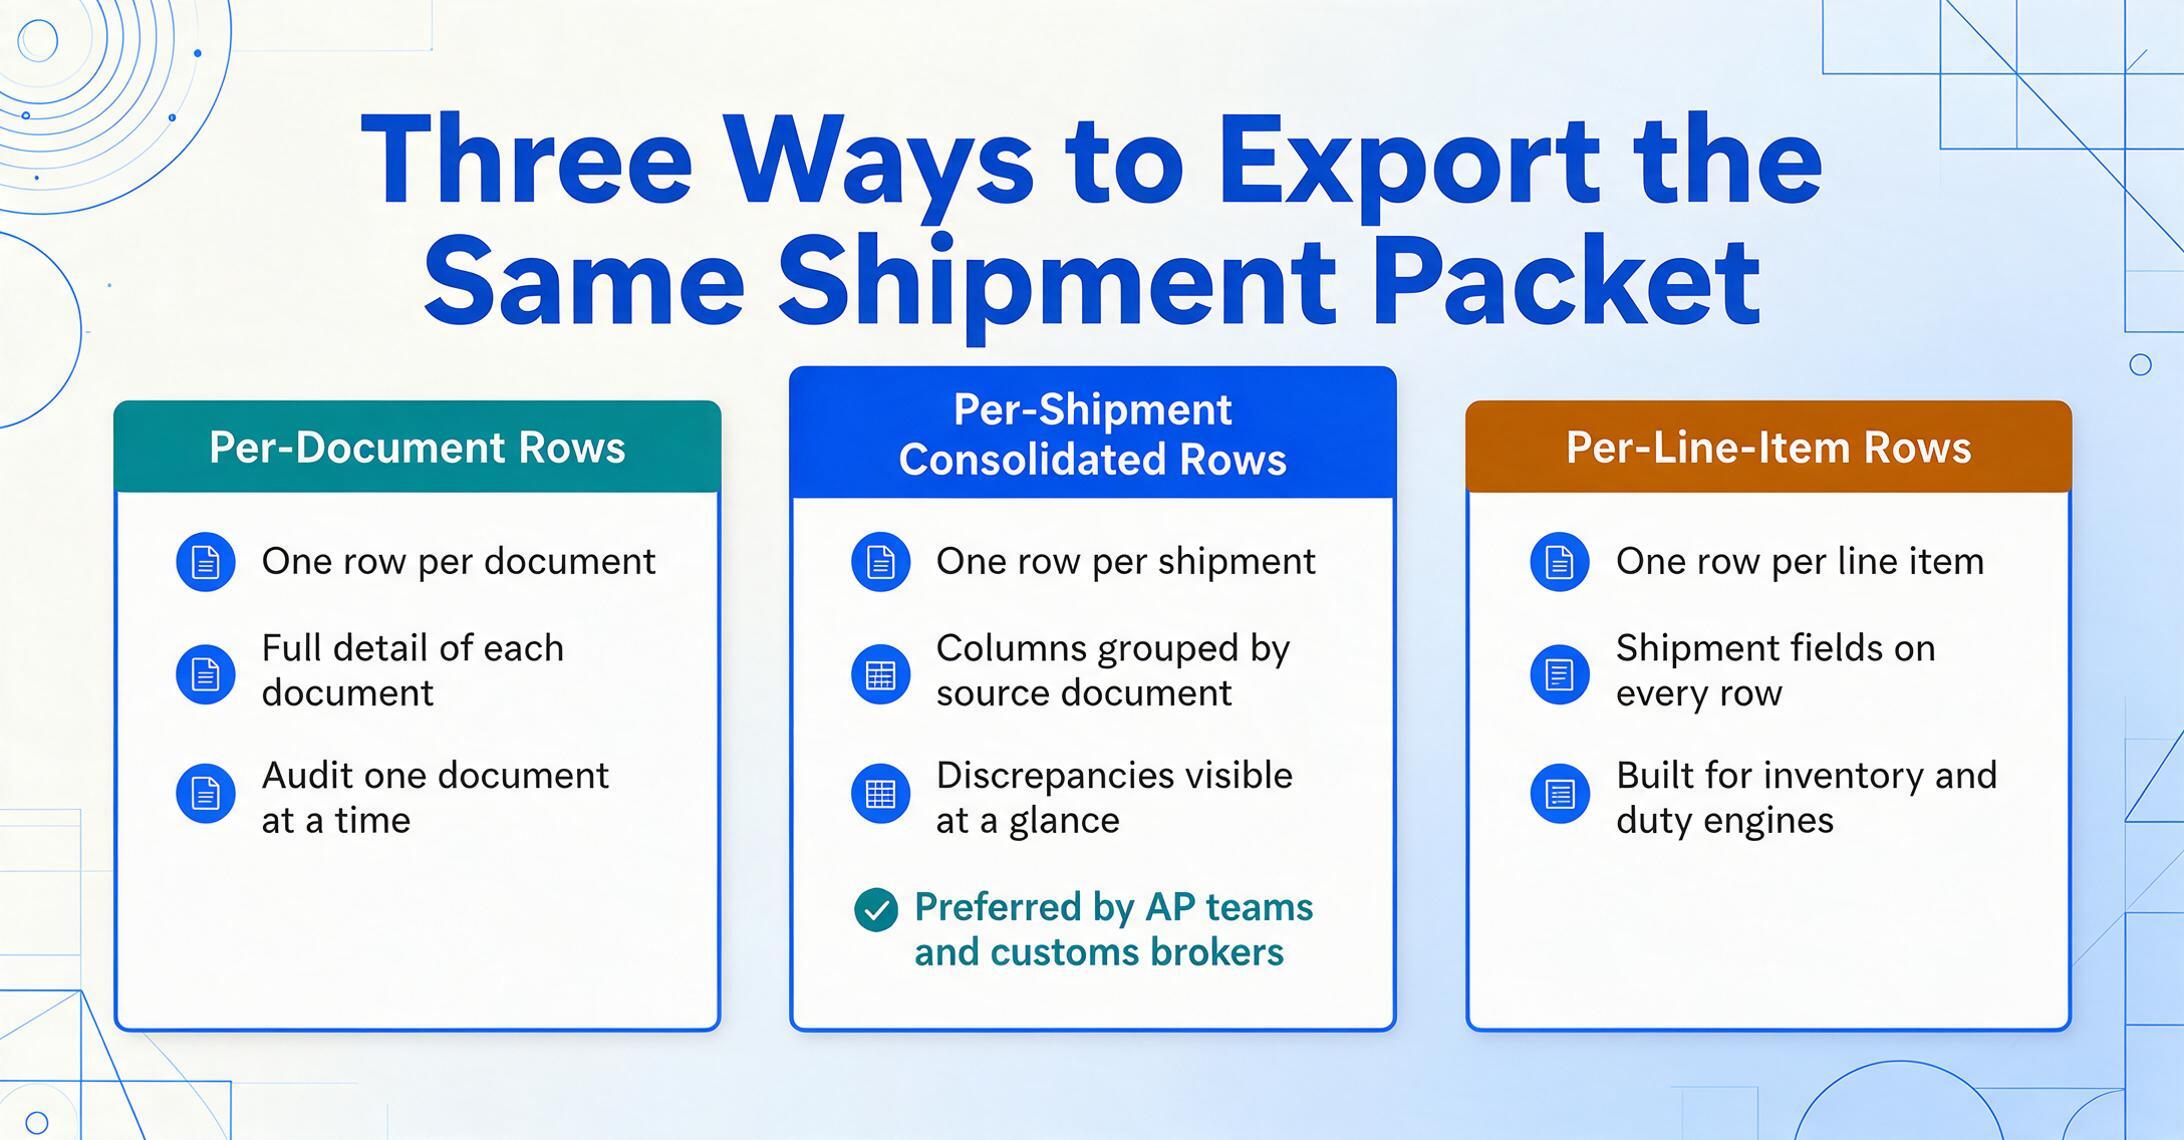
Linhas por documento. Cada documento no pacote gera uma linha de saída. A linha do B/L contém todos os campos do B/L. A linha da lista de embalagem contém todos os campos da lista de embalagem. Isso preserva o detalhe completo de cada documento, mas exige que você faça referência cruzada entre linhas manualmente. Ideal para equipes que precisam auditar cada documento individualmente.
Linhas consolidadas por envio. Uma linha por envio, com colunas agrupadas por documento de origem: BOL_Container_Number, Manifest_Container_Number, PL_Container_Number, seguidas por uma columna de conciliación. Este é o formato que as equipes de AP e os despachantes de aduana preferem — todos os dados do envio em um só lugar, com discrepâncias visíveis de imediato.
Linhas por item de linha. Uma linha por item de linha da lista de embalagem ou fatura comercial, com campos a nível de envio (número do contêiner, número do B/L, códigos de porto) repetidos em cada linha. Este é o formato para sistemas de gestão de inventário e motores de cálculo de direitos aduaneros que necessitam de detalhes a nível de item.
ImageToTable.ai suporta todos os três formatos de saída através de seu pipeline de processamento em lote. O sistema de token de exportação permite gerar arquivos Excel sob demanda e compartilhá-los com membros da equipe que não têm contas — o destinatário abre um link e baixa a saída. Isso é particularmente útil para transitários que precisam compartilhar dados de envio com seus clientes sem dar a cada cliente acesso à própria ferramenta.
Erros Comuns na Extração de Documentos de Remessa
Mesmo com a abordagem certa, a extração de documentos de remessa tem armadilhas que pegam equipes de logística novas no processamento automatizado.
Tratar todos os B/L como o mesmo documento. Um B/L direto, um B/L marítimo, um B/L multimodal, um B/L house e um B/L master compartilham o nome, mas diferem na estrutura de campos e no efeito legal. Uma configuração de extração que funciona em um B/L direto (um remetente, um consignatário, roteamento simples) perderá o número de referência HBL em um B/L house e os termos de transporte adiante em um B/L multimodal. A solução é projetar seu esquema de colunas para o tipo de documento mais complexo que você encontrar e deixar que documentos mais simples preencham menos campos.
Ignorar a camada de consolidação. Quando um agente de carga consolida remessas de cinco remetentes em um contêiner, a lista de embalagem não é um documento único — é uma coleção de listas de embalagem por remetente, além de um manifesto de consolidação. A configuração de extração deve entender que o contêiner MSCU 234781 6 pode conter 15 ordens de compra separadas de cinco exportadores, cada uma com seu próprio número de PO, código SH e país de origem. Uma ferramenta que gera uma linha por contêiner perde todos os detalhes em nível de item que a alfândega exige.
Pular a normalização de peso. O B/L pode mostrar 15.420 KGS. O manifesto mostra 34.000 LBS. A lista de embalagem mostra 340 CWT (cem pesos). Esses são o mesmo peso em unidades diferentes — mas a extração de texto bruto os gera como três números diferentes. Uma coluna calculada que normaliza todos os pesos para uma única unidade (quilogramas) e sinaliza quaisquer discrepâncias reais (após a conversão de unidades) evita retenções alfandegárias relacionadas a peso e disputas de fatura com transportadoras.
Não validar códigos no momento da extração. Um dígito verificador de contêiner inválido, um UN/LOCODE inexistente ou um código SH incompatível detectado na extração não custa nada para corrigir. O mesmo erro detectado 48 horas depois — após o envio do ISF, após a carga ter sido embarcada — gera uma multa de alteração de US$ 5.000 sob as regulamentações do CBP dos EUA (19 CFR 149.3). Extração sem validação em tempo real não é extração — é digitação em alta velocidade.
Perguntas Frequentes
Uma única ferramenta de extração pode processar todos os tipos de documentos de embarque (CT, manifesto, packing list, fatura comercial)?
Sim — mas apenas se a ferramenta usar extração semântica em vez de OCR baseado em modelos. Ferramentas baseadas em modelos exigem uma configuração separada por tipo de documento e formato de transportadora, o que significa manter mais de 50 modelos. A extração semântica identifica campos pelo que significam, não por onde estão, então a mesma definição de coluna para "Número do Contêiner" funciona em um CT da Maersk, um manifesto da MSC e um packing list do embarcador sem configuração por formato. O pré-requisito essencial é que o modelo de IA da ferramenta tenha sido treinado em documentos logísticos — modelos genéricos de extração de documentos que só viram faturas perderão códigos SCAC e padrões de números de contêiner.
Como lidar com documentos de diferentes transportadoras com layouts distintos?
A extração semântica por IA elimina completamente o problema de modelos por transportadora. Em vez de desenhar caixas delimitadoras para cada CT de transportadora (Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd), você define colunas pelo significado do campo — "Número do Contêiner", "Porto de Embarque", "Código SCAC" — e a IA localiza cada valor em qualquer layout de transportadora ao entender a relação semântica entre rótulos de campo e valores de dados em um documento de embarque. Quando uma transportadora reformula seu formulário, a extração funciona no novo layout sem qualquer atualização de modelo.
A IA consegue ler entradas manuscritas em packing lists e campos manuscritos em CTs?
A IA de visão moderna lê manuscritos com 85-95% de precisão em imagens de qualidade razoável, significativamente maior que a faixa de 50-70% do OCR tradicional na mesma entrada manuscrita. No entanto, a precisão varia por tipo de campo: números manuscritos estruturados (contagens de peças, pesos, datas) são mais confiáveis que nomes de consignatários em cursivo. Para documentos de embarque especificamente, marcas de pacotes manuscritas em packing lists e correções de contagem de peças manuscritas em CTs são o desafio mais comum de manuscritos — e o mais importante de acertar, pois esses são os campos que geram disputas de faturas de transportadoras. Uma abordagem prática é sinalizar campos manuscritos com pontuações de confiança mais baixas para revisão manual, em vez de confiar cegamente em toda a saída manuscrita.
Como lidar com documentos de várias páginas, como um BL marítimo de 5 páginas com itens nas páginas 2 a 4?
Um pipeline de extração bem projetado trata documentos de várias páginas como unidades lógicas únicas. A IA lê todas as páginas em sequência, carregando o contexto do embarque (número do BL, embarcador, nome do navio da página 1) para as páginas de itens. A tabela de descrição de carga que começa na página 2 e continua nas páginas 3-4 é mesclada em um único bloco de saída, em vez de ser dividida em quatro trabalhos de extração separados. Isso exige que a ferramenta entenda as relações entre as páginas do documento — não é um recurso suportado por todas as ferramentas de extração, e é uma das principais causas de falha quando equipes de logística tentam usar ferramentas focadas em faturas em BLs.
Qual formato de saída é padrão para extração de documentos de embarque — Excel, CSV ou JSON?
Excel (.xlsx) é o formato de saída mais comum para equipes de logística, pois suporta colunas calculadas (fórmulas de reconciliação), pastas de trabalho com várias planilhas (uma planilha por tipo de documento) e é diretamente importável na maioria dos sistemas TMS e ERP. CSV é uma alternativa leve útil para feeds EDI e importações em sistemas legados. JSON é preferido quando os dados extraídos alimentam uma API ou aplicativo personalizado. As melhores ferramentas de extração suportam todos os três formatos e permitem escolher por lote. Para o fluxo de trabalho por embarque descrito neste guia, o Excel com colunas de reconciliação calculadas é o formato recomendado.
Como validar números de contêiner durante a extração?
Os números de contêiner seguem o formato ISO 6346: quatro letras maiúsculas (código do proprietário + identificador de categoria) seguidas por sete dígitos, onde o sétimo dígito é um dígito verificador calculado usando um algoritmo específico. Um pipeline de validação aplica o algoritmo do dígito verificador a qualquer número de contêiner extraído — se o dígito verificador calculado não corresponder ao dígito verificado extraído, o valor é sinalizado com um aviso de validação. Isso detecta o erro de digitação mais comum em números de contêiner (transposição de dígitos) antes que ele chegue ao seu TMS. Um número de contêiner que passa na validação do dígito verificador não tem garantia de estar correto (um dígito verificador válido no código do proprietário errado ainda é possível), mas elimina mais de 95% dos erros de digitação.
Como Construir um Fluxo de Trabalho Repetible para Documentos de Envio
A extração de documentos de envio não é um projeto de digitalização único. É um processo operacional repetible: todos os dias, um lote de B/Ls, manifestos, listas de embalagem, faturas comerciais e faturas de frete chega como PDFs e imagens, e todos os dias, esses dados precisam chegar ao TMS, ao despachante aduanero e ao sistema de AP sem uma etapa de digitação manual. A diferença entre uma extração que funciona e uma que cria trabalho adicional é se a ferramenta lida com todo o pacote junto — com mapeamento de campos entre documentos, validação de códigos e exportação em lote — ou se força você a extraer cada tipo de documento separadamente e combinar os resultados manualmente.
A ferramenta que lê o B/L e para — antes do manifesto, antes da lista de embalagem, antes da reconciliação entre documentos — leu um documento. Não processou o envio. Uma extração completa captura o pacote, valida os campos compartilhados e gera um conjunto de dados onde as discrepâncias já estão marcadas e os códigos já estão padronizados. Essa é a diferença entre uma ferramenta de leitura de documentos e um fluxo de trabalho para documentos de envio.