日本語請求書の完全ガイド
AP・税務のためのデータ抽出
日本の請求書(請求書、seikyūsho)には、米国や欧州の請求書抽出ツールに列名が存在しないフィールドが約12個含まれている。振込先ブロック(振込先、furikomisaki)だけでも、銀行名・支店名・預金種目・口座番号の4フィールドがあり、AP担当者は毎回インターネットバンキング画面に手入力している。同じ4つの値がすでに仕入先マスタに登録されているにもかかわらずだ。支払条件の文字列(支払条件、shiharai jōken)には、「20日締翌月末払い」のような複合テキストの中に、締日と支払遅延日数という2つの計算可能な値が埋め込まれており、その経費がどの会計期間に属するかを決定する。源泉徴収区分(源泉徴収区分、gensen chōshū kubun)は、支払者が送金前に10.21%を差し引くことを意味する。これを見落とすと、仕入先にその金額を過払いしつつ、税務署には依然として支払義務が残る。このガイドでは、日本語請求書の全フィールド、それぞれの業務上の意味、構造化されたスプレッドシートへの抽出方法、そしてその出力を支払バッチ作成・会計ソフト取込・消費税申告という3つの下流パイプラインにどう渡すかを網羅する。月末に、それぞれ異なる請求システム・異なるレイアウトを使用する仕入先から30〜60件の請求書を処理しているなら、これがあなたのためのリファレンスだ。
重要ポイント
- 抽出ツールは請求書の金額と日付を見つける——あらゆる請求書で見つけるのと同じフィールドだ——そしてジョブ完了と報告する。
- しかし、振込先の銀行4フィールド、締日の支払慣行、源泉徴収区分——APチームが実際に銀行画面に再入力しているフィールド——は、スキップされるか文字化けする。なぜなら、米国・EUの請求書のトレーニングデータには、合計額の下に支払指示セクションが含まれていなかったからだ。
- 各日本語フィールドの意味に基づいて列を定義する——振込先は4つの金融列、締日は支払日と支払遅延日数に解析、源泉徴収はYes/Noフラグ——同じスキーマが30のレイアウトを持つ30の仕入先で機能する。AIはテンプレート上の位置ではなく、フィールドが何であるかを理解して位置を特定するからだ。
日本の請求書が他と違う理由 — 抽出において重要な点
日本の請求書は、欧米の抽出ツールが解析するよう訓練されていないフィールド構造を持っています。米国やEUの請求書は、ヘッダーから明細行、合計、支払期日へと流れ、買掛金ワークフローをカバーするのに通常4~6の抽出列で十分です。日本の請求書は、合計額の下にまったく別のセクション、つまり支払指示ブロックを追加します。これは、買い手にどの銀行に送金すべきか、どの決済日慣行が支払期日を制御するか、そして税務署に差し引くべき金額があるかどうかを伝えます。文書を上から下に読み、「請求書番号」と「合計」を探すだけの汎用抽出エンジンは、このセクション全体をスキップするか、さらに悪いことに、4つの別々の銀行フィールドを1つの文字化けしたテキスト文字列に連結してしまいます。
2023年10月以降、この問題には構造的な側面に加えてコンプライアンスの側面があります。インボイス制度(正式には適格請求書等保存方式)は、消費税法第57条の2に基づき、仕入税額控除の請求をサポートするすべての請求書に6つの必須項目を義務付けています。そのうちの3つ — 登録番号、税率別の税額合計、税率区分の内訳 — は、制度開始前には必須項目として存在していませんでした。2025年3月時点で、国税庁は約461万の適格請求書発行事業者を報告しています。そのすべてが、すべての請求書にT+13桁の登録番号を含めなければなりません。その番号がない場合、買い手の仕入税額控除は減額されます — 80%控除可能からゼロへと段階的に移行する経過措置に従います。
したがって、抽出の課題は単に日本語のテキストを読むことではありません。それは、APと税務にとって重要な列であるフィールドスキーマが、抽出ツールが期待するように構築されたスキーマとは異なる文書を読むことです。解決策はカスタム列抽出です。APスプレッドシートと日本のビジネスロジックに一致する列名を使用して出力スキーマを自分で定義し、AIに各フィールドが何を意味するかを理解させることで — 特定のサプライヤーの請求書テンプレート上の位置ではなく — 各フィールドを特定させます。同じ列スキーマは、大手商社のERP生成PDF、地元のサービスプロバイダーのWordテンプレートを印刷してスキャンしたもの、または手書きフォームのモバイル写真のいずれであっても機能します。各列定義がどうあるべきか、そして日本の慣習を捉える推論ロジックの書き方については、ステップバイステップの日本請求書抽出チュートリアルを参照してください。このチュートリアルでは、25の列を一度定義し、すべてのサプライヤーで再利用する方法を説明しています。
このガイドの残りの部分では、それらの各列が何を抽出する必要があるか、そして日本の請求書に固有のフィールド — 振込先の銀行詳細、締日の決済慣行、源泉徴収、および複数税率の消費税 — が、列定義から支払バッチ出力、消費税申告書の提出に至るまで、抽出ワークフロー全体をどのように形成するかを説明します。
請求書のフィールド構造
日本の請求書には、4つの論理ゾーンがあります。最初の2つ(ヘッダーと明細行)は、世界中の請求書に共通するものです。残りの2つ(税務・コンプライアンス、支払い・銀行)は、フィールドスキーマが欧米の抽出エンジンが想定するものと異なる部分です。以下は、APチームが多様な仕入先からの請求書を処理する際に遭遇するすべてのフィールドを、ゾーンごとに整理したものです。
ヘッダーと識別情報
- 請求書番号 — 一意の識別子で、多くの場合「2026-07-001」のような日付と連番の複合形式。APの検索と支払い追跡における主キーです。これがないと、銀行の振込確認と元の請求書の照合は、ボリュームが増えるほど複雑化する照合問題になります。
- 発行日 — 請求書が発行された日付。支払条件が請求締日を基準とする場合、支払期日の計算の起点となります。
- 取引年月日 — 実際の取引が行われた日付。発行日と異なる場合があり、多くの場合、和暦(令和8年)で表示されます。抽出時には、会計システムで使用するために和暦を西暦(ISO 8601)に変換する必要があります。
- 発行元 — 売り手の会社名、住所、連絡先。多くの場合、会社の印鑑(社判)が添えられます。
- 宛名 — 宛先の会社名と部署名。通常、敬称である「御中」が続きます。
明細行と価格
- 品名 — 製品またはサービスの説明。仕入先の請求システムでは、発注書と同じ製品を異なる名称で記載することがあり、これがVLOOKUP #N/A問題を引き起こします。品番や摘要などのオプションフィールドを含む場合があります。
- 数量 — 単位(個、式、kg、m、時間など)と共に記載。発注書と請求書で単位が異なる場合、正規化が必要です。
- 単価 — 通常は税抜価格。税込価格に切り替わった請求書の場合、APは逆算して消費税を計算し、発注書と照合する必要があります。
- 金額 — 税抜きの明細合計。多くの場合、小計と併せて表示されます。
税務・法令遵守
- インボイス登録番号 (Qualified Invoice Registration Number) — 「T」+13桁。2023年10月より必須。買い手がこの仕入先からの仕入れについて全額の仕入税額控除を適用するための唯一の方法。番号が欠落または誤っている場合、経過的な仕入税額控除スケジュールが適用される:2026年9月までは80%控除可能、2029年9月までは50%、その後はゼロ。この制度の詳細については、日本の適格請求書データ抽出の完全ガイドを参照。
- 消費税額 (Consumption Tax) — 税率区分ごとに個別表示:10%標準(国7.8%+地方2.2%)および8%軽減(国6.24%+地方1.76%)。請求書には各税率区分の課税標準額と税額を記載する必要がある。買い手の消費税申告では、これらの税率グループ別の合計値を入力データとして必要とする。
- 源泉徴収区分 (Withholding Tax Classification) — 所得税法第204条に基づき、対象となる専門サービス提供者からの請求書に記載される。支払者は支払額の10.21%を源泉徴収し、売り手に代わって税務署に納付する。
支払・銀行
- 振込先 (Bank Transfer Details) — 4つの個別フィールド:銀行名、支店名、口座種別(普通または当座)、口座番号。5つ目のフィールドとして口座名義が記載されることも多い。これらは経理担当者がインターネットバンキング画面に再入力する項目であり、同じデータはすでに仕入先マスターに存在している。ゆうちょ銀行の場合、口座参照には記号-番号形式が使用され、7桁の振込用口座番号に変換する必要がある。
- 支払条件 (Payment Terms) — 簡潔な日本語構文で表現される。「20日締翌月末払い」は、請求期間が20日に締め切られ、支払期日が翌月末であることを意味する。これには2つの計算可能な値が含まれる:締日と支払ラグ。締日は会計年度の分類を決定する—20日締めの条件で3月22日付の請求書は、当期ではなく翌会計年度に属する。
- 振込手数料 (Transfer Fee Responsibility) — 銀行振込手数料の負担者。請求書に「貴社ご負担」と記載されている場合、経理は振込総額に手数料を加算する必要がある。
この構造は推測ではない—内閣府による適格請求書制度の公式概要には6つの必須項目が列挙されている。しかし、データ抽出の課題は必須項目にとどまらない。最も多くの経理担当者の手作業時間を消費する項目—振込先、支払条件の解析、源泉徴収—は、法的要件ではなく慣行によって含まれている。これらこそが、日本の請求書処理を欧米のそれと構造的に異なるものにし、汎用的な抽出が最初に破綻するポイントである。手作業による抽出のコストを理解するには、日本の中小企業における手作業による請求書処理のコスト分析で、典型的な月末締めにおける1サイクルあたりの労務コストを円単位で詳述している。
中核となる抽出の洞察:日本の請求書は、日本語のテキストが入った英語の請求書ではありません。異なるフィールドスキーマを持つ文書であり、抽出列の定義はそのスキーマを反映していなければなりません。そうでなければ、出力はAPチームがまだ手入力し直さなければならないデータの表にすぎません。
振込先: なぜ4つの別々の銀行フィールドなのか — 1つのテキストブロックではなく
銀行振込先詳細ブロックは、日本のAP業務で最も反復的なデータ入力タスクです。仕入先からの請求書には、銀行名、支店名、口座種別、口座番号という4つのラベル付きフィールドがあり、AP担当者はインターネットバンキング画面を開いて、請求書ごとに1つずつ入力します。同じ4つの値は、すでに会計ソフトの仕入先マスタに存在しています。月末に30枚の請求書が届くと、APチームはその4つのフィールドを30回再入力することになります — 新しい情報を追加せず、既存のマスタデータをある画面から別の画面に複製するだけの120件の個別入力です。
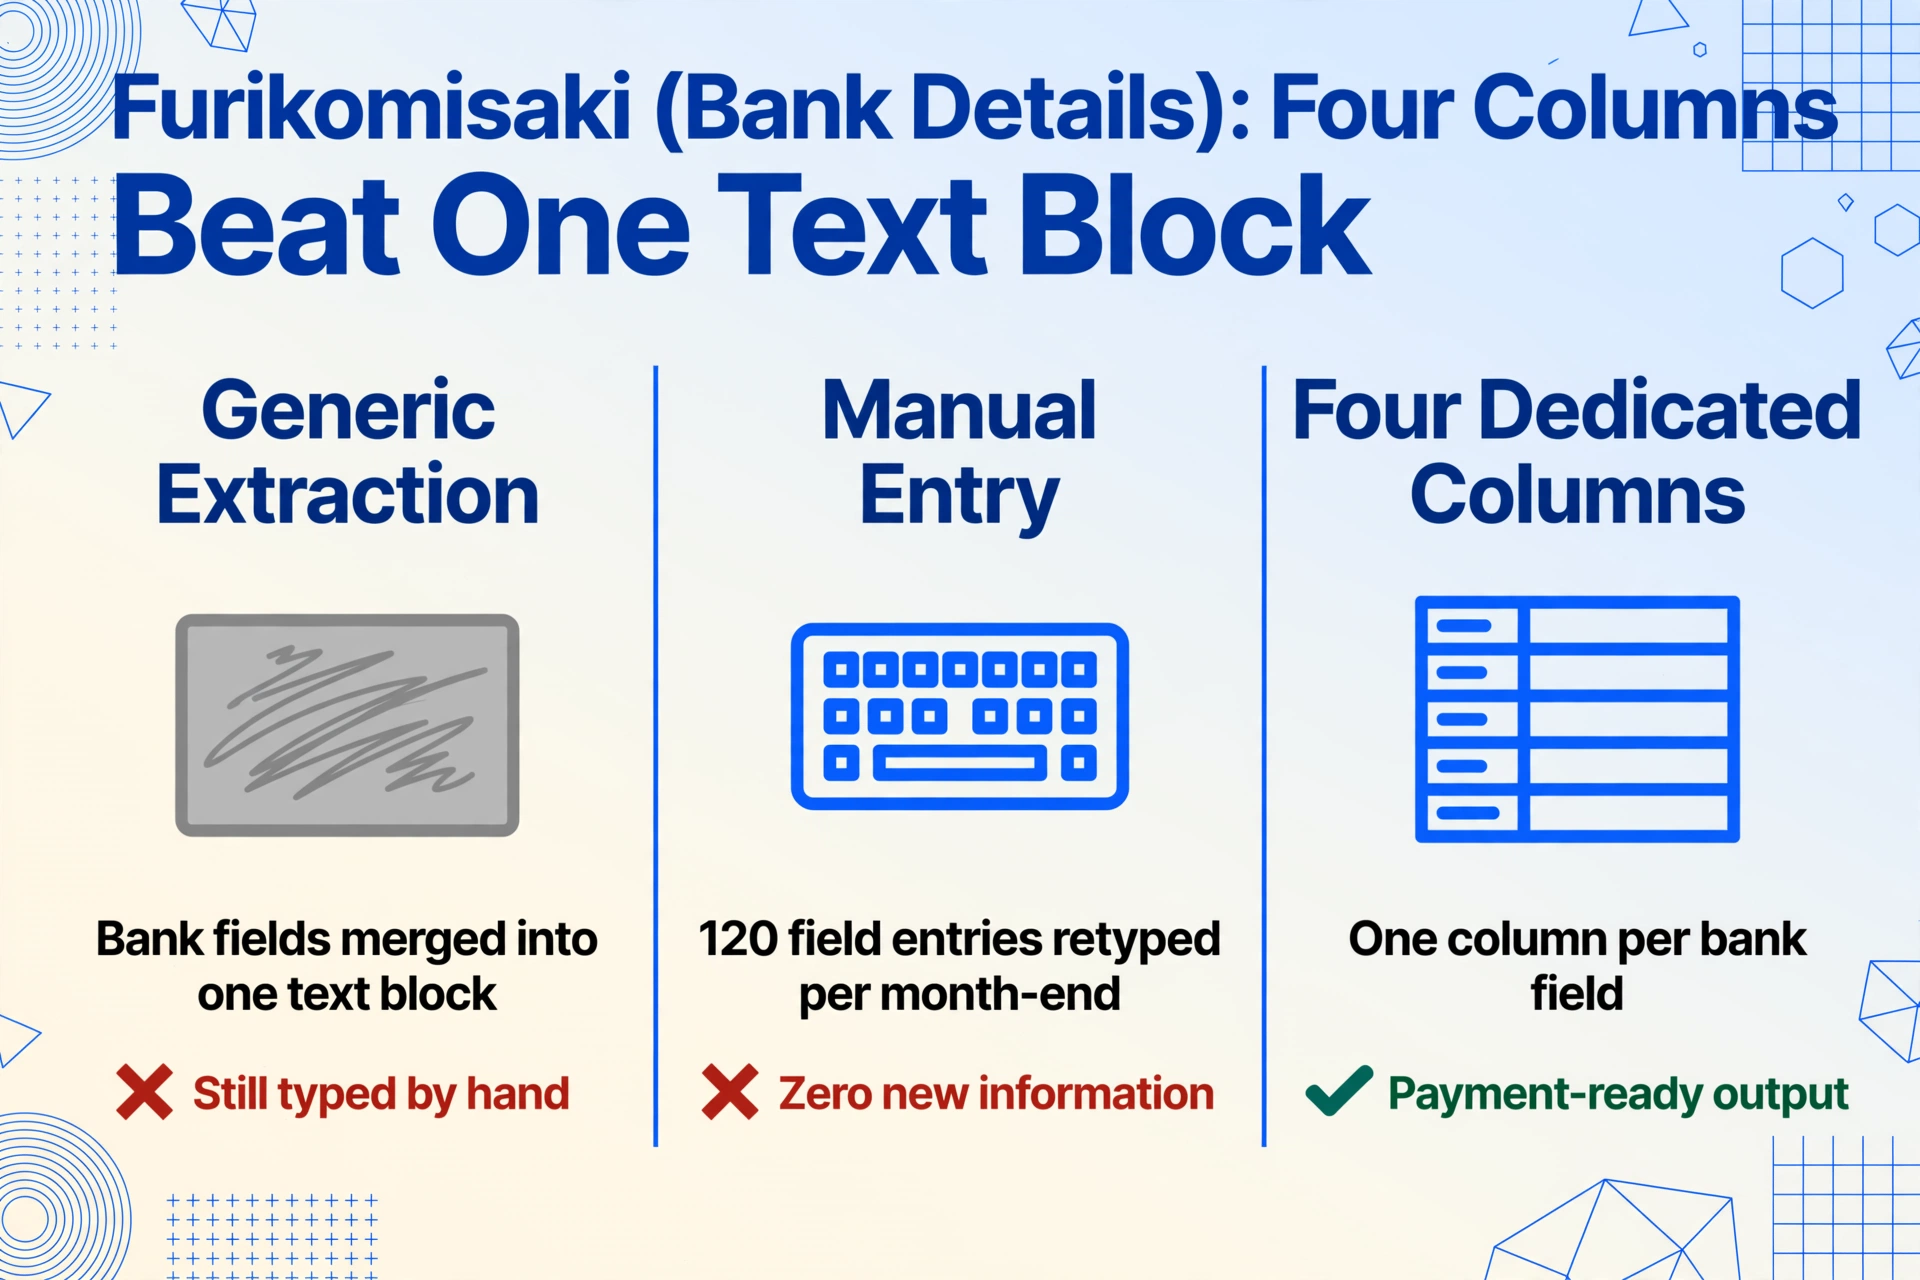
ほとんどの汎用抽出ツールは、米国およびEUの請求書データセットでトレーニングされており、「支払方法」は単一のフィールド — 「銀行振込」や「ACH」— であり、請求書に銀行振込先詳細を記載するという概念は構造化されたフィールドセットとして存在しません。これらのツールの1つに請求書を投入すると、銀行振込先詳細ブロックはスキップされるか、1つの非構造化テキストフィールドに連結されます。APチームは依然としてPDFを開いて各フィールドをコピー&ペーストしなければなりません。
抽出アプローチでは、振込先ブロックを4つの専用列に分離し — 各列が1つのフィールドを独立して捕捉し — ゆうちょ銀行の変換を処理するために推論列を使用します。ゆうちょ銀行の口座システムは、商業銀行の振込システムで必要な7桁の振込口座番号とは異なる記号-番号のペアを使用します。推論列 — ページに印刷された値を見つけるのではなく、文書の文脈に基づいてAIが値を計算する列 — は、抽出中に変換を処理します:振込口座番号(銀行名にゆうちょが含まれる場合、記号-番号ペアをゆうちょ銀行の変換ルールに従って7桁形式に変換。それ以外の場合は口座番号を出力)。列定義は一度実行され、すべてのバッチに適用されます。
4つの構造化された銀行列は、単なる組織上の利便性ではありません。これらは支払いバッチファイルの入力データであり — ここで全銀フォーマットがワークフローに入ります。バッチ処理ガイドでは、完全なチェーンを説明しています:1つのバッチで処理される30枚の請求書 → 別々の列にある振込銀行詳細 → 銀行が受け入れ可能な支払いバッチファイルにフォーマットされた出力。抽出は単に入力を節約するだけではありません — 抽出によって入力された銀行フィールドが、銀行のアップロード画面が取り込むのと同じ銀行フィールドであるデータパイプラインを作成します。
支払条件: 会計期間を決定する締日
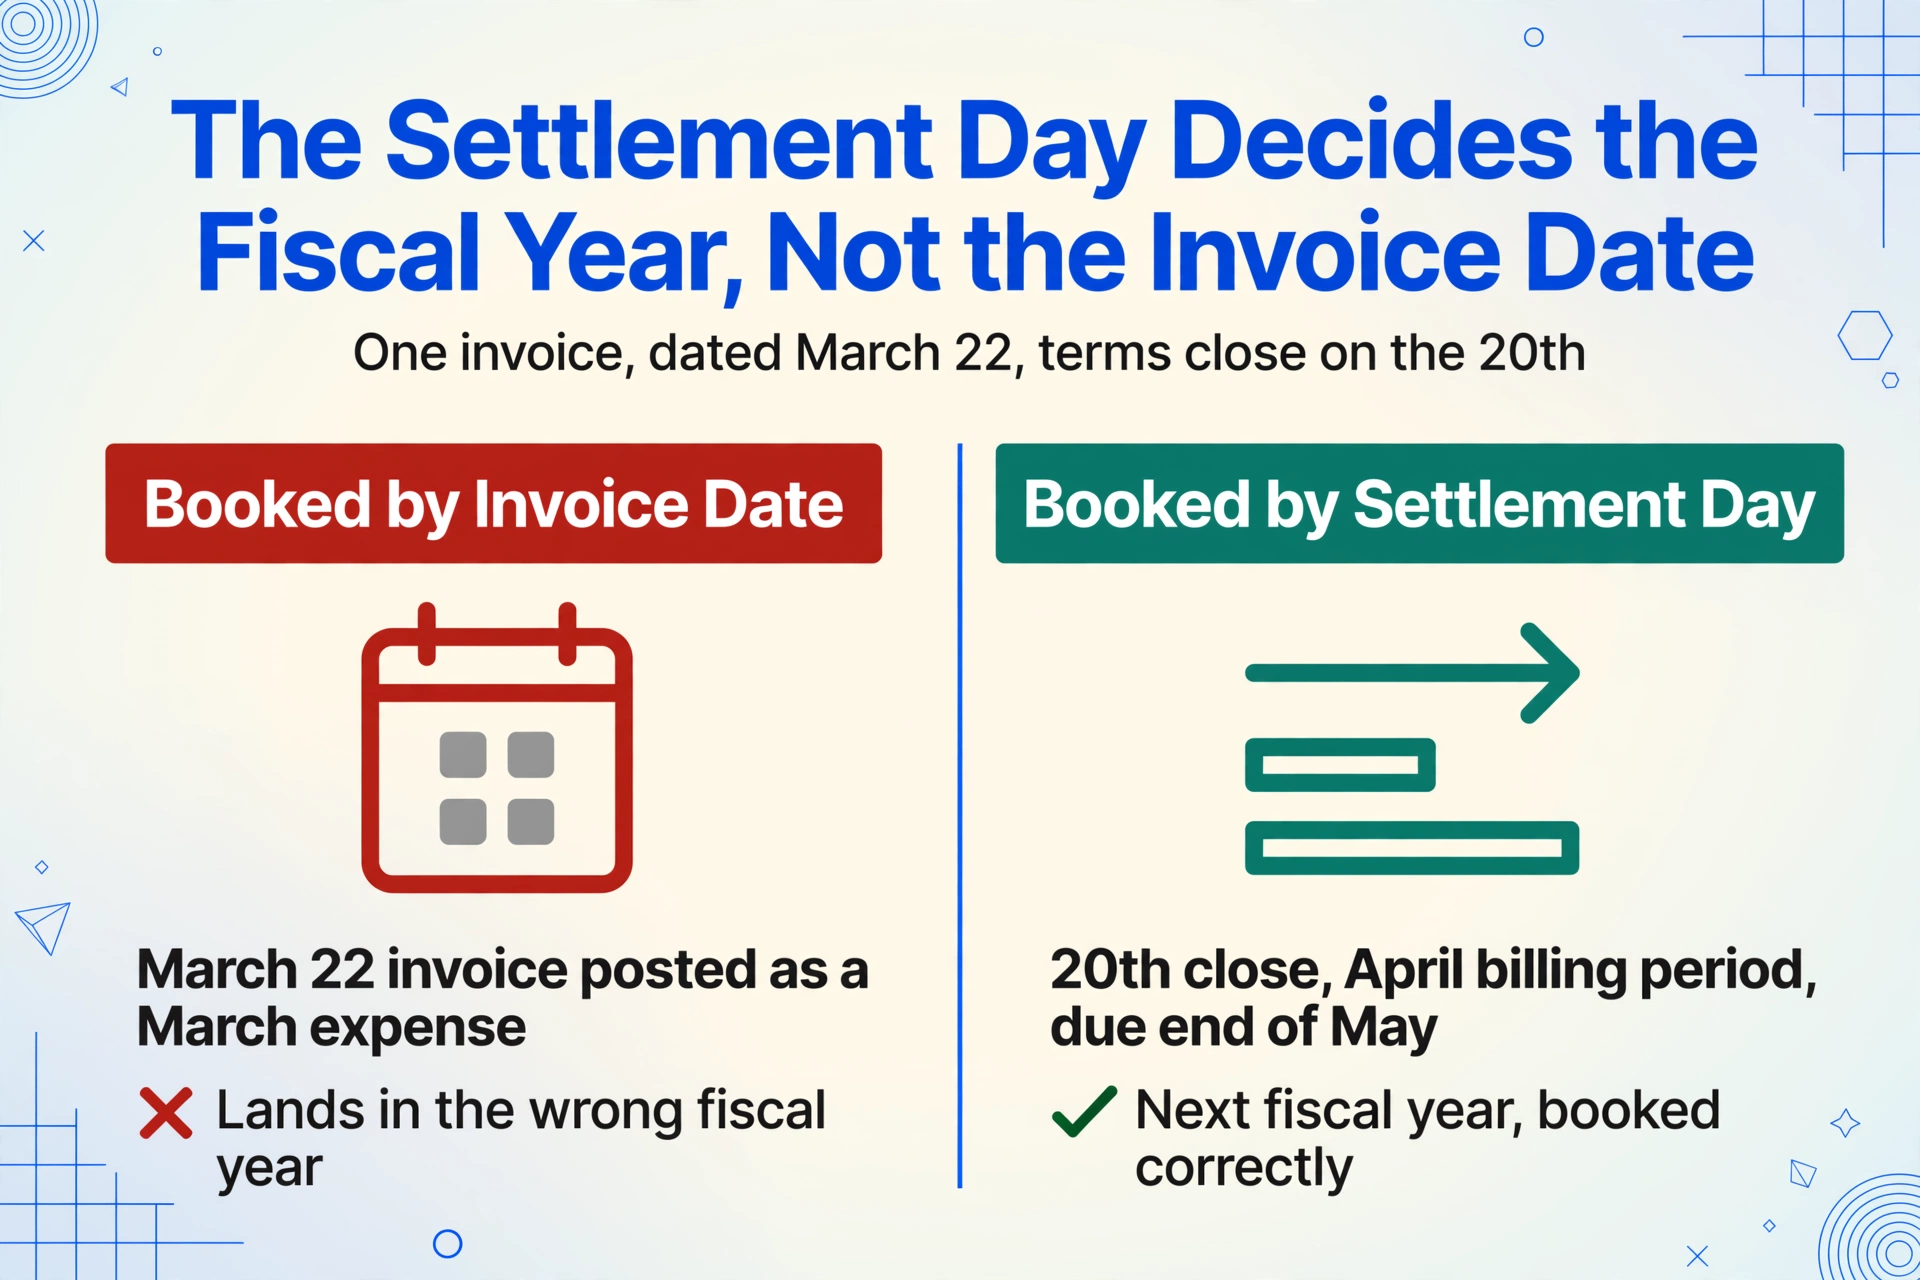
日本の支払条件は、APチームが一目で読めるコンパクトな構文だが、一般的な抽出では不透明なテキストとして扱われる。「20日締翌月末払い」は、請求期間が毎月20日に締まり、支払いが翌月末までに完了することを意味する。この文字列には、締日(20)と支払いラグ(1ヶ月)という2つの計算可能な値がエンコードされている。「月末締翌々月末払い」— 建設業や製造業で一般的 — は、月末締め、翌々月末までの支払い(ラグ: 2ヶ月)を意味する。
締日は形式的なものではなく、実務上の意味を持つ。20日締の条件で3月18日付の請求書は3月請求期間に該当する: 支払いは4月末、経費は3月31日に決算が締まる場合、当期の会計年度に属する。同じ条件で3月22日付の請求書は4月請求期間に該当する: 支払いは5月末、経費は翌会計年度に属する。会計年度の分類を決定するのは、請求日でも暦月の境界でもなく、締日である。締日支払期限分析では、30社のサプライヤーがそれぞれ異なる締日を使用する場合に、締日ルールがキャッシュフロー予測にどのように連鎖的な影響を与えるか、その全体的な実務的影響を解説している。
計算列 — AIが抽出時に定義された計算式を用いて値を算出する列 — は、支払条件を構造化フィールドに分割する: 締日(支払条件から解析: 「20日締」→ 20、「月末締」→ 31、「10日締」→ 10) および 支払いラグ月数(支払条件から解析: 「翌月末払い」→ 1、「翌々月末払い」→ 2)。この2つの列は、実際の支払期日を計算するスプレッドシートの計算式で使用される — 出力スプレッドシートの支払期日列は、入力されたものではなく、自由テキストフィールドから抽出されたものでもなく、請求日と解析された条件から導出される。この日付列はキャッシュフロー予測と支払バッチスケジュールに供給され、どちらもそれをエンコードするテキスト文字列ではなく、実際の暦日を必要とする。
源泉徴収区分: 支払者が支払前に源泉徴収をしなければならないケース
日本の源泉徴収制度では、支払先が特定の職業に該当する場合、支払者に源泉徴収義務が生じます。税理士、公認会計士、弁護士、司法書士、デザイナー、著作家など、所得税法第204条に定められた職業は、支払金額の10.21%が源泉徴収の対象となります。支払者は源泉徴収額を差し引いた残りの89.79%を支払先に支払い、差し引いた所得税を税務署に納付します。
該当する職業からの請求書には、通常、源泉徴収に関する記載があります。「源泉徴収額」として差引額が明記されているか、「源泉徴収あり」といった区分表示がされています。源泉徴収のある請求書は買掛金の支払計算に影響します。正味支払額は請求書合計額から源泉徴収額を差し引いた額となり、税務署への納付義務に対応する別途の負債計上が必要です。抽出時に源泉徴収情報を取得できない場合、買掛金チームは該当する請求書を個別に確認し、手動で控除額を計算して支払額を調整する必要があります。この作業を60件の請求書で行うと、多大な時間を要します。
源泉徴収区分(請求書に源泉徴収の記載があるか確認。該当する職業で源泉徴収ありの場合は「該当」、それ以外は「非該当」と出力) という列を定義することで、どの請求書に源泉徴収が必要かを自動判定できます。さらに、正味支払額(源泉徴収該当の場合:合計額×0.8979、非該当の場合:合計額) という計算列を設定すれば、実際の振込額を直接算出できます。これにより、支払バッチファイルには請求書合計額ではなく正しい振込額が含まれ、買掛金チームが該当請求書ごとに個別計算する手間が省けます。
インボイス番号: T+13の登録番号とその存在理由
適格請求書の登録番号(インボイス登録番号)は「T」を冠した13桁の番号であり、例えばT1234567890123のような形式である。登録を受けたすべての適格請求書発行事業者(QII)は、登録時に国税庁からこの番号を付与され、買い手が消費税控除を受けるために使用するすべての請求書にこの番号を記載しなければならない。国税庁は適格請求書発行事業者の公的登録簿を維持しており、APチームはそこで登録番号を検証できる。
この登録番号により、2023年10月以前には存在しなかった請求書ごとの検証ステップが新たに生まれた。請求書を受け取ったAP担当者は、T番号を特定しなければならない。そのT番号は、ヘッダー、フッター、余白、社判の横の細かい文字、または振込先情報の近くのテキストブロックに埋め込まれている場合があり、それが仕入先のものであることを確認する必要がある。番号が欠落している場合、または国税庁の登録簿と一致しない場合、その取引における買い手の仕入税額控除は、80%控除可能(2026年9月まで)から50%(2029年9月まで)、そしてゼロへと段階的に移行する経過措置に基づき減額される。日本の適格請求書抽出に関する完全ガイドでは、6つの必須項目、経過措置の控除スケジュール、抽出したT番号を国税庁の登録簿に対して単一列ルックアップで検証する方法など、コンプライアンス対応の請求書の全体像を詳しく解説している。
抽出ワークフローにおいて、登録番号の列は定義が簡単である。AIがドキュメントを読み取り、ページ上のどこにあってもT+13のパターンを識別し、その列に入力する。課題は抽出自体ではなく、配置のばらつきにある。仕入先ごとにT番号の配置場所が異なるのだ。登録番号が固定の位置にあることを前提とするテンプレートベースのツールでは、仕入先がフッターに配置した請求書ではその番号を見逃してしまう。セマンティック抽出、つまりフィールドがどこにあるかではなく何であるかを理解して特定する方法であれば、位置に関係なく捕捉できる。同じ原則が請求書のすべてのフィールドに適用され、30の仕入先が30の異なるレイアウトであっても単一の列スキーマで機能する理由がそこにある。
消費税: 申告のための複数税率抽出
日本の消費税制度は2つの税率を使用する — 10%標準税率(ほとんどの商品・サービスに適用)と8%軽減税率(食品、非アルコール飲料、週2回以上発行される定期購読新聞に適用)。適格請求書には、各税率区分ごとに課税標準額と税額を区分して記載し、端数は1円未満を切り捨てる必要がある。両税率を合算した単一の総額表示は、インボイス制度において不適合となる。
抽出の課題は分類である。複数税率の明細行を含む請求書 — 事務用品(10%)と飲料(8%)が混在する場合 — 各明細行を正しい税率区分に割り当て、税率別の小計が供給者の記載額と一致するかを検証する必要がある。供給者が誤って10%の品目を8%の欄に含めた場合、買い手の消費税申告で仕入税額控除を過大に計上することになる — 国税庁のデータ照合エンジンは、意図的な過少申告と供給者の誤りへの依存を区別しない。
推論列が抽出時に税率分類を処理する: 税率(品目説明から: 食品・飲料(酒類・外食を除く)→ 8%軽減税率; 標準的な商品・サービス → 10%標準税率; 輸出関連と明示されたもの → 免税)。AIが各明細行の説明を読み、日本の複数税率ルールを適用して税率列に入力する。2つの計算列が税率別小計を計算する — 10%小計(税率=10%の明細金額の合計)および8%小計(税率=8%の明細金額の合計) — これらを請求書に記載された各税率区分の小計と直接照合できる。
消費税データは抽出されたスプレッドシートから消費税申告の入力データとして流れ込む — 10%課税標準額、10%税額、8%課税標準額、8%税額。抽出出力が各明細行を発生源で分類していれば、税理士は分類を検証するだけでよく、ゼロから分類を行う必要はない。消費税の一般的な入力ミスガイドでは、税率分類を抽出段階ではなく手作業で行った場合に税務差異を引き起こす具体的なミスを解説している。
抽出ワークフロー:PDFから支払い準備済みスプレッドシートへ
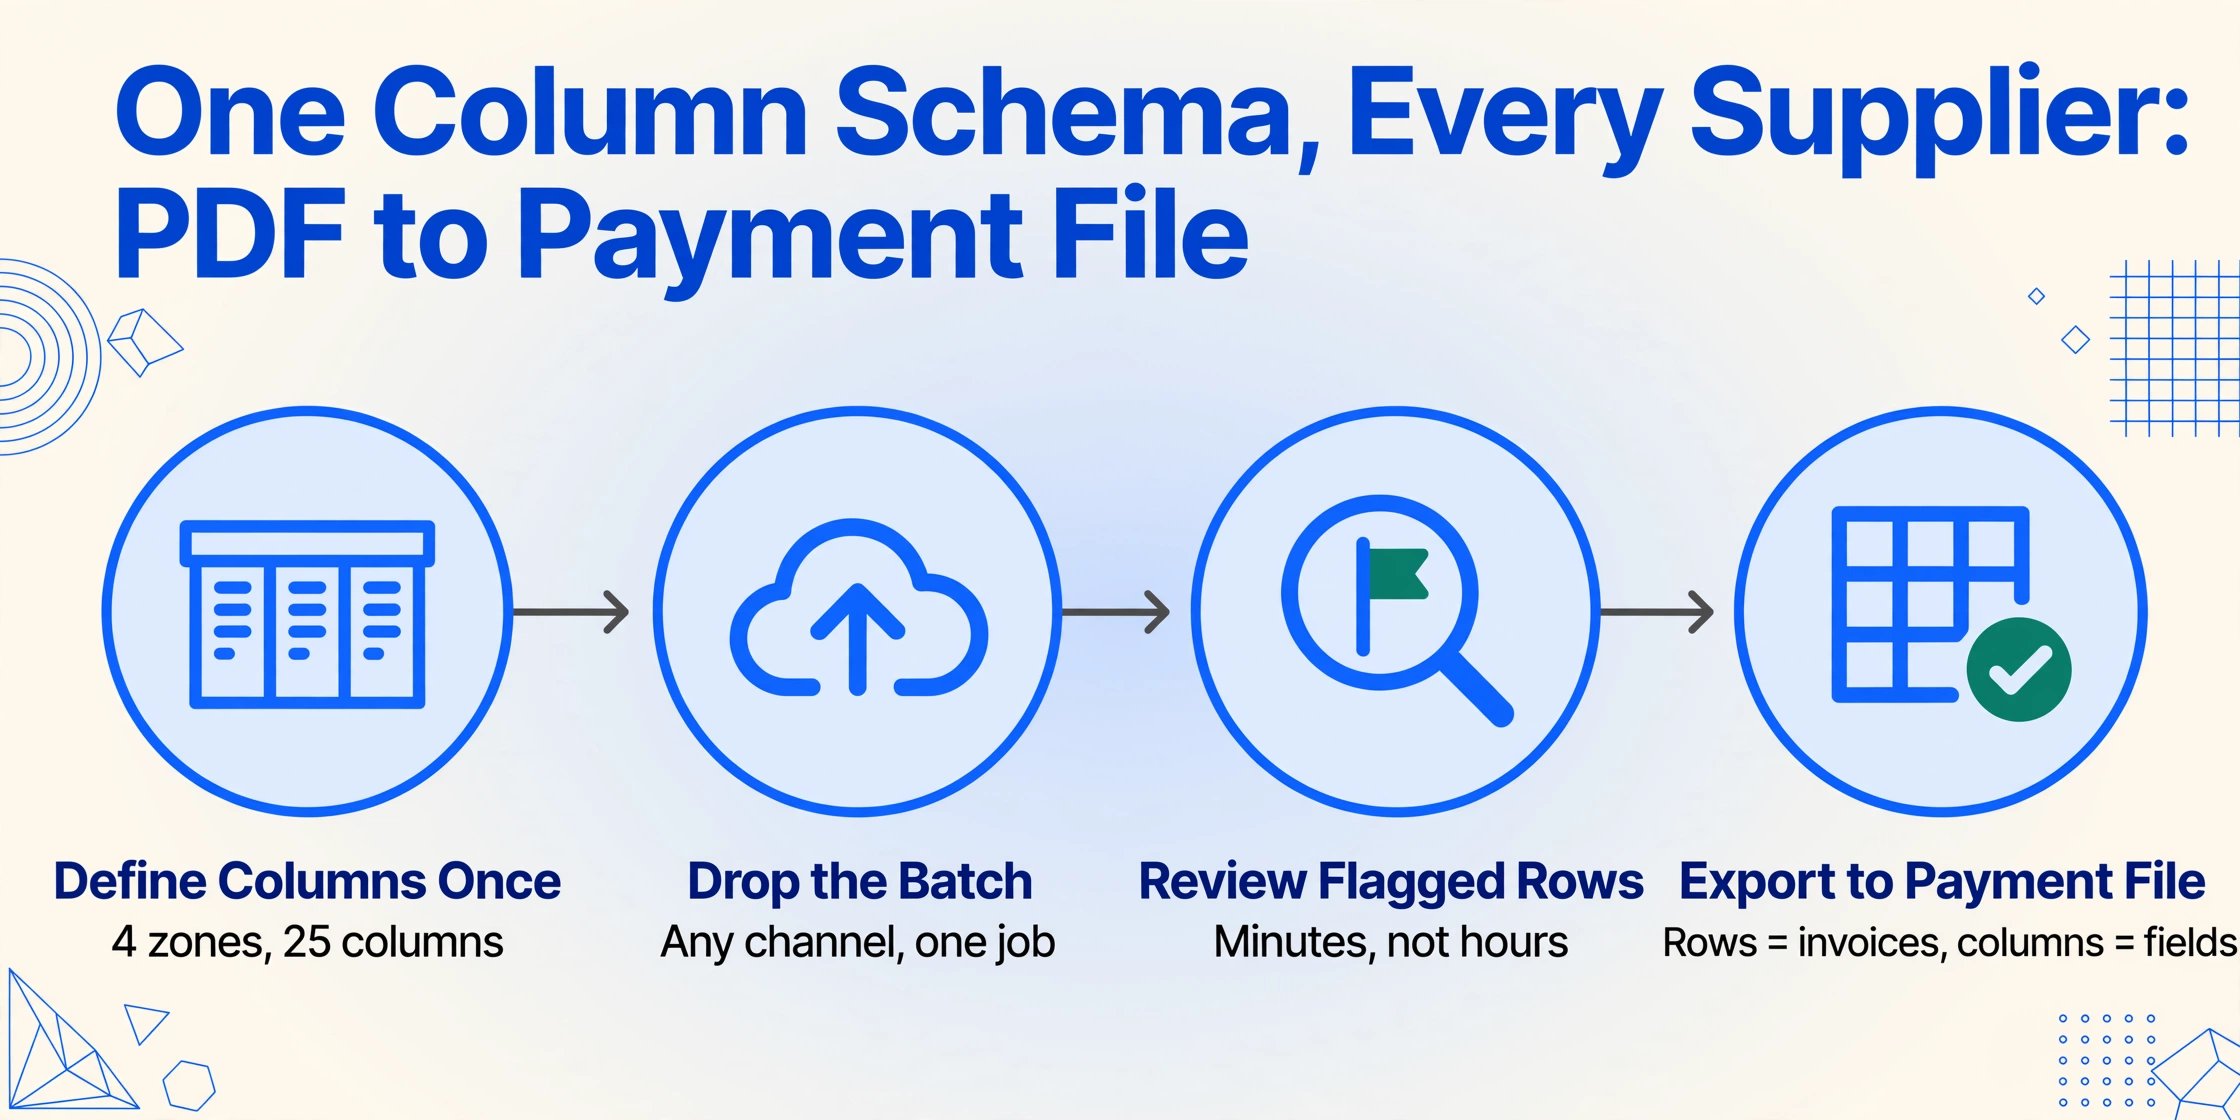
手作業による請求書からスプレッドシートへの転記を置き換えるこのワークフローは、一度定義すれば、すべての仕入先、すべての請求書フォーマット、そして毎月末のバッチに適用されます。これは仕入先ごとの設定プロセスではありません。列スキーマは、送信元に関係なく、APチームが請求書から必要とするものを捕捉します。AIが各ドキュメントを読み取り、スキーマに入力し、出力は毎回同じ列に配置されます。
日本語の請求書抽出列を一度だけ定義する
フィールド名を列ヘッダーとして入力する。完全な日本語請求書抽出には、実用的な列セットは4つのゾーンをカバーする: ヘッダー — 請求書番号、発行日、取引年月日、発行元; 明細行 — 品名、数量、単位、単価、金額; 税・コンプライアンス — インボイス登録番号、10%対象額、10%消費税、8%対象額、8%消費税、合計金額、源泉徴収区分; 支払・銀行 — 振込先銀行名、支店名、口座種別、口座番号、口座名義、支払条件、振込手数料負担。決済日、支払遅延月数、正味支払額、税率の計算列を追加する。これはカスタム列抽出を使用する: APスプレッドシートの構造に一致する列で出力スキーマを定義し、AIは各フィールドが特定のテンプレート上のどこにあるかではなく、その意味を理解することで、あらゆる仕入先の請求書上の各フィールドを特定する。
月末の請求書をすべて一括アップロードする
すべての仕入先請求書 — メールのPDF、仕入先ポータルからダウンロードした請求明細書、郵送で受け取った紙の請求書のスキャン、手書き請求書のスマホ写真 — を1つのアップロードにドロップする。バッチ処理はこれらを1つのジョブとして扱う: 各請求書は列スキーマに従って個別に処理され、すべての結果は請求書ごとに1行の1つのスプレッドシートに統合される。20〜40社の仕入先からの30〜60枚の請求書は、それぞれ異なる請求システムの異なるレイアウトであり、1回の実行で処理される。AIは、仕入先ブロック、宛先ブロック、日付フィールド、明細テーブル、小計/税/合計フッター、銀行振込詳細ブロックという構造パターンを認識して各文書を請求書として識別し、文書内の関連データを特定して定義済み列に入力する。仕入先ごとのテンプレートは不要。フォーマットごとのトレーニングも不要。入力が30の異なる請求システムからの60の異なる文書であっても、出力は1つのファイルである。
抽出を検証する — データを再入力しない
AIがすべての列に入力する。このステップでの作業は検証であり、作成ではない。AIが低い信頼度でフラグを付けたフィールドをスプレッドシートで確認する — ページ端で切れたT番号、予期しない形式で表示された元号日付、曖昧な文字を含む手書きの明細行など。抽出ではこれらを人間によるレビューのためのフラグ付き行として表示する。検証には数分かかる。手動作成 — 30枚の請求書PDFをそれぞれ開き、同じフィールドを別の画面に入力する — には数時間かかる。両者の差こそが抽出レイヤーの価値である。
Excelにエクスポートして下流ワークフローに供給
統合結果をExcelファイル(XLSX)としてダウンロードする。出力は3つのパイプラインに供給される。会計ソフトへのインポート — 構造化された列が弥生会計、freee、マネーフォワード クラウド会計、または勘定奉行に直接インポートされ、仕入帳の仕訳が作成される。支払バッチの作成 — 銀行振込明細列(銀行名、支店、口座種別、口座番号、口座名義人)と正味支払額列が、全銀フォーマットの支払バッチファイルの入力となり、銀行のインターネットバンキングシステムが振込アップロードとして受け付ける。消費税申告 — 税率別にグループ化された消費税列が消費税申告に供給され、10%と8%の合計がすでに分離・小計されている。各パイプラインは、システムごとに個別に入力するのではなく、一度抽出されて3回再利用された構造化データを受け取る。
ファイルは安全に処理され、保存されることはありません。
月末APのバッチ処理
国内の30〜50社の仕入先から仕入れを行う日本企業の月末APでは、仕入先請求書を3つのチャネルで受け取る。請求ソフトを使用する企業からのメールPDF、仕入先ポータル(大手商社やメーカー向け)からダウンロードしたPDF、郵便で届きスキャンまたは撮影された紙の請求書である。3つのチャネルすべてが月の同じ週に同じデスクに集約され、すべて同じAP処理サイクルに投入される。
バッチ処理とは、これらの請求書すべてを——送信元チャネル、仕入先、レイアウトに関係なく——単一のジョブとして処理することを意味する。列スキーマはバッチ内のすべてのドキュメントに適用される。出力は1つのスプレッドシートで、各行が1つの請求書、各列が1つの抽出フィールドに対応する。3つのチャネルと20〜30の異なる請求システムから届いた30〜50枚の請求書が、統一された構造を持つ単一のファイルに集約される。
バッチ処理が変える3つの運用上の決定事項:
APチームは再入力から検証へとシフトする。抽出がスプレッドシートを埋め、AP担当者の仕事はフラグ付き項目(低信頼度とマークされたT番号、不自然に読める銀行支店名、誤っているように見える計算済み支払遅延など)を列でスキャンすることであり、ゼロからデータを作成することではない。検証はバッチあたり数分で完了する。作成——各PDFを開き、正しいフィールドを見つけ、別の画面に入力する——には数時間かかる。
スプレッドシートは、下流の3つのシステムにとって単一の真実の源となる。会計ソフトは仕入仕訳データを取得する。銀行システムは支払バッチデータを取得する。税務申告は消費税の入力データを取得する。3つのシステムが3つの別々の手入力作業ではなく同じ抽出データに依存する場合、あるシステムの不一致は抽出出力に遡って追跡できる——3つの独立したデータ入力作業のうちの1つのタイプミスに起因するのではない。
同じ列スキーマは翌月も機能する。仕入先が請求書レイアウトを変更するかもしれない。新しい仕入先が追加されるかもしれない。スキーマ——各フィールドの意味によって定義され、表示位置ではない——は更新する必要がない。バッチ処理ガイドでは、振込先情報、源泉徴収計算、支払日別にグループ化された支払スケジュールを含む30枚の請求書の例を解説する。
全銀フォーマット: スプレッドシートの列から銀行が受け付ける一括振込ファイルへ
全銀フォーマットは、全国銀行資金決済ネットワークが標準化した固定長ファイル形式であり、企業がインターネットバンキング画面で1件ずつ入力する代わりに、複数の振込を1回のアップロードで提出できるようにするものです。主要な日本の銀行はすべて、法人向けインターネットバンキング(FB)サービスを通じて、この形式での一括振込を受け付けています。
この形式は1行120バイト、Shift-JISエンコードで、4つのレコードタイプがあります:
| レコード種別 | 識別子 | 内容 | 主要フィールド |
|---|---|---|---|
| ヘッダーレコード | 1 | 振込元銀行および口座情報 | 銀行コード(4桁)、支店コード(3桁)、口座番号(7桁)、振込日(MMDD) |
| データレコード | 2 | 受取人ごとの振込1件につき1レコード | 受取人銀行コード(4桁)、支店コード(3桁)、口座種別(1:普通/2:当座)、口座番号(7桁)、受取人名(カタカナ、30文字)、振込金額(10桁、右詰めゼロ埋め) |
| トレーラーレコード | 8 | 一括合計 | 合計件数(6桁)、合計金額(12桁) |
| エンドレコード | 9 | ファイル終了マーカー | 該当なし |
抽出から全銀フォーマットへの接続は、ファイル変換ではなくデータパイプラインです。抽出結果には、銀行名、支店名、口座種別、口座番号、口座名義人、支払金額がそれぞれ別の列として含まれています。これらの列は、全銀ファイルの各データレコードを埋めるまさにそのフィールドです。銀行コード(4桁)と支店コード(3桁)— 全銀フォーマットで使用される数値識別子で、請求書に記載されたテキスト名とは異なります — は、APチームが一度だけ保守するルックアップテーブル(仕入先の銀行名・支店名から全銀銀行コード・支店コードへのマッピング)で解決できます。
計算列は、抽出中にこのルックアップを実行できます:全銀銀行コード(銀行名マッピングテーブルからルックアップ)。この列の出力には、請求書に表示される銀行名ではなく、全銀データレコードにそのまま使える数値の銀行コードが含まれます。スプレッドシートから全銀への変換 — 抽出出力列から固定長120バイト形式へ — は、スプレッドシートの数式または簡単なスクリプトで実行できます。抽出は、設計されたとおりのことを行います:構造化されたデータを列で生成します。支払いバッチ生成は、その列を入力として消費します。
全国銀行資金決済ネットワークが正式な全銀システム仕様書を公開しています(PDF)。各銀行は独自のFBアップロード形式仕様を公開しており、具体的な文字エンコーディング(JISまたはShift-JIS)、フィールドのパディング規則(数値フィールドは右詰めゼロ埋め、名称フィールドは左詰めスペース埋め)、および空白でよいフィールドを指定しています。抽出出力はフォーマット非依存です — 列を生成します。APチームまたはスクリプトが、会社が使用する銀行の全銀仕様に合わせてそれらの列をフォーマットします。
インボイス制度コンプライアンスを構造化抽出で実現
インボイス制度により、すべてのAPチームが各仕入先請求書に対して実行しなければならないコンプライアンス検証手順が3つ新たに追加されました:
- 登録番号の検証 — 請求書のT+13番号が仕入先に属し、国税庁の公的登録簿と一致し、失効または取消されていないことを確認します。
- 税率区分の分離 — 請求書が8%軽減税率の品目と10%標準税率の品目を正しく分離し、税率別の小計と税額が算術的に正しいこと(課税標準×税率、端数切り捨て)を確認します。
- 経過措置控除の計算 — 未登録の仕入先からの請求書について、経過措置スケジュールに従って仕入控除額を計算します(2026年9月までは80%控除、2029年9月までは50%、その後はゼロ)。
この制度以前は、AP担当者は2つのことを検証していました:請求書の合計が正しいか、仕入先がマスターファイルに存在するか。現在、担当者は請求書ごとに3つの追加のコンプライアンス次元を検証する必要があります。月末に30〜50件の請求書がある場合、2023年10月以前には存在しなかった90〜150件の追加検証チェックが発生します。2023年のインボイス制度改革が経理処理を困難にした分析では、制度改革前後の検証チェックリストの変化を詳しく説明しています。
構造化抽出は、これらのチェックの機械的な部分を吸収します。登録番号の列により、国税庁の登録簿に対する単一列ルックアップで検索可能になります。税率別小計の計算列により、仕入先の記載数値と直接比較できます。仕入先のインボイス制度登録状況の列は、経過措置控除の計算が適用されるかどうかを示します。APチームは依然として検証を行います — ただし検証とは、抽出データをスプレッドシートのソースデータと比較することであり、各請求書の税区分を読んで電卓で税率別の算術計算を行うことではありません。日本の適格請求書の抽出に関する完全ガイドでは、検証ワークフロー — 登録番号のクロスチェック、税率区分の算術、経過措置控除の計算 — を詳細に説明しています。
これらの記事の関連性:日本の請求書クラスター
このガイドは、日本の請求書(請求書)抽出をあらゆる角度からカバーする6つの記事のクラスターのハブ記事です。ハウツー、バッチ処理、問題分析、コスト、よくある間違い、そしてこの完全なリファレンスです。各記事は単独でも成立する次元をカバーしていますが、クラスター全体から文脈を得ることでより価値が高まります。以下がその構成です:
ハウツー:フィールドレベル抽出チュートリアル
ステップバイステップの抽出ガイドでは、実践的なワークフローを説明します。請求書番号から振込先口座番号までの25列を一度定義し、サプライヤーの請求書のレイアウトに関係なく同じスキーマを適用します。iframeデモ、支払条件の解析と源泉徴収計算のための計算列の定義、会計ソフトウェアへのエクスポートパイプラインも含まれます。最初の日本の請求書バッチを処理する場合は、ここから始めてください。
バッチ:30枚の請求書、1つの支払い準備済みファイル
バッチ処理ガイドでは、月末のワークフローを説明します。30枚の請求書を1つのバッチに投入し、振込先の銀行情報を別々の列に取得し、源泉徴収を事前計算し、消費税を税率別に分割します。抽出出力から支払いバッチ作成までの全チェーンをカバーします。これは、構造化された銀行列が振込アップロードファイルになるステップです。
問題:30社のベンダーにわたる締日デッドライン
締日支払い期限分析では、異なる締日慣行を持つ30社のサプライヤーが、支払いカレンダーでは解決できないキャッシュフロー予測問題を生み出す理由を分析します。また、支払条件テキストから締日を抽出することで、不透明な文字列を計算可能なフィールドに変換し、数式でスケジュールできるようにする方法も説明します。
コスト:決済サイクルごとの手動処理コスト
手動の請求書処理のコスト分析では、月末サイクルごとの人件費を定量化します。銀行情報の再入力、源泉徴収の計算、消費税の検証に費やす時間と、同じ作業を数分で行う抽出レイヤーのコストを比較します。毎月30〜60枚のサプライヤー請求書を処理する中小企業にとって、サイクルごとの節約は円と時間で測定可能です。
間違い:税務申告に到達する消費税エラー
一般的な消費税データ入力エラーガイドでは、具体的な間違いをカバーしています。8%の項目が10%として分類される、項目ごとの丸めと税率区分ごとの丸めの差異による端数処理の不一致、取引を誤った報告期間に移す元号変換エラーなどです。また、計算列を使用した抽出が、税務調整ステップではなくデータ作成ステップでこれらのエラーをどのように検出するかも説明します。
関連する2つの記事は、日本の請求書クラスターを超えて、請求書と抽出ロジックを共有する隣接するドキュメントタイプに拡張されます:
銀行通帳の抽出
日本の銀行通帳抽出の完全ガイドでは、支払いのもう一方の側面、つまり銀行が印字する取引記録を扱う。個人事業主や小規模企業が税務申告の主要な財務記録として利用するものだ。通帳の5列台帳形式、ATM印字のドットマトリクス文字、残高照合ロジックは、請求書と同様に和暦変換や振込取引の識別といった抽出上の課題を共有している。
オーストラリアBASの抽出
オーストラリアBASデータ抽出の完全ガイドでは、日本の請求書と構造上の課題を共有する別の国の税務文書、Business Activity Statementを扱う。単一の文書から複数の税種を抽出し、それぞれを別々の税務申告に送り込むという構造的な課題だ。列定義のアプローチは同じだが、スキーマは異なる。
よくある質問
AI抽出はスマートフォンの写真で撮影した日本の請求書データを読み取れますか?
はい。基盤となるビジョン言語モデルは、テキスト優先のOCRではなく、画像を視覚入力として処理する。オフィスの照明下で多少の遠近歪みがある状態で撮影した紙の請求書のモバイル写真も、有効な入力だ。AIは、完全にフラットベッドスキャンされた文書を必要とするのではなく、フィールドがどのように見え、何を意味するかを理解することでフィールドを読み取る。サプライヤーのERP生成PDFで機能する同じ列スキーマは、小規模サービス事業者の手書き請求書の写真でも機能する。抽出はフィールドの位置ではなく、フィールドの識別情報を読み取るからだ。
請求書の支払条件文字列が通常とは異なる形式の場合、どうなりますか?
解析ロジックを定義する計算列(“20日締” → 支払日20日、“月末締” → 支払日31日)は、標準的なパターンに対応します。非標準的な条件(“15日締翌々月20日払い”や、まったく異なる表現の条件)の場合、抽出は元のテキストを支払条件列に出力し、計算列は手動レビュー対象としてフラグを付けます。APチームは30件中1〜2件のフラグ付き行をレビューするだけで、全請求書の支払条件を手作業で解析する必要はありません。時間の経過とともに計算列のロジックを拡張して新しいパターンに対応すれば、フラグ付き行の数は減少します。
抽出はゆうちょ銀行の口座番号を正しく処理できますか?
はい。推論列が銀行名としてゆうちょ銀行を検出し、抽出時にゆうちょ銀行の記号-番号から7桁の振込口座番号への変換ルールを適用します。出力には、元の口座参照(請求書との照合用)と、変換後の振込口座番号(支払バッチ作成用)の両方が含まれます。ゆうちょ銀行は変換ルールを公式サイトで公開しています。
10%と8%の消費税項目が混在する請求書はどのように処理されますか?
推論列が各明細の説明を読み取り、日本の消費税区分(外食を除く食品・非アルコール飲料 → 8%軽減、その他のほとんどの商品・サービス → 10%標準)に基づいて8%軽減または10%標準に分類します。計算列が各税率区分の小計を算出します。APチームは仕入先が提示した小計と分類を照合します — これは分類ではなく比較のステップです。仕入先が軽減税率対象項目を明示しない請求書の場合、推論による分類が、各請求書PDFを開き直さずに仕入先の合計額の正確性を検証する唯一の方法です。
このガイドと適格請求書抽出ガイドの違いは何ですか?
適格請求書抽出ガイドは、インボイス制度における適格請求書の6つの必須項目に焦点を当てています。経過措置による仕入税額控除スケジュール、国税庁の登録番号検証プロセス、手書き・縦書き請求書特有の課題などが含まれます。このガイドはより広範な請求書抽出の全体像を扱います — APチームが直面するすべての項目、抽出から支払・税務申告までのパイプライン全体、そして適格請求書ガイドでは扱わない全銀フォーマット連携です。コンプライアンス固有の詳細については適格請求書ガイドを、エンドツーエンドのプロセスについてはこのガイドをお読みください。
日本の請求書から明細行(ヘッダー合計だけでなく)を抽出できますか?
はい。本ガイドで説明するカラムスキーマには、ヘッダーおよびフッターフィールドに加えて、明細行レベルのカラム(品名、数量、単位、単価、金額)が含まれています。各明細行は出力スプレッドシートの1行になり、ヘッダーフィールド(請求書番号、仕入先、発行日)が各行に繰り返されるため、すべての明細行を元の請求書にトレースできます。この構造により、請求書合計だけでなく個々の明細行を比較する必要がある三者照合(発注書→納品書→請求書)をサポートします。