일본 청구서 데이터 추출 완전 가이드
AP 및 세무용
일본 청구서에는 미국이나 유럽 청구서 추출 도구에 열 이름이 없는 필드가 약 12개 있습니다. 은행 송금 정보 블록(계좌 정보)만 해도 은행명, 지점명, 계좌 유형, 계좌 번호의 네 필드로, AP 담당자가 공급업체 마스터에 이미 동일한 네 값이 있음에도 매 청구서마다 인터넷 뱅킹 화면에 다시 입력해야 합니다. 지급 조건 문자열(지급 조건)은 “20일 마감 다음 달 말 지급” 같은 복합 텍스트 안에 결제일과 지급 지연일이라는 두 가지 계산 가능한 값을 담고 있으며, 이 값이 비용이 속할 회계 기간을 결정합니다. 원천징수 구분(원천징수 구분)이 있으면 지급자는 송금 전에 10.21%를 공제해야 합니다. 이를 놓치면 공급업체에 그만큼 초과 지급하면서 세무서에는 여전히 납부해야 할 금액이 남게 됩니다. 이 가이드에서는 일본 청구서의 모든 필드, 각 필드의 운영상 의미, 이를 구조화된 스프레드시트로 추출하는 방법, 그리고 그 출력을 지급 배치 생성, 회계 소프트웨어 가져오기, 소비세 신고라는 세 가지 다운스트림 파이프라인에 공급하는 방법까지 전체를 다룹니다. 월말에 서로 다른 청구 시스템과 레이아웃을 사용하는 공급업체들로부터 30~60건을 처리해야 한다면, 이 가이드가 바로 필요한 참고 자료입니다.
핵심 요점
- 추출 도구가 세이큐쇼에서 금액과 날짜를 찾아내면 작업이 완료된 것으로 보고합니다. 이는 모든 청구서에서 찾는 동일한 필드와 동일합니다.
- 하지만 AP 팀이 실제로 뱅킹 화면에 다시 입력하는 네 개의 후리코미사키 은행 필드, 시메비 결제 관행, 겐센 초슈 구분 분류는 건너뛰거나 왜곡됩니다. 그 이유는 미국·EU 청구서 훈련 데이터에 합계 아래 지급 지시 섹션이 포함된 적이 없기 때문입니다.
- 각 일본 필드의 의미에 따라 열을 정의하세요. 후리코미사키를 네 개의 금융 열로, 시메비를 결제일과 지급 지연일로 파싱하고, 겐센을 예/아니오 플래그로 정의하면 동일한 스키마가 서로 다른 레이아웃을 가진 30개 공급업체에서도 동일하게 작동합니다. AI가 템플릿에서 위치가 아니라 필드가 무엇인지 이해하여 필드를 찾기 때문입니다.
일본식 청구서가 다른 점 — 그리고 추출에 중요한 이유
일본식 청구서는 서양 추출 도구가 분석하도록 훈련되지 않은 필드 구조를 가지고 있습니다. 미국 또는 EU 청구서는 헤더에서 라인 항목을 거쳐 합계와 납기일로 이어지며, 일반적으로 4~6개의 추출 열이 지급 계정 워크플로를 처리합니다. 일본식 청구서는 합계 아래에 두 번째 전체 섹션인 지급 지시 블록을 추가합니다. 이는 구매자에게 어느 은행으로 자금을 보낼지, 어떤 결제일 관행이 자금 만기를 결정하는지, 그리고 자금 중 일부를 세무서를 위해 원천징수해야 하는지 여부를 알려줍니다. 문서를 위에서 아래로 읽으며 "청구서 번호"와 "합계"만 찾는 일반 추출 엔진은 이 전체 섹션을 건너뛰거나, 더 나쁜 경우 네 개의 개별 은행 필드를 하나의 뒤섞인 텍스트 문자열로 연결합니다.
2023년 10월부터 이 문제는 구조적 차원 외에 규정 준수 차원도 추가되었습니다. 인보이스 제도는 소비세법 제57조의2에 따라 매입 세액 공제 청구를 뒷받침하는 모든 청구서에 6개의 필수 필드를 요구합니다. 이 중 세 가지는 제도 시행 전에는 필수 필드가 아니었습니다. 2025년 3월 기준, 국세청은 약 461만 명의 적격 청구서 발행 사업자가 등록되었다고 보고했습니다. 이들 모두는 모든 청구서에 T+13자리 등록 번호를 포함해야 합니다. 해당 번호가 누락되면 구매자의 매입 세액 공제가 감소하며, 이는 80% 공제 가능에서 0%로 단계적으로 전환되는 경과 일정에 따릅니다.
따라서 추출 작업은 단순히 일본어 텍스트를 읽는 것이 아닙니다. AP 및 세금에 중요한 열인 문서의 필드 스키마가 추출 도구가 예상하도록 구축된 스키마와 다르다는 점을 인식하는 것입니다. 해결책은 맞춤 열 추출입니다. AP 스프레드시트와 일본 비즈니스 로직에 맞는 열 이름으로 출력 스키마를 직접 정의한 다음, AI가 각 필드의 의미를 이해하여 위치를 찾도록 하는 것입니다. 특정 공급업체의 청구서 템플릿에서 어디에 있는지가 아니라요. 동일한 열 스키마는 대형 무역 회사의 ERP 생성 PDF, 지역 서비스 제공업체의 Word 템플릿을 인쇄하여 스캔한 문서, 또는 손으로 작성한 양식의 모바일 사진 등 모든 청구서에 적용됩니다. 각 열 정의가 무엇이어야 하는지, 그리고 일본 관행을 포착하는 추론 로직을 작성하는 방법을 알아보려면 단계별 일본식 청구서 추출 튜토리얼을 참조하십시오. 이 튜토리얼에서는 25개의 열을 한 번 정의하고 모든 공급업체에 걸쳐 재사용하는 방법을 설명합니다.
이 가이드의 나머지 부분에서는 각 열이 추출해야 하는 내용과 일본식 청구서 고유의 필드가 열 정의부터 지급 배치 출력, 소비세 신고 제출에 이르기까지 전체 추출 워크플로를 어떻게 형성하는지 다룹니다.
세이큐쇼의 필드 구조
일본 청구서는 네 가지 논리 영역으로 구성됩니다. 처음 두 영역인 헤더와 라인 항목은 전 세계 청구서에 공통적으로 존재합니다. 마지막 두 영역인 세금 및 규정 준수, 지급 및 은행 정보는 서양식 추출 엔진이 예상하는 필드 스키마와 차이가 나는 부분입니다. 다음은 다양한 공급업체로부터 세이큐쇼를 처리할 때 AP 팀이 접하게 되는 모든 필드를 영역별로 정리한 것입니다.
헤더 및 식별 정보
- 請求書番号 — "2026-07-001"과 같이 날짜-일련번호 조합으로 표시되는 고유 식별자입니다. AP 조회 및 지급 추적의 기본 키 역할을 합니다. 이 번호가 없으면 은행의 후리코미사키 확인 내역을 원본 청구서와 대조하는 작업이 물량이 늘어날수록 복잡해지는 조정 문제로 이어집니다.
- 発行日 — 청구서가 발행된 날짜입니다. 지급 조건이 청구 마감일을 기준으로 할 때 지급 기한을 계산하는 시작점으로 사용됩니다.
- 取引年月日 — 실제 거래가 발생한 날짜입니다. 발행일과 다를 수 있으며, 종종 일본 연호 형식(令和8年)으로 표시됩니다. 추출 시 연호 날짜를 다운스트림 회계에서 사용할 수 있도록 서양력(ISO 8601)으로 변환해야 합니다.
- 発行元 — 판매자의 회사명, 주소 및 연락처 정보입니다. 종종 회사 직인이 함께 표시됩니다.
- 宛名 — 수신 회사 및 부서명이며, 일반적으로 존칭 접미사 御中가 뒤따릅니다.
라인 항목 및 가격
- 品名 — 제품 또는 서비스 설명입니다. 공급업체의 청구 시스템이 구매 주문서와 동일한 제품을 다르게 설명하여 VLOOKUP #N/A 문제를 발생시킬 수 있습니다. 品番 및 摘要와 같은 선택적 필드가 포함됩니다.
- 数量 — 단위(単位)와 함께 표시됩니다: 個(개), 式(로트/세트), kg, m, 時間(시간). PO와 청구서 간의 단위 불일치는 정규화가 필요합니다.
- 単価 — 일반적으로 세금 별도 가격입니다. 세금 포함 가격으로 전환된 청구서의 경우 AP가 역으로 세금을 계산하여 PO와 대조해야 합니다.
- 金額 — 세전 라인 합계입니다. 종종 소계와 함께 표시됩니다.
세금 및 법규 준수
- 인보이스 등록 번호 — "T" + 13자리. 2023년 10월부터 필수입니다. 구매자가 해당 공급업체로부터의 구매에 대해 전액 매입세액 공제를 청구할 수 있는 유일한 방법입니다. 번호가 누락되거나 올바르지 않으면 경과적 매입세액 공제 일정이 적용됩니다: 2026년 9월까지 80% 공제, 2029년 9월까지 50%, 이후 0%. 이 시스템에 대한 자세한 내용은 일본 적격 청구서 추출 완벽 가이드를 참조하십시오.
- 소비세액 — 세율별로 별도 기재: 10% 표준세율 및 8% 경감세율. 청구서에는 각 세율 구간별 과세 표준과 세액이 명시되어야 합니다. 구매자의 소비세 신고에는 이러한 세율별 합계가 입력 데이터로 필요합니다.
- 겐센 초슈 쿠분 — 소득세법 제204조에 따라 적격 전문 서비스 제공업체의 청구서에 표시됩니다. 지급자는 지급 금액의 10.21%를 원천징수하여 판매자를 대신해 세무서에 납부합니다.
지급 및 은행 정보
- 후리코미사키 — 네 개의 개별 필드: 은행명, 지점명, 구좌 종별, 구좌 번호. 다섯 번째 필드인 구좌 명의도 자주 나타납니다. 이는 AP 담당자가 인터넷 뱅킹 화면에 다시 입력하는 필드로, 공급업체 마스터에 이미 존재하는 데이터와 동일합니다. 유초 은행의 경우 계좌 참조에 기호-번호 형식을 사용하며, 이를 7자리 이체 계좌 번호로 변환해야 합니다.
- 시하라이 조켄 — 간결한 일본어 구문으로 표현됩니다. "20일 마감 다음 달 말일 지급"은 청구 기간이 20일에 마감되고 지급 기한이 다음 달 말일까지임을 의미합니다. 여기에는 계산 가능한 두 가지 값, 즉 결제일과 지급 지연 기간이 포함됩니다. 결제일은 회계연도 분류를 결정합니다. 예를 들어 20일 마감 조건에서 3월 22일자 청구서는 당해 회계연도가 아닌 다음 회계연도에 속합니다.
- 송금 수수료 부담 — 은행 송금 수수료를 누가 부담하는지 명시합니다. 청구서에 "귀사 부담"이라고 명시된 경우, AP는 송금 총액에 수수료를 추가해야 합니다.
이 구조는 추측이 아닙니다. 내각부의 적격 청구서 제도 공식 개요에는 6가지 필수 항목이 나열되어 있습니다. 그러나 추출 작업은 필수 항목을 넘어섭니다. 가장 많은 수동 AP 시간을 소모하는 필드는 법적 요구사항이 아닌 관행에 의해 포함됩니다. 이것이 일본 청구서 처리를 서양식과 구조적으로 다르게 만드는 요소이며, 일반적인 추출이 가장 먼저 실패하는 지점입니다. 추출 작업을 수동으로 수행할 때의 비용을 이해하려면 일본 중소기업의 수동 세이큐쇼 처리 비용 분석에서 월말 마감 주기별 인건비를 엔화로 분석합니다.
핵심 추출 인사이트: 일본식 청구서는 일본어 텍스트가 있는 영어 청구서가 아닙니다. 필드 스키마가 다른 문서이며, 추출 열 정의가 해당 스키마를 반영해야 합니다. 그렇지 않으면 AP 팀이 여전히 다시 입력해야 하는 데이터 테이블이 출력됩니다.
후리코미사키: 하나의 텍스트 블록이 아닌 네 개의 개별 은행 필드가 필요한 이유
은행 송금 정보 블록은 일본 AP에서 가장 반복적인 데이터 입력 작업입니다. 공급업체의 청구서에는 은행명, 지점명, 계좌 유형, 계좌 번호라는 네 개의 라벨이 지정된 필드가 있으며, AP 담당자는 인터넷 뱅킹 화면을 열고 모든 청구서에 대해 하나씩 입력합니다. 동일한 네 가지 값은 이미 회계 소프트웨어의 공급업체 마스터에 존재합니다. 월말에 30장의 청구서가 도착하면 AP 팀은 해당 네 필드를 30번 다시 입력합니다. 즉, 새로운 정보를 추가하지 않고 기존 마스터 데이터를 한 화면에서 다른 화면으로 복제하는 120개의 개별 입력입니다.
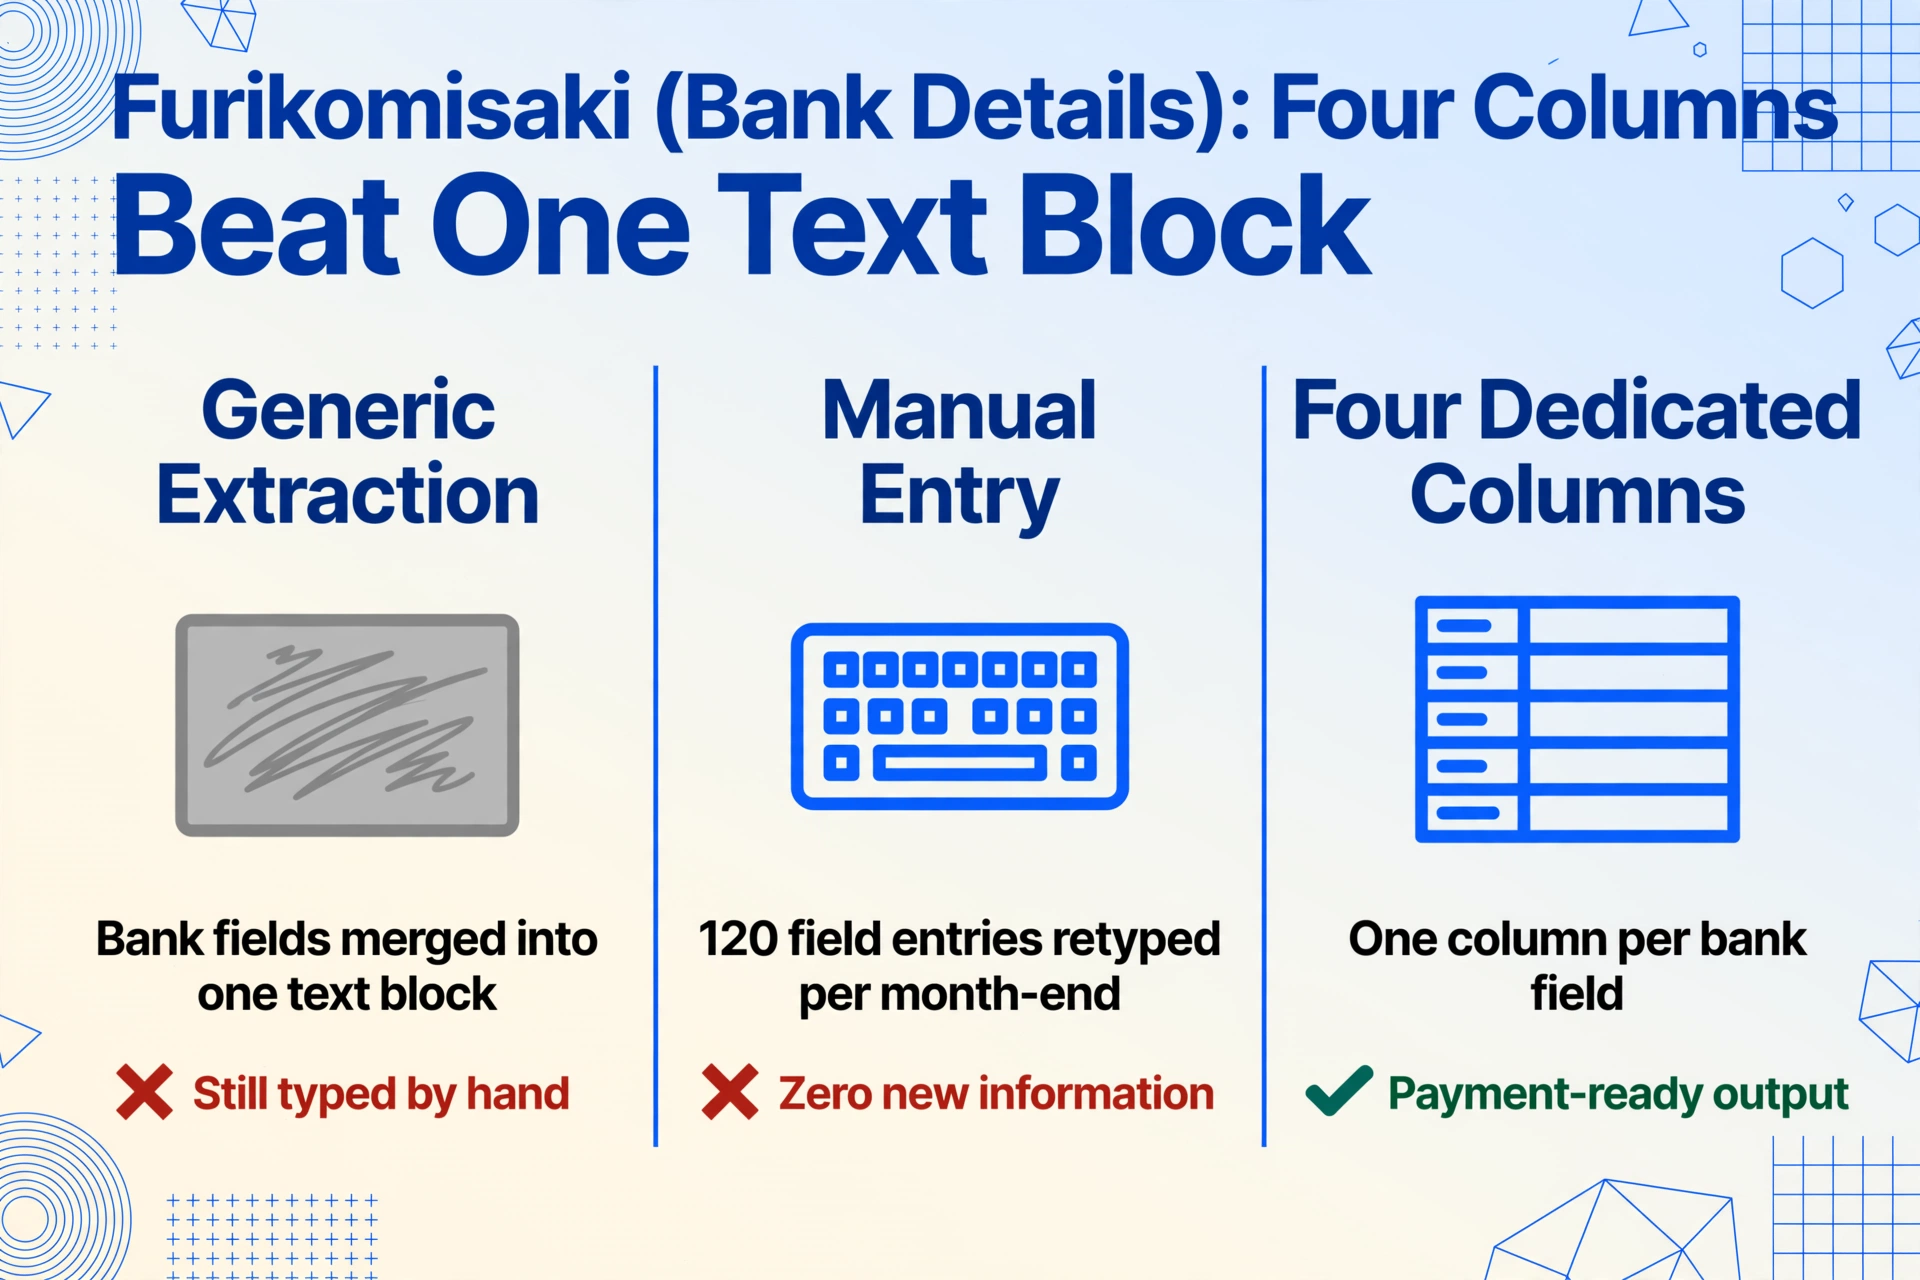
대부분의 일반 추출 도구는 “지급 방법”이 단일 필드인 미국 및 EU 청구서 데이터 세트로 학습되었으며, 청구서에 은행 정보를 라우팅하는 개념은 구조화된 필드 세트로 존재하지 않습니다. 이러한 도구 중 하나에 세이큐쇼를 넣으면 은행 정보 블록이 건너뛰어지거나 하나의 비정형 텍스트 필드로 연결됩니다. AP 팀은 여전히 PDF를 열어 각 필드를 복사하여 붙여넣어야 합니다.
추출 접근 방식은 후리코미사키 블록을 네 개의 전용 열로 분리하고 — 각 열이 하나의 필드를 독립적으로 캡처하며 — 유초 은행(ゆうちょ銀行) 변환을 처리하기 위해 추론 열을 사용합니다. 유초 은행 계좌 시스템은 상업 은행 후리코미 시스템에 필요한 7자리 송금 계좌 번호와 다른 기호-번호(記号-番号) 쌍을 사용합니다. 추론 열 — AI가 페이지에 인쇄된 값을 찾는 대신 문서 컨텍스트를 기반으로 값을 계산하는 열 — 추출 중에 변환을 처리합니다: 송금 계좌 번호. 열 정의는 한 번 실행되며 모든 배치에 적용됩니다.
네 개의 구조화된 은행 열은 단순한 조직적 편의가 아닙니다. 이는 지급 배치 파일의 입력 데이터이며, 여기서 젠긴 포맷(全銀フォーマット)이 워크플로에 들어옵니다. 배치 처리 가이드는 전체 체인을 다룹니다: 한 배치에서 처리된 30장의 청구서 → 별도 열의 후리코미 은행 정보 → 은행이 수락 가능한 지급 배치 파일로 형식화된 출력. 추출은 단순히 입력을 줄이는 것이 아니라, 추출로 입력된 동일한 은행 필드가 은행 업로드 화면에서 수집되는 동일한 은행 필드인 데이터 파이프라인을 만듭니다.
시하라이 조켄: 결산 기간을 결정하는 마감일
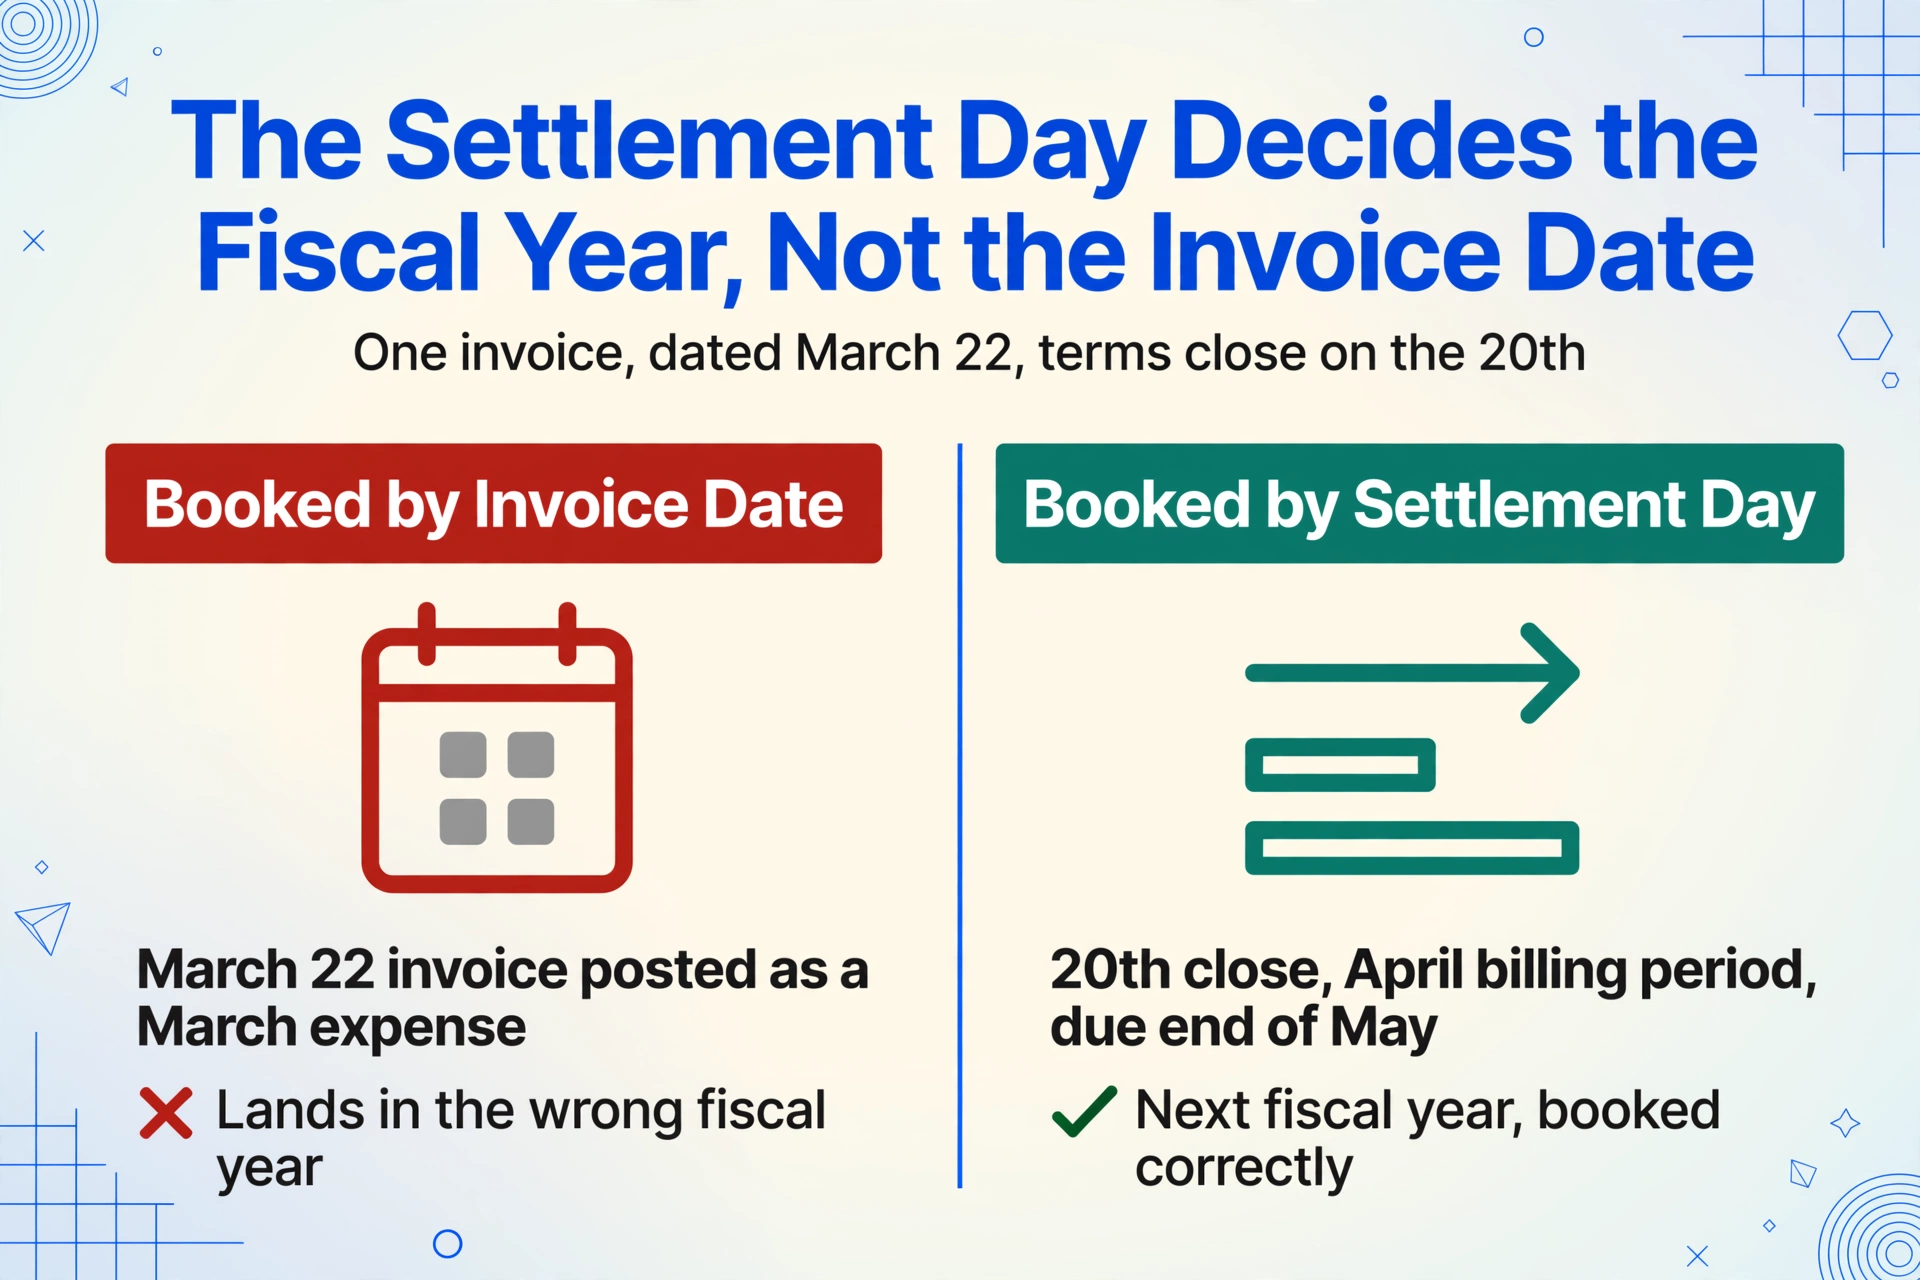
일본의 지급 조건은 AP 팀이 한눈에 읽을 수 있지만 일반적인 추출 도구는 불투명한 텍스트로 읽는 간결한 구문입니다. "20일締翌月末払い"는 청구 기간이 매월 20일에 마감되고 지급이 다음 달 말까지 이루어져야 함을 의미합니다. 이 문자열은 두 가지 계산 가능한 값을 인코딩합니다: 마감일(20)과 지급 지연 기간입니다. 건설 및 제조업에서 흔히 볼 수 있는 "月末締翌々月末払い"는 월말 마감, 다음 다음 달 말까지 지급을 의미합니다.
마감일은 형식적인 것이 아니라 실무적으로 중요합니다. 20일 마감 조건에서 3월 18일자 청구서는 3월 청구 기간에 속합니다: 지급은 4월 말, 비용은 3월 31일에 장부를 마감하면 현재 회계 연도에 귀속됩니다. 동일한 조건에서 3월 22일자 청구서는 4월 청구 기간에 속합니다: 지급은 5월 말, 비용은 다음 회계 연도에 귀속됩니다. 회계 연도 분류를 결정하는 것은 청구서 날짜나 달력 월 경계가 아니라 마감일입니다. 시메비 지급 기한 분석은 30개 공급업체가 각각 다른 시메비 날짜를 사용할 때 마감일 관행이 현금 흐름 예측에 어떻게 연쇄적으로 영향을 미치는지에 대한 전체적인 운영 영향을 다룹니다.
계산 열 — AI가 정의된 수식을 사용하여 추출 중에 값을 계산하는 열 — 지급 조건을 구조화된 필드로 분할합니다: 마감일 및 지급 지연 개월 수. 이 두 열은 실제 지급 기한을 계산하는 스프레드시트 수식에서 사용됩니다 — 출력 스프레드시트의 지급 기한 열은 입력된 것이 아니라 자유 텍스트 필드에서 추출된 것도 아니며, 청구서 날짜에 파싱된 조건을 더하여 파생됩니다. 해당 날짜 열은 현금 흐름 예측과 지급 일괄 일정에 공급되며, 둘 다 텍스트 문자열이 아닌 실제 달력 날짜가 필요합니다.
겐센 초슈 쿠분: 지급자가 송금 전에 원천징수해야 하는 경우
일본의 원천징수 제도는 수취인이 적격 전문 서비스 제공자일 때 지급자에게 원천징수 의무를 부과합니다. 세무사(税理士), 공인회계사(公認会計士), 변호사(弁護士), 사법서사(司法書士), 디자이너(デザイナー), 작가(著作家) 및 소득세법(所得税法) 제204조에 정의된 기타 여러 직종은 지급액의 10.21%를 원천징수 대상으로 합니다. 지급자는 원천징수액을 공제하여 세무서에 납부하고, 공급자에게 나머지 89.79%를 지급합니다.
적격 전문가의 세이큐쇼에는 일반적으로 원천징수 표시가 있습니다. 공제액이 기재된 "源泉徴収額" 항목이 있거나 "源泉徴収あり"와 같은 분류 표시가 있습니다. 원천징수가 포함된 청구서는 AP 지급 계산을 변경합니다. 순 지급액은 청구서 총액에서 원천징수액을 뺀 금액이며, 세금 예치금에 대한 별도의 부채 항목을 계상해야 합니다. 추출 과정에서 원천징수가 포착되지 않으면 AP 팀은 적격 청구서 각각을 개별적으로 재검토하고, 공제액을 수동으로 계산한 후 지급액을 조정해야 합니다. 청구서 60건에 걸친 이 청구서별 산술 단계는 상당한 AP 시간을 소모합니다.
원천징수 분류(청구서에 겐센 초슈 표시가 있는지 확인; 공급자가 적격 전문가이고 원천징수가 표시된 경우 "해당", 그렇지 않으면 "해당 없음" 출력)으로 정의된 열은 원천징수가 필요한 청구서를 식별합니다. 계산 열(Computed Columns) — 순 지급액 — 은 실제 후리코미사키 송금액을 직접 계산합니다. 이제 지급 배치 파일에는 AP 팀이 적격 청구서 각각에 대해 별도의 계산 단계를 실행하지 않아도 청구서 총액이 아닌 올바른 송금액이 포함됩니다.
인보이스 번호: T+13 등록 번호와 그 존재 이유
적격 청구서 등록 번호는 “T”로 시작하는 13자리 숫자입니다. 등록된 모든 적격 청구서 발행 사업자(QII)는 등록 시 국세청으로부터 이 번호를 부여받으며, 구매자가 소비세 공제에 사용할 모든 청구서에 이 번호를 인쇄해야 합니다. 국세청은 AP 팀이 등록 번호를 확인할 수 있는 적격 청구서 발행 사업자 공개 등록부를 운영하고 있습니다.
등록 번호는 2023년 10월 이전에는 존재하지 않았던 청구서별 검증 단계를 새로 만들었습니다. 청구서를 받은 AP 담당자는 T-번호를 찾아야 합니다. 이 번호는 헤더, 푸터, 여백, 회사 직인 옆의 작은 글씨, 또는 은행 송금 정보 근처의 텍스트 블록에 포함되어 있을 수 있으며, 공급업체의 번호인지 확인해야 합니다. 번호가 없거나 국세청 등록부와 일치하지 않으면 해당 거래에 대한 구매자의 매입세액 공제는 80% 공제에서 50%, 이후 0%로 단계적으로 축소되는 경과 규정에 따라 감액됩니다. 일본 적격 청구서 추출에 대한 전체 가이드는 6가지 필수 항목, 경과 공제 일정, 추출된 T-번호를 단일 열 조회로 국세청 등록부와 대조하는 방법 등 적격 청구서 환경을 심층적으로 다룹니다.
추출 워크플로우에서 등록 번호 열은 정의하기 쉽습니다. AI가 문서를 읽고 페이지 어디에서든 T+13 패턴을 식별하여 열을 채웁니다. 문제는 추출 자체가 아니라 위치 변동성입니다. 모든 공급업체가 T-번호를 다른 위치에 배치합니다. 등록 번호가 고정 영역에 있을 것으로 예상하는 템플릿 기반 도구는 공급업체가 푸터에 배치한 청구서에서는 이를 놓칩니다. 의미론적 추출 — 필드가 어디에 있는지가 아니라 무엇인지를 이해하여 위치를 찾는 방식 — 은 위치와 관계없이 이를 포착합니다. 동일한 원칙이 청구서의 모든 필드에 적용되며, 이것이 단일 열 스키마로 30개 공급업체의 30가지 다른 레이아웃을 처리할 수 있는 이유입니다.
소비세: 세금 신고를 위한 이중 세율 추출
일본의 소비세 제도는 10% 표준 세율과 8% 경감 세율의 두 가지 세율을 사용합니다. 적격 청구서에는 각 세율 구분별로 과세 표준액과 세액을 별도로 기재해야 하며, 분수는 원 단위로 절사합니다. 두 세율을 합산한 단일 총액은 적격 청구서 제도에 부합하지 않습니다.
추출의 핵심 과제는 분류입니다. 혼합 세율 품목이 포함된 청구서는 각 품목을 올바른 세율 구분에 배정하여 세율별 소계가 공급업체가 명시한 합계와 일치하는지 검증할 수 있어야 합니다. 공급업체가 실수로 10% 품목을 8% 열에 포함시킨 경우, 구매자의 소비세 신고에서 매입세액 공제를 과다 청구하게 되며, 국세청의 데이터 매칭 엔진은 의도적 허위 신고와 공급업체 오류에 의존한 경우를 구분하지 않습니다.
추론 열은 추출 중 세율 분류를 처리합니다: 세율(품목 설명 기준: 식품/음료 → 8% 경감 세율, 일반 상품/서비스 → 10% 표준 세율, 명시적 수출 관련 → 면세). AI가 각 품목 설명을 읽고 일본의 이중 세율 규칙을 적용하여 세율 열을 채웁니다. 두 개의 계산 열이 세율별 소계를 계산합니다 — 10% 소계 및 8% 소계 — 이를 청구서에 명시된 각 세율 구분별 소계와 직접 비교할 수 있습니다.
소비세 데이터는 추출된 스프레드시트에서 소비세 신고(消費税申告)로 입력 데이터로 흐릅니다 — 10% 과세 합계, 10% 세액, 8% 과세 합계, 8% 세액. 추출 출력이 각 품목을 원천에서 분류하면, 세무사는 분류를 처음부터 수행하는 대신 검증만 하면 됩니다. 일반적인 소비세 데이터 입력 오류 가이드는 세율 분류를 추출 단계가 아닌 수동으로 수행할 때 세금 불일치를 유발하는 특정 오류를 다룹니다.
추출 워크플로우: PDF에서 지급 준비 완료 스프레드시트까지
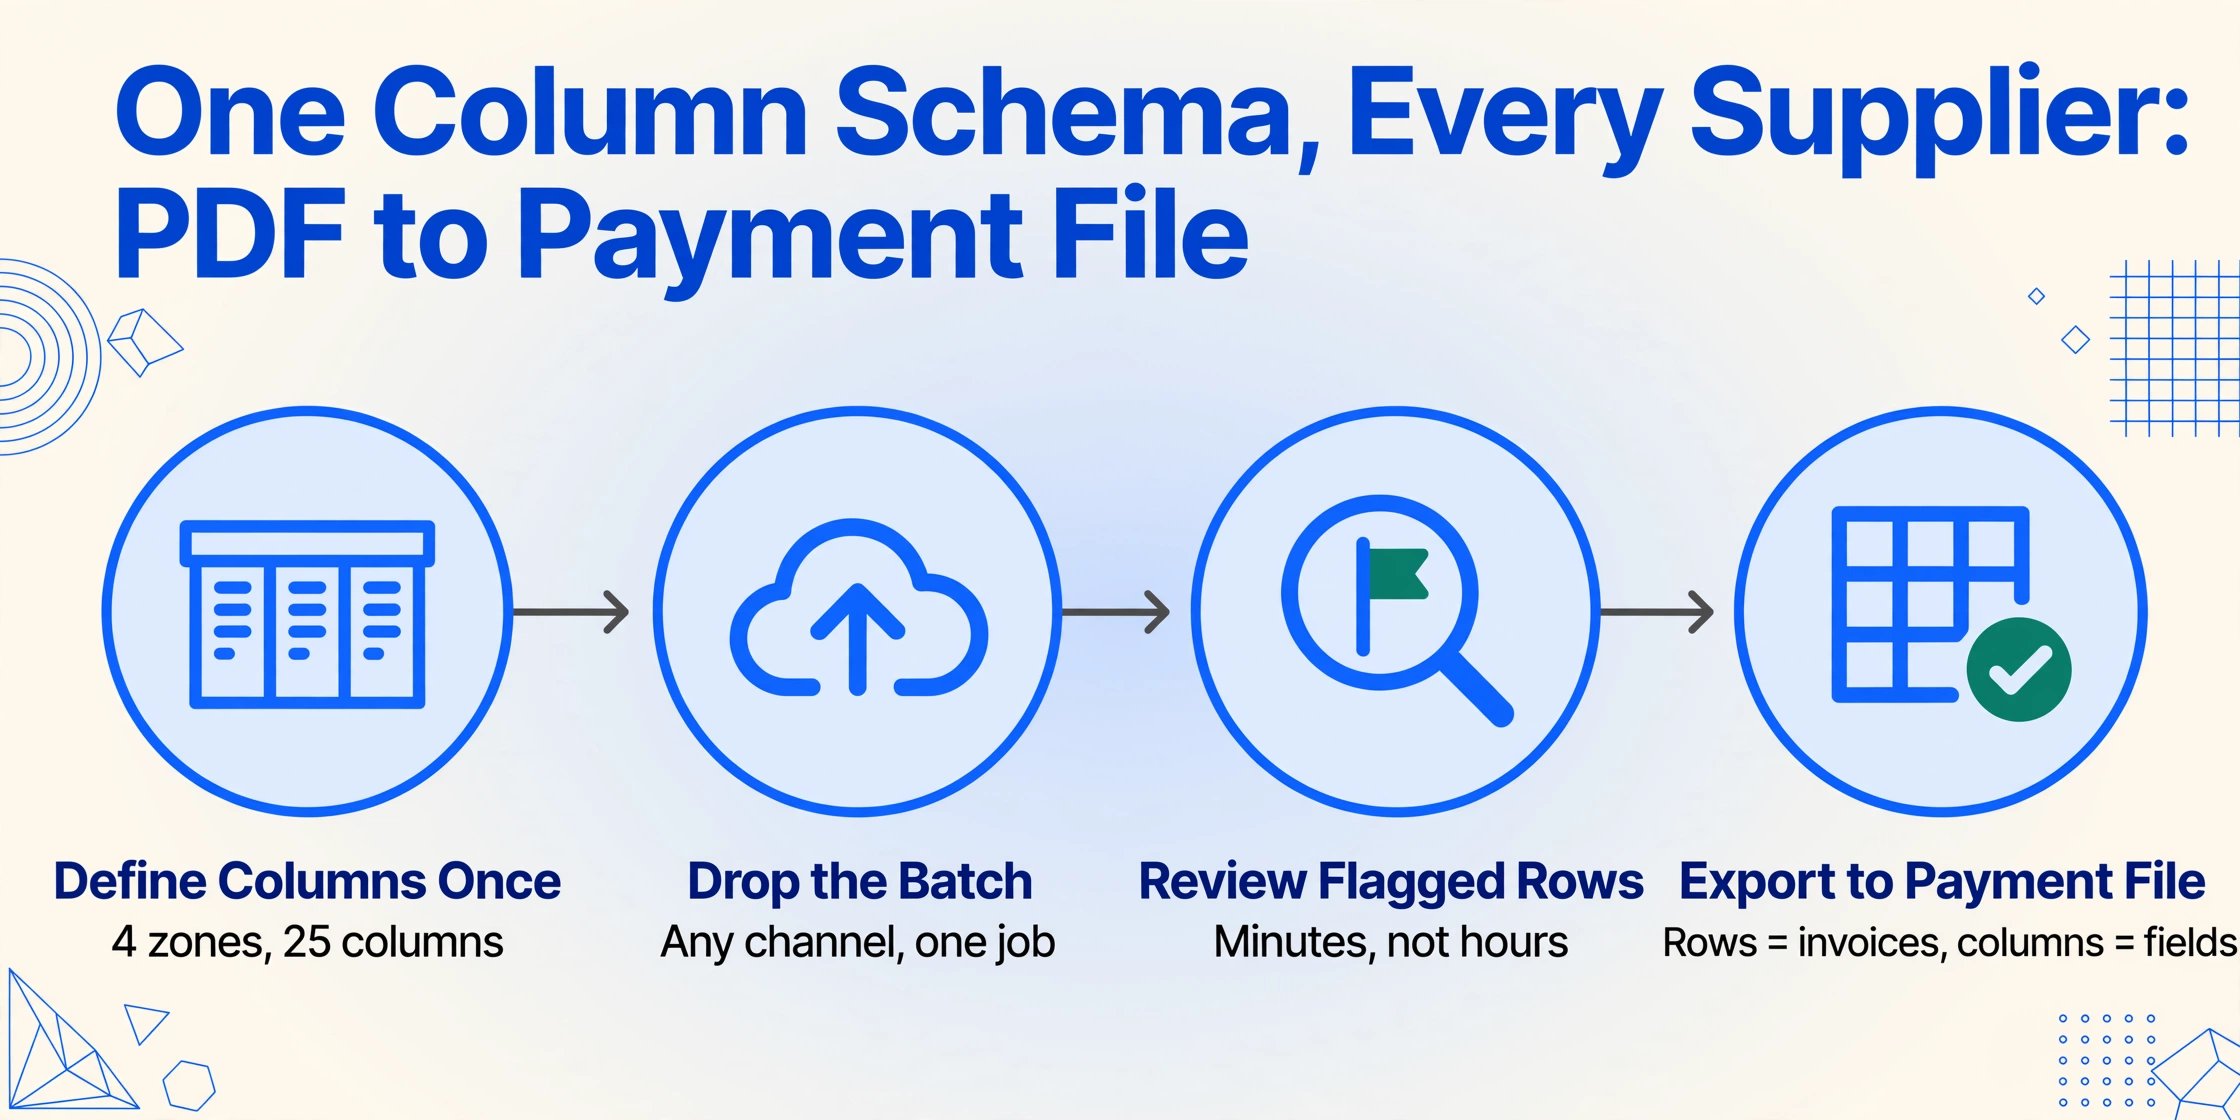
수동 청구서-스프레드시트 입력을 대체하는 워크플로우는 한 번 정의되며 모든 공급업체, 모든 청구서 형식, 이후 모든 월말 배치에 적용됩니다. 공급업체별 설정 프로세스가 아닙니다. 열 스키마는 발신자가 누구든 관계없이 AP 팀이 세이큐쇼에서 필요로 하는 것을 포착합니다. AI가 각 문서를 읽고 스키마를 채우며, 출력은 매번 동일한 열에 저장됩니다.
일본식 청구서 추출 열을 한 번만 정의하세요
필드 이름을 열 머리글로 입력하세요. 완전한 일본식 청구서 추출을 위한 실용적인 열 구성은 네 가지 영역을 다룹니다: 헤더 — 청구서 번호(請求書番号), 발행일(発行日), 거래일(取引年月日), 발행처(発行元); 품목 — 품명(品名), 수량(数量), 단위(単位), 단가(単価), 금액(金額); 세금 및 규정 준수 — 적격 청구서 등록 번호(インボイス登録番号), 10% 대상액(10%対象額), 10% 소비세(10%消費税), 8% 대상액(8%対象額), 8% 소비세(8%消費税), 합계(合計金額), 원천징수 구분(源泉徴収区分); 지불 및 은행 — 은행명(振込先銀行名), 지점명(支店名), 계좌 유형(口座種別), 계좌 번호(口座番号), 예금주(口座名義), 지급 조건(支払条件), 송금 수수료 부담(振込手数料負担). 결제일, 지급 지연 개월 수, 순 지급액, 세율에 대한 계산 열을 추가하세요. 이는 맞춤 열 추출을 사용합니다: AP 스프레드시트 구조와 일치하는 열로 출력 스키마를 정의하면, AI가 각 공급업체의 청구서에서 해당 필드가 어디에 있는지가 아니라 무엇을 의미하는지 이해하여 각 필드를 찾습니다.
월말 청구서를 한 번에 일괄 업로드하세요
모든 공급업체 청구서를 단일 업로드에 넣으세요. 일괄 처리는 이를 하나의 작업으로 처리합니다: 각 청구서는 열 스키마에 따라 독립적으로 처리되며, 모든 결과는 청구서당 한 행씩 하나의 스프레드시트로 병합됩니다. 서로 다른 청구 시스템의 서로 다른 레이아웃을 가진 20~40개 공급업체의 30~60개 청구서가 한 번에 처리됩니다. AI는 공급업체 블록, 수신자 블록, 날짜 필드, 품목 테이블, 소계/세금/합계 바닥글, 은행 송금 세부 정보 블록과 같은 구조적 패턴을 인식하여 각 문서를 세이큐쇼로 식별하고, 문서 내 관련 데이터를 찾아 정의된 열을 채웁니다. 공급업체별 템플릿이 필요 없습니다. 형식별 교육이 필요 없습니다. 입력이 30개 서로 다른 청구 시스템의 60개 서로 다른 문서임에도 출력은 하나의 파일입니다.
추출을 검증하세요 — 데이터를 다시 입력하지 마세요
AI가 모든 열을 채웁니다. 이 단계에서 귀하의 작업은 데이터 생성이 아닌 검증입니다. AI가 낮은 신뢰도로 표시한 필드에 대해 스프레드시트를 살펴보세요. 추출은 이러한 항목을 검토용 플래그 행으로 표시합니다. 검증은 몇 분이 걸립니다. 수동 생성은 몇 시간이 걸립니다. 이 둘의 차이가 추출 레이어의 가치입니다.
Excel로 내보내고 다운스트림 워크플로우에 공급
병합된 결과를 Excel 파일(XLSX)로 다운로드하세요. 출력은 세 가지 파이프라인에 공급됩니다: 회계 소프트웨어 가져오기 — 구조화된 열이 弥生会計, freee, マネーフォワード クラウド会計 또는 勘定奉行에 직접 가져와져 구매 분개 입력에 사용됩니다. 지급 일괄 생성 — 은행 송금 세부 열과 순 지급액 열이 全銀フォーマット의 지급 일괄 파일 입력을 구성하며, 은행 인터넷 뱅킹 시스템이 후리코미 업로드로 수락합니다. 소비세 신고 — 세율별 소비세 열이 消費税申告에 공급되며 10%와 8% 합계가 이미 분리되어 소계 처리됩니다. 각 파이프라인은 각 시스템에 별도로 입력하는 대신 한 번 추출되어 세 번 재사용된 구조화된 데이터를 받습니다.
파일은 안전하게 처리되며 저장되지 않습니다.
월말 AP를 위한 일괄 처리
일본 기업의 월말 AP는 국내 공급업체 30~50곳에서 구매하는 경우, 청구서를 세 가지 채널로 수신합니다: 청구 소프트웨어를 사용하는 기업의 이메일 PDF, 공급업체 포털에서 다운로드한 PDF, 우편으로 수령 후 PDF로 스캔하거나 촬영한 종이 청구서입니다. 세 채널 모두 월말 같은 주에 같은 담당자에게 도착하며, 모두 동일한 AP 처리 주기에 투입됩니다.
일괄 처리란 이러한 모든 청구서를 — 출처 채널, 공급업체, 레이아웃에 관계없이 — 단일 작업으로 처리하는 것을 의미합니다. 열 스키마는 배치의 모든 문서에 적용됩니다. 출력은 각 행이 청구서 하나, 각 열이 추출된 필드 하나인 단일 스프레드시트입니다. 세 채널과 20~30개 서로 다른 청구 시스템을 통해 도착한 30~50장의 청구서는 이제 균일한 구조의 단일 파일로 통합됩니다.
일괄 처리가 바꾸는 세 가지 운영상의 결정:
AP 팀은 재입력에서 검증으로 전환합니다. 추출이 스프레드시트를 채우고, AP 담당자의 업무는 이제 플래그가 지정된 항목에 대해 열을 스캔하는 것입니다 — 데이터를 처음부터 만드는 것이 아닙니다. 검증은 배치당 몇 분이 걸립니다. 생성 — 각 PDF를 열고, 올바른 필드를 찾고, 다른 화면에 입력하는 작업 — 은 몇 시간이 걸립니다.
스프레드시트는 세 가지 다운스트림 시스템의 단일 진실 공급원이 됩니다. 회계 소프트웨어는 구매 분개 데이터를 받습니다. 은행 시스템은 지급 배치 데이터를 받습니다. 세무 신고는 소비세 입력 데이터를 받습니다. 세 시스템이 서로 다른 세 번의 수동 입력 작업이 아닌 동일한 추출 데이터에 의존할 때, 한 시스템의 불일치는 추출 출력으로 추적됩니다 — 단절된 세 번의 데이터 입력 작업 중 하나의 오타가 아닙니다.
동일한 열 스키마가 다음 달에도 작동합니다. 공급업체가 청구서 레이아웃을 변경할 수 있습니다. 새 공급업체가 추가될 수 있습니다. 스키마 — 각 필드의 의미로 정의되며, 위치가 아닌 — 는 업데이트할 필요가 없습니다. 일괄 처리 가이드는 후리코미사키, 원천징수 계산, 결제일별 지급 일정이 포함된 30장 청구서 예시를 안내합니다.
젠긴 포맷: 스프레드시트 열에서 은행 승인 일괄 지급 파일로
젠긴 포맷(全銀フォーマット)은 일본 은행 자금 결제 네트워크(全国銀行資金決済ネットワーク)가 표준화한 고정 너비 파일 형식으로, 기업이 인터넷 뱅킹 화면에서 하나씩 입력하는 대신 단일 업로드로 여러 후리코미사키 은행 송금을 제출할 수 있게 합니다. 일본의 모든 주요 은행은 펌뱅킹(FB) 서비스를 통한 일괄 전자 송금에 이 형식을 허용합니다.
이 형식은 줄당 120바이트, Shift-JIS 인코딩이며 네 가지 레코드 유형이 있습니다:
| 레코드 유형 | 식별자 | 내용 | 주요 필드 |
|---|---|---|---|
| 헤더 레코드 | 1 | 송금 은행 및 계좌 정보 | 은행 코드, 지점 코드, 계좌 번호, 송금일(MMDD) |
| 데이터 레코드 | 2 | 수취인 송금당 레코드 1개 | 수취인 은행 코드, 지점 코드, 계좌 유형, 계좌 번호, 수취인 이름, 송금 금액 |
| 트레일러 레코드 | 8 | 일괄 합계 | 총 건수, 총 금액 |
| 종료 레코드 | 9 | 파일 끝 표시 | 해당 없음 |
추출에서 젠긴 포맷으로의 연결은 파일 변환이 아닌 데이터 파이프라인입니다. 추출 출력에는 은행 이름, 지점 이름, 계좌 유형, 계좌 번호, 예금주 이름, 순 지급 금액이 각각 별도의 열로 포함됩니다. 해당 열은 젠긴 파일의 각 데이터 레코드를 채우는 정확한 필드입니다. 은행 코드와 지점 코드 — 젠긴 포맷에서 사용되며 청구서의 텍스트 이름과 다른 숫자 식별자 — 는 AP 팀이 한 번 유지 관리하는 조회 테이블을 통해 확인할 수 있습니다.
계산 열은 추출 중에 이 조회를 수행할 수 있습니다: 젠긴 은행 코드. 열 출력에는 청구서에 표시된 은행 이름이 아닌 젠긴 데이터 레코드에 사용할 준비가 된 숫자 은행 코드가 포함됩니다. 스프레드시트에서 젠긴으로의 변환 — 추출 출력 열에서 고정 너비 120바이트 형식으로 — 은 스프레드시트 수식이나 간단한 스크립트로 수행할 수 있습니다. 추출은 설계된 대로 수행합니다: 열에 구조화된 데이터를 생성합니다. 일괄 지급 생성은 해당 열을 입력으로 사용합니다.
일본 은행 자금 결제 네트워크가 공식 젠긴 시스템 사양을 발행합니다 (PDF). 개별 은행은 자체 FB 업로드 형식 사양을 발행하며, 여기에는 특정 문자 인코딩, 필드 패딩 규칙, 그리고 비워 둘 수 있는 필드가 포함됩니다. 추출 출력은 형식에 구애받지 않습니다 — 열을 생성합니다. AP 팀 또는 스크립트가 해당 열을 회사가 사용하는 은행의 젠긴 사양에 맞게 포맷합니다.
인보이스 제도 준수를 위한 구조화된 추출
적격 청구서 제도는 모든 AP 팀이 모든 공급업체 인보이스에 대해 수행해야 하는 세 가지 새로운 준수 검증 단계를 만들었습니다:
- 등록 번호 검증 — 인보이스의 T+13 번호가 공급업체에 속하고, 국세청 공개 등록부와 일치하며, 만료되거나 취소되지 않았는지 확인합니다.
- 세율 구분 — 인보이스가 8% 경감세율 항목과 10% 표준세율 항목을 올바르게 구분하고, 세율별 소계와 세액이 산술적으로 정확한지 확인합니다.
- 경과적 공제 계산 — 미등록 공급업체의 인보이스에 대해 경과적 일정에 따라 매입세액 공제를 축소 계산합니다.
시스템 도입 전에는 AP 담당자가 두 가지만 검증했습니다: 인보이스 합계가 맞아 보이는지, 공급업체가 마스터 파일에 있는지. 이제 담당자는 인보이스당 세 가지 추가 준수 차원을 검증해야 합니다. 월말에 인보이스 30~50건을 처리한다면, 2023년 10월 이전에는 존재하지 않았던 90~150건의 추가 검증 확인이 필요합니다. 2023년 인보이스 개혁이 금융 처리(Finance Processing)를 더 어렵게 만든 방식에 대한 분석은 개혁 전과 후의 검증 체크리스트 변화를 자세히 설명합니다.
구조화된 추출은 이러한 검사의 기계적 부분을 흡수합니다. 등록 번호 열을 만들면 단일 열 조회로 국세청 등록부와 대조할 수 있습니다. 세율별 소계를 위한 계산 열(Computed Columns)은 공급업체가 명시한 수치와 직접 비교할 수 있게 합니다. 공급업체의 인보이스 시스템 등록 상태 열은 경과적 공제 계산이 적용되는지 여부를 표시합니다. AP 팀은 여전히 검증합니다 — 그러나 검증은 스프레드시트에서 추출된 데이터를 원본 데이터와 비교하는 것을 의미하며, 각 인보이스의 세금 섹션을 읽고 계산기로 세율 그룹 산술을 수행하는 것이 아닙니다. 일본 적격 청구서 추출에 대한 전체 가이드는 등록 번호 교차 확인, 세율 구간 산술, 경과적 공제 계산을 포함한 검증 워크플로우를 자세히 다룹니다.
이 문서들의 관계: 일본 청구서 클러스터
이 가이드는 일본 청구서(請求書) 추출을 모든 각도에서 다루는 6개 문서 클러스터의 허브 문서입니다 — 방법, 일괄 처리, 문제 분석, 비용, 흔한 실수, 그리고 이 완전한 참조 자료까지. 각 문서는 독립적으로도 유효하지만 클러스터 안에서 더 큰 맥락을 얻습니다. 구성은 다음과 같습니다:
방법: 필드 수준 추출 튜토리얼
단계별 추출 가이드는 실용적인 워크플로우를 다룹니다: 請求書番号부터 振込先口座番号까지 25개 열을 한 번 정의한 다음, 레이아웃과 관계없이 모든 공급업체의 청구서에 동일한 스키마를 적용합니다. iframe 데모, 지급 조건 파싱 및 원천징수 계산을 위한 계산 열 정의, 회계 소프트웨어로의 내보내기 파이프라인이 포함되어 있습니다. 첫 번째 일본 청구서 배치를 처리 중이라면 여기서 시작하세요.
배치: 청구서 30장, 지급 준비 완료 파일 하나
일괄 처리 가이드는 월말 워크플로우를 안내합니다: 세이큐쇼 30장을 한 배치에 넣고, 후리코미 은행 정보를 별도 열로 받고, 겐센 초슈 원천징수를 미리 계산하고, 소비세를 세율별로 분리합니다. 추출 출력부터 지급 배치 생성까지 전체 체인을 다룹니다 — 구조화된 은행 열이 후리코미 업로드 파일이 되는 단계입니다.
문제: 30개 공급업체의 시메비 마감일
시메비 지급 마감일 분석은 결제일 규칙이 다른 30개 공급업체가 왜 지급 캘린더로는 해결할 수 없는 현금 흐름 예측 문제를 만드는지, 그리고 지급 조건 텍스트에서 결제일을 추출하면 불투명한 문자열이 수식으로 일정을 잡을 수 있는 계산 가능한 필드로 바뀌는 방식을 분석합니다.
비용: 결제 주기당 수동 처리 비용
수동 세이큐쇼 처리 비용 분석은 월말 주기당 인건비를 정량화합니다 — 은행 정보 재입력, 원천징수 계산, 소비세 검증에 드는 시간 — 같은 작업을 몇 분 만에 처리하는 추출 레이어의 비용과 비교합니다. 월 30~60장의 공급업체 청구서를 처리하는 중소기업에게 주기당 절감액은 엔과 시간으로 측정 가능합니다.
실수: 세금 신고까지 도달하는 소비세 오류
흔한 소비세 데이터 입력 오류 가이드는 구체적인 실수를 다룹니다 — 8% 항목을 10%로 분류, 항목별 반올림과 세율 구간별 반올림의 차이로 인한 불일치, 거래를 잘못된 신고 기간으로 옮기는 연호 날짜 변환 오류 — 그리고 계산 열을 사용한 추출이 세금 조정 단계가 아닌 데이터 생성 단계에서 이를 잡아내는 방법을 설명합니다.
관련 문서 두 편은 일본 청구서 클러스터를 넘어 세이큐쇼와 추출 로직을 공유하는 인접 문서 유형으로 확장됩니다:
은행 통장(通帳) 추출
일본 은행 통장(通帳) 추출 완전 가이드는 지급 방정식의 다른 측면, 즉 은행이 인쇄하고 개인 사업자와 중소기업이 세금 신고의 주요 재무 기록으로 사용하는 거래 기록을 다룹니다. 통장의 5열 원장 형식, ATM 인쇄 도트 매트릭스 문자, 그리고 잔액 검증 로직은 세이큐쇼와 추출 과제를 공유하며, 연호 날짜 변환 및 후리코미 거래 식별을 포함합니다.
호주 BAS 추출
호주 BAS 데이터 추출 완전 가이드는 일본 청구서와 구조적 과제를 공유하는 다른 국가의 세금 문서, 즉 사업 활동 명세서(Business Activity Statement)를 다룹니다. 단일 문서에서 여러 세금 유형을 추출하고 이를 별도의 하위 세금 신고서에 전달하는 구조적 과제가 동일합니다. 열 정의 접근 방식은 동일하지만 스키마는 다릅니다.
자주 묻는 질문
AI 추출이 스마트폰 사진으로 촬영한 일본 청구서 데이터를 읽을 수 있나요?
네 — 기본 비전 언어 모델은 텍스트 우선 OCR이 아닌 시각적 입력으로 이미지를 처리합니다. 사무실 조명 아래에서 약간의 원근 왜곡이 있는 종이 청구서의 모바일 사진은 유효한 입력입니다. AI는 완벽한 평판 스캔 문서를 요구하지 않고 필드가 어떻게 보이는지, 무엇을 의미하는지 이해하여 필드를 읽습니다. 공급업체의 ERP 생성 PDF에서 작동하는 동일한 열 스키마는 소규모 서비스 제공업체의 손으로 쓴 청구서 사진에서도 작동합니다 — 추출이 필드 위치가 아닌 필드 정체성을 읽기 때문입니다.
청구서의 지급 조건 문자열이 비정상적인 형식일 경우 어떻게 되나요?
파싱 로직을 정의하는 계산 열 — “20日締” → 결제일 20일, “月末締” → 결제일 31일 — 이 표준 패턴을 처리합니다. 비표준 조건의 경우, 추출 결과는 지급 조건 열에 원본 텍스트를 출력하고 계산 열은 수동 검토 대상으로 표시합니다. AP 팀은 30개 중 1~2개인 해당 표시 행을 검토하며, 모든 청구서의 지급 조건을 수동으로 파싱하지 않습니다. 시간이 지나면서 계산 열 로직이 새 패턴을 처리하도록 확장되면 표시 행 수가 줄어듭니다.
추출 기능이 유초 은행(ゆうちょ銀行) 계좌 번호를 올바르게 처리하나요?
네, 유초 은행을 은행명으로 감지하고 유초 은행 기호-번호를 7자리 송금 계좌 번호로 변환하는 규칙을 추출 중에 적용하는 추론 열을 통해 처리합니다. 출력에는 원본 계좌 참조와 변환된 송금 계좌 번호가 모두 포함됩니다. 유초 은행은 변환 규칙을 웹사이트에 공개하고 있습니다.
10%와 8% 소비세 항목이 혼합된 청구서는 어떻게 처리하나요?
추론 열이 각 라인 항목 설명을 읽고 일본 소비세 구분에 따라 8% 경감 또는 10% 표준으로 분류합니다. 그런 다음 계산 열이 각 세율 구분별로 소계를 계산합니다. AP 팀은 공급업체가 명시한 소계와 분류를 대조하는데, 이는 분류 단계가 아닌 비교 단계입니다. 공급업체가 경감 세율 항목을 표시하지 않은 청구서의 경우, 추론 분류가 각 청구서 PDF를 다시 열지 않고 공급업체의 합계가 올바른지 검증할 수 있는 유일한 방법입니다.
이 가이드와 적격 청구서 추출 가이드의 차이점은 무엇인가요?
적격 청구서 추출 가이드는 인보이스 제도에 따른 적격 청구서(適格請求書)의 6가지 필수 항목, 경과적 매입세액 공제 일정, 국세청 등록부 검증 절차, 수기 및 세로 형식 청구서의 특수 과제에 중점을 둡니다. 이 가이드는 더 넓은 세이큐쇼 추출 범위를 다룹니다 — AP 팀이 접하는 모든 필드, 추출-지급-세금 전체 파이프라인, 그리고 적격 청구서 가이드가 다루지 않는 젠긴 포맷 통합까지 포함합니다. 규정 준수 관련 세부 사항은 적격 청구서 가이드를 읽으세요. 종단 간 프로세스는 이 가이드를 읽으세요.
일본 청구서에서 헤더 합계뿐만 아니라 라인 항목도 추출할 수 있나요?
네, 가능합니다. 이 가이드에서 설명하는 열 스키마에는 헤더 및 푸터 필드와 함께 라인 항목 수준의 열(品名, 数量, 単位, 単価, 金額)이 포함됩니다. 각 라인 항목은 출력 스프레드시트에서 하나의 행이 되며, 헤더 필드가 각 행에 반복되어 모든 라인 항목을 원본 청구서로 추적할 수 있습니다. 이 구조는 청구서 총액뿐만 아니라 개별 라인 항목을 비교해야 하는 삼자 매칭을 지원합니다.