Der vollständige Leitfaden zur japanischen Rechnung
Datenextraktion für Kreditorenbuchhaltung und Steuern
Eine japanische Rechnung (Seikyūsho) enthält etwa ein Dutzend Felder, für die ein amerikanisches oder europäisches Rechnungsextraktionstool keinen Spaltennamen hat. Der Block mit den Banküberweisungsdaten (Furikomisaki, Bankverbindung) umfasst allein vier Felder – Bankname, Filialname, Kontotyp, Kontonummer – die ein Kreditoren-Sachbearbeiter für jede Rechnung in die Online-Banking-Maske neu eintippt, selbst wenn dieselben vier Werte bereits im Lieferantenstamm vorhanden sind. Die Zeichenfolge der Zahlungsbedingungen (Shiharai Jōken, Zahlungsbedingungen) kodiert zwei berechenbare Werte – Abrechnungsstichtag und Zahlungsverzögerung – in einem zusammengesetzten Text wie „20日締翌月末払い“, der bestimmt, zu welchem Geschäftsjahr die Ausgabe gehört. Die Quellensteuer-Klassifizierung (Gensen Chōshū Kubun) bedeutet, dass der Zahlende vor der Überweisung 10.21% einbehalten muss – wenn man das übersieht, zahlt man dem Lieferanten diesen Betrag zu viel und schuldet ihn dem Finanzamt trotzdem noch. Dieser Leitfaden deckt die gesamte Landschaft ab: jedes Feld auf einer japanischen Rechnung, was jedes einzelne in operativer Hinsicht bedeutet, wie man sie alle in eine strukturierte Tabelle extrahiert und wie man diese Ausgabe in drei nachgelagerte Pipelines einspeist – Erstellung von Zahlungsbatches, Import in Buchhaltungssoftware und Verbrauchssteuererklärung. Wenn Sie am Monatsende dreißig bis sechzig solcher Rechnungen von Lieferanten verarbeiten, die jeweils ein anderes Abrechnungssystem mit einem anderen Layout verwenden, ist dies die Referenz, die Sie benötigen.
Wichtige Erkenntnisse
- Ihr Extraktionstool findet den Betrag und das Datum auf einem Seikyūsho – dieselben Felder, die es auf jeder Rechnung findet – und meldet den Auftrag als abgeschlossen.
- Aber die vier Furikomisaki-Bankfelder, die Shimebi-Abrechnungskonvention und die Gensen-Chōshū-Klassifizierung – die Felder, die Ihr Kreditoren-Team tatsächlich in die Online-Banking-Maske neu eintippt – sind das, was es überspringt oder verfälscht, weil seine Trainingsdaten aus US- und EU-Rechnungen nie einen Zahlungsanweisungsabschnitt unterhalb der Summen enthielten.
- Definieren Sie Ihre Spalten danach, was jedes japanische Feld bedeutet – Furikomisaki als vier Finanzspalten, Shimebi aufgeteilt in Abrechnungsstichtag und Zahlungsverzögerung, Gensen Chōshū als Ja/Nein-Flag – und dasselbe Schema funktioniert über dreißig Lieferanten mit dreißig Layouts hinweg, weil die KI Felder dadurch findet, dass sie versteht, was sie sind, und nicht, wo sie auf einer Vorlage sitzen.
Was eine japanische Rechnung anders macht – und warum das für die Extraktion wichtig ist
Eine japanische Rechnung besitzt eine Feldarchitektur, für die westliche Extraktionstools nicht ausgelegt sind. Eine US- oder EU-Rechnung verläuft vom Kopf über die Positionen zur Summe und zum Fälligkeitsdatum – vier bis sechs extrahierte Spalten decken in der Regel den Kreditoren-Workflow ab. Eine japanische Rechnung fügt unterhalb der Summen einen zweiten, vollständigen Abschnitt hinzu: den Zahlungsanweisungsblock. Er teilt dem Käufer mit, an welche Bank das Geld überwiesen werden soll, welche Abrechnungsstichtag-Konvention den Fälligkeitszeitpunkt bestimmt und ob ein Teil des Betrags für das Finanzamt einbehalten werden muss. Eine generische Extraktions-Engine, die das Dokument von oben nach unten nach „Rechnungsnummer“ und „Gesamtsumme“ durchsucht, überspringt diesen gesamten Abschnitt – oder schlimmer noch, sie verkettet die vier separaten Bankfelder zu einem einzigen verstümmelten Textstring.
Seit Oktober 2023 kommt zur strukturellen eine Compliance-Dimension hinzu. Das Qualifizierte Rechnungssystem (インボイス制度, offiziell 適格請求書等保存方式) gemäß Artikel 57-2 des Verbrauchssteuergesetzes schreibt sechs Pflichtfelder auf jeder Rechnung vor, die einen Vorsteuerabzug ermöglicht. Drei dieser sechs Felder – Registrierungsnummer, Steuerbeträge nach Steuersatz und Aufschlüsselung nach Steuerkategorie – waren vor Einführung des Systems keine Pflichtfelder. Stand März 2025 meldete die National Tax Agency rund 4,61 Millionen registrierte qualifizierte Rechnungsaussteller. Jeder von ihnen muss auf jeder Rechnung eine T+13-stellige Registrierungsnummer angeben. Fehlt diese Nummer, verringert sich der Vorsteuerabzug des Käufers – nach einem Übergangsplan, der von 80 % abzugsfähig auf null absinkt.
Die Extraktionsaufgabe besteht also nicht nur darin, japanischen Text zu lesen. Es geht darum, ein Dokument zu lesen, dessen Feldschema – die für Kreditorenbuchhaltung und Steuern relevanten Spalten – sich von dem Schema unterscheidet, für das das Extraktionstool entwickelt wurde. Die Lösung ist die Benutzerdefinierte Spaltenextraktion: Sie definieren das Ausgabeschema selbst mit Spaltennamen, die zu Ihrer Kreditoren-Tabelle und Ihrer japanischen Geschäftslogik passen, und lassen dann die KI jedes Feld lokalisieren, indem sie seine Bedeutung versteht – nicht seine Position auf der Rechnungsvorlage eines bestimmten Lieferanten. Dasselbe Spaltenschema funktioniert, ob die Rechnung nun als ERP-generiertes PDF eines großen Handelshauses, als ausgedrucktes und wieder eingescanntes Word-Template eines lokalen Dienstleisters oder als Handyfoto eines handschriftlichen Formulars eingeht. Um zu erfahren, wie jede Spaltendefinition aussehen sollte – und wie Sie Inferenzlogik schreiben, die die japanischen Konventionen erfasst – lesen Sie das Schritt-für-Schritt-Tutorial zur japanischen Rechnungsextraktion, das die Definition von fünfundzwanzig Spalten einmalig und deren Wiederverwendung für alle Lieferanten beschreibt.
Der Rest dieses Leitfadens behandelt, was jede dieser Spalten extrahieren muss und warum die für japanische Rechnungen einzigartigen Felder – Furikomisaki-Bankdaten, Shimebi-Abrechnungskonventionen, Gensen-Quellensteuer und zweistufige Verbrauchssteuer – den gesamten Extraktionsworkflow von der Spaltendefinition über den Zahlungs-Batch-Export bis zur Verbrauchssteuererklärung prägen.
Die Felder einer 請求書 im Detail
Eine japanische Rechnung besteht aus vier logischen Zonen. Die ersten beiden – Kopfzeile und Positionen – sind universell und auf jeder Rechnung zu finden. Die letzten beiden – Steuern und Compliance sowie Zahlung und Bankverbindung – weichen im Feldschema von dem ab, was westliche Extraktionssysteme erwarten. Hier ist jedes Feld, auf das ein AP-Team bei der Verarbeitung von Seikyūsho (japanische Rechnungen) einer gemischten Lieferantenbasis stößt, geordnet nach Zone.
Kopfzeile & Identifikation
- 請求書番号 (Rechnungsnummer) – die eindeutige Kennung, oft als Datums-Serien-Kombination wie „2026-07-001“ formatiert. Der Primärschlüssel für AP-Suche und Zahlungsverfolgung. Ohne sie wird der Abgleich einer Furikomisami (Bankverbindung)-Bestätigung der Bank mit der Originalrechnung zu einem Abstimmungsproblem, das mit der Menge wächst.
- 発行日 (Ausstellungsdatum) – das Datum, an dem die Rechnung ausgestellt wurde. Dient als Ausgangspunkt für die Berechnung des Zahlungsziels, wenn die Bedingungen auf den Abrechnungsschluss verweisen.
- 取引年月日 (Transaktionsdatum) – das Datum des zugrunde liegenden Geschäftsvorfalls. Kann vom Ausstellungsdatum abweichen und wird oft im japanischen Jahresformat angegeben (令和8年). Die Extraktion muss Jahresdaten für die weitere buchhalterische Verwendung in das westliche Kalenderformat (ISO 8601) umwandeln.
- 発行元 (Aussteller / Lieferant) – Firmenname, Adresse und Kontaktdaten des Verkäufers. Oft begleitet vom Firmenstempel (社判, Shahan).
- 宛名 (Empfänger / Käufer) – die adressierte Firma und Abteilung, typischerweise gefolgt vom Ehrenpräfix 御中 (Onchū).
Positionen & Preise
- 品名 (Artikelname) – Produkt- oder Dienstleistungsbeschreibung. Das Abrechnungssystem eines Lieferanten kann dasselbe Produkt anders bezeichnen als die Bestellung (発注書, Hatchūsho), was zum VLOOKUP-#N/A-Problem führt. Enthält optionale Felder wie 品番 (Teilenummer) und 摘要 (Beschreibung/Vermerk).
- 数量 (Menge) – mit Einheit (単位): 個 (Stück), 式 (Los/Satz), kg, m, 時間 (Stunden). Einheitenkonflikte zwischen Bestellung und Rechnung erfordern eine Normalisierung.
- 単価 (Einzelpreis) – in der Regel ohne Steuer (税抜, Zeinuki). Eine Rechnung, die auf Preise inklusive Steuer umstellt, erfordert, dass die AP die Steuerberechnung rückgängig macht, um die Übereinstimmung mit der Bestellung zu prüfen.
- 金額 (Positionsbetrag) – Positionssumme vor Steuern. Wird oft zusammen mit der Zwischensumme (小計, Shōkei) angezeigt.
Steuer- & Rechtskonformität
- インボイス登録番号 (Qualifizierte Rechnungsregistrierungsnummer) — „T“ + 13 Ziffern. Pflicht seit Oktober 2023. Nur so kann der Käufer den vollen Vorsteuerabzug auf Einkäufe bei diesem Lieferanten geltend machen. Eine fehlende oder falsche Nummer löst den Übergangszeitplan für den Vorsteuerabzug aus: 80 % abzugsfähig bis September 2026, 50 % bis September 2029, danach null. Eine ausführliche Erläuterung dieses Systems finden Sie im vollständigen Leitfaden zur Extraktion japanischer qualifizierter Rechnungen.
- 消費税額 (Verbrauchssteuer) — getrennt nach Steuersatz ausgewiesen: 10 % Standardsatz (7,8 % national + 2,2 % lokal) und 8 % ermäßigter Satz (6,24 % national + 1,76 % lokal). Die Rechnung muss die Steuerbemessungsgrundlage und den Steuerbetrag für jede Steuersatzklasse angeben. Die Verbrauchssteuererklärung (消費税申告) des Käufers benötigt diese nach Steuersatz gruppierten Summen als Eingabedaten.
- 源泉徴収区分 (Quellensteuer-Klassifizierung) — auf Rechnungen von qualifizierten Dienstleistern gemäß Artikel 204 des Einkommensteuergesetzes (所得税法). Der Zahlungspflichtige behält 10,21 % des Zahlungsbetrags ein und führt ihn namens des Verkäufers an das Finanzamt ab.
Zahlung & Bankwesen
- 振込先 (Bankverbindung) — vier separate Felder: 銀行名 (Bankname), 支店名 (Filialname), 口座種別 (Kontotyp — 普通/Futsū (Girokonto) oder 当座/Tōza (Kontokorrentkonto)) und 口座番号 (Kontonummer). Ein fünftes Feld, 口座名義 (Kontoinhaber), erscheint oft ebenfalls. Dies sind die Felder, die die AP-Mitarbeiter in die Online-Banking-Maske eintippen – dieselben Daten, die bereits im Lieferantenstamm vorhanden sind. Bei der Japan Post Bank (ゆうちょ銀行) verwendet die Kontoreferenz ein Symbol-Nummer-Format (記号-番号), das in eine 7-stellige Überweisungskontonummer umgewandelt werden muss.
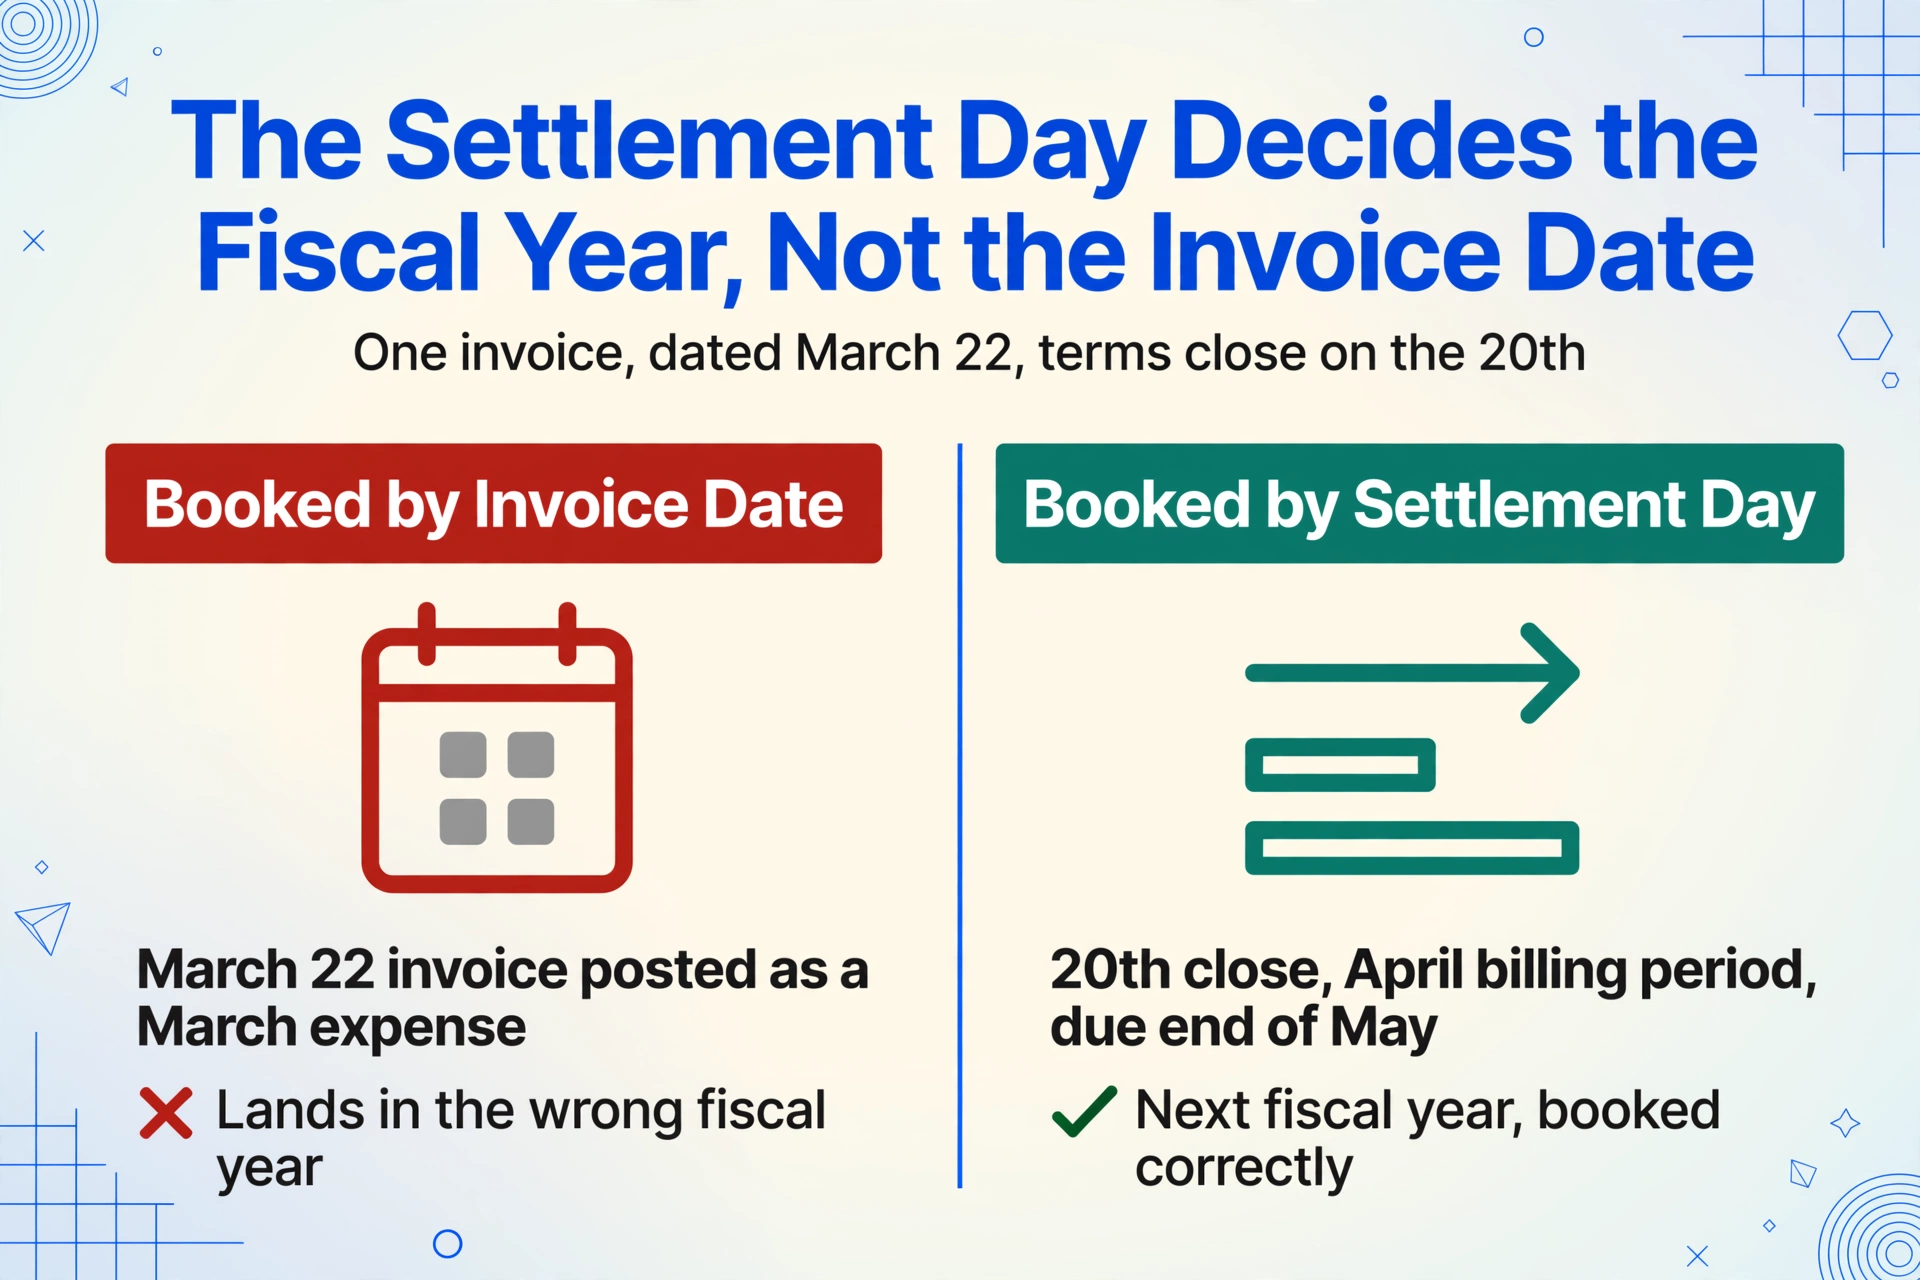
- 支払条件 (Zahlungsbedingungen) — in kompakter japanischer Syntax ausgedrückt. „20日締翌月末払い“ bedeutet, dass der Abrechnungszeitraum am 20. endet, die Zahlung bis Ende des Folgemonats fällig ist. Enthält zwei berechenbare Werte: Abrechnungsstichtag (締日, Shimebi) und Zahlungsverzögerung. Der Abrechnungsstichtag bestimmt die Zuordnung zum Geschäftsjahr – eine Rechnung vom 22. März mit den Bedingungen „20日締“ gehört zum nächsten Geschäftsjahr, nicht zum aktuellen.
- 振込手数料 (Verantwortung für Überweisungsgebühren) — wer trägt die Banküberweisungsgebühr. Wenn die Rechnung „貴社ご負担“ (zu Ihren Lasten) angibt, muss die AP den Gebührenbetrag zum Überweisungsgesamtbetrag hinzurechnen.
Die Struktur ist keine Spekulation – der offizielle Überblick des Kabinettsamts über das Qualifizierte Rechnungssystem listet die sechs Pflichtangaben auf. Die Extraktionsaufgabe geht jedoch über die Pflichtfelder hinaus. Die Felder, die die meiste manuelle AP-Zeit in Anspruch nehmen – Bankverbindung, Analyse der Zahlungsbedingungen und Quellensteuer – sind durch Konvention enthalten, nicht durch gesetzliche Vorschrift. Sie machen die Verarbeitung japanischer Rechnungen strukturell anders als ihre westlichen Pendants, und an ihnen scheitert die generische Extraktion zuerst. Um die Kosten der manuellen Extraktionsarbeit zu verstehen, analysiert die Kostenanalyse der manuellen Seikyūsho-Verarbeitung für japanische KMU die Arbeitskosten pro Zyklus in Yen über einen typischen Monatsabschluss hinweg.
Die zentrale Erkenntnis zur Extraktion: Eine japanische Rechnung ist keine englische Rechnung mit japanischem Text. Es ist ein Dokument mit einem anderen Feldschema – und die Spaltendefinitionen für die Extraktion müssen dieses Schema widerspiegeln, sonst entsteht eine Tabelle mit Daten, die ein AP-Team dennoch manuell abtippen muss, um sie nutzbar zu machen.
振込先: Warum vier separate Bankfelder – nicht ein Textblock
Der Banküberweisungsblock ist die mit Abstand repetitivste Dateneingabeaufgabe in der japanischen Kreditorenbuchhaltung. Eine Rechnung eines Lieferanten enthält vier beschriftete Felder – Bankname, Filialname, Kontotyp, Kontonummer – und der AP-Sachbearbeiter öffnet den Online-Banking-Bildschirm und tippt sie für jede Rechnung einzeln ein. Dieselben vier Werte existieren bereits im Lieferantenstamm der Buchhaltungssoftware. Wenn am Monatsende dreißig Rechnungen eintreffen, tippt das AP-Team diese vier Felder dreißig Mal neu ein – 120 einzelne Eingaben, die keine neuen Informationen hinzufügen, sondern nur vorhandene Stammdaten von einem Bildschirm auf einen anderen duplizieren.
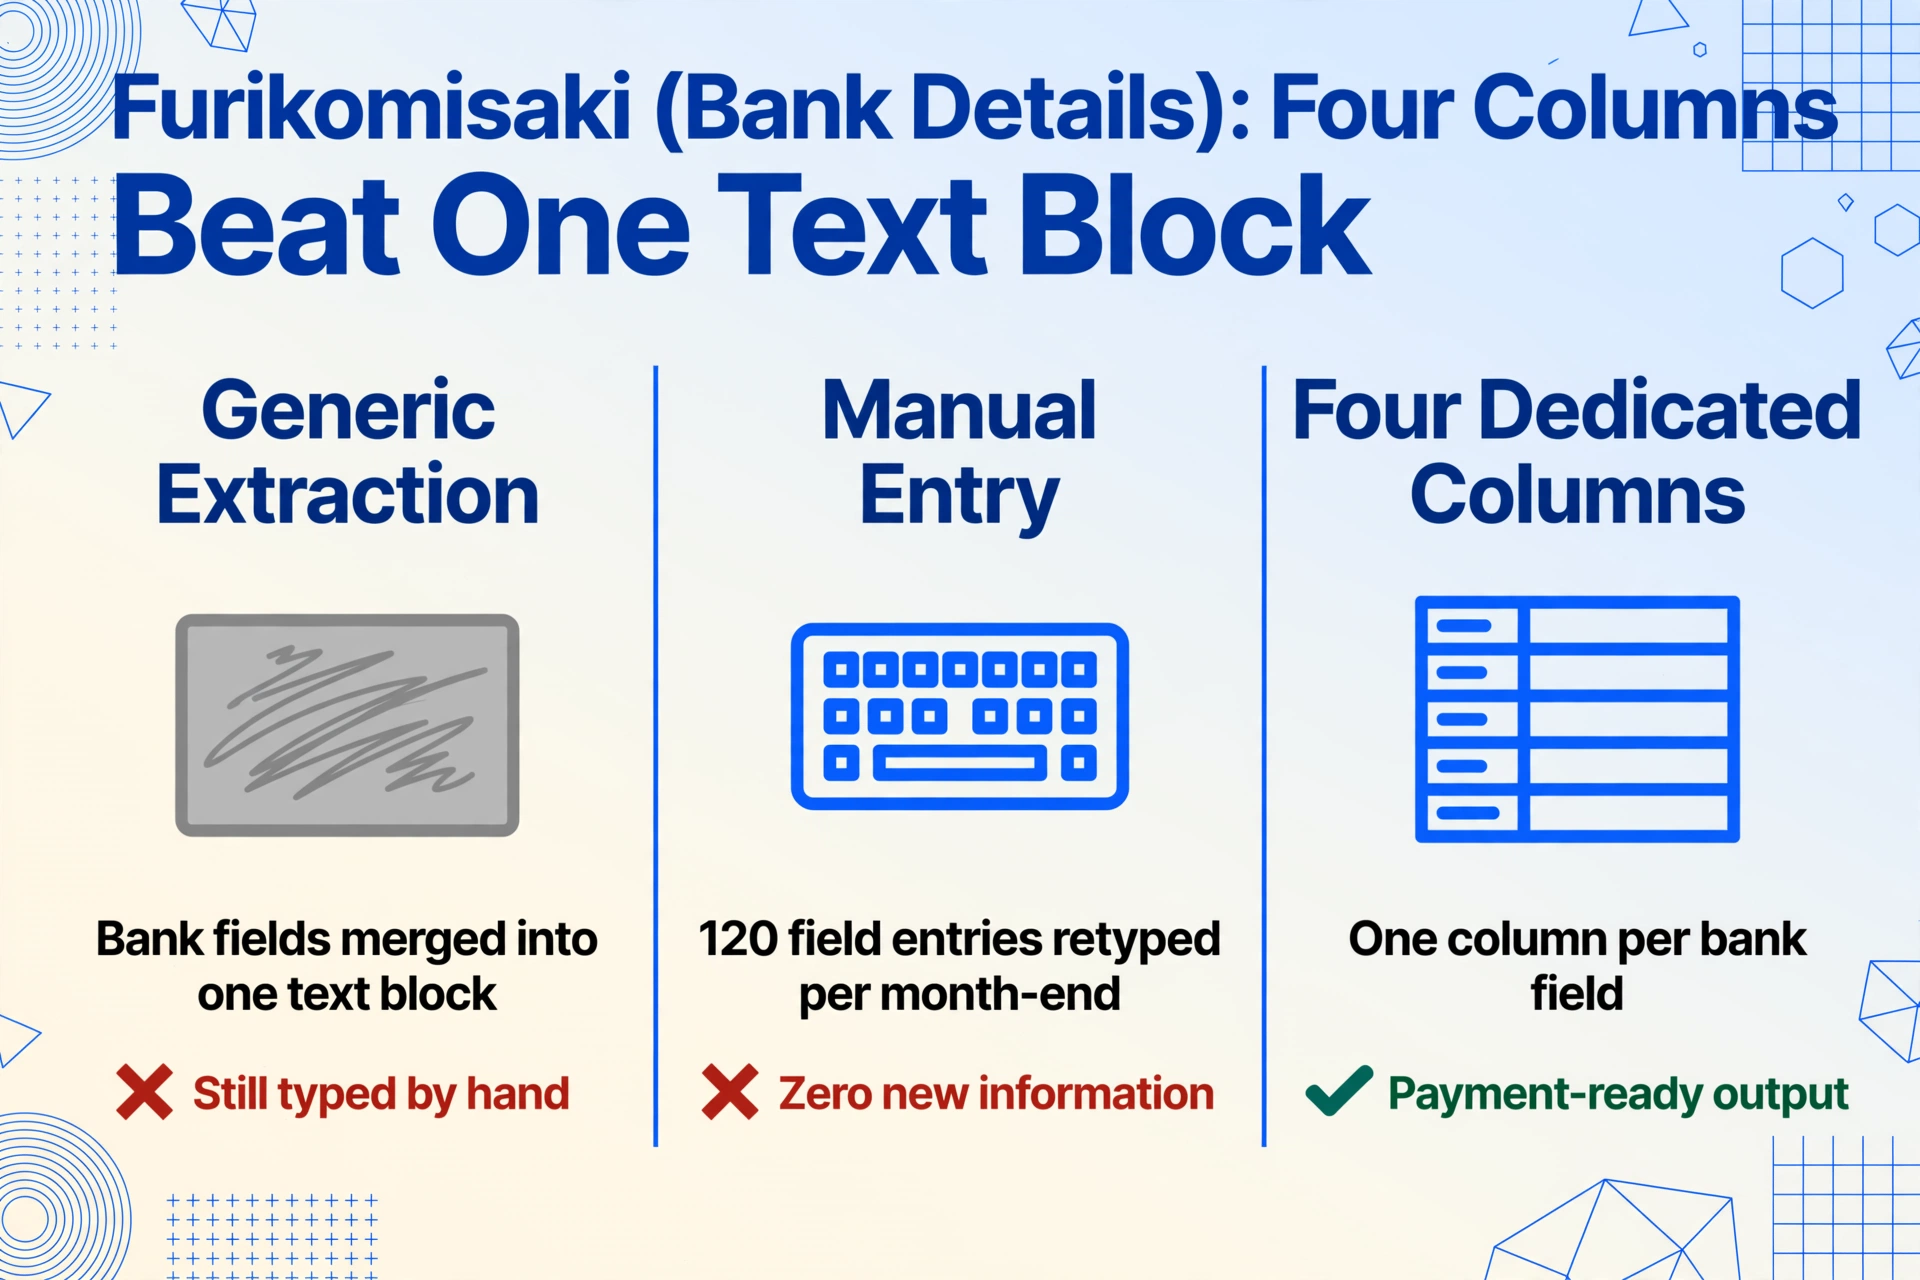
Die meisten generischen Extraktionstools wurden mit US- und EU-Rechnungsdatensätzen trainiert, in denen „Zahlungsmethode“ ein einzelnes Feld ist – „Überweisung“ oder „ACH“ – und das Konzept, Bankdaten auf der Rechnung zu strukturieren, existiert dort nicht als strukturierter Feldsatz. Legt man ein Seikyūsho in eines dieser Tools, wird der Bankdatenblock entweder übersprungen oder zu einem unstrukturierten Textfeld zusammengefasst. Das AP-Team muss die PDF-Datei weiterhin öffnen, um jedes Feld per Copy-Paste zu übernehmen.
Der Extraktionsansatz trennt den Furikomisaki-Block in vier dedizierte Spalten – jede erfasst ein Feld unabhängig – und verwendet eine abgeleitete Spalte, um die Umrechnung für Japan Post Bank (ゆうちょ銀行) zu handhaben. Das Kontosystem der Japan Post verwendet ein 記号-番号 (Symbol-Nummer)-Paar, das sich von der 7-stelligen Überweisungskontonummer unterscheidet, die für kommerzielle Bank-Furikomi-Systeme erforderlich ist. Eine abgeleitete Spalte – eine Spalte, deren Wert die KI basierend auf dem Dokumentkontext berechnet, statt ihn auf der Seite gedruckt zu finden – übernimmt die Umrechnung während der Extraktion: Überweisungskontonummer (wenn Bankname ゆうちょ enthält, 記号-番号-Paar gemäß Umrechnungsregel der Japan Post Bank in 7-stelliges Format umwandeln; andernfalls Kontonummer ausgeben). Die Spaltendefinition wird einmal ausgeführt und gilt für jeden Batch.
Vier strukturierte Bankspalten sind nicht nur eine organisatorische Annehmlichkeit. Sie sind die Eingabedaten für eine Zahlungs-Batch-Datei – und hier kommt das 全銀フォーマット (Zengin-Format) in den Workflow. Der Batch-Verarbeitungsleitfaden behandelt die gesamte Kette: dreißig Rechnungen in einem Batch verarbeitet → Furikomi-Bankdaten in separaten Spalten → Ausgabe in eine bankfähige Zahlungs-Batch-Datei formatiert. Die Extraktion spart nicht nur Tipparbeit – sie schafft eine Datenpipeline, in der dieselben Bankfelder, die von der Extraktion erfasst werden, dieselben Bankfelder sind, die der Upload-Bildschirm der Bank übernimmt.
Shiharai Jōken (Zahlungsbedingungen): Der Abrechnungsstichtag, der den Geschäftszeitraum bestimmt
Japanische Zahlungsbedingungen sind eine kompakte Syntax, die AP-Teams auf einen Blick lesen, die generische Extraktion jedoch als undurchsichtigen Text liest. “20日締翌月末払い” bedeutet, dass der Abrechnungszeitraum am 20. des Monats endet und die Zahlung bis zum Ende des Folgemonats fällig ist. Diese Zeichenfolge kodiert zwei berechenbare Werte: den Abrechnungsstichtag (20) und die Zahlungsverzögerung (1 Monat). “月末締翌々月末払い” — üblich im Bau- und Fertigungssektor — bedeutet Monatsende-Abschluss, Zahlung bis zum Ende des übernächsten Monats (Verzögerung: 2 Monate).
Der Abrechnungsstichtag ist operativ, nicht kosmetisch. Eine Rechnung vom 18. März unter 20日締-Bedingungen fällt in den Abrechnungszeitraum März: Zahlung fällig Ende April, Ausgabe gehört zum aktuellen Geschäftsjahr, wenn die Bücher am 31. März schließen. Eine Rechnung vom 22. März unter denselben Bedingungen fällt in den Abrechnungszeitraum April: Zahlung fällig Ende Mai, Ausgabe gehört zum nächsten Geschäftsjahr. Der Abrechnungsstichtag — nicht das Rechnungsdatum, nicht die Kalendermonatsgrenze — bestimmt die Geschäftsjahresklassifizierung. Die Shimebi-Zahlungsfristen-Analyse behandelt die vollständige operative Auswirkung, wie Abrechnungsstichtag-Konventionen in die Cashflow-Prognose einfließen, wenn dreißig Lieferanten jeweils unterschiedliche Shimebi-Daten verwenden.
Eine berechnete Spalte — eine Spalte, deren Wert die KI während der Extraktion mithilfe einer definierten Formel berechnet — zerlegt die Zahlungsbedingungen in strukturierte Felder: Abrechnungsstichtag (aus Zahlungsbedingungen parsen: wenn “20日締” → 20, wenn “月末締” → 31, wenn “10日締” → 10) und Zahlungsverzögerungsmonate (aus Zahlungsbedingungen parsen: wenn “翌月末払い” → 1, wenn “翌々月末払い” → 2). Diese beiden Spalten werden dann von einer Tabellenkalkulationsformel verbraucht, die das tatsächliche Zahlungsfälligkeitsdatum berechnet — die Fälligkeitsdatum-Spalte in der Ausgabetabelle wird nicht getippt, nicht aus einem Freitextfeld extrahiert, sondern aus dem Rechnungsdatum plus den geparsten Bedingungen abgeleitet. Diese Datumsspalte speist die Cashflow-Prognose und den Zahlungsstapelplan, die beide das tatsächliche Kalenderdatum benötigen, nicht die Textzeichenfolge, die es kodiert.
Gensen Chōshū Kubun (Quellensteuer-Klassifizierung): Wenn der Zahlungspflichtige vor der Überweisung abziehen muss
Das japanische Quellensteuersystem verpflichtet den Zahlungspflichtigen zum Abzug, wenn der Zahlungsempfänger ein qualifizierter freiberuflicher Dienstleister ist. Steuerberater (税理士), Wirtschaftsprüfer (公認会計士), Rechtsanwälte (弁護士), Rechtsschreiber (司法書士), Designer (デザイナー), Autoren (著作家) und mehrere andere Kategorien gemäß Artikel 204 des Einkommensteuergesetzes (所得税法) unterliegen einem Quellensteuerabzug von 10,21 % des Zahlungsbetrags. Der Zahlungspflichtige zieht die Quellensteuer ab, führt sie an das Finanzamt ab und zahlt dem Lieferanten die verbleibenden 89,79 %.
Ein Seikyūsho (japanische Rechnung) eines qualifizierten Freiberuflers enthält in der Regel einen Quellensteuerhinweis – entweder eine Zeile mit „源泉徴収額“ und dem abgezogenen Betrag oder eine Klassifizierungsmarkierung wie „源泉徴収あり“. Eine Rechnung mit Quellensteuerabzug ändert die AP-Zahlungsberechnung: Der Nettozahlungsbetrag ist der Rechnungsbetrag abzüglich der Quellensteuer, und eine separate Verbindlichkeit für die Steuerhinterlegung muss gebucht werden. Wird der Abzug bei der Extraktion nicht erfasst, muss das AP-Team jede qualifizierende Rechnung einzeln prüfen, den Abzug manuell berechnen und die Zahlung anpassen – ein rechenintensiver Schritt pro Rechnung, der bei sechzig Rechnungen messbare AP-Zeit verbraucht.
Eine Spalte, definiert als Klassifizierung Quellensteuer (prüfen, ob die Rechnung 源泉徴収 angibt; Ausgabe „Anwendbar“, wenn der Lieferant ein qualifizierter Freiberufler mit angegebenem Abzug ist, sonst „Nicht anwendbar“), kennzeichnet, welche Rechnungen den Abzug erfordern. Eine berechnete Spalte – Nettozahlungsbetrag (wenn Quellensteuer anwendbar: Gesamtbetrag × 0,8979; sonst: Gesamtbetrag) – berechnet den tatsächlichen Furikomisaki (Bankverbindung)-Überweisungsbetrag direkt. Die Zahlungsbatchdatei enthält nun den korrekten Überweisungsbetrag, nicht den Rechnungsbetrag, ohne dass das AP-Team für jede qualifizierende Rechnung einen separaten Berechnungsschritt durchführen muss.
インボイス番号: Die T+13-Registrierungsnummer und warum es sie gibt
Die Registrierungsnummer für qualifizierte Rechnungsaussteller (インボイス登録番号) ist eine 13-stellige Nummer mit dem Präfix “T” — zum Beispiel T1234567890123. Jeder registrierte qualifizierte Rechnungsaussteller (QII) erhält diese Nummer von der National Tax Agency bei der Registrierung und muss sie auf jeder Rechnung angeben, die der Käufer für den Vorsteuerabzug verwendet. Die National Tax Agency führt ein öffentliches Register qualifizierter Rechnungsaussteller, in dem AP-Teams Registrierungsnummern überprüfen können.
Die Registrierungsnummer hat einen neuen, rechnungsbezogenen Prüfschritt geschaffen, der vor Oktober 2023 nicht existierte. Ein AP-Sachbearbeiter, der eine Rechnung erhält, muss die T-Nummer finden — die im Kopfbereich, im Fußbereich, am Rand, im Kleingedruckten neben dem Firmenstempel oder in einem Textblock in der Nähe der Bankverbindung erscheinen kann — und bestätigen, dass sie zum Lieferanten gehört. Fehlt die Nummer oder stimmt sie nicht mit dem Register der National Tax Agency überein, wird der Vorsteuerabzug des Käufers für diese Transaktion nach einem Übergangsplan reduziert, der von 80 % abzugsfähig (bis September 2026) über 50 % (bis September 2029) auf null sinkt. Der vollständige Leitfaden zur Extraktion japanischer qualifizierter Rechnungen behandelt die konforme Rechnungslandschaft eingehend, einschließlich der sechs Pflichtfelder, des Übergangsplans für den Vorsteuerabzug und der Überprüfung extrahierter T-Nummern gegen das Register der National Tax Agency in einer einspaltigen Suche.
Für den Extraktionsworkflow ist die Spalte für die Registrierungsnummer einfach zu definieren — die KI liest das Dokument, erkennt das T+13-Muster an beliebiger Stelle auf der Seite und füllt die Spalte. Die Herausforderung liegt nicht in der Extraktion selbst, sondern in der Positionsvielfalt: Jeder Lieferant platziert die T-Nummer an einer anderen Stelle. Ein vorlagenbasiertes Tool, das die Registrierungsnummer in einem festen Bereich erwartet, wird sie bei Rechnungen übersehen, bei denen der Lieferant sie im Fußbereich platziert. Semantische Extraktion — das Auffinden des Felds durch Verständnis dessen, was es ist, nicht wo es sich befindet — erfasst sie unabhängig von der Position. Dasselbe Prinzip gilt für jedes Feld auf der Rechnung, und es ist der Grund, warum ein einziges Spaltenschema über dreißig Lieferanten mit dreißig verschiedenen Layouts funktioniert.
Verbrauchssteuer: Dual-Rate-Erfassung für die Steuererklärung
Japans Verbrauchssteuersystem verwendet zwei Sätze — 10 % Standardsatz (für die meisten Waren und Dienstleistungen) und 8 % ermäßigter Satz (für Lebensmittel, alkoholfreie Getränke und Abonnementzeitungen, die mindestens zweimal wöchentlich erscheinen). Eine qualifizierte Rechnung muss den steuerpflichtigen Betrag und den Steuerbetrag für jede Steuersatzkategorie getrennt ausweisen, wobei Bruchteile auf ganze Yen abgerundet werden. Eine einzige gemischte Summe über beide Sätze hinweg ist im qualifizierten Rechnungssystem nicht konform.
Die Herausforderung bei der Erfassung ist die Klassifizierung. Eine Rechnung mit Positionen mit gemischten Sätzen — Büromaterial mit 10 % neben abgepackten Getränken mit 8 % — erfordert, dass jede Position der richtigen Steuersatzkategorie zugeordnet wird, damit die nach Sätzen gruppierten Zwischensummen mit den vom Lieferanten angegebenen Summen abgeglichen werden können. Wenn der Lieferant versehentlich eine 10-%-Position in die 8-%-Spalte eingeordnet hat, wird der Vorsteuerabzug in der Verbrauchssteuererklärung des Käufers zu hoch angesetzt — und die Datenabgleichs-Engine der National Tax Agency unterscheidet nicht zwischen vorsätzlicher Falschangabe und dem Vertrauen auf einen Fehler des Lieferanten.
Eine abgeleitete Spalte übernimmt die Steuersatzklassifizierung während der Erfassung: Steuersatz (aus Positionsbeschreibung: Positionen, die Lebensmittel/Getränke ohne Alkohol und Außer-Haus-Verzehr sind → 8 % ermäßigter Satz; Standardwaren/-dienstleistungen → 10 % Standardsatz; ausdrücklich exportbezogen → steuerbefreit). Die KI liest jede Positionsbeschreibung, wendet Japans Dual-Rate-Regeln an und füllt die Spalte Steuersatz. Zwei berechnete Spalten berechnen dann die nach Sätzen gruppierten Zwischensummen — 10-%-Zwischensumme (Summe der Positionsbeträge, wenn Steuersatz = 10 %) und 8-%-Zwischensumme (Summe der Positionsbeträge, wenn Steuersatz = 8 %) — die direkt mit den auf der Rechnung angegebenen Zwischensummen für jede Steuersatzkategorie verglichen werden können.
Die Verbrauchssteuerdaten fließen aus der extrahierten Tabelle in die Verbrauchssteuererklärung als Eingabedaten — der 10-%-steuerpflichtige Gesamtbetrag, der 10-%-Steuerbetrag, der 8-%-steuerpflichtige Gesamtbetrag und der 8-%-Steuerbetrag. Wenn das Extraktionsergebnis jede Position an der Quelle klassifiziert, überprüft der Steuerberater die Klassifizierungen, anstatt sie von Grund auf neu durchzuführen. Der Leitfaden zu häufigen Eingabefehlern bei der Verbrauchssteuer behandelt die spezifischen Fehler, die Steuerdifferenzen auslösen, wenn die Steuersatzklassifizierung manuell statt im Extraktionsschritt erfolgt.
Der Extraktions-Workflow: Vom PDF zur zahlungsbereiten Tabelle
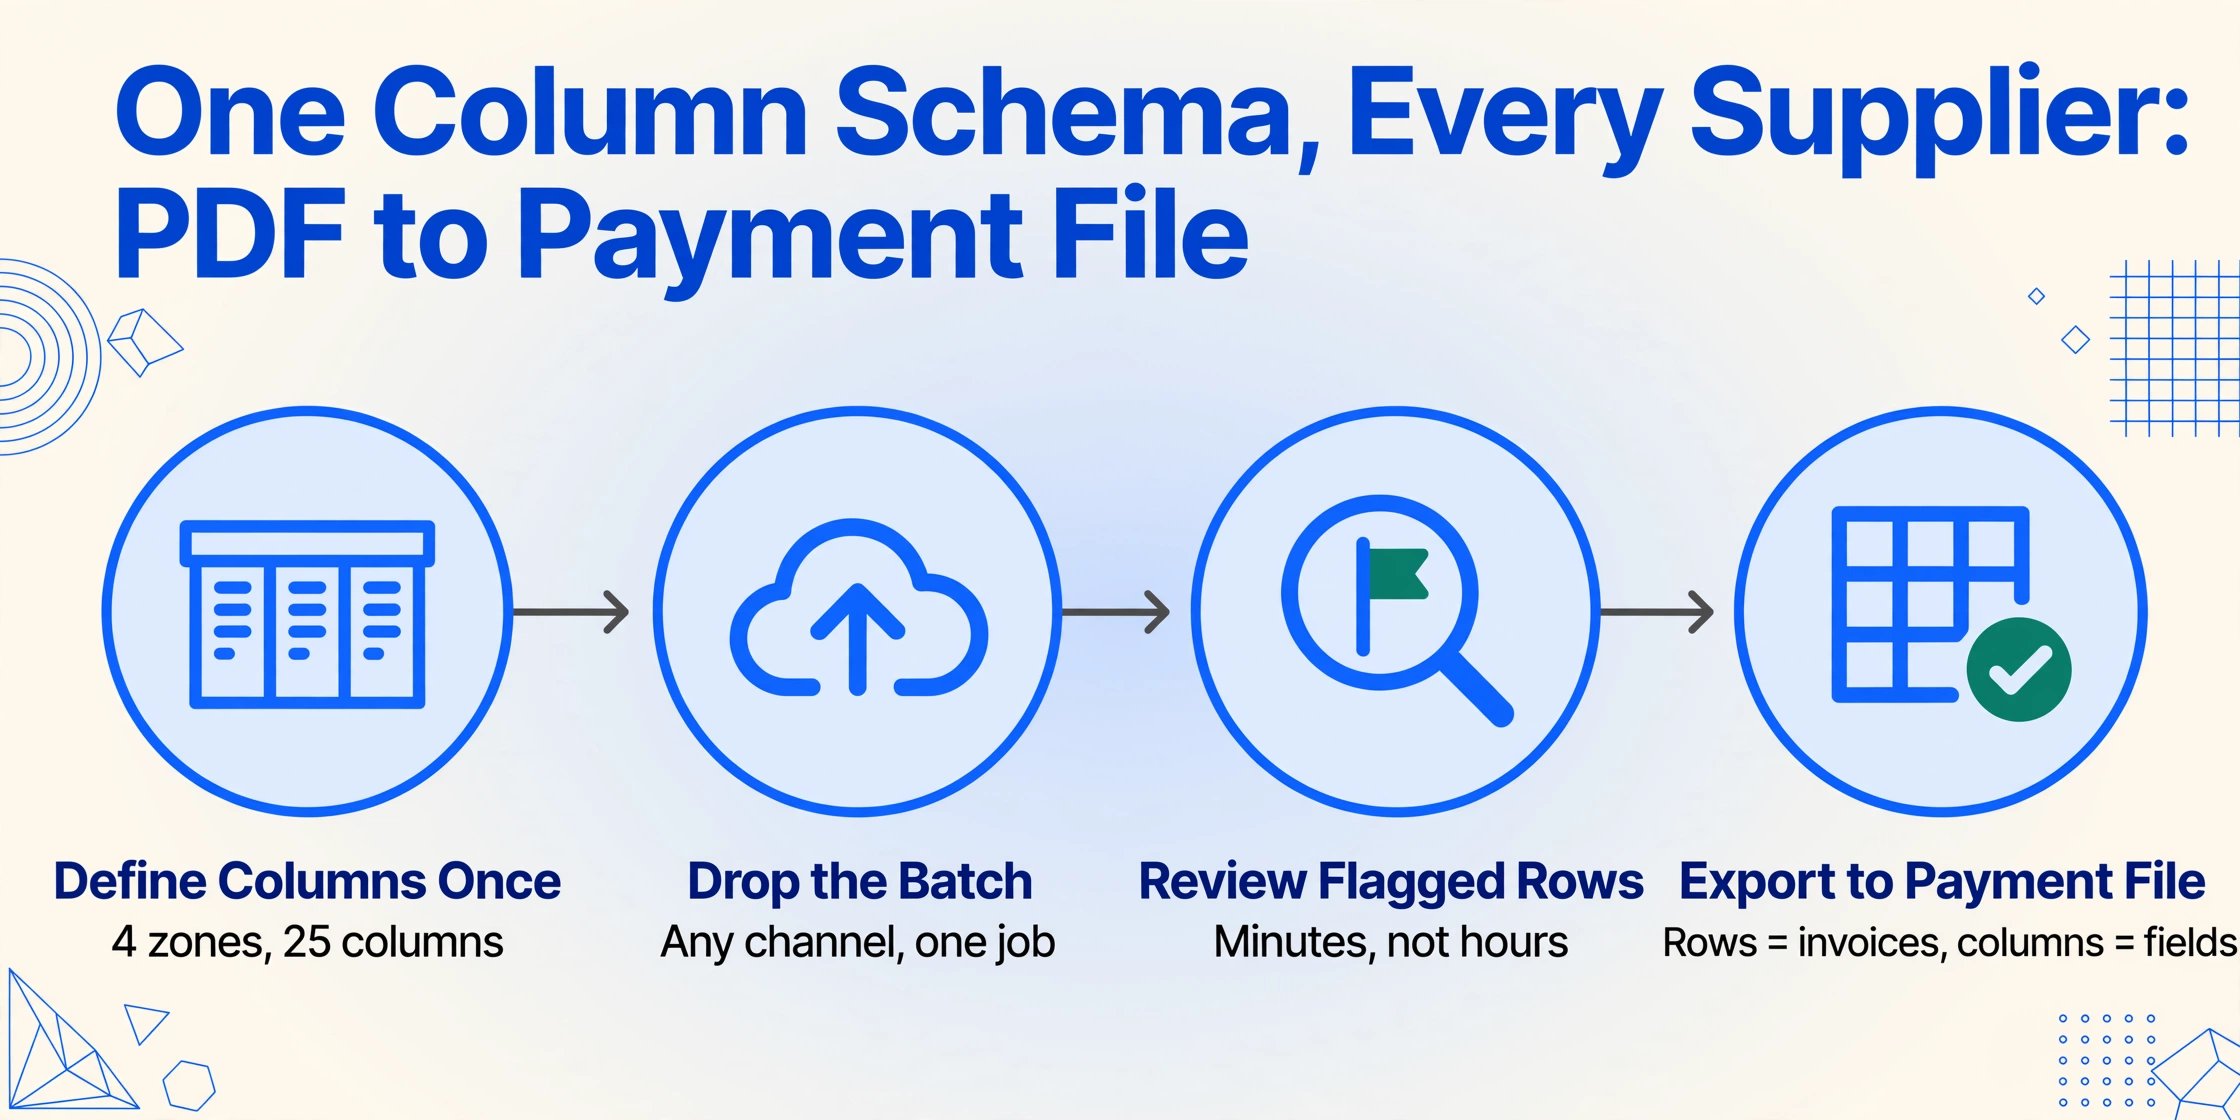
Der Workflow, der die manuelle Übertragung von Rechnungen in Tabellen ersetzt, wird einmal definiert und gilt für jeden Lieferanten, jedes Rechnungsformat und jeden darauffolgenden Monatsend-Batch. Es handelt sich nicht um einen pro Lieferanten eingerichteten Prozess. Das Spaltenschema erfasst, was das AP-Team aus einem Seikyūsho benötigt, unabhängig davon, wer es gesendet hat – die KI liest jedes Dokument und befüllt das Schema, und die Ausgabe landet jedes Mal in denselben Spalten.
Definieren Sie Ihre Extraktionsspalten für japanische Rechnungen einmalig
Geben Sie die Feldnamen als Spaltenüberschriften ein. Für eine vollständige Extraktion japanischer Rechnungen deckt der praktische Spaltensatz vier Bereiche ab: Kopfbereich — Rechnungsnummer (請求書番号), Ausstellungsdatum (発行日), Transaktionsdatum (取引年月日), Lieferant (発行元); Positionen — Artikelname (品名), Menge (数量), Einheit (単位), Einzelpreis (単価), Positionsbetrag (金額); Steuer & Compliance — Registrierungsnummer für qualifizierte Rechnungen (インボイス登録番号), 10 % steuerpflichtiger Betrag (10%対象額), 10 % Verbrauchssteuer (10%消費税), 8 % steuerpflichtiger Betrag (8%対象額), 8 % Verbrauchssteuer (8%消費税), Gesamtbetrag (合計金額), Gensen Chōshū Kubun (Quellensteuer-Klassifizierung) (源泉徴収区分); Zahlung & Bankverbindung — Bankname (振込先銀行名), Filialname (支店名), Kontotyp (口座種別), Kontonummer (口座番号), Kontoinhaber (口座名義), Shiharai Jōken (Zahlungsbedingungen) (支払条件), Überweisungsgebührenübernahme (振込手数料負担). Fügen Sie berechnete Spalten für Abrechnungsstichtag, Zahlungsverzögerung in Monaten, Nettobetrag und Steuersatz (abgeleitete Spalte) hinzu. Dies nutzt die Benutzerdefinierte Spaltenextraktion: Sie definieren das Ausgabeschema mit Spalten, die Ihrer AP-Tabellenstruktur entsprechen, und die KI findet jedes Feld auf der Rechnung eines beliebigen Lieferanten, indem sie versteht, was es bedeutet — und nicht, wo es auf dieser bestimmten Vorlage platziert ist.
Laden Sie alle Monatsend-Rechnungen in einem Stapel hoch
Legen Sie jede Lieferantenrechnung — E-Mail-PDFs, heruntergeladene Abrechnungen aus Lieferantenportalen, Scans von per Post erhaltenen Papierrechnungen und Handyfotos handschriftlicher Rechnungen — in einen einzigen Upload. Die Stapelverarbeitung behandelt sie als einen Auftrag: Jede Rechnung wird unabhängig mit Ihrem Spaltenschema verarbeitet, und alle Ergebnisse werden in einer Tabelle mit einer Zeile pro Rechnung zusammengeführt. Dreißig bis sechzig Rechnungen von zwanzig bis vierzig Lieferanten, jede mit einem anderen Layout aus einem anderen Abrechnungssystem, werden in einem Durchlauf verarbeitet. Die KI identifiziert jedes Dokument als Seikyūsho (japanische Rechnung), indem sie das strukturelle Muster erkennt — Lieferantenblock, Empfängerblock, Datumsfelder, Positionstabelle, Fußzeile mit Zwischensumme/Steuer/Gesamtsumme, Banküberweisungsdetails — und füllt die definierten Spalten, indem sie die relevanten Daten im Dokument lokalisiert. Keine Vorlage pro Lieferant ist erforderlich. Kein Training pro Format ist erforderlich. Die Ausgabe ist eine einzige Datei, auch wenn die Eingabe sechzig verschiedene Dokumente aus dreißig verschiedenen Abrechnungssystemen umfasst.
Überprüfen Sie die Extraktion — nicht die Daten neu eingeben
Die KI füllt jede Spalte aus. Ihre Aufgabe in diesem Schritt ist die Überprüfung, nicht die Erstellung. Durchsuchen Sie die Tabelle nach Feldern, die die KI mit geringerer Konfidenz markiert hat — eine T-Nummer, die am Seitenrand abgeschnitten wurde, ein Ära-Datum, das in einem unerwarteten Format erschien, eine handschriftliche Position mit mehrdeutigen Zeichen. Die Extraktion zeigt diese als markierte Zeilen zur manuellen Prüfung an. Die Überprüfung dauert Minuten. Die manuelle Erstellung — das Öffnen jeder der dreißig Rechnungs-PDFs und das Eintippen derselben Felder in einen anderen Bildschirm — dauert Stunden. Der Unterschied zwischen beiden ist der Wert der Extraktionsebene.
Nach Excel exportieren und nachgelagerte Workflows speisen
Laden Sie die zusammengeführten Ergebnisse als Excel-Datei (XLSX) herunter. Die Ausgabe speist drei Pipelines: Import in Buchhaltungssoftware — strukturierte Spalten werden direkt in 弥生会計, freee, マネーフォワード クラウド会計 oder 勘定奉行 für Einkaufsjournaleinträge importiert. Erstellung von Zahlungsbatches — die Spalten mit den Banküberweisungsdetails (Bank Name, Branch, Account Type, Account Number, Account Holder) sowie die Spalte Net Payment Amount bilden die Eingabe für eine Zahlungsbatch-Datei im 全銀フォーマット (Zengin-Format), die das Online-Banking-System der Bank als Furikomi-Upload akzeptiert. Verbrauchssteuererklärung — die nach Steuersatz gruppierten Verbrauchssteuerspalten fließen in die 消費税申告 ein, wobei die 10%- und 8%-Summen bereits getrennt und subtotalisiert sind. Jede Pipeline erhält strukturierte Daten, die einmal extrahiert und dreimal wiederverwendet wurden, anstatt sie für jedes System separat einzugeben.
Dateien werden sicher verarbeitet und nicht gespeichert.
Batch-Verarbeitung für den Monatsabschluss AP
Beim Monatsabschluss in einem japanischen Unternehmen, das von dreißig bis fünfzig inländischen Lieferanten einkauft, gehen Lieferantenrechnungen über drei Kanäle ein: E-Mail-PDFs von Unternehmen mit Abrechnungssoftware, heruntergeladene PDFs von Lieferantenportalen (bei größeren Handelsunternehmen und Herstellern) sowie Papierrechnungen per Post, die gescannt oder fotografiert und als PDF gespeichert werden. Alle drei Kanäle treffen in derselben Woche des Monats am selben Schreibtisch ein, und alle drei fließen in denselben AP-Verarbeitungszyklus ein.
Batch-Verarbeitung bedeutet, dass alle diese Rechnungen — unabhängig von Quellkanal, Lieferant oder Layout — als ein einziger Auftrag verarbeitet werden. Das Spaltenschema wird auf jedes Dokument im Batch angewendet. Das Ergebnis ist eine einzige Tabelle, in der jede Zeile eine Rechnung und jede Spalte ein extrahiertes Feld ist. Die dreißig bis fünfzig Rechnungen, die über drei Kanäle und zwanzig bis dreißig verschiedene Abrechnungssysteme eingegangen sind, befinden sich nun in einer einzigen Datei mit einheitlicher Struktur.
Drei operative Entscheidungen, die die Batch-Verarbeitung verändert:
Das AP-Team wechselt vom Abtippen zur Überprüfung. Die Extraktion füllt die Tabelle — die Aufgabe des AP-Sachbearbeiters besteht nun darin, Spalten auf markierte Punkte zu prüfen (eine T-Nummer mit geringer Konfidenz, ein seltsam klingender Bankfilialname, eine berechnete Zahlungsverzögerung, die falsch erscheint), anstatt die Daten von Grund auf zu erstellen. Die Überprüfung dauert pro Batch Minuten. Die Erstellung — Öffnen jeder PDF, Finden der richtigen Felder, Eintippen in einen anderen Bildschirm — dauert Stunden.
Die Tabelle wird zur einzigen Wahrheitsquelle für drei nachgelagerte Systeme. Die Buchhaltungssoftware erhält ihre Einkaufsbuchungs-Einträge. Das Banksystem erhält seine Zahlungsbatch-Daten. Die Steuererklärung erhält ihre Verbrauchssteuer-Eingabedaten. Wenn sich die drei Systeme auf dieselben extrahierten Daten stützen statt auf drei separate manuelle Eingaben, lässt sich eine Abweichung in einem System auf die Extraktionsausgabe zurückführen — nicht auf einen Tippfehler in einer von drei getrennten Dateneingabeübungen.
Dasselbe Spaltenschema funktioniert auch im nächsten Monat. Lieferanten können ihre Rechnungslayouts ändern. Neue Lieferanten können hinzukommen. Das Schema — definiert durch die Bedeutung jedes Felds, nicht durch seine Position — muss nicht aktualisiert werden. Der Leitfaden zur Batch-Verarbeitung zeigt ein Beispiel mit dreißig Rechnungen mit Furikomisaki (Bankverbindung), Quellensteuerberechnungen und Zahlungsplanung, gruppiert nach Shimebi (Abrechnungsstichtag).
Zengin-Format: Von Tabellenspalten zu einer bankfähigen Zahlungsstapeldatei
Das Zengin-Format (全銀フォーマット) ist ein festformatiges Dateiformat, das vom Japanese Banks' Payment Clearing Network (全国銀行資金決済ネットワーク) standardisiert wurde. Es ermöglicht einem Unternehmen, mehrere Furikomi-Überweisungen in einem einzigen Upload einzureichen, anstatt sie einzeln über die Internet-Banking-Oberfläche einzugeben. Jede größere japanische Bank akzeptiert das Format für Sammelüberweisungen über ihren Firmen-Banking-Dienst (FB).
Das Format umfasst 120 Bytes pro Zeile, ist Shift-JIS-kodiert und besteht aus vier Datensatztypen:
| Datensatztyp | Kennung | Inhalt | Wichtige Felder |
|---|---|---|---|
| Kopfsatz | 1 | Informationen zu überweisender Bank und Konto | Bankcode (4 Stellen), Filialcode (3 Stellen), Kontonummer (7 Stellen), Überweisungsdatum (MMDD) |
| Datensatz | 2 | Ein Datensatz pro Empfängerüberweisung | Bankcode des Empfängers (4 Stellen), Filialcode (3 Stellen), Kontotyp (1: Futsū (Girokonto)/2: Tōza (Kontokorrentkonto)), Kontonummer (7 Stellen), Empfängername (Katakana, 30 Zeichen), Überweisungsbetrag (10 Stellen, rechtsbündig mit Nullen aufgefüllt) |
| Summensatz | 8 | Stapelsummen | Gesamtanzahl (6 Stellen), Gesamtbetrag (12 Stellen) |
| Endesatz | 9 | Dateiende-Marker | N/A |
Die Verbindung von der Extraktion zum Zengin-Format ist eine Datenpipeline, keine Dateikonvertierung. Die Extraktionsausgabe enthält Bankname, Filialname, Kontotyp, Kontonummer, Kontoinhabername und Nettozahlungsbetrag – jeweils in einer eigenen Spalte. Diese Spalten sind genau die Felder, die jeden Datensatz in der Zengin-Datei befüllen. Der Bankcode (4 Stellen) und der Filialcode (3 Stellen) – numerische Kennungen im Zengin-Format, die sich von den Textnamen auf der Rechnung unterscheiden – können über eine Nachschlagetabelle aufgelöst werden, die das AP-Team einmal pflegt: eine Zuordnung von Lieferantenbanknamen und Filialnamen zu ihren Zengin-Bankcodes und Filialcodes.
Eine berechnete Spalte kann diese Suche während der Extraktion durchführen: Zengin-Bankcode (Nachschlag aus Banknamen-Zuordnungstabelle). Die Spaltenausgabe enthält den numerischen Bankcode, der für den Zengin-Datensatz bereit ist, nicht den Banknamen, den die Rechnung anzeigt. Die Umwandlung von Tabelle zu Zengin – von den Extraktionsausgabespalten zum festformatigen 120-Byte-Format – kann anschließend mit einer Tabellenformel oder einem einfachen Skript erfolgen. Die Extraktion tut, wofür sie entwickelt wurde: strukturierte Daten in Spalten erzeugen. Die Zahlungsstapelgenerierung verwendet diese Spalten als Eingabe.
The Japanese Banks' Payment Clearing Network veröffentlicht die offiziellen Zengin-Systemspezifikationen (PDF). Einzelne Banken veröffentlichen ihre eigenen FB-Upload-Formatspezifikationen, einschließlich der spezifischen Zeichenkodierung (JIS oder Shift-JIS), der Feldauffüllungsregeln (rechtsbündig mit Nullen für numerische Felder, linksbündig mit Leerzeichen für Namensfelder) und der Felder, die leer bleiben dürfen. Die Extraktionsausgabe ist formatunabhängig – sie erzeugt Spalten. Das AP-Team oder ein Skript formatiert diese Spalten gemäß der Zengin-Spezifikation der jeweiligen Bank, die das Unternehmen verwendet.
Compliance durch strukturierte Extraktion im Rahmen des Indefinite Invoice System (Qualifiziertes Rechnungssystem)
Das Qualifizierte Rechnungssystem hat drei neue Compliance-Prüfschritte geschaffen, die jedes AP-Team nun bei jeder Lieferantenrechnung durchführen muss:
- Prüfung der Registrierungsnummer – bestätigen, dass die T+13-Nummer auf der Rechnung zum Lieferanten gehört, mit dem öffentlichen Register der National Tax Agency übereinstimmt und weder abgelaufen noch widerrufen ist.
- Trennung der Steuersätze – bestätigen, dass die Rechnung Artikel mit 8 % ermäßigtem Satz korrekt von Artikeln mit 10 % Standardsatz trennt und dass die nach Steuersatz gruppierten Zwischensummen und Steuerbeträge arithmetisch korrekt sind (steuerpflichtige Basis × Satz, Bruchteile abgerundet).
- Berechnung des Übergangs-Vorsteuerabzugs – für Rechnungen von nicht registrierten Lieferanten den reduzierten Vorsteuerabzug gemäß dem Übergangszeitplan berechnen (80 % abzugsfähig bis September 2026, 50 % bis September 2029, danach null).
Vor dem System prüfte ein AP-Sachbearbeiter zwei Dinge: Sieht der Rechnungsbetrag richtig aus und ist der Lieferant in der Stammdatei? Jetzt muss der Sachbearbeiter pro Rechnung drei zusätzliche Compliance-Dimensionen prüfen. Bei dreißig bis fünfzig Rechnungen zum Monatsende sind das neunzig bis einhundertfünfzig zusätzliche Prüfschritte, die es vor Oktober 2023 nicht gab. Die Analyse, wie die Rechnungsreform 2023 die Finanzverarbeitung erschwert hat erläutert die Änderung der Prüfliste vor und nach der Reform im Detail.
Die strukturierte Extraktion übernimmt den mechanischen Teil dieser Prüfungen. Eine Spalte für die Registrierungsnummer macht sie per Einzelspalten-Abfrage gegen das Register der National Tax Agency durchsuchbar. berechnete Spalte für nach Steuersatz gruppierte Zwischensummen machen diese direkt mit den vom Lieferanten angegebenen Beträgen vergleichbar. Eine Spalte für den Registrierungsstatus des Lieferanten im Rechnungssystem kennzeichnet, ob die Übergangs-Vorsteuerabzugsberechnung anwendbar ist. Das AP-Team prüft weiterhin – aber Prüfung bedeutet nun, extrahierte Daten mit Quelldaten in einer Tabellenkalkulation zu vergleichen, nicht jeden Steuerabschnitt der Rechnung zu lesen und die Steuersatz-Arithmetik auf einem Taschenrechner durchzuführen. Der vollständige Leitfaden zur Extraktion qualifizierter japanischer Rechnungen behandelt den Prüfworkflow – Abgleich der Registrierungsnummer, Steuersatz-Arithmetik und Übergangs-Vorsteuerabzugsberechnung – im Detail.
So passen diese Artikel zusammen: Der japanische Rechnungs-Cluster
Dieser Leitfaden ist der zentrale Artikel eines Clusters aus sechs Artikeln, die die Extraktion japanischer Rechnungen (請求書) aus jedem Blickwinkel abdecken – Anleitung, Batch-Verarbeitung, Problemanalyse, Kosten, häufige Fehler und diese vollständige Referenz. Jeder Artikel behandelt eine Dimension, die für sich allein steht, aber durch den Cluster an Kontext gewinnt. So fügen sie sich zusammen:
Die Anleitung: Tutorial zur Extraktion auf Feldebene
Die Schritt-für-Schritt-Extraktionsanleitung deckt den praktischen Arbeitsablauf ab: Definieren Sie Ihre fünfundzwanzig Spalten – von 請求書番号 bis 振込先口座番号 – einmal und wenden Sie dann dasselbe Schema auf jede Lieferantenrechnung an, unabhängig vom Layout. Sie enthält die Iframe-Demo, die Definitionen für berechnete Spalten zur Zahlungsbedingungsanalyse und Quellensteuerberechnung sowie die Pipeline für den Export in Buchhaltungssoftware. Beginnen Sie hier, wenn Sie Ihre erste Charge japanischer Rechnungen verarbeiten.
Der Batch: Dreißig Rechnungen, eine zahlungsbereite Datei
Der Leitfaden zur Batch-Verarbeitung führt durch den Monatsend-Workflow: Legen Sie dreißig Seikyūsho in einen Batch, erhalten Sie Furikomi-Bankdaten in separaten Spalten, vorberechnete Gensen-Quellensteuer und nach Steuersatz aufgeschlüsselte Verbrauchssteuer. Er deckt die gesamte Kette von der Extraktionsausgabe bis zur Erstellung des Zahlungsbatches ab – der Schritt, in dem strukturierte Bankspalten zu einer Furikomi-Upload-Datei werden.
Das Problem: Shimebi-Fristen bei dreißig Lieferanten
Die Analyse der Shimebi-Zahlungsfristen untersucht, warum dreißig Lieferanten mit unterschiedlichen Abrechnungsstichtags-Konventionen ein Cashflow-Planungsproblem schaffen, das ein Zahlungskalender nicht lösen kann – und wie die Extraktion des Abrechnungsstichtags aus dem Zahlungsbedingungstext eine undurchsichtige Zeichenfolge in ein berechenbares Feld verwandelt, das eine Formel planen kann.
Die Kosten: Was manuelle Verarbeitung pro Abrechnungszyklus kostet
Die Kostenanalyse der manuellen Seikyūsho-Verarbeitung beziffert den Arbeitsaufwand pro Monatsendzyklus – Stunden des Abtippens von Bankdaten, der Quellensteuerberechnung und der Verbrauchssteuerprüfung – im Vergleich zu den Kosten einer Extraktionsebene, die dieselbe Arbeit in Minuten erledigt. Für KMU, die dreißig bis sechzig Lieferantenrechnungen pro Monat verarbeiten, sind die Einsparungen pro Zyklus in Yen und Stunden messbar.
Die Fehler: Verbrauchssteuerfehler, die bis zur Steuererklärung reichen
Der Leitfaden zu häufigen Dateneingabefehlern bei der Verbrauchssteuer behandelt spezifische Fehler – 8-%-Positionen, die als 10 % klassifiziert werden, Rundungsabweichungen durch positionsweise statt steuersatzweiser Rundung, Fehler bei der Datumsumrechnung von Jahreszahlen, die Transaktionen in den falschen Berichtszeitraum verschieben – und wie die Extraktion mit berechneten Spalten diese bereits bei der Datenerstellung abfängt, statt erst bei der Steuerabstimmung.
Zwei verwandte Artikel gehen über den japanischen Rechnungscluster hinaus und befassen sich mit angrenzenden Dokumenttypen, die sich die Extraktionslogik mit Seikyūsho teilen:
Bank Passbook (通帳) Extraction
Der vollständige Leitfaden zur Extraktion japanischer Bankpassbücher (通帳) behandelt die andere Seite der Zahlungsgleichung: den Transaktionsdatensatz, den die Bank druckt — und den Einzelunternehmer und kleine Unternehmen als primäres Finanzdokument für die Steuererklärung nutzen. Das fünfspaltige Ledger-Format des Passbuchs, die im Geldautomaten gedruckten Punktmatrix-Zeichen und die Prüflogik des laufenden Saldos teilen Extraktionsherausforderungen mit dem Seikyūsho, einschließlich der Umrechnung von Ära-Daten und der Identifizierung von Furikomi-Transaktionen.
Australian BAS Extraction
Der vollständige Leitfaden zur Extraktion australischer BAS-Daten behandelt ein anderes nationales Steuerdokument — die Business Activity Statement —, das mit japanischen Rechnungen die strukturelle Herausforderung teilt, mehrere Steuerarten aus einem einzigen Dokument zu extrahieren und sie in separate nachgelagerte Steuererklärungen einzuspeisen. Der Spaltendefinitionsansatz ist derselbe; das Schema ist anders.
Häufig gestellte Fragen
Kann KI-Extraktion japanische Rechnungsdaten lesen, die mit einem Smartphone-Foto aufgenommen wurden?
Ja — das zugrunde liegende Vision-Sprachmodell verarbeitet das Bild als visuelle Eingabe, nicht als textbasierte OCR. Ein Mobilfoto einer Papierrechnung, aufgenommen unter Bürobeleuchtung mit etwas Perspektivverzerrung, ist eine gültige Eingabe. Die KI liest die Felder, indem sie versteht, wie sie aussehen und was sie bedeuten — nicht, indem sie ein perfekt flach gescanntes Dokument voraussetzt. Dasselbe Spaltenschema, das bei einer ERP-generierten PDF eines Lieferanten funktioniert, funktioniert auch bei einem Foto einer handschriftlichen Rechnung eines kleinen Dienstleisters — weil die Extraktion die Feldidentität liest, nicht die Feldposition.
Was passiert, wenn die Zahlungsbedingungen auf der Rechnung ein ungewöhnliches Format verwenden?
Eine berechnete Spalte, die die Parsing-Logik definiert — „20日締“ → Abrechnungstag 20, „月末締“ → Abrechnungstag 31 — deckt die Standardmuster ab. Bei nicht standardkonformen Bedingungen („15日締翌々月20日払い“ oder völlig anders formulierten Bedingungen) gibt die Extraktion den Originaltext in der Spalte Zahlungsbedingungen aus und markiert die berechnete Spalte zur manuellen Prüfung. Das AP-Team prüft diese markierten Zeilen — eine oder zwei von dreißig — anstatt die Zahlungsbedingungen jeder Rechnung von Hand zu parsen. Mit der Zeit, wenn die Logik der berechneten Spalte erweitert wird, um neue Muster abzudecken, sinkt die Anzahl der markierten Zeilen.
Verarbeitet die Extraktion Kontonummern der Japan Post Bank (ゆうちょ銀行) korrekt?
Ja, über eine abgeleitete Spalte, die ゆうちょ銀行 als Banknamen erkennt und die Umrechnungsregel der Japan Post Bank von Symbol-Nummer auf 7-stellige Überweisungskontonummer während der Extraktion anwendet. Die Ausgabe enthält sowohl die ursprüngliche Kontoreferenz (zur Überprüfung gegen die Rechnung) als auch die umgerechnete Überweisungskontonummer (für die Erstellung des Zahlungs-Batches). Die Japan Post Bank veröffentlicht die Umrechnungsregel auf ihrer Website.
Wie verarbeitet die Extraktion Rechnungen mit gemischten 10%- und 8%-Verbrauchssteuerpositionen?
Eine abgeleitete Spalte liest jede Positionsbeschreibung und klassifiziert sie als 8 % ermäßigt oder 10 % Standard basierend auf Japans Verbrauchssteuerkategorien (Lebensmittel und alkoholfreie Getränke ohne Restaurantbesuche → 8 %; die meisten anderen Waren und Dienstleistungen → 10 %). Berechnete Spalten bilden dann Zwischensummen für jede Steuerkategorie. Das AP-Team überprüft die Klassifizierung anhand der vom Lieferanten angegebenen Zwischensummen — ein Vergleichsschritt statt eines Klassifizierungsschritts. Bei Rechnungen, bei denen der Lieferant ermäßigte Positionen nicht kennzeichnet, ist die abgeleitete Klassifizierung der einzige Weg, um zu überprüfen, ob die Gesamtsumme des Lieferanten korrekt ist, ohne jede Rechnungs-PDF erneut zu öffnen.
Was ist der Unterschied zwischen diesem Leitfaden und dem Leitfaden zur Extraktion qualifizierter Rechnungen?
Der Leitfaden zur Extraktion qualifizierter Rechnungen konzentriert sich auf die sechs Pflichtfelder einer konformen qualifizierten Rechnung (適格請求書) unter dem Indefinite Invoice System, einschließlich des Übergangszeitplans für den Vorsteuerabzug, des Überprüfungsprozesses der National Tax Agency-Registrierung und der besonderen Herausforderungen handschriftlicher und vertikal formatierter Rechnungen. Dieser Leitfaden deckt die breitere Seikyūsho-Extraktionslandschaft ab — jedes Feld, auf das ein AP-Team stößt, die vollständige Pipeline von Extraktion über Zahlung bis Steuer und die Zengin-Format-Integration, die der Leitfaden für qualifizierte Rechnungen nicht abdeckt. Lesen Sie den Leitfaden für qualifizierte Rechnungen für compliance-spezifische Tiefe. Lesen Sie diesen Leitfaden für den End-to-End-Prozess.
Kann ich auch die Einzelposten — nicht nur die Kopfsummen — aus einer japanischen Rechnung extrahieren?
Ja. Das in diesem Leitfaden beschriebene Spaltenschema enthält neben Kopf- und Fußfeldern auch Einzelposten-Spalten (品名, 数量, 単位, 単価, 金額). Jeder Einzelposten wird zu einer Zeile in der Ausgabetabelle, wobei die Kopffelder (Rechnungsnummer, Lieferant, Ausstellungsdatum) in jeder Zeile wiederholt werden, sodass jeder Einzelposten seiner Quellrechnung zugeordnet werden kann. Diese Struktur unterstützt den Drei-Wege-Abgleich — Bestellung mit Lieferschein und Rechnung — bei dem einzelne Einzelposten und nicht nur die Rechnungssummen verglichen werden müssen.