完全ガイド:
納品書&PODデータ抽出
トラックが倉庫に到着します。ドライバーが納品書を手渡します。カーボン複写の感熱紙には、手書きの数量と受領欄に走り書きされた署名があります。荷物は降ろされますが、その紙のデータがTMSに届くまでには24〜72時間かかります。誰かが遅いからではありません。誰かが手書きを読み解き、ドライバーの略語を解読し、発注書・運送会社の請求書・顧客の配送確認と照合できるように、5つの異なる画面にすべてのフィールドを入力しなければならないからです。
重要ポイント
- すでに信頼している抽出ツールは、印刷テキストでは95%の精度を誇りますが、納品書のほぼ100%を占める手書きフィールドでは15%しかありません。
- 手書きの走り書きで「48」と「50」を読み間違えるだけで、3つの部門をまたぐ20〜45分の紛争が発生し、誰も予算化していません。
- Vision AIは、文字ピクセルの照合ではなく、各フィールドの意味を理解することで手書き納品書を読み取ります。1枚あたり4分の入力作業が、10秒のバッチアップロードに変わります。
納品書・配送証明書(POD)抽出とは?
納品書と配送証明書(POD)の抽出とは、貨物配送に同行する紙の伝票に記載された手書き・印刷の配送確認項目(納品書番号、日付、荷送人、荷受人、運送会社、追跡番号、明細数量、署名など)を自動で読み取り、TMS、ERP、照合用スプレッドシートに取り込める構造化データに変換するプロセスです。従来は、シフト終了時に事務員やドライバーがカーボン複写の伝票の束から各項目を手入力していましたが、1枚あたり3〜6分かかり、手書き部分では項目ごとのエラー率が5%を超えることもあります。抽出ソフトウェアは各文書を全体として読み取り、各項目がページ上のどこにあるかではなく「何を意味するか」を理解し、照合にすぐ使える構造化テーブルを出力します。
納品書は梱包明細書とは異なりますが、両者はよく混同されます。梱包明細書はサプライヤー向けの文書で、倉庫から商品とともに移動し、「注文したもの」と「出荷したもの」の対比を示します。納品書(納品受領書、貨物引渡書、配送証明書とも呼ばれます)は運送会社向けの文書で、実際に到着したもの、誰が署名したか、例外(破損、不足、受取拒否)があったかどうかを記録します。重要な違いは、納品書には手書きの署名、ドライバーのメモ、例外コードが含まれる点で、梱包明細書にはこれらがありません。類似の文書タイプの詳細な紹介については、梱包明細書データ抽出とはの記事をご覧ください。本ガイドでは、主な入力が手書きで、スマートフォンで撮影され、法的な配送証明として機能する場合の抽出における特有の課題に焦点を当てます。
請求、クレーム、運送会社との決済を左右するラストマイル文書である「署名済み配送証明」側のワークフローに特化している場合は、物流業務向けにPODデータをExcelへ抽出する専用のチュートリアルをご覧ください。DSOへの影響、TMSインポート列、複数停車地のマニフェストについて詳しく解説しています。
手作業による納品書処理が、あなたが思う以上にコストがかかる理由
手作業による納品書処理のコストは、物流オペレーション、買掛金(AP)、カスタマーサービスの3つの部門に分散しているため、目に見えにくくなっています。各部門はそれぞれの症状しか見えておらず、全体の連鎖を見ることはできません。
ラストマイル配送の紛争
顧客が48個受け取ったと主張する一方で、納品書には50個と記載され、受領数量欄の手書きが「48」か「50」のどちらにも読める場合、誰が負担するのでしょうか。運送会社は不足している2個分を荷主に請求します。荷主の買掛金(AP)チームは運送会社の請求書を保留にします。物流オペレーションの誰かが紙の納品書を探さなければなりませんが、それは運転席にあるか、倉庫に保管されているか、紛失している可能性もあります。そして、署名欄が判読できるかどうかを確認する必要があります。各紛争は複数の役割にわたって20〜45分を消費します。週に500件の配送を行う中規模の車両群では、紛争率が1%でも週に5件の紛争が発生し、部門横断的な作業時間は約2.5〜5.5時間にもなり、誰も予算化していません。
配送証明書(POD)の不一致は支払い遅延につながる
運送会社の支払い条件は通常、有効な配送証明書(POD)の受領から30日以内です。「有効な配送証明書(POD)」とは、運送会社の請求書の明細項目と一致する署名済みの納品書を意味します。配送証明書(POD)が判読不能、不完全、または運転手の書類から出てくるまでに3日かかる場合、時計は動き始めません。運送会社の請求書は支払われず、運送会社はフォローアップし、買掛金(AP)チームは調査し、本来30日で完了するはずの支払いサイクルが45日、60日、またはそれ以上に延びます。運送会社はその遅延を料金に織り込み、荷主は紛争のあるレーンだけでなく、すべてのレーンで1回あたりの輸送費を多く支払うことになります。NMFTAの標準的な船荷証券(BOL)条件は、運送会社への支払いを配送証明書(POD)の入手可能性に明示的に結び付けていますが、配送証明書(POD)の遅延が支払いサイクルにどの程度影響するかを追跡している荷主はほとんどありません。
運転手の走り書きからの手動データ再入力
最も一般的なコストは、最も見えにくいものです。各シフトの終わりに、事務員やデータ入力オペレーターが20〜60枚の納品書の束を読み、各フィールドをTMSまたは照合スプレッドシートに入力します。1枚あたり3〜6分かかります。1シフトあたり40枚、1枚あたり4分の場合、入力だけで2時間40分、つまりシフトの約3分の1になります。物流業界のデータ入力スタッフの総人件費が1時間あたり22〜28ドルだとすると、1シフトあたりの入力作業だけで60〜75ドル、つまりデータ入力担当者1人あたり年間約15,000〜19,000ドルになります。3シフトでデータ入力が必要なフリートでは、年間の人件費は、エラー、紛争、支払い遅延を考慮する前に、約50,000ドルに達します。
手書き文字がこれらのコストをどのように悪化させるかについての詳細な分析は、AIが手書きの納品書を読めるかどうかに関する記事をご覧ください。
納品書抽出の特有の課題
納品書の抽出は、請求書や梱包明細書の抽出よりも難しいものです。これはツールを評価するすべての人にとって重要な理由によります。これらの課題を事前に理解しておくことで、選んだツールが日常のワークフローに対応できるのか、それともデモのシナリオだけに対応できるのかが決まります。
1. 手書き文字が最大の課題 — そしてツールが失敗する最大の理由
照合に重要な納品書のフィールドのほぼ100%が手書きです。受領数量、例外コード、ドライバー名、受領者の署名、納品日などです。現場のドライバーは、トラックの荷台や運転席で、カールして色あせた感熱紙にボールペンで素早く書きます。手書きの「3」は「8」に見えることがあります。列を斜めに走る「50」は印刷されたラベルに重なることがあります。文字レベルのパターンマッチングに依存する従来のOCRエンジンは、このような入力では役に立たない結果を出します。公開されたベンチマークによると、フィールドレベルの手書き文字の精度は15〜40%で、抽出されたデータは目隠しでタイピングするよりも信頼性が低くなります。
筆記具がさらに問題を悪化させます。ドライバーは手元にあるものを使います。ボールペン、油性マーカー、鉛筆、インクが切れかけたペンなどです。感熱紙へのボールペンの筆記は、薄くコントラストの低い跡を残すため、スキャナーやカメラでは読み取りにくくなります。蛍光ペンやスタンプが押されたフィールドは背景ノイズを加え、従来のOCRの文字セグメンテーションを混乱させます。手書きに対応できないツールは、印刷された梱包明細書をどれだけうまく処理できても、納品書には役に立ちません。
手書き文字は納品書上で単独で現れることはほとんどありません。サプライヤーの印刷された出荷データの上に直接重なっており、両方のレイヤーが互いに破損することなく出力スプレッドシートに到達する必要があります。この2層抽出が実際にどのように機能するかについて詳しくは、同じ納品書から印刷された出荷データと手書きの受領確認を抽出するに関する記事をご覧ください。
2. 倉庫環境で撮影されたスマホ写真
バックオフィスに届く納品書のほとんどは、きれいなスキャンではありません。倉庫の受取担当者がスマホで撮影した写真として届きます。斜めの角度、倉庫の照明(蛍光灯の下で深い影ができる)、フレームに収まらない部分(運転手の親指が署名欄を覆っている)、解像度もさまざまです。雨の中で撮影され、感熱紙に水滴がついている写真もあります。また、コンクリートの床や段ボール箱を背景に撮影されたものもあり、従来のOCRはその背景をノイズとして解釈します。
納品書で機能する抽出ソフトウェアは、視覚シーン全体を単一の意味論的な問題として扱う必要があります。「このきれいなページのテキストを見つける」ではなく、「この写真の中から文書を見つけ、遠近感を補正し、手書きと背景を分離し、各フィールドを読み取る」というものです。必要な視覚的理解は、スキャナベースのOCRパイプラインとは根本的に異なります。スマホで撮影された現場文書をVision AIがどのように処理するかについての詳細な分析は、AI手書き文字認識とはのガイドをご覧ください。
3. 署名、印鑑、走り書きが混在するケース
納品書はきれいなフォームではありません。受取人は署名欄に署名し、運転手は余白に納品時間を書き込みます。誰かが「受領済み」の印鑑を運送会社名に重なる角度で押し、別の人が受取数量を丸で囲んで確認します。これらの注記はすべて記録に必要なものです。つまり、何が起こったかの証拠ですが、印刷されたデータの上に重なり、表のセルに重なったり、フィールドラベルを圧迫したりします。
従来のOCRは、注記と重なったテキストを区別できません。「受領済み」の印鑑が「Consignee」という単語を部分的に覆うと、文字化けした文字列が生成されます。印刷された「Qty」の上に丸で囲まれた「80」があると、「Qty80」と読み取られ、注記とラベルの両方が失われます。一方、Vision AIモデルは、文書のコンテキスト(表構造、フィールドラベル、印鑑の位置)を利用して、重なり合う要素を分離し、それぞれを独立してキャプチャします。
4. 感熱紙の劣化
ほとんどの納品書は感熱紙に印刷されています。レシートロールと同じ素材です。熱で反り返り、時間とともに色あせ、暑いトラックの運転室内に置かれると黒く変色します。納品書がバックオフィスに届く頃には——運転手の納品帳に1週間、またはファイルキャビネットに1ヶ月保管された後——印刷された文字はほとんど見えなくなっていることがあります。高コントラストの黒地に白の文字に依存する従来のOCRでは、グレー地にグレーの文字のフィールドとしてしか認識できません。低コントラストで劣化した文書画像でトレーニングされたVision AIモデルは、しきい値ベースのOCRエンジンでは見えない文字を復元できます。モデルは二値のピクセルコントラストではなく、文脈から文字の形状を認識することを学習するためです。
手書きPODにおける従来のOCRとVision AIの比較
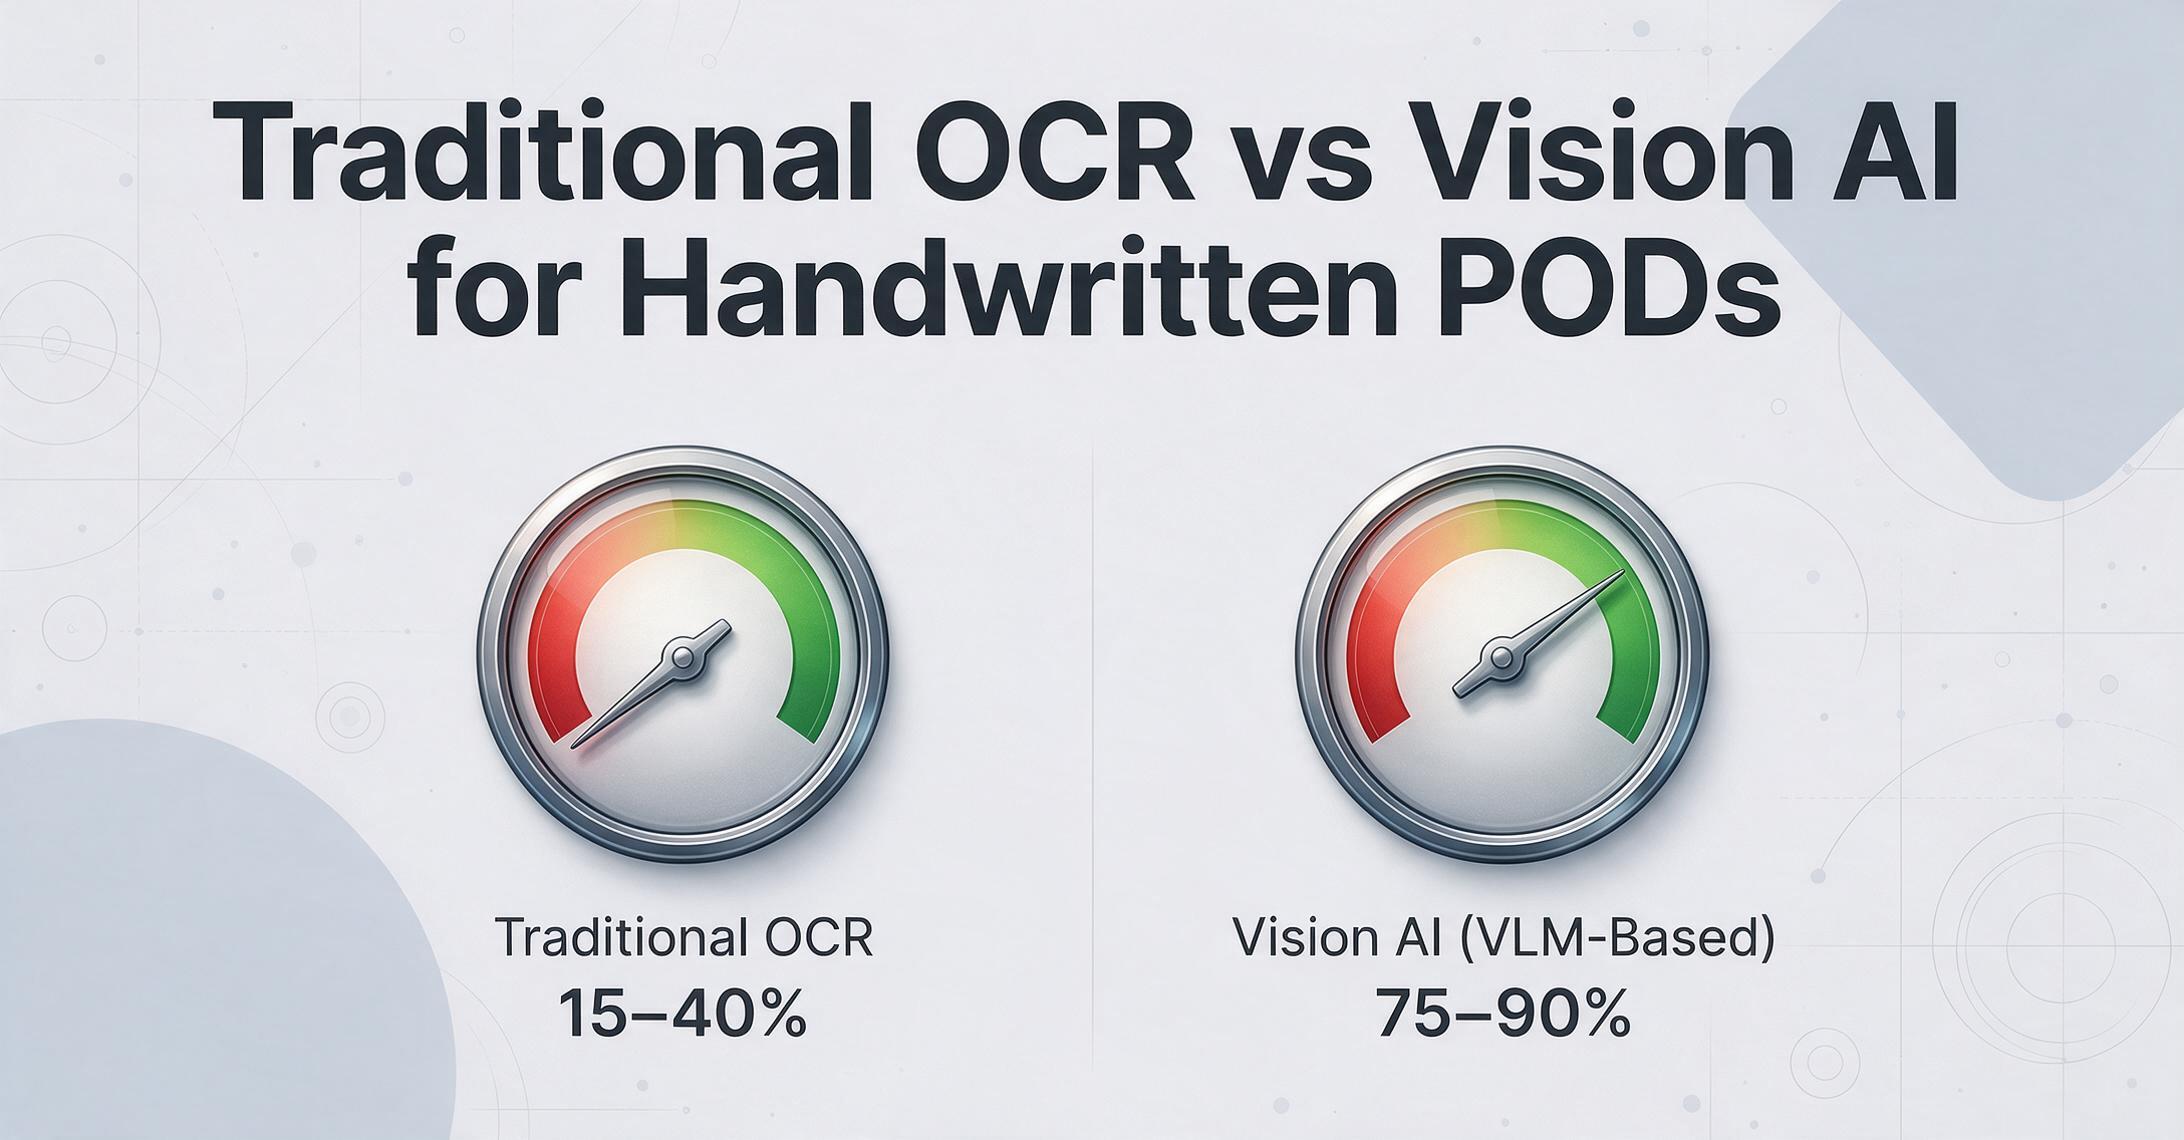
納品書抽出における従来のOCRとVision AIの違いは、漸進的な改善の問題ではありません——それぞれの技術がそもそも何を読み取れるかという、カテゴリー的な違いです。
| 条件 | 従来のOCR | Vision AI(VLMベース) |
|---|---|---|
| 白紙に印刷された鮮明な文字 | 精度95〜99% | 精度98〜99% |
| 手書きの数量(感熱紙にボールペン) | 文字レベル精度15〜40% | フィールドレベル精度75〜90% |
| 影や角度のあるスマホ写真 | 手動の前処理が必要、または失敗 | 遠近感と照明をネイティブに処理 |
| 印刷文字に重なるスタンプ | 文字化けした混在出力 | 両方を分離して独立に読み取り |
| 色あせた感熱紙 | 低コントラスト=読み取り不可 | 文脈による復元が可能 |
| 署名の取得 | 取得不可——テキストではない | 署名画像を特定して保持 |
| キャリアごとのテンプレート設定 | 必須(ゾーンOCR) | 不要(セマンティック抽出) |
従来のOCRは、クリーンな入力——均一なレイアウトの印刷文書の高解像度スキャン——があればうまく機能します。しかし、入力が手書きだったり、照明が悪い状態で撮影されたり、構造的に一貫性がない場合には壊滅的に失敗します。つまり、実際の現場の納品書の大部分では失敗するということです。対照的に、Vision AIは文書を理解します。テーブルを見て右下のセルに「受領数量」が含まれていることを認識し、走り書きの「48」をピクセルパターンの一致ではなく文脈から数字として認識し、署名をテキストとして解読しようとするのではなく、独立した視覚要素として扱います。
その違いを実際にご確認ください——納品書の写真をアップロードして、抽出がリアルタイムで行われる様子をご覧ください:
ファイルは安全に処理され、保存されることはありません。
納品書の抽出で必ず取得すべき重要項目
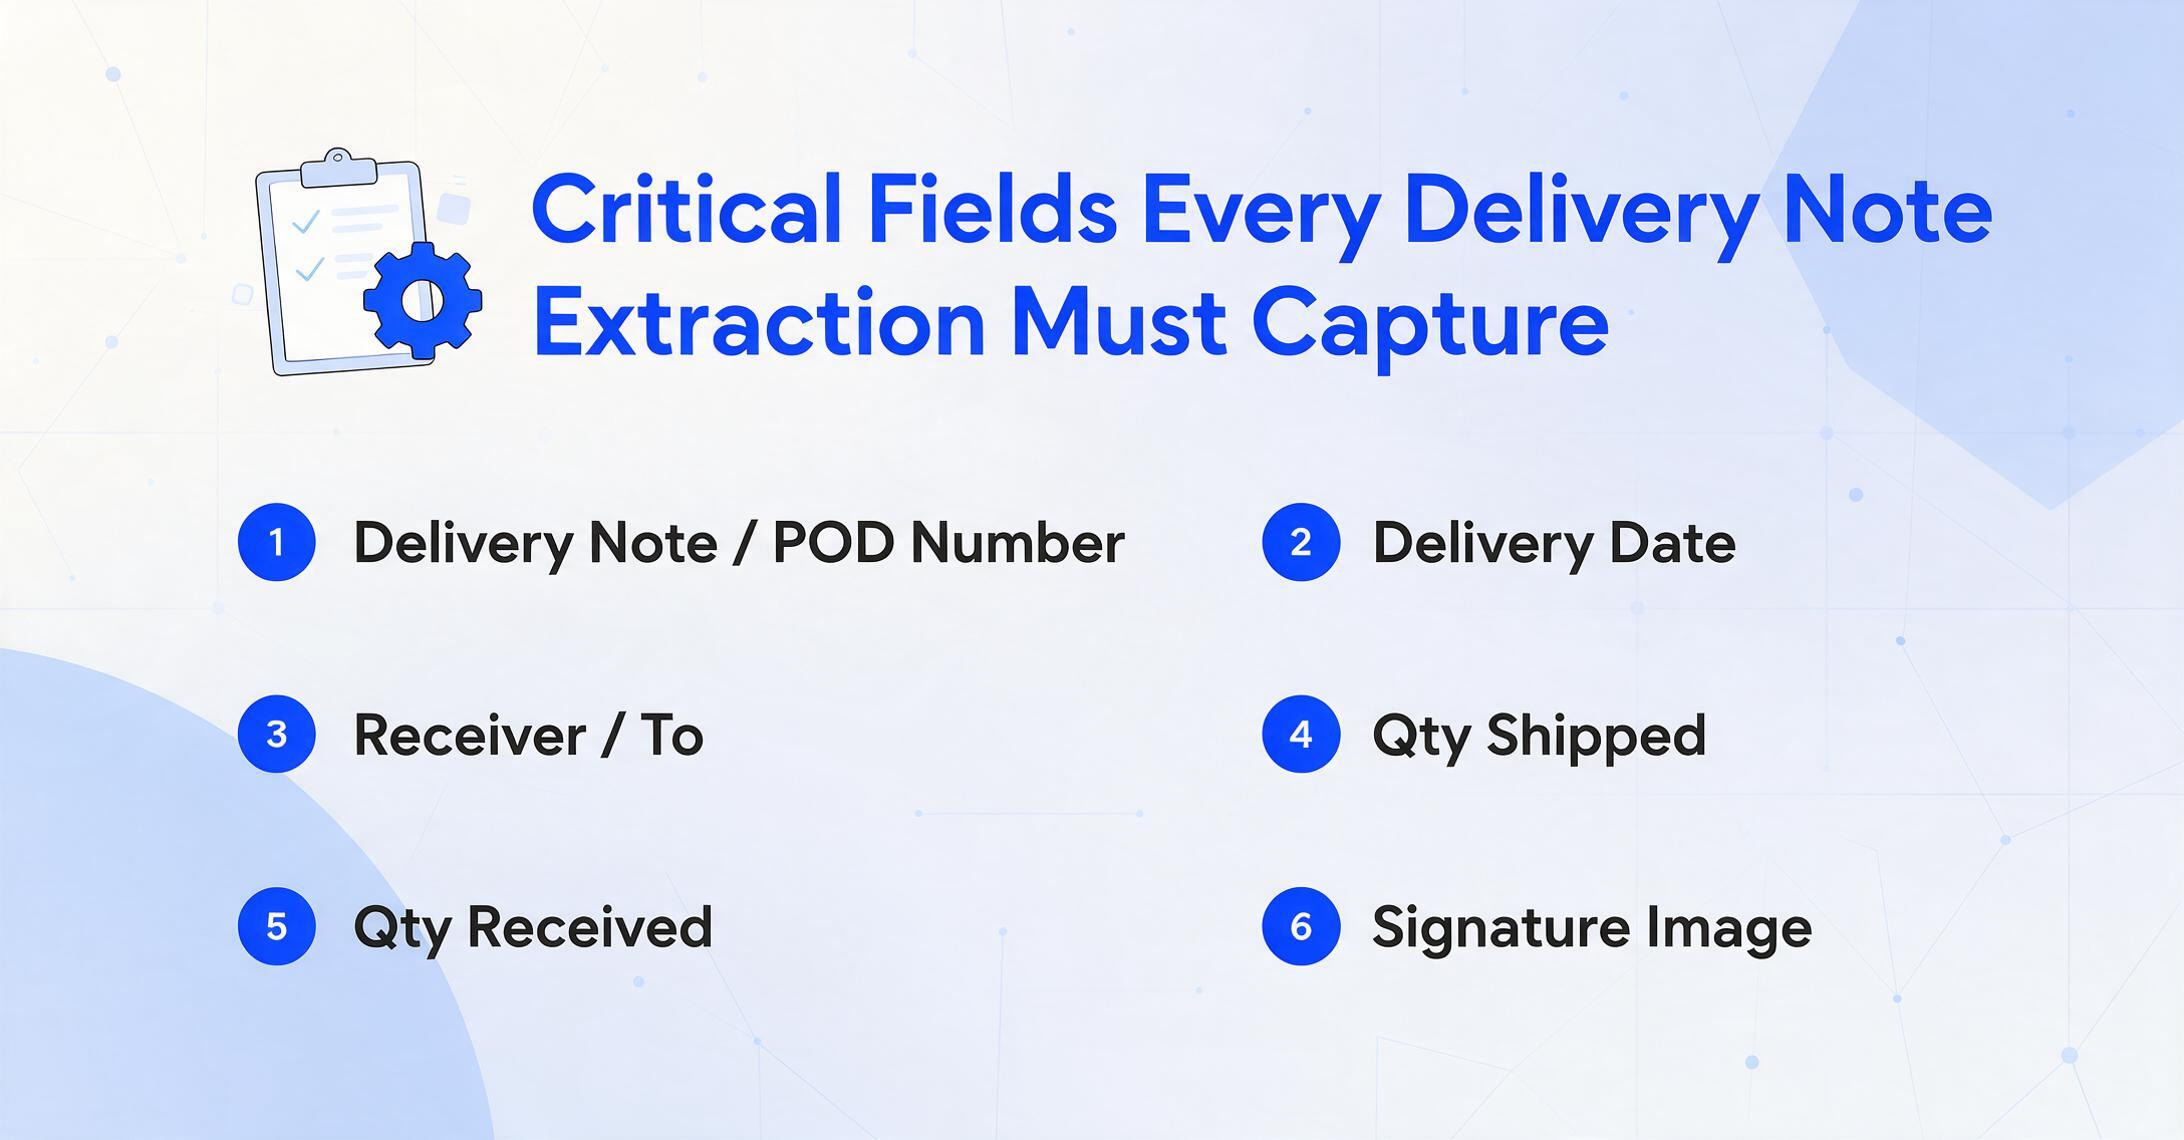
納品書のすべての項目が照合において同じ重みを持つわけではありません。支払い、在庫、紛争解決に関わる項目は特定のセットを形成しており、納品書抽出ツールはそれらを確実に取得する必要があります。手書き入力を例外的なケースではなく、標準的な前提として扱う必要があります。
| 項目 | 表示される場所 | 重要な理由 |
|---|---|---|
| 納品書 / POD番号 | 印刷または手書きスタンプ | 追跡・照合のための一意の識別子。運送会社の請求書との突合に使用 |
| 納品日 | 手書きまたは日付スタンプ | 納品がいつ行われたかを確認 — 支払い期限の開始とOTIF測定の基準となる |
| 荷主 / 発送元 | 印刷(事前入力) | 出発地を特定 — 運送会社の請求書との突合に使用 |
| 受取人 / 届け先 | 印刷または手書き | 届け先を確認 — 不一致があると即座に紛争が発生 |
| 運送会社名 & ドライバー | 印刷 + 手書きのドライバー名 | 納品を担当運送会社に紐付け、支払いとパフォーマンス追跡に使用 |
| 追跡 / PRO番号 | 印刷されたバーコードまたは番号 | 運送会社の内部追跡参照番号 — 照合に必須 |
| 発注書(PO)参照 | 印刷または手書き | 納品を発注書に紐付け、三者照合に使用 |
| 明細行: コード / 説明 | 印刷された表 | 出荷された内容を特定 — 在庫受領に使用 |
| 出荷数量 | 印刷または手書き | 運送会社が積載したと申告する数量 |
| 受領数量 | 手書き — 最も重要な項目 | 受取人が確認する数量。この数値が在庫に入り、支払いのトリガーとなる。ここを誤読すると紛争が発生し、解決に20〜45分かかる |
| 不足 / 欠品 | 手書きの注記 | 部分納品のフラグ — フォローアップが必要かどうかを運用チームに知らせる |
| 破損 / 例外コード | 手書き(例:「1 CTN DMG」) | クレーム処理と運送会社へのチャージバックに重要 |
| 受取人サイン | 手書き — テキストではない | 納品の法的証明。テキストとして書き起こすのではなく、画像として取得する必要がある |
| ドライバーサイン | 手書き | 引き渡しの確認 — POD検証のために一部の運送会社で必須 |
| 備考 / コメント | 手書きの自由記述 | ドライバーの所見、受取人のコメント、納品例外 — 非構造化だが運用上重要 |
受領数量は、照合に最も重要な項目であると同時に、信頼性高く抽出するのが最も難しい項目でもあるため、特別な注意が必要です。ほぼ常に手書きで、多くの場合ライン項目テーブルの小さなボックスに書かれます。「48」と「50」のような一桁の誤読が、運送会社の紛争、在庫調整、買掛金(AP)の保留を引き起こす差異を生み出します。納品書抽出ツールを評価する際は、まず手書き数量を読み取る能力で判断すべきであり、印刷テキストの抽出速度ではありません。
ルート別バッチ処理による日次照合
納品書は個別の文書単位ではなく、ルート単位、ドライバー単位、シフト単位でバッチとして届きます。1日20ルートを運行する車両隊は、20スタックの納品書を生成し、各スタックが1人のドライバーの配送を表します。照合ワークフローは自然にバッチ指向です。ルート12のすべての納品書をルートマニフェストと照合し、数量を顧客の署名済みコピーと照合し、そのルートの運送会社への支払いをリリースします。
ルート別バッチ処理に対応した納品書抽出ツールを使用すると、単一ルートのすべての納品書をバッチとしてアップロードし、各配送が1行に対応する単一のスプレッドシートにフィールドを抽出し、ルート、ドライバー、日付、または例外ステータスで並べ替えやフィルタリングができます。各納品書を個別に開く代わりに、ルート全体を1回のパスで処理します。定義する列名(納品書番号、日付、受領数量、例外)が出力テーブルのヘッダーになり、バッチ内のすべての納品書がそれぞれの行に入力されます。
複数の納品書を同時にバッチ処理する実践的なガイド(ファイル整理のヒントや列設計を含む)については、納品書と配送伝票のExcelへの一括抽出に関するガイドをご覧ください。
バッチアプローチにより日次照合も可能になります。朝一番に当日の納品書をアップロードし、データを抽出し、TMSマニフェストと比較し、紛争になる前に例外を特定します。PODがクリーンなルートは支払いがリリースされます。例外のあるルートは調査用にフラグが立てられます。すべてドライバーの次のシフトが始まる前に行われます。文書抽出が関連する配送書類とともに物流ワークフローにどのように組み込まれるかについての広範な概要は、物流文書抽出ツールのベストまとめをご覧ください。
エクスポート、統合、TMSワークフロー
納品書データは単独では役に立ちません。照合が行われるシステムに流し込む必要があります。ImageToTable.aiは、物流チームが実際に働く方法に合わせた複数のエクスポートパスをサポートしています。
Excelでの照合スプレッドシート作成
最も一般的なワークフローはExcelへのエクスポートです。ルートバッチからすべてのフィールドを単一の.xlsxファイルに抽出し、納品書ごとに1行、照合テンプレートに合わせた列構成で出力します。Excelエクスポートでは、定義した列構造(納品書番号、日付、発注書(PO)参照、出荷数量、受領数量、例外、署名画像(メモとして))が保持されます。抽出から買掛金(AP)チームがすでに使用しているスプレッドシートまでの間に再フォーマットの手順は不要です。今すぐご自身の納品書で抽出結果を確認したい場合は、納品書からExcelへの変換ツールをお試しください。伝票をアップロードすると、数秒で構造化されたテーブルが返されます。
構造化データによるTMS連携
輸送管理システムに納品書データを必要とするチーム向けに、抽出結果は構造化されたCSVまたはJSONとしてエクスポートできます。フィールドマッピング(納品書番号→運送会社参照、受荷数量→配送確認数量、例外コード→ステータスフラグ)は、列設定時に一度定義すれば、すべてのバッチで一貫して適用されます。SAP TM、Oracle TMS、Descartes、project44はすべて、CSVインポートまたはAPI経由で構造化された出荷データを受け入れます。抽出出力はそれらのパイプラインに直接供給されます。関連書類のTMSワークフローへの文書抽出の接続について詳しくは、BOL抽出の完全ガイドをご覧ください。
カスタマーポータルでの配送証明書(POD)
多くの荷主は顧客に配送証明書(POD)の証拠を提供する必要があります。商品が届いたことを証明する署名済みの納品書です。抽出ツールは、受取人の署名を画像フィールドとして、納品書番号をテキストフィールドとして取得するため、出力テーブルの各行には構造化データと署名済み文書への参照の両方が含まれます。抽出出力をカスタマーポータルにアップロードするか、コレクションリンクで共有してください。受信者は、スキャンしたPDFがメールで送信されるのを待つことなく、配送確認を確認できます。
納品書抽出ツールの選び方
ほとんどの文書抽出ツールの比較では、対応フォーマット、出力タイプ、統合オプションなど同じ基準が挙げられます。しかし納品書の場合、優先順位は異なります。ここでは、実際の物流業務で重要となる基準を、重要度順に紹介します。
これは数ある基準の一つではなく、ツールが納品書で機能するかどうかを左右する最重要基準です。ベンダーには、きれいなスキャン文書の印刷文字ではなく、スマホで撮影した手書き数量のフィールド別精度を確認してください。実際の条件下で手書きの納品書フィールドに対して75%以上の精度を出せないツールは、納品書抽出ツールとは言えません。
スキャンしたPDFではなく、倉庫内で撮影した写真でテストしてください。ツールは、遠近法による歪み、不均一な照明、フレームアウト、低解像度に対応できる必要があります。フラットベッドスキャナーを必要とするツールは、ドライバーのスマホで撮影した最初の納品書写真で失敗するでしょう。
ツールは、署名、印鑑、ロゴなどのテキスト以外の要素を識別可能なフィールドとして取得し、無視したり文字起こしを試みたりしてはいけません。署名は法的証拠です。ツールが署名を特定して保持できない場合、抽出データは配送証明書(POD)の目的には不完全です。
納品書は運送会社ごとに数十種類のフォーマットで届きます。運送会社のフォーマットごとにテンプレート設定(領域の指定、フィールドのラベル付け、レイアウトごとのトレーニング)が必要なツールは、毎日複数の運送会社から納品書を受け取る車両運行管理には対応できません。セマンティック抽出(AIが位置ではなく意味でフィールドを見つける)が不可欠です。
単一文書の抽出では、車両運行業務には遅すぎます。ツールは一括アップロード(一度に20枚、50枚、100枚の納品書)に対応し、ルート、日付、ドライバーごとにグループ化された単一の構造化テーブルに出力して、効率的な照合を可能にする必要があります。
出力は照合ワークフローに適合している必要があります。手動レビュー用のExcel、TMSインポート用のCSV、APIパイプライン用の構造化フィールド。バッチごとに再フォーマットが必要な場合、抽出による時間節約は後処理で一部失われます。
市場のほとんどの抽出ツールは、請求書や納品書など、レイアウトが予測可能な印刷文書向けに設計されています。納品書は別のカテゴリです。手書き、撮影、感熱紙の劣化、そして法的証拠としての役割を担います。請求書抽出用に設計された基準を納品書のユースケースに適用すると、印刷PDFのデモでは見栄えがするものの、ドライバーの納品帳からの最初の実際の手書き伝票で失敗するツールを選ぶことになります。
物流文書のニーズに照らして評価した抽出ツールの包括的な比較(納品書、BOL、納品書類を含む)については、2026年の物流文書抽出ツールのベストの記事をご覧ください。
よくある質問
AIは手書きの納品書や配送証明書(POD)を読み取れますか?
はい、読み取れます。最新のVision AIモデルは、スマートフォンで撮影した手書きの納品書データに対して75〜90%のフィールドレベル精度を達成しており、同じ入力に対する従来のOCRの文字精度15〜40%をはるかに上回ります。重要な違いは、Vision AIが個々の文字ピクセルを照合するのではなく、文脈、テーブル構造、意味を理解しながらフィールドを総合的に読み取る点です。精度の詳細な内訳については、AIと手書き納品書に関する専用記事をご覧ください。
倉庫で撮影したスマートフォンの写真でも納品書の抽出は可能ですか?
はい、可能です。ただし、従来のOCRではなくVision AIを使用するツールである必要があります。ImageToTable.aiは、倉庫の照明条件下、さまざまな角度、部分的に遮蔽された状態で撮影された写真にも対応します。モデルが写真内の文書を検出し、遠近の歪みを補正して、表示された画像からフィールドを読み取ります。フラットベッドスキャナーや完全に正面からの撮影は必要ありません。
納品書から受取人の署名を取得できますか?
はい、取得できます。署名は視覚要素としてキャプチャされます。ツールは文書上の署名欄を特定し、テキストとして書き起こすのではなく、出力内の画像フィールドとして保存します。これは重要です。署名の法的有効性は、テキスト表現ではなく手書きのマークであることに依存するためです。署名画像はExcelエクスポートにセルメモとして含めたり、別ファイルとして参照したりできます。
複数のルートの納品書を1つのバッチとして処理できますか?
はい、可能です。このツールはバッチファースト処理を前提に設計されています。1日の業務で発生するすべての納品書を、複数のルート、ドライバー、運送会社にまたがって1つのバッチでアップロードできます。抽出された出力は統合されたスプレッドシートで、各行が1枚の納品書に対応します。セットアップ時に定義したルート、日付、その他の任意のフィールドで並べ替え、フィルタリング、エクスポートが可能です。
納品書や配送証明書(POD)から抽出できるフィールドは何ですか?
納品書番号、納品日、荷主、受取人、運送会社名、ドライバー名、追跡番号/PRO番号、発注書(PO)参照、明細行のコードと説明、出荷数量、受領数量、バックオーダー/不足の記載、破損/例外コード、受取人とドライバーの署名(画像として)、および自由記述の備考を抽出できます。フィールド選択は完全にカスタマイズ可能で、必要な列を自由に定義できます。
納品書の抽出は梱包明細書の抽出とどう違いますか?
梱包明細書は、注文内容と出荷内容を記載したサプライヤー側の書類で、ほとんどが印刷されたフィールドと構造化された表で構成されています。一方、納品書は、実際に到着したものと受領者の署名を記録する運送会社の書類で、重要なフィールドのほぼ100%が手書きで、署名・印鑑・例外コードが含まれます。梱包明細の抽出では複数列の数量テーブルの処理が必要ですが、納品書の抽出では手書き文字、低品質な写真、テキスト以外の要素への対応が必要です。両者は密接に関連した書類ですが、抽出の課題は根本的に異なります。関連するワークフローについては、梱包明細抽出の完全ガイドをご覧ください。
抽出したデータをTMSやERPシステムにエクスポートできますか?
はい。本ツールはExcel(.xlsx)、CSV、JSON形式へのエクスポートに対応しています。CSVおよびJSON出力は、SAP TM、Oracle TMS、Descartesなどの主要なTMSプラットフォームやERPシステムにインポートできます。抽出フィールドとターゲットシステムのフィールド間の列マッピングは、セットアップ時に一度設定すれば、すべてのバッチで一貫して適用されます。project44やFourKitesをご利用のチームでは、Excel/CSVエクスポートをデータインポートパイプラインに統合できます。
色あせたり傷んだ感熱紙でも正確に読み取れますか?
Vision AIは、従来のOCRではまったく読み取れない感熱紙のデータも、文脈(テーブル構造、隣接フィールド、一般的な数字パターン)を利用して、コントラスト閾値を下回って色あせた文字を推論することで復元できます。ただし、感熱紙が完全に黒変している場合(極度の熱にさらされた場合)や、手書きのインクが物理的に消えてしまった場合は、どのソフトウェアでも存在しないデータを復元することはできません。重要な配送証明書(POD)については、配送時にデジタル写真を撮っておくことが最善のバックアップです。
各運送会社の納品書フォーマットごとにテンプレートを作成する必要がありますか?
いいえ — ImageToTable.aiはテンプレートマッチングではなくセマンティック抽出を使用します。必要な列名(納品書番号、日付、受領数量など)を定義するだけで、AIはページ上の位置ではなく意味を理解して値を特定します。UPSの納品書レイアウトとLTL運送会社の送り状がまったく異なっていても、テンプレート設定や再トレーニングなしで自動的に適応します。
ドライバーの手から使えるデータへ
納品書は物流業務の中で最も手書きが多い文書です。数量の読み取りミスが1件あるだけで、複数チームにまたがる20〜45分のキャリア紛争が発生します。そして、その紛争コストは、どの部門も予算項目として「手書き解読の時間」を追跡していないため、見えないままです。ドライバーが署名済みの伝票を渡してから、その配送確認がTMSに表示されるまでのギャップは、技術の問題ではありません——従来のOCRが解決するように設計されたことのない手書きの問題です。
Vision AIはこれを変えます。人間と同じように文書を理解して納品書を読み取るツールは、データ入力担当者が最初の3件を入力する間に、ルート全体の納品書を処理できます。最も重要なフィールド——受領数量、支払い、在庫、紛争解決を左右する数字——こそ、Vision AIが従来のOCRに対して最大の優位性を発揮するフィールドです。
何を見るべきか分かれば、選定基準は明確です。まず手書き精度、次にスマホ写真への耐性、その他は後回しです。手書きの数量で失敗するツールは、印刷された請求書をどれだけうまく処理しても、納品書抽出ツールではありません。
ご自身の手書き納品書でテストしてください。1枚あたり4分が、バッチあたり10秒になるかどうか。
サインアップは不要です。ファイルは安全に処理され、保存されません。