Der vollständige Leitfaden zur
Lieferschein- und POD-Datenerfassung
Ein LKW trifft im Lager ein. Der Fahrer übergibt den Lieferschein — einen Durchschlag auf Thermopapier mit handschriftlichen Mengenangaben und einer hingekritzelten Unterschrift im Empfängerfeld. Die Ware wird entladen, aber die Daten auf dem Zettel erreichen Ihr TMS erst 24 bis 72 Stunden später — nicht weil jemand langsam ist, sondern weil jemand die Handschrift lesen, die Abkürzungen des Fahrers entziffern und jedes Feld in fünf verschiedene Bildschirme eintippen muss, bevor die Sendung mit der Bestellung, der Speditionsrechnung und der Lieferbestätigung des Kunden abgeglichen werden kann.
Die wichtigsten Erkenntnisse
- Das Extraktionstool, dem Sie bereits vertrauen, erreicht 95 % Genauigkeit bei gedrucktem Text — und 15 % bei den handschriftlichen Feldern, die fast 100 % eines Lieferscheins ausmachen.
- Eine einzige falsch gelesene Menge — „48" statt „50" auf einem hingekritzelten handschriftlichen Zettel — löst eine 20- bis 45-minütige Auseinandersetzung über drei Abteilungen hinweg aus, die niemand eingeplant hat.
- Vision AI liest handschriftliche Lieferscheine, indem es versteht, was jedes Feld bedeutet — nicht durch Abgleich von Zeichenpixeln — und verwandelt 4 Minuten Tipparbeit pro Beleg in einen 10-sekündigen Stapel-Upload.
Was ist Lieferschein- & POD-Erfassung?
Die Lieferschein- und Abliefernachweis-Erfassung (POD) ist der automatisierte Prozess, handschriftliche und gedruckte Sendungsbestätigungsfelder — Lieferscheinnummer, Datum, Absender, Empfänger, Spediteur, Sendungsnummer, Positionsmengen und Unterschriften — von den Papierbelegen zu lesen, die Frachtlieferungen begleiten, und sie in strukturierte Daten für Ihr TMS, ERP oder Ihre Abstimmungstabelle zu überführen. Statt dass ein Sachbearbeiter oder Fahrer am Schichtende jedes Feld manuell aus einem Stapel durchgeschriebener Belege eingibt — ein Prozess, der 3–6 Minuten pro Dokument dauert und bei Handschrift eine Fehlerquote von über 5 % pro Feld aufweist — liest die Erfassungssoftware jedes Dokument ganzheitlich, versteht, was jedes Feld bedeutet, nicht wo es auf der Seite steht, und liefert eine strukturierte Tabelle, die zur Abstimmung bereit ist.
Ein Lieferschein ist kein Packzettel, auch wenn die beiden oft verwechselt werden. Ein Packzettel ist ein lieferantenseitiges Dokument, das mit der Ware vom Lager reist und zeigt, was bestellt versus was versendet wurde. Ein Lieferschein — manchmal auch Lieferbestätigung, Frachtbrief oder Abliefernachweis genannt — ist ein spediteurseitiges Dokument, das festhält, was tatsächlich angekommen ist, wer es unterschrieben hat und ob es Ausnahmen gab (Schaden, Minderlieferung, Annahmeverweigerung). Der entscheidende Unterschied: Ein Lieferschein trägt handschriftliche Unterschriften, Fahrervermerke und Ausnahmecodes, die ein Packzettel nicht hat. Für eine ausführlichere Einführung in den eng verwandten Dokumenttyp lesen Sie unseren Artikel Was ist Packzettel-Datenerfassung — dieser Leitfaden konzentriert sich auf die besonderen Herausforderungen der Erfassung, wenn die primäre Eingabe handschriftlich, per Handy fotografiert und als rechtlicher Abliefernachweis dient.
Wenn Ihr Workflow speziell die unterschriebene Abliefernachweis-Seite betrifft — das Last-Mile-Dokument, das Abrechnung, Reklamationen und Speditionsabrechnung steuert — lesen Sie unsere eigene Anleitung zum Extrahieren von POD-Daten nach Excel für Logistikabläufe, die DSO-Auswirkungen, TMS-Importspalten und Multi-Stopp-Manifeste ausführlich behandelt.
Warum die manuelle Lieferscheinverarbeitung mehr kostet, als Sie denken
Die Kosten der manuellen Lieferscheinverarbeitung sind unsichtbar, weil sie sich über drei Abteilungen verteilen, die nicht miteinander darüber sprechen: Logistikbetrieb, Kreditorenbuchhaltung und Kundenservice. Jede Abteilung sieht nur ihr eigenes Symptom; niemand sieht die gesamte Kette.
Streitfälle bei der letzten Meile
Wenn ein Kunde behauptet, 48 Einheiten erhalten zu haben, der Lieferschein aber 50 ausweist und die Handschrift im Feld für die empfangene Menge entweder „48" oder „50" sein könnte – wer zahlt? Der Spediteur berechnet dem Versender die fehlenden 2 Einheiten. Das AP-Team des Versenders legt die Spediteursrechnung auf Eis. Jemand aus dem Logistikbetrieb muss den Papier-Lieferschein finden – der sich möglicherweise noch im Führerhaus befindet, im Lager abgelegt oder verloren ist – und das Unterschriftenfeld prüfen, ob es lesbar ist. Jeder Streitfall verbraucht 20–45 Minuten über mehrere Rollen hinweg. Bei einer mittelgroßen Flotte mit 500 Lieferungen pro Woche bedeutet selbst eine Streitquote von 1 % fünf Streitfälle pro Woche, also etwa 2,5 bis 5,5 Stunden abteilungsübergreifender Arbeit, die niemand budgetiert.
POD-Abweichung gleich Zahlungsverzug
Die Zahlungsbedingungen für Spediteure betragen üblicherweise netto 30 Tage ab Erhalt eines gültigen POD. „Gültiger POD" bedeutet einen unterschriebenen Lieferschein, der mit den Rechnungspositionen der Spediteursrechnung übereinstimmt. Wenn der POD unleserlich, unvollständig ist oder drei Tage braucht, um aus den Papieren des Fahrers aufzutauchen, startet die Uhr nicht. Die Spediteursrechnung bleibt unbezahlt, der Spediteur fragt nach, das AP-Team recherchiert, und aus einem 30-tägigen Zahlungszyklus werden 45, 60 oder mehr Tage. Der Spediteur kalkuliert diese Verzögerung in seinen Tarif ein, und der Versender zahlt mehr pro Sendung auf allen Routen – nicht nur bei den strittigen. Die NMFTA-Standardbedingungen für Frachtbriefe knüpfen die Zahlung an Spediteure ausdrücklich an die Verfügbarkeit des POD, doch nur wenige Versender verfolgen, wie oft POD-Verzögerungen die Zahlungszyklen beeinflussen.
Manuelle Datenerfassung aus Fahrernotizen
Die häufigsten Kosten sind die am wenigsten sichtbaren: Ein Sachbearbeiter oder eine Datenerfassungskraft liest am Ende jeder Schicht einen Stapel von 20–60 Lieferscheinen und tippt jedes Feld in das TMS oder die Abstimmungstabelle. Jeder Lieferschein dauert 3–6 Minuten. Bei 40 Lieferscheinen pro Schicht à 4 Minuten sind das 2 Stunden und 40 Minuten Tipparbeit – etwa ein Drittel der Schicht. Bei Lohnkosten von 22–28 $ pro Stunde für Datenerfassungspersonal in der Logistik sind das 60–75 $ pro Schicht allein für Tipparbeit, also etwa 15.000–19.000 $ pro Datenerfassungsstelle und Jahr. Für eine Flotte, die Datenerfassung über drei Schichten benötigt, belaufen sich die jährlichen Arbeitskosten auf fast 50.000 $ – bevor Fehler, Streitfälle und Zahlungsverzögerungen hinzukommen.
Eine detaillierte Aufschlüsselung, wie Handschrift diese Kosten verstärkt, finden Sie in unserem Artikel darüber, ob KI handschriftliche Lieferscheine lesen kann.
Die besonderen Herausforderungen der Lieferscheinextraktion
Die Lieferscheinextraktion ist schwieriger als die Extraktion von Rechnungen oder Packzetteln – aus Gründen, die für jeden relevant sind, der Tools evaluiert. Wenn Sie diese Herausforderungen im Vorfeld verstehen, entscheidet das darüber, ob das von Ihnen gewählte Tool Ihren täglichen Arbeitsablauf bewältigt oder nur das Demo-Szenario.
1. Handschrift ist die Herausforderung Nr. 1 – und der Hauptgrund, warum Tools scheitern
Nahezu 100 % der Lieferscheinfelder, die für den Abgleich relevant sind, sind handschriftlich: empfangene Mengen, Ausnahmecodes, Fahrername, Unterschrift des Empfängers, Lieferdatum. Fahrer schreiben schnell, oft auf der Ladeklappe eines LKWs oder im Führerhaus, mit einem Kugelschreiber auf Thermopapier, das sich wellt und verblasst. Eine handschriftliche „3" kann wie eine „8" aussehen. Eine „50", diagonal über eine Spalte gekritzelt, kann das gedruckte Etikett überlappen. Herkömmliche OCR-Engines, die auf zeichenbasierter Mustererkennung beruhen, liefern bei solchen Eingaben unbrauchbare Ergebnisse – 15–40 % Zeichengenauigkeit bei feldbezogener Handschrift laut veröffentlichten Benchmarks, was bedeutet, dass die extrahierten Daten weniger zuverlässig sind als blindes Abtippen.
Die Schreibgeräte machen es noch schlimmer. Fahrer verwenden, was gerade zur Hand ist: Kugelschreiber, Permanentmarker, Bleistift, einen austrocknenden Stift. Kugelschreiber auf Thermopapier hinterlässt einen dünnen, kontrastarmen Abdruck, den ein Scanner oder eine Kamera kaum erfassen kann. Markierte oder gestempelte Felder fügen Hintergrundrauschen hinzu, das die Zeichensegmentierung herkömmlicher OCR verwirrt. Ein Tool, das bei Handschrift versagt – egal wie gut es gedruckte Packungszettel verarbeitet – ist für Lieferscheine unbrauchbar.
Handschrift erscheint auf einem Lieferschein selten isoliert – sie liegt direkt auf den gedruckten Versanddaten des Lieferanten, und beide Ebenen müssen in die Ausgabetabelle gelangen, ohne sich gegenseitig zu beeinträchtigen. Für einen genaueren Blick darauf, wie diese zweischichtige Extraktion in der Praxis funktioniert, lesen Sie unseren Artikel über die Extraktion gedruckter Versanddaten und handschriftlicher Empfangsbestätigungen aus demselben Lieferschein.
2. Handyfotos unter Lagerbedingungen
Nur sehr wenige Lieferscheine erreichen die Backoffice-Abteilung als saubere Scans. Sie kommen als Fotos an, die mit dem Handy des Lagerempfängers aufgenommen wurden: schiefer Winkel, Lagerbeleuchtung (Leuchtstoffröhren mit tiefen Schatten), unvollständiger Bildausschnitt (der Daumen des Fahrers verdeckt das Unterschriftenfeld), unterschiedliche Auflösung. Manche Fotos entstehen im Regen, mit Wassertropfen auf dem Thermopapier. Andere wurden auf einem Betonboden oder einem Karton aufgenommen, wodurch ein Hintergrund entsteht, den herkömmliche OCR als Rauschen interpretiert.
Die Extraktionssoftware, die mit Lieferscheinen arbeitet, muss die gesamte visuelle Szene als ein einziges semantisches Problem behandeln – nicht „den Text auf dieser makellosen Seite finden", sondern „das Dokument in diesem Foto finden, die Perspektive korrigieren, die Handschrift vom Hintergrund trennen und jedes Feld lesen". Das erforderliche visuelle Verständnis unterscheidet sich grundlegend von einer scannerbasierten OCR-Pipeline. Für eine tiefergehende Analyse, wie Vision AI mit per Handy aufgenommenen Felddokumenten umgeht, lesen Sie unseren Leitfaden Was ist KI-Handschrifterkennung.
3. Signaturen, Stempel und Kritzeleien vermischt
Ein Lieferschein ist kein sauberes Formular. Der Empfänger unterschreibt im Signaturfeld. Der Fahrer schreibt die Lieferzeit an den Rand. Jemand stempelt „EMPFANGEN" in einem Winkel, der den Speditionsnamen überlappt. Eine andere Person kreist die empfangene Menge ein, um sie zu bestätigen. Diese Anmerkungen sind alle für den Nachweis notwendig – sie sind der Beleg dafür, was passiert ist – aber sie liegen auf den gedruckten Daten, oft überlappen sie Tabellenzellen oder drängen sich an Feldbeschriftungen.
Herkömmliche OCR kann die Anmerkung nicht von dem Text unterscheiden, den sie überlappt. Ein gestempelter „EMPFANGEN"-Stempel, der teilweise das Wort „Empfänger" überdeckt, erzeugt eine verstümmelte Zeichenfolge. Eine eingekreiste „80", die auf einem gedruckten „Menge" liegt, wird als „Menge80" gelesen – wobei sowohl die Anmerkung als auch die Beschriftung verloren gehen. Ein Vision-AI-Modell hingegen nutzt den Dokumentkontext – die Tabellenstruktur, die Feldbeschriftungen, die Position des Stempels – um überlappende Elemente zu trennen und jedes einzeln zu erfassen.
4. Verblassen von Thermopapier
Die meisten Lieferscheine werden auf Thermopapier gedruckt – dem gleichen Material, das auch für Kassenbons verwendet wird. Es wellt sich bei Hitze, verblasst mit der Zeit und wird schwarz, wenn es in einer heißen Fahrerkabine liegt. Bis ein Lieferschein in der Verwaltung ankommt – nach einer Woche im Lieferbuch des Fahrers oder einem Monat im Aktenschrank – ist der gedruckte Text oft kaum noch lesbar. Herkömmliche OCR, die auf kontrastreichen Schwarz-Weiß-Zeichen basiert, sieht nur ein Grau-in-Grau-Feld. Vision-AI-Modelle, die auf kontrastarmen und beschädigten Dokumentbildern trainiert wurden, können Text wiederherstellen, der für schwellenwertbasierte OCR-Engines unsichtbar ist, weil das Modell lernt, Zeichenformen aus dem Kontext zu erkennen – nicht aus binärem Pixelkontrast.
Herkömmliche OCR vs. Vision AI für handschriftliche Abliefernachweise
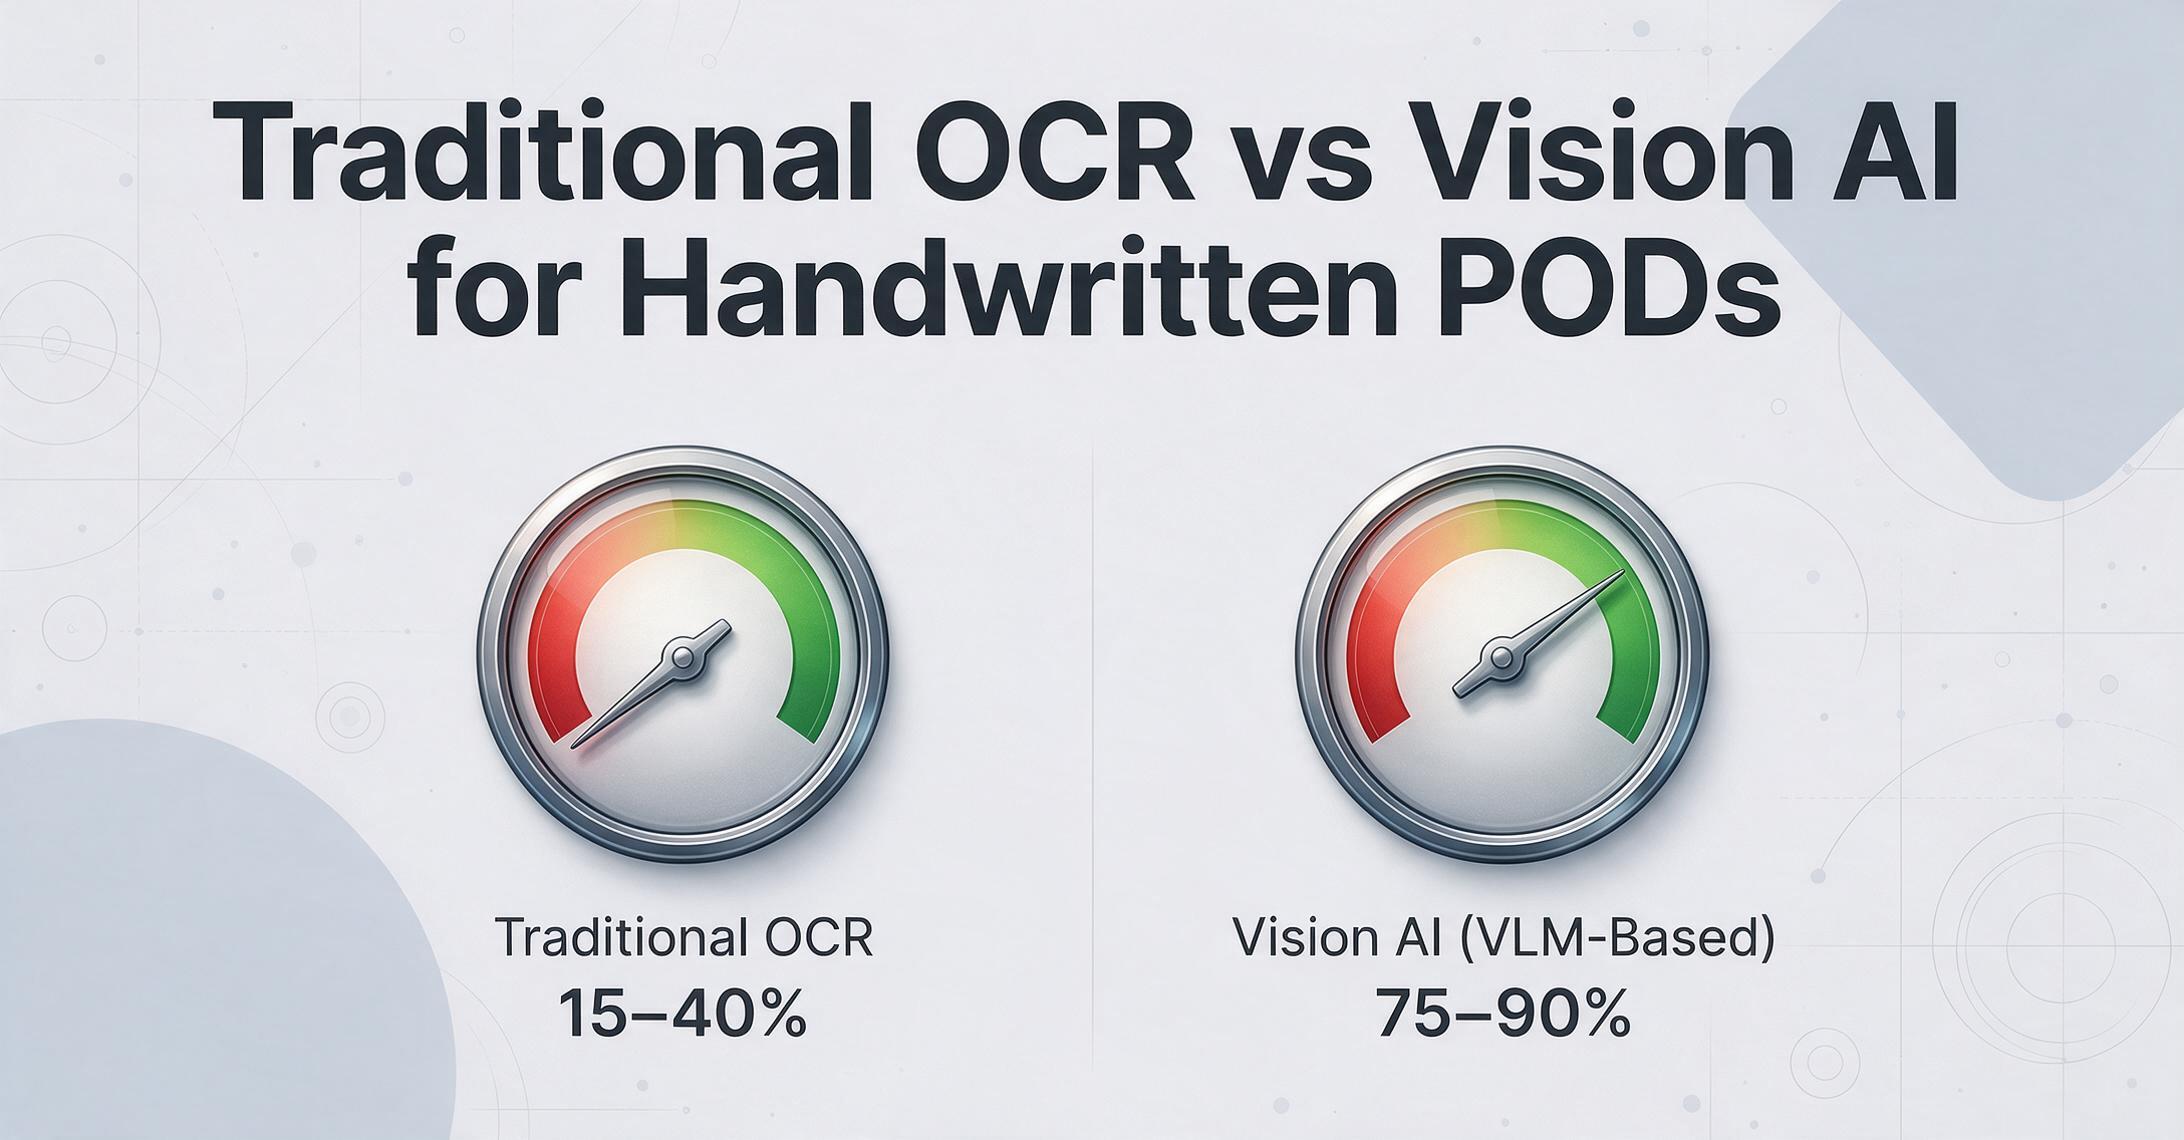
Der Unterschied zwischen herkömmlicher OCR und Vision AI bei der Lieferscheinextraktion ist keine Frage der inkrementellen Verbesserung – es ist ein kategorialer Unterschied darin, was jede Technologie überhaupt lesen kann.
| Bedingung | Herkömmliche OCR | Vision AI (VLM-basiert) |
|---|---|---|
| Sauberer Druck auf weißem Papier | 95–99 % Genauigkeit | 98–99 % Genauigkeit |
| Handschriftliche Mengen (Kugelschreiber auf Thermopapier) | 15–40 % Genauigkeit auf Zeichenebene | 75–90 % Genauigkeit auf Feldebene |
| Handyfoto mit Schatten und Schräglage | Erfordert manuelle Vorverarbeitung oder scheitert | Verarbeitet Perspektive und Lichtverhältnisse nativ |
| Stempel über gedrucktem Text | Verstümmelte Mischausgabe | Trennt und liest beide unabhängig |
| Verblasstes Thermopapier | Geringer Kontrast = kein Lesen | Kontextuelle Wiederherstellung möglich |
| Erfassung von Unterschriften | Nicht möglich – kein Text | Lokalisiert und erhält das Unterschriftenbild |
| Vorlageneinrichtung pro Spediteur | Erforderlich (zonale OCR) | Nicht erforderlich (semantische Extraktion) |
Herkömmliche OCR funktioniert gut bei sauberen Eingaben: hochauflösende Scans gedruckter Dokumente mit einheitlichem Layout. Sie scheitert katastrophal, wenn die Eingabe handschriftlich, bei schlechten Lichtverhältnissen fotografiert oder strukturell inkonsistent ist – das heißt, sie scheitert bei der überwiegenden Mehrheit realer Lieferscheine. Vision AI hingegen versteht das Dokument: Sie erkennt eine Tabelle und weiß, dass die untere rechte Zelle „Empfangene Menge" enthält, liest ein hingekritzeltes „48" nicht durch Abgleich von Pixelmustern, sondern durch Erkennung der Zahl aus dem Kontext, und behandelt eine Unterschrift als eigenständiges visuelles Element, statt sie als Text zu dekodieren.
Überzeugen Sie sich selbst – laden Sie ein Lieferscheinfoto hoch und beobachten Sie die Extraktion in Echtzeit:
Dateien werden sicher verarbeitet und nicht gespeichert.
Kritische Felder, die jede Lieferschein-Extraktion erfassen muss
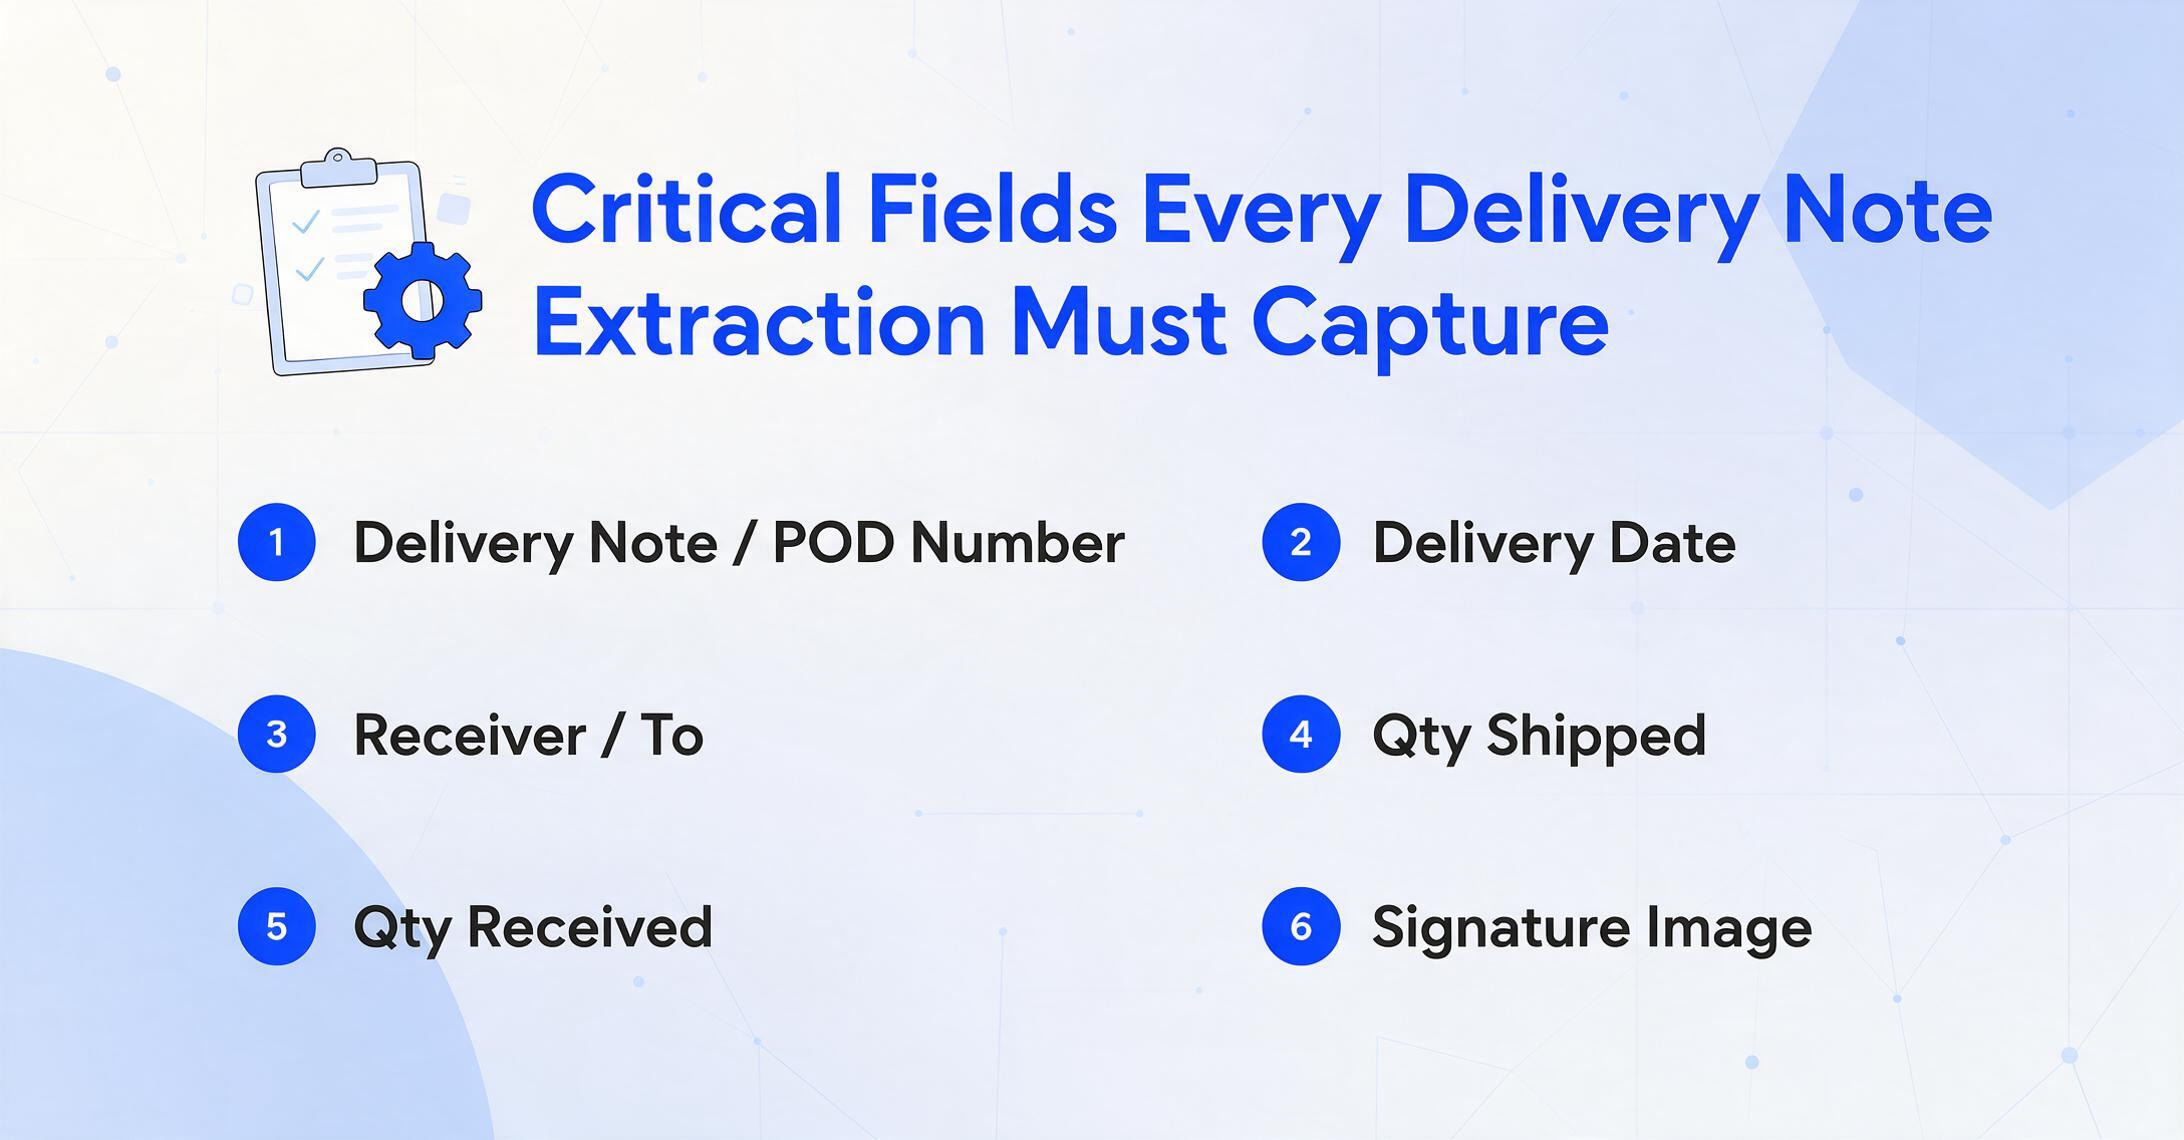
Nicht alle Felder eines Lieferscheins sind für den Abgleich gleich wichtig. Die Felder, die für Zahlung, Lagerbestand und Streitbeilegung relevant sind, bilden eine bestimmte Gruppe, die ein Lieferschein-Extraktionstool zuverlässig erfassen muss – mit handschriftlichen Eingaben als Grundannahme, nicht als Ausnahmefall.
| Feld | Darstellung | Warum es wichtig ist |
|---|---|---|
| Lieferschein / POD-Nummer | Gedruckt oder handgestempelt | Eindeutige Kennung für Nachverfolgung und Abgleich mit der Speditionsrechnung |
| Lieferdatum | Handschriftlich oder Datumsstempel | Bestätigt den Lieferzeitpunkt – startet die Zahlungsfrist und die OTIF-Messung |
| Absender / Von | Gedruckt (vorausgefüllt) | Identifiziert den Ursprung – wird beim Abgleich der Speditionsrechnung verwendet |
| Empfänger / An | Gedruckt oder handschriftlich | Bestätigt das Ziel – Abweichungen hier führen sofort zu einer Reklamation |
| Spediteur & Fahrer | Gedruckt + handschriftlicher Fahrername | Verknüpft die Lieferung mit dem verantwortlichen Spediteur für Zahlung und Leistungsverfolgung |
| Tracking / PRO-Nummer | Gedruckter Barcode oder Nummer | Interne Tracking-Referenz des Spediteurs – unerlässlich für den Abgleich |
| Bestellreferenz (PO) | Gedruckt oder handschriftlich | Verknüpft die Lieferung mit der Bestellung für den Drei-Wege-Abgleich |
| Positionen: Code / Beschreibung | Gedruckte Tabelle | Identifiziert das Gelieferte – wird für den Wareneingang verwendet |
| Gelieferte Menge | Gedruckt oder handschriftlich | Was laut Spediteur verladen wurde |
| Empfangene Menge | Handschriftlich – kritischstes Feld | Was der Empfänger bestätigt. Diese Zahl fließt in den Bestand und löst die Zahlung aus. Ein Lesefehler hier führt zu einer Reklamation, deren Klärung 20–45 Minuten kostet |
| Nachlieferung / Fehlmenge | Handschriftlicher Vermerk | Kennzeichen für Teillieferung – zeigt der Disposition, ob eine Nachfassung nötig ist |
| Schaden / Ausnahmecode | Handschriftlich (z. B. „1 KTN BESCHÄDIGT") | Kritisch für die Schadensbearbeitung und die Rückbelastung des Spediteurs |
| Unterschrift Empfänger | Handschriftlich – kein Text | Rechtlicher Abliefernachweis. Muss als Bild erfasst werden, nicht als Text transkribiert |
| Unterschrift Fahrer | Handschriftlich | Bestätigt die Übergabe – von einigen Spediteuren zur POD-Validierung gefordert |
| Anmerkungen / Bemerkungen | Handschriftlicher Freitext | Beobachtungen des Fahrers, Kommentare des Empfängers, Lieferausnahmen – unstrukturiert, aber betrieblich wichtig |
Das Feld „Empfangene Menge" verdient besondere Aufmerksamkeit, da es gleichzeitig das kritischste Feld für den Abgleich und am schwierigsten zuverlässig zu erfassen ist. Es ist fast immer handschriftlich, oft in einem kleinen Kästchen in der Positionstabelle, und ein einzelner Ziffernlesefehler – „48" statt „50" – erzeugt eine Abweichung, die zu einer Speditionsreklamation, einer Bestandskorrektur und einer Sperre in der Kreditorenbuchhaltung führt. Jedes Tool zur Lieferscheinextraktion sollte zuerst an seiner Fähigkeit gemessen werden, handschriftliche Mengen zu lesen – nicht an seiner Geschwindigkeit beim Extrahieren von gedrucktem Text.
Routenbasierte Stapelverarbeitung für die tägliche Abstimmung
Lieferscheine treffen in Stapeln ein – nicht als Einzeldokumente, sondern nach Route, nach Fahrer, nach Schicht. Eine Flotte mit 20 Routen pro Tag erzeugt 20 Stapel Lieferscheine, wobei jeder Stapel die Lieferungen eines einzelnen Fahrers repräsentiert. Der Abstimmungsprozess ist von Natur aus stapelorientiert: Alle Lieferscheine der Route 12 gegen das Routenmanifest abgleichen, Mengen gegen die unterschriebenen Kundendurchschläge prüfen und die Zahlung an den Spediteur für diese Route freigeben.
Ein Lieferschein-Extraktionstool, das routenbasierte Stapelverarbeitung unterstützt, ermöglicht es Ihnen, alle Lieferscheine einer einzelnen Route als Stapel hochzuladen, die Felder in eine einzige Tabelle zu extrahieren, in der jede Zeile einer Lieferung entspricht, und nach Route, Fahrer, Datum oder Ausnahmestatus zu sortieren oder zu filtern. Statt jeden Lieferschein einzeln zu öffnen, verarbeiten Sie eine gesamte Route in einem Durchgang. Die von Ihnen definierten Spaltennamen – Lieferschein-Nr., Datum, Empfangene Menge, Ausnahme – werden zu den Kopfzeilen Ihrer Ausgabetabelle, und jeder Lieferschein im Stapel füllt seine eigene Zeile.
Eine praktische Anleitung zur Stapelverarbeitung mehrerer Lieferscheine gleichzeitig, einschließlich Tipps zur Dateiorganisation und Spaltengestaltung, finden Sie in unserem Leitfaden zur Stapelextraktion von Packzetteln und Lieferscheinen nach Excel.
Der Stapelansatz ermöglicht auch die tägliche Abstimmung: Laden Sie die Lieferscheine des Tages gleich am Morgen hoch, extrahieren Sie die Daten, gleichen Sie sie gegen das TMS-Manifest ab und identifizieren Sie Ausnahmen, bevor sie zu Streitfällen werden. Routen mit sauberen PODs werden zur Zahlung freigegeben. Routen mit Ausnahmen werden zur Prüfung markiert – alles vor Beginn der nächsten Schicht des Fahrers. Einen breiteren Überblick darüber, wie Dokumentenextraktion in Logistikabläufe neben verwandten Versanddokumenten passt, finden Sie in unserer Übersicht der besten Logistik-Dokumentextraktionstools.
Export, Integration und TMS-Workflow
Lieferscheindaten sind isoliert nicht nützlich – sie müssen in die Systeme fließen, in denen die Abstimmung stattfindet. ImageToTable.ai unterstützt mehrere Exportpfade, die zu den tatsächlichen Arbeitsweisen von Logistikteams passen.
Excel für Abstimmungs-Tabellen
Der häufigste Workflow ist der Export nach Excel: Alle Felder aus einer Routencharge werden in eine einzige .xlsx-Datei extrahiert, mit einer Zeile pro Lieferschein und Spalten, die Ihrer Abstimmungsvorlage entsprechen. Der Excel-Export behält die von Ihnen definierte Spaltenstruktur bei – Lieferschein-Nr., Datum, Bestellreferenz (PO), Versandmenge, Empfangsmenge, Ausnahmen, Unterschriftsbild (als Notiz). Kein Umformatierungsschritt zwischen Extraktion und der Tabelle, die Ihre Kreditorenbuchhaltung (AP) bereits verwendet. Wenn Sie das Extraktionsergebnis jetzt an Ihrem eigenen Lieferschein sehen möchten, probieren Sie unseren Lieferschein-zu-Excel-Konverter – laden Sie einen Beleg hoch und erhalten Sie die strukturierte Tabelle in Sekunden.
TMS-Integration über strukturierte Daten
Für Teams, die Lieferscheindaten in ihrem Transportmanagementsystem benötigen, kann das Extraktionsergebnis als strukturiertes CSV oder JSON exportiert werden. Das Feld-Mapping – Lieferschein-Nr. → Speditionsreferenz, Empfangsmenge → Lieferbestätigungsmenge, Ausnahmecode → Statuskennzeichen – wird einmalig bei der Spalteneinrichtung definiert und bei jeder Charge konsistent angewendet. SAP TM, Oracle TMS, Descartes und project44 akzeptieren alle strukturierte Sendungsdaten per CSV-Import oder API – das Extraktionsergebnis fließt direkt in diese Pipelines ein. Für einen genaueren Blick darauf, wie die Dokumentextraktion mit TMS-Workflows für verwandte Dokumente verbunden ist, lesen Sie unseren vollständigen Leitfaden zur Frachtbrief-Extraktion (BOL).
Abliefernachweis im Kundenportal
Viele Versender müssen ihren Kunden einen Abliefernachweis (POD) vorlegen – einen unterschriebenen Lieferschein, der belegt, dass die Waren angekommen sind. Das Extraktionstool erfasst die Empfängerunterschrift als Bildfeld und die Lieferscheinnummer als Textfeld, sodass jede Zeile in Ihrer Ausgabetabelle sowohl die strukturierten Daten als auch einen Verweis auf das unterschriebene Dokument enthält. Laden Sie das Extraktionsergebnis in Ihr Kundenportal hoch oder teilen Sie es über einen Sammellink – der Empfänger sieht die Lieferbestätigung, ohne auf eine per E-Mail versandte gescannte PDF-Datei warten zu müssen.
So wählen Sie ein Tool zur Lieferschein-Erfassung
Die meisten Vergleiche von Dokumentextraktions-Tools nennen dieselben Kriterien: unterstützte Formate, Ausgabetypen, Integrationsoptionen. Bei Lieferscheinen ist die Prioritätenreihenfolge anders. Hier sind die Kriterien, die für den tatsächlichen Logistikbetrieb zählen, nach Wichtigkeit geordnet.
Dies ist nicht nur ein Kriterium unter vielen – es ist das Kriterium, das darüber entscheidet, ob ein Tool für Lieferscheine überhaupt funktioniert. Fragen Sie den Anbieter nach feldgenauer Genauigkeit bei handschriftlichen Mengen aus Handyfotos, nicht nach gedrucktem Text aus sauberen Scans. Ein Tool, das unter realen Bedingungen nicht >75 % bei handschriftlichen Lieferscheinfeldern erreicht, ist kein Tool zur Lieferschein-Erfassung.
Testen Sie mit Fotos, die in einem Lagerhaus aufgenommen wurden, nicht mit gescannten PDFs. Das Tool sollte perspektivische Verzerrung, gemischte Beleuchtung, Teilausschnitte und niedrige Auflösung verarbeiten können. Wenn es für eine zuverlässige Funktion einen Flachbettscan benötigt, wird es beim ersten Lieferscheinfoto vom Handy eines Fahrers scheitern.
Das Tool muss Nicht-Text-Elemente – Unterschriften, Stempel, Logos – als identifizierbare Felder erfassen, nicht ignorieren oder versuchen, sie zu transkribieren. Eine Unterschrift ist ein rechtlicher Beweis. Wenn das Tool sie nicht lokalisieren und erhalten kann, sind die extrahierten Daten für Abliefernachweis-Zwecke unvollständig.
Lieferscheine kommen in Dutzenden von Formaten von verschiedenen Spediteuren. Ein Tool, das eine Vorlageneinrichtung pro Spediteurformat erfordert – Zonen zeichnen, Felder beschriften, Training pro Layout – ist nicht skalierbar für eine Flotte, die täglich Lieferscheine von mehreren Spediteuren erhält. Semantische Extraktion (die KI findet Felder nach Bedeutung, nicht nach Position) ist unerlässlich.
Die Einzeldokument-Extraktion ist für den Flottenbetrieb zu langsam. Das Tool sollte Batch-Upload unterstützen – 20, 50 oder 100 Lieferscheine auf einmal – und sie in einer einzigen strukturierten Tabelle ausgeben, gruppiert nach Route, Datum oder Fahrer für einen effizienten Abgleich.
Die Ausgabe muss zu Ihrem Abgleich-Workflow passen. Excel für die manuelle Prüfung, CSV für den TMS-Import, strukturierte Felder für API-Pipelines. Wenn jeder Batch einen Neuformatierungsschritt erfordert, geht ein Teil der Zeitersparnis durch die Extraktion in der Nachbearbeitung verloren.
Die meisten Extraktionstools auf dem Markt wurden für Rechnungen und Lieferscheine entwickelt – gedruckte Dokumente mit vorhersehbaren Layouts. Lieferscheine sind eine andere Kategorie: handschriftlich, fotografiert, thermisch verblassend und als rechtlicher Nachweis dienend. Kriterien anzuwenden, die für die Rechnungsextraktion entwickelt wurden, auf einen Lieferschein-Anwendungsfall führt zu einem Tool, das in einer Demo mit gedruckten PDFs beeindruckend wirkt und beim ersten echten handschriftlichen Beleg aus dem Fahrer-Lieferbuch versagt.
Für einen umfassenden Vergleich von Extraktionswerkzeugen, die auf die Anforderungen von Logistikdokumenten – einschließlich Lieferscheinen, Frachtbriefen (BOL) und Packlisten – bewertet wurden, lesen Sie unseren Artikel über die besten Logistikdokument-Extraktionstools für 2026.
Häufig gestellte Fragen
Kann KI handschriftliche Lieferscheine und Abliefernachweise (POD) lesen?
Ja — moderne Vision-AI-Modelle erreichen eine Feldgenauigkeit von 75–90 % bei handschriftlichen Lieferscheindaten aus Handyfotos und übertreffen damit die Zeichengenauigkeit herkömmlicher OCR von 15–40 % bei gleicher Eingabe deutlich. Der entscheidende Unterschied: Vision AI liest Felder ganzheitlich — sie versteht Kontext, Tabellenstruktur und semantische Bedeutung — statt einzelne Zeichenpixel abzugleichen. Eine detaillierte Genauigkeitsanalyse finden Sie in unserem Fachartikel zu KI und handschriftlichen Lieferscheinen.
Funktioniert die Lieferscheinextraktion mit Handyfotos aus dem Lager?
Ja, sofern das Tool Vision AI statt herkömmlicher OCR verwendet. ImageToTable.ai verarbeitet Fotos, die unter Lagerbeleuchtung, aus verschiedenen Winkeln und mit teilweisen Verdeckungen aufgenommen wurden. Das Modell erkennt das Dokument im Foto, korrigiert perspektivische Verzerrungen und liest die Felder direkt aus dem Bild. Ein Flachbettscanner oder ein perfekt ausgerichtetes Foto ist nicht erforderlich.
Kann das Tool Empfängerunterschriften von Lieferscheinen erfassen?
Ja. Unterschriften werden als visuelle Elemente erfasst — das Tool lokalisiert das Unterschriftenfeld auf dem Dokument und speichert es als Bildfeld in der Ausgabe, statt es als Text zu transkribieren. Das ist wichtig, denn die rechtliche Gültigkeit einer Unterschrift hängt davon ab, dass sie ein handschriftliches Zeichen ist, nicht eine Textdarstellung. Das Unterschriftenbild kann als Zellnotiz in den Excel-Export aufgenommen oder als separate Datei referenziert werden.
Kann ich Lieferscheine mehrerer Touren als einen einzigen Batch verarbeiten?
Ja — das Tool ist für die Batch-First-Verarbeitung konzipiert. Sie können alle Lieferscheine eines Tages — über mehrere Touren, Fahrer und Spediteure hinweg — in einem einzigen Batch hochladen. Die extrahierte Ausgabe ist eine einheitliche Tabelle, in der jede Zeile einen Lieferschein darstellt. Sie können nach Tour, Datum oder jedem anderen bei der Einrichtung definierten Feld sortieren, filtern oder exportieren.
Welche Felder können aus einem Lieferschein oder POD extrahiert werden?
Das Tool kann Lieferscheinnummer, Lieferdatum, Versender, Empfänger, Speditionsname, Fahrername, Tracking-/PRO-Nummer, Bestellreferenz (PO), Positionscodes und -beschreibungen, versandte Mengen, empfangene Mengen, Nachbestellungs-/Fehlmengenvermerke, Schadens-/Ausnahmecodes, Empfänger- und Fahrerunterschriften (als Bilder) sowie Freitextbemerkungen extrahieren. Die Feldauswahl ist vollständig anpassbar — Sie definieren die benötigten Spalten.
Wie unterscheidet sich die Lieferscheinextraktion von der Packzettel-Extraktion?
Ein Packzettel ist ein Lieferantendokument, das auflistet, was bestellt versus was versendet wurde – meist gedruckte Felder mit strukturierten Tabellen. Ein Lieferschein ist ein Frachtdokument, das festhält, was tatsächlich angekommen ist und wer es unterschrieben hat – fast 100 % handschriftliche kritische Felder, plus Unterschriften, Stempel und Ausnahmecodes. Die Packzettel-Extraktion erfordert die Verarbeitung mehrspaltiger Mengentabellen. Die Lieferscheinextraktion erfordert die Verarbeitung von Handschrift, schlechter Fotoqualität und Nicht-Text-Elementen. Die Dokumenttypen sind eng verwandt, aber die Extraktionsherausforderungen sind grundlegend unterschiedlich. Siehe unseren vollständigen Leitfaden zur Packzettel-Extraktion für den verwandten Workflow.
Können die extrahierten Daten in mein TMS oder ERP exportiert werden?
Ja. Das Tool unterstützt den Export in Excel (.xlsx), CSV- und JSON-Formate. CSV- und JSON-Ausgaben können in die meisten TMS-Plattformen importiert werden, einschließlich SAP TM, Oracle TMS und Descartes, sowie in ERP-Systeme. Das Spaltenmapping zwischen Ihren Extraktionsfeldern und den Zielfeldern wird einmalig bei der Einrichtung konfiguriert und konsistent auf alle Batches angewendet. Für Teams, die project44 oder FourKites nutzen, kann der Excel/CSV-Export in deren Datenimport-Pipelines integriert werden.
Wie genau ist das Tool bei verblasstem oder beschädigtem Thermopapier?
Vision AI kann Daten aus Thermopapier wiederherstellen, die herkömmliche OCR überhaupt nicht lesen kann, da es den Kontext nutzt – die Tabellenstruktur, benachbarte Felder, gängige Zahlenmuster – um Zeichen zu erschließen, die unter die Kontrastschwelle verblasst sind. Wenn das Thermopapier jedoch vollständig geschwärzt ist (durch extreme Hitze) oder die handschriftliche Tinte physisch abgenutzt ist, kann kein Software-Tool wiederherstellen, was nicht vorhanden ist. Für kritische POD-Dokumente ist ein digitales Foto, das zum Zeitpunkt der Lieferung aufgenommen wurde, die beste Absicherung.
Muss ich für jedes Spediteurformat des Lieferscheins Vorlagen erstellen?
Nein – ImageToTable.ai verwendet semantische Extraktion, kein Vorlagen-Matching. Sie definieren die benötigten Spaltennamen (Lieferschein-Nr., Datum, Empfangene Menge usw.), und die KI lokalisiert diese Werte, indem sie versteht, was sie bedeuten, nicht wo sie auf der Seite erscheinen. Ein UPS-Lieferscheinlayout und ein LTL-Frachtbrief können sich völlig unterscheiden – das Tool passt sich automatisch an, ohne Vorlagenkonfiguration oder Nachschulung.
Von der Hand des Fahrers zu nutzbaren Daten
Lieferscheine sind die handschriftlich intensivsten Dokumente im Logistikbetrieb. Eine einzige falsch gelesene Menge erzeugt einen Speditionsstreit, der 20–45 Minuten über mehrere Teams hinweg kostet – und diese Streitkosten sind unsichtbar, weil keine Abteilung „Zeit für das Entziffern von Handschrift" als Posten in ihrem Budget führt. Die Lücke zwischen der Übergabe eines unterschriebenen Belegs durch den Fahrer und dem Erscheinen dieser Lieferbestätigung im TMS ist kein Technologieproblem – es ist ein Handschriftproblem, das herkömmliche OCR nie lösen sollte.
Vision AI ändert das. Ein Tool, das Lieferscheine auf dieselbe Weise liest wie ein Mensch – durch Verstehen des Dokuments, nicht durch Scannen nach Zeichenmustern – kann die Lieferscheine einer gesamten Route in der Zeit verarbeiten, die ein Datenerfasser für die ersten drei benötigt. Das wichtigste Feld – die empfangene Menge, die Zahl, die Zahlung, Lagerbestand und Streitbeilegung steuert – ist das Feld, in dem Vision AI seinen größten Vorteil gegenüber herkömmlicher OCR bietet.
Die Auswahlkriterien sind einfach, wenn Sie wissen, worauf Sie achten müssen: Handschriftgenauigkeit zuerst, Toleranz für Handyfotos an zweiter Stelle, alles andere danach. Ein Tool, das bei handschriftlichen Mengen versagt, ist kein Lieferschein-Extraktionstool, egal wie gut es gedruckte Rechnungen verarbeitet.
Testen Sie mit Ihren eigenen handschriftlichen Lieferscheinen. Sehen Sie, ob 4 Minuten pro Lieferschein zu 10 Sekunden pro Stapel werden.
Keine Anmeldung erforderlich. Ihre Dateien werden sicher verarbeitet und nicht gespeichert.