AIは学生の
入学届を抽出できますか?はい — 項目別の精度はこちら
はい — 最新のAIビジョンモデルは、セマンティック文書抽出を使用して、学校ごとに異なるフォームレイアウト用のテンプレートを必要とせず、印刷された項目で95〜99%、手書きの記入で85〜95%、チェックボックスの選択で95%以上の精度で学生の入学届からデータを抽出できます。精度は項目の種類によって大きく異なります — 保護者の印刷された電話番号はほぼ確実に抽出できますが、筆記体で書かれた自由記述の医療メモは人間による確認が必要な場合があります。ここでは、テクノロジーの現状、まだ苦手とする分野、そして8月から9月の入学ピークが処理ワークフローに与える影響について正確に説明します。
重要なポイント
- 入学届抽出に関する本当の疑問は、AIが手書きを読めるかどうかではなく、8月に400件の入学届セットを処理する学校が、クラス編成、バスルート計画、ランチプログラムの登録を1日遅らせるごとに、20時間の手動データ入力を負担できるかどうかです。
- 手書きの電話番号は、どの入学届でも最も壊れやすい項目です — 周囲の文字で曖昧さを解消できる名前とは異なり、10桁のうち1桁を読み間違えると緊急連絡先全体が使えなくなり、400件のフォームには400人の異なる手書きがあり、オートコレクトもありません。
- バッチ処理こそが真の効率性を生みます — データ入力チームが20時間かかる400件の入学届セットは、AI抽出なら30分で完了します。なぜなら、85〜90%の項目が95〜99%の精度で抽出され、手書きの電話番号と医療メモだけが人間の確認を必要とするからです。
精度の実力 — 入学届における項目別の正確さ
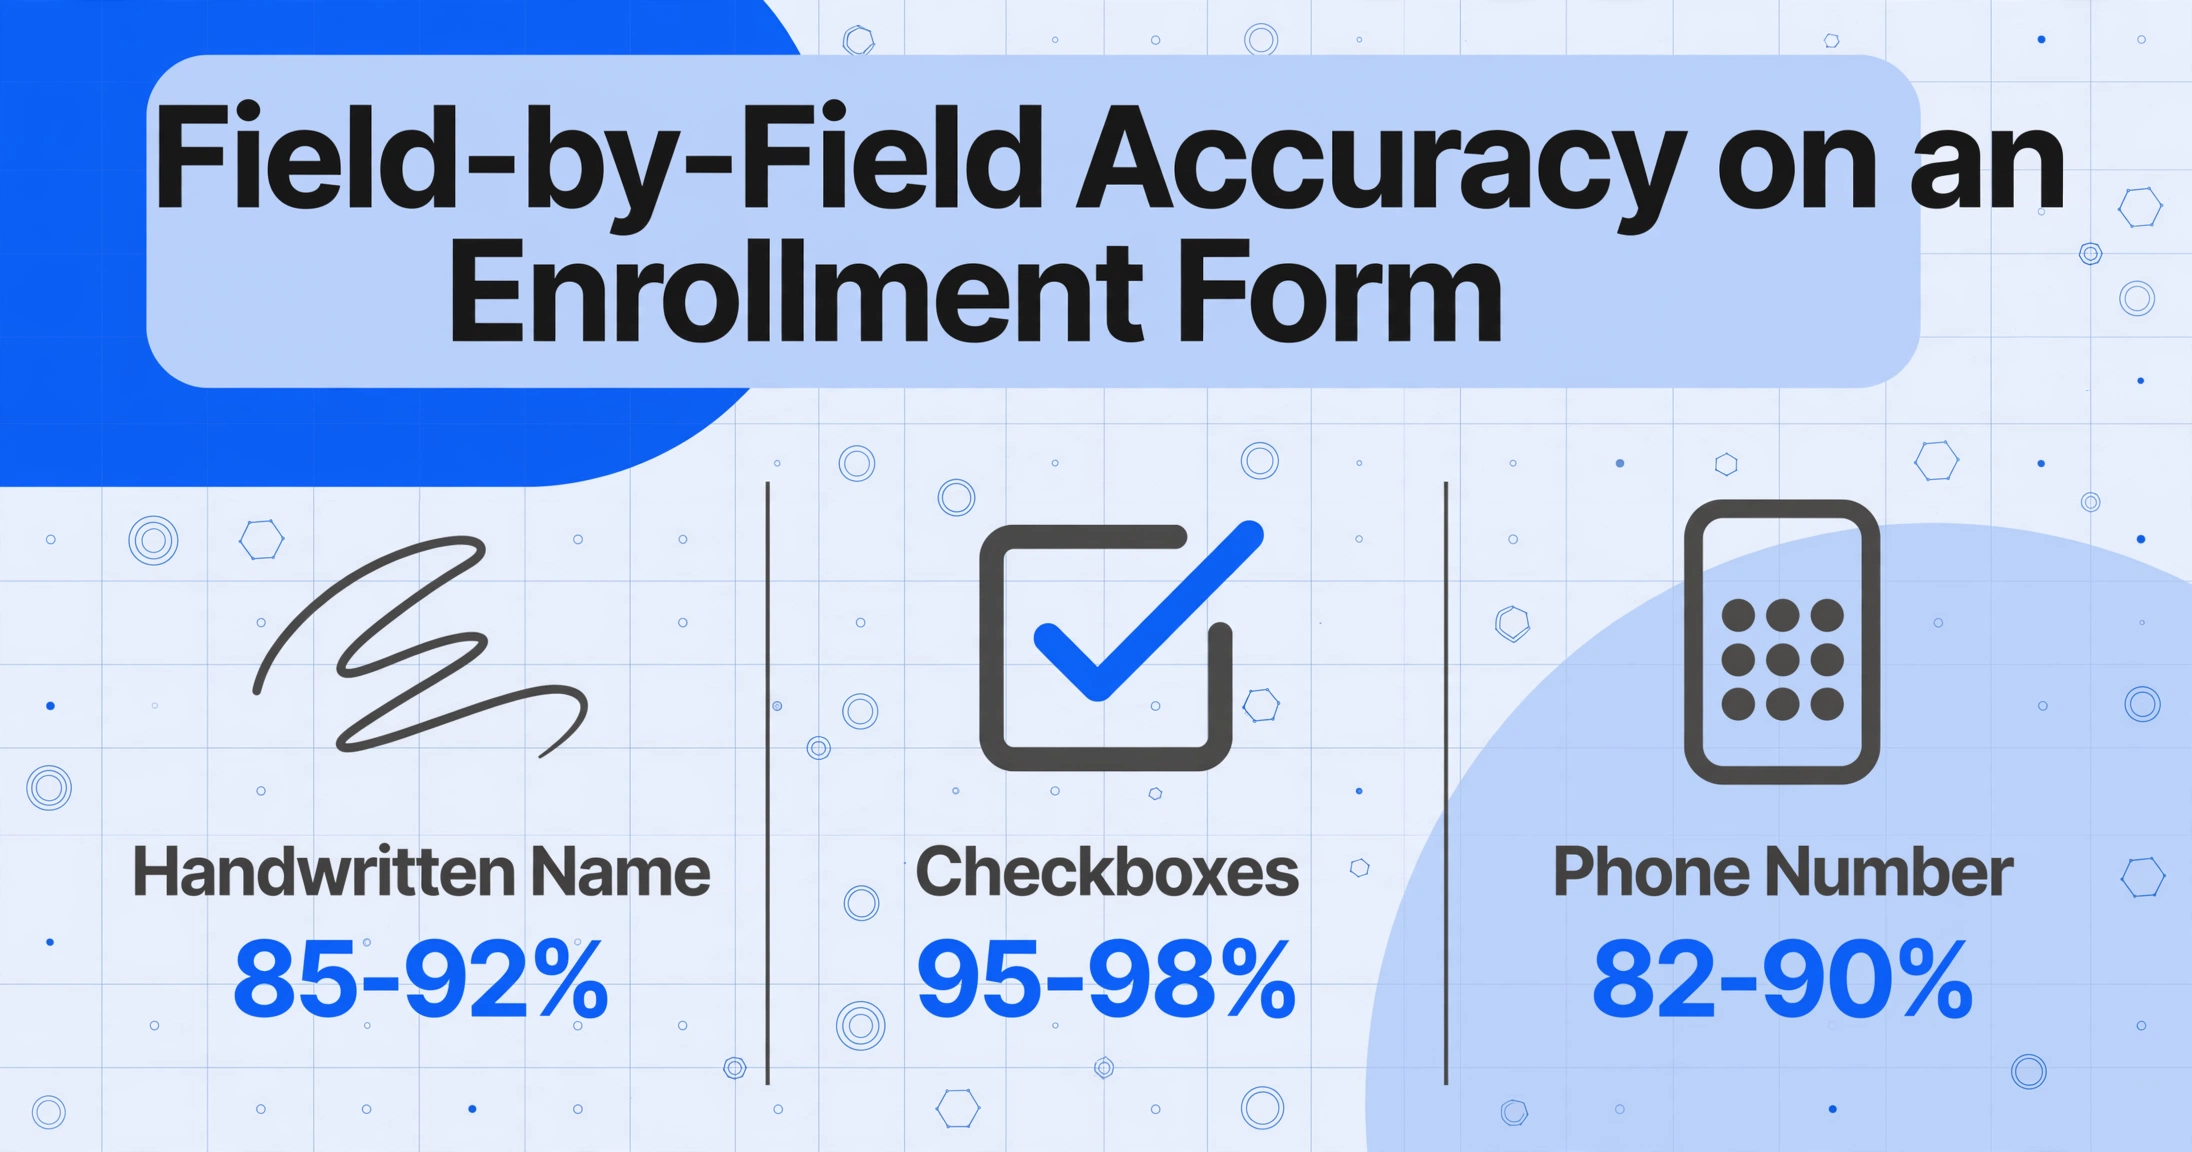
入学届は単一の抽出問題ではありません。一般的なK-12の入学届セットには、さまざまな種類の項目が混在しており、それぞれ正確さのプロファイルが異なります。以下は、従来のテンプレートOCRではなくビジョン言語モデルを使用する最新のAI抽出ツールが、最も一般的な入学届の項目に対して達成する精度です。
| 項目の種類 | 一般的な内容 | 推定AI精度 | 主な課題 |
|---|---|---|---|
| 生徒氏名(印刷) | タイプ入力または丁寧な手書き | 97〜99% | スキャン品質が悪い場合を除き、失敗はまれ |
| 生徒氏名(手書き) | 子どもまたは保護者による筆記体またはブロック体 | 85〜92% | 子どもの手書きは個人差が大きく、最初の文字の判読性が重要 |
| 生年月日 | MM/DD/YYYY形式または文章で記載 | 90〜95% | 曖昧な日付形式(MM/DDとDD/MM)は、文脈なしでは誤読される可能性がある |
| 保護者/後見人氏名 | 保護者による手書き | 88〜95% | 大人の筆記体は子どものものより一貫性があるが、珍しい名前は推論を誤る可能性がある |
| 保護者電話番号 | 手書きの数字 | 82〜90% | 1桁の誤読で番号が使えなくなる — 電話番号には自動修正がない |
| 自宅住所 | 手書きの番地、市区町村、郵便番号 | 85〜92% | 番地と郵便番号は数字が多く、住所データベースとの照合が役立つ |
| 緊急連絡先情報 | 手書きの氏名+電話番号 | 83〜90% | 電話番号の脆弱性に加え、あまり一般的でない姓が重なる |
| チェックボックス(はい/いいえ) | ✓、✗、塗りつぶし、または走り書き | 95〜98% | 曖昧なマーク(インクの飛び散り、半分だけ塗られた楕円)がほとんどのエラーの原因 |
| 医療情報/アレルギー | 手書きの自由記述段落 | 75〜85% | 筆記体、略語、医学用語が最も難しい抽出シナリオを作り出す |
| 学年(印刷または丸印) | 事前印刷された選択肢または手書き | 93〜97% | 丸印の選択が隣接する選択肢と重なる可能性がある |
| 印刷されたフォームのヘッダー(学校名、フォームタイトル) | 事前印刷されたテキスト | 99% | 精度上の懸念なし — 最も抽出しやすい対象 |
これらの数値は、文書が良好な品質でスキャンまたは撮影されていることを前提としています。最低200 DPI、良好なコントラスト、折り目や影の干渉が最小限であることです。照明の悪いスマートフォン写真に落とすと、すべての推定値は5〜10ポイント下がります。FERPAコンプライアンスガイドは、これらの文書が第三者による抽出パイプラインに入った瞬間に適用される規制上の考慮事項を扱っていますが、入学窓口が最初に尋ねる運用上の質問は上記のものです。つまり、フィールドごとに、実際に何が機能するのか、ということです。
入学窓口への要点: 印刷されたフィールドとチェックボックスは基本的に解決済みです。95〜99%のストレートスルー精度が期待できます。手書きの電話番号と自由記述の医療メモは、人間によるレビューパスが最も一般的に必要となる2つのフィールドタイプです。フォーム全体ではなく、これらの特定のフィールドに検証作業の予算を集中させてください。
AIが入学届で優れている点
標準的な印刷テキストとフォームヘッダー
学校名、フォームタイトル、学年オプション、プリントされた指示文など、プリンターまたは学校のSIS(PowerSchool、Infinite Campus、Skyward)から出力されたテキストは、最も抽出が容易なターゲットです。AIビジョンモデルは、テキストがクリーンで、フォントが標準的で、インクと紙のコントラストが通常高いため、ほぼ完璧な精度でこれらを処理します。これは従来のOCRを支えるものと同じ能力ですが、学校ごとのレイアウトにテンプレートを必要としません。セマンティック抽出は、ピクセル座標ではなく意味によってフィールドを見つけるからです。
チェックボックスと選択マーク
入学届にはチェックボックスが密集しています。「お子様にアレルギーはありますか? ☐ はい ☐ いいえ」、「学年を指定してください: ☐ K ☐ 1 ☐ 2 ☐ 3」。最新のAIモデルは、チェックマーク、X、塗りつぶした丸、ボックス内の走り書き、鉛筆で塗られたボックスなど、幅広いマークスタイルを認識するように訓練されています。精度は高い(95〜98%)のは、決定が2値(ボックスがマークされているかどうか)であり、視覚的な信号が筆記体の文字を解読するのに比べて比較的明確だからです。
エラーを引き起こすエッジケースは予測可能です。ボックス内のインクの飛び散り、親がマークを始めて途中で止めた半分塗りの楕円、マークされた後に取り消し線が引かれたボックスなどです。これらはまれで、チェックボックスフィールドの約2〜5%ですが、発生した場合、信頼度スコアフラグが誤った値を黙って出力するのではなく、人間によるレビューのためにそれらを捕捉します。
入学シーズンの規模に対応するバッチ処理
ここでAI抽出が手動データ入力と差別化されるのは、精度ではなく処理量の面です。学年の始まりに400件の入学届セットを処理する学校は、各フォームに10〜15フィールドあるため、約4,000〜6,000件の個別データポイントを入力する必要があります。1フォームあたり3分かかると、データ入力に20時間かかります。バッチファースト処理を使用するAIツールは、すべてのファイルを同時にアップロードし、システムがすべてのフォームから並行してデータを抽出するため、同じ作業を実時間30〜60分で完了し、出力は1つのスプレッドシートに統合されます。
Epic Charter Schoolsの事例は参考になります。米国最大級のバーチャル公立チャータースクールの1つであるEpicは、単一の入学期間に15,000件以上の学生記録を処理し、65種類以上の文書タイプを分類し、最初のサイクルで95%の精度を達成したAIシステムを使用しました。手動処理は学生1人あたり数時間から数秒に短縮されました。このシステムは入学ピーク向けに設計されており、クラウドベースで1日1,000人以上の学生に対応可能で、8月から9月の急増期に臨時のデータ入力スタッフを追加することなく処理できるよう構築されています。
入学届の抽出ワークフローを最初から最後まで完全に解説した手順については、カスタム列の設定方法、エッジケースの処理方法、結果の検証方法を含め、学生入学届抽出の完全ガイドをご覧ください。
AIがまだ苦手とする分野 — 正直な限界
手書きの電話番号
電話番号は入学届で最も壊れやすいフィールドです。その理由は単純で、意味的な冗長性がないからです。「555-123-4567」を読む人間は数字の形から「5」が「5」であると判断できますが、手書きが雑で最初の数字が「5」か「6」か判別できない場合、曖昧さを解決するための単語の文脈がありません。名前は周囲の文字から推測できますが、電話番号はできません。郵便番号、番地、学生ID番号にも同じことが当てはまります。
実際的な対策は、これらのフィールドで99%の精度を期待しないことです。電話番号と数値識別子には検証パスを計画しましょう。抽出された列の人間による目視確認か、ルールベースの検証(例:「この電話番号は正確に10桁か?」)のいずれかです。ほとんどの学校は手動入力時にも電話番号を検証しています。AIは単に、その検証が必要なフィールドの量を85〜90%削減するだけです。
低コントラスト・コピー済みの入学届
入学届は頻繁にコピーされます。学校が300部印刷し、保護者が手書きで記入し、事務室が記入済みの用紙をスキャンします。コピーを重ねるごとにコントラストが劣化します。3〜4世代目になると、鉛筆で記入されたチェックボックスのグレー地にグレーの文字は、人間の目にもAIモデルにもほぼ見えなくなります。解決策は単純です。白黒ではなくグレースケールで300 DPIでスキャンすることです。しかし実際には、多くの学校の事務室ではファイルサイズを抑えるためにモノクロでスキャンし、薄い鉛筆の跡と用紙の背景を区別する微妙なコントラストを失っています。
特殊なチェックボックスの記入方法
標準的なチェックマークや×印は適切に処理されますが、一部の記入方法は依然として課題です。「はい」の欄にチェックを入れるのではなく丸で囲む、行全体に線を引く、チェックマークがチェックボックスの境界を大きくはみ出すなどのケースです。これらは稀なケースですが、実際の入学届セットでは頻繁に出現するため、抽出パイプラインは推測するのではなく、レビュー用にフラグを立てるべきです。
自由記述の医療メモとアレルギー記載
入学届の「医療情報」または「アレルギー」欄は、抽出が最も難しい対象です。保護者はアレルギーを自由記述で記載します。「ペニシリン — 発疹が出る。猫アレルギーもあり。」といった具合です。筆跡は丁寧な活字から走り書きの筆記体までさまざまです。略語も一般的です(ペニシリンは「PCN」、薬剤アレルギーなしは「NKDA」など)。そして読み間違えた場合の影響は、住所の読み間違いよりも深刻です。アレルギーの見落としは子どもの安全に関わる可能性があります。
自由記述の医療欄には、AI抽出と人間による検証を組み合わせたアプローチが推奨されます。AIに最初のパスを実行させ、これらの欄をレビュー用にフラグし、学校の看護師または事務スタッフがスキャン画像と照合して抽出テキストを確認します。このハイブリッドアプローチにより、時間を90%以上節約しながら、安全に関わるデータの正確性を100%維持できます。
入学シーズンにバッチ処理が本当の変革をもたらす理由
「AIにできるか」という議論では精度が注目されがちですが、入学事務局にとってより重要なのは処理量です。8月から9月の入学受付期間は固定されたカレンダー上の制約です。新規家庭の登録、既存家庭の緊急連絡先の更新、そして授業開始までに学校のSISへ正確なデータを入力する必要があります。データ入力が1日遅れるごとに、クラス編成、スクールバスのルート計画、ランチプログラムの登録が後ろ倒しになります。
バッチファースト処理 — 数十枚から数百枚の入学届を同時にアップロードして並列処理する方式 — は、この制約に直接対応します。データ入力チームが1枚ずつ処理する代わりに、AIがすべてのフォームを同時に抽出し、結果を1つのスプレッドシートに統合します。そのスプレッドシートはSISのインポート形式(PowerSchool用CSV、Skyward用Excel、カスタム連携用JSON)に直接マッピングできるため、フォームごとの手動入力が不要になります。
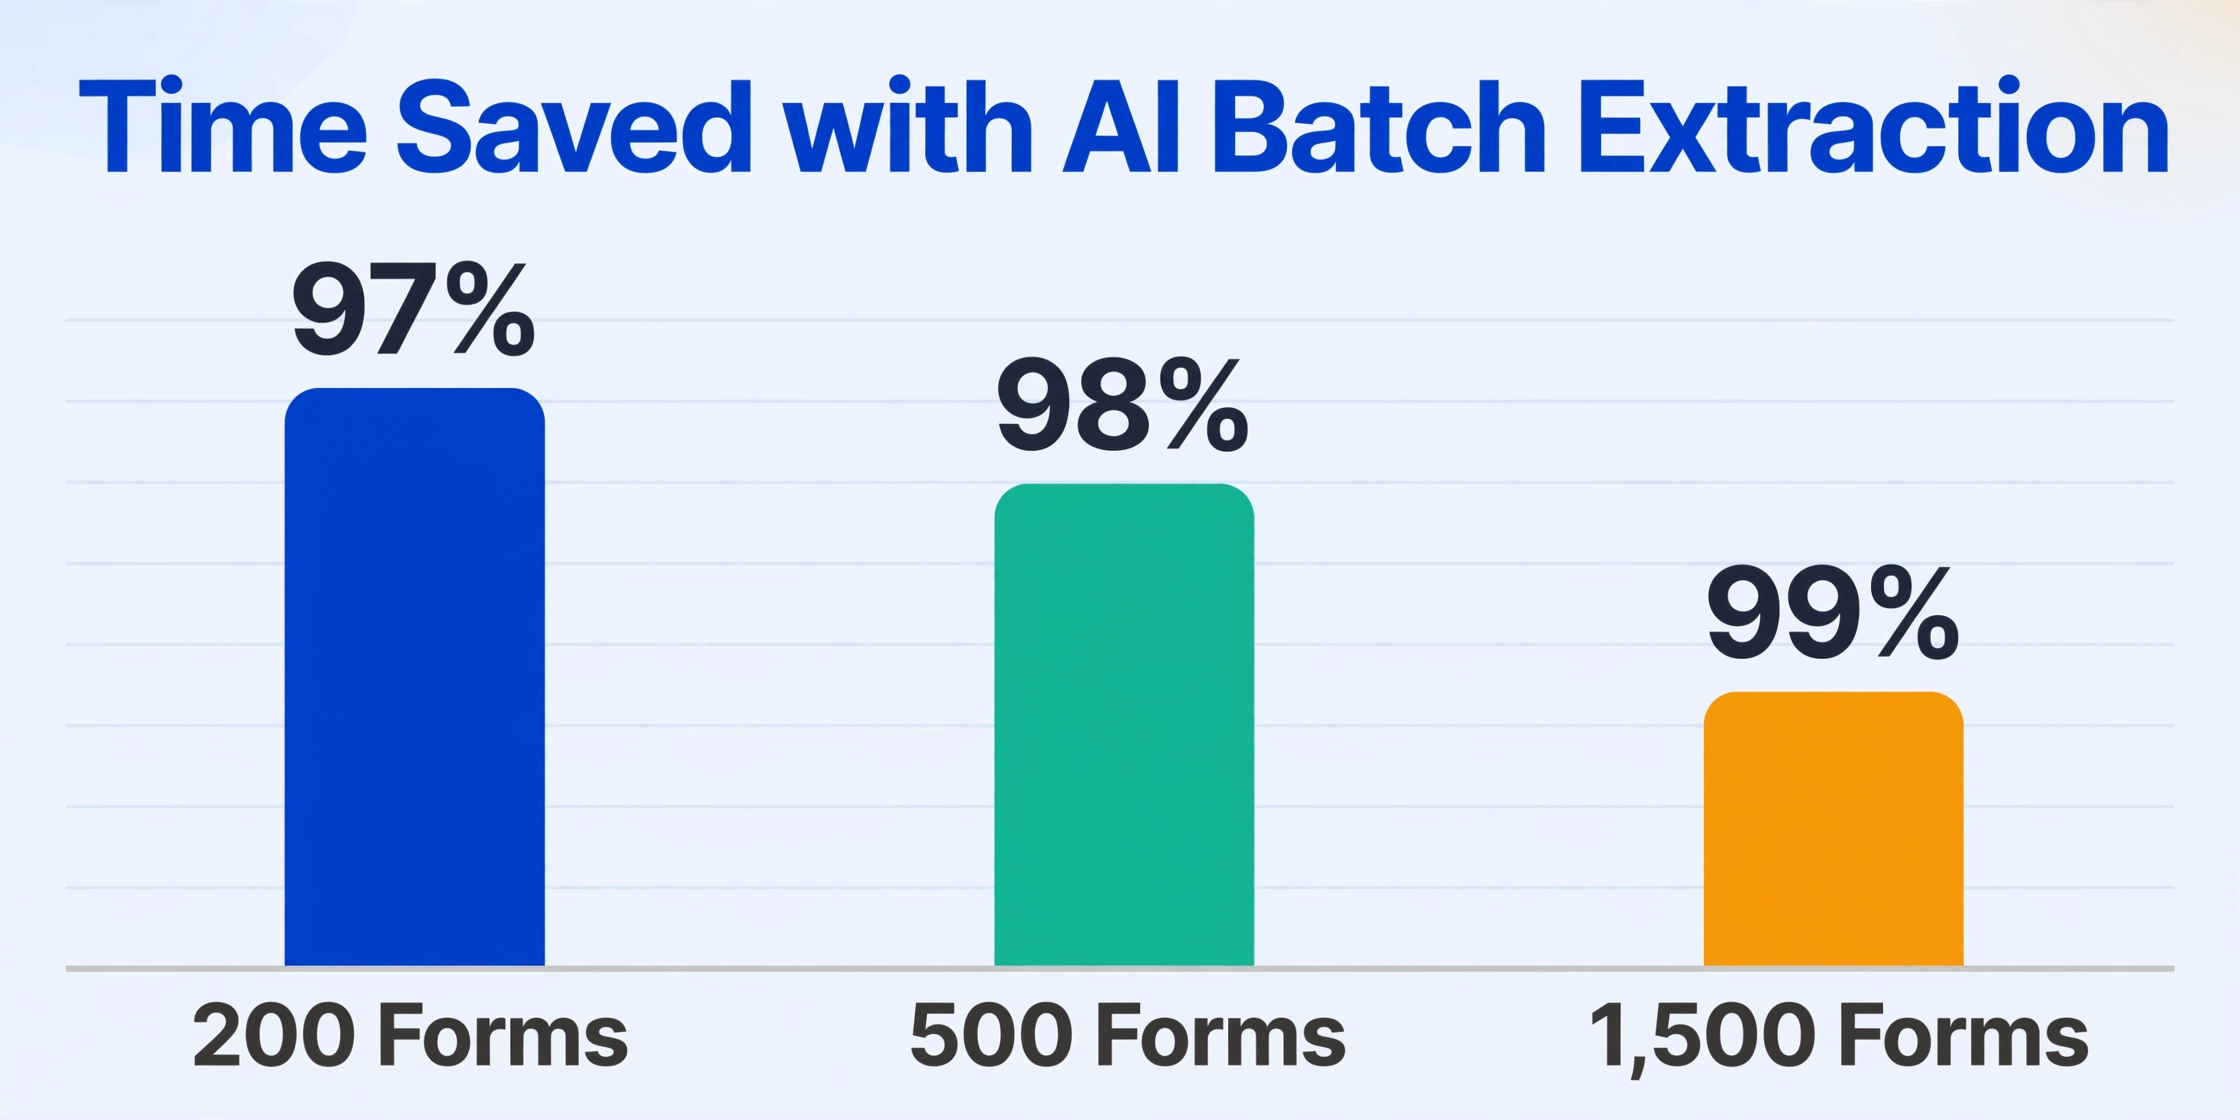
以下の表は、3つの一般的な入学処理量における運用上の違いを示しています。
| 入学処理量 | 手動データ入力(1枚あたり3分) | AIバッチ抽出 | 節約できる時間 |
|---|---|---|---|
| 200枚(小規模な小学校) | 10時間 | 約15分 | 97% |
| 500枚(中規模のK-8校) | 25時間 | 約30分 | 98% |
| 1,500枚(大規模な学区または高校) | 75時間 | 約60分 | 99% |
これらの時間短縮は、信頼度の低いフィールド(通常は全フィールドの10〜15%)に対する1回の検証パスを前提としており、AI処理時間に約10〜20%が追加されます。その検証を含めても、50枚を超えるバッチでは正味の時間短縮は90%を超えます。
これを可能にする仕組みがカスタム列抽出です。従来のOCRツールのように学校ごとのフォームレイアウトにテンプレートを設定する代わりに、必要なフィールド名(生徒氏名、生年月日、保護者連絡先、緊急連絡先電話番号、アレルギー、学年)を入力するだけで、AIが各フォーム上の該当データを意味理解に基づいて場所に関係なく特定します。1つの設定で、異なる学校、異なる年度、異なるSISエクスポートのフォームを処理できます。AIは座標ではなく内容を読み取るからです。
FERPAコンプライアンス — 入学届にAIを利用する際に変わること
生徒の氏名、生年月日、住所、保護者の連絡先を含む入学届は、Family Educational Rights and Privacy Act(FERPA)の34 CFR § 99.3に基づく教育記録に該当します。その書類が — スキャン、撮影、PDFメールのいずれであっても — 第三者によるAI抽出ツールにアップロードされた時点で、教育機関はFERPA § 99.30に基づく開示を行ったことになります。この開示には法的根拠が必要であり、ほとんどの入学事務局では、§ 99.31(a)(1)(i)(B)に基づく学校関係者(school official)の例外が適用されます。
規制の全体像はFERPA準拠の生徒データ抽出ガイドで解説していますが、入学届の処理に直接適用される運用上の要件は次の3つです:
- 書面による契約。 抽出プロバイダーは、学校関係者として指定し、データの利用を抽出サービスに限定し、生徒の書類を用いたモデル学習を禁止する署名済み契約の下で運用されなければなりません。クリックするだけの利用規約ではこの要件を満たしません — PTACのガイダンスは、交渉による契約とプロバイダーの標準的な利用規約を明確に区別しています。
- 一時的な処理アーキテクチャ。 書類は抽出期間中のみ保持し、定められた期間内に削除する必要があります。完了した入学届を無期限に保存するプロバイダー — またはAIモデル改善に利用するプロバイダー — は、認可された処理目的と実際のデータ保持の間にコンプライアンス上のギャップを生み出します。
- 開示の記録。 § 99.32(a)に基づき、教育機関は教育記録からのPIIの各開示について記録を維持しなければなりません。バッチ抽出の場合、どの書類が、どのプロバイダーによって、いつ、どの契約権限の下で処理されたかを記録することを意味します。現在、ほとんどの学校はこれを行っていません — しかし、コンプライアンス準拠のワークフローには必須です。
入学届抽出におけるコンプライアンスの問題は理論上のものではありません。署名済みの機関契約なしにAIツールで200件の入学届セットを処理する学校は、有効なFERPA例外なしに200件の開示を行っていることになります。実際の結果として即座に調査が行われる可能性は低いでしょう — しかし、保護者が§ 99.32(a)(2)に基づき子どもの開示履歴を請求した場合、学校はそれを提示しなければなりません。コンプライアンス準拠の体制は、そのリスクを完全に排除します。
よくある質問
AIは同じ入学届の手書き欄と印刷欄を区別できますか?
はい。最新のビジョン言語モデルは、欄に印刷文字と手書き文字のどちらが含まれているかを識別し、それに応じて抽出戦略を調整できます。保護者が一部の欄を手書きで、他の欄を活字体で記入する形式では、AIは各欄を独立して処理します。同じ用紙における両者の精度差は上記の一般的な推定値と一致しており、印刷欄は95〜99%、手書き欄は読みやすさに応じて85〜95%です。
95〜99%の精度は文字単位か欄単位のどちらで測定していますか?
この記事の数値は欄単位の精度です。つまり、抽出された値が修正なしで使用できる欄の割合です。欄単位の精度は、個々の文字を数える文字単位の精度よりも厳しい指標です。電話番号の1桁が誤っている場合、10桁中9桁が正しくても欄単位の精度は不合格となります。入学届では、電話番号や住所の1桁の誤りが欄全体の信頼性を損なうため、欄単位が適切な指標です。
異なる入学届レイアウトを使用する複数の学校でも抽出は機能しますか?
はい。ここがセマンティック抽出がテンプレートOCRと根本的に異なる点です。テンプレートベースのツールは、学校ごとの用紙レイアウトに個別の設定が必要です。学校Aは「保護者名」欄を右上に配置し、学校Bは2ページ目の中央に配置しています。セマンティックAIツールは位置を気にしません。「保護者/後見人名」(または「保護者名」「後見人情報」)というラベルを読み取り、その隣の記入値を抽出します。1つの設定で、50種類の異なるレイアウトの50校に対応できます。
1回のバッチで処理できる入学フォームの数に制限はありますか?
実際のバッチサイズはツールのアーキテクチャに依存します。バッチ処理用に設計されたクラウドベースの抽出システムは、フォームごとの精度を落とすことなく、1バッチあたり数百件のファイルを処理できます。処理能力の制約はAIモデルの処理能力ではなく、アップロード帯域幅と抽出後の検証ステップです。ほとんどの学校事務局では、200〜500件のバッチで抽出に15〜30分かかり、低信頼度フィールドの確認にさらに30〜60分かかります。
抽出した入学データをPowerSchoolやSISに直接取り込めますか?
AI抽出ツールは、データインポート機能を持つあらゆるSISに取り込める標準形式(CSV、Excel(XLSX)、JSON)で構造化データを出力します。PowerSchool、Infinite Campus、Skyward、Ellucian Bannerはすべて、学生の人口統計データの一括CSVインポートに対応しています。抽出されたスプレッドシートは各列を対応するSISフィールドにマッピングします。最初のマッピング設定を一度行えば、以降のバッチは同じテンプレートに従います。これにより、紙のフォームから各フィールドを手動でSISインターフェースに入力する手間がなくなります。
人間でも読めないほど筆跡が不鮮明な場合はどうなりますか?
学校職員が読めないほど筆跡が悪い場合、AIモデルも読むことはできません。このようなケース(入学フォームの約1〜3%を占める)では、抽出ツールはそのフィールドを低信頼度としてフラグを立て、元のスキャン画像を人間による確認用に表示する必要があります。正しい対応は推測することではありません。適切に設計された抽出ワークフローは、不鮮明なフィールドを例外として扱い、誤った可能性のある低信頼度の値を黙って出力するのではなく、人間の判断に回します。
AI抽出のコストは、入学フォームの手動データ入力と比べてどうですか?
一般的な15フィールドの入学フォームの手動データ入力には、時給と処理速度にもよりますが、スタッフの人件費として約$1.50〜$3.00かかります。AI抽出は通常、1ページあたり$0.10〜$0.25で、フィールドごとの追加料金はありません。年間500件の入学書類を処理する学校の場合、直接コストの比較は、手動で$750〜$1,500、AIで$50〜$125となり、8月から9月のピーク時の時間節約、残業削減、下流の管理業務を生み出す転記ミスの排除はまだ考慮していません。学生入学フォーム抽出の完全ガイドには、さまざまな入学件数にわたる詳細なコスト比較が含まれています。
FERPAは、学年やアレルギーなどの非識別項目のみを抽出する場合でも適用されますか?
FERPAの適用基準は、抽出する特定の項目ではなく、文書自体の開示です。入学届を第三者ツールにアップロードすることは、たとえ「学年」や「アレルギー」のみを抽出するつもりでも、教育記録全体の開示に該当します。文書には生徒の氏名、生年月日、その他の識別情報が含まれており、抽出する項目に関係なく、これらの情報は抽出プロバイダーに送信されるファイル内に存在します。§ 99.31(a)(1)に基づく学校職員の例外は、処理関係に適用されるものであり、個々の項目の選択に適用されるものではありません。準拠した設定には、1つの項目を抽出する場合でも20の項目を抽出する場合でも、同じ書面による合意が必要です。
入学届は、印刷文字、手書き、チェックボックス、自由記述欄が同じページに共存する数少ない文書タイプです。AI抽出の精度は、各フィールドがどの形式を使用しているかによって予測可能な形で変動します。
入学事務局にとっての実用的なポイント:印刷フィールドとチェックボックスは95〜99%の精度で動作し、確認作業は最小限で済みます。手書きの電話番号と医療メモは、検証パスが必要なフィールドの10〜15%に該当します。残りの価値はバッチ処理から生まれます。手動データ入力に20時間かかっていた作業を、SISインポート形式に直接マッピングできる結果を生成する30分のAI抽出セッションに変えることができます。
ご自身の入学届セットでお試しください。特定のフォームレイアウト、保護者の手書きスタイル、入学シーズンのボリュームに対して、精度がどの程度になるかをご確認いただけます。
サインアップ不要で無料でお試しいただけます。ファイルは一時的に処理され、保持されません。学区または大学向けのFERPA準拠の機関契約についてはお問い合わせください。