Kann KI Schüler
Anmeldeformulare erfassen? Ja – so sieht die Genauigkeit nach Feld aus
Ja – moderne KI-Vision-Modelle können Daten aus Schüler-Anmeldeformularen mit 95–99 % Genauigkeit bei gedruckten Feldern, 85–95 % bei handschriftlichen Einträgen und über 95 % bei Kontrollkästchen-Auswahlen erfassen, und das mit semantischer Dokumentextraktion, die keine Vorlage für das individuelle Formularlayout jeder Schule benötigt. Die Genauigkeit variiert stark je nach Feldtyp – eine gedruckte Telefonnummer eines Elternteils ist nahezu garantiert, während eine Freitext-Notiz in Schreibschrift möglicherweise eine menschliche Überprüfung erfordert. Hier ist genau, wo die Technologie heute steht, wo sie noch Schwierigkeiten hat und was die Anmeldespitze im August–September für Ihren Verarbeitungsworkflow bedeutet.
Wichtigste Erkenntnisse
- Die eigentliche Frage zur Extraktion von Anmeldeformularen ist nicht, ob KI Handschrift lesen kann – sondern ob eine Schule, die im August 400 Anmeldesätze verarbeitet, sich 20 Stunden manuelle Dateneingabe leisten kann, wenn jeder Tag Verzögerung die Klassenzuweisungen, Busroutenplanung und Anmeldung zum Mittagsprogramm nach hinten verschiebt.
- Handschriftliche Telefonnummern sind das fragilste Feld auf jedem Anmeldeformular – anders als bei einem Namen, den umgebende Buchstaben eindeutig machen können, macht eine falsch gelesene Ziffer von zehn den gesamten Notfallkontakt unbrauchbar, und 400 Formulare bedeuten 400 verschiedene Hände, die diese zehn Ziffern ohne Autokorrektur schreiben.
- Batch-Verarbeitung ist der Ort, an dem die echte Effizienz liegt – 400 Anmeldesätze, für die ein Dateneingabeteam 20 Stunden benötigt, sind in 30 Minuten KI-Extraktion fertig, weil 85–90 % der Felder mit 95–99 % Genauigkeit durchkommen und nur handschriftliche Telefonnummern und medizinische Notizen einen menschlichen Blick benötigen.
Wie gut es funktioniert – Feldgenauigkeit bei einem Anmeldeformular
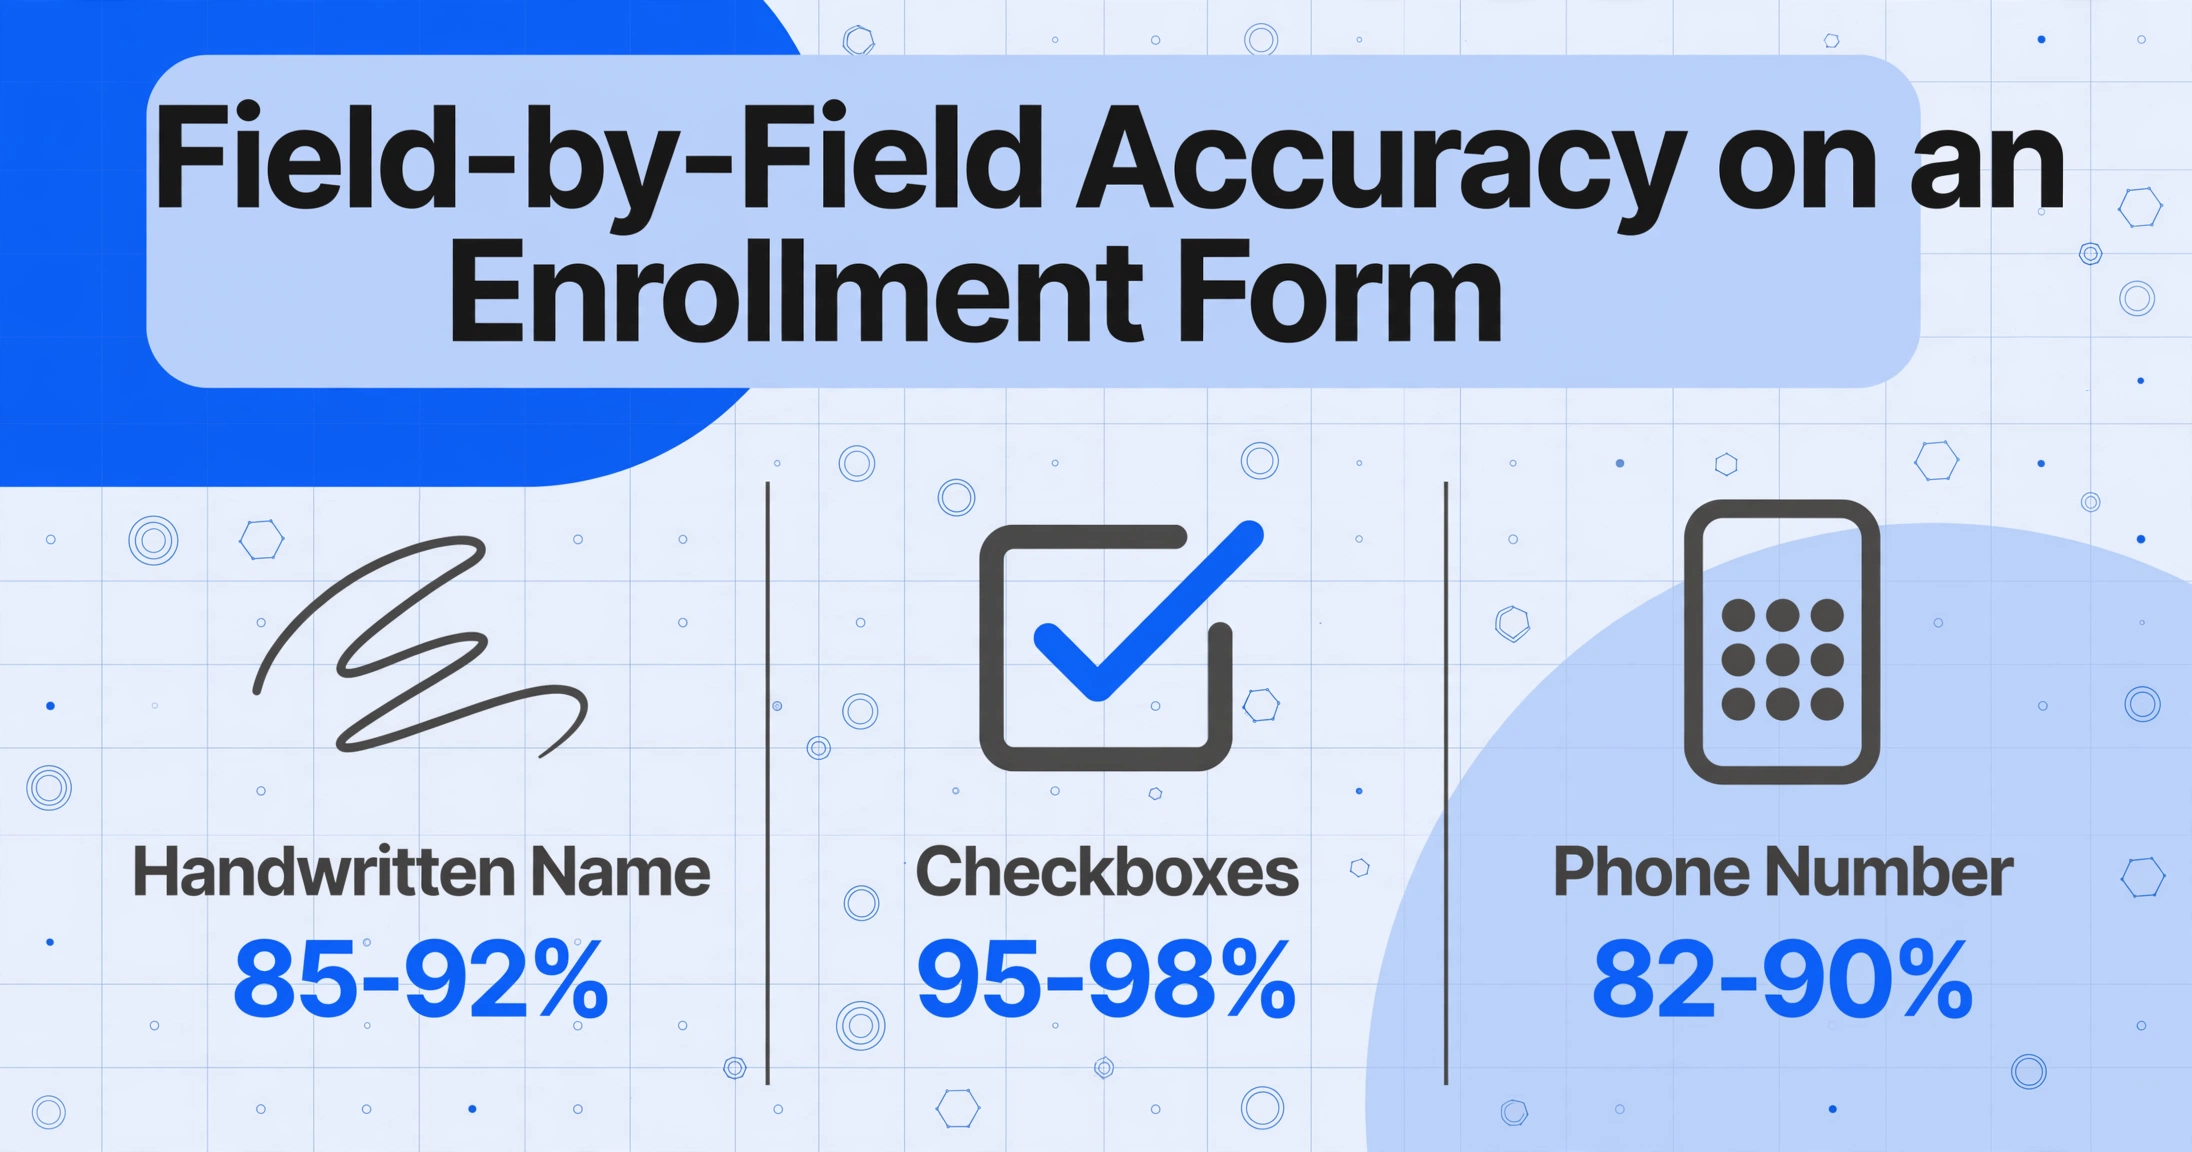
Anmeldeformulare sind kein einzelnes Extraktionsproblem. Ein typisches K-12-Anmeldesatz enthält eine Mischung aus Feldtypen, jeweils mit einem unterschiedlichen Genauigkeitsprofil. Nachfolgend sehen Sie, was ein modernes KI-Extraktionstool – eines, das Vision-Language-Modelle statt traditioneller Template-OCR verwendet – bei den häufigsten Anmeldeformularfeldern liefert.
| Feldtyp | Typischer Inhalt | Geschätzte KI-Genauigkeit | Hauptherausforderung |
|---|---|---|---|
| Schülername (gedruckt) | Getippt oder sauber geschrieben | 97–99 % | Scheitert selten, außer die Scanqualität ist schlecht |
| Schülername (handschriftlich) | Schreibschrift oder Druckschrift von Kind oder Elternteil | 85–92 % | Die Handschrift von Kindern variiert stark; die Lesbarkeit des ersten Buchstabens ist entscheidend |
| Geburtsdatum | MM/TT/JJJJ oder ausgeschrieben | 90–95 % | Mehrdeutige Datumsformate (MM/TT vs. TT/MM) können ohne Kontext falsch gelesen werden |
| Name des Elternteils/Erziehungsberechtigten | Handschriftlich vom Elternteil | 88–95 % | Erwachsenenschreibschrift ist konsistenter als die von Kindern, aber ungewöhnliche Namen können die Inferenz stören |
| Telefonnummer des Elternteils | Handschriftliche Ziffern | 82–90 % | Eine einzige falsch gelesene Ziffer macht die Nummer unbrauchbar – Telefonnummern haben keine Autokorrektur |
| Wohnadresse | Handschriftliche Straße, Stadt, PLZ | 85–92 % | Hausnummern und PLZ sind ziffernlastig; der Abgleich mit Adressdatenbanken hilft |
| Notfallkontaktinformationen | Handschriftlicher Name + Telefon | 83–90 % | Gleiche Telefonnummer-Fragilität, verstärkt durch weniger häufige Nachnamen |
| Kontrollkästchen (Ja/Nein) | ✓, ✗, ausgefüllter Kreis oder Gekritzel | 95–98 % | Mehrdeutige Markierungen (ein versehentlicher Stiftpunkt, ein halb ausgefülltes Oval) verursachen die meisten Fehler |
| Medizinische Informationen/Allergien | Freitext, handschriftlicher Absatz | 75–85 % | Schreibschrift, Abkürzungen und medizinische Terminologie ergeben das schwierigste Extraktionsszenario |
| Klassenstufe (gedruckt oder eingekreist) | Vorgedruckte Optionen oder handschriftlich | 93–97 % | Eingekreiste Auswahlen können mit benachbarten Optionen überlappen |
| Gedruckte Formularkopfzeilen (Schulname, Formulartitel) | Vorgedruckter Text | 99 % | Keine Genauigkeitsbedenken – dies ist das einfachste Extraktionsziel |
Diese Zahlen gehen davon aus, dass das Dokument in angemessener Qualität gescannt oder fotografiert wird — mindestens 200 DPI, guter Kontrast, minimale Falz- oder Schattenbeeinträchtigung. Bei einem Smartphone-Foto bei schlechten Lichtverhältnissen sinken alle Schätzungen um 5–10 Punkte. Der FERPA-Compliance-Leitfaden behandelt die regulatorischen Aspekte, die gelten, sobald diese Dokumente in eine Drittanbieter-Extraktionspipeline gelangen, aber die operative Frage, die sich die meisten Anmeldebüros zuerst stellen, ist die obige: Feld für Feld, was funktioniert tatsächlich?
Das Fazit für Anmeldebüros: Gedruckte Felder und Kontrollkästchen sind im Wesentlichen gelöst — rechnen Sie mit 95–99 % Durchsatzgenauigkeit ohne manuelle Eingriffe. Handgeschriebene Telefonnummern und Freitext-Notizen zu medizinischen Angaben sind die beiden Feldtypen, die am häufigsten eine manuelle Prüfung erfordern. Planen Sie Ihren Verifizierungsaufwand um diese spezifischen Felder herum, nicht um das gesamte Formular.
Wo KI bei Anmeldeformularen glänzt
Standardmäßig gedruckter Text und Formularköpfe
Schulname, Formulartitel, Klassenstufenoptionen, vorab gedruckte Anweisungen — jeder Text, der aus einem Drucker oder dem SIS einer Schule (PowerSchool, Infinite Campus oder Skyward) stammt, ist das einfachste Extraktionsziel. KI-Visionsmodelle verarbeiten diese mit nahezu perfekter Genauigkeit, da der Text sauber, die Schriftart standardisiert und der Kontrast zwischen Tinte und Papier in der Regel hoch ist. Dies ist dieselbe Fähigkeit, die traditioneller OCR zugrunde liegt — jedoch ohne dass eine Vorlage pro Schullayout erforderlich ist, da die semantische Extraktion das Feld anhand der Bedeutung und nicht anhand von Pixelkoordinaten findet.
Kontrollkästchen und Auswahlmarkierungen
Anmeldeformulare sind voller Kontrollkästchen: „Ist Ihr Kind gegen Medikamente allergisch? ☐ Ja ☐ Nein", „Bitte geben Sie die Klassenstufe an: ☐ K ☐ 1 ☐ 2 ☐ 3". Moderne KI-Modelle sind darauf trainiert, eine Vielzahl von Markierungsstilen zu erkennen — ein Häkchen, ein X, ein ausgefüllter Kreis, ein Gekritzel im Kästchen oder ein mit Bleistift ausgemaltes Kästchen. Die Genauigkeit ist hoch (95–98 %), da die Entscheidung binär ist: Das Kästchen ist entweder markiert oder nicht, und das visuelle Signal ist im Vergleich zum Entziffern von Schreibschrift relativ eindeutig.
Die Randfälle, die Fehler verursachen, sind vorhersehbar: ein versehentlicher Stiftpunkt im Kästchen, ein halb ausgefülltes Oval, bei dem die Eltern mit dem Markieren begonnen und aufgehört haben, oder ein Kästchen, das markiert und dann durchgestrichen wurde. Diese sind selten — vielleicht 2–5 % der Kontrollkästchenfelder — aber wenn sie auftreten, wird durch eine Konfidenzpunkt-Flagge eine manuelle Prüfung ausgelöst, anstatt stillschweigend den falschen Wert auszugeben.
Batch-Verarbeitung im Maßstab der Anmeldesaison
Hier zeigt sich, wie sich KI-Extraktion von manueller Dateneingabe unterscheidet – nicht bei der Genauigkeit, sondern beim Durchsatz. Eine Schule, die zu Beginn des Schuljahres 400 Anmeldesätze verarbeitet – jeder mit 10–15 Feldern –, hat etwa 4.000–6.000 einzelne Datenpunkte einzugeben. Bei drei Minuten pro Formular sind das 20 Stunden Dateneingabe. Ein KI-Tool mit Batch-First-Verarbeitung – bei der alle Dateien gleichzeitig hochgeladen werden und das System Daten aus jedem Formular parallel extrahiert – erledigt dieselbe Arbeit in 30–60 Minuten Echtzeit, wobei die Ausgabe in einer einzigen Tabelle zusammengeführt wird.
Der Fall Epic Charter Schools ist hier aufschlussreich. Als eine der größten virtuellen öffentlichen Charterschulen in den USA verarbeitete Epic über 15.000 Schülerdatensätze in einem einzigen Anmeldezeitraum mithilfe eines KI-Systems, das 65+ Dokumenttypen klassifizierte und im ersten Zyklus eine Genauigkeit von 95 % erreichte. Die manuelle Verarbeitung sank von Stunden pro Schüler auf Sekunden. Das System wurde für die Anmeldespitze konzipiert – cloudbasiert, skalierbar auf 1.000+ Schüler pro Tag und gebaut, um den Ansturm von August bis September ohne zusätzliches Dateneingabepersonal zu bewältigen.
Eine vollständige Schritt-für-Schritt-Anleitung zum Workflow der Anmeldeformular-Extraktion – einschließlich der Einrichtung benutzerdefinierter Spalten, der Behandlung von Randfällen und der Validierung von Ergebnissen – finden Sie im vollständigen Leitfaden zur Extraktion von Schüleranmeldeformularen.
Wo KI weiterhin scheitert – die ehrlichen Grenzen
Handgeschriebene Telefonnummern
Telefonnummern sind das fragilste Feld auf einem Anmeldeformular, aus einem einfachen Grund: Sie haben keine semantische Redundanz. Ein Mensch, der „555-123-4567“ liest, kann anhand der Ziffernformen erkennen, dass die „5“ eine „5“ ist – aber wenn die Handschrift unleserlich ist und die erste Ziffer eine „5“ oder „6“ sein könnte, gibt es keinen Wortkontext, um die Mehrdeutigkeit aufzulösen. Namen können aus umgebenden Buchstaben abgeleitet werden; Telefonnummern nicht. Dasselbe gilt für Postleitzahlen, Hausnummern und Schüler-ID-Nummern.
Die praktische Abhilfe besteht nicht darin, bei diesen Feldern 99 % zu erwarten. Planen Sie einen Verifizierungsdurchgang für Telefonnummern und numerische Kennungen ein – entweder eine menschliche Sichtprüfung der extrahierten Spalte oder eine regelbasierte Validierung (z. B. „Hat diese Telefonnummer genau 10 Ziffern?“). Die meisten Schulen überprüfen Telefonnummern bei der manuellen Eingabe ohnehin; die KI reduziert lediglich die Anzahl der Felder, die diese Überprüfung benötigen, um 85–90 %.
Formulare mit geringem Kontrast und Fotokopien
Anmeldeformulare werden häufig fotokopiert – die Schule druckt 300 Exemplare, die Eltern füllen sie von Hand aus, und das Büro scannt die ausgefüllten Formulare wieder ein. Jede Kopiergeneration verringert den Kontrast. Ab der dritten oder vierten Generation kann der graue Text eines mit Bleistift ausgefüllten Kontrollkästchens für das menschliche Auge und das KI-Modell nahezu unsichtbar sein. Die Lösung ist einfach – Scannen mit 300 DPI in Graustufen statt in Schwarzweiß – aber in der Praxis scannen viele Schulbüros in Monochrom, um die Dateigröße zu reduzieren, wodurch der feine Kontrast verloren geht, der eine helle Bleistiftmarkierung vom Papierhintergrund unterscheidet.
Ungewöhnliche Markierungen in Kontrollkästchen
Während Standard-Häkchen und X-Markierungen gut verarbeitet werden, bleiben einige Markierungsarten eine Herausforderung: ein Kreis um „Ja“ statt einer Markierung im Kästchen, eine Linie durch die gesamte Zeile oder ein Häkchen, das weit über die Grenze des Kontrollkästchens hinausragt. Dies sind Randfälle, aber sie treten in echten Anmeldesätzen häufig genug auf, dass eine Extraktionspipeline sie zur Überprüfung kennzeichnen sollte, anstatt zu raten.
Freitext-Notizen zu medizinischen Angaben und Allergiebeschreibungen
Der Abschnitt „Medizinische Angaben“ oder „Allergien“ eines Anmeldeformulars ist das schwierigste Extraktionsziel. Eltern beschreiben Allergien in Freitext: „Penicillin – verursacht Hautausschlag. Auch allergisch gegen Katzen.“ Die Handschrift kann von sauberer Druckschrift bis zu hastiger Schreibschrift reichen. Abkürzungen sind üblich („PCN“ für Penicillin, „NKDA“ für keine bekannten Medikamentenallergien). Und die Folgen einer Fehlinterpretation sind schwerwiegender als bei einer falsch gelesenen Adresse – eine übersehene Allergie könnte die Sicherheit des Kindes gefährden.
Für medizinische Freitextfelder wird ein KI-gestützter Ansatz mit menschlicher Überprüfung empfohlen: Die KI erstellt einen ersten Entwurf, diese Felder werden zur Überprüfung gekennzeichnet, und eine Schulkrankenschwester oder ein Verwaltungsmitarbeiter bestätigt den extrahierten Text anhand des Scans. Dieser hybride Ansatz spart über 90 % der Zeit und gewährleistet gleichzeitig 100 % Genauigkeit bei sicherheitskritischen Daten.
Warum die Batch-Verarbeitung der eigentliche Game-Changer für die Anmeldesaison ist
Genauigkeitsdiskussionen dominieren oft die Frage „Kann KI das?“, doch für Anmeldebüros ist die Frage nach dem Durchsatz oft wirkungsvoller. Das Anmeldefenster von August bis September ist eine feste Kalendergrenze: Neue Familien registrieren sich, bestehende Familien aktualisieren Notfallkontakte, und die Schule benötigt saubere Daten im SIS, bevor der Unterricht beginnt. Jeder Tag Verzögerung bei der Dateneingabe verschiebt die Klassenzuweisungen, die Busroutenplanung und die Anmeldung zum Mittagsprogramm.
Die Batch-First-Verarbeitung – bei der dutzende oder hunderte Anmeldeformulare gleichzeitig hochgeladen und parallel verarbeitet werden – geht diese Einschränkung direkt an. Statt dass ein Dateneingabeteam einen Stapel Formular für Formular durcharbeitet, extrahiert die KI jedes Formular gleichzeitig und führt die Ergebnisse in einer einzigen Tabelle zusammen. Die Tabelle lässt sich dann direkt in SIS-Importformate (CSV für PowerSchool, Excel für Skyward, JSON für kundenspezifische Integrationen) übertragen, wodurch die manuelle Einzelerfassung entfällt.
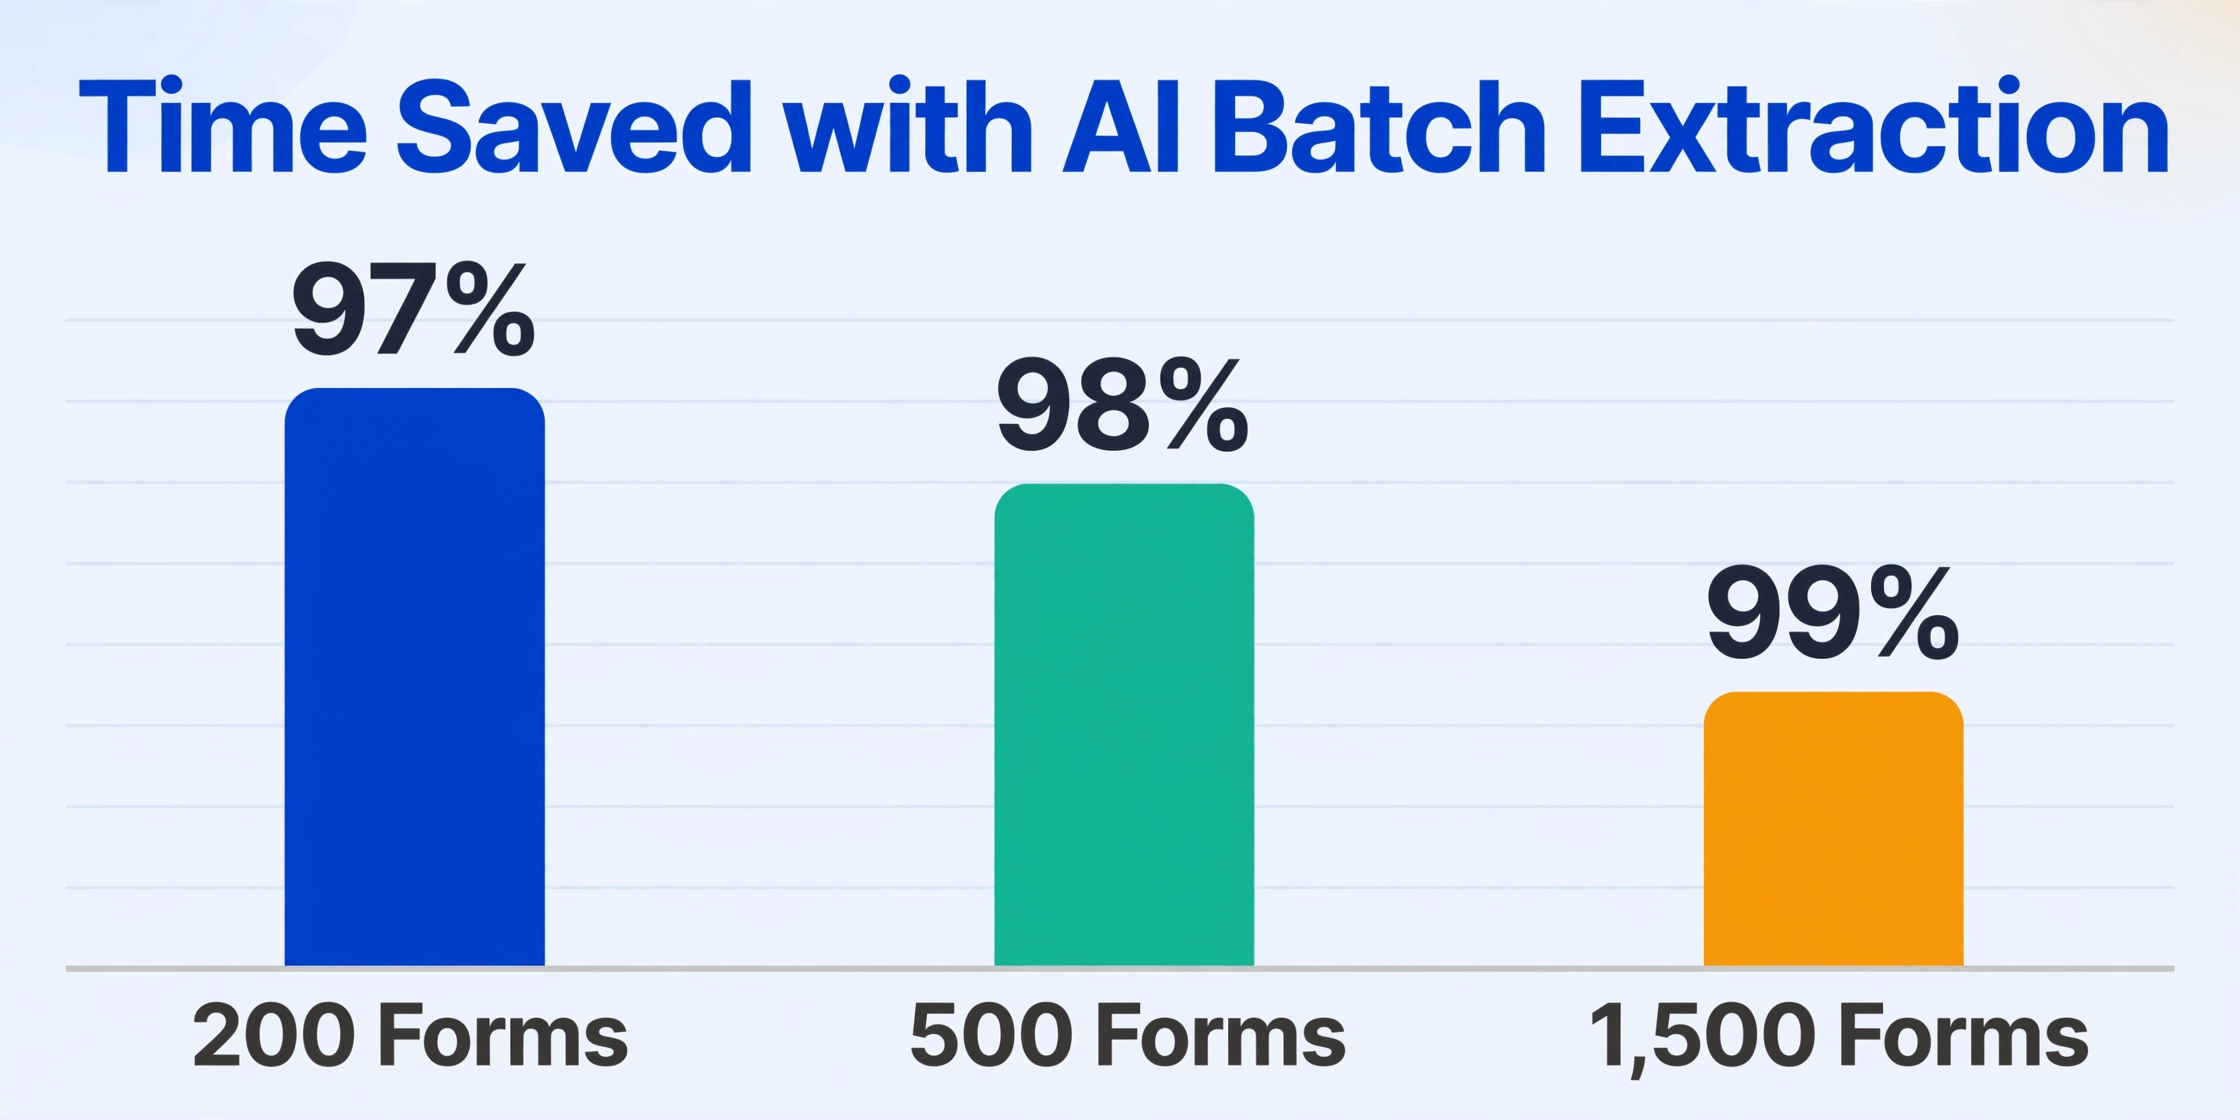
Die folgende Tabelle veranschaulicht den operativen Unterschied bei drei gängigen Anmeldevolumina:
| Anmeldevolumen | Manuelle Dateneingabe (3 Min./Formular) | KI-Batchextraktion | Zeitersparnis |
|---|---|---|---|
| 200 Formulare (kleine Grundschule) | 10 Stunden | ~15 Minuten | 97 % |
| 500 Formulare (mittelgroße K-8-Schule) | 25 Stunden | ~30 Minuten | 98 % |
| 1.500 Formulare (großer Bezirk oder weiterführende Schule) | 75 Stunden | ~60 Minuten | 99 % |
Diese Zeitersparnisse setzen einen einzigen Verifizierungsdurchgang für Felder mit geringer Konfidenz voraus – typischerweise 10–15 % aller Felder –, was etwa 10–20 % zur KI-Verarbeitungszeit hinzufügt. Selbst mit dieser Verifizierung übersteigt die Netto-Zeitersparnis 90 % für jede Charge mit mehr als 50 Formularen.
Die Struktur, die dies ermöglicht, ist die Benutzerdefinierte Spaltenextraktion: Statt für jedes schulspezifische Formularlayout eine Vorlage zu konfigurieren – was herkömmliche OCR-Tools erfordern – geben Sie die gewünschten Feldnamen ein (Schülername, Geburtsdatum, Elternteil-Kontakt, Notfalltelefon, Allergien, Klasse) und die KI lokalisiert die entsprechenden Daten auf jedem Formular durch semantisches Verständnis, unabhängig davon, wo sich jedes Feld auf der Seite befindet. Eine Konfiguration verarbeitet Formulare verschiedener Schulen, verschiedener Jahrgänge und verschiedener SIS-Exporte, weil die KI Inhalte liest, nicht Koordinaten.
FERPA-Konformität – Was sich ändert, wenn Sie KI für Anmeldeformulare nutzen
Ein Anmeldeformular mit dem vollständigen gesetzlichen Namen, dem Geburtsdatum, der Adresse und den Kontaktdaten der Eltern eines Schülers ist eine Bildungsakte im Sinne von 34 CFR § 99.3 des Family Educational Rights and Privacy Act. In dem Moment, in dem dieses Formular – ob gescannt, fotografiert oder als PDF per E-Mail versendet – in ein KI-Extraktionstool eines Drittanbieters hochgeladen wird, hat die Bildungseinrichtung eine Offenlegung gemäß FERPA § 99.30 vorgenommen. Diese Offenlegung erfordert eine Rechtsgrundlage, und für die meisten Zulassungsstellen ist die anwendbare Grundlage die Ausnahme für Schulbeamte gemäß § 99.31(a)(1)(i)(B).
Der vollständige regulatorische Rahmen ist im Leitfaden zur FERPA-konformen Extraktion von Schülerdaten beschrieben, aber drei betriebliche Anforderungen gelten direkt für die Verarbeitung von Anmeldeformularen:
- Schriftliche Vereinbarung. Der Extraktionsanbieter muss unter einem unterzeichneten Vertrag arbeiten, der ihn als Schulbeamten ausweist, die Datennutzung auf den Extraktionsdienst beschränkt und das Training von Modellen mit Schülerdokumenten untersagt. Angeklickte Nutzungsbedingungen erfüllen diese Anforderung nicht – die PTAC-Leitlinien unterscheiden ausdrücklich zwischen einem ausgehandelten Vertrag und den Standardbedingungen eines Anbieters.
- Transiente Verarbeitungsarchitektur. Dokumente sollten nur für die Dauer der Extraktion aufbewahrt und innerhalb eines definierten Zeitfensters gelöscht werden. Ein Anbieter, der abgeschlossene Anmeldeformulare auf unbestimmte Zeit speichert – oder sie zur Verbesserung von KI-Modellen verwendet – schafft eine Konformitätslücke zwischen dem autorisierten Verarbeitungszweck und der tatsächlichen Datenaufbewahrung.
- Protokollierung von Offenlegungen. Gemäß § 99.32(a) muss die Einrichtung eine Aufzeichnung jeder Offenlegung von PII aus Bildungsakten führen. Bei der Batch-Extraktion bedeutet dies, dass protokolliert werden muss, welche Dokumente verarbeitet wurden, von welchem Anbieter, an welchem Datum und unter welcher vertraglichen Befugnis. Die meisten Schulen tun dies heute nicht – aber ein konformer Arbeitsablauf erfordert es.
Die Konformitätsfrage bei der Extraktion von Anmeldeformularen ist nicht theoretisch. Eine Schule, die 200 Anmeldesätze mit einem KI-Tool ohne unterzeichnete institutionelle Vereinbarung verarbeitet, nimmt 200 Offenlegungen ohne gültige FERPA-Ausnahme vor. Die praktische Konsequenz ist wahrscheinlich keine unmittelbare Untersuchung – aber wenn ein Elternteil die Offenlegungshistorie seines Kindes gemäß § 99.32(a)(2) anfordert, muss die Schule diese vorlegen. Ein konformer Aufbau eliminiert dieses Risiko vollständig.
Häufig gestellte Fragen
Kann KI zwischen handschriftlichen und gedruckten Feldern auf demselben Anmeldeformular unterscheiden?
Ja. Moderne Vision-Language-Modelle können erkennen, ob ein Feld handschriftlichen oder gedruckten Text enthält, und die Extraktionsstrategie entsprechend anpassen. Bei Formularen, bei denen Eltern einige Felder handschriftlich und andere in Druckbuchstaben ausfüllen, behandelt die KI jedes Feld unabhängig. Der Genauigkeitsunterschied zwischen beiden auf demselben Formular entspricht den oben genannten allgemeinen Schätzungen: Gedruckte Felder erreichen 95–99 %, handschriftliche Felder 85–95 %, abhängig von der Lesbarkeit.
Wie messen Sie die Genauigkeitswerte von 95–99 % – auf Zeichen- oder Feldebene?
Die Zahlen in diesem Artikel beziehen sich auf die Genauigkeit auf Feldebene – den Prozentsatz der Felder, bei denen der extrahierte Wert ohne Korrektur verwendbar ist. Die Genauigkeit auf Feldebene ist ein strengeres Maß als die Genauigkeit auf Zeichenebene, die einzelne Zeichen zählt. Eine Telefonnummer mit einer falschen Ziffer besteht die Feldebene-Genauigkeit nicht, selbst wenn 9 von 10 Ziffern korrekt sind. Bei Anmeldeformularen ist die Feldebene die relevante Kennzahl, da eine falsche Ziffer in einer Telefonnummer oder Adresse das gesamte Feld unzuverlässig macht.
Funktioniert die Extraktion über verschiedene Schulen hinweg, die unterschiedliche Anmeldeformular-Layouts verwenden?
Ja – genau hier unterscheidet sich die semantische Extraktion grundlegend von der Template-OCR. Ein templatebasiertes Tool benötigt eine separate Konfiguration für das Formularlayout jeder Schule: Schule A platziert das Feld „Name des Elternteils“ oben rechts; Schule B platziert es in der Mitte von Seite zwei. Ein semantisches KI-Tool kümmert sich nicht um die Position – es liest die Beschriftung „Name des Elternteils/Erziehungsberechtigten“ (oder „Name des Elternteils“ oder „Angaben zum Erziehungsberechtigten“) und extrahiert den daneben ausgefüllten Wert. Eine Konfiguration verarbeitet 50 Schulen mit 50 verschiedenen Formularlayouts.
Gibt es ein Limit, wie viele Anmeldeformulare in einem Batch verarbeitet werden können?
Die praktische Batch-Größe hängt von der Architektur des Tools ab. Cloud-basierte Extraktionssysteme, die für die Batch-Verarbeitung ausgelegt sind, verarbeiten Hunderte von Dateien pro Batch ohne Einbußen bei der Genauigkeit pro Formular. Der Engpass liegt nicht in der Verarbeitungskapazität des KI-Modells, sondern in der Upload-Bandbreite und dem Verifizierungsschritt nach der Extraktion. Für die meisten Schulsekretariate dauert die Extraktion eines Batches von 200–500 Formularen 15–30 Minuten, plus weitere 30–60 Minuten für die Überprüfung von Feldern mit geringer Konfidenz.
Können extrahierte Anmeldedaten direkt in PowerSchool oder unser SIS übertragen werden?
KI-Extraktionstools geben strukturierte Daten in Standardformaten aus – CSV, Excel (XLSX) und JSON – die in jedes SIS mit Datenimportfunktion importiert werden können. PowerSchool, Infinite Campus, Skyward und Ellucian Banner unterstützen alle den CSV-Massenimport für Schülerdemografiedaten. Die extrahierte Tabelle ordnet jede Spalte dem entsprechenden SIS-Feld zu; nach einer einmaligen Zuordnungseinrichtung folgen nachfolgende Batches derselben Vorlage. Dies eliminiert den Schritt des manuellen Eintippens jedes Feldes aus einem Papierformular in die SIS-Oberfläche.
Was passiert, wenn die Handschrift völlig unleserlich ist – selbst für einen Menschen?
Wenn die Handschrift so schlecht ist, dass ein Schulmitarbeiter sie nicht lesen kann, wird auch ein KI-Modell sie nicht lesen können. In diesen Fällen – die vielleicht 1–3 % der Anmeldeformulare ausmachen – sollte das Extraktionstool das Feld als niedrige Konfidenz markieren und das ursprüngliche Scanbild zur menschlichen Überprüfung anzeigen. Die richtige Reaktion ist nicht zu raten. Ein gut gestalteter Extraktionsworkflow behandelt unleserliche Felder als Ausnahmen und leitet sie an eine menschliche Entscheidung weiter, anstatt stillschweigend einen Wert mit niedriger Konfidenz auszugeben, der falsch sein könnte.
Wie vergleichen sich die Kosten der KI-Extraktion mit der manuellen Dateneingabe für Anmeldeformulare?
Die manuelle Dateneingabe für ein typisches Anmeldeformular mit 15 Feldern kostet je nach Stundenlohn und Verarbeitungsgeschwindigkeit etwa $1,50–$3,00 an Personalzeit. KI-Extraktion kostet typischerweise $0,10–$0,25 pro Seite, ohne zusätzliche Kosten pro Feld. Für eine Schule, die jährlich 500 Anmeldesätze verarbeitet, beträgt der direkte Kostenvergleich $750–$1.500 (manuell) gegenüber $50–$125 (KI), bevor man die Zeitersparnis während der Spitzenzeit von August bis September, reduzierte Überstunden und die Beseitigung von Übertragungsfehlern berücksichtigt, die nachgelagerte Verwaltungsarbeit erzeugen. Der vollständige Leitfaden zur Extraktion von Schüleranmeldeformularen enthält einen detaillierten Kostenvergleich für verschiedene Anmeldevolumina.
Gilt FERPA, wenn wir nur nicht identifizierende Felder wie Klassenstufe oder Allergien extrahieren?
FERPA wird durch die Offenlegung des Dokuments selbst ausgelöst, nicht durch die spezifischen Felder, die Sie daraus extrahieren. Das Hochladen eines Anmeldeformulars in ein Drittanbieter-Tool – selbst wenn Sie nur „Klassenstufe" und „Allergien" extrahieren möchten – stellt eine Offenlegung des gesamten Bildungsdatensatzes dar. Das Dokument enthält den Namen des Schülers, das Geburtsdatum und andere Identifikatoren; diese sind in der an den Extraktionsanbieter übertragenen Datei vorhanden, unabhängig davon, welche Felder Sie ausgeben. Die Ausnahme für Schulbeamte gemäß § 99.31(a)(1) gilt für die Verarbeitungsbeziehung, nicht für einzelne Feldauswahlen. Eine konforme Einrichtung erfordert dieselbe schriftliche Vereinbarung, unabhängig davon, ob Sie ein Feld oder zwanzig extrahieren.
Anmeldeformulare für Studierende gehören zu den wenigen Dokumenttypen, bei denen gedruckter Text, Handschrift, Kontrollkästchen und Freitextnotizen auf derselben Seite koexistieren – und die Genauigkeit der KI-Extraktion variiert vorhersehbar je nachdem, welches dieser Formate jedes Feld verwendet.
Die praktische Erkenntnis für Anmeldebüros: Gedruckte Felder und Kontrollkästchen laufen mit 95–99 % Genauigkeit und benötigen nur minimale Prüfung; handschriftliche Telefonnummern und medizinische Notizen sind die 10–15 % der Felder, die einen Verifizierungsdurchlauf verdienen. Der verbleibende Wert ergibt sich aus der Stapelverarbeitung – die Umwandlung einer 20-stündigen manuellen Dateneingabewoche in eine 30-minütige KI-Extraktionssitzung mit Ergebnissen, die direkt Ihrem SIS-Importformat entsprechen.
Testen Sie es mit Ihrem eigenen Anmeldesatz. Sehen Sie, wo die Genauigkeit für Ihr spezifisches Formularlayout, die Handschriftstile der Eltern und das Volumen Ihrer Anmeldesaison liegt.
Kostenlos testbar, ohne Anmeldung. Dateien werden transient verarbeitet und nicht gespeichert. Fragen Sie nach einer FERPA-konformen institutionellen Vereinbarung für Ihren Bezirk oder Ihre Universität.