A IA consegue extrair formulários de
inscrição de alunos? Sim — veja a precisão por campo
Sim — os modelos modernos de visão computacional com IA conseguem extrair dados de formulários de inscrição de alunos com 95–99% de precisão em campos impressos, 85–95% em entradas manuscritas e mais de 95% em seleções de caixas de seleção, usando extração semântica de documentos que não exige um modelo para o layout exclusivo de cada escola. A precisão varia significativamente por tipo de campo — o número de telefone impresso de um responsável é quase garantido, enquanto uma anotação médica de texto livre escrita em cursiva pode precisar de revisão humana. Veja exatamente onde a tecnologia está hoje, onde ainda enfrenta dificuldades e o que o pico de inscrições de agosto a setembro significa para o seu fluxo de processamento.
A IA consegue extrair formulários de inscrição de alunos? Sim — veja a precisão por campoA IA consegue extrair formulários de inscrição de alunos? Sim — veja a precisão por campo
Principais conclusões
- A verdadeira questão sobre a extração de formulários de inscrição não é se a IA consegue ler caligrafia — é se uma escola que processa 400 pacotes em agosto pode arcar com 20 horas de entrada manual de dados quando cada dia de atraso adia a atribuição de turmas, o planejamento de rotas de ônibus e a inscrição no programa de almoço.
- Números de telefone manuscritos são o campo mais frágil em qualquer formulário de inscrição — ao contrário de um nome que as letras ao redor podem desambiguar, um dígito lido incorretamente entre dez torna todo o contato de emergência inutilizável, e 400 formulários significam 400 mãos diferentes escrevendo esses dez dígitos sem corretor automático para recorrer.
- O processamento em lote é onde está a eficiência real — 400 pacotes que levam 20 horas para uma equipe de entrada de dados são concluídos em 30 minutos de extração com IA, porque 85–90% dos campos passam com 95–99% de precisão e apenas números de telefone manuscritos e anotações médicas precisam de uma olhada humana.
Qualidade da Extração — Precisão Campo por Campo em um Formulário de Inscrição
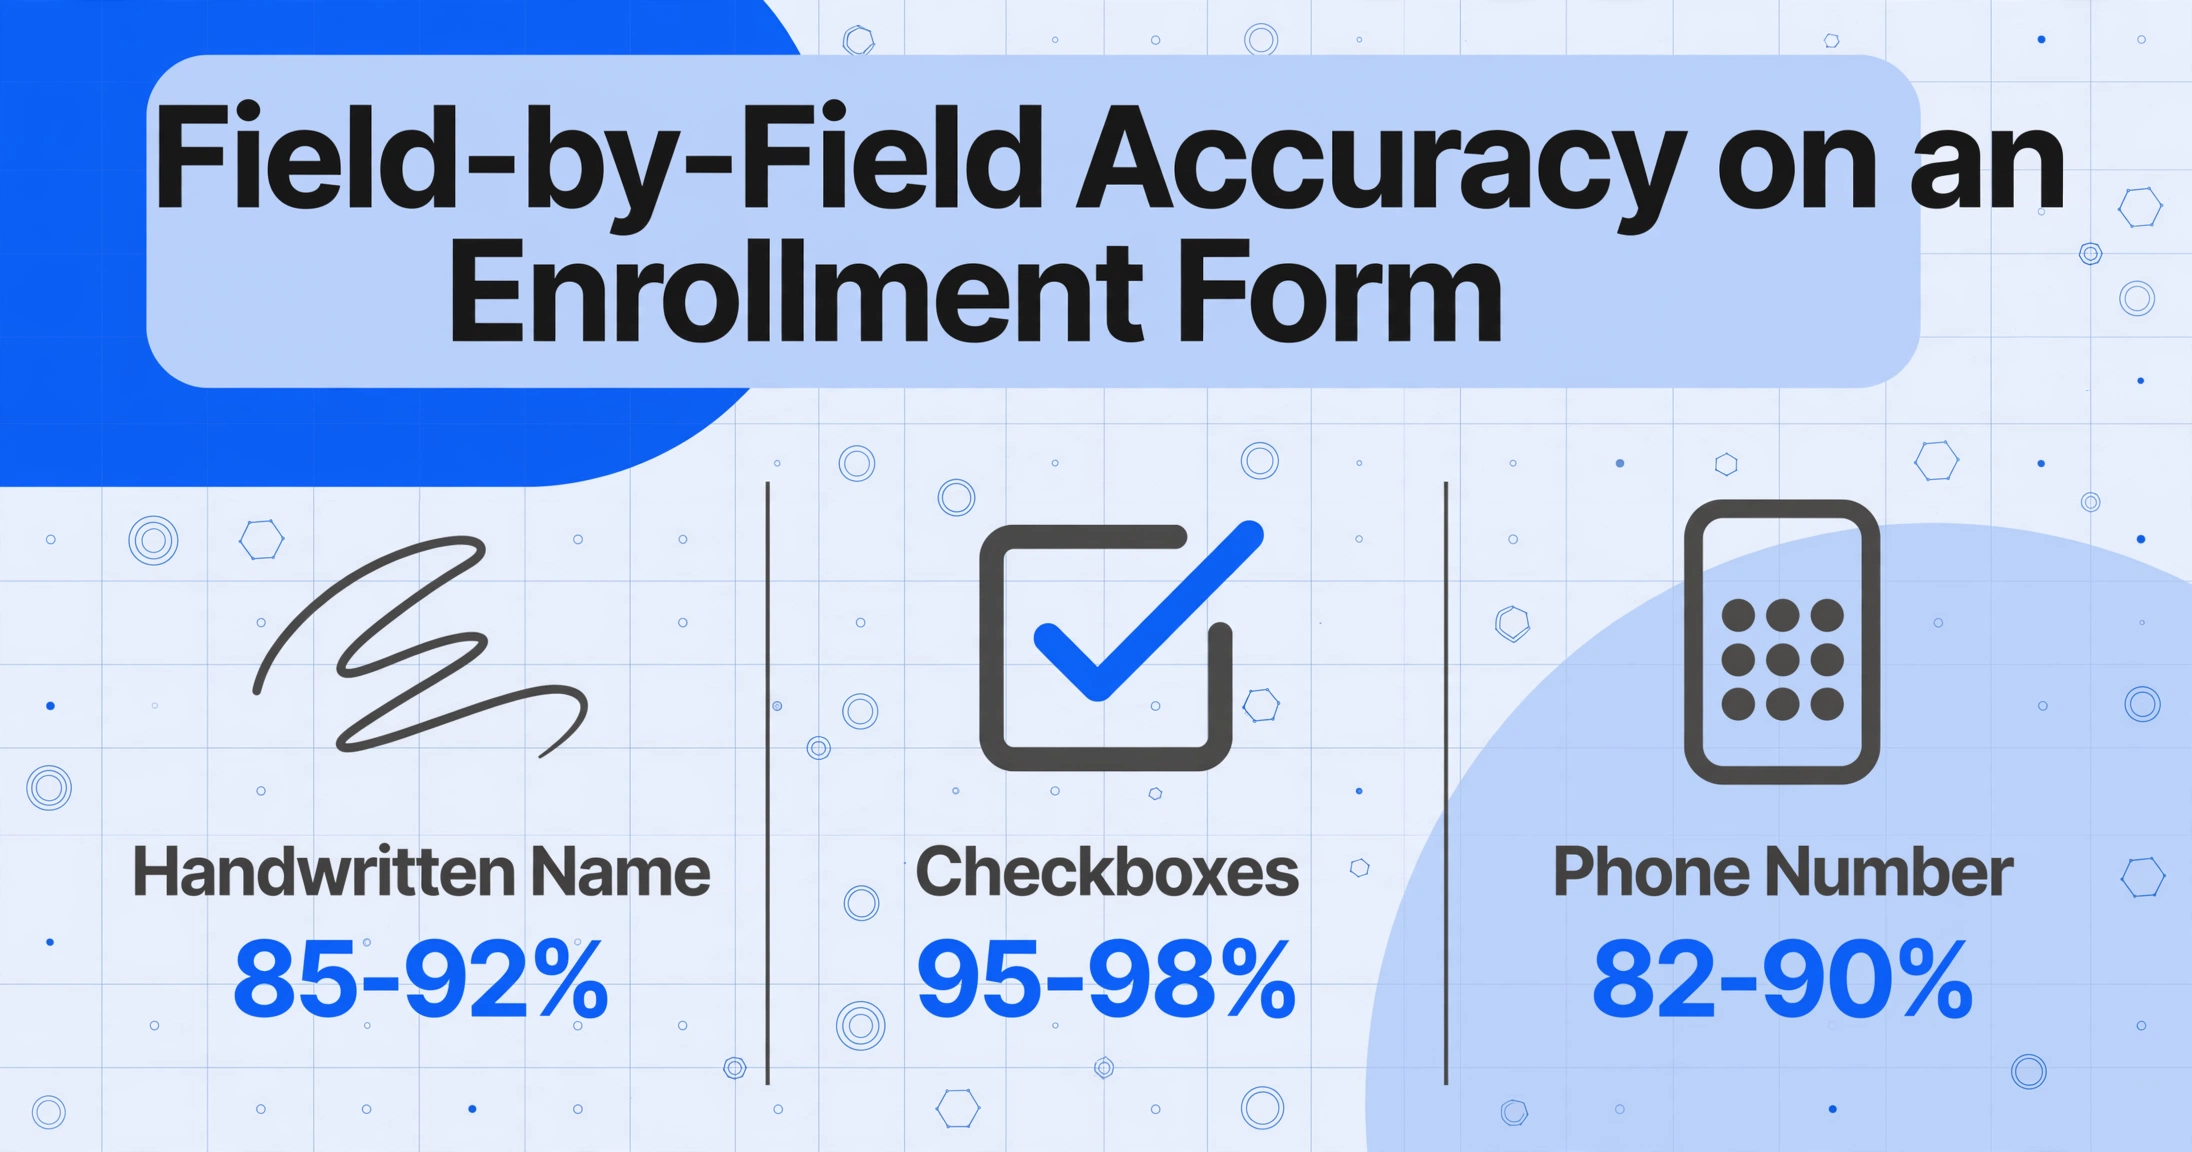
Os formulários de inscrição não representam um único problema de extração. Um pacote de inscrição típico de K-12 contém uma mistura de tipos de campos, cada um com um perfil de precisão diferente. A seguir, o que uma ferramenta moderna de extração por IA — que usa modelos de visão-linguagem em vez de OCR tradicional baseado em modelos — oferece nos campos mais comuns de formulários de inscrição.
| Tipo de Campo | Conteúdo Típico | Precisão Estimada da IA | Desafio Principal |
|---|---|---|---|
| Nome do aluno | Digitado ou escrito de forma legível | 97–99% | Raramente falha, a menos que a qualidade da digitalização seja deficiente |
| Nome do aluno (manuscrito) | Letra cursiva ou de imprenta, escrita pela criança ou pelos pais | 85–92% | A caligrafia das crianças varia muito; a legibilidade da primeira letra é fundamental |
| Data de nascimento | MM/DD/AAAA ou por extenso | 90–95% | Formatos de data ambíguos (MM/DD vs DD/MM) podem ser mal interpretados sem contexto |
| Nome do pai/mãe/tutor | Manuscrito pelo pai/mãe | 88–95% | A caligrafia cursiva de adultos é mais consistente que a das crianças, mas nomes pouco comuns podem confundir a inferência |
| Número de telefone dos pais | Dígitos manuscritos | 82–90% | Um único dígito mal lido torna o número inutilizável — os números de telefone não têm autocorreção |
| Endereço residencial | Rua, cidade, código postal manuscritos | 85–92% | Os números de rua e códigos postais têm muitos dígitos; a referência cruzada com bancos de dados de endereços ajuda |
| Informações de contato de emergência | Nome + telefone manuscritos | 83–90% | Mesma fragilidad dos números de telefone, agravada por sobrenomes menos comuns |
| Caixas de seleção (Sí/No) | ✓, ✗, círculo preenchido ou rabisco | 95–98% | Marcas ambíguas (um ponto de caneta perdido, um oval preenchido parcialmente) causam a maioria dos erros |
| Informações médicas / alergias | Parágrafo manuscrito de texto livre | 75–85% | A caligrafia cursiva, as abreviaturas e a terminologia médica criam o cenário de extração mais difícil |
| Nível de escolaridade (impresso ou circulado) | Opções pré-impresas ou manuscritas | 93–97% | As seleções circuladas podem se superponer com opções adjacentes |
| Cabeçalhos de formulários impressos (nome da escola, título do formulário) | Texto pré-impreso | 99% | Não há preocupação de precisão — este é o alvo de extração mais fácil |
Esses números pressupõem que o documento seja digitalizado ou fotografado com qualidade razoável — mínimo de 200 DPI, bom contraste, pouca interferência de vincos ou sombras. Se for uma foto de smartphone tirada com pouca luz, todas as estimativas caem de 5 a 10 pontos. O guia de conformidade com a FERPA aborda as considerações regulatórias que se aplicam no momento em que esses documentos entram em um pipeline de extração de terceiros, mas a questão operacional que a maioria dos escritórios de matrícula faz primeiro é a acima: campo por campo, o que realmente funciona?
A conclusão para escritórios de matrícula: Campos impressos e caixas de seleção estão praticamente resolvidos — espere 95–99% de precisão direta. Números de telefone manuscritos e anotações médicas de texto livre são os dois tipos de campo que mais comumente exigem uma revisão humana. Direcione seu esforço de verificação para esses campos específicos, não para o formulário inteiro.
Onde a IA se destaca em formulários de inscrição
Texto impresso padrão e cabeçalhos de formulário
Nome da escola, título do formulário, opções de série, instruções pré-impressas — qualquer texto que saiu de uma impressora ou do SIS da escola (PowerSchool, Infinite Campus ou Skyward) é o alvo de extração mais fácil. Os modelos de visão por IA lidam com isso com precisão quase perfeita, pois o texto é limpo, a fonte é padrão e o contraste entre tinta e papel costuma ser alto. Essa é a mesma capacidade que alimenta a OCR tradicional — mas sem exigir um modelo para o layout de cada escola, porque a extração semântica encontra o campo pelo significado, não pela coordenada de pixel.
Caixas de seleção e marcas de escolha
Formulários de inscrição são cheios de caixas de seleção: "Seu filho tem alergia a algum medicamento? ☐ Sim ☐ Não", "Indique a série: ☐ K ☐ 1 ☐ 2 ☐ 3". Os modelos modernos de IA são treinados para reconhecer uma ampla variedade de estilos de marcação — um visto, um X, um círculo preenchido, um rabisco dentro da caixa ou uma caixa colorida com lápis. A precisão é alta (95–98%) porque a decisão é binária: a caixa está marcada ou não, e o sinal visual é relativamente inequívoco em comparação com decifrar letras cursivas.
Os casos extremos que causam erros são previsíveis: um ponto de caneta perdido na caixa, um oval meio preenchido onde o responsável começou a marcar e parou, ou uma caixa marcada e depois riscada. Esses casos são raros — talvez 2–5% dos campos de caixa de seleção — mas quando ocorrem, um sinalizador de pontuação de confiança os captura para revisão humana, em vez de gerar silenciosamente o valor errado.
Processamento em lote na escala da temporada de inscrições
É aqui que a extração por IA se diferencia da entrada manual de dados de uma forma que não diz respeito à precisão, mas sim à produtividade. Uma escola que processa 400 pacotes de inscrição no início do ano letivo — cada um com 10 a 15 campos — enfrenta cerca de 4.000 a 6.000 pontos de dados individuais para inserir. A três minutos por formulário, isso representa 20 horas de entrada de dados. Uma ferramenta de IA que usa Processamento Prioritário em Lote — em que todos os arquivos são enviados simultaneamente e o sistema extrai dados de todos os formulários em paralelo — conclui o mesmo trabalho em 30 a 60 minutos de tempo real, com o resultado consolidado em uma única planilha.
O caso da Epic Charter Schools é instrutivo aqui. Uma das maiores escolas charter virtuais públicas dos EUA, a Epic processou mais de 15.000 registros de alunos em um único período de inscrição usando um sistema de IA que classificou mais de 65 tipos de documentos e alcançou 95% de precisão no primeiro ciclo. O processamento manual caiu de horas por aluno para segundos. O sistema foi projetado para o pico de inscrições — baseado em nuvem, escalável para mais de 1.000 alunos por dia e construído para lidar com o aumento de agosto a setembro sem contratar funcionários temporários de entrada de dados.
Para um passo a passo completo do fluxo de extração do formulário de inscrição do início ao fim — incluindo como configurar colunas personalizadas, lidar com casos extremos e validar resultados — consulte o guia completo para extração de formulários de inscrição de alunos.
Onde a IA Ainda Enfrenta Dificuldades — As Limitações Honestas
Números de telefone manuscritos
Os números de telefone são o campo mais frágil em um formulário de inscrição por um motivo simples: eles não têm redundância semântica. Um humano lendo "555-123-4567" consegue distinguir pelos formatos dos dígitos que o "5" é um "5" — mas se a caligrafia for ilegível e o primeiro dígito puder ser um "5" ou um "6", não há contexto de palavras para resolver a ambiguidade. Nomes podem ser inferidos a partir das letras ao redor; números de telefone não podem. O mesmo se aplica a CEPs, números de endereço e números de identificação de alunos.
A mitigação prática não é esperar 99% nesses campos. Reserve uma etapa de verificação para números de telefone e identificadores numéricos — seja uma revisão humana da coluna extraída ou uma validação baseada em regras (por exemplo, "este número de telefone tem exatamente 10 dígitos?"). A maioria das escolas já verifica números de telefone durante a entrada manual de qualquer forma; a IA simplesmente reduz o volume de campos que precisam dessa verificação em 85–90%.
Formulários de baixo contraste e fotocopiados
Formulários de inscrição são frequentemente fotocopiados — a escola imprime 300 cópias, os pais preenchem à mão e o escritório digitaliza os formulários preenchidos. Cada geração de fotocópia degrada o contraste. Na terceira ou quarta geração, o texto cinza sobre cinza de uma caixa de seleção preenchida a lápis pode ficar quase invisível tanto para o olho humano quanto para o modelo de IA. A solução é simples — digitalizar a 300 DPI em escala de cinza, não em preto e branco — mas, na prática, muitos escritórios escolares digitalizam em monocromático para economizar espaço no arquivo, perdendo o contraste sutil que separa uma marca de lápis leve do fundo do papel.
Marcas de caixa de seleção atípicas
Embora marcas de verificação e X padrão sejam bem tratadas, alguns estilos de marcação continuam desafiadores: um círculo desenhado ao redor de "Sim" em vez de uma marca na caixa, uma linha cortando a linha inteira ou uma marca de verificação que se estende muito além do limite da caixa de seleção. Esses são casos extremos, mas aparecem com frequência suficiente em pacotes de inscrição reais para que um pipeline de extração sinalize-os para revisão em vez de adivinhar.
Anotações médicas em texto livre e descrições de alergias
A seção "Informações Médicas" ou "Alergias" de um formulário de inscrição é o alvo de extração mais difícil. Os pais descrevem alergias em texto livre: "Penicilina — causa erupção cutânea. Também alérgico a gatos." A caligrafia pode variar de letra de forma legível a cursiva apressada. Abreviações são comuns ("PCN" para penicilina, "NKDA" para nenhuma alergia medicamentosa conhecida). E as consequências de uma leitura incorreta são maiores do que para um endereço errado — uma alergia não identificada pode afetar a segurança da criança.
Para campos médicos em texto livre, a abordagem recomendada é extração por IA com verificação humana: deixe a IA produzir uma primeira passagem, sinalize esses campos para revisão e tenha uma enfermeira escolar ou membro da equipe administrativa confirmando o texto extraído contra a digitalização. Essa abordagem híbrida entrega 90%+ da economia de tempo, preservando 100% de precisão para dados críticos de segurança.
Por que o Processamento em Lote é o Verdadeiro Divisor de Águas para a Temporada de Inscrição
As discussões sobre precisão tendem a dominar a conversação sobre "a IA pode fazer isso?", mas para os escritórios de inscrição, a questão mais impactante costuma ser sobre a capacidade de processamento. A janela de inscrição de agosto a setembro é uma restrição de calendário fixa: novas famílias se registram, famílias que retornam atualizam os contatos de emergência, e a escola precisa de dados limpos no SIS antes do início das aulas. Cada dia de atraso na entrada de dados atrasa a atribuição de classes, o planejamento de rotas de ônibus e a inscrição no programa de almoço.
A extração prioritária em lote — onde dezenas ou centenas de formulários de inscrição são enviados simultaneamente e processados em paralelo — aborda essa restrição diretamente. Em vez de uma equipe de entrada de dados trabalhando em uma pilha de formulários um de cada vez, a IA extrae todos os formulários simultáneamente e combina os resultados em uma única planilha. A planilha então é mapeada diretamente aos formatos de importação do SIS (CSV para PowerSchool, Excel para Skyward, JSON para integraciones personalizadas), eliminando a necessidade de entrada manual por formulário.
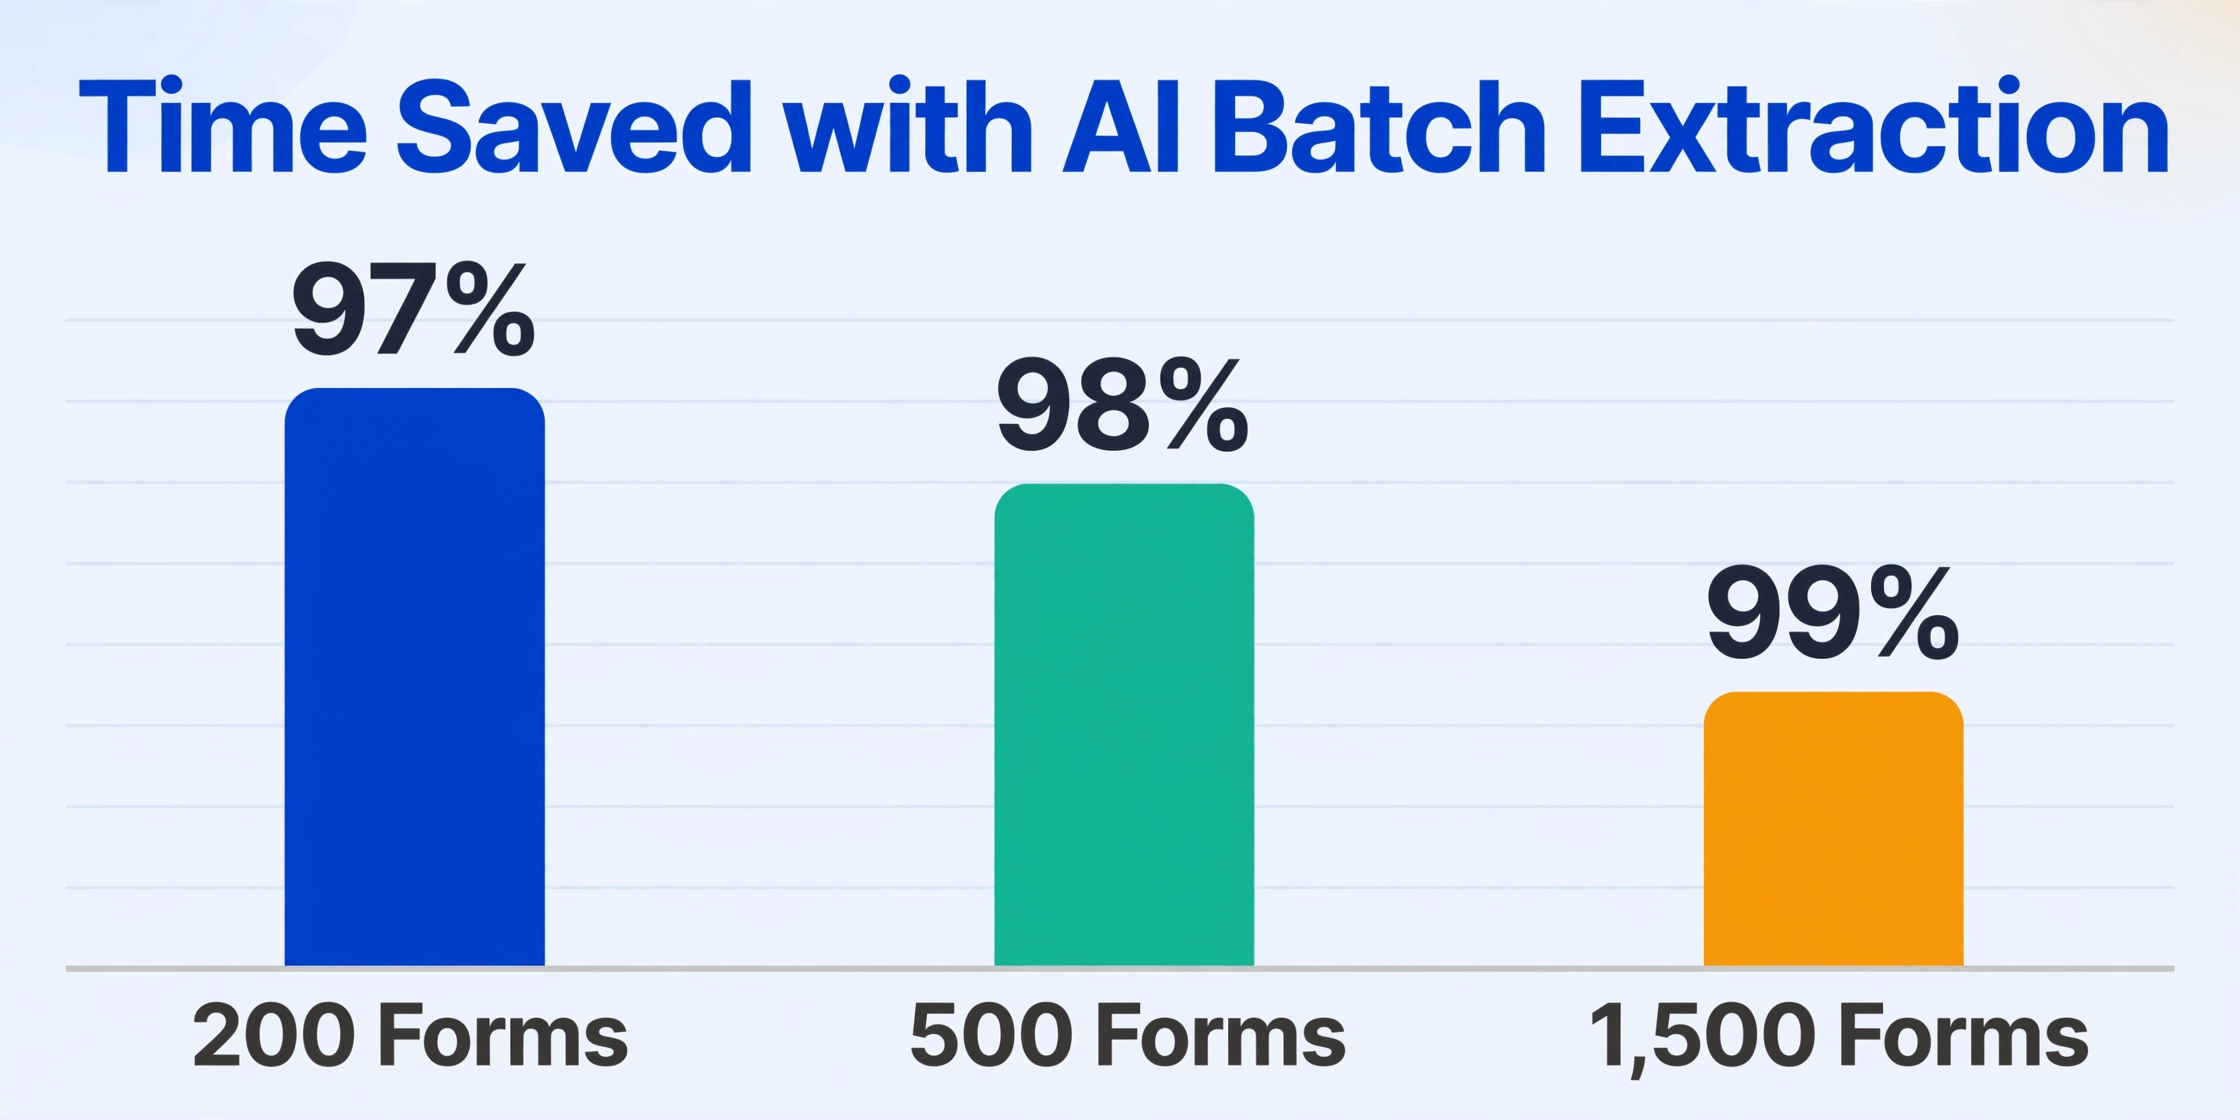
A tabela abaixo ilustra a diferença operacional em três volumes de inscrição comuns:
| Volume de Inscrição | Entrada Manual de Dados (3 min/formulário) | Extração em Lote por IA | Tempo Economizado |
|---|---|---|---|
| 200 formulários (escola primária pequena) | 10 horas | ~15 minutos | 97% |
| 500 formulários (K-8 de tamanho médio) | 25 horas | ~30 minutos | 98% |
| 1.500 formulários (distrito grande ou escola secundária) | 75 horas | ~60 minutos | 99% |
Estas economias de tempo assumem uma única passada de verificação em campos de baixa confianza — tipicamente 10–15% do total de campos — que adiciona aproximadamente 10–20% de volta ao tempo de processamento da IA. Mesmo com essa verificação, a economia de tempo neta excede 90% para qualquer lote maior que 50 formulários.
A estrutura que possibilita isso é a Extraction de Colunas Personalizadas: em vez de configurar um modelo para o layout específico de formulário de cada escola — que é o que as herramientas tradicionais de OCR exigem — você digita os nomes dos campos que deseja (Nome do Estudante, DOB, Contato dos Pais, Telefone de Emergencia, Alergias, Grado) e a IA localiza os dados correspondentes em cada formulário por compreensão semántica, independentemente de onde cada campo esteja na página. Uma única configuração maneja formulários de diferentes escolas, diferentes anos e diferentes exportações do SIS porque a IA lê conteúdo, não coordenadas.
Conformidade com FERPA — O que muda quando você usa IA para formulários de inscrição
Um formulário de inscrição contendo o nome legal completo do aluno, data de nascimento, endereço e informações de contato dos pais é um registro educacional conforme 34 CFR § 99.3 da Lei de Direitos Educacionais e Privacidade da Família. No momento em que esse formulário — seja digitalizado, fotografado ou enviado por e-mail como PDF — é carregado em uma ferramenta de extração de IA de terceiros, a instituição fez uma divulgação sob a FERPA § 99.30. Essa divulgação exige uma base legal e, para a maioria dos escritórios de inscrição, a base aplicável é a exceção de funcionário escolar sob § 99.31(a)(1)(i)(B).
O quadro regulatório completo é abordado no guia de extração de dados de alunos em conformidade com FERPA, mas três requisitos operacionais se aplicam diretamente ao processamento de formulários de inscrição:
- Acordo por escrito. O provedor de extração deve operar sob um contrato assinado que o designe como funcionário escolar, restrinja o uso dos dados apenas ao serviço de extração e proíba o treinamento de modelos em documentos de alunos. Termos de serviço aceitos por clique não satisfazem esse requisito — a orientação do PTAC distingue especificamente entre um contrato negociado e os termos padrão de um provedor.
- Arquitetura de processamento transitório. Os documentos devem ser retidos apenas durante a extração e excluídos dentro de um prazo definido. Um provedor que armazena formulários de inscrição concluídos indefinidamente — ou os usa para melhoria de modelos de IA — cria uma lacuna de conformidade entre a finalidade de processamento autorizada e a retenção real de dados.
- Registro de divulgações. Sob § 99.32(a), a instituição deve manter um registro de cada divulgação de PII de registros educacionais. Para extração em lote, isso significa registrar quais documentos foram processados, por qual provedor, em que data e sob qual autoridade contratual. A maioria das escolas não faz isso hoje — mas um fluxo de trabalho em conformidade exige.
A questão de conformidade para extração de formulários de inscrição não é teórica. Uma escola processando 200 pacotes de inscrição por meio de uma ferramenta de IA sem um acordo institucional assinado está fazendo 200 divulgações sem uma exceção válida da FERPA. A consequência prática provavelmente não é uma investigação imediata — mas se um pai solicitar o histórico de divulgações de seu filho sob § 99.32(a)(2), a escola deve fornecê-lo. Uma configuração em conformidade elimina esse risco completamente.
Perguntas Frequentes
A IA consegue distinguir entre campos manuscritos e impressos no mesmo formulário de inscrição?
Sim. Modelos modernos de visão e linguagem conseguem identificar se um campo contém texto impresso ou manuscrito e ajustar a estratégia de extração de acordo. Em formulários onde os pais preenchem alguns campos à mão e outros em letras de forma, a IA trata cada campo de forma independente. A diferença de precisão entre os dois no mesmo formulário é consistente com as estimativas mais amplas acima: campos impressos atingem 95–99%, campos manuscritos atingem 85–95%, dependendo da legibilidade.
Como vocês medem os números de precisão de 95–99% — em nível de caractere ou de campo?
Os números neste artigo referem-se à precisão em nível de campo — o percentual de campos onde o valor extraído é utilizável sem correção. A precisão em nível de campo é uma medida mais rigorosa do que a precisão em nível de caractere, que conta caracteres individuais. Um número de telefone com um dígito errado falha na precisão em nível de campo, mesmo que 9 de 10 dígitos estejam corretos. Para formulários de inscrição, o nível de campo é a métrica relevante, pois um dígito errado em um telefone ou endereço torna todo o campo não confiável.
A extração funciona em diferentes escolas que usam layouts diferentes de formulários de inscrição?
Sim — é aqui que a extração semântica difere fundamentalmente do OCR baseado em modelo. Uma ferramenta baseada em modelo precisa de uma configuração separada para o layout de cada escola: a Escola A coloca o campo "Nome do Pai/Mãe" no canto superior direito; a Escola B o coloca no meio da segunda página. Uma ferramenta de IA semântica não se importa com a posição — ela lê o rótulo "Nome do Pai/Responsável" (ou "Nome do Pai/Mãe", ou "Informações do Responsável") e extrai o valor preenchido ao lado. Uma única configuração atende 50 escolas com 50 layouts diferentes de formulários.
Existe um limite de quantos formulários de inscrição podem ser processados em um único lote?
O tamanho prático do lote depende da arquitetura da ferramenta. Sistemas de extração baseados em nuvem, projetados para processamento em lote, lidam com centenas de arquivos por lote sem degradação na precisão por formulário. A restrição de throughput não é a capacidade de processamento do modelo de IA, mas a largura de banda de upload e a etapa de verificação após a extração. Para a maioria dos escritórios escolares, um lote de 200–500 formulários conclui a extração em 15–30 minutos, com mais 30–60 minutos para revisão de campos de baixa confiança.
Os dados de inscrição extraídos podem ir diretamente para o PowerSchool ou nosso SIS?
Ferramentas de extração com IA geram dados estruturados em formatos padrão — CSV, Excel (XLSX) e JSON — que podem ser importados para qualquer SIS com recurso de importação de dados. PowerSchool, Infinite Campus, Skyward e Ellucian Banner suportam importação em massa de CSV para dados demográficos de alunos. A planilha extraída mapeia cada coluna para o campo correspondente do SIS; após a configuração inicial do mapeamento, os lotes subsequentes seguem o mesmo modelo. Isso elimina a etapa de digitar manualmente cada campo de um formulário em papel na interface do SIS.
O que acontece quando a caligrafia está completamente ilegível — até para um humano?
Se a caligrafia for tão ruim que um funcionário da escola não consiga lê-la, um modelo de IA também não conseguirá. Nesses casos — que representam talvez 1–3% dos formulários de inscrição — a ferramenta de extração deve sinalizar o campo como de baixa confiança e apresentar a imagem original digitalizada para revisão humana. A resposta correta não é adivinhar. Um fluxo de extração bem projetado trata campos ilegíveis como exceções e os encaminha para uma decisão humana, em vez de gerar silenciosamente um valor de baixa confiança que pode estar errado.
Como o custo da extração com IA se compara à entrada manual de dados para formulários de inscrição?
A entrada manual de dados para um formulário de inscrição típico de 15 campos custa aproximadamente $1,50–$3,00 em tempo de equipe, dependendo do salário por hora e da velocidade de processamento. A extração com IA normalmente custa $0,10–$0,25 por página, sem custo adicional por campo. Para uma escola que processa 500 pacotes de inscrição anualmente, a comparação de custo direto é $750–$1.500 versus $50–$125 (IA), antes de considerar a economia de tempo durante o pico de agosto a setembro, a redução de horas extras e a eliminação de erros de transcrição que geram trabalho administrativo downstream. O guia completo para extração de formulários de inscrição de alunos inclui uma comparação detalhada de custos em diferentes volumes de inscrição.
A FERPA se aplica se extrairmos apenas campos não identificadores, como série ou alergias?
O gatilho da FERPA é a divulgação do documento em si, não os campos específicos que você extrai dele. Enviar um formulário de inscrição para uma ferramenta de terceiros — mesmo que você pretenda extrair apenas "Série" e "Alergias" — constitui uma divulgação de todo o registro educacional. O documento contém o nome do aluno, data de nascimento e outros identificadores; esses dados estão presentes no arquivo transmitido ao provedor de extração, independentemente de quais campos você gera. A exceção do funcionário escolar sob § 99.31(a)(1) se aplica à relação de processamento, não às seleções individuais de campos. Uma configuração em conformidade exige o mesmo acordo por escrito, quer você extraia um campo ou vinte.
Os formulários de inscrição de alunos são um dos poucos tipos de documento em que texto impresso, escrita manual, caixas de seleção e anotações de texto livre coexistem na mesma página — e a precisão da extração por IA varia de forma previsível conforme o formato usado em cada campo.
A conclusão prática para escritórios de inscrição: campos impressos e caixas de seleção operam com 95–99% de precisão e exigem revisão mínima; números de telefone escritos à mão e anotações médicas são os 10–15% dos campos que merecem uma verificação. O valor restante vem do processamento em lote — transformar uma semana de 20 horas de entrada manual de dados em uma sessão de extração por IA de 30 minutos, com resultados que mapeiam diretamente para o formato de importação do seu SIS.
Teste com seu próprio pacote de inscrição. Veja onde a precisão se situa para o layout específico do seu formulário, os estilos de caligrafia dos pais e o volume da sua temporada de inscrições.
Grátis para testar, sem necessidade de cadastro. Os arquivos são processados de forma transitória e não são retidos. Consulte sobre um acordo institucional em conformidade com a FERPA para seu distrito ou universidade.