¿Puede la IA Extraer Formularios de
Inscripción de Estudiantes? Sí — Así es la Precisión por Campo
Sí — los modelos modernos de visión por IA pueden extraer datos de formularios de inscripción de estudiantes con una precisión del 95–99% en campos impresos, 85–95% en entradas manuscritas y más del 95% en selecciones de casillas, utilizando extracción semántica de documentos que no requiere una plantilla para el diseño único de cada escuela. La precisión varía significativamente según el tipo de campo — un número de teléfono impreso de un padre es casi garantizado, mientras que una nota médica manuscrita en cursiva puede necesitar revisión humana. Aquí está exactamente dónde está la tecnología hoy, dónde aún falla y qué significa el pico de inscripción de agosto a septiembre para su flujo de trabajo.
Conclusiones Clave
- La verdadera pregunta sobre la extracción de formularios de inscripción no es si la IA puede leer escritura a mano — es si una escuela que procesa 400 paquetes en agosto puede permitirse 20 horas de entrada manual de datos cuando cada día de retraso retrasa la asignación de clases, la planificación de rutas de autobús y la inscripción al programa de almuerzo.
- Los números de teléfono manuscritos son el campo más frágil en cualquier formulario de inscripción — a diferencia de un nombre que las letras circundantes pueden desambiguar, un dígito mal leído de diez hace que todo el contacto de emergencia sea inutilizable, y 400 formularios significan 400 manos diferentes escribiendo esos diez dígitos sin autocorrección de respaldo.
- El procesamiento por lotes es donde reside la verdadera eficiencia — 400 paquetes que toman a un equipo de entrada de datos 20 horas se completan en 30 minutos de extracción con IA, porque el 85-90% de los campos llegan con una precisión del 95-99% y solo los números de teléfono manuscritos y las notas médicas necesitan una revisión humana.
Qué tan bien funciona: precisión campo por campo en un formulario de inscripción
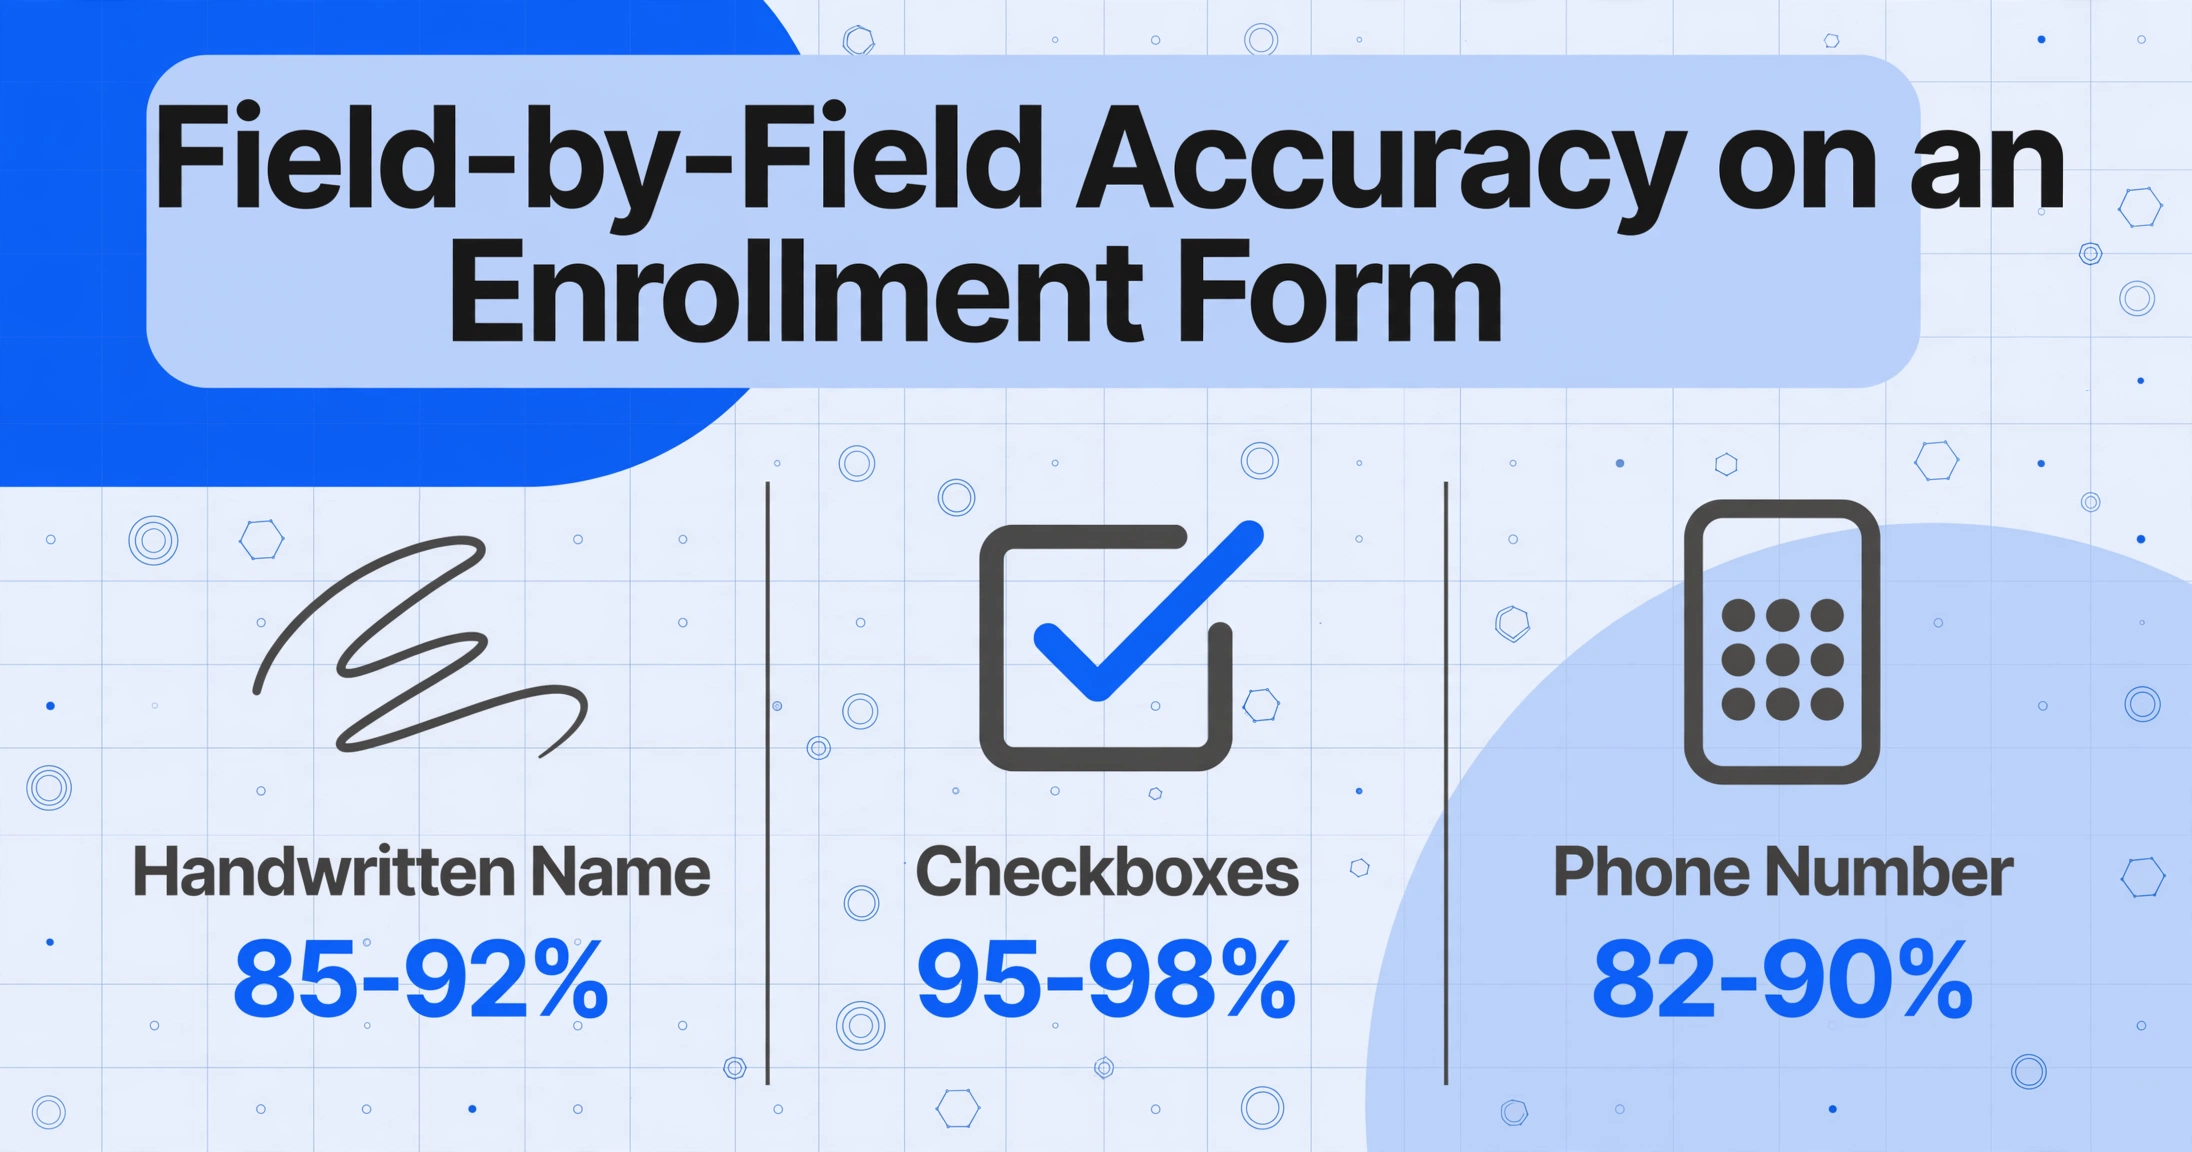
Los formularios de inscripción no son un único problema de extracción. Un paquete de inscripción típico de K-12 contiene una mezcla de tipos de campos, cada uno con un perfil de precisión diferente. A continuación se muestra lo que una herramienta moderna de extracción con IA —una que utiliza modelos de visión-lenguaje en lugar de OCR tradicional basado en plantillas— ofrece en los campos más comunes de los formularios de inscripción.
| Tipo de campo | Contenido típico | Precisión estimada de la IA | Desafío principal |
|---|---|---|---|
| Nombre del estudiante | Escrito a máquina o con letra clara | 97–99 % | Rara vez falla, salvo que la calidad del escaneo sea deficiente |
| Nombre del estudiante (manuscrito) | Letra cursiva o de molde escrita por el niño o el padre | 85–92 % | La letra de los niños varía mucho; la legibilidad de la primera letra es fundamental |
| Fecha de nacimiento | MM/DD/AAAA o escrita con palabras | 90–95 % | Los formatos de fecha ambiguos (MM/DD frente a DD/MM) pueden leerse mal sin contexto |
| Nombre del padre/tutor | Manuscrito por el padre | 88–95 % | La letra cursiva de los adultos es más consistente que la de los niños, pero los nombres poco comunes pueden confundir a la inferencia |
| Número de teléfono del padre | Dígitos manuscritos | 82–90 % | Un solo dígito mal leído hace que el número sea inutilizable: los números de teléfono no tienen autocorrección |
| Dirección de casa | Calle, ciudad y código postal manuscritos | 85–92 % | Los números de calle y los códigos postales tienen muchos dígitos; la verificación cruzada con bases de datos de direcciones ayuda |
| Información de contacto de emergencia | Nombre + teléfono manuscritos | 83–90 % | La misma fragilidad de los números de teléfono, agravada por apellidos menos comunes |
| Casillas de verificación (Sí/No) | ✓, ✗, círculo relleno o garabato | 95–98 % | Las marcas ambiguas (un punto de bolígrafo suelto, un óvalo medio relleno) causan la mayoría de los errores |
| Información médica / alergias | Párrafo manuscrito de texto libre | 75–85 % | La letra cursiva, las abreviaturas y la terminología médica crean el escenario de extracción más difícil |
| Nivel de grado (impreso o marcado con un círculo) | Opciones preimpresas o manuscritas | 93–97 % | Las selecciones marcadas con un círculo pueden superponerse a las opciones adyacentes |
| Encabezados de formularios impresos (nombre de la escuela, título del formulario) | Texto preimpreso | 99 % | Sin problemas de precisión: este es el objetivo de extracción más fácil |
Estas cifras suponen que el documento se escanea o fotografía con una calidad razonable: 200 DPI como mínimo, buen contraste y una interferencia mínima de pliegues o sombras. Si se usa una foto de teléfono inteligente tomada con poca luz, cada estimación baja de 5 a 10 puntos. La guía de cumplimiento de FERPA cubre las consideraciones regulatorias que aplican en el momento en que estos documentos entran en un flujo de extracción de terceros, pero la pregunta operativa que la mayoría de las oficinas de inscripción plantean primero es la anterior: campo por campo, ¿qué funciona realmente?
La conclusión para las oficinas de inscripción: Los campos impresos y las casillas de verificación están prácticamente resueltos: espere una precisión directa del 95–99%. Los números de teléfono escritos a mano y las notas médicas de texto libre son los dos tipos de campo que con mayor frecuencia requieren una revisión humana. Centre su esfuerzo de verificación en esos campos específicos, no en todo el formulario.
Dónde sobresale la IA en los formularios de inscripción
Texto impreso estándar y encabezados de formulario
Nombre de la escuela, título del formulario, opciones de grado, instrucciones preimpresas: cualquier texto que salió de una impresora o del SIS de una escuela (PowerSchool, Infinite Campus o Skyward) es el objetivo de extracción más fácil. Los modelos de visión de IA manejan estos casos con una precisión casi perfecta porque el texto es limpio, la fuente es estándar y el contraste entre la tinta y el papel suele ser alto. Esta es la misma capacidad que impulsa la OCR tradicional, pero sin necesidad de una plantilla por diseño de escuela, porque la extracción semántica encuentra el campo por significado, no por coordenadas de píxeles.
Casillas de verificación y marcas de selección
Los formularios de inscripción están llenos de casillas: «¿Su hijo es alérgico a algún medicamento? ☐ Sí ☐ No», «Indique el grado: ☐ K ☐ 1 ☐ 2 ☐ 3». Los modelos de IA modernos están entrenados para reconocer una amplia variedad de estilos de marcado: una marca de verificación, una X, un círculo relleno, un garabato dentro de la casilla o una casilla coloreada con lápiz. La precisión es alta (95–98%) porque la decisión es binaria: la casilla está marcada o no, y la señal visual es relativamente inequívoca en comparación con descifrar letras cursivas.
Los casos límite que causan errores son predecibles: un punto de bolígrafo accidental en la casilla, un óvalo a medio rellenar donde el padre comenzó a marcar y se detuvo, o una casilla marcada y luego tachada. Estos son poco frecuentes (quizás del 2–5% de los campos de casillas), pero cuando ocurren, una marca de puntuación de confianza los detecta para revisión humana en lugar de generar silenciosamente el valor incorrecto.
Procesamiento por lotes a escala de temporada de inscripción
Aquí es donde la extracción con IA se diferencia del ingreso manual de datos, no en términos de precisión sino de rendimiento. Una escuela que procesa 400 paquetes de inscripción al inicio del año escolar — cada uno con 10 a 15 campos — enfrenta aproximadamente 4,000 a 6,000 puntos de datos individuales para ingresar. A tres minutos por formulario, eso equivale a 20 horas de ingreso de datos. Una herramienta de IA que utiliza Procesamiento por lotes prioritario — donde todos los archivos se suben simultáneamente y el sistema extrae datos de cada formulario en paralelo — completa el mismo trabajo en 30 a 60 minutos de tiempo real, con los resultados consolidados en una sola hoja de cálculo.
El caso de Epic Charter Schools es ilustrativo aquí. Una de las escuelas chárter virtuales públicas más grandes de EE. UU., Epic procesó más de 15,000 registros de estudiantes en un solo período de inscripción utilizando un sistema de IA que clasificó más de 65 tipos de documentos y logró un 95% de precisión en su primer ciclo. El procesamiento manual pasó de horas por estudiante a segundos. El sistema fue diseñado para el pico de inscripción — basado en la nube, escalable a más de 1,000 estudiantes por día, y creado para manejar el aumento de agosto a septiembre sin contratar personal temporal de ingreso de datos.
Para un recorrido completo del flujo de extracción de formularios de inscripción de principio a fin — incluyendo cómo configurar columnas personalizadas, manejar casos límite y validar resultados — consulte la guía completa para la extracción de formularios de inscripción de estudiantes.
Donde la IA Aún Tiene Dificultades — Las Limitaciones Honestas
Números de teléfono escritos a mano
Los números de teléfono son el campo más frágil en un formulario de inscripción por una razón simple: no tienen redundancia semántica. Una persona que lee "555-123-4567" puede distinguir por la forma de los dígitos que el "5" es un "5" — pero si la letra es descuidada y el primer dígito podría ser un "5" o un "6," no hay contexto de palabras para resolver la ambigüedad. Los nombres pueden inferirse de las letras circundantes; los números de teléfono no. Lo mismo aplica a los códigos postales, números de calle y números de identificación de estudiantes.
La mitigación práctica no es esperar un 99% en estos campos. Presupueste una pasada de verificación para números de teléfono e identificadores numéricos — ya sea una revisión humana rápida de la columna extraída o una validación basada en reglas (por ejemplo, "¿este número de teléfono tiene exactamente 10 dígitos?"). La mayoría de las escuelas ya verifican los números de teléfono durante el ingreso manual de todos modos; la IA simplemente reduce el volumen de campos que necesitan esa verificación en un 85–90%.
Formularios de bajo contraste y fotocopiados
Los formularios de inscripción se fotocopian con frecuencia: la escuela imprime 300 copias, los padres las llenan a mano y la oficina escanea los formularios completados. Cada generación de fotocopiado degrada el contraste. Para la tercera o cuarta generación, el texto gris sobre gris de una casilla marcada con lápiz puede ser casi invisible tanto para el ojo humano como para el modelo de IA. La solución es sencilla: escanear a 300 DPI en escala de grises, no en blanco y negro, pero en la práctica, muchas oficinas escolares escanean en monocromo para ahorrar tamaño de archivo, perdiendo el contraste sutil que separa una marca de lápiz clara del fondo del papel.
Marcas de casillas atípicas
Aunque las marcas de verificación y las equis estándar se manejan bien, algunos estilos de marcado siguen siendo difíciles: un círculo alrededor de "Sí" en lugar de una marca en la casilla, una línea que tacha toda la fila, o una marca de verificación que se extiende mucho más allá del límite de la casilla. Estos son casos excepcionales, pero aparecen con la frecuencia suficiente en los paquetes de inscripción reales como para que un flujo de extracción los señale para revisión en lugar de adivinar.
Notas médicas de texto libre y descripciones de alergias
La sección de "Información médica" o "Alergias" de un formulario de inscripción es el objetivo de extracción más difícil. Los padres describen las alergias en texto libre: "Penicilina: causa sarpullido. También alérgico a los gatos". La caligrafía puede variar desde letra clara hasta cursiva apresurada. Las abreviaturas son comunes ("PCN" para penicilina, "NKDA" para sin alergias medicamentosas conocidas). Y las consecuencias de una lectura errónea son mayores que las de una dirección mal leída: una alergia pasada por alto podría afectar la seguridad del niño.
Para los campos médicos de texto libre, el enfoque recomendado es la extracción con IA y verificación humana: dejar que la IA produzca un primer borrador, señalar estos campos para revisión y hacer que una enfermera escolar o un miembro del personal administrativo confirme el texto extraído contra el escaneo. Este enfoque híbrido ofrece más del 90% del ahorro de tiempo mientras preserva el 100% de precisión para los datos críticos de seguridad.
Por qué el procesamiento por lotes es el verdadero cambio de juego para la temporada de inscripción
Las discusiones sobre precisión tienden a dominar la conversación sobre "¿puede la IA hacer esto?", pero para las oficinas de inscripción, la pregunta más impactante suele ser sobre el rendimiento. La ventana de inscripción de agosto a septiembre es una restricción de calendario fija: las familias nuevas se registran, las familias existentes actualizan los contactos de emergencia, y la escuela necesita datos limpios en el SIS antes de que comiencen las clases. Cada día de retraso en la entrada de datos retrasa las asignaciones de clases, la planificación de rutas de autobús y la inscripción en el programa de almuerzos.
La extracción por lotes prioritario — donde docenas o cientos de formularios de inscripción se suben simultáneamente y se procesan en paralelo — aborda esta restricción directamente. En lugar de que un equipo de entrada de datos trabaje con una pila de formularios uno a la vez, la IA extrae cada formulario de forma concurrente y fusiona los resultados en una sola hoja de cálculo. La hoja de cálculo luego se asigna directamente a los formatos de importación del SIS (CSV para PowerSchool, Excel para Skyward, JSON para integraciones personalizadas), eliminando la necesidad de entrada manual por formulario.
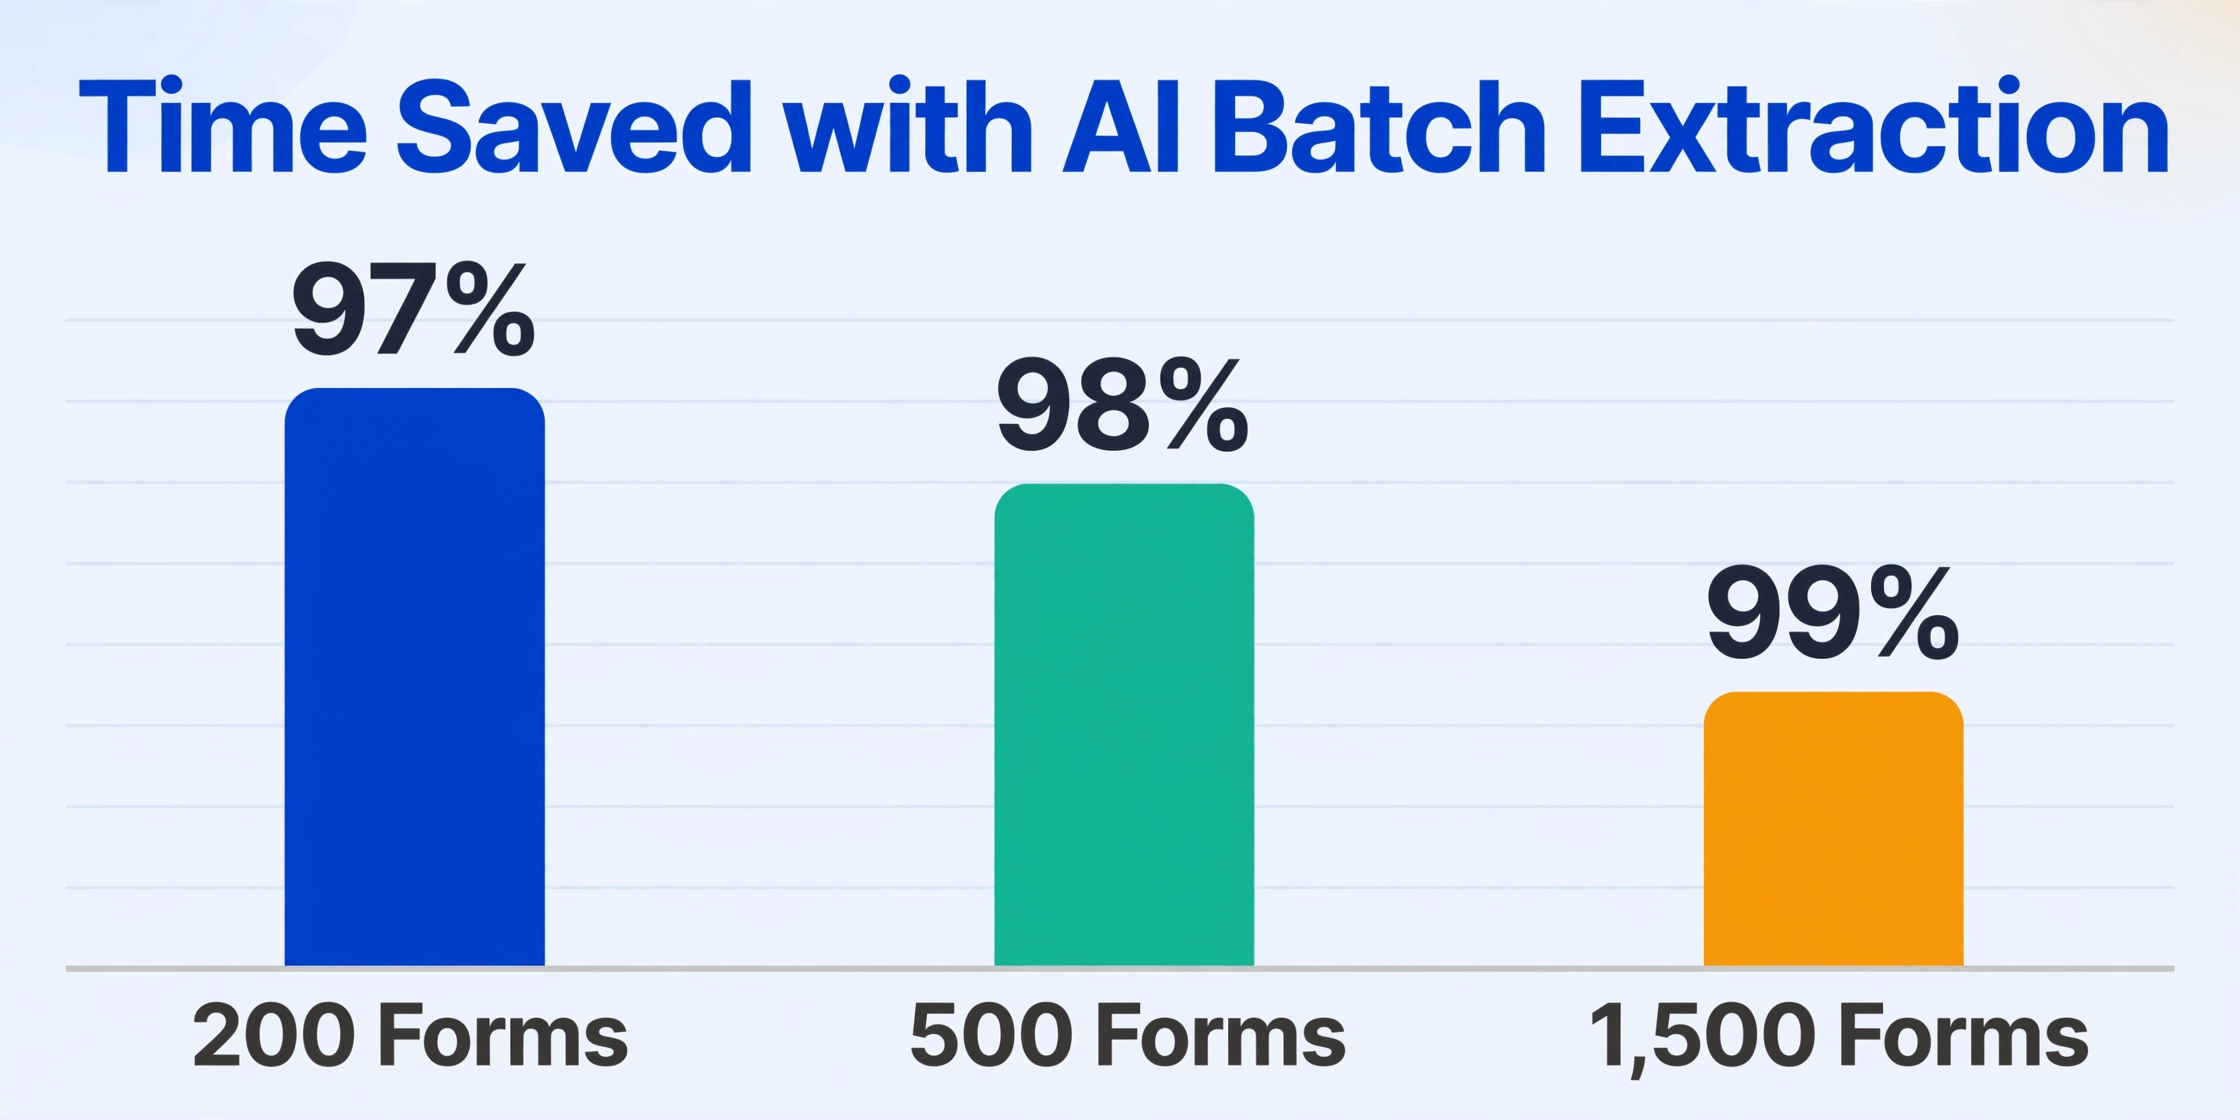
La tabla siguiente ilustra la diferencia operativa en tres volúmenes comunes de inscripción:
| Volumen de inscripción | Entrada manual de datos (3 min/formulario) | Extracción por lotes con IA | Tiempo ahorrado |
|---|---|---|---|
| 200 formularios (escuela primaria pequeña) | 10 horas | ~15 minutos | 97% |
| 500 formularios (K-8 de tamaño mediano) | 25 horas | ~30 minutos | 98% |
| 1,500 formularios (distrito grande o escuela secundaria) | 75 horas | ~60 minutos | 99% |
Estos ahorros de tiempo asumen una sola pasada de verificación en campos de baja confianza — típicamente el 10–15% del total de campos — lo que añade aproximadamente un 10–20% al tiempo de procesamiento de la IA. Incluso con esa verificación, el ahorro neto de tiempo supera el 90% para cualquier lote mayor de 50 formularios.
La estructura que permite esto es la Extracción de Columnas Personalizadas: en lugar de configurar una plantilla para el diseño de formulario específico de cada escuela — que es lo que requieren las herramientas OCR tradicionales — usted escribe los nombres de los campos que desea (Nombre del estudiante, FDN, Contacto de los padres, Teléfono de emergencia, Alergias, Grado) y la IA localiza los datos correspondientes en cada formulario mediante comprensión semántica, sin importar dónde se encuentre cada campo en la página. Una sola configuración maneja formularios de diferentes escuelas, diferentes años y diferentes exportaciones del SIS porque la IA lee contenido, no coordenadas.
Cumplimiento de FERPA: qué cambia al usar IA para formularios de inscripción
Un formulario de inscripción que contiene el nombre legal completo del estudiante, la fecha de nacimiento, la dirección y la información de contacto de los padres es un expediente educativo según 34 CFR § 99.3 de la Ley de Derechos Educativos y Privacidad de la Familia. En el momento en que ese formulario —ya sea escaneado, fotografiado o enviado por correo electrónico como PDF— se sube a una herramienta de extracción de IA de terceros, la institución ha realizado una divulgación según FERPA § 99.30. Esa divulgación requiere una base legal y, para la mayoría de las oficinas de inscripción, la base aplicable es la excepción de funcionario escolar según § 99.31(a)(1)(i)(B).
El marco regulatorio completo se cubre en la guía de extracción de datos de estudiantes conforme a FERPA, pero tres requisitos operativos se aplican directamente al procesamiento de formularios de inscripción:
- Acuerdo por escrito. El proveedor de extracción debe operar bajo un contrato firmado que lo designe como funcionario escolar, restrinja el uso de los datos únicamente al servicio de extracción y prohíba el entrenamiento de modelos con documentos de estudiantes. Los términos de servicio de clic para aceptar no cumplen este requisito: la guía de PTAC distingue específicamente entre un contrato negociado y los términos estándar de un proveedor.
- Arquitectura de procesamiento transitorio. Los documentos deben conservarse solo durante la duración de la extracción y eliminarse dentro de un período definido. Un proveedor que almacena formularios de inscripción completados indefinidamente —o los utiliza para mejorar modelos de IA— crea una brecha de cumplimiento entre el propósito de procesamiento autorizado y la retención real de datos.
- Registro de divulgaciones. Según § 99.32(a), la institución debe mantener un registro de cada divulgación de PII de expedientes educativos. Para la extracción por lotes, esto implica registrar qué documentos se procesaron, con qué proveedor, en qué fecha y bajo qué autoridad contractual. La mayoría de las escuelas no hacen esto hoy — pero un flujo de trabajo conforme lo requiere.
La cuestión de cumplimiento para la extracción de formularios de inscripción no es teórica. Una escuela que procesa 200 paquetes de inscripción mediante una herramienta de IA sin un acuerdo institucional firmado está realizando 200 divulgaciones sin una excepción válida de FERPA. La consecuencia práctica probablemente no sea una investigación inmediata — pero si un padre solicita el historial de divulgaciones de su hijo según § 99.32(a)(2), la escuela debe producirlo. Una configuración conforme elimina ese riesgo por completo.
Preguntas Frecuentes
¿Puede la IA distinguir entre campos escritos a mano y campos impresos en el mismo formulario de inscripción?
Sí. Los modelos modernos de visión-lenguaje pueden identificar si un campo contiene texto escrito a mano o impreso y ajustar la estrategia de extracción en consecuencia. En formularios donde los padres completan algunos campos a mano y otros en letras de molde impresas, la IA trata cada campo de forma independiente. La diferencia de precisión entre ambos en el mismo formulario es consistente con las estimaciones generales anteriores: los campos impresos alcanzan 95–99%, los campos escritos a mano alcanzan 85–95% dependiendo de la legibilidad.
¿Cómo se miden los números de precisión del 95–99% — a nivel de carácter o a nivel de campo?
Los números en este artículo son precisión a nivel de campo — el porcentaje de campos donde el valor extraído es utilizable sin corrección. La precisión a nivel de campo es una medida más estricta que la precisión a nivel de carácter, que cuenta caracteres individuales. Un número de teléfono con un dígito incorrecto falla la precisión a nivel de campo incluso si 9 de 10 dígitos son correctos. Para formularios de inscripción, el nivel de campo es la métrica relevante porque un dígito incorrecto en un número de teléfono o una dirección hace que todo el campo no sea confiable.
¿Funciona la extracción en diferentes escuelas que usan diferentes diseños de formularios de inscripción?
Sí — aquí es donde la extracción semántica difiere fundamentalmente del OCR basado en plantillas. Una herramienta basada en plantillas necesita una configuración separada para el diseño de formulario de cada escuela: la Escuela A coloca el campo "Nombre del Padre" en la esquina superior derecha; la Escuela B lo coloca en el medio de la página dos. Una herramienta de IA semántica no le importa la posición — lee la etiqueta "Nombre del Padre/Tutor" (o "Nombre del Padre," o "Información del Tutor") y extrae el valor completado junto a ella. Una configuración maneja 50 escuelas con 50 diseños de formularios diferentes.
¿Existe un límite en la cantidad de formularios de inscripción que se pueden procesar en un solo lote?
El tamaño práctico del lote depende de la arquitectura de la herramienta. Los sistemas de extracción basados en la nube, diseñados para el procesamiento por lotes, manejan cientos de archivos por lote sin degradación en la precisión por formulario. La limitación no es la capacidad de procesamiento del modelo de IA, sino el ancho de banda de carga y el paso de verificación posterior a la extracción. Para la mayoría de las oficinas escolares, un lote de 200 a 500 formularios completa la extracción en 15 a 30 minutos, con 30 a 60 minutos adicionales para revisar los campos de baja confianza.
¿Pueden los datos de inscripción extraídos ir directamente a PowerSchool o a nuestro SIS?
Las herramientas de extracción con IA generan datos estructurados en formatos estándar — CSV, Excel (XLSX) y JSON — que se pueden importar a cualquier SIS con función de importación de datos. PowerSchool, Infinite Campus, Skyward y Ellucian Banner admiten la importación masiva de CSV para datos demográficos de estudiantes. La hoja de cálculo extraída asigna cada columna al campo correspondiente del SIS; después de una configuración inicial de asignación, los lotes posteriores siguen la misma plantilla. Esto elimina el paso de escribir manualmente cada campo de un formulario en papel en la interfaz del SIS.
¿Qué sucede cuando la escritura es completamente ilegible, incluso para un humano?
Si la escritura es tan deficiente que un miembro del personal escolar no puede leerla, un modelo de IA tampoco podrá leerla. En estos casos — que representan quizás el 1–3% de los formularios de inscripción — la herramienta de extracción debe marcar el campo como de baja confianza y presentar la imagen escaneada original para revisión humana. La respuesta correcta no es adivinar. Un flujo de extracción bien diseñado trata los campos ilegibles como excepciones y los deriva a una decisión humana, en lugar de generar silenciosamente un valor de baja confianza que podría ser incorrecto.
¿Cómo se compara el costo de la extracción con IA frente a la entrada manual de datos para formularios de inscripción?
La entrada manual de datos para un formulario de inscripción típico de 15 campos cuesta aproximadamente $1.50–$3.00 en tiempo de personal, según el salario por hora y la velocidad de procesamiento. La extracción con IA suele costar $0.10–$0.25 por página, sin recargos por campo. Para una escuela que procesa 500 paquetes de inscripción al año, la comparación de costos directos es de $750–$1,500 frente a $50–$125 (IA), sin contar el ahorro de tiempo durante el pico de agosto a septiembre, la reducción de horas extra y la eliminación de errores de transcripción que generan trabajo administrativo adicional. La guía completa para la extracción de formularios de inscripción de estudiantes incluye una comparación detallada de costos según diferentes volúmenes de inscripción.
¿Aplica FERPA si solo extraemos campos no identificativos como el nivel de grado o las alergias?
El desencadenante de FERPA es la divulgación del documento en sí, no los campos específicos que usted extrae de él. Subir un formulario de inscripción a una herramienta de terceros — incluso si solo tiene la intención de extraer "Nivel de Grado" y "Alergias" — constituye una divulgación de todo el registro educativo. El documento contiene el nombre del estudiante, la fecha de nacimiento y otros identificadores; esos datos están presentes en el archivo transmitido al proveedor de extracción, independientemente de los campos que usted genere. La excepción de funcionario escolar según § 99.31(a)(1) se aplica a la relación de procesamiento, no a selecciones de campos individuales. Una configuración conforme requiere el mismo acuerdo por escrito ya sea que extraiga un campo o veinte.
Los formularios de inscripción de estudiantes son uno de los pocos tipos de documentos donde el texto impreso, la escritura a mano, las casillas de verificación y las notas de texto libre coexisten en la misma página — y la precisión de la extracción con IA varía de forma predecible según cuál de esos formatos use cada campo.
La conclusión práctica para las oficinas de inscripción: los campos impresos y las casillas de verificación funcionan al 95–99% y requieren una revisión mínima; los números de teléfono escritos a mano y las notas médicas son el 10–15% de los campos que merecen una pasada de verificación. El valor restante proviene del procesamiento por lotes — convertir una semana de entrada manual de datos de 20 horas en una sesión de extracción con IA de 30 minutos con resultados que se asignan directamente a su formato de importación de SIS.
Pruébelo con su propio paquete de inscripción. Vea dónde aterriza la precisión para el diseño de su formulario específico, los estilos de escritura a mano de los padres y el volumen de su temporada de inscripción.
Gratis para probar, sin registro. Los archivos se procesan de forma transitoria y no se conservan. Consulte sobre un acuerdo institucional compatible con FERPA para su distrito o universidad.