複数商品のAmazon注文スクリーンショットは
乱雑に見える — それでもクリーンなデータを取得できる理由
1回のAmazon注文で7つの商品を購入したとします。レシートページには、それぞれが細いグレーの線で区切られた、密集した商品ブロックが表示されます。一部の商品名は省略記号で途切れています。いくつかの商品の下には「販売元」と表示され、次の行に属さない余分なテキストが追加されています。全体として、自動抽出の試みを妨害するように設計されたかのように見えます。
重要なポイント
- グレーの区切り線の後ろに積み重なった7つのAmazon商品は、データ入力の手間のように見えます — しかし、ページを混沌と見せるすべてのグレーの線、省略された名前、販売者バッジは、視覚AIに1文字も読む前の完全な行マップを提供します。
- 従来のOCRは、グレーの線を文書の境界として扱うため、各線でページを分割します。しかし、視覚言語モデルはスクリーンショット全体を一度に認識し、レシートのミシン目と同じようにそれらの線を使用します — 商品を数えるためであり、切り離すためではありません。
- Amazonの注文スクリーンショットが密集しているほど、抽出はより速く、より正確になります — 視覚的な乱雑さは視覚AIにとってノイズではなく、ページレイアウトを完全に明確にする、無料の構造的ランドマークの余剰です。
複数商品のAmazonスクリーンショットが一見して絶望的に見える理由
この種のスクリーンショットが自動解析不可能に見える具体的な理由を挙げてみましょう。これらは曖昧な問題ではなく、それぞれが従来の抽出方法がつまずく具体的な障害です。
グレーの区切り線。Amazonは注文サマリーページの各商品行の間に細いグレーの水平線を引いています。テキスト領域を検出して意味のあるグループに組み立てる従来のOCRエンジンにとって、これらの線は境界線のように見えます。各商品を独立したテキストゾーンとして扱うため、分割されたゾーン同士の関連性を推測しなければなりません。ゾーン2の右端にある価格はゾーン2のものか、ゾーン3のものか。OCRにはそれを判断する方法がありません。
省略された商品名。「Logitech G502 X PLUS LIGHTSPEED Wireless Gaming Mouse with HERO 25K Sensor...」— しかしスクリーンショットには「Logitech G502 X PLUS LIGHTSP...」と省略記号付きで表示されています。この省略されたテキストは、完全な行を左から右に読むことに依存するシステムを混乱させます。行ベースのパーサーは省略された名前を見て、単語の途中で行が途切れているため、次の列がどこから始まるのか判断できません。
第三者販売者のバッジ。Amazonが直接販売していない商品には、商品名の下に小さなフォントで「販売元: [販売者名]」と表示されます。このテキストは2つの商品行の間にありますが、前の行に属しており、次の行には属しません。単純な抽出ではこれを別の行として扱うか、さらに悪いことに次の商品のデータに追加してしまいます。どちらにせよ、出力は間違ったものになります。
数量と価格の配置。Amazonの注文ページでは、数量は商品名の横に「数量: 1」と表示され、価格は右端に配置されています。従来のOCRは価格を右余白に浮かぶ独立した数字として抽出し、どの商品に属するかを推測しなければなりません。7つの価格と7つの商品名が同じ視覚フィールドに散らばっている場合、照合の問題は行が増えるごとに複雑化します。
これらの問題は個々には致命的ではありません。しかし、これらが組み合わさると、密度の高い複数商品のスクリーンショットは、「これは面倒すぎる、手入力しよう」と言わせるようなデータ抽出の課題に変わります。
ピクセルを読むこととページを読むことの違い
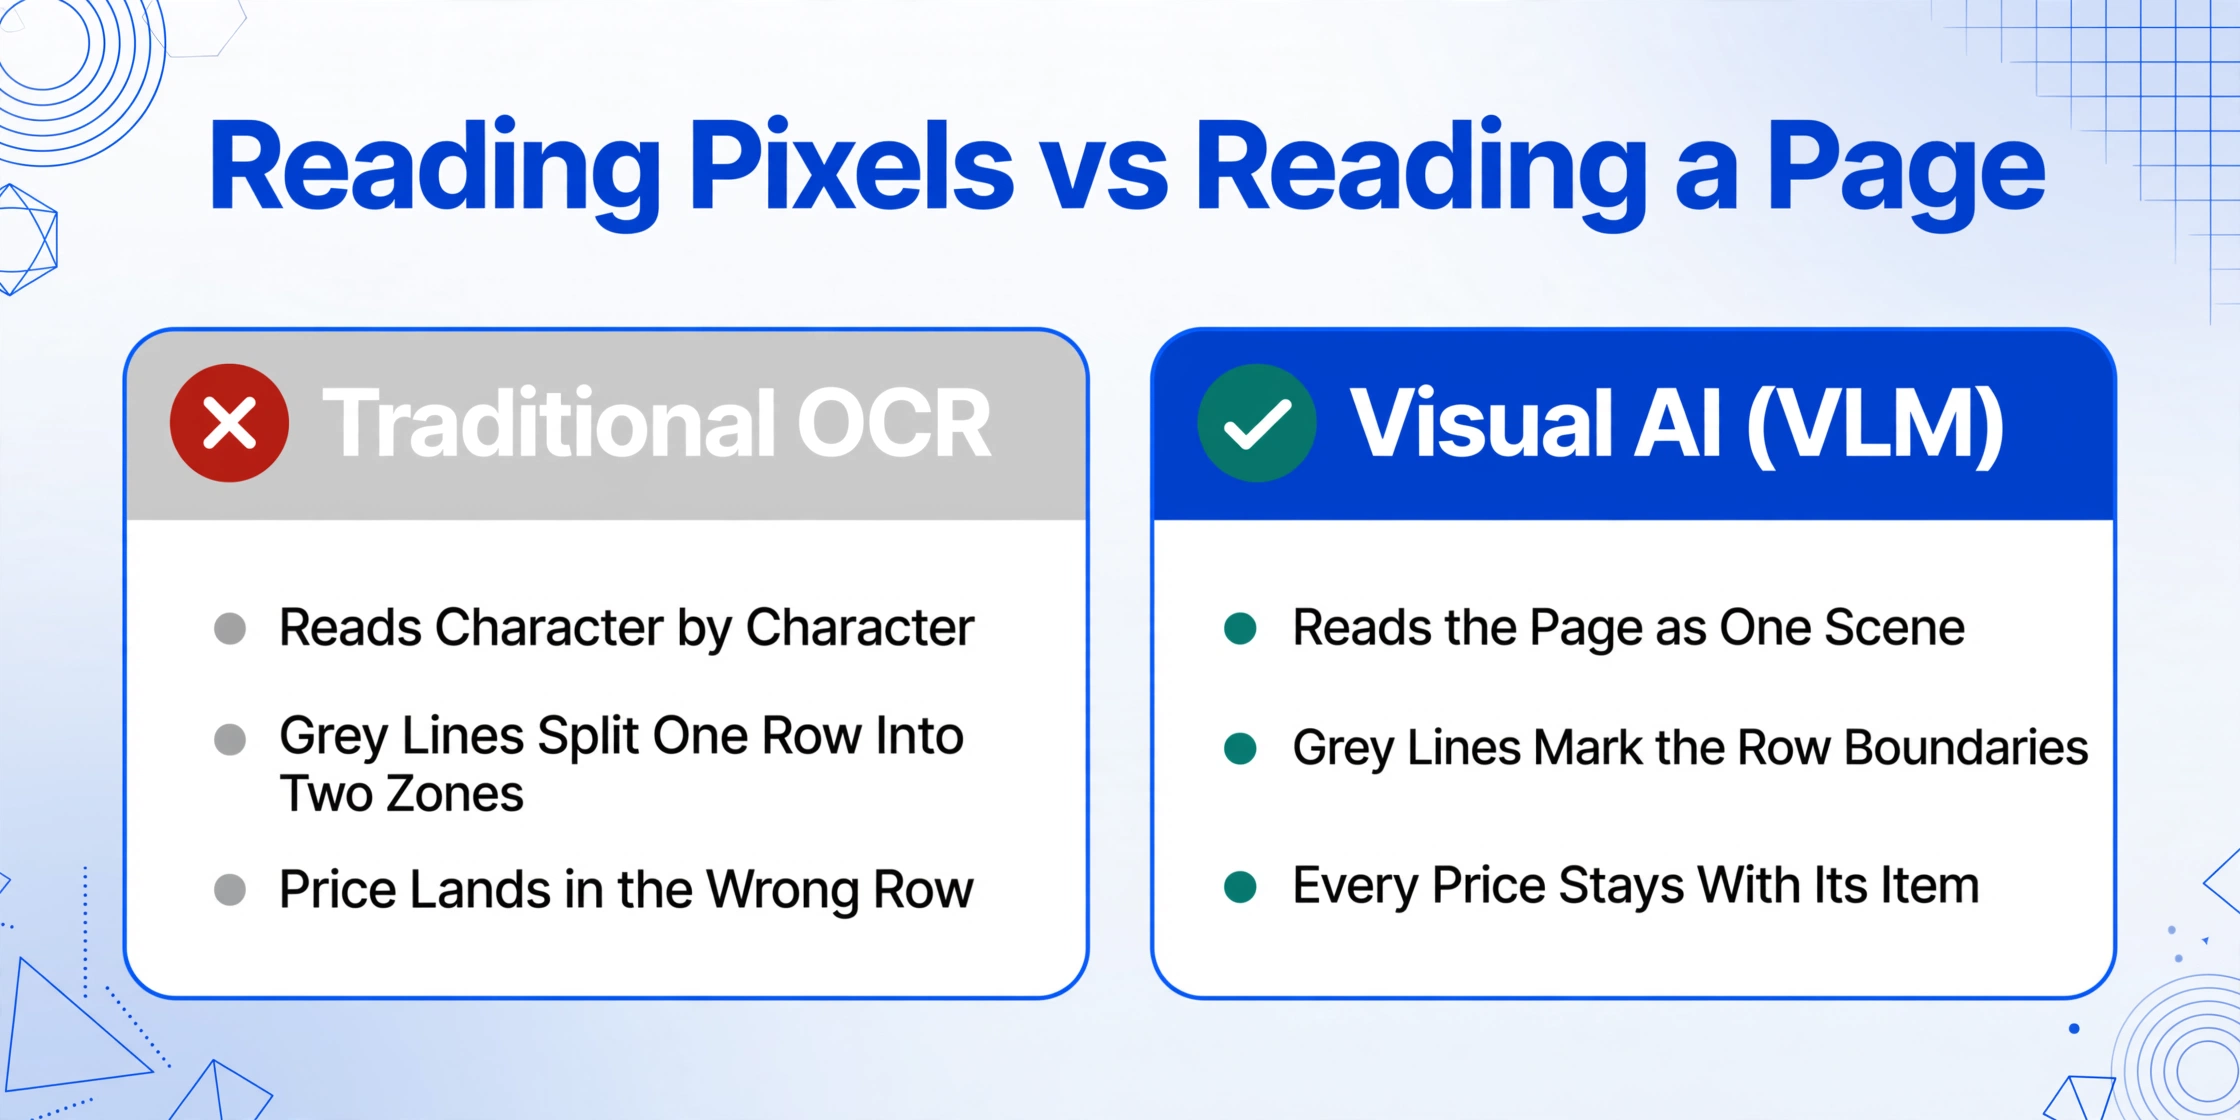
従来のOCRとビジュアルAIは、同じ画像に対して根本的に異なるアプローチを取ります。その違いが最も重要になるのは、入力画像が視覚的に情報量が多い場合です。
OCRエンジンは文字単位で動作します。文字の形を認識し、単語に組み立て、近接性に基づいてテキストブロックにグループ化し、それらのブロックから構造を推測しようとします。依存する視覚的手がかり(明確な列の境界、途切れのないテキスト行、一貫した間隔)が欠けていたり曖昧だったりすると、結果は乱れたデータになります。
視覚言語モデル(VLM)は異なる方法で動作します。スクリーンショット全体を一貫したシーンとして扱います。写真を見て、どのオブジェクトが互いに近くにあるか、どれが別々か、空間的にどう関連しているかを即座に理解するのと同じです。灰色の線はテキスト領域の境界ではなく、新聞の列間の余白のような視覚的な区切りです。途切れた名前は不完全な行ではなく、表示フレームを超えて続くタイトルであり、VLMは表示されているデータを正しい行に関連付けることができます。
ImageToTable.aiはこの種のビジュアルAIを使用しています。複数商品のAmazonスクリーンショットを渡し、商品名、数量、価格の3列を指定すると、スプレッドシートスキャナーのようにページを解析しようとはしません。画像を全体的に見て、視覚的な境界(灰色の線はノイズではなく強い信号です)を特定して各商品行の領域を識別し、各領域内のテキストを指定した列にマッピングします。
従来のOCRを混乱させる灰色の区切り線は、VLMベースの抽出にとって信頼できる構造的なアンカーになります。システムは「この灰色の線は1行目の終わりを示す。その上のすべては商品1に属する。次の灰色の線までの下のすべては商品2に属する」と認識できます。推測しているのではなく、人間の読者と同じようにページレイアウトを読んでいるのです。ただ、機械の速度で行っているだけです。
同じロジックは、明細行とページ合計の区別にも適用されます。「小計」「送料」「注文合計」は最後の商品行の下にあり、多くの場合、異なる形式(太字や異なる背景色)で表示されます。VLMはこれらを追加の商品ではなく集計行として認識します。これらを商品名列に無理やり入れようとはしません。
具体的な例:Amazonの1注文に7点の商品があるケース
具体的に見ていきましょう。Amazonの確認ページの実際のスクリーンショットを想像してください。1つの注文に7つの異なる商品が含まれています。各行の内容と、抽出がどのように行われるかを説明します。
| 行 | スクリーンショットの表示内容 | 抽出された商品名 | 数量 | 価格 |
|---|---|---|---|---|
| 1 | "Kindle Paperwhite (11th Gen) — 数量 1 — $129.99" | Kindle Paperwhite (11th Gen) | 1 | $129.99 |
| 2 | "Amazon Basics USB-C to USB-C Cable 6ft, Brai..." — $9.99 | Amazon Basics USB-C to USB-C Cable 6ft | 1 | $9.99 |
| 3 | "Fire TV Stick 4K Max with Alexa Voic..." + 「販売元: Amazon」バッジ | Fire TV Stick 4K Max | 1 | $39.99 |
| 4 | "Anker 20W USB-C Charger, Compact Fast Cha..." — 数量 2 — $14.99 | Anker 20W USB-C Charger | 2 | $14.99 |
| 5 | "Samsung T7 Portable SSD 1TB, Up to 1050MB/s..." — $99.99 | Samsung T7 Portable SSD 1TB | 1 | $99.99 |
| 6 | "Hydro Flask 32oz Wide Mouth Stainless Steel..." — $34.95 | Hydro Flask 32oz Wide Mouth | 1 | $34.95 |
| 7 | "Merino Wool Hiking Socks 3-Pack, Size Large, Ma..." — $24.99 | Merino Wool Hiking Socks 3-Pack | 1 | $24.99 |
| — | 小計 → 送料 → 注文合計 | 追加の商品ではなく、集計行として正しく認識されます | ||
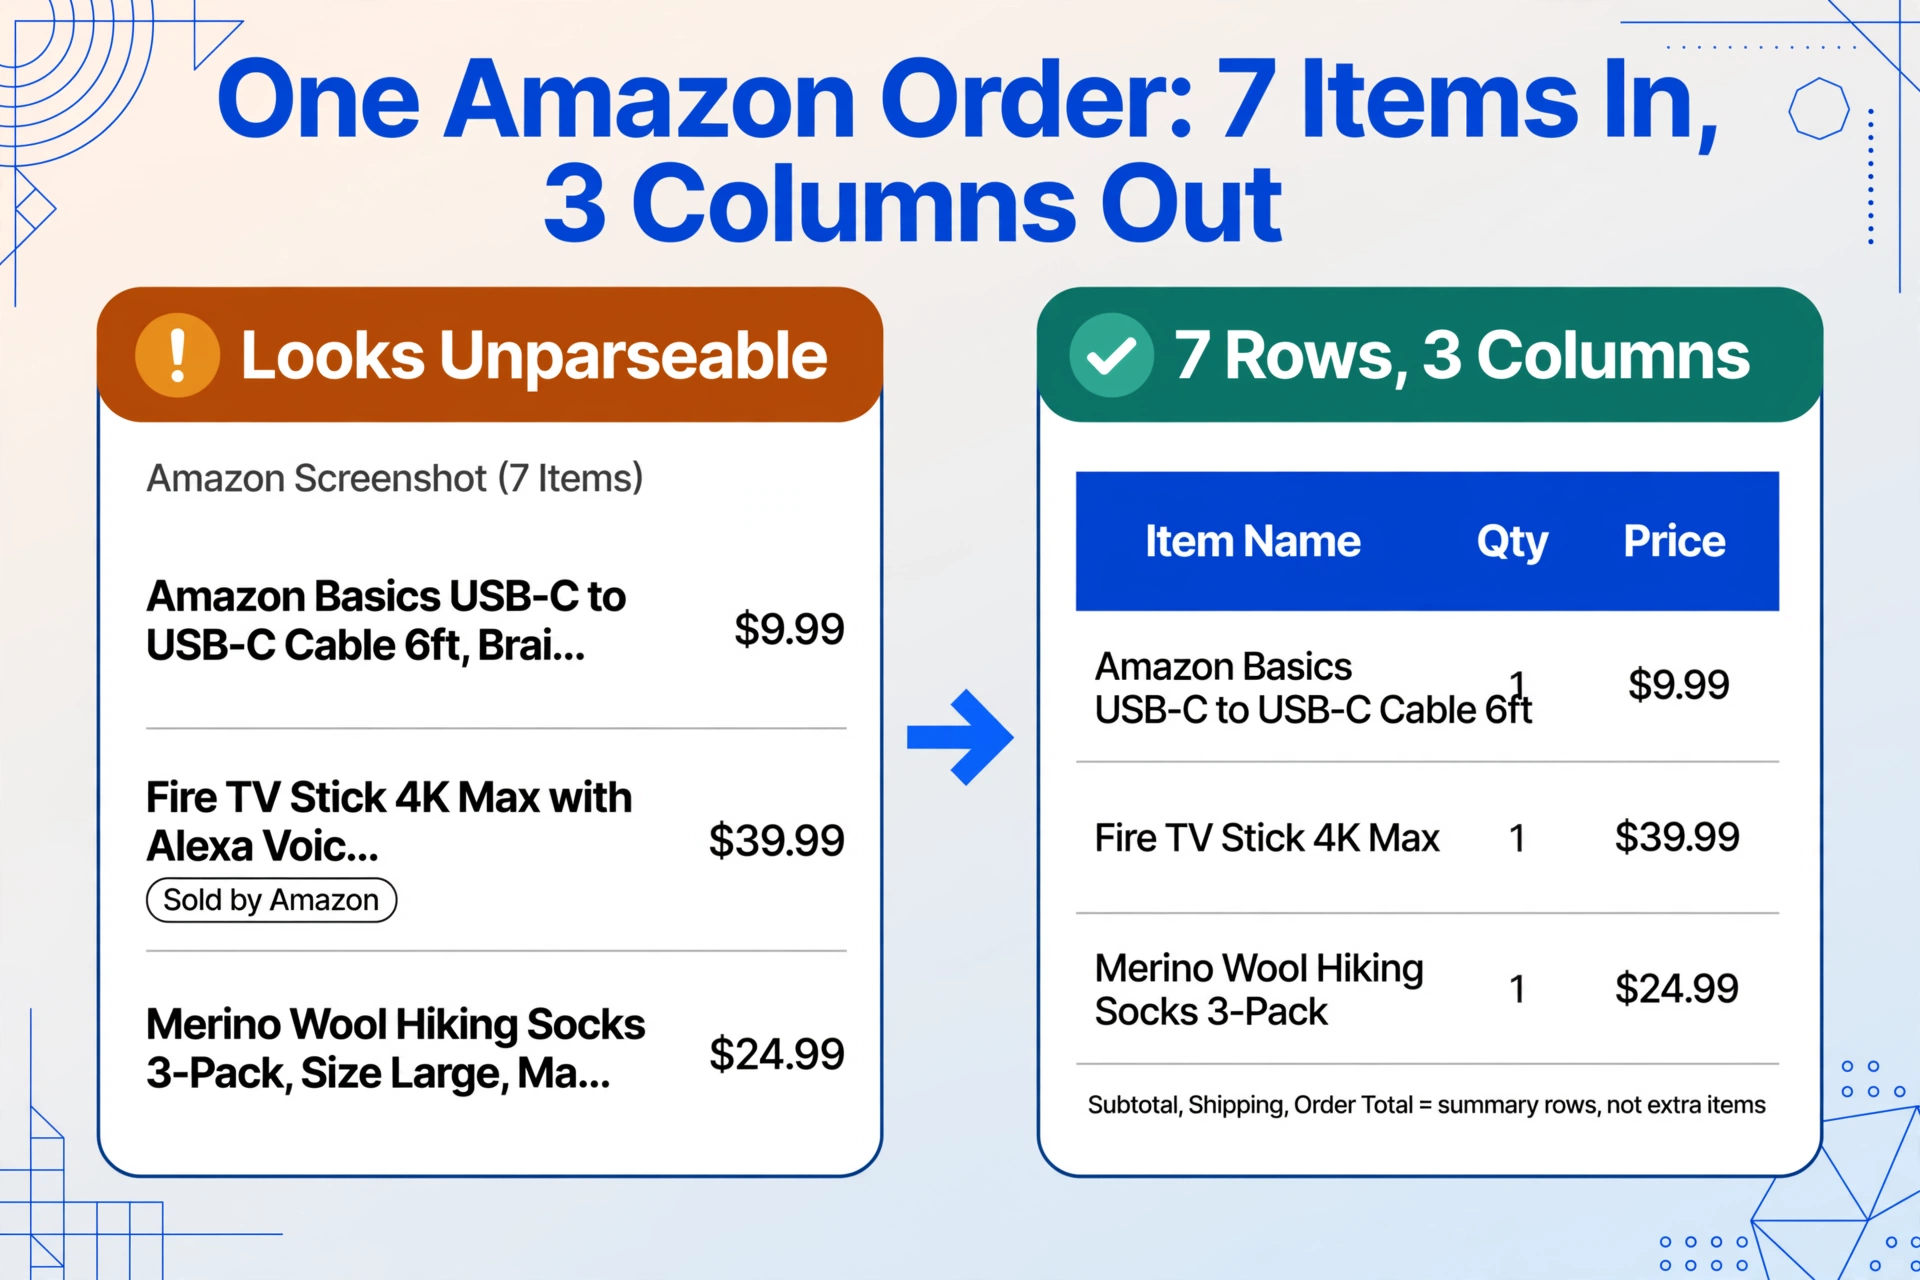
それぞれの課題に対して何が起こったかに注目してください。
- グレーの線 — 各行の境界は、商品間の視覚的な区切りによって識別されました。VLMはこれらを信頼できる行マーカーとして使用しました。
- 省略された商品名 — 2、3、4、7行目はすべて、商品名が「...」で終わる形で明らかに短縮されています。AIはそれでも各価格と数量を親行に正しく関連付けました。これは、空間的な関係(ページ内でテキストがどの垂直位置にあるか)が明確だったためです。
- 第三者バッジ — 3行目の「販売元: Amazon」ラベルは、商品3のサブ要素として認識され、別のレコードとしては扱われませんでした。
- インラインの数量 — 4行目の「数量 2」は正しく読み取られ、Anker充電器に割り当てられました。AIは$14.99が単価であり、2個分の合計ではないことを理解しました。
- 集計行 — 小計、送料、注文合計は商品リストから正しく除外されました。これらは書式と位置が明確に異なり、VLMはそれらをメタレベルの情報として認識しました。
結果は、きれいな7行のテーブルです。支出を追跡したり、ルームメイトと費用を分け合ったり、業務記録として注文を記録したりする場合に、まさに必要な形です。
ワークフローへの影響
上記の具体的なウォークスルーは、1つのことを証明しています。複数商品を含むAmazonスクリーンショットの視覚的な乱雑さは、適切な抽出ツールにとっては障害にはなりません。グレーの線、省略、販売者バッジ — これらはVLMが簡単に見抜く表面レベルのノイズです。
任意のAmazon注文スクリーンショットから明細データを確実に抽出できるようになると、何が変わるのでしょうか?
各スクリーンショットを一回限りの手動データ入力タスクとして扱うのをやめられます。Amazonの注文ページを開いて、商品をセルごとにスプレッドシートに入力し、数字を再確認する代わりに、スクリーンショットをImageToTable.aiにアップロードし、必要な列を指定するだけで、数秒でテーブルが得られます。手動で入力すると2〜3分かかる7行が、10秒未満で抽出されます。
繰り返し発生するシナリオこそが価値を持ちます。1枚のスクリーンショットは些細なものです — 手入力でも対応できます。しかし、毎月の家庭用品のAmazon注文はどうでしょうか?複数のAmazonアカウントで毎週注文を出す転売業者は?5人のクライアントからAmazonの領収書を受け取るフリーランスの簿記係は?規模が大きくなると(週に12件以上の複数商品注文)、手動入力は大きな時間の浪費になります。自動抽出により、持続可能になります。
抽出したデータを他のソースと組み合わせられます。商品名、数量、価格の列は、支払い確認書、仕入先請求書、経費報告書と同じスプレッドシートに入れることができます。すでにImageToTable.aiを他の文書タイプのデータ抽出に使用している場合、Amazonの複数商品注文を同じワークフローに追加するのは、同じシステムが処理するもう1つの入力形式にすぎません。
実際のツールでこれを行うための完全なステップバイステップガイドについては、関連記事 Amazonの複数商品注文: 1枚のスクリーンショットから各商品名、数量、価格を抽出する方法 を参照してください。その記事では実践的なワークフローを説明しています — この記事は、そもそもそれが可能かどうかという疑問を解決するためのものです。
よくある質問
Amazonモバイルアプリのスクリーンショットの場合、デスクトップブラウザとはレイアウトが異なりますか?見た目は変わりますか?
モバイルアプリの注文サマリーページはレイアウトが若干異なります。商品が縦に積み重ねられ、フォントが小さく、間隔が狭く、グレーの区切り線も細くなっています。しかし、核となる視覚構造は同じです。各商品は、商品名・数量・価格を含む明確な行領域を占めています。Visual AIはページ全体を総合的に読み取るため、固定ピクセル位置に依存せず、両方の形式に対応できます。モバイルとデスクトップのスクリーンショットを同じバッチに混在させても、抽出結果は正しく整列されます。
複数数量が注文された場合、AIは単価と合計価格を区別できますか?
はい、できます。行に「Qty 2」と価格$14.99が表示されている場合、AIはAmazonが注文サマリーページでこの情報を通常表示する方法に基づいて、$14.99を単価として認識します(2個分の合計ではありません)。行合計を計算列として必要な場合は、抽出中に数量に単価を掛ける計算列ルールを定義できます。システムはこれをネイティブにサポートしており、Excelでの後処理は不要です。
税情報を含むAmazon Business注文も同じように機能しますか?
はい。Amazon Business注文にはSales Tax行が追加され、免税詳細が表示されることもありますが、基盤となる明細項目の構造は個人用Amazon注文と同一です。追加の税関連行はメタデータとして扱われるため、商品リストが乱雑になることはありません。税額を別の列として必要な場合は、列名として「Sales Tax」を追加すれば、AIがページ上のどこに表示されていても抽出します。
複数のAmazon注文スクリーンショットを一度に処理できますか?それとも1枚ずつですか?
一度に複数処理できます。ImageToTable.aiはバッチファースト処理を前提に設計されています。複数のスクリーンショットをアップロードすると、AIがそれらをまとめて処理し、単一の統合テーブルを生成します。各スクリーンショットの商品は個別の行として表示されます。どの商品がどの注文から来たかを追跡する必要がある場合は、カスタム列(「Order ID」や「Screenshot Source」など)を追加すれば、AIがページから注文番号を識別します。
商品リストの一部だけが表示されているスクリーンショットでも、AIは表示されている部分を抽出できますか?
はい、できます。スクリーンショットに7件中6件しか表示されていない場合でも、AIはその6件を抽出します。完全なフレームや完璧な構図のページでなくても動作します。ただし、提供された画像に含まれる情報のみを抽出するため、完全に切れてしまった商品は出力に含まれません。長い注文で複数回スクロールが必要な場合は、各セクションを個別にスクリーンショットし、まとめてバッチ処理してください。