Una captura de pedido de Amazon con varios artículos
parece un desastre: por qué aún puede obtener datos limpios
Compró siete cosas en un solo pedido de Amazon. La página del recibo muestra un bloque denso de artículos, cada uno separado por una fina línea gris. Algunos nombres de producto se cortan con puntos suspensivos. Un par de artículos dicen "Vendido por" debajo, añadiendo texto extra que no pertenece a la siguiente fila. Todo parece diseñado para frustrar cualquier intento de extracción automática.
Conclusiones clave
- Siete artículos de Amazon apilados tras líneas separadoras grises parecen una tarea tediosa de entrada de datos, pero cada línea gris, nombre truncado e insignia de vendedor que hace caótica la página le da a la IA visual un mapa completo de filas antes de leer un solo carácter.
- El OCR tradicional fragmenta la página en cada línea gris porque las trata como límites de documento, pero un modelo de lenguaje visual ve toda la captura de una vez y usa esas mismas líneas como usted usa las perforaciones de un recibo: para contar artículos, no para cortarlos.
- Cuanto más densa es la captura del pedido de Amazon, más rápida y precisa se vuelve la extracción: el desorden visual no es ruido para la IA visual, es un excedente de puntos de referencia estructurales gratuitos que hacen que el diseño de la página sea completamente inequívoco.
Por qué una captura de Amazon con varios artículos parece imposible a primera vista
Mencionemos las cosas específicas que hacen que este tipo de captura parezca imposible de analizar automáticamente. No son problemas vagos: cada uno es un obstáculo concreto con el que los métodos tradicionales de extracción tropiezan.
Líneas separadoras grises. Amazon dibuja una línea gris horizontal delgada entre cada fila de artículos en la página de resumen del pedido. Para un motor OCR tradicional —que funciona detectando regiones de texto y luego intentando agruparlas de forma significativa— estas líneas parecen límites. Trata cada artículo como su propia zona de texto aislada, y cuando algo se divide en zonas aisladas, el motor tiene que adivinar cómo se relacionan entre sí. ¿El precio en el borde derecho de la zona dos pertenecía a la zona dos o a la zona tres? El OCR no tiene forma de saberlo.
Nombres de productos truncados. "Logitech G502 X PLUS LIGHTSPEED Wireless Gaming Mouse with HERO 25K Sensor..." — pero en la captura se muestra "Logitech G502 X PLUS LIGHTSP..." seguido de puntos suspensivos. Ese texto truncado desestabiliza cualquier sistema que dependa de leer una línea completa de izquierda a derecha. Un analizador basado en filas ve el nombre abreviado y luego no sabe dónde comienza la siguiente columna porque la línea simplemente se detiene a mitad de una palabra.
Insignias de vendedores externos. Los artículos que no vende directamente Amazon muestran "Vendido por [Nombre del vendedor]" en una fuente más pequeña debajo del nombre del producto. Este texto se encuentra entre dos artículos, pero pertenece a la fila anterior, no a la siguiente. Una extracción ingenua lo trata como una fila separada o, peor aún, lo agrega a los datos del siguiente artículo. En cualquier caso, el resultado es incorrecto.
Alineación de cantidad y precio. En la página de pedidos de Amazon, la cantidad se muestra junto al nombre del artículo — "Cantidad: 1" — mientras que el precio está en el extremo derecho. El OCR tradicional extrae el precio como un número independiente flotando en el margen derecho y tiene que adivinar a qué artículo pertenece. Cuando siete precios y siete nombres de artículos están dispersos en el mismo campo visual, el problema de coincidencia se agrava con cada fila adicional.
Ninguno de estos problemas es un obstáculo insuperable por sí solo. Pero juntos, convierten una captura densa con varios artículos en exactamente el tipo de desafío de extracción de datos que hace que la gente diga "esto es demasiado complicado, mejor lo escribo a mano".
La diferencia entre leer píxeles y leer una página
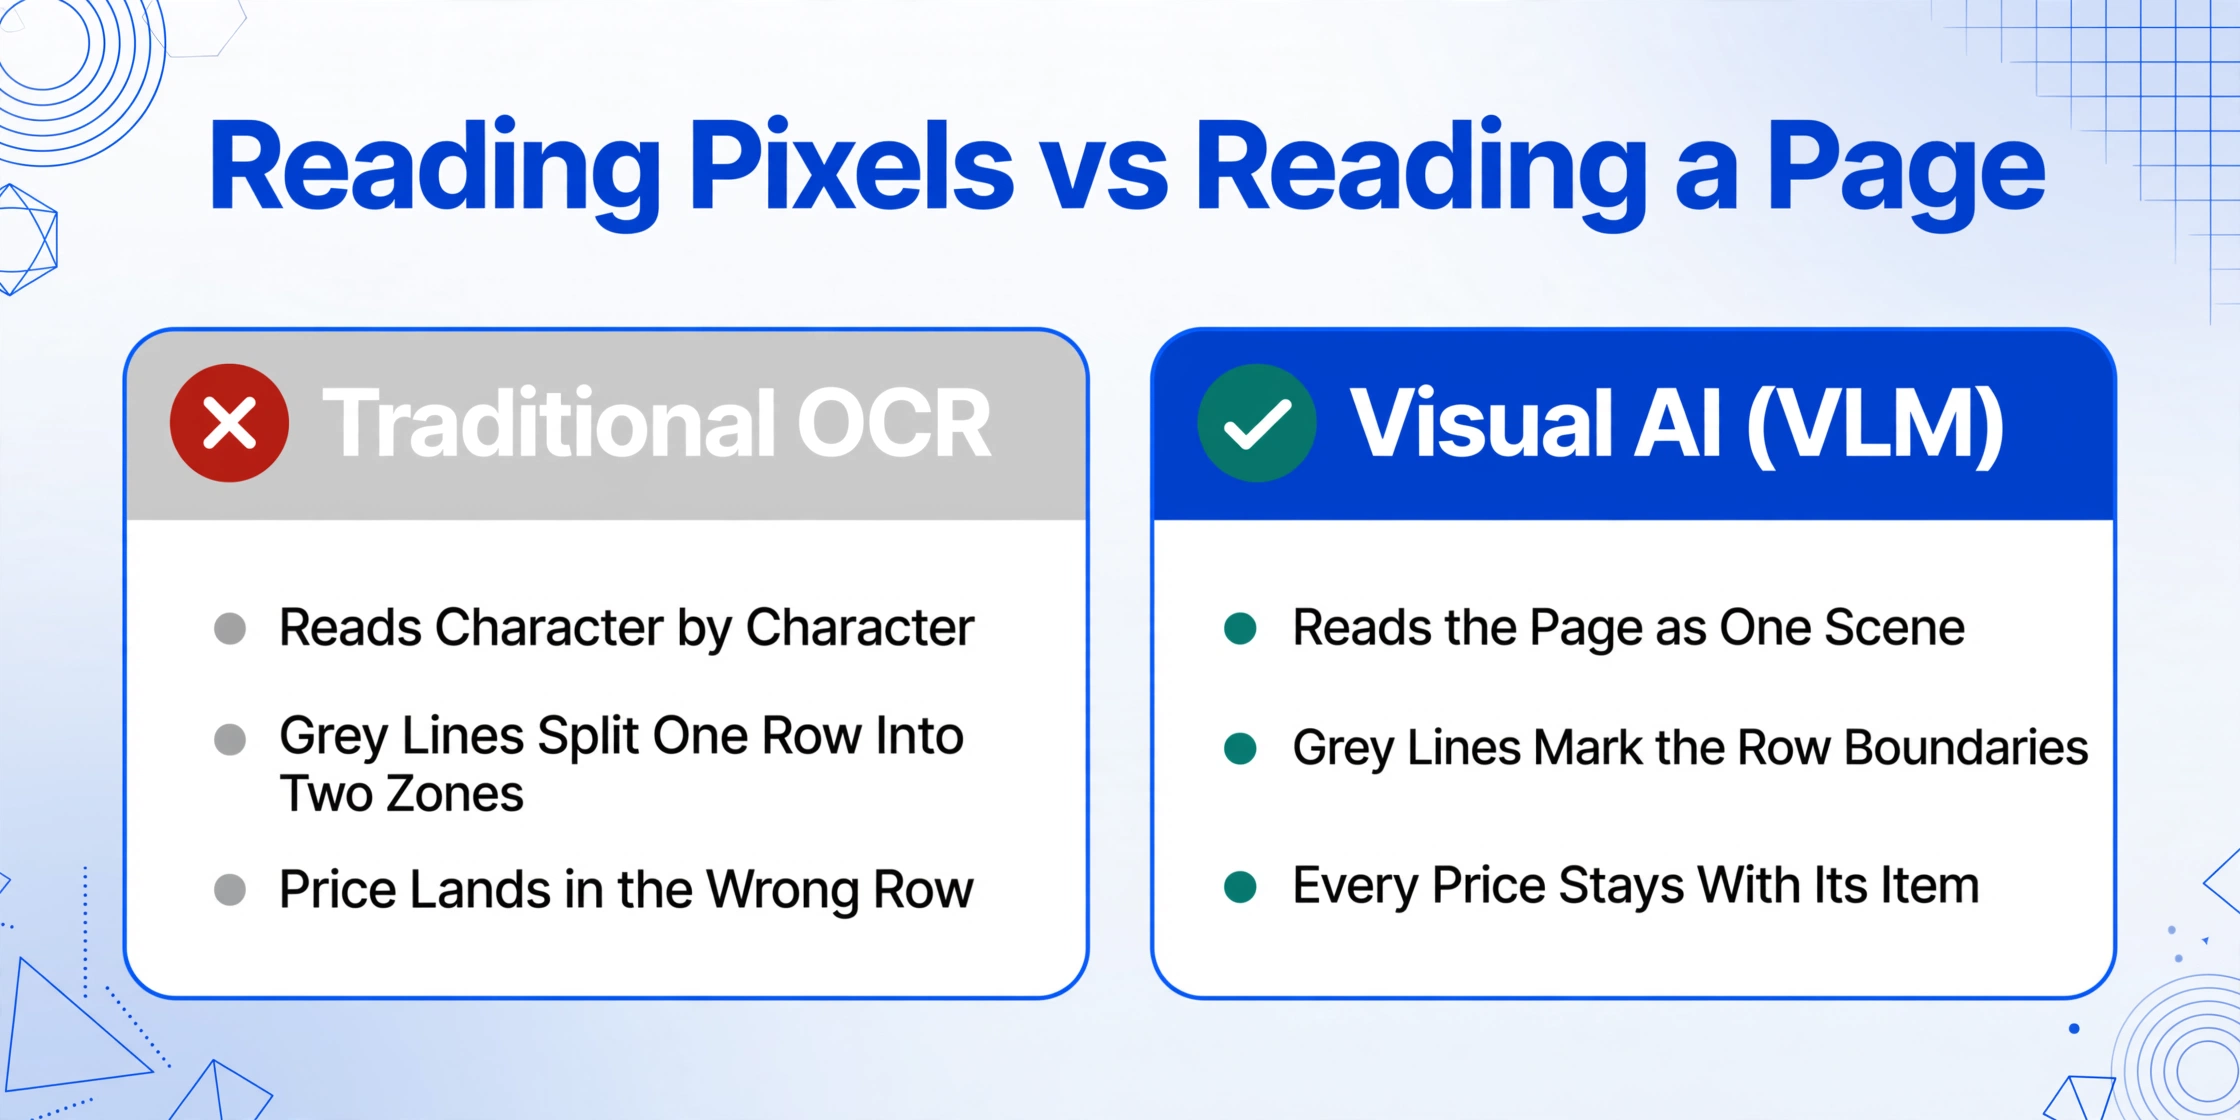
El OCR tradicional y la IA visual abordan la misma imagen de maneras fundamentalmente diferentes, y la diferencia importa más cuando la entrada es visualmente densa.
Un motor de OCR funciona carácter por carácter: encuentra formas de letras, las ensambla en palabras, agrupa palabras en bloques de texto por proximidad y luego intenta inferir la estructura a partir de esos bloques. Cuando las señales visuales de las que depende (límites de columna claros, líneas de texto ininterrumpidas, espaciado consistente) están ausentes o son ambiguas, el resultado son datos desordenados.
Un modelo de lenguaje visual (VLM) funciona de manera diferente. Trata la captura de pantalla completa como una escena coherente, de la misma manera en que usted o yo miramos una fotografía y entendemos de inmediato qué objetos están cerca entre sí, cuáles están separados y cómo se relacionan espacialmente. Las líneas grises no son bordes de regiones de texto, son separadores visuales, como el margen entre columnas de un periódico. Los nombres truncados no son líneas incompletas, son títulos que se extienden más allá del marco visible, y el VLM aún puede asociar los datos que sí son visibles con la fila correcta.
ImageToTable.ai utiliza este tipo de IA visual. Cuando usted le da una captura de pantalla de Amazon con varios artículos y le indica que quiere tres columnas — Nombre del artículo, Cantidad y Precio — no intenta analizar la página como lo haría un escáner de hojas de cálculo. Mira la imagen de manera holística, identifica cada región de fila distinta al detectar los límites visuales (las líneas grises son una señal fuerte, no una distracción) y luego asigna el texto dentro de cada región a las columnas que usted solicitó.
La línea separadora gris, que confunde al OCR tradicional, se convierte en un ancla estructural confiable para la extracción basada en VLM. El sistema puede ver: "esta línea gris marca el final de la fila uno. Todo lo que está encima pertenece al artículo uno. Todo lo que está debajo, hasta la siguiente línea gris, pertenece al artículo dos". No está adivinando, está leyendo el diseño de la página de la misma manera que lo hace un lector humano, solo que a velocidad de máquina.
La misma lógica se aplica para distinguir los artículos de línea de los totales de la página. "Subtotal", "Envío", "Total del pedido" — estos se encuentran debajo de la última fila de artículos, a menudo con un formato diferente (en negrita o con un fondo distinto). El VLM los reconoce como filas de resumen, no como productos adicionales. No intenta forzarlos en la columna de Nombre del artículo.
Un Ejemplo Concreto: 7 Artículos en un Solo Pedido de Amazon
Vamos a hacerlo concreto. Imagine una captura de pantalla real de la página de confirmación de Amazon: un solo pedido con siete artículos diferentes. Esto es lo que contiene cada fila y cómo se desarrolla la extracción.
| Fila | Lo que Muestra la Captura | Nombre del Artículo Extraído | Cantidad | Precio |
|---|---|---|---|---|
| 1 | "Kindle Paperwhite (11.ª generación) — Cantidad 1 — $129.99" | Kindle Paperwhite (11.ª generación) | 1 | $129.99 |
| 2 | "Cable Amazon Basics USB-C a USB-C de 6 pies, Brai..." — $9.99 | Cable Amazon Basics USB-C a USB-C de 6 pies | 1 | $9.99 |
| 3 | "Fire TV Stick 4K Max con Alexa Voic..." + insignia "Vendido por Amazon" | Fire TV Stick 4K Max | 1 | $39.99 |
| 4 | "Cargador Anker 20W USB-C, carga rápida compacta..." — Cantidad 2 — $14.99 | Cargador Anker 20W USB-C | 2 | $14.99 |
| 5 | "Samsung T7 SSD portátil 1TB, hasta 1050MB/s..." — $99.99 | Samsung T7 SSD portátil 1TB | 1 | $99.99 |
| 6 | "Hydro Flask 32oz boca ancha de acero inoxidable..." — $34.95 | Hydro Flask 32oz boca ancha | 1 | $34.95 |
| 7 | "Calcetines de senderismo de lana merino 3 pares, talla L, Ma..." — $24.99 | Calcetines de senderismo de lana merino 3 pares | 1 | $24.99 |
| — | Subtotal → Envío → Total del pedido | Reconocidas correctamente como filas de resumen, no como artículos adicionales | ||
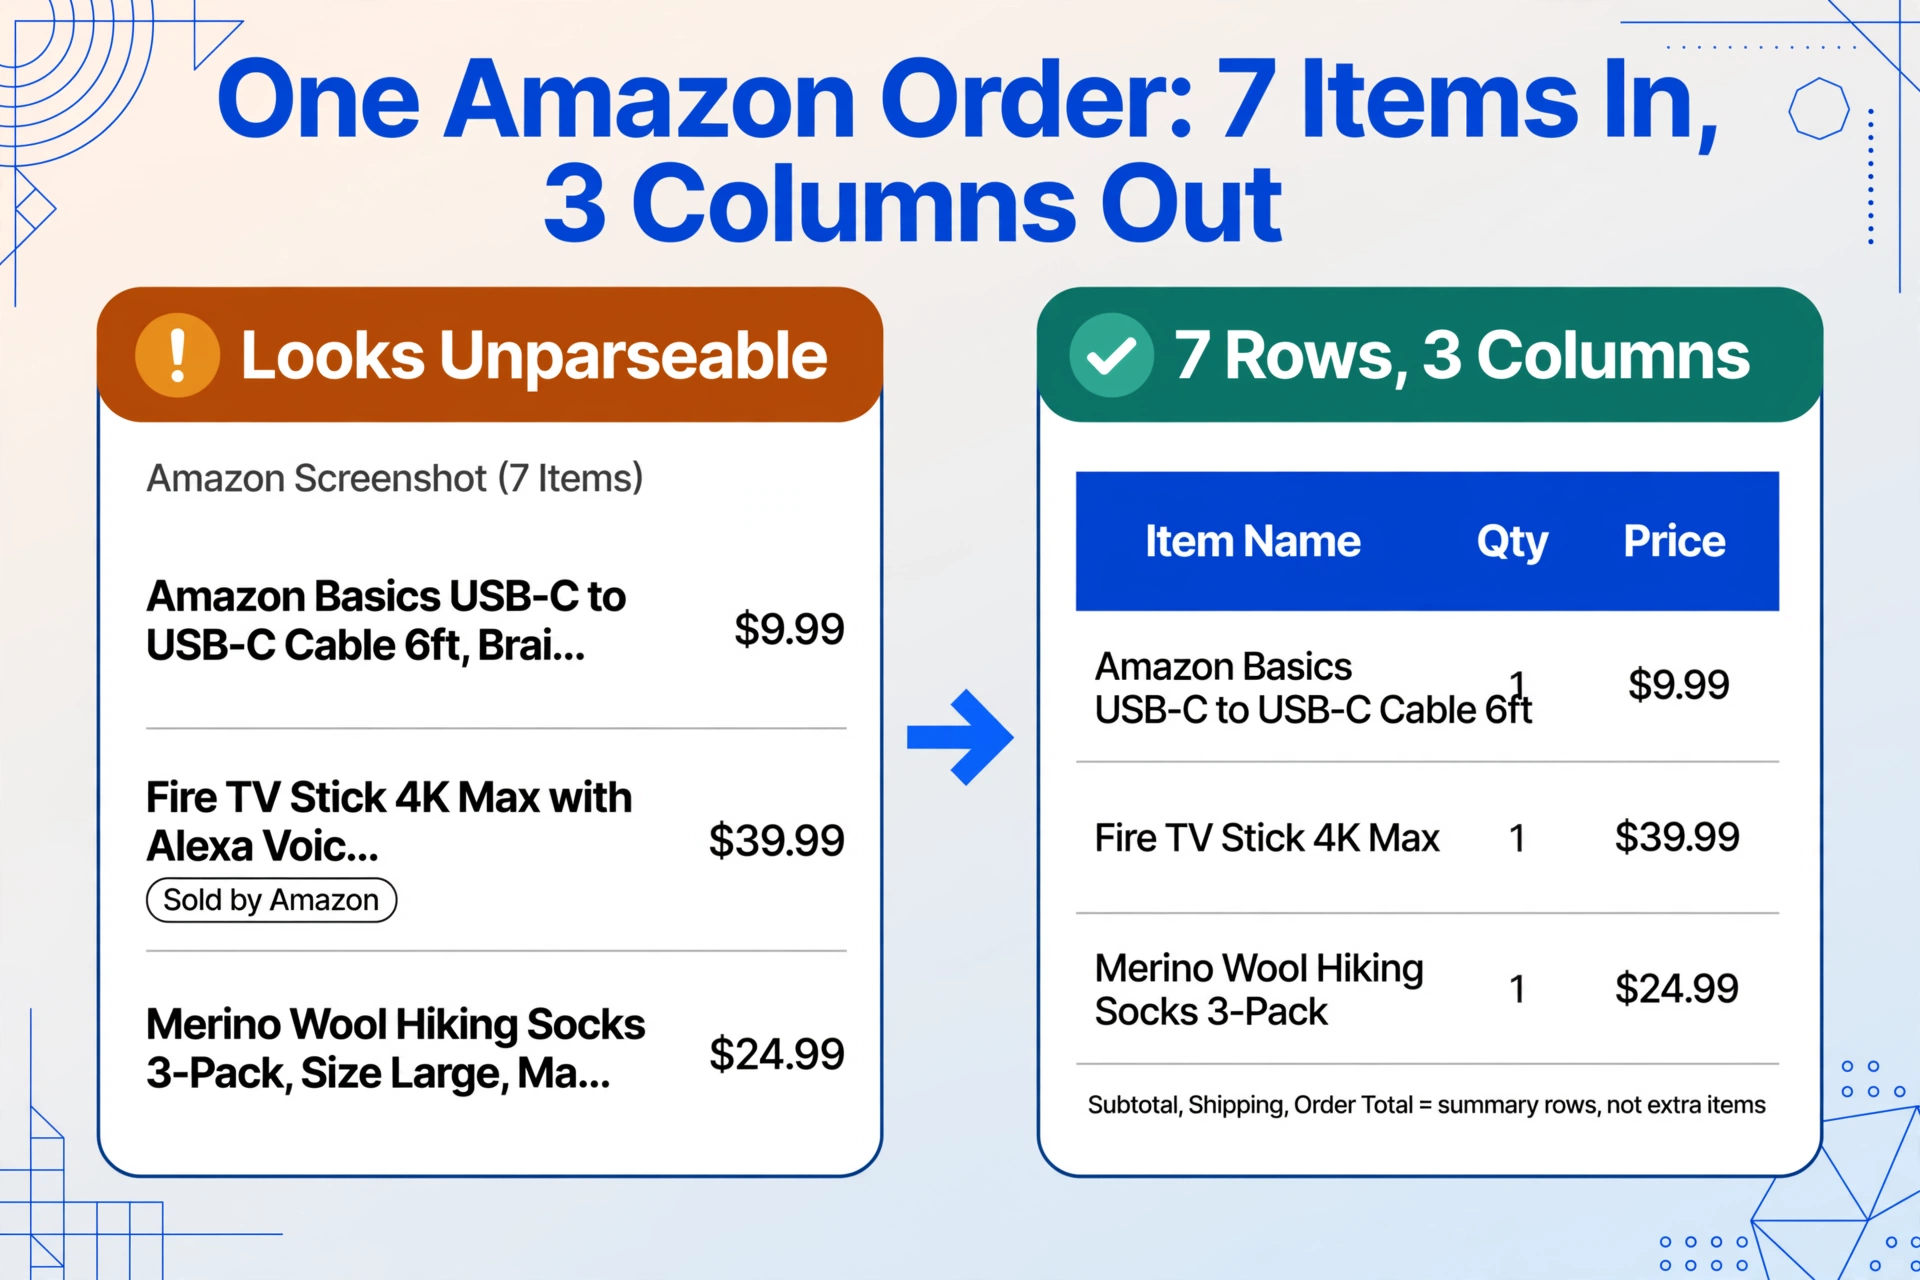
Observe lo que sucedió con cada desafío:
- Líneas grises — cada límite de fila fue identificado por el separador visual entre artículos. El VLM las utilizó como marcadores de fila confiables.
- Nombres truncados — las filas 2, 3, 4 y 7 tienen nombres de producto visiblemente acortados que terminan con "...". La IA asoció correctamente cada precio y cantidad con su fila correspondiente, porque la relación espacial (qué texto se encuentra en qué posición vertical en la página) no era ambigua.
- Insignias de terceros — la etiqueta "Vendido por Amazon" de la fila 3 fue reconocida como un subelemento del artículo 3, no como un registro separado.
- Cantidad en línea — el "Cantidad 2" de la fila 4 fue leído y asignado correctamente al cargador Anker, y la IA entendió que los $14.99 eran el precio por unidad, no el total por dos.
- Filas de resumen — Subtotal, Envío y Total del pedido fueron excluidos correctamente de la lista de artículos. Son claramente distintos en formato y posición, y el VLM los reconoció como información de nivel meta.
El resultado es una tabla limpia de siete filas — exactamente lo que usted querría si estuviera rastreando gastos, dividiendo costos con un compañero de cuarto o registrando un pedido para fines contables.
Qué Significa Esto para Su Flujo de Trabajo
El recorrido concreto anterior demuestra una cosa: el desorden visual de una captura de pantalla de Amazon con varios artículos no es un obstáculo para el tipo adecuado de herramienta de extracción. Las líneas grises, la truncación y las insignias de vendedores — son ruido superficial que un VLM atraviesa fácilmente.
¿Qué cambia cuando usted puede extraer de manera confiable los datos de artículos de cualquier captura de pantalla de pedido de Amazon?
Usted deja de tratar cada captura de pantalla como una tarea manual de entrada de datos de una sola vez. En lugar de abrir la página de pedido de Amazon, escribir los artículos en una hoja de cálculo celda por celda y verificar los números, usted sube la captura de pantalla a ImageToTable.ai, le indica qué columnas necesita y obtiene la tabla en segundos. Siete filas que tomarían de 2 a 3 minutos escribir manualmente se extraen en menos de 10 segundos.
El escenario recurrente se convierte en el valioso. Una captura de pantalla es trivial — usted podría escribirla. Pero, ¿qué hay del pedido mensual de Amazon para suministros del hogar? ¿El revendedor que realiza pedidos semanales en diferentes cuentas de Amazon? ¿El contador independiente que recibe recibos de Amazon de cinco clientes? A escala — una docena o más de pedidos con varios artículos por semana — la entrada manual se convierte en una pérdida de tiempo significativa. La extracción automatizada lo hace sostenible.
Usted puede combinar los datos extraídos con otras fuentes. Las columnas Nombre del artículo, Cantidad y Precio pueden ir en la misma hoja de cálculo que las confirmaciones de pago, facturas de proveedores o informes de gastos. Si usted ya está usando ImageToTable.ai para extraer datos de otros tipos de documentos, agregar pedidos de Amazon con varios artículos al mismo flujo de trabajo es solo un formato de entrada más que el mismo sistema maneja.
Para obtener una guía completa paso a paso sobre cómo hacer esto con una herramienta real, consulte el artículo complementario Pedidos de Amazon con Varios Artículos: Cómo Extraer el Nombre, la Cantidad y el Precio de Cada Artículo de una Sola Captura de Pantalla. Ese artículo recorre el flujo de trabajo práctico — este existe para resolver la cuestión de si es siquiera posible en primer lugar.
Preguntas Frecuentes
¿Qué sucede si la captura de pantalla proviene de la aplicación móvil de Amazon en lugar de un navegador de escritorio? ¿El diseño se ve diferente?
La página de resumen de pedidos de la aplicación móvil tiene un diseño ligeramente diferente: los artículos se apilan verticalmente con fuentes más pequeñas y un espaciado más compacto, y las líneas separadoras grises son más delgadas. Pero la estructura visual central es la misma: cada artículo ocupa una región de fila distinta con su nombre, cantidad y precio. La IA visual maneja ambos formatos porque lee la página de manera holística en lugar de depender de posiciones fijas de píxeles. Puede mezclar capturas de pantalla móviles y de escritorio en el mismo lote y la extracción se alineará correctamente.
¿Puede la IA distinguir entre el precio unitario y el precio total cuando se piden varias cantidades?
Sí. Cuando una fila muestra "Cantidad 2" y un precio de $14.99, la IA reconoce los $14.99 como el precio unitario — no el total de dos unidades — basándose en cómo Amazon muestra típicamente esta información en la página de resumen de pedidos. Si necesita el total de la línea como una columna calculada ($29.98 = 2 × $14.99), puede definir una regla que multiplique la cantidad por el precio unitario durante la extracción. El sistema admite esto de forma nativa sin ningún procesamiento posterior en Excel.
¿Los pedidos de Amazon Business con información de impuestos funcionan de la misma manera?
Sí. Los pedidos de Amazon Business agregan una línea de Impuesto sobre las ventas y a veces muestran detalles de exención de impuestos, pero la estructura subyacente de las líneas de artículos es idéntica a la de un pedido personal de Amazon. Las filas adicionales relacionadas con impuestos se tratan como metadatos — no saturarán su lista de artículos. Si necesita el monto del impuesto como una columna separada, puede agregar "Impuesto sobre las ventas" como nombre de columna y la IA lo extraerá de donde aparezca en la página.
¿Puedo procesar varias capturas de pantalla de pedidos de Amazon a la vez, o tiene que ser una a la vez?
Varias a la vez. ImageToTable.ai está diseñado como un sistema de procesamiento por lotes prioritario — usted sube varias capturas de pantalla y la IA las procesa juntas, produciendo una sola tabla unificada. Los artículos de cada captura aparecen como filas separadas, y si necesita rastrear qué artículos provienen de qué pedido, puede agregar una columna personalizada (como "ID de pedido" o "Fuente de captura") y la IA identificará el número de pedido desde la página.
¿Qué pasa con las capturas de pantalla que muestran solo parte de la lista de artículos? ¿Puede la IA extraer lo que es visible?
Sí. Si solo seis de siete artículos son visibles en la captura de pantalla, la IA extrae esos seis. No necesita una página completa o perfectamente encuadrada para funcionar. La limitación es que solo puede extraer lo que está en la imagen que usted le proporciona: si un artículo está completamente recortado, no aparecerá en el resultado. Para pedidos largos que abarcan varios desplazamientos, tome capturas de pantalla separadas de cada sección y procéselas juntas.