Uma Captura de Pedido Amazon com Vários Itens
Parece um Caos — Aqui Está Por Que Você Ainda Pode Obter Dados Limpos
Você comprou sete coisas em um único pedido Amazon. A página de recibo mostra um bloco denso de itens, cada um separado por uma linha cinza fina. Alguns nomes de produtos se cortan com reticências. Alguns itens dizem "Vendido por" debajo, adicionando texto extra que não pertence à linha seguinte. Todo parece desenhado para derrotar qualquer tentativa de extração automática.
Principais Conclusões
- Sete itens Amazon empilhados atrás de linhas separadoras cinzas parecem uma tarefa de entrada de dados — mas cada linha cinza, nome truncado e insignia de vendedor que torna a página caótica dá à IA visual um mapa completo de linhas antes de ler um único caractere.
- O OCR tradicional fragmenta a página em cada linha cinza porque as trata como limites de documento, mas um modelo de linguagem visual vê toda a captura de uma vez e usa essas mesmas linhas como você usa as perfurações de um recibo — para contar itens, não para cortarlos.
- Quanto mais densa a captura de pedido Amazon, mais rápida e precisa se torna a extração — o caos visual não é ruido para a IA visual, é um excedente de marcos estruturais gratuitos que tornan o layout da página completamente inequívoco.
Por que uma captura de tela da Amazon com vários itens parece impossível à primeira vista
Vamos citar os pontos específicos que fazem esse tipo de captura de tela parecer impossível de analisar automaticamente. Não são problemas vagos — cada um é um obstáculo concreto que os métodos tradicionais de extração encontram.
Linhas separadoras cinzas. A Amazon desenha uma linha cinza horizontal fina entre cada linha de item na página de resumo do pedido. Para um mecanismo de OCR tradicional — que funciona detectando regiões de texto e depois tentando agrupá-las de forma significativa — essas linhas parecem limites. Ele trata cada item como uma zona de texto isolada, e quando algo é dividido em zonas isoladas, o mecanismo precisa adivinhar como elas se relacionam. O preço na borda direita da zona dois pertencia à zona dois ou à zona três? O OCR não tem como saber.
Nomes de produtos truncados. "Logitech G502 X PLUS LIGHTSPEED Wireless Gaming Mouse with HERO 25K Sensor..." — mas na captura de tela aparece "Logitech G502 X PLUS LIGHTSP..." seguido de reticências. Esse texto truncado atrapalha qualquer sistema que dependa da leitura de uma linha completa da esquerda para a direita. Um analisador baseado em linhas vê o nome abreviado e não sabe onde a próxima coluna começa, porque a linha simplesmente para no meio de uma palavra.
Selos de vendedores terceirizados. Itens que não são vendidos diretamente pela Amazon mostram "Vendido por [Nome do Vendedor]" em uma fonte menor abaixo do nome do produto. Esse texto fica entre dois itens, mas pertence à linha anterior, não à seguinte. Uma extração ingênua trata isso como uma linha separada ou, pior, anexa aos dados do próximo item. De qualquer forma, o resultado está errado.
Alinhamento de quantidade e preço. Na página de pedidos da Amazon, a quantidade é exibida ao lado do nome do item — "Quantidade: 1" — enquanto o preço fica no extremo direito. O OCR tradicional extrai o preço como um número isolado flutuando na margem direita e precisa adivinhar a qual item ele pertence. Quando sete preços e sete nomes de itens estão espalhados pelo mesmo campo visual, o problema de correspondência aumenta a cada linha adicional.
Nenhum desses problemas é um obstáculo individualmente. Mas juntos, eles transformam uma captura de tela densa com vários itens exatamente no tipo de desafio de extração de dados que faz as pessoas dizerem "isso é muito confuso, vou apenas digitar".
A Diferença Entre Ler Pixels e Ler uma Página
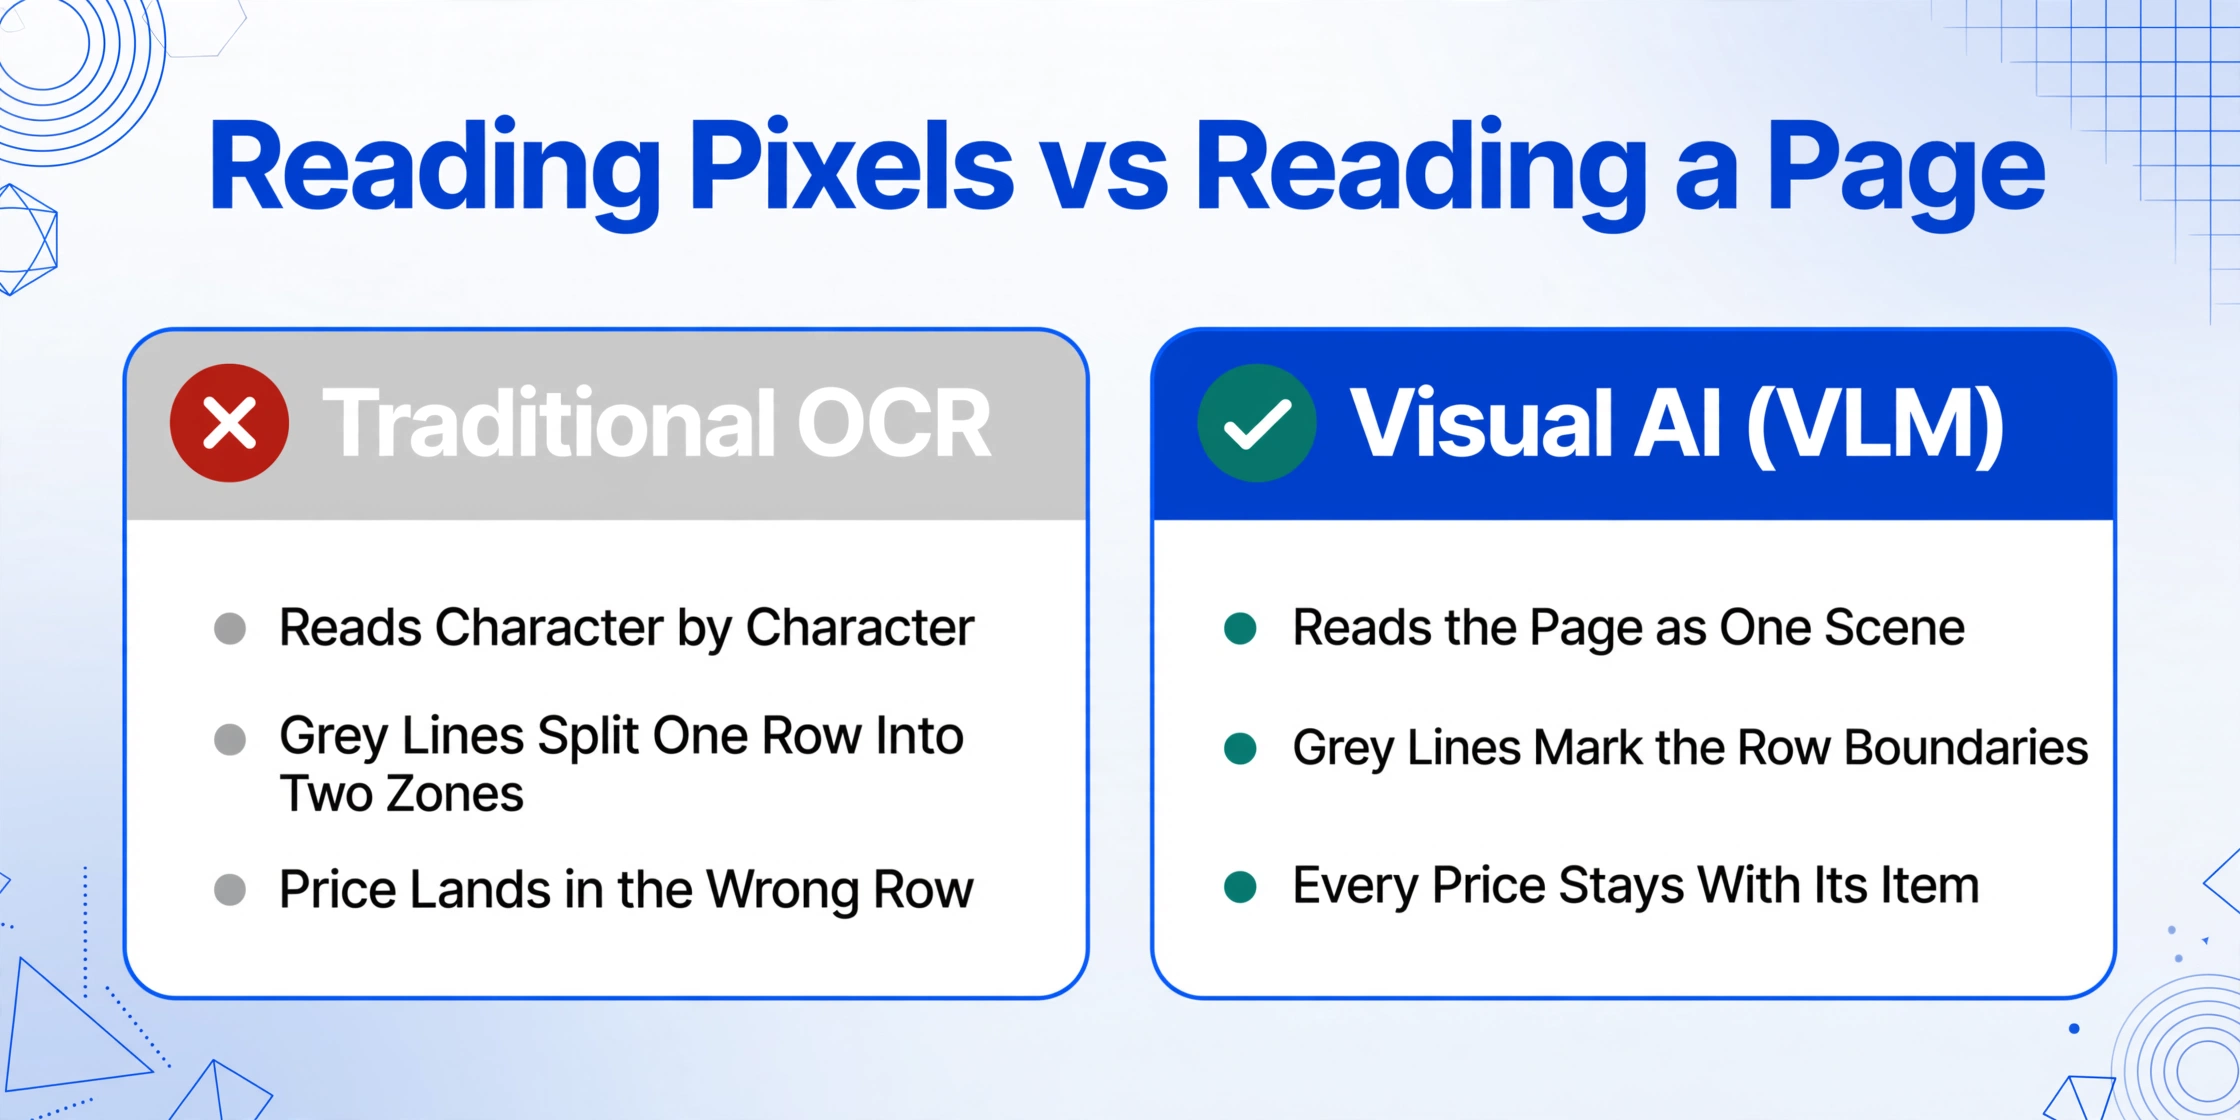
O OCR tradicional e a IA visual abordam a mesma imagem de maneiras fundamentalmente diferentes, e a diferença importa mais quando a entrada é visualmente densa.
Um mecanismo de OCR funciona caractere por caractere — ele encontra formatos de letras, os agrupa em palavras, agrupa palavras em blocos de texto por proximidade e então tenta inferir a estrutura desses blocos. Quando as pistas visuais das quais depende (limites de coluna claros, linhas de texto ininterruptas, espaçamento consistente) estão ausentes ou ambíguas, o resultado são dados embaralhados.
Um modelo de linguagem visual (VLM) funciona de forma diferente. Ele trata a captura de tela inteira como uma cena coerente — da mesma forma que você ou eu olhamos para uma fotografia e entendemos imediatamente quais objetos estão próximos uns dos outros, quais estão separados e como eles se relacionam espacialmente. Linhas cinzas não são bordas de região de texto — são separadores visuais, como a margem entre colunas em um jornal. Nomes truncados não são linhas incompletas — são títulos que se estendem além do quadro visível, e o VLM ainda consegue associar os dados que estão visíveis à linha correta.
O ImageToTable.ai usa esse tipo de IA visual. Quando você dá a ele uma captura de tela da Amazon com vários itens e pede três colunas — Nome do item, Quantidade e Preço — ele não tenta analisar a página como um scanner de planilha faria. Ele olha para a imagem de forma holística, identifica cada região distinta de linha detectando os limites visuais (as linhas cinzas são um sinal forte, não uma distração) e então mapeia o texto dentro de cada região para as colunas que você pediu.
A linha separadora cinza — que confunde o OCR tradicional — se torna uma âncora estrutural confiável para a extração baseada em VLM. O sistema consegue ver: "esta linha cinza marca o fim da linha um. Tudo acima dela pertence ao item um. Tudo abaixo dela, até a próxima linha cinza, pertence ao item dois." Não é adivinhação — é leitura do layout da página da mesma forma que um leitor humano faz, só que em velocidade de máquina.
A mesma lógica se aplica para distinguir itens de linha dos totais da página. "Subtotal", "Envío", "Total do pedido" — estes ficam abaixo da última linha de item, geralmente formatados de forma diferente (em negrito ou com um fundo diferente). O VLM os reconhece como linhas de resumo, não como produtos adicionais. Ele não tenta forçá-los para a coluna Nome do item.
Um Exemplo Concreto: 7 Itens em um Único Pedido da Amazon
Vamos tornar isso concreto. Imagine uma captura de tela real da página de confirmação da Amazon — um único pedido com sete itens diferentes. Veja o que cada linha contém e como a extração acontece.
| Linha | O que a Captura de Tela Mostra | Nome do Item Extraído | Quantidade | Preço |
|---|---|---|---|---|
| 1 | "Kindle Paperwhite (11ª Geração) — Quantidade 1 — $129.99" | Kindle Paperwhite (11ª Geração) | 1 | $129.99 |
| 2 | "Amazon Basics Cabo USB-C para USB-C 6 pés, Brai..." — $9.99 | Amazon Basics Cabo USB-C para USB-C 6 pés | 1 | $9.99 |
| 3 | "Fire TV Stick 4K Max com Alexa Voic..." + selo "Vendido por Amazon" | Fire TV Stick 4K Max | 1 | $39.99 |
| 4 | "Anker Carregador USB-C 20W, Compacto e Rápido..." — Quantidade 2 — $14.99 | Anker Carregador USB-C 20W | 2 | $14.99 |
| 5 | "Samsung T7 SSD Portátil 1TB, Até 1050MB/s..." — $99.99 | Samsung T7 SSD Portátil 1TB | 1 | $99.99 |
| 6 | "Hydro Flask Garrafa de Boca Larga 32oz em Aço Inoxidável..." — $34.95 | Hydro Flask Garrafa de Boca Larga 32oz | 1 | $34.95 |
| 7 | "Meias de Caminhada em Lã Merino 3-Par, Tamanho G, Ma..." — $24.99 | Meias de Caminhada em Lã Merino 3-Par | 1 | $24.99 |
| — | Subtotal → Envío → Total do pedido | Reconhecidas corretamente como linhas de resumo, não como itens extras | ||
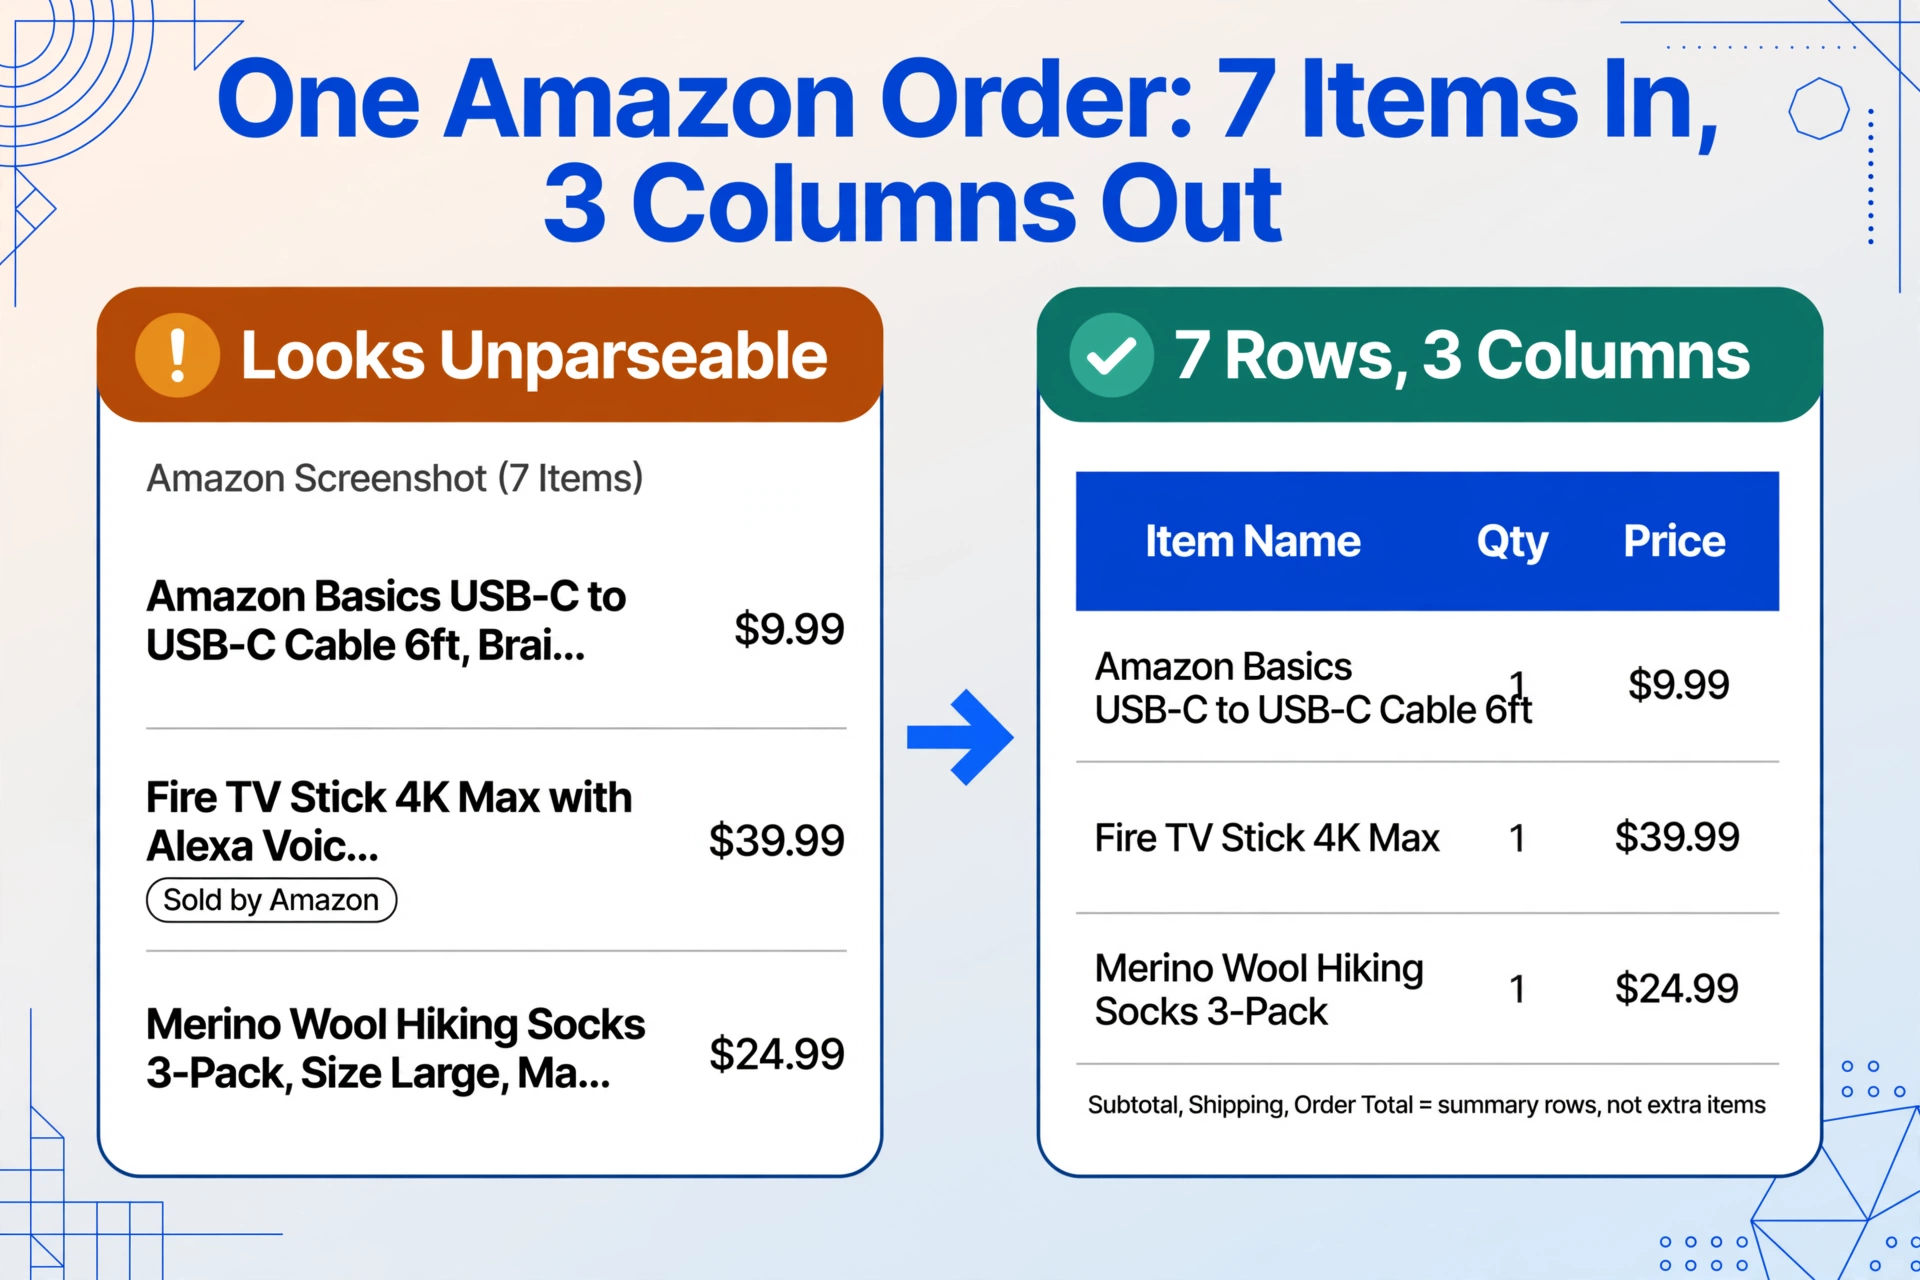
Observe o que aconteceu com cada desafio:
- Linhas cinzas — cada limite de linha foi identificado pelo separador visual entre os itens. O VLM as usou como marcadores confiáveis de linha.
- Nomes truncados — as linhas 2, 3, 4 e 7 têm nomes de produtos visivelmente encurtados terminando com "...". A IA ainda associou corretamente cada preço e quantidade à sua linha de origem, porque a relação espacial (qual texto está em qual posição vertical na página) era inequívoca.
- Selos de terceiros — o rótulo "Vendido por Amazon" da linha 3 foi reconhecido como um subelemento do item 3, não como um registro separado.
- Quantidade na mesma linha — o "Qty 2" da linha 4 foi lido e atribuído corretamente ao carregador Anker, e a IA entendeu que os $14.99 eram o preço por unidade, não o total de duas unidades.
- Linhas de resumo — Subtotal, Envío e Total do pedido foram corretamente excluídos da lista de itens. Eles são claramente distintos em formatação e posição, e o VLM os reconheceu como informações de nível de resumo.
O resultado é uma tabela limpa de sete linhas — exatamente o que você deseja se estiver acompanhando gastos, dividindo custos com um colega de quarto ou registrando um pedido para fins comerciais.
O Que Isso Significa para Seu Fluxo de Trabalho
A demonstração concreta acima prova uma coisa: a bagunça visual de uma captura de tela da Amazon com vários itens não é um obstáculo para o tipo certo de ferramenta de extração. As linhas cinzas, a truncagem e os selos de vendedor — esses são ruídos superficiais que um VLM enxerga facilmente.
O que muda quando você consegue extrair dados de itens de linha de qualquer captura de tela de pedido da Amazon de forma confiável?
Você para de tratar cada captura de tela como uma tarefa manual de entrada de dados. Em vez de abrir a página do pedido da Amazon, digitar os itens em uma planilha célula por célula e verificar os números, você envia a captura de tela para o ImageToTable.ai, informa quais colunas precisa e obtém a tabela em segundos. Sete linhas que levariam de 2 a 3 minutos para digitar manualmente são extraídas em menos de 10 segundos.
O cenário recorrente se torna o valioso. Uma captura de tela é trivial — você poderia digitá-la. Mas e o pedido mensal da Amazon para suprimentos domésticos? O revendedor que faz pedidos semanais em diferentes contas da Amazon? O contador freelancer que recebe recibos da Amazon de cinco clientes? Em escala — uma dúzia ou mais de pedidos com vários itens por semana — a entrada manual se torna um grande desperdício de tempo. A extração automatizada torna isso sustentável.
Você pode combinar dados extraídos com outras fontes. As colunas Nome do item, Quantidade e Preço podem ir para a mesma planilha que confirmações de pagamento, faturas de fornecedores ou relatórios de despesas. Se você já usa o ImageToTable.ai para extrair dados de outros tipos de documento, adicionar pedidos da Amazon com vários itens ao mesmo fluxo de trabalho é apenas mais um formato de entrada que o mesmo sistema processa.
Para um guia passo a passo completo sobre como fazer isso com uma ferramenta real, consulte o artigo complementar Amazon Orders with Multiple Items: How to Extract Each Item Name, Quantity, and Price from a Single Screenshot. Esse artigo aborda o fluxo de trabalho prático — este existe para resolver a questão de saber se isso é sequer possível em primeiro lugar.
Perguntas Frequentes
E se a captura de tela vier do aplicativo móvel da Amazon em vez de um navegador de desktop? O layout fica diferente?
A página de resumo do pedido no aplicativo móvel tem um layout um pouco diferente — os itens são empilhados verticalmente com fontes menores e espaçamento mais apertado, e as linhas separadoras cinzas são mais finas. Mas a estrutura visual central é a mesma: cada item ocupa uma região distinta de linha com seu nome, quantidade e preço. A IA visual lida com ambos os formatos porque lê a página de forma holística, em vez de depender de posições fixas de pixels. Você pode misturar capturas de tela móveis e de desktop no mesmo lote e a extração ainda será alinhada corretamente.
A IA consegue distinguir entre preço unitário e preço total quando várias quantidades são pedidas?
Sim. Quando uma linha mostra "Quantidade 2" e um preço de $14.99, a IA reconhece o $14.99 como o preço unitário — não o total para duas unidades — com base em como a Amazon normalmente exibe essas informações na página de resumo do pedido. Se você precisar do total da linha como uma coluna calculada ($29.98 = 2 × $14.99), você pode definir uma regra de coluna calculada que multiplica a quantidade pelo preço unitário durante a extração. O sistema suporta isso nativamente, sem nenhum pós-processamento no Excel.
Pedidos da Amazon Business com informações de imposto funcionam da mesma forma?
Sim. Pedidos da Amazon Business adicionam uma linha de Imposto sobre Vendas e às vezes mostram detalhes de isenção de imposto, mas a estrutura subjacente de itens de linha é idêntica a um pedido pessoal da Amazon. As linhas extras relacionadas a impostos são tratadas como metadados — elas não vão poluir sua lista de itens. Se você precisar do valor do imposto como uma coluna separada, você pode adicionar "Imposto sobre Vendas" como nome de coluna e a IA vai extraí-lo de onde quer que apareça na página.
Posso processar várias capturas de tela de pedidos da Amazon de uma vez, ou precisa ser uma de cada vez?
Várias de uma vez. ImageToTable.ai é projetado como um sistema de Processamento Prioritário em Lote — você envia várias capturas de tela, e a IA as processa juntas, produzindo uma única tabela unificada. Os itens de cada captura aparecem como linhas separadas, e se você precisar rastrear quais itens vieram de qual pedido, você pode adicionar uma coluna personalizada (como "ID do Pedido" ou "Fonte da Captura") e a IA vai identificar o número do pedido na página.
E quanto a capturas de tela que mostram apenas parte da lista de itens — a IA ainda consegue extrair o que está visível?
Sim. Se apenas seis de sete itens estiverem visíveis na captura de tela, a IA extrai esses seis. Ela não precisa de uma página completa ou perfeitamente enquadrada para funcionar. A limitação é que ela só consegue extrair o que está na imagem que você fornece — se um item estiver totalmente cortado, ele não aparecerá na saída. Para pedidos longos que abrangem várias rolagens, tire capturas de tela separadas de cada seção e agrupe-as.