Une capture d'écran de commande Amazon multi-articles
ressemble à un désordre — Voici pourquoi vous pouvez quand même en extraire des données propres
Vous avez acheté sept articles dans une seule commande Amazon. La page de reçu affiche un bloc dense d'articles, chacun séparé par une fine ligne grise. Certains noms de produits se terminent par des points de suspension. Quelques articles affichent « Vendu par » en dessous, ajoutant du texte supplémentaire qui n'appartient pas à la ligne suivante. L'ensemble semble conçu pour contrecarrer toute tentative d'extraction automatique.
Points clés à retenir
- Sept articles Amazon empilés derrière des lignes de séparation grises ressemblent à une corvée de saisie de données — mais chaque ligne grise, nom tronqué et badge de vendeur qui rend la page chaotique donne à l'IA visuelle une carte complète des lignes avant même qu'elle ne lise un seul caractère.
- L'OCR traditionnel fragmente la page à chaque ligne grise car il les traite comme des limites de document, mais un modèle de langage visuel voit toute la capture d'écran d'un seul coup et utilise ces mêmes lignes comme vous utilisez les perforations d'un reçu — pour compter les articles, pas pour les découper.
- Plus la capture d'écran de commande Amazon est dense, plus l'extraction devient rapide et précise — le désordre visuel n'est pas du bruit pour l'IA visuelle, c'est un surplus de repères structurels gratuits qui rendent la mise en page totalement sans ambiguïté.
Pourquoi une capture d'écran Amazon multi-articles semble désespérée au premier abord
Nommons les éléments précis qui rendent ce type de capture d'écran apparemment impossible à analyser automatiquement. Ce ne sont pas des problèmes vagues — chacun est un obstacle concret sur lequel butent les méthodes d'extraction traditionnelles.
Lignes de séparation grises. Amazon trace une fine ligne grise horizontale entre chaque ligne d'article sur la page de récapitulatif de commande. Pour un moteur OCR traditionnel — qui fonctionne en détectant des zones de texte, puis en essayant de les assembler en groupes cohérents — ces lignes ressemblent à des frontières. Il traite chaque article comme une zone de texte isolée, et lorsqu'un élément est divisé en zones isolées, le moteur doit deviner comment elles se rapportent les unes aux autres. Le prix au bord droit de la zone deux appartenait-il à la zone deux ou à la zone trois ? L'OCR n'a aucun moyen de le savoir.
Noms de produits tronqués. « Logitech G502 X PLUS LIGHTSPEED Wireless Gaming Mouse with HERO 25K Sensor... » — mais sur la capture d'écran, on voit « Logitech G502 X PLUS LIGHTSP... » suivi de points de suspension. Ce texte tronqué perturbe tout système qui repose sur la lecture d'une ligne complète de gauche à droite. Un analyseur basé sur les lignes voit le nom abrégé, puis ne sait pas où commence la colonne suivante car la ligne s'arrête simplement au milieu d'un mot.
Badges de vendeurs tiers. Les articles qui ne sont pas vendus directement par Amazon affichent « Vendu par [Nom du vendeur] » dans une police plus petite sous le nom du produit. Ce texte se situe entre deux articles mais appartient à la ligne précédente, pas à la suivante. Une extraction naïve le traite comme une ligne distincte ou, pire, l'ajoute aux données de l'article suivant. Dans les deux cas, le résultat est incorrect.
Alignement de la quantité et du prix. Sur la page de commande d'Amazon, la quantité est affichée à côté du nom de l'article — « Quantité : 1 » — tandis que le prix se trouve à l'extrême droite. L'OCR traditionnel extrait le prix comme un nombre isolé flottant dans la marge droite et doit deviner à quel article il appartient. Lorsque sept prix et sept noms d'articles sont dispersés dans le même champ visuel, le problème de correspondance s'aggrave à chaque ligne supplémentaire.
Aucun de ces problèmes n'est rédhibitoire individuellement. Mais ensemble, ils transforment une capture d'écran dense multi-articles en exactement le genre de défi d'extraction de données qui fait dire aux gens « c'est trop compliqué, je vais juste le saisir à la main ».
La différence entre lire des pixels et lire une page
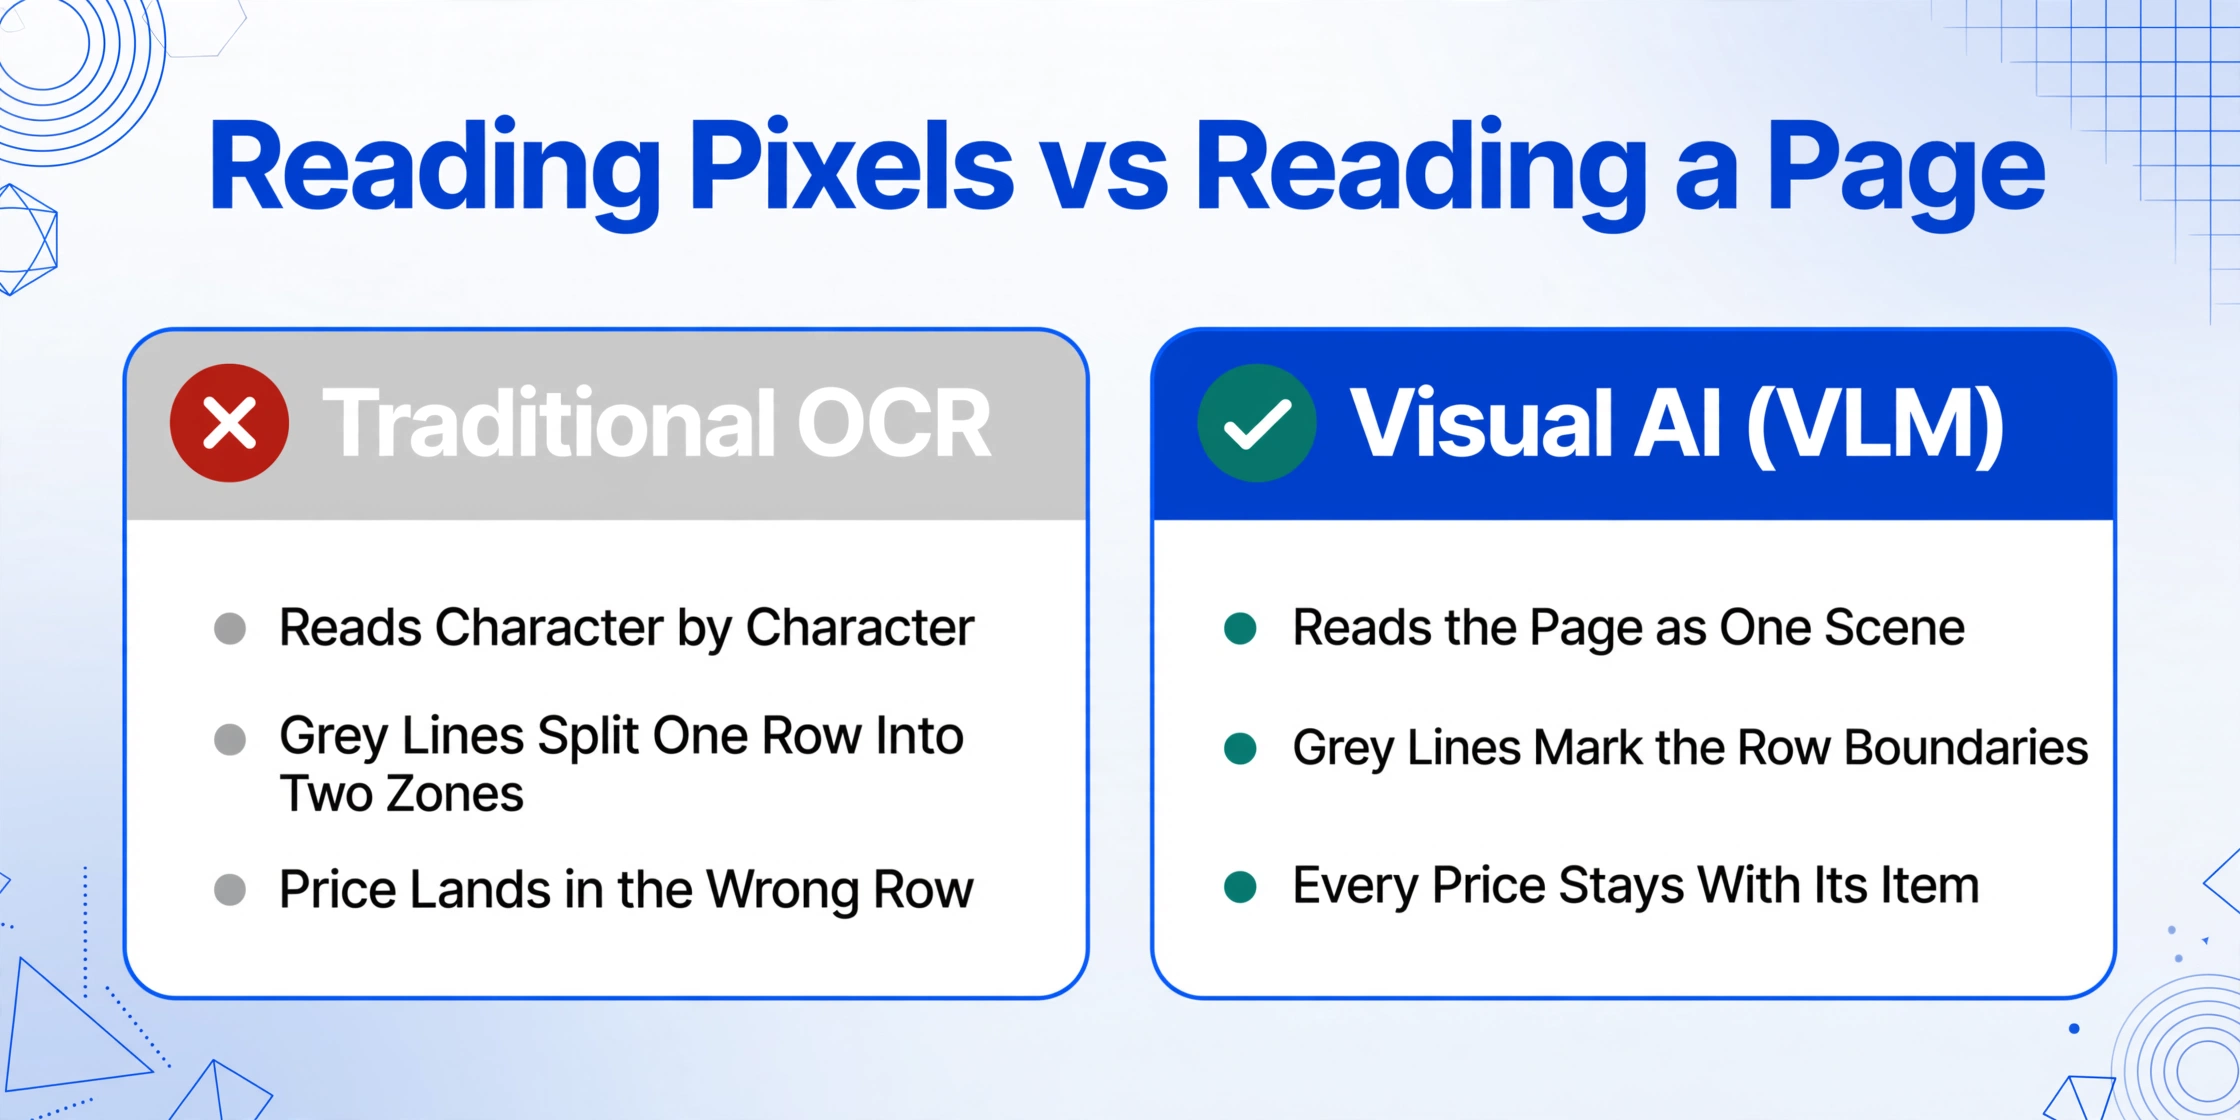
L'OCR traditionnel et l'IA visuelle abordent la même image de manières fondamentalement différentes, et cette différence compte surtout lorsque l'entrée est visuellement dense.
Un moteur OCR fonctionne caractère par caractère — il détecte les formes de lettres, les assemble en mots, regroupe les mots en blocs de texte par proximité, puis tente d'inférer une structure à partir de ces blocs. Lorsque les indices visuels dont il dépend (limites de colonnes claires, lignes de texte ininterrompues, espacement cohérent) sont absents ou ambigus, le résultat est des données brouillées.
Un modèle de langage visuel (VLM) fonctionne différemment. Il traite la capture d'écran entière comme une scène cohérente — de la même manière que vous ou moi regardons une photographie et comprenons immédiatement quels objets sont proches les uns des autres, lesquels sont séparés, et comment ils se rapportent spatialement. Les lignes grises ne sont pas des bordures de zones de texte — ce sont des séparateurs visuels, comme la marge entre les colonnes d'un journal. Les noms tronqués ne sont pas des lignes incomplètes — ce sont des titres qui s'étendent au-delà du cadre visible, et le VLM peut toujours associer les données visibles à la bonne ligne.
ImageToTable.ai utilise ce type d'IA visuelle. Lorsque vous lui fournissez une capture d'écran Amazon multi-articles et lui demandez trois colonnes — Nom de l'article, Quantité et Prix — il n'essaie pas d'analyser la page comme le ferait un scanner de feuille de calcul. Il regarde l'image de manière holistique, identifie chaque région de ligne distincte en repérant les limites visuelles (les lignes grises sont un signal fort, pas une distraction), puis mappe le texte de chaque région vers les colonnes demandées.
La ligne de séparation grise — qui perturbe l'OCR traditionnel — devient un ancrage structurel fiable pour l'extraction basée sur VLM. Le système peut voir : « cette ligne grise marque la fin de la première ligne. Tout ce qui est au-dessus appartient à l'article un. Tout ce qui est en dessous, jusqu'à la prochaine ligne grise, appartient à l'article deux. » Il ne devine pas — il lit la mise en page de la même manière qu'un lecteur humain, mais à la vitesse d'une machine.
La même logique s'applique pour distinguer les lignes d'articles des totaux de page. « Sous-total », « Expédition », « Total de la commande » — ces éléments se trouvent sous la dernière ligne d'article, souvent formatés différemment (en gras, ou avec un arrière-plan différent). Le VLM les reconnaît comme des lignes de synthèse, pas comme des produits supplémentaires. Il n'essaie pas de les forcer dans la colonne Nom de l'article.
Un exemple concret : 7 articles sur une seule commande Amazon
Prenons un exemple concret. Imaginez une capture d'écran réelle d'une page de confirmation Amazon — une seule commande avec sept articles différents. Voici ce que contient chaque ligne et comment l'extraction se déroule.
| Ligne | Ce que montre la capture d'écran | Nom de l'article extrait | Quantité | Prix |
|---|---|---|---|---|
| 1 | "Kindle Paperwhite (11e génération) — Quantité 1 — 129,99 $" | Kindle Paperwhite (11e génération) | 1 | $129.99 |
| 2 | "Amazon Basics USB-C vers USB-C Cable 6ft, Brai..." — 9,99 $ | Amazon Basics USB-C vers USB-C Cable 6ft | 1 | $9.99 |
| 3 | "Fire TV Stick 4K Max avec Alexa Voic..." + badge "Vendu par Amazon" | Fire TV Stick 4K Max | 1 | $39.99 |
| 4 | "Anker 20W USB-C Charger, Compact Fast Cha..." — Quantité 2 — 14,99 $ | Anker 20W USB-C Charger | 2 | $14.99 |
| 5 | "Samsung T7 Portable SSD 1TB, Up to 1050MB/s..." — 99,99 $ | Samsung T7 Portable SSD 1TB | 1 | $99.99 |
| 6 | "Hydro Flask 32oz Wide Mouth Stainless Steel..." — 34,95 $ | Hydro Flask 32oz Wide Mouth | 1 | $34.95 |
| 7 | "Merino Wool Hiking Socks 3-Pack, Size Large, Ma..." — 24,99 $ | Merino Wool Hiking Socks 3-Pack | 1 | $24.99 |
| — | Sous-total → Expédition → Total de la commande | Correctement reconnues comme des lignes de synthèse, pas comme des articles supplémentaires | ||
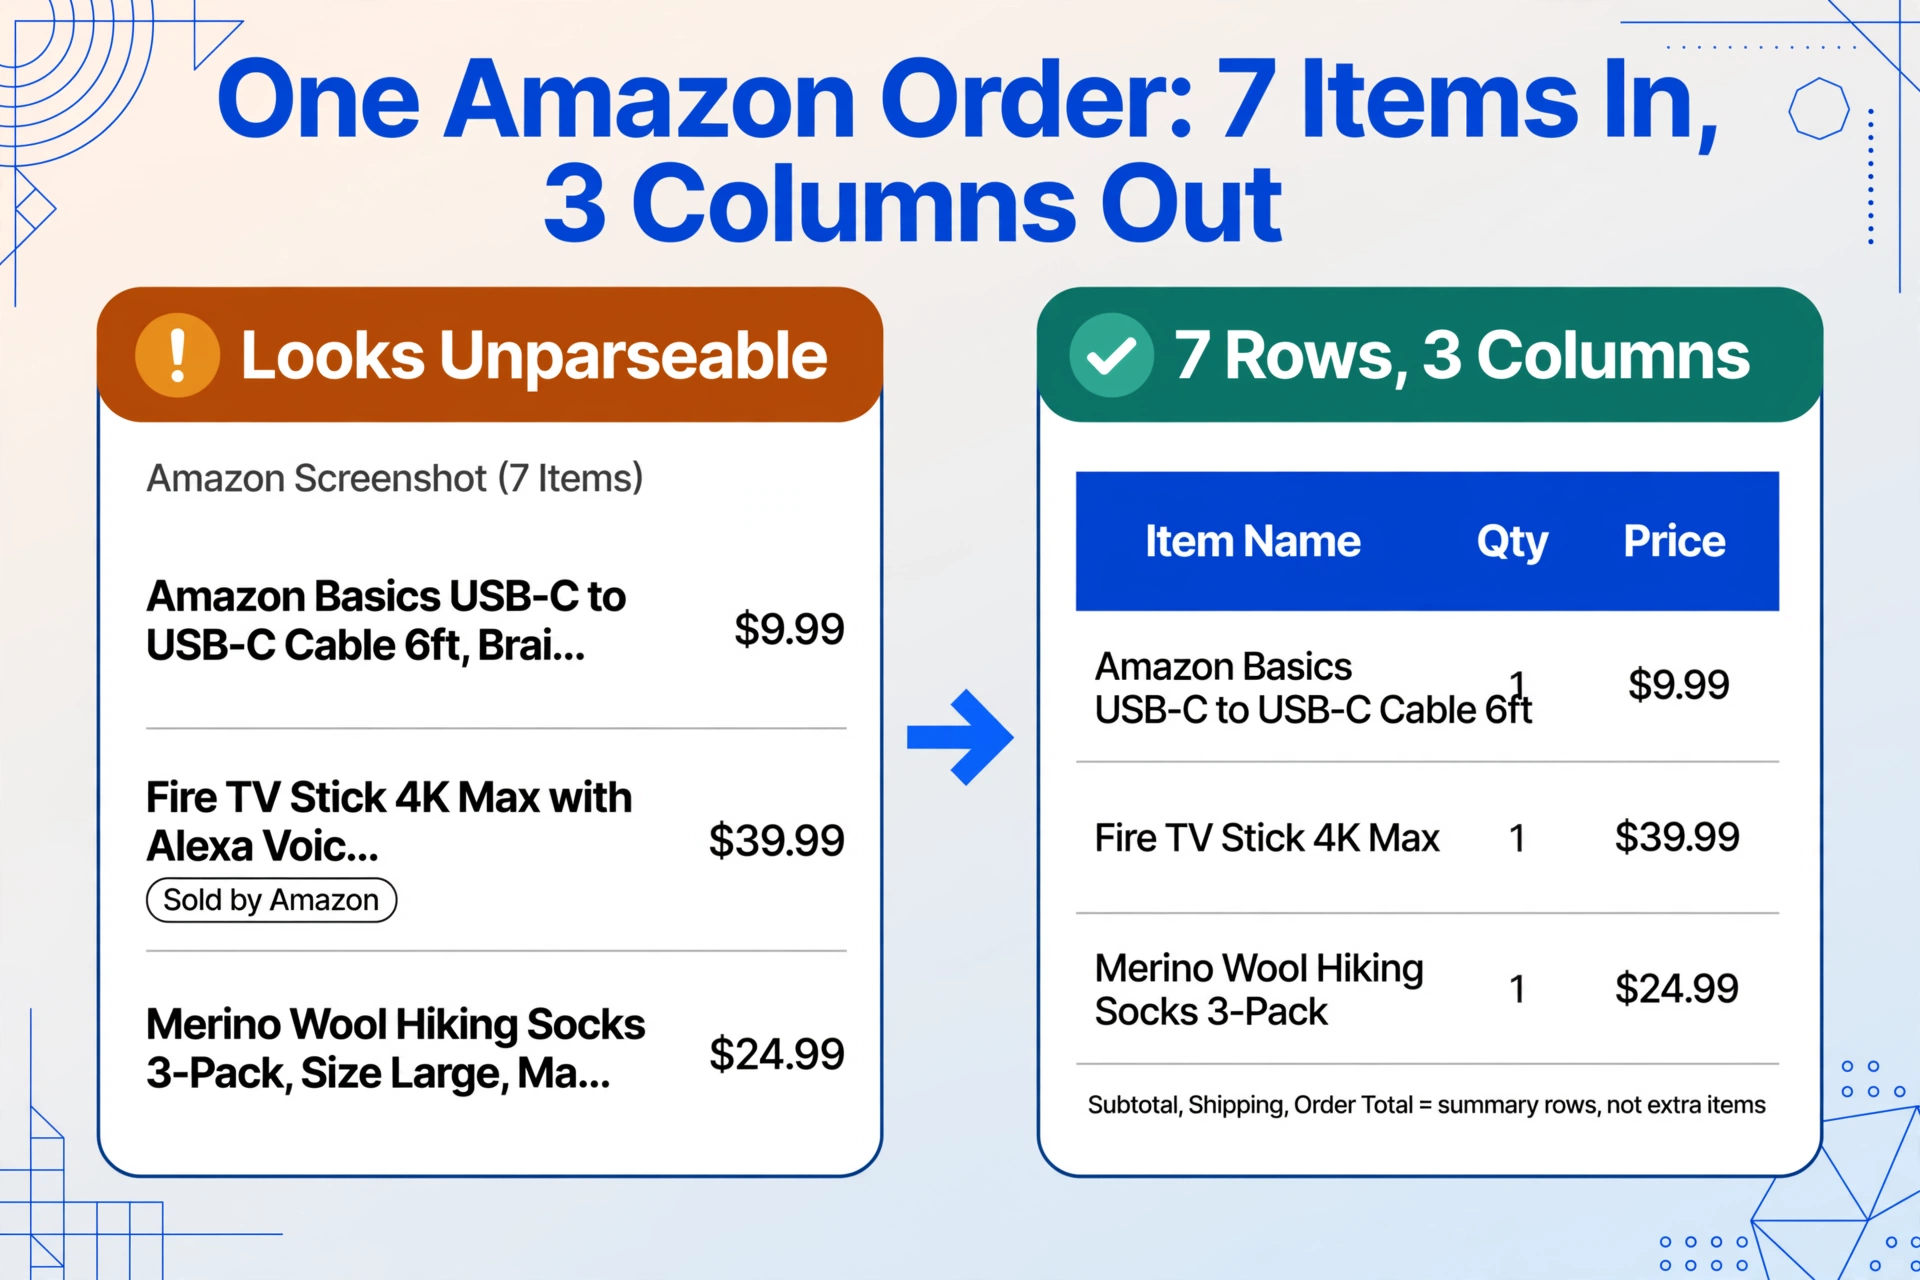
Remarquez ce qui s'est passé avec chaque défi :
- Lignes grises — chaque limite de ligne a été identifiée grâce au séparateur visuel entre les articles. Le VLM les a utilisées comme marqueurs de ligne fiables.
- Noms tronqués — les lignes 2, 3, 4 et 7 présentent toutes des noms de produits visiblement raccourcis se terminant par « ... ». L'IA a néanmoins correctement associé chaque prix et quantité à sa ligne parente, car la relation spatiale (quel texte se trouve à quelle position verticale dans la page) était sans ambiguïté.
- Badges de vendeurs tiers — le libellé « Vendu par Amazon » de la ligne 3 a été reconnu comme un sous-élément de l'article 3, et non comme un enregistrement distinct.
- Quantité en ligne — la mention « Quantité 2 » de la ligne 4 a été correctement lue et attribuée au chargeur Anker, et l'IA a compris que les 14,99 $ correspondaient au prix unitaire, et non au total pour deux articles.
- Lignes de synthèse — Sous-total, Expédition et Total de la commande ont été correctement exclus de la liste des articles. Leur format et leur position les distinguent clairement, et le VLM les a reconnus comme des informations de niveau méta.
Le résultat est un tableau propre de sept lignes — exactement ce que vous souhaiteriez si vous suiviez vos dépenses, partagiez des coûts avec un colocataire ou enregistriez une commande pour vos dossiers professionnels.
Ce que cela signifie pour votre flux de travail
La démonstration concrète ci-dessus prouve une chose : le désordre visuel d'une capture d'écran Amazon multi-articles n'est pas un obstacle pour le bon type d'outil d'extraction. Les lignes grises, les troncatures et les badges de vendeurs — ce sont des bruits de surface que le VLM traverse facilement.
Qu'est-ce qui change lorsque vous pouvez extraire de manière fiable les données de ligne de n'importe quelle capture d'écran de commande Amazon ?
Vous cessez de traiter chaque capture d'écran comme une tâche de saisie manuelle ponctuelle. Au lieu d'ouvrir la page de commande Amazon, de saisir les articles dans un tableur cellule par cellule et de vérifier les chiffres, vous téléchargez la capture d'écran sur ImageToTable.ai, vous lui indiquez les colonnes dont vous avez besoin, et vous obtenez le tableau en quelques secondes. Sept lignes qui prendraient 2 à 3 minutes à saisir manuellement sont extraites en moins de 10 secondes.
Le scénario récurrent devient le plus précieux. Une seule capture d'écran est triviale — vous pourriez la saisir. Mais qu'en est-il de la commande mensuelle Amazon de fournitures ménagères ? Du revendeur qui passe des commandes hebdomadaires sur différents comptes Amazon ? Du comptable indépendant qui reçoit des reçus Amazon de cinq clients ? À grande échelle — une douzaine ou plus de commandes multi-articles par semaine — la saisie manuelle devient une perte de temps considérable. L'extraction automatisée rend cela durable.
Vous pouvez combiner les données extraites avec d'autres sources. Les colonnes Nom de l'article, Quantité et Prix peuvent être intégrées au même tableur que les confirmations de paiement, les factures fournisseurs ou les rapports de dépenses. Si vous utilisez déjà ImageToTable.ai pour extraire des données d'autres types de documents, ajouter les commandes Amazon multi-articles au même flux de travail n'est qu'un format d'entrée supplémentaire que le même système gère.
Pour un guide étape par étape complet sur la façon de procéder avec un outil réel, consultez l'article complémentaire Commandes Amazon multi-articles : comment extraire le nom, la quantité et le prix de chaque article à partir d'une seule capture d'écran. Cet article détaille le flux de travail pratique — celui-ci existe pour répondre à la question de savoir si c'est même possible en premier lieu.
Questions fréquemment posées
Que se passe-t-il si la capture d'écran provient de l'application mobile Amazon au lieu d'un navigateur de bureau ? La mise en page est-elle différente ?
La page de résumé de commande de l'application mobile a une mise en page légèrement différente : les articles sont empilés verticalement avec des polices plus petites et un espacement plus serré, et les lignes de séparation grises sont plus fines. Mais la structure visuelle de base est la même : chaque article occupe une zone de ligne distincte avec son nom, sa quantité et son prix. L'IA visuelle gère les deux formats car elle lit la page dans son ensemble plutôt que de dépendre de positions de pixels fixes. Vous pouvez mélanger des captures d'écran mobiles et de bureau dans le même lot et l'extraction s'alignera toujours correctement.
L'IA peut-elle faire la distinction entre le prix unitaire et le prix total lorsque plusieurs quantités sont commandées ?
Oui. Lorsqu'une ligne affiche « Quantité 2 » et un prix de 14,99 $, l'IA reconnaît que 14,99 $ est le prix unitaire — et non le total pour deux unités — en se basant sur la façon dont Amazon affiche généralement ces informations sur la page de résumé de commande. Si vous avez besoin du total de la ligne comme colonne calculée (29,98 $ = 2 × 14,99 $), vous pouvez définir une règle de colonne calculée qui multiplie la quantité par le prix unitaire lors de l'extraction. Le système prend en charge cela nativement, sans aucun post-traitement dans Excel.
Les commandes Amazon Business avec informations fiscales fonctionnent-elles de la même manière ?
Oui. Les commandes Amazon Business ajoutent une ligne de taxe de vente et affichent parfois des détails d'exonération fiscale, mais la structure sous-jacente des articles est identique à celle d'une commande Amazon personnelle. Les lignes supplémentaires liées à la taxe sont traitées comme des métadonnées — elles n'encombreront pas votre liste d'articles. Si vous avez besoin du montant de la taxe comme colonne distincte, vous pouvez ajouter « Taxe de vente » comme nom de colonne et l'IA l'extraira où qu'elle apparaisse sur la page.
Puis-je traiter plusieurs captures d'écran de commandes Amazon à la fois, ou faut-il le faire une par une ?
Plusieurs à la fois. ImageToTable.ai est conçu comme un système de traitement par lots en priorité : vous téléchargez plusieurs captures d'écran, et l'IA les traite ensemble, produisant un tableau unifié unique. Les articles de chaque capture apparaissent comme des lignes distinctes, et si vous devez savoir quels articles proviennent de quelle commande, vous pouvez ajouter une colonne personnalisée (comme « ID de commande » ou « Source de la capture ») et l'IA identifiera le numéro de commande à partir de la page.
Et si la capture d'écran ne montre qu'une partie de la liste d'articles — l'IA peut-elle quand même extraire ce qui est visible ?
Oui. Si seulement six des sept articles sont visibles dans la capture d'écran, l'IA extrait ces six articles. Elle n'a pas besoin d'une page complète ou parfaitement cadrée pour fonctionner. La limite est qu'elle ne peut extraire que ce qui se trouve dans l'image que vous lui fournissez — si un article est entièrement coupé, il ne sera pas dans le résultat. Pour les commandes longues qui s'étendent sur plusieurs défilements, prenez des captures d'écran séparées de chaque section et regroupez-les.