10-KがPDFパーサーを破綻させる理由、
そして保持すべきもの
10-Kには4つか5つの財務諸表、60ページに及ぶこともある注記セクション、そして組版担当が選んだ任意の列形式でレイアウトされた経営陣の議論が含まれます。数字自体は簡単な部分です。この提出書類を機械で読むのが難しいのは、各数値が数字ではない3つの要素との関係においてのみ意味を持つからです。それは、その数値が属する財務諸表、その上にある対象期間の列、そしてグリッドの上部で一度だけ宣言される単位です。
一般的なPDFパーサーは、ページをテキストのストリームとして、表をセルの矩形として扱います。10-Kはそのどちらでもなく、そのギャップは後に、完全に見えて何とも照合できないスプレッドシートとして現れます。
主なポイント
- PDFパーサーは10-Kのすべての数字を正しく読み取っても、1,000倍ずれた数値を返すことがあります。
- その誤りはグリッドの上に一度だけ印刷されたキャプションに隠れているため、セル自体はごく普通に見えます。
- 財務諸表、対象期間、単位、ページを示す4つの列があれば、すべての行を数秒で確認できます。
この記事の読者は、PDFを手にしている人であり、検索パイプラインを構築する人ではありません。株式アナリストは同業他社の財務諸表を比較シートに取り込み、財務データチームはデータウェアハウスに投入し、監査人は開示された数値をサンプリングします。いずれの場合も、ドキュメントは投資家向け広報ページ、顧客からのメール、または提出代行会社から届いたものであり、SECの提出システムであるEDGAR上に別の形式で存在するもののレンダリングコピーです。以下では、そのコピーがどこで構造を失うのか、そして保持する価値のある抽出結果を得るために何を引き出す必要があるのかを説明します。
10-Kは複数の財務諸表を含む提出書類であり、1つの表ではない
10-Kの抽出で最初に判断すべきは、ある行がどの財務諸表に属するかであり、汎用のPDFパーサーはこの問いを決して発しません。Form 10-Kは4つのパートと項目のリストで構成されています。Item 8には監査済みの財務諸表と注記が、Item 7には経営陣の議論が、Item 1Aにはリスク要因が含まれます。Item 8の中だけでも4つか5つの財務諸表があり、それぞれに独自のタイトル、独自の単位行、独自の合計値のセットがあり、包括利益が独立して表示されるか損益計算書内に含まれるかによって異なります。
これが重要なのは、「Total」はそれ自体では何も特定しないラベルだからです。どの財務諸表にも合計行があり、いくつかは同じ言葉を使っています。総資産、総負債、総資本、売上高合計。どの財務諸表から出力されたかを知らずに合計を読んでも、それが何と等しくなるべきか、何と比較すべきか、あるいはワークブックの貸借対照表ブロックに属するのかキャッシュ・フロー・ブロックに属するのかを判断できません。読み取り順に返すパーサーは、ラベルは正しく返しますが、意味はまったく返しません。
財務諸表の境界が重要である2つ目の理由があります。単位の宣言は各グリッドの上に一度だけ印刷されるため、貸借対照表が千単位である一方、3ページ後の注記が百万単位であることがあります。財務諸表は単位のスコープであり、それが計算のスコープでもあります。境界を間違えると、乗数が2つの異なるスコープにまたがって適用されます。
ファイル自体についての1つの事実は早めに確定しておく価値があります。SECが公開するコピーはインラインXBRLが埋め込まれたHTMLであり、財務数値はページ自体の中の機械可読なタクソノミーでタグ付けされており、ほとんどの人が作業するPDFは企業が投稿したレンダリングか、印刷された年次報告書のスキャンです。したがって、ここでの10-Kパーシングの仕事は視覚的なコピーの構造を復元することであり、SEC提出書類の抽出は文字認識の問題である前に、主にレイアウトの問題です。
そのレイアウトは企業間で安定しておらず、実際の難しさのほとんどはそこにあります。実務家はそれを辛抱強く説明しません:「SEC提出書類からの表抽出は、企業間、さらには年ごとにも書式が大きく異なるため、本当に厄介です。」(r/fintech)。ある提出者の貸借対照表で機能するルールは、次の提出者用に書き直す必要があり、同じ企業が監査人を変更したり新しい基準を採用したりするたびに、また書き直す必要があります。
2つの財務諸表が同じページを共有し、2つ目は1つ目の最終行の下から始まることがある
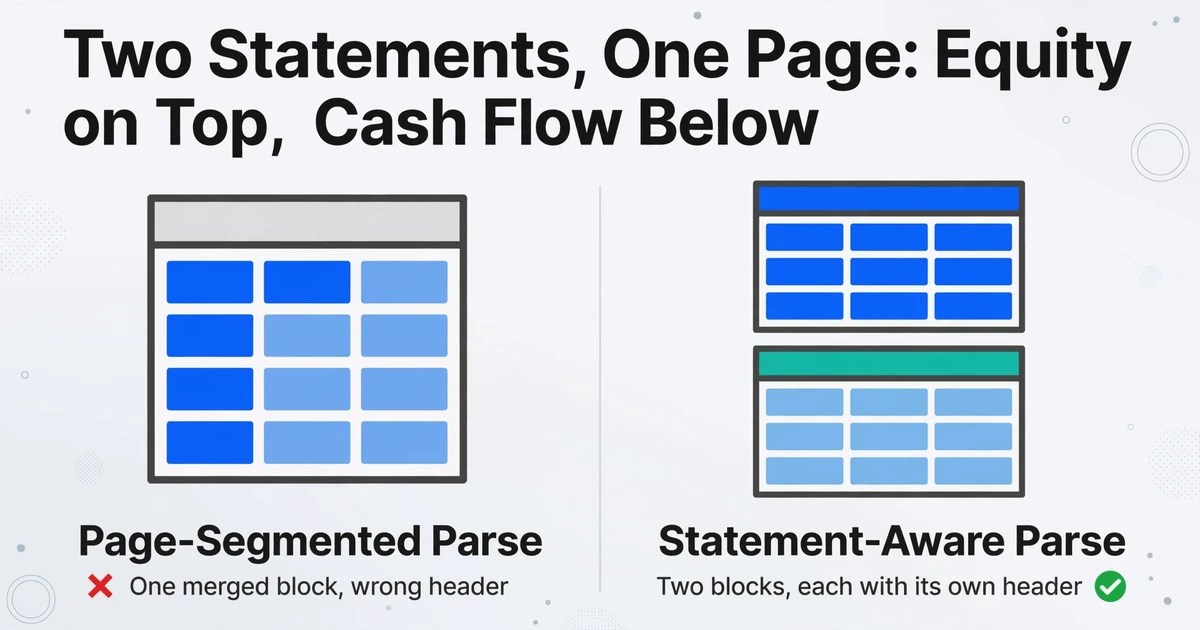
提出書類の組版担当者は、すべての財務諸表に新しいページを割り当てるわけではありません。ドキュメントの肥大化を防ぐため、株主資本等変動計算書の最終行がページ上部に位置し、そのすぐ下から連結キャッシュ・フロー計算書が独自のタイトルとヘッダー行を伴って始まることがよくあります。
ページ単位で分割するパーサーは、1つのブロックを返します。ブロックは読者が見る順序で内部的に並んでいるため、一見すると壊れているようには見えません。株主資本の行が上部に、キャッシュ・フローの行が下部にあり、すべての数値がページ上の正しい位置にあります。問題はテーブルにあります。2つの財務諸表の行が1つのヘッダーを共有し、そのヘッダーはパーサーが紐付けた方の財務諸表のものになります。累積その他の包括利益などの株主資本の列がキャッシュ・フローの数値の上に来てしまい、キャッシュ・フローの小計が本来属するはずのない列を引き継ぎます。
この失敗では行数はほぼ正しいままになるため、一見しただけでは気づかず、最初の照合で初めて失敗します。
下流の症状は具体的です。営業キャッシュ・フローは純利益から始まり現金の増減で終わるはずで、計算書にはその両端が記載されています。ブロックが結合されると、チェックが実行できないか、実際には誤ったテーブルにある行で失敗します。アナリストは照合の不一致を見て、読み取り誤った数字を探し始めますが、数字は正しく、行が誤った財務諸表にあるのです。
ページをまたぐ表で失われるのは数値ではなくヘッダー
58ページの下部付近で始まる貸借対照表が59ページに続き、継続ページでは財務諸表のタイトルが「(continued)」付きで繰り返されることがありますが、列見出しは欠落していることが少なくありません。数値は続いても、その上にある対象期間は続きません。
各ページを独立して解析すると、2つの表が得られます。1つ目はヘッダーと半分の行を持ち、2つ目は残りの行を持ちますが対象期間の割り当てがまったくありません。親切心からそうするパーサーは、継続ページで最も近いヘッダーを採用しますが、それは下方で始まるまったく別の表のものである可能性があり、その結果、行に誤った年度が付与されます。いずれにせよ、数値は正しく読み取られ、誤った列に格納されます。
ページをまたぐ構造は例外的なケースではなく通常のケースです。FinMMDocRは、平均50.8ページの837ドキュメントにわたる専門家作成の財務質問1,200件のベンチマークですが、質問の65%が複数ページにまたがる根拠を必要とし、平均2.4ページの根拠ページを持ちます。同じ研究のエラー分析は、算術のせいにする人にとってより示唆的です。サンプリングされた100件の失敗のうち78件はドキュメント理解の失敗、つまりモデルが根拠を特定または読み取れなかったことを意味し、計算エラーはわずか5件でした(Tang et al., FinMMDocR, AAAI 2026)。
実務上の帰結は、ページ単位の抽出では財務諸表自身のチェックを実行できないということです。資産が負債と資本の合計に等しいのは、すべての資産行とすべての負債行が対象期間を伴って残っている場合に限られます。表の半分はそれ自体と照合できず、こうしてラベルのない継続ページが、誰も検証できないスプレッドシートへと変わってしまいます。
対象期間は結合されたヘッダーセルにあり、結合セルはパーサーが最初に平坦化するもの
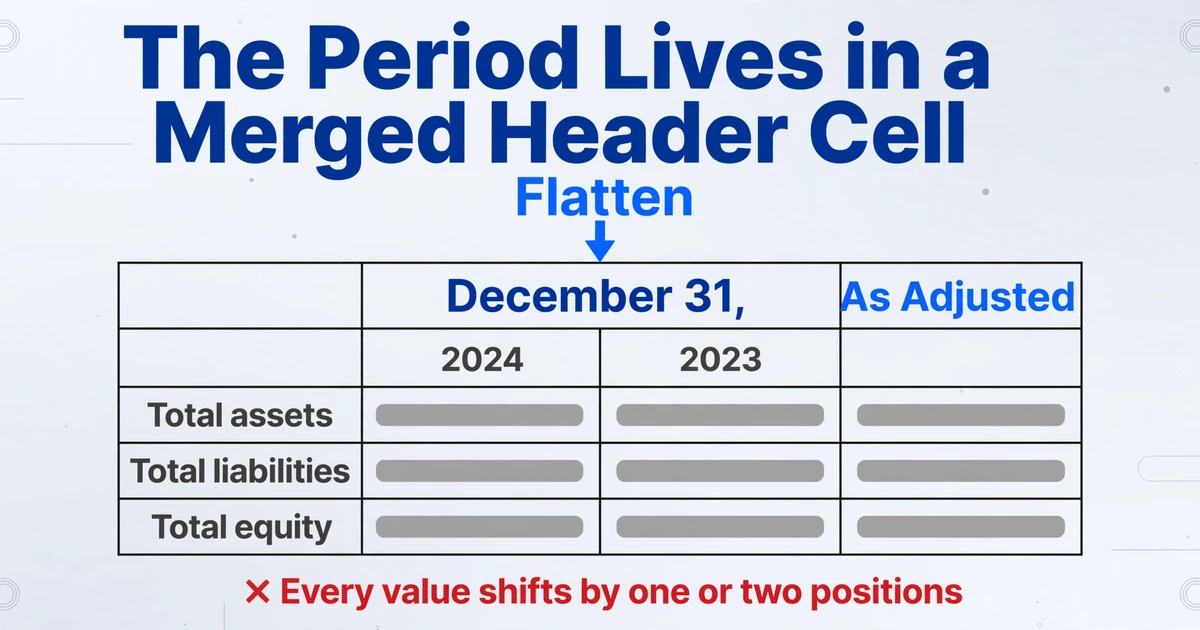
10-Kのヘッダーが年度ラベルの単一行であることはまれです。それは階層構造です。「December 31,」は2つの列にまたがり、その下に「2024」と「2023」があります。3つ目の列には「As Adjusted」があります。合併や会計年度の変更後、ヘッダーは罫線で区切られた「Successor」ブロックと「Predecessor」ブロックに分かれ、両側の対象期間は同じ長さではないため、ある列が11か月、次の列が12か月をカバーすることがあります。
この階層を平坦化することが、列の割り当てが誤る原因であり、「As Adjusted」列はそれがラベル欠落よりも深刻である理由を示しています。どちらの列も2024年を持ち得ます。一方は報告されたままの数値、もう一方は買収に伴うプロフォーマベースで修正された数値です。サブヘッダーを失えば、同じ名前の2つの列ができ、どちらがどちらか見分ける方法がなくなり、比較シートは報告数値と修正数値を密かに混在させることになります。
結合セルは第2の種類のエラーを生みます。1つのヘッダーセルが3つの列にまたがり、パーサーがそれを最初の列に押し込むと、その下のすべての値が左に2つずれます。数字は正しく、行ラベルも正しく、年度が誤っています。誤った列も依然として有効な数値であるため、セル内の何もそれを警告しません。
結合されたヘッダーセルはラベルではなく列の割り当てです。平坦化すると、その下のすべての値が移動します。
会計年度は、抽出では解決できないものの、少なくとも露呈させることはできる定義上の問題を追加します。2024 とラベル付けされた列は、1月に終わることも、6月に終わることも、あるいはカレンダーから数日ずれた 52/53 週の期間に終わることもあります。これを12月決算の同業他社と比較するのは、パースの誤りではなく分析の誤りであり、唯一の防御策は、4桁の数字ではなく完全な対象期間ラベル(「fiscal year ended 31 January 2024」)を保持することです。
注記参照は数値とともに移動し、数値から最初に取り除かれるもの
10-K では、必要な数値は財務諸表に載っているのに、その意味の理由は60ページ離れた注記にあることがよくあります。財務諸表はそれをマーカーで示します。「See Note 12」、上付きの 1、アスタリスク、または数値に対して印刷された括弧付きの「(1)」です。
数値パーサーは、そのマーカーが値の一部ではないため取り除きますが、その除去は予測可能な形で失敗します。1,234(1) と表示されたセルは、テキストレイヤーで上付き文字がどのように分離されているかによって、1,234、1,2341、または 1,234.1 として返ってくる可能性があります。読者を説明へ導くはずだったマークアップが、破損した数字として届くのです。
より微妙な失敗には、破損した文字が含まれていません。「Other, net」「Miscellaneous」「Other income (expense)」とラベル付けされた行は複数の項目を集計しており、その集計が分解されるのは注記においてです。その行を抽出すると、分解できない正しい数値が得られ、つまり「Other」に異なるものが含まれる同業他社と比較できません。方針も同じ問題を抱えています。ある費用が売上原価に属するのか、販売費及び一般管理費に属するのかは注記に記載されており、財務諸表の表面上の数字を一つも変えずに売上総利益率を変えてしまいます。
これは明確に述べておく価値のある境界です。抽出は「Note 12」を列の値として取り込み、レビュー担当者が正しいページへ移動できるようにすることができます。しかし、注記を解決したり、相互参照をたどったり、注記自体の表を取得したりはしません。その作業は提出書類を読む人に残ります。
MD&Aの読み順は列単位だが、テキスト抽出は行単位で読む
10-Kの叙述セクション、特にMD&Aは、1ページにより多くのテキストを収めるため2段または3段組で組まれることがよくあります。人間は左の列を下へ読み、次に右の列を読みます。テキスト抽出ツールは、文字がコンテンツストリームに現れる順序に従って、ページを横切って行単位で読みます。
その結果は、売上高に関する文が流動性に関する文の途中に混ざり込む交互配置の文章か、一方の列が二重に読まれ他方が脱落するかのどちらかです。どちらもデータエラーには見えないため、レビューを通過します。「売上総利益率が上昇した」と読める文が2つの異なる列から組み立てられ、実際の提出書類は逆のことを述べていたとき、初めてエラーになります。
ここは、PDF抽出が構造化データと競合するのではなく、その存在意義を得るセクションです。XBRLは数値にタグを付けますが、数値が動いた理由の説明、経営陣が挙げる価格圧力、来年失効する契約にはタグを付けません。提出書類を読む目的が数値を取得することではなく事業を理解することなら、叙述こそが重要な部分であり、読み順がすべてを決めます。
正しい抽出は数値ではない4つのフィールドを保持する
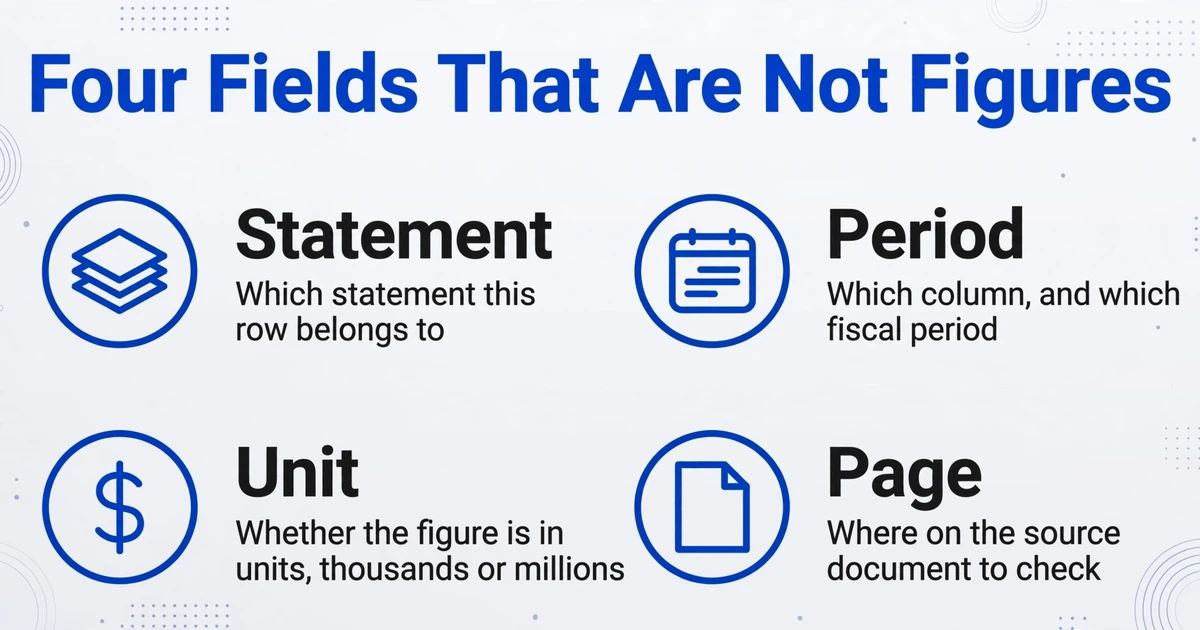
正しい10-K抽出は出所情報で測られます。すべての数値がどこから来たのかを依然として把握している必要があります。その役割を担う4つのフィールドがあり、それぞれが数値だけでは答えられない問いに答えます。
| フィールド | 何に答えるか | ない場合に何が起きるか |
|---|---|---|
| 財務諸表 | この行がどの財務諸表に属するか | 異なる財務諸表の合計が比較され、照合が誤った行で失敗する |
| 対象期間 | どの列で、実際にどの会計期間を対象とするか | 前年の数値が当年の下に入り、すべての変化の符号が逆になる |
| 単位 | 数値が単位、千単位、百万単位のいずれか | セルは普通に見えるのに、すべての値が1,000倍ずれる |
| ページ | 元のドキュメントのどこを確認すべきか | レビューがPDF内の検索になり、エラーが検証されずに受け入れられる |
| 行レベル(任意) | その行が明細行か小計か | 列を合計すると同じ金額を2回または3回数えてしまう |
単位フィールドが強調されるのには理由があります。パーサーが最も高くつく形で落とす情報だからです。Suffolk Universityの研究では、未学習のLLMに2014年から2023年に提出された5,000件の年次報告書を読ませ、26の会計指標を取得させました。発生したエラーの約半数はスケーリングエラーで、その率はテキストから8.16%、HTMLから5.81%、XBRLから0.11%でした(XBRL USによる研究の要約)。
1,000倍の誤りの原因となった数字自体は正しく読み取られていました。失敗したのは、グリッドの外にあるキャプションを引き継ぐことであり、普通の数値が入ったセルはそれを決して警告しません。
だからこそ、解決策は「もっと注意深く読め」というモデルへの指示ではなく、列なのです。同じ論理は、財務諸表が一致するかどうかを決める他の2つの慣習、括弧と小計の階層にも当てはまります。これらについては財務諸表が単位・符号・小計を失う理由の解説で説明しています。
機能する設定は地味です:まずコンテキスト列、次に行の形
ImageToTable.aiは、固定座標をマッピングするのではなく、ビジョンモデルでページを読み取り、指定した列を埋めます。そのため、コンテキストを担うフィールドも数値と同じ方法で要求できます。この概念がCustom Column Extractionです。欲しい列名を入力すると、AIがページ上のどこであっても、その意味に基づいて各値を特定します。
ほとんどの提出書類の作業は2つの行の形でカバーでき、残りは提出書類を分けておくことと結果の確認にかかっています。
ロング形式:1行につき1明細行、財務諸表全体向け
列には Company、Statement、Line Item、FY2025、FY2024、Unit、Note Reference、Page を指定します。各行は1つの財務諸表の1行であり、対象期間、単位、出所ページが付随します。財務諸表そのものが必要な場合に使う形式で、小計を含む印刷されたすべての行がそれぞれ独立した行として返されます。
ワイド形式:1行につき1提出書類、同業比較向け
比較する明細項目を列として指定します。例えば Revenue、Gross profit、Operating income、Net income、Total assets、Operating cash flow に、Fiscal Year 列を加えます。1つの提出書類が1行になり、比較シートに求められる形になります。
バッチ:同業グループを1つのスプレッドシートに
バッチ処理では複数の提出書類を一度に取り込み、結果を1つの Excel ファイルにマージします。Company 列がそれらを区別します。8件の 10-K が8枚ではなく1枚のシートになります。ここではラベルのばらつきが問題にならなくなります。ある企業は「Total revenues」、別の企業は「Net sales」、さらに別の企業は「Total net revenue」と記載していても、意味的なマッチングによって同じ列に解決されます。これは座標ベースのテンプレートにはできないことです。
確認:セルからページへたどる
Review Mode と bbox 位置特定により、セルにカーソルを合わせると値の出所である正確な領域がハイライトされ、ページ上の領域をクリックすると対応するセルにジャンプします。セルだけでは分からない2つの点、つまりその行がどの財務諸表に属するか、値がどの列の下にあったかを確認するのに使います。古い資料では同じ理由で Model Tier が重要になります。きれいな印刷済み財務諸表なら標準ティアで十分ですが、濃いスキャン、コピーされた年次報告書、脚注の多いページにはより高いティアが必要です。
計算列は、別のツールを追加することなくもう一歩進められます。行レベルの算術は抽出時に評価されるため、2つの対象期間列の差として定義した列は、両方の列が同じ単位であれば、印刷された変化額を返します。一方の財務諸表が千単位で、次が百万単位であることを知る術はないため、単位をまたぐ比較ではルール内で乗数を明示的に指定する必要があります。それでも、その変化が意味を持つかどうかまでは分かりません。それは依然として利用者の判断です。
抽出後に何が起こるか、つまり各財務諸表の行を自身のテンプレートが想定する行に突き合わせる作業は、財務諸表のスプレッディングで説明されているマッピング作業です。ツールは行を埋めます。その行がモデルのどこに属するかはアナリストが判断します。
ファイルは安全に処理され、保存されません。
提出書類がEDGAR上にあるなら、タグ付けされた数値のほうが通常は優れた情報源です
Inline XBRLは、大規模加速提出者には2019年から、加速提出者には2020年から、それ以外には2021年から、事業会社の財務諸表情報に義務付けられています(SECプレスリリース2018-117)。これを含む提出書類では、タグ付けされたファクトはすでにレイアウトから分離されており、それを取り出すのはPDFを読むのとは別の、しばしばより優れた作業です。そう明言することも、率直な回答の一部です。
XBRLは、報告された数値ファクトを大規模に扱う必要がある場合に適した道です。銘柄群のスクリーニング、期間をまたいだ比率の計算、20社にわたる同一項目の比較などです。その限界は現実のものですが、パーサーのそれとは異なります。企業は独自のタグでタクソノミーを拡張するため、企業間比較が弱まります。ファクトは印刷された表示形式を伴わずに届くため、小計の構造や人間が読む順序は含まれません。タグ付け自体にも誤りがあり、符号の慣例は繰り返し発生する問題です。そして叙述的なセクションはまったくタグ付けされていません。
PDF抽出が適した道となるのは4つの状況で、いずれも計画に入れておくべきほど一般的です。提出書類がスキャンまたはテキストレイヤーの使えない画像のみのPDFである場合。文書がXBRLタグ付け(2009年開始)より前のものである場合。渡された資料がEDGARの提出書類ではなく、印刷された年次報告書、ブローカーがまとめた同業比較セット、外国親会社の現地レポートなどである場合。あるいは必要なものが叙述的な部分で、優先すべき構造化された情報源が存在しない場合です。提出書類が数百ページのスキャンである場合、ページの扱い自体が問題となり、数千ページに及ぶPDFをOCRする方法で扱っています。
ImageToTable.aiはXBRLを解析せず、脚注を解決したり相互参照をたどったりせず、モデルを構築しません。渡されたページを、行が財務諸表・対象期間・単位・ページを持つテーブルに変換します。すでにクリーンなタグ付きデータがある提出書類にこれを使うのは、より難しい道を選ぶことになります。
よくある質問
PDFから10-Kの財務諸表をExcelに抽出できますか?
はい、そして有用な出力は数値以上のものを含みます。財務諸表、対象期間、単位、ページの列を、勘定科目や値と並べて設けることで、スプレッドシートの各行をページまでたどれます。これらのフィールドがなければ、エクスポートは、もはや見えないレイアウトに意味を依存する数値のグリッドにすぎません。
なぜ数値が誤った年度の列に入るのですか?
原因の大半は2つです。継続ページのヘッダーが欠けているため、パーサーが見つけられる最も近いヘッダーを割り当ててしまう。あるいはヘッダーが結合された多階層セル(2つのサブ列にまたがる年度、報告値の隣の「修正後」列など)で、それを平坦化するとすべての値が1つか2つずれる。列の順序を信頼する前に、最初の3行を元のページと照合してください。
「in thousands」で全数値が狂うのを防ぐには?
想定せずに、その注記を独自の列として取り込んでください。この宣言はグリッドの外にあるため、列を読むパーサーには決して見えず、すべての値が桁は正しいまま1,000倍ずれて返ってきます。乗数を1か所に保持し、一度だけ適用し、「except per share amounts」のような限定句は一部の行がまったくスケーリングされないことを意味すると覚えておいてください。
脚注も読み取りますか?
行に印刷された「Note 12」のような注記参照を値として取り込めます。これはレビュー担当者が正しいページを見つけるのに役立ちます。参照を解決したり、注記を開いたり、注記の表を出力に含めたりはしません。必要な数値が注記の中にしかない場合は、それが含まれるページをアップロードし、独自のテーブルとして抽出してください。
XBRLはPDFの解析より優れていますか?
報告された数値ファクトについては、通常ははい。タグ付けされたデータはすでにレイアウトから分離されており、エラー率がそれを示しています。5,000件の年次報告書の調査では、スケーリングエラーがXBRL取得で0.11%、プレーンテキストからは8.16%でした。叙述、スキャンまたは画像のみのコピー、EDGARに提出されなかったドキュメントについては、優先すべき構造化ソースがありません。
スキャンされた、または古い10-Kにも対応できますか?
はい。ビジョンモデルはテキストレイヤーではなくページを読むため、スキャンやコピーでも機能し、より高いModel Tierは薄い印刷、密集した脚注、傾いたページに役立ちます。実用的な限界はソースの品質です。ページが斜めにコピーされ、ある桁が本当に判読できない場合、どの抽出もそれを復元できません。Review Modeは、そうしたセルを信頼するのではなく見つけるための方法です。
抽出する価値があるのは文脈の部分です
10-K が汎用の PDF パーサーを寄せ付けないのは、ドキュメントが意味をパーサーにとって装飾でしかない場所に保存しているからです。財務諸表のタイトル、結合セルのヘッダー、表の上にあるキャプション、数値の横の上付き文字、散文ページの列レイアウト。これらを取り除いても数字はすべて残りますが、どの照合でも確認できない並び方になります。
つまり、あらゆる抽出の試金石は、行がスプレッドシートから離れずに4つの問いに答えられるかどうかです。どの財務諸表か、どの対象期間か、どの単位か、どのページか。答えられれば、レビュー担当者は数秒で確認でき、アナリストは会議でそれを擁護できます。答えられなければ、その数字はデータの衣装をまとった推測にすぎません。