Por qué un 10-K rompe un analizador de PDF,
y qué conservar
Un 10-K contiene cuatro o cinco estados financieros, una sección de notas que puede extenderse sesenta páginas y una discusión de la administración presentada en el formato de columnas que eligió el tipógrafo. Los dígitos son lo fácil. Lo que hace difícil leer el documento por máquina es que cada cifra significa algo solo en relación con tres cosas que no son cifras: el estado financiero en el que se encuentra, la columna de periodo que está encima y la unidad declarada una vez en la parte superior de la cuadrícula.
Un analizador de PDF general trata una página como un flujo de texto y una tabla como un rectángulo de celdas. Un 10-K no es ninguna de esas dos cosas, y la brecha aparece después como una hoja de cálculo que parece completa y no concilia con nada.
Puntos clave
- Un analizador de PDF puede leer correctamente cada dígito de un 10-K y aun así devolver una cifra desviada por un factor de 1,000.
- Ese error se oculta en un título impreso una vez sobre la cuadrícula, por lo que la celda en sí parece perfectamente normal.
- Cuatro columnas que nombran el estado financiero, el periodo, la unidad y la página permiten verificar cada fila en segundos.
El público de este artículo es la persona que tiene el PDF en sus manos, no la que construye una canalización de recuperación. Los analistas de renta variable llevan los estados financieros de empresas comparables a una hoja de comparación, los equipos de datos financieros alimentan un almacén de datos, los auditores muestrean cifras divulgadas. En los tres casos el documento llegó desde una página de relaciones con inversores, un correo de un cliente o un agente de presentación, y es una copia renderizada de algo que existe en otro formato en EDGAR, el sistema de presentaciones de la SEC. Lo que sigue es dónde esa copia pierde estructura y qué tiene que extraer una extracción para que merezca la pena conservarla.
Un 10-K es una presentación con varios estados financieros, no una sola tabla
La primera decisión que debe tomar una extracción de 10-K es a qué estado financiero pertenece cada fila, y un analizador de PDF genérico nunca se plantea esa pregunta. Un Form 10-K se estructura en cuatro partes y una lista de puntos. El Item 8 contiene los estados financieros auditados y las notas, el Item 7 contiene el análisis de la dirección, el Item 1A contiene los factores de riesgo. Incluso dentro del Item 8 hay cuatro o cinco estados financieros, cada uno con su propio título, su propia línea de unidad y su propio conjunto de totales, según si el resultado integral se presenta por separado o dentro del estado de resultados.
Eso importa porque "Total" no es una etiqueta que identifique nada por sí sola. Cada estado financiero tiene una fila de total, y varios usan las mismas palabras: total de activos, total de pasivos, total de patrimonio, ingresos totales. Lea un total sin saber qué estado financiero lo produjo y no podrá decir a qué debería ser igual, con qué debería compararse ni si pertenece al bloque del balance general de su libro de trabajo o al bloque del estado de flujos de efectivo. Un analizador que devuelve el orden de lectura devuelve las etiquetas correctamente y el significado en absoluto.
Hay una segunda razón por la que importa el límite del estado financiero. La declaración de unidad se imprime una vez encima de cada cuadrícula, así que el balance general puede estar en miles mientras que una nota tres páginas más adelante está en millones. El estado financiero es el ámbito de la unidad, lo que lo convierte en el ámbito de la aritmética. Equivoque el límite y el multiplicador se aplicará a dos ámbitos distintos.
Conviene aclarar pronto un hecho sobre el propio archivo. La copia que publica la SEC es HTML con Inline XBRL incrustado, lo que significa que las cifras financieras están etiquetadas en una taxonomía legible por máquina dentro de la propia página, y el PDF con el que trabaja la mayoría es una renderización publicada por la empresa o un escaneo de un informe anual impreso. Así que la tarea del análisis de 10-K aquí es recuperar la estructura de una copia visual, y la extracción de presentaciones de la SEC es sobre todo un problema de diseño antes que un problema de reconocimiento de caracteres.
Ese diseño no es estable entre empresas, y ahí es donde reside en realidad la mayor parte de la dificultad. Los profesionales lo describen sin mucha paciencia: "La extracción de tablas de las presentaciones de la SEC es genuinamente molesta porque el formato varía enormemente entre empresas e incluso entre años." (r/fintech). Una regla que funciona para el balance general de un presentador tiene que reescribirse para el siguiente, y de nuevo cuando la misma empresa cambia de auditores o adopta una nueva norma.
Dos estados pueden compartir una página, y el segundo comienza debajo de la última fila del primero
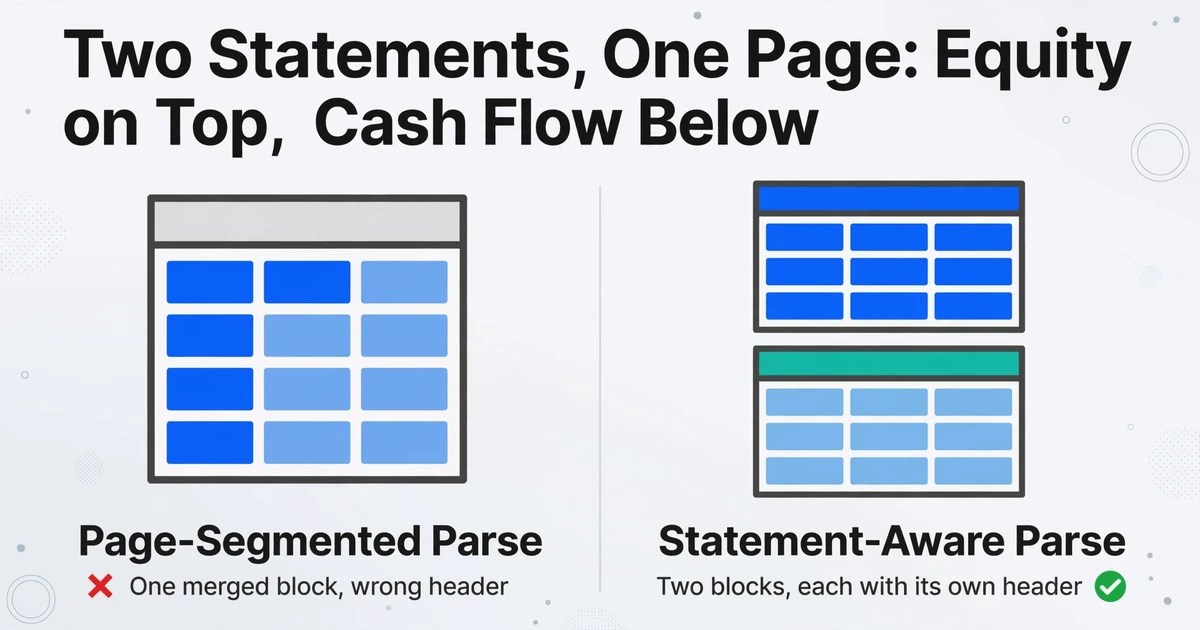
Los tipógrafos de los filings no asignan una página nueva a cada estado financiero. Para evitar que el documento crezca, las últimas filas del estado de cambios en el patrimonio suelen quedar en la parte superior de una página y el estado de flujos de efectivo consolidado comienza inmediatamente debajo, con su propio título y su propia fila de encabezado.
Un analizador que segmenta por página devuelve un solo bloque. El bloque está ordenado internamente tal como lo vería un lector, así que nada parece roto: las filas del patrimonio quedan arriba, las del flujo de efectivo abajo, y cada número está en el lugar correcto de la página. El daño está en la tabla. Las filas de dos estados ahora comparten un encabezado, y el encabezado pertenece al estado al que el analizador lo asignó. Columnas del patrimonio como el resultado integral acumulado terminan sobre cifras del flujo de efectivo, y el subtotal del flujo de efectivo hereda una columna bajo la que nunca debió estar.
El fallo deja el recuento de filas más o menos correcto, y por eso sobrevive a una primera revisión y falla en la primera conciliación.
El síntoma posterior es específico. El flujo de efectivo operativo debe partir del ingreso neto y terminar en el cambio en efectivo, y el estado imprime ambos extremos. Cuando el bloque se fusiona, la verificación no puede ejecutarse o falla en una fila que en realidad está en la tabla equivocada. El analista ve una ruptura en la conciliación y empieza a buscar un dígito mal leído, cuando el dígito es correcto y la fila está en el estado equivocado.
Una tabla que cruza un salto de página pierde su encabezado, no sus cifras
Un balance general que comienza cerca del final de la página 58 continúa en la página 59, y la página de continuación puede repetir el título del estado financiero, a veces con "(continuación)", mientras que los encabezados de columna con frecuencia faltan. Las cifras siguen apareciendo; los periodos que las acompañan, no.
Analice cada página de forma independiente y obtendrá dos tablas. La primera tiene un encabezado y la mitad de las filas. La segunda tiene las filas restantes y ninguna asignación de periodo. Un analizador que intenta ser útil tomará el encabezado más cercano en la página de continuación, que puede pertenecer a una tabla completamente distinta que empieza más abajo, y las filas quedan etiquetadas con los años equivocados. En cualquier caso, las cifras se leen correctamente y se archivan bajo la columna incorrecta.
La estructura entre páginas es el caso normal, no una excepción. En FinMMDocR, un benchmark de 1,200 preguntas financieras elaboradas por expertos sobre 837 documentos con un promedio de 50.8 páginas, el 65% de las preguntas requiere evidencia que abarca más de una página, con un promedio de 2.4 páginas de evidencia cada una. El análisis de errores del mismo estudio es más revelador para quien culpa a la aritmética: 78 de 100 fallos muestreados fueron fallos de comprensión del documento, es decir, el modelo no pudo localizar o leer la evidencia, mientras que solo 5 fueron errores de cálculo (Tang et al., FinMMDocR, AAAI 2026).
La consecuencia práctica es que una extracción a nivel de página no puede ejecutar las verificaciones propias del estado financiero. Los activos equivalen a los pasivos más el patrimonio solo si todas las filas de activos y todas las filas de pasivos sobrevivieron con sus periodos adjuntos. Media tabla no puede verificarse contra sí misma, y así es como una página de continuación sin etiquetas se convierte en una hoja de cálculo que nadie puede validar.
El periodo vive en una celda de encabezado combinada, y las celdas combinadas son lo primero que un analizador aplana
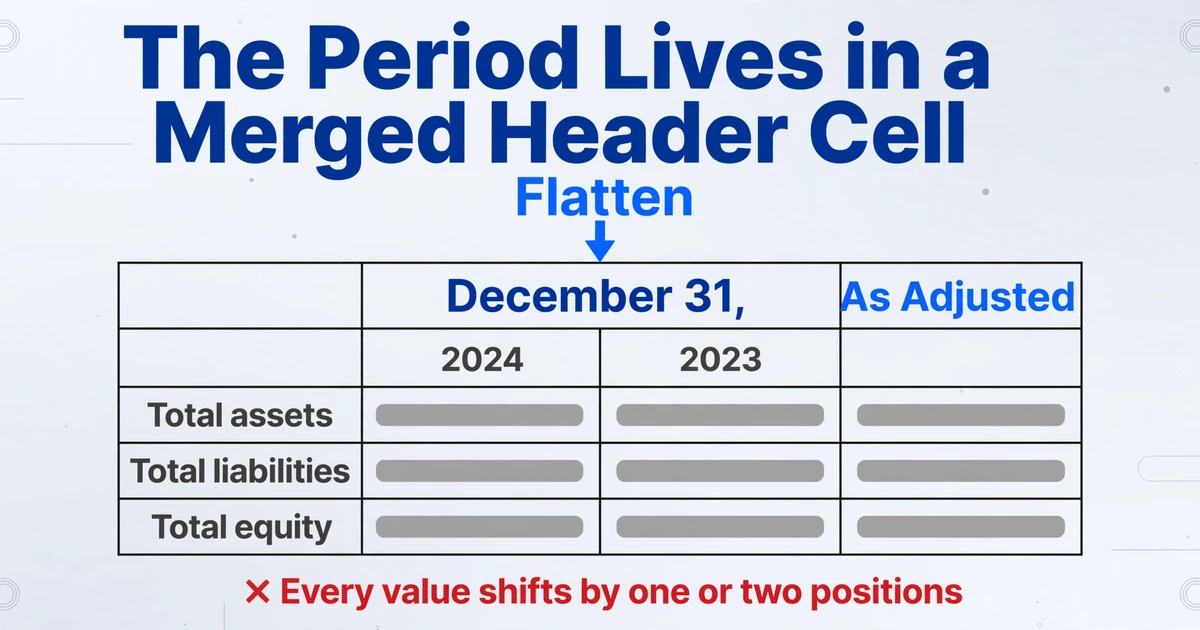
Un encabezado de 10-K rara vez es una sola fila de etiquetas de año. Es una jerarquía. "December 31," abarca dos columnas, con "2024" y "2023" debajo. Una tercera columna lleva "As Adjusted". Tras una fusión o un cambio de ejercicio fiscal, el encabezado se divide en bloques "Successor" y "Predecessor" separados por una línea, y los periodos a cada lado no tienen la misma duración, por lo que una columna puede abarcar once meses y la siguiente doce.
Aplanar esa jerarquía es donde las asignaciones de columna salen mal, y la columna "As Adjusted" muestra por qué es peor que una etiqueta faltante. Ambas columnas pueden llevar el año 2024. Una es la cifra tal como se reportó, la otra es la cifra reexpresada sobre una base pro forma por una adquisición. Elimine el subencabezado y tendrá dos columnas con el mismo nombre, sin forma de distinguir cuál es cuál, y una hoja de comparación que mezcla silenciosamente una cifra reportada con una ajustada.
Una celda combinada crea un segundo tipo de error. Cuando una celda de encabezado abarca tres columnas y el analizador la colapsa en la primera columna, cada valor debajo de ella se desplaza dos posiciones a la izquierda. Los dígitos son correctos, las etiquetas de fila son correctas y el año es incorrecto. Nada en la celda lo señala, porque una columna equivocada sigue siendo un número válido.
Una celda de encabezado combinada es una asignación de columna, no una etiqueta. Si la aplana, todos los valores que están debajo se desplazan.
El ejercicio fiscal añade un problema de definición que la extracción no puede resolver, pero que al menos puede exponer. Una columna etiquetada como 2024 puede terminar en enero, en junio o en un periodo de 52/53 semanas que cae unos días fuera del calendario. Compararla con un par cuyo cierre es en diciembre es un error del análisis, no del analizador, y la única defensa es conservar la etiqueta completa del periodo ("ejercicio fiscal finalizado el 31 de enero de 2024") en lugar de los cuatro dígitos.
Una referencia a nota viaja con el número y es lo primero que se elimina de él
En un 10-K, el número que usted necesita suele estar en el estado financiero, y la razón de su significado está en una nota a sesenta páginas de distancia. El estado financiero lo indica con una marca: "See Note 12", un superíndice 1, un asterisco o un "(1)" entre corchetes impreso junto a la cifra.
Los analizadores de números eliminan esa marca porque no forma parte del valor, y la eliminación falla de una manera predecible. Una celda que dice 1,234(1) puede devolverse como 1,234, como 1,2341 o como 1,234.1, según cómo esté separado el superíndice en la capa de texto. La marca que debía llevar al lector a la explicación llega como un dígito corrupto.
El fallo más sutil no contiene caracteres corruptos. Las filas etiquetadas como "Other, net", "Miscellaneous" u "Other income (expense)" agregan varios conceptos, y la nota es donde se desglosa esa agregación. Extraiga la fila y tendrá un número correcto que no puede descomponerse, lo que significa que no puede compararse con un par cuyo "Other" contiene conceptos distintos. La política contable tiene el mismo problema: si un cargo va en el costo de ventas o en los gastos de venta, generales y administrativos se indica en la nota, y eso cambia el margen bruto sin cambiar una sola cifra en la cara del estado financiero.
Este es un límite que conviene enunciar con claridad. Una extracción puede capturar "Note 12" como valor de una columna para que un revisor navegue a la página correcta. No resuelve la nota, no sigue la referencia cruzada ni extrae la tabla propia de la nota. Ese trabajo queda en manos de quien lee la presentación.
En el MD&A el orden de lectura es columna por columna, y la extracción de texto lee línea por línea
Las secciones narrativas de un 10-K, en particular el análisis y discusión de la administración, suelen maquetarse en dos o tres columnas para incluir más texto en una página. Una persona lee hacia abajo la columna izquierda y luego hacia abajo la derecha. Un extractor de texto lee a lo ancho de la página, línea por línea, porque ese es el orden en que aparecen los caracteres en el flujo de contenido.
El resultado es o bien prosa entrelazada, donde una oración sobre ingresos continúa a mitad de cláusula en una oración sobre liquidez, o bien una columna leída dos veces mientras la otra se pierde. Ninguno de los dos parece un error de datos, así que pasa la revisión. Se convierte en uno cuando una oración que dice "el margen bruto aumentó" se armó con dos columnas distintas y el filing decía lo contrario.
Esta es la sección donde la extracción de PDF se gana su lugar en vez de competir con los datos estructurados. XBRL etiqueta las cifras. No etiqueta la explicación de por qué se movieron las cifras, la presión de precios que menciona la administración ni el contrato que vence el año próximo. Si el objetivo de leer el filing es entender el negocio y no obtener un número, la narrativa es la parte que importa, y el orden de lectura lo es todo.
Una extracción correcta conserva cuatro campos que no son cifras
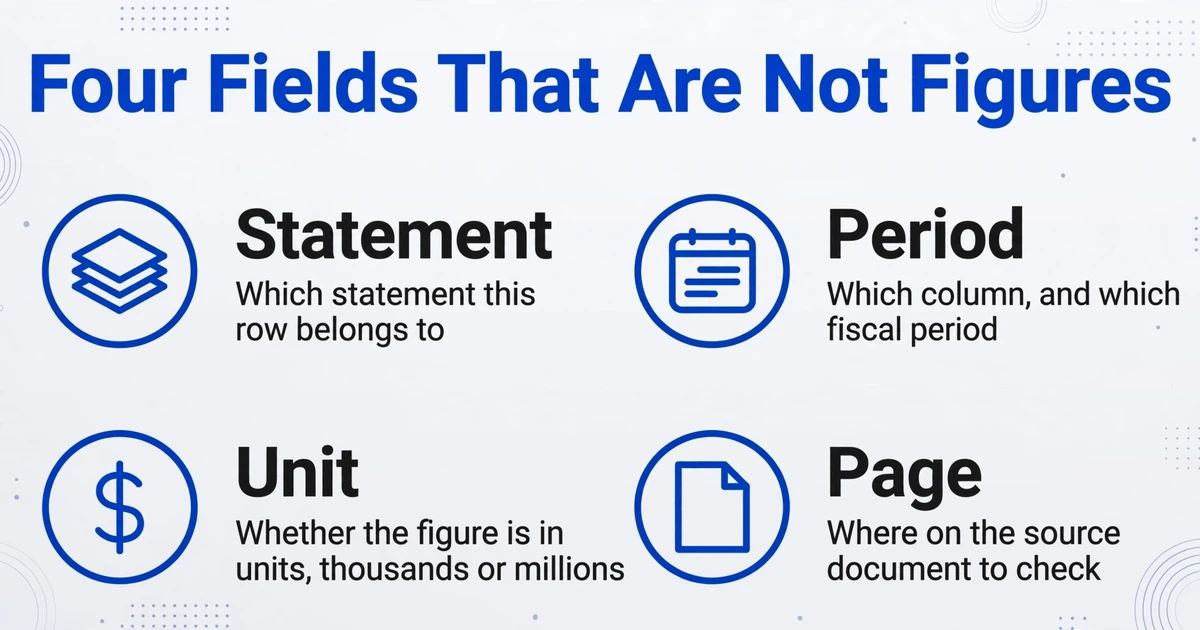
Una extracción correcta de un 10-K se mide por la trazabilidad: cada cifra sigue sabiendo de dónde vino. Cuatro campos hacen ese trabajo, y cada uno responde una pregunta que el número por sí solo no puede.
| Campo | Qué responde | Qué falla sin él |
|---|---|---|
| Statement | A qué estado financiero pertenece esta fila | Se comparan totales de estados financieros distintos y la conciliación falla en la fila equivocada |
| Period | Qué columna, y qué periodo fiscal cubre en realidad | Las cifras del año anterior quedan bajo el año actual y todo cambio tiene el signo equivocado |
| Unit | Si la cifra está en unidades, miles o millones | Todo valor se desvía por un factor de 1,000 mientras la celda parece normal |
| Page | Dónde verificar en el documento de origen | La revisión se vuelve una búsqueda por el PDF, así que los errores se aceptan en vez de verificarse |
| Nivel de fila (opcional) | Si la fila es una línea de detalle o un subtotal | Sumar la columna cuenta el mismo dinero dos o tres veces |
El campo de unidad merece el énfasis que recibe porque es lo más costoso que un analizador deja caer. Un estudio de Suffolk University puso un LLM sin entrenamiento contra 5,000 informes anuales presentados entre 2014 y 2023, pidiéndole recuperar 26 métricas contables. Cerca de la mitad de los errores que cometió fueron errores de escala, y las tasas fueron 8.16% desde texto, 5.81% desde HTML y 0.11% desde XBRL (resumen del estudio de XBRL US).
Los dígitos en un error de 1,000x se leyeron correctamente. Lo que falló fue trasladar un encabezado que está fuera de la cuadrícula, y una celda que contiene un número ordinario nunca lo señala.
Por eso la solución es una columna en lugar de una instrucción al modelo de leer con más esfuerzo. La misma lógica cubre los paréntesis y la jerarquía de subtotales, las otras dos convenciones que deciden si un estado financiero cuadra, y esas se detallan en el desglose de por qué los estados financieros pierden unidades, signos y subtotales.
La configuración que funciona es aburrida: primero las columnas de contexto, luego la forma de las filas
ImageToTable.ai lee la página con un modelo de visión y llena las columnas que usted nombra, en lugar de mapear coordenadas fijas, así que los campos que aportan contexto se pueden solicitar igual que las cifras. El concepto es Custom Column Extraction: usted escribe los nombres de columna que desea, y la IA localiza cada valor por lo que significa en cualquier parte de la página.
Dos formas de fila cubren la mayor parte del trabajo con presentaciones, y el resto se trata de mantener las presentaciones separadas y verificar el resultado.
Formato largo: una fila por línea, para un estado financiero completo
Nombre las columnas Company, Statement, Line Item, FY2025, FY2024, Unit, Note Reference y Page. Cada fila es una línea de un estado financiero, con su periodo, escala y página de origen adjuntos. Esta es la forma que debe usar cuando necesita el estado financiero en sí, porque cada línea impresa, incluidos los subtotales, vuelve como su propia fila.
Formato ancho: una fila por presentación, para una comparación entre pares
Nombre como columnas las líneas que compara, como Revenue, Gross profit, Operating income, Net income, Total assets y Operating cash flow, con una columna Fiscal Year. Una presentación se convierte en una fila, que es lo que una hoja de comparación necesita.
Lote: una hoja de cálculo para el conjunto de pares
El procesamiento por lotes toma varias presentaciones a la vez y fusiona los resultados en un solo archivo Excel, con una columna Company que las mantiene separadas. Ocho 10-K se convierten en una hoja en lugar de ocho. Aquí es donde la variación de etiquetas deja de ser un problema: una empresa imprime "Total revenues", otra "Net sales", una tercera "Total net revenue", y la coincidencia semántica las resuelve en la misma columna, algo que una plantilla de coordenadas no puede hacer.
Verificación: señale la celda de vuelta a la página
Review Mode con localización bbox resalta la región exacta de la que proviene un valor al pasar el cursor sobre la celda, y hacer clic en una región de la página salta de vuelta a su celda. Úselo en las dos cosas que una celda no puede mostrarle: a qué estado financiero pertenece la fila y bajo qué columna estaba el valor. Model Tier importa por la misma razón en material más antiguo. Un estado financiero impreso limpio está bien en el nivel estándar; un escaneo denso, un informe anual fotocopiado o una página con muchas notas al pie necesita uno superior.
Una columna calculada puede dar un paso más sin añadir una segunda herramienta. Como la aritmética a nivel de fila se evalúa durante la extracción, una columna definida como la diferencia entre las dos columnas de periodo devuelve el cambio impreso, siempre que ambas columnas estén en la misma unidad. No tiene forma de saber que un estado financiero está en miles y el siguiente en millones, por lo que una comparación entre escalas necesita el multiplicador indicado explícitamente en la regla. Aun así, no le dirá si el cambio es significativo. Eso sigue siendo responsabilidad suya.
Lo que ocurre después de la extracción, emparejar cada línea del estado financiero con la línea que su propia plantilla espera, es el trabajo de mapeo que describe financial statement spreading. La herramienta llena una fila. El analista decide dónde pertenece esa fila en el modelo.
Los archivos se procesan de forma segura y no se almacenan.
Si el documento está en EDGAR, las cifras etiquetadas suelen ser la mejor fuente
El Inline XBRL es obligatorio para la información de los estados financieros de empresas operativas desde 2019 para los declarantes acelerados de gran tamaño, 2020 para los declarantes acelerados y 2021 para todos los demás (comunicado de prensa de la SEC 2018-117). En un documento que lo incluye, los hechos etiquetados ya están separados del diseño, y extraerlos es una tarea distinta y a menudo mejor que leer el PDF. Decirlo forma parte de dar una respuesta directa.
XBRL es el camino correcto cuando necesita hechos numéricos declarados a escala: filtrar un universo, calcular ratios entre periodos, comparar una línea entre veinte empresas. Sus límites son reales, pero distintos de los de un analizador. Las empresas amplían la taxonomía con sus propias etiquetas, lo que debilita la comparación entre empresas; un hecho llega sin la presentación impresa, por lo que la estructura de subtotales y el orden que lee una persona no están en él; el etiquetado en sí contiene errores, y las convenciones de signo son uno recurrente; y las secciones narrativas no están etiquetadas en absoluto.
La extracción de PDF es el camino correcto en cuatro situaciones, y son lo bastante comunes como para preverlas. El documento es un escaneo o un PDF solo de imagen sin capa de texto utilizable. El documento es anterior al etiquetado XBRL, que comenzó en 2009. El paquete que le entregaron no es un documento de EDGAR, como un informe anual impreso, un conjunto de comparación entre pares compilado por un bróker o el informe local de una matriz extranjera. O lo que necesita es la narrativa, donde no hay una fuente estructurada que preferir. Cuando el documento es un escaneo de varios cientos de páginas, el manejo de páginas se convierte en un problema aparte, tratado en cómo aplicar OCR a un PDF de miles de páginas.
ImageToTable.ai no analiza XBRL, no resuelve notas al pie ni sigue referencias cruzadas, y no construye un modelo. Convierte las páginas que le entrega en una tabla cuyas filas llevan su estado, periodo, unidad y página. Usarlo en un documento que ya tiene datos etiquetados limpios sería elegir el camino más difícil.
Preguntas frecuentes
¿Puedo extraer los estados financieros de un 10-K de un PDF a Excel?
Sí, y el resultado útil incluye más que las cifras. Nombre columnas para el estado financiero, el periodo, la unidad y la página junto con las partidas y los valores, de modo que cada fila de la hoja de cálculo pueda rastrearse hasta una página. Sin esos campos, la exportación es una cuadrícula de números cuyo significado depende de una maquetación que ya no puede ver.
¿Por qué los números quedan bajo la columna del año equivocado?
Dos causas explican la mayoría de los casos. Falta el encabezado en una página de continuación, así que el analizador asigna el encabezado más cercano que encuentra. O el encabezado es una celda combinada de varios niveles (un año que abarca dos subcolumnas, una columna "As Adjusted" junto a una reportada) y aplanarla desplaza cada valor una o dos posiciones. Verifique las tres primeras filas contra la página de origen antes de confiar en el orden de las columnas.
¿Cómo evito que "in thousands" haga que cada cifra sea incorrecta?
Capture la leyenda como su propia columna en lugar de darla por supuesta. La declaración está fuera de la cuadrícula, así que un analizador que lee columnas nunca la ve, y cada valor vuelve correcto en sus dígitos pero erróneo por un factor de 1,000. Mantenga el multiplicador en un solo lugar, aplíquelo una vez y recuerde que calificadores como "except per share amounts" significan que algunas filas no se escalan en absoluto.
¿Lee las notas al pie?
Puede capturar la referencia a nota impresa junto a una línea, como "Note 12", como un valor, lo que ayuda a un revisor a encontrar la página correcta. No resuelve la referencia, no abre la nota ni incorpora la tabla de la nota al resultado. Si el número que necesita existe solo dentro de una nota, suba las páginas que la contienen y extráigalas como su propia tabla.
¿Es XBRL mejor que analizar el PDF?
Para datos numéricos reportados, por lo general sí. Los datos etiquetados ya están separados de la maquetación, y las tasas de error lo reflejan: un estudio de 5,000 informes anuales encontró errores de escala en el 0.11% de las recuperaciones XBRL frente al 8.16% del texto plano. Para lo narrativo, para copias escaneadas o PDF solo de imagen, y para documentos que nunca se presentaron en EDGAR, no hay una fuente estructurada que preferir.
¿Puede manejar un 10-K escaneado o más antiguo?
Sí. Un modelo de visión lee la página en lugar de una capa de texto, así que un escaneo o una fotocopia funciona, y un nivel de modelo superior ayuda con impresión tenue, notas al pie densas y páginas inclinadas. El límite práctico es la calidad de la fuente: si una página se copió en ángulo y un dígito es realmente ilegible, ninguna extracción lo recupera, y Review Mode es la forma de encontrar esas celdas en lugar de confiar en ellas.
El contexto es la parte que vale la pena extraer
Un 10-K derrota a un analizador de PDF genérico porque el documento almacena significado en lugares que el analizador trata como decoración: el título del estado financiero, la celda combinada del encabezado, el título sobre la cuadrícula, el superíndice junto a una cifra, la disposición en columnas de una página de texto. Elimine esos elementos y seguirá teniendo todos los dígitos, ordenados de una forma que ninguna conciliación puede confirmar.
Por eso, la prueba para cualquier extracción es si una fila puede responder cuatro preguntas sin salir de la hoja de cálculo: qué estado financiero, qué periodo, qué unidad, qué página. Si puede, un revisor la verifica en segundos y un analista puede defenderla en una reunión. Si no puede, los números son conjeturas disfrazadas de datos.