Pourquoi un 10-K met à mal un analyseur PDF,
et ce qu'il faut conserver
Un 10-K contient quatre ou cinq états financiers, une section de notes qui peut s'étendre sur soixante pages, et une discussion de la direction présentée dans le format de colonnes choisi par le typographe. Les chiffres sont la partie facile. Ce qui rend le dépôt difficile à lire par une machine, c'est que chaque montant n'a de sens que par rapport à trois éléments qui ne sont pas des chiffres : l'état financier dans lequel il figure, la colonne de période au-dessus, et l'unité déclarée une fois en haut de la grille.
Un analyseur PDF générique traite une page comme un flux de texte et un tableau comme un rectangle de cellules. Un 10-K n'est ni l'un ni l'autre, et l'écart apparaît plus tard sous la forme d'une feuille de calcul qui semble complète et ne se rapproche de rien.
Points clés
- Un analyseur PDF peut lire correctement chaque chiffre d'un 10-K et renvoyer malgré tout un montant erroné d'un facteur 1 000.
- Cette erreur se cache dans une légende imprimée une fois au-dessus de la grille, si bien que la cellule elle-même paraît parfaitement ordinaire.
- Quatre colonnes nommant l'état financier, la période, l'unité et la page rendent chaque ligne vérifiable en quelques secondes.
Le public de cet article est la personne qui détient le PDF, pas celle qui construit un pipeline de recherche. Les analystes actions extraient les états de sociétés comparables dans une feuille de comparaison, les équipes de données financières alimentent un entrepôt, les auditeurs échantillonnent les chiffres publiés. Dans les trois cas, le document provient d'une page de relations investisseurs, d'un e-mail client ou d'un agent de dépôt, et c'est une copie rendue de quelque chose qui existe dans un autre format sur EDGAR, le système de dépôt de la SEC. Ce qui suit décrit où cette copie perd sa structure, et ce qu'une extraction doit en tirer pour valoir la peine d'être conservée.
Un 10-K est un dépôt comportant plusieurs états, pas un seul tableau
La première décision qu'une extraction de 10-K doit prendre est de déterminer à quel état appartient une ligne, et un analyseur PDF générique ne pose jamais la question. Un Form 10-K se décompose en quatre parties et une liste d'items. L'Item 8 contient les états financiers audités et les notes, l'Item 7 contient la discussion de la direction, l'Item 1A contient les facteurs de risque. Même à l'intérieur de l'Item 8, il y a quatre ou cinq états, chacun avec son propre titre, sa propre ligne d'unité et son propre ensemble de totaux, selon que le résultat global est présenté séparément ou à l'intérieur du compte de résultat.
Cela compte parce que « Total » n'est pas un libellé qui identifie quoi que ce soit à lui seul. Chaque état a une ligne de total, et plusieurs utilisent les mêmes mots : total de l'actif, total du passif, total des capitaux propres, chiffre d'affaires total. Lisez un total sans savoir quel état l'a produit et vous ne pouvez pas dire à quoi il devrait être égal, à quoi il devrait être comparé, ni s'il appartient au bloc bilan de votre classeur ou au bloc flux de trésorerie. Un analyseur qui renvoie l'ordre de lecture renvoie les libellés correctement et le sens pas du tout.
Il y a une seconde raison pour laquelle la frontière entre états compte. La déclaration d'unité est imprimée une fois au-dessus de chaque grille, de sorte que le bilan peut être en milliers tandis qu'une note trois pages plus loin est en millions. L'état est la portée de l'unité, ce qui en fait la portée de l'arithmétique. Si la frontière est erronée, le multiplicateur est appliqué sur deux portées différentes.
Un fait sur le fichier lui-même mérite d'être établi tôt. La copie publiée par la SEC est du HTML avec XBRL en ligne intégré, ce qui signifie que les chiffres financiers sont balisés dans une taxonomie lisible par machine au sein même de la page, et le PDF à partir duquel la plupart des gens travaillent est un rendu publié par la société ou une numérisation d'un rapport annuel imprimé. Le travail d'analyse d'un 10-K consiste donc ici à récupérer la structure d'une copie visuelle, et l'extraction de dépôts SEC est surtout un problème de mise en page avant d'être un problème de reconnaissance de caractères.
Cette mise en page n'est pas stable d'une société à l'autre, et c'est là que réside l'essentiel de la difficulté. Les praticiens le décrivent sans beaucoup de patience : « L'extraction de tableaux à partir des dépôts SEC est vraiment pénible parce que le formatage varie énormément d'une société à l'autre et même d'une année à l'autre. » (r/fintech). Une règle qui fonctionne pour le bilan d'un déposant doit être réécrite pour le suivant, et de nouveau lorsque la même société change d'auditeur ou adopte une nouvelle norme.
Deux états financiers peuvent partager une page, le second commençant sous la dernière ligne du premier
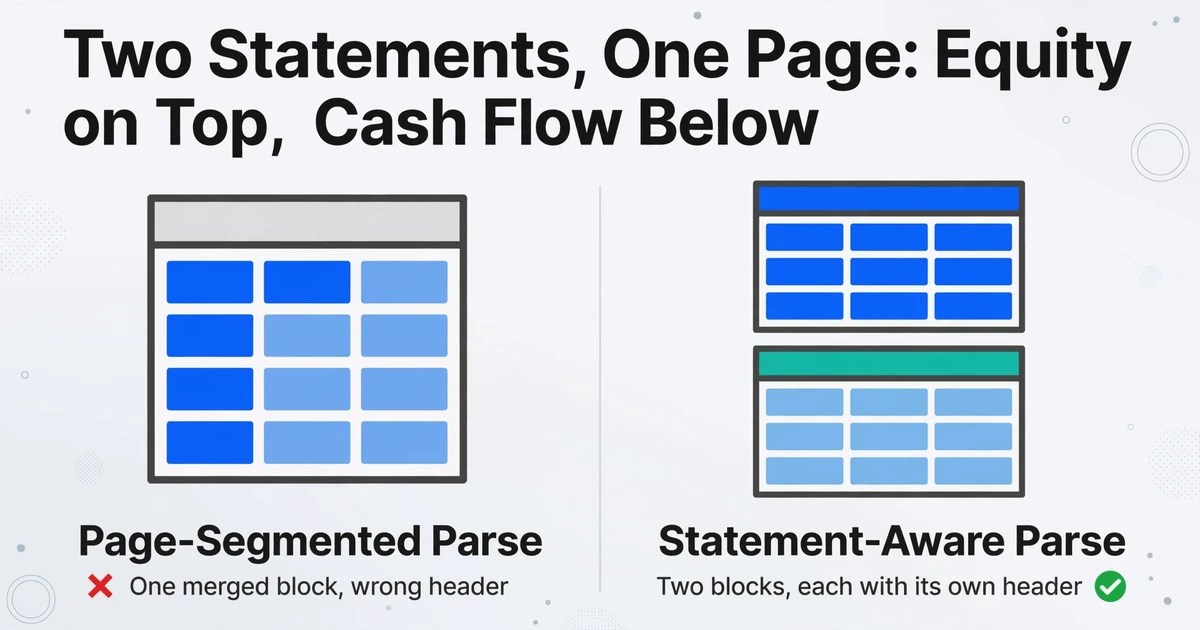
Les metteurs en page des dépôts ne consacrent pas une nouvelle page à chaque état financier. Pour éviter que le document ne s'allonge, les dernières lignes du tableau de variation des capitaux propres se trouvent souvent en haut d'une page et le tableau consolidé des flux de trésorerie commence immédiatement en dessous, avec son propre titre et sa propre ligne d'en-tête.
Un analyseur qui segmente par page renvoie un seul bloc. Ce bloc est ordonné en interne tel qu'un lecteur le verrait, donc rien ne semble anormal : les lignes de capitaux propres en haut, les lignes de flux de trésorerie en dessous, et chaque chiffre à sa place sur la page. Le problème est dans le tableau. Les lignes de deux états financiers partagent désormais un seul en-tête, et cet en-tête appartient à l'état financier auquel l'analyseur l'a rattaché. Des colonnes de capitaux propres comme le cumul des autres éléments du résultat global se retrouvent au-dessus de chiffres de flux de trésorerie, et le sous-total des flux de trésorerie hérite d'une colonne sous laquelle il n'aurait jamais dû figurer.
L'erreur laisse un nombre de lignes à peu près correct, ce qui lui permet de passer un premier coup d'œil mais la fait échouer au premier rapprochement.
Le symptôme en aval est précis. Le flux de trésorerie d'exploitation doit partir du résultat net et aboutir à la variation de trésorerie, et l'état financier affiche les deux extrémités. Lorsque le bloc est fusionné, le contrôle ne peut pas s'exécuter ou échoue sur une ligne qui appartient en réalité au mauvais tableau. L'analyste voit une rupture de rapprochement et se met à chercher un chiffre mal lu, alors que le chiffre est correct et que la ligne se trouve dans le mauvais état financier.
Un tableau qui traverse un saut de page perd son en-tête, pas ses chiffres
Un bilan qui commence près du bas de la page 58 se poursuit page 59, et la page de continuation peut répéter le titre de l'état financier, parfois avec « (suite) », tandis que les en-têtes de colonnes sont souvent absents. Les chiffres continuent d'arriver ; les périodes au-dessus, non.
Analysez chaque page indépendamment et vous obtenez deux tableaux. Le premier a un en-tête et la moitié des lignes. Le second a les lignes restantes et aucune affectation de période. Un analyseur qui cherche à être utile prendra l'en-tête le plus proche sur la page de continuation, lequel peut appartenir à un tableau entièrement différent qui commence plus bas, et les lignes sont alors étiquetées avec les mauvaises années. Dans les deux cas, les chiffres sont lus correctement et classés dans la mauvaise colonne.
La structure inter-pages est le cas normal, pas un cas limite. Dans FinMMDocR, un benchmark de 1 200 questions financières conçues par des experts sur 837 documents d'une moyenne de 50,8 pages, 65 % des questions exigent des preuves réparties sur plus d'une page, avec une moyenne de 2,4 pages de preuves chacune. L'analyse des erreurs de la même étude est plus révélatrice pour qui blâme l'arithmétique : 78 des 100 échecs échantillonnés étaient des échecs de compréhension du document, c'est-à-dire que le modèle n'a pas pu localiser ou lire les preuves, tandis que 5 seulement étaient des erreurs de calcul (Tang et al., FinMMDocR, AAAI 2026).
La conséquence pratique est qu'une extraction page par page ne peut pas exécuter les contrôles propres à l'état financier. L'actif est égal au passif plus les capitaux propres seulement si toutes les lignes d'actif et toutes les lignes de passif ont survécu avec leurs périodes rattachées. Un demi-tableau ne peut pas être vérifié par lui-même, et c'est ainsi qu'une page de continuation non étiquetée se transforme en une feuille de calcul que personne ne peut valider.
La période réside dans une cellule d'en-tête fusionnée, et les cellules fusionnées sont la première chose qu'un analyseur aplatit
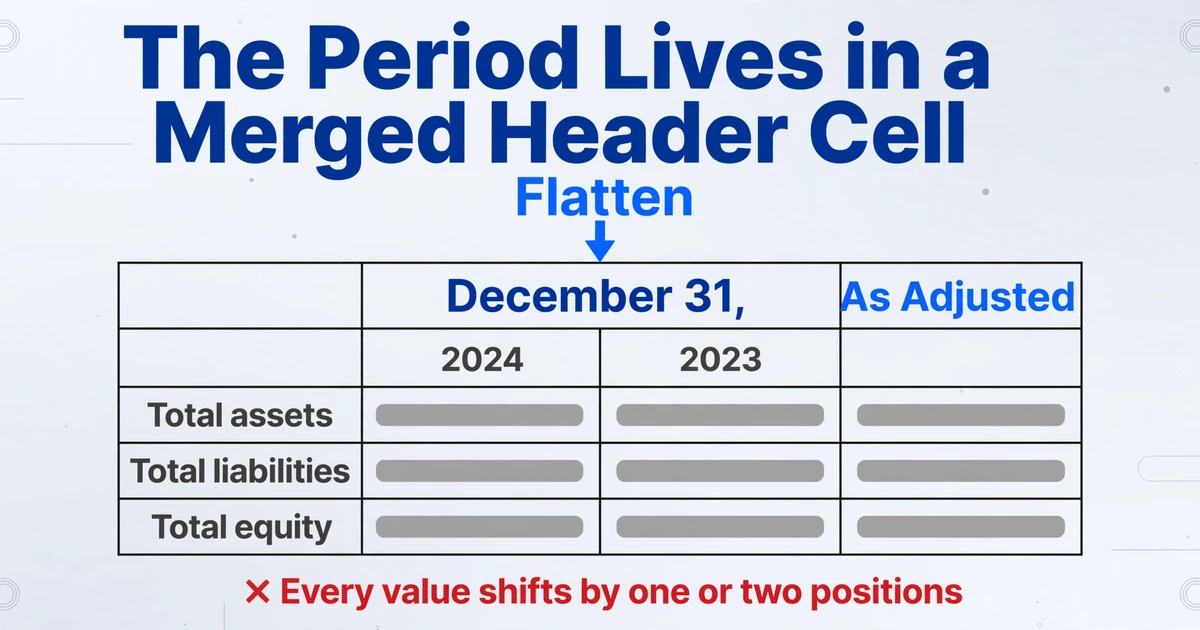
Un en-tête de 10-K est rarement une seule ligne d'étiquettes d'années. C'est une hiérarchie. « December 31, » couvre deux colonnes, avec « 2024 » et « 2023 » en dessous. Une troisième colonne porte « As Adjusted ». Après une fusion ou un changement d'exercice fiscal, l'en-tête se scinde en blocs « Successor » et « Predecessor » séparés par un filet, et les périodes de part et d'autre n'ont pas la même durée : une colonne peut couvrir onze mois et la suivante douze.
C'est en aplatisant cette hiérarchie que les affectations de colonnes dérapent, et la colonne « As Adjusted » montre pourquoi c'est pire qu'une étiquette manquante. Les deux colonnes peuvent porter l'année 2024. L'une contient le chiffre tel que déclaré, l'autre le chiffre retraité sur une base pro forma pour une acquisition. Supprimez le sous-en-tête et vous avez deux colonnes du même nom, aucun moyen de les distinguer, et une feuille de comparaison qui mélange silencieusement un chiffre déclaré et un chiffre retraité.
Une cellule fusionnée crée un second type d'erreur. Quand une cellule d'en-tête couvre trois colonnes et que l'analyseur la réduit à la première colonne, chaque valeur en dessous se décale de deux positions vers la gauche. Les chiffres sont bons, les étiquettes de lignes sont bonnes, et l'année est fausse. Rien dans la cellule ne le signale, car une mauvaise colonne reste un nombre valide.
Une cellule d'en-tête fusionnée est une affectation de colonne, pas un libellé. Aplatissez-la et toutes les valeurs situées en dessous se décalent.
L'exercice fiscal ajoute un problème de définition que l'extraction ne peut pas résoudre mais qu'elle peut au moins exposer. Une colonne intitulée 2024 peut se terminer en janvier, ou en juin, ou sur une période de 52/53 semaines qui tombe à quelques jours du calendrier. La comparer avec un pair dont l'exercice se clôture en décembre est une erreur d'analyse, pas d'analyse syntaxique, et la seule défense consiste à conserver le libellé complet de la période (« exercice fiscal clos le 31 janvier 2024 ») plutôt que les quatre chiffres.
Un renvoi de note voyage avec le nombre et est la première chose qui en est retirée
Dans un 10-K, le nombre dont vous avez besoin figure souvent dans l'état financier, et la raison pour laquelle il signifie ce qu'il signifie se trouve dans une note à soixante pages de là. L'état financier le signale par un marqueur : « Voir note 12 », un exposant 1, un astérisque ou un « (1) » entre parenthèses imprimé à côté du chiffre.
Les analyseurs de nombres suppriment ce marqueur parce qu'il ne fait pas partie de la valeur, et cette suppression échoue de manière prévisible. Une cellule indiquant 1,234(1) peut ressortir en 1,234, en 1,2341 ou en 1,234.1 selon la façon dont l'exposant est séparé dans la couche de texte. Le balisage censé renvoyer le lecteur à l'explication arrive sous forme de chiffre corrompu.
L'échec plus subtil ne contient aucun caractère corrompu. Les lignes intitulées « Autres, net », « Divers » ou « Autres produits (charges) » agrègent plusieurs éléments, et c'est dans la note que cette agrégation est détaillée. Extrayez la ligne et vous obtenez un nombre correct qui ne peut pas être décomposé, ce qui signifie qu'il ne peut pas être comparé à celui d'un pair dont la ligne « Autres » contient des éléments différents. La méthode comptable pose le même problème : le fait qu'une charge soit imputée au coût des ventes ou aux frais de vente, généraux et administratifs est précisé dans la note, et cela modifie la marge brute sans changer un seul chiffre au corps de l'état financier.
Voilà une limite qu'il vaut la peine d'énoncer clairement. Une extraction peut capturer « Note 12 » comme valeur de colonne afin qu'un relecteur puisse naviguer vers la bonne page. Elle ne résout pas la note, ne suit pas le renvoi et n'extrait pas le tableau propre à la note. Ce travail reste à la personne qui lit le dépôt.
Dans le MD&A, l'ordre de lecture est colonne par colonne, et l'extraction de texte lit ligne par ligne
Les sections narratives d'un 10-K, en particulier la discussion et l'analyse de la direction, sont souvent disposées en deux ou trois colonnes pour faire tenir plus de texte sur une page. Un humain lit la colonne de gauche de haut en bas, puis celle de droite. Un extracteur de texte lit la page en travers, ligne par ligne, car c'est l'ordre dans lequel les caractères apparaissent dans le flux de contenu.
Le résultat est soit une prose entremêlée, où une phrase sur le chiffre d'affaires reprend en milieu de proposition dans une phrase sur la liquidité, soit une colonne lue deux fois tandis que l'autre est perdue. Ni l'un ni l'autre ne ressemble à une erreur de données, donc cela passe la revue. Cela en devient une quand une phrase qui dit « la marge brute a augmenté » a été assemblée à partir de deux colonnes différentes et que le dépôt disait le contraire.
C'est la section où l'extraction PDF gagne sa place plutôt que de rivaliser avec les données structurées. XBRL balise les chiffres. Il ne balise pas l'explication des variations des chiffres, la pression tarifaire que la direction nomme, ou le contrat qui expire l'année prochaine. Si le but de lire le dépôt est de comprendre l'activité plutôt que d'extraire un chiffre, la narration est la partie qui compte, et l'ordre de lecture est tout l'enjeu.
Une extraction correcte conserve quatre champs qui ne sont pas des chiffres
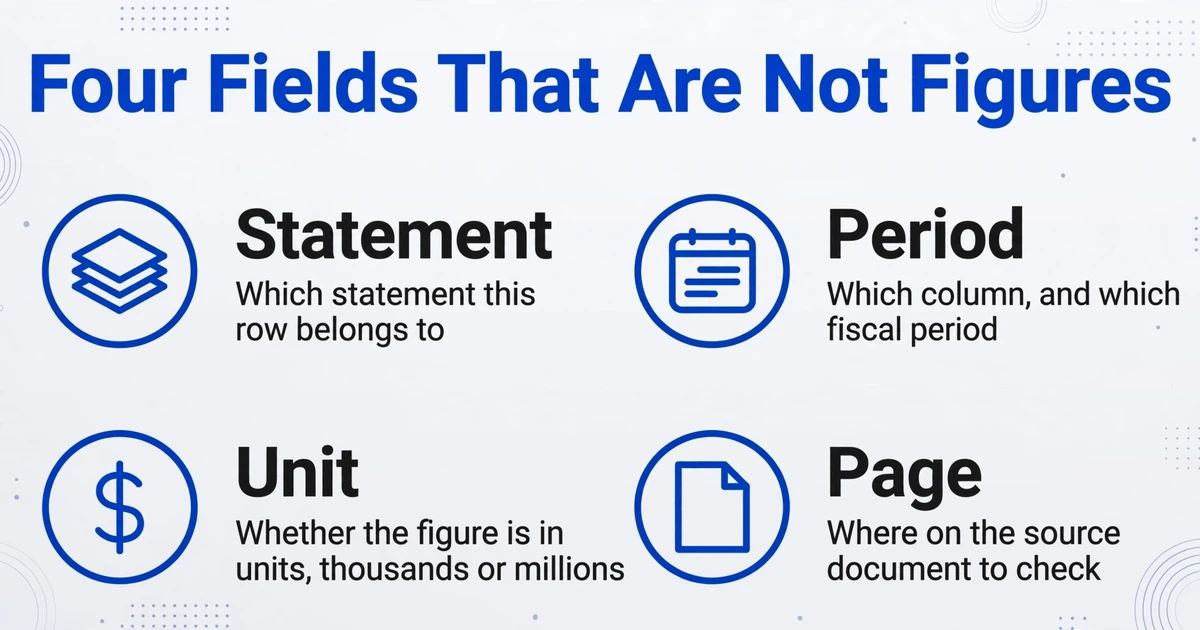
Une extraction 10-K correcte se mesure à la traçabilité : chaque chiffre sait encore d'où il vient. Quatre champs font ce travail, et chacun répond à une question que le nombre seul ne peut pas résoudre.
| Champ | À quoi il répond | Ce qui va mal sans lui |
|---|---|---|
| Statement | À quel état financier cette ligne appartient | Des totaux d'états financiers différents sont comparés, et le rapprochement échoue sur la mauvaise ligne |
| Period | Quelle colonne, et quelle période qu'elle couvre réellement | Les chiffres de l'exercice précédent se retrouvent sous l'exercice en cours, et chaque variation a le mauvais signe |
| Unit | Si le chiffre est en unités, en milliers ou en millions | Chaque valeur est décalée d'un facteur 1 000 alors que la cellule paraît ordinaire |
| Page | Où vérifier sur le document source | La revue devient une recherche dans le PDF, donc les erreurs sont acceptées plutôt que vérifiées |
| Niveau de ligne (facultatif) | Si la ligne est une ligne de détail ou un sous-total | Additionner la colonne compte le même montant deux ou trois fois |
Le champ unité mérite l'importance qu'on lui accorde, car c'est l'élément le plus coûteux qu'un analyseur puisse perdre. Une étude de la Suffolk University a confronté un LLM non entraîné à 5 000 rapports annuels déposés entre 2014 et 2023, en lui demandant d'extraire 26 indicateurs comptables. Environ la moitié des erreurs commises étaient des erreurs d'échelle, avec des taux de 8,16 % à partir du texte, 5,81 % à partir du HTML et 0,11 % à partir du XBRL (synthèse de l'étude par XBRL US).
Les chiffres d'une erreur d'un facteur 1 000 avaient été lus correctement. Ce qui a échoué, c'est le report d'une légende située en dehors de la grille, et une cellule contenant un nombre ordinaire ne le signale jamais.
C'est pourquoi la solution est une colonne plutôt qu'une instruction demandant au modèle de lire plus attentivement. La même logique s'applique aux parenthèses et à la hiérarchie des sous-totaux, les deux autres conventions qui déterminent si un état financier s'équilibre, et celles-ci sont détaillées dans l'analyse des raisons pour lesquelles les états financiers perdent unités, signes et sous-totaux.
La configuration qui fonctionne est banale : d'abord les colonnes de contexte, puis une forme de ligne
ImageToTable.ai lit la page avec un modèle de vision et remplit les colonnes que vous nommez, plutôt que de mapper des coordonnées fixes, de sorte que les champs porteurs de contexte peuvent être demandés de la même manière que les chiffres. Le concept est Custom Column Extraction : vous saisissez les noms de colonnes souhaités, et l'IA localise chaque valeur selon ce qu'elle signifie n'importe où sur la page.
Deux formes de lignes couvrent la plupart du travail sur les dépôts, et le reste consiste à distinguer les dépôts entre eux et à vérifier le résultat.
Format long : une ligne par poste, pour un état complet
Nommez les colonnes Company, Statement, Line Item, FY2025, FY2024, Unit, Note Reference et Page. Chaque ligne correspond à une ligne d'un état, avec sa période, son échelle et sa page source. C'est le format à utiliser lorsque vous avez besoin de l'état lui-même, car chaque ligne imprimée, y compris les sous-totaux, revient sur sa propre ligne.
Format large : une ligne par dépôt, pour une comparaison sectorielle
Nommez les postes que vous comparez comme colonnes, tels que Revenue, Gross profit, Operating income, Net income, Total assets et Operating cash flow, avec une colonne Fiscal Year. Un dépôt devient une ligne, ce qu'attend une feuille de comparaison.
Lot : une feuille de calcul pour l'ensemble des pairs
Le traitement par lots prend plusieurs dépôts à la fois et fusionne les résultats dans un seul fichier Excel, avec une colonne Company qui les distingue. Huit 10-K deviennent une seule feuille au lieu de huit. C'est ici que la variation des libellés cesse d'être un problème : une société imprime « Total revenues », une autre « Net sales », une troisième « Total net revenue », et la correspondance sémantique les résout dans la même colonne, ce qu'un modèle à coordonnées ne peut pas faire.
Vérification : renvoyez la cellule à la page
Review Mode avec localisation bbox met en évidence la région exacte d'où provient une valeur lorsque vous survolez la cellule, et cliquer sur une région de la page renvoie à sa cellule. Utilisez-le sur les deux choses qu'une cellule ne peut pas vous montrer : à quel état appartient la ligne, et sous quelle colonne se trouvait la valeur. Model Tier compte pour la même raison sur des documents plus anciens. Un état imprimé propre convient au niveau standard ; une numérisation dense, un rapport annuel photocopié ou une page riche en notes de bas de page nécessite un niveau supérieur.
Une colonne calculée peut aller un peu plus loin sans ajouter un second outil. Comme l'arithmétique au niveau des lignes est évaluée pendant l'extraction, une colonne définie comme la différence entre les deux colonnes de période renvoie la variation imprimée, à condition que les deux colonnes soient dans la même unité. Elle n'a aucun moyen de savoir qu'un état est en milliers et le suivant en millions, donc une comparaison entre échelles nécessite que le multiplicateur soit fourni explicitement dans la règle. Même dans ce cas, elle ne vous dira pas si la variation est significative. Cela reste votre travail.
Ce qui se passe après l'extraction, en faisant correspondre chaque ligne d'état à la ligne attendue par votre propre modèle, relève du travail de mapping que décrit financial statement spreading. L'outil remplit une ligne. L'analyste décide où cette ligne doit figurer dans le modèle.
Les fichiers sont traités en toute sécurité et ne sont pas conservés.
Si le dépôt est sur EDGAR, les chiffres balisés sont généralement la meilleure source
Le format Inline XBRL est obligatoire pour les informations des états financiers des sociétés d'exploitation depuis 2019 pour les grands déposants accélérés, 2020 pour les déposants accélérés et 2021 pour tous les autres (communiqué de presse SEC 2018-117). Pour un dépôt qui en est doté, les faits balisés sont déjà séparés de la mise en page, et leur extraction est une tâche différente et souvent meilleure que la lecture du PDF. Le dire fait partie d'une réponse honnête.
XBRL est la bonne voie lorsque vous avez besoin de faits numériques déclarés à grande échelle : filtrer un univers, calculer des ratios sur plusieurs périodes, comparer une ligne entre vingt sociétés. Ses limites sont réelles mais différentes de celles d'un analyseur. Les sociétés étendent la taxonomie avec leurs propres balises, ce qui affaiblit la comparaison entre sociétés ; un fait arrive sans la présentation imprimée, donc la structure des sous-totaux et l'ordre que lit un humain n'y figurent pas ; le balisage lui-même contient des erreurs, les conventions de signe étant récurrentes ; et les sections narratives ne sont pas balisées du tout.
L'extraction PDF est la bonne voie dans quatre situations, et elles sont assez courantes pour être anticipées. Le dépôt est une numérisation ou un PDF image sans couche de texte exploitable. Le document est antérieur au balisage XBRL, qui a commencé en 2009. Le dossier qui vous a été remis n'est pas du tout un dépôt EDGAR, comme un rapport annuel imprimé, une comparaison sectorielle compilée par un courtier ou le rapport local d'une société mère étrangère. Ou bien ce dont vous avez besoin est le contenu narratif, pour lequel il n'existe aucune source structurée à privilégier. Lorsque le dépôt est une numérisation de plusieurs centaines de pages, la gestion des pages devient un problème à part entière, abordé dans comment OCRiser un PDF de plusieurs milliers de pages.
ImageToTable.ai n'analyse pas le XBRL, ne résout pas les notes de bas de page et ne suit pas les renvois, et ne construit pas de modèle. Il transforme les pages que vous lui fournissez en un tableau dont les lignes portent leur statement, period, unit et page. L'utiliser sur un dépôt qui dispose déjà de données balisées propres reviendrait à choisir le chemin le plus difficile.
Questions fréquentes
Puis-je extraire les états financiers d'un 10-K depuis un PDF vers Excel ?
Oui, et le résultat utile contient plus que les chiffres. Nommez des colonnes pour l'état financier, la période, l'unité et la page à côté des postes et des valeurs, afin que chaque ligne de la feuille de calcul puisse être rattachée à une page. Sans ces champs, l'export n'est qu'une grille de nombres dont le sens dépend d'une mise en page que vous ne voyez plus.
Pourquoi les chiffres se retrouvent-ils sous la mauvaise colonne d'année ?
Deux causes expliquent la plupart des cas. L'en-tête d'une page de continuation est absent, et l'analyseur attribue l'en-tête le plus proche qu'il trouve. Ou l'en-tête est une cellule fusionnée à plusieurs niveaux (une année couvrant deux sous-colonnes, une colonne « As Adjusted » à côté d'une colonne déclarée) et son aplatissement décale chaque valeur d'une ou deux positions. Vérifiez les trois premières lignes par rapport à la page source avant de faire confiance à l'ordre des colonnes.
Comment éviter que « in thousands » ne fausse tous les chiffres ?
Capturez la mention dans sa propre colonne au lieu de la supposer. La déclaration se situe en dehors de la grille, donc un analyseur qui lit les colonnes ne la voit jamais, et chaque valeur revient exacte au chiffre près mais fausse d'un facteur 1 000. Conservez le multiplicateur en un seul endroit, appliquez-le une fois, et rappelez-vous que des qualificatifs tels que « except per share amounts » signifient que certaines lignes ne sont pas mises à l'échelle du tout.
Lit-il les notes de bas de page ?
Il peut capturer le renvoi de note imprimé en regard d'une ligne, tel que « Note 12 », comme valeur, ce qui aide un relecteur à trouver la bonne page. Il ne résout pas le renvoi, n'ouvre pas la note et n'intègre pas le tableau de la note dans le résultat. Si le chiffre dont vous avez besoin n'existe que dans une note, téléversez les pages qui la contiennent et extrayez-les comme un tableau à part.
XBRL est-il préférable à l'analyse du PDF ?
Pour les données numériques déclarées, généralement oui. Les données balisées sont déjà séparées de la mise en page, et les taux d'erreur le reflètent : une étude de 5 000 rapports annuels a relevé des erreurs de mise à l'échelle dans 0,11 % des extractions XBRL contre 8,16 % à partir de texte brut. Pour le narratif, pour les copies numérisées ou en PDF image, et pour les documents qui n'ont jamais été déposés sur EDGAR, il n'existe aucune source structurée à privilégier.
Peut-il traiter un 10-K numérisé ou plus ancien ?
Oui. Un modèle de vision lit la page plutôt qu'une couche de texte, donc une numérisation ou une photocopie fonctionne, et un niveau de modèle plus élevé aide sur les impressions pâles, les notes denses et les pages inclinées. La limite pratique est la qualité de la source : si une page a été copiée de biais et qu'un chiffre est réellement illisible, aucune extraction ne le récupère, et Review Mode est le moyen de repérer ces cellules au lieu de leur faire confiance.
Le contexte est la partie qui mérite d'être extraite
Un 10-K met en échec un analyseur PDF généraliste parce que le document stocke du sens là où l'analyseur ne voit que de la décoration : le titre de l'état financier, la cellule d'en-tête fusionnée, la légende au-dessus du tableau, l'exposant à côté d'un chiffre, la disposition en colonnes d'une page de texte courant. Supprimez ces éléments et il vous reste tous les chiffres, agencés d'une manière qu'aucun rapprochement ne peut confirmer.
Le test pour toute extraction est donc de savoir si une ligne peut répondre à quatre questions sans quitter la feuille de calcul : quel état financier, quelle période, quelle unité, quelle page. Si oui, un relecteur peut la vérifier en quelques secondes et un analyste peut la défendre en réunion. Si non, les chiffres ne sont que des suppositions déguisées en données.