Comment extraire les données de facture
par champ, et non par page
La plupart des outils d'extraction de factures reposent sur le même postulat implicite : vous voulez chaque donnée présente sur la page. Nom du fournisseur, numéro de facture, date, date d'échéance, sous-total, taxes, lignes d'articles, adresse de livraison, conditions de paiement, coordonnées bancaires — ils extraient tout. Ensuite, vous passez dix minutes à supprimer des colonnes. L'extraction sélective inverse cette logique : vous nommez les champs souhaités, et l'IA ne trouve que ceux-là. Résultat : moins de nettoyage après extraction, une précision par champ supérieure, et un tableur qui arrive plus proche de l'état final. Ce guide vous montre exactement comment procéder — champ par champ, et non page par page.
Points clés à retenir
- La sagesse conventionnelle dit d'extraire chaque champ de chaque facture — on ne sait jamais quelles données pourraient être utiles plus tard.
- Une précision par champ de 97 % semble excellente — mais sur 20 champs, seules 54 % des factures arrivent entièrement correctes, car chaque champ supplémentaire constitue un point de défaillance indépendant.
- Extrayez uniquement les 6 champs dont votre système comptable a réellement besoin et votre taux de traitement direct passe à 83 % — l'étape de nettoyage disparaît complètement.
L'hypothèse « tout extraire » qui vous ralentit
L'entreprise médiane dépense 21,40 $ pour traiter manuellement une seule facture, selon le cycle d'analyse comparative 2024-2025 d'APQC. Avec l'extraction assistée par IA, le coût des meilleurs de leur catégorie tombe à 2,78 $ — soit une réduction de 87 %. Mais ces économies ne se matérialisent que si les données arrivent propres dans votre feuille de calcul.
Demandez à une équipe financière ce qu'elle veut extraire d'une facture, et la plupart répondront « tout ». Le raisonnement semble logique : plus de données signifie une meilleure analyse à terme. Mais en pratique, extraire « tout » crée une phase de nettoyage qui efface l'essentiel du gain d'efficacité. Chaque champ extrait par l'IA comporte une petite probabilité d'erreur indépendante. Lorsque vous extrayez 20 champs au lieu de 8, ces probabilités se cumulent — et soudain, vous auditez les résultats d'extraction au lieu de relire le document original.
Cette frustration n'est pas théorique. Comme l'a dit un utilisateur sur r/Accounting après avoir testé l'extraction par IA sur un lot de 100 factures : « Je me suis rendu compte que ce n'était jamais précis et que je passais plus de temps à vérifier et corriger [qu']à attendre le téléchargement. » Le coupable n'était pas l'IA — c'était l'hypothèse que chaque champ de chaque facture devait être extrait.
Le rapport State of ePayables 2025 d'Ardent Partners révèle que seulement 35,4 % des factures sont traitées de bout en bout sans intervention humaine, et que le taux moyen d'exceptions atteint 18,4 %. Une grande partie de cette gestion des exceptions remonte à une cause racine : l'extracteur tentait d'en tirer trop. Lorsque chaque colonne exige une vérification humaine, l'automatisation ne supprime pas le goulot d'étranglement — elle le déplace simplement de la saisie des données à la revue des données.
C'est le cœur de l'argument en faveur de l'extraction sélective. Vous n'avez pas besoin de l'adresse de livraison sur chaque facture si votre système comptable ne mappe que le nom du fournisseur, le montant et la date d'échéance. Vous n'avez pas besoin des descriptions de lignes si vous comptabilisez les dépenses par catégorie. Extraire moins de champs n'est pas un compromis — c'est le chemin le plus rapide vers une feuille de calcul réellement utilisable.
Pourquoi moins de champs signifie une meilleure précision (les maths dont personne ne parle)
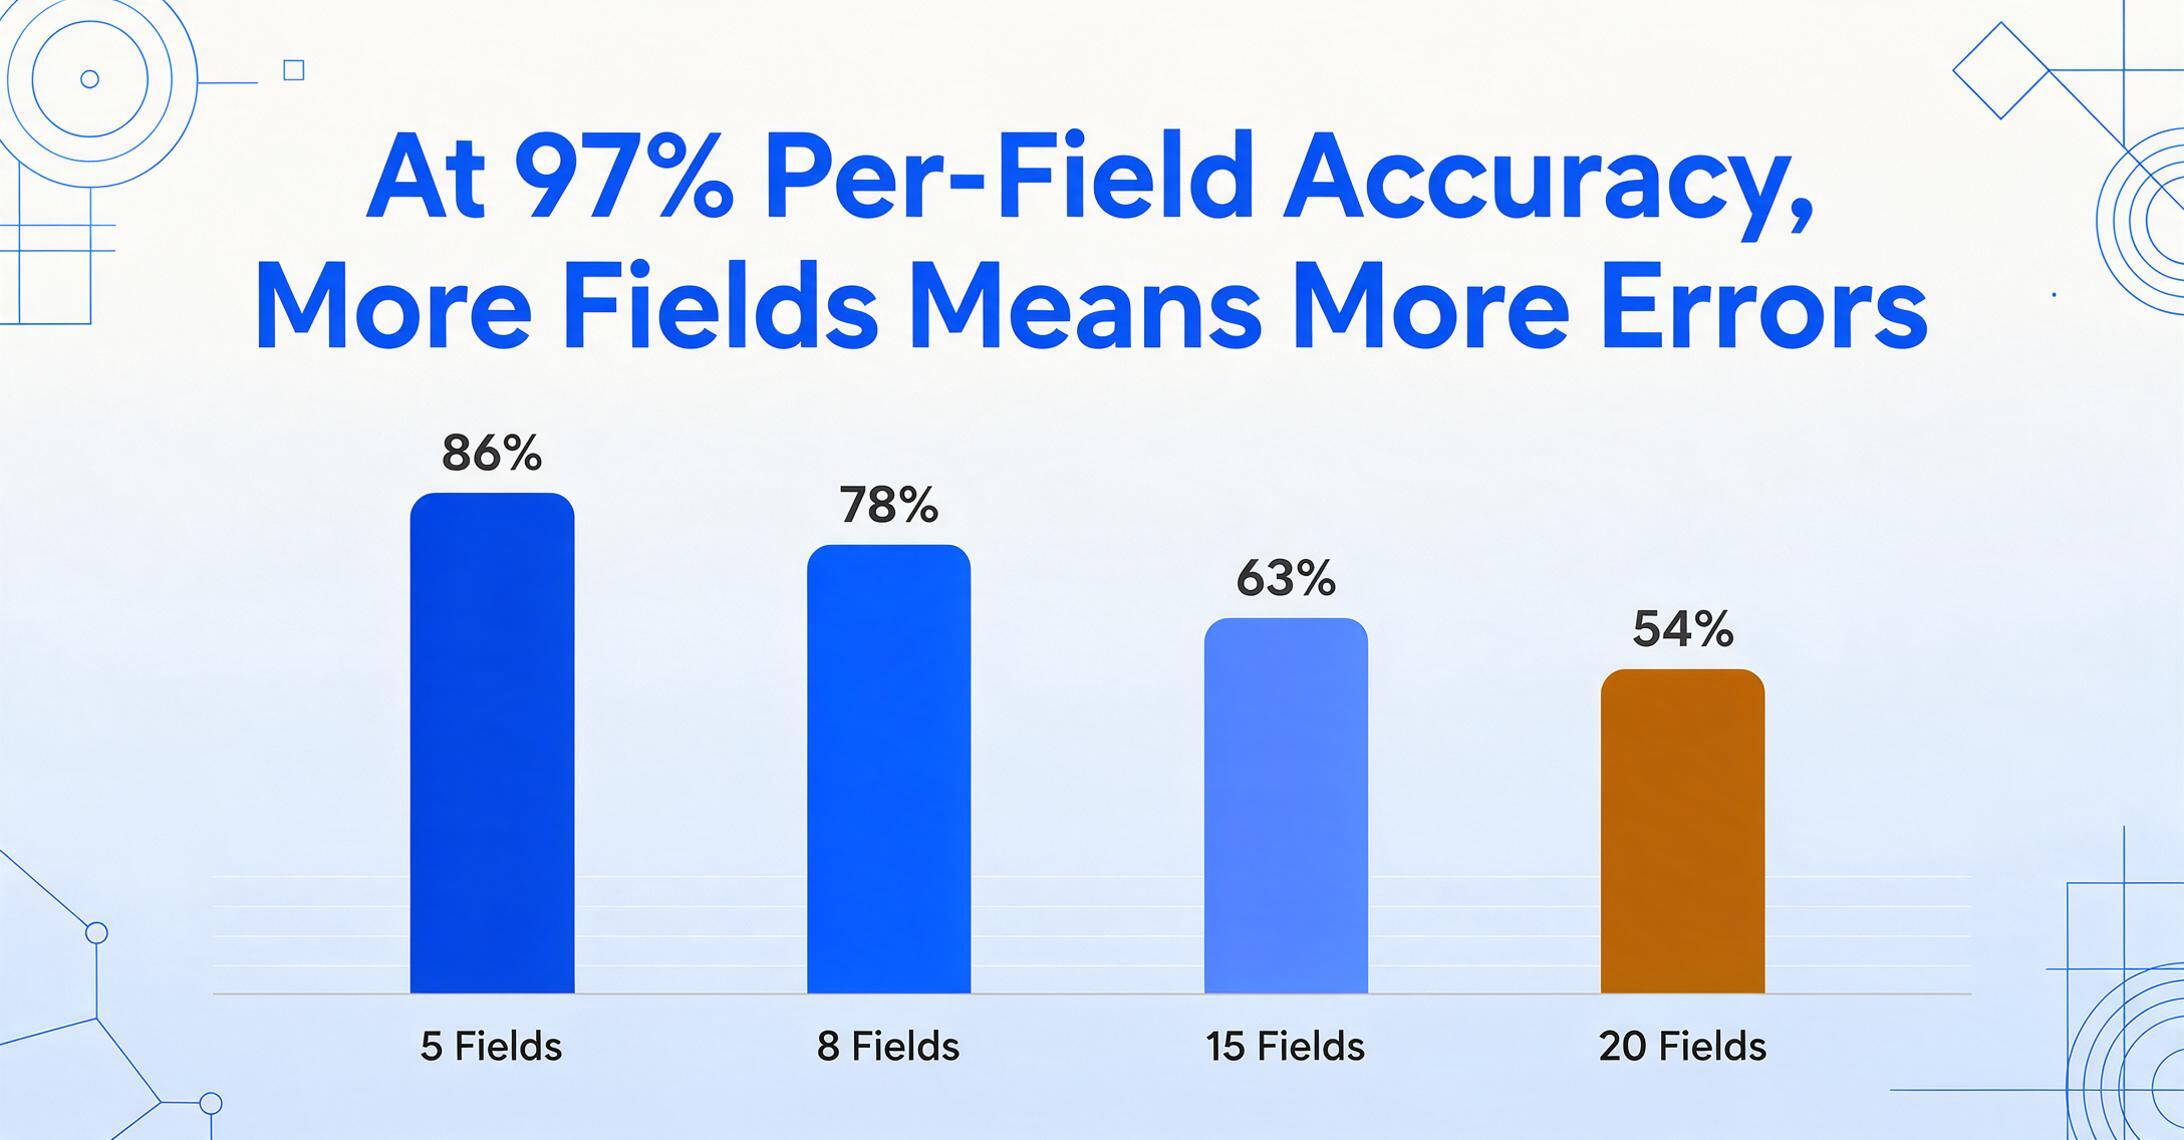
Même avec une précision par champ de 97 % — une référence solide pour les moteurs d'extraction IA modernes — extraire 20 champs signifie que seulement 54 % environ des factures arrivent entièrement correctes. Réduisez à 8 champs, et ce chiffre grimpe à environ 78 %.
Le calcul est simple : 0,97 élevé à la puissance 8 = 0,784, mais 0,97 élevé à la puissance 20 = 0,544. Chaque champ supplémentaire que vous extrayez est un nouveau coup de dés. L'erreur composée est la raison pour laquelle les flux « tout extraire » échouent à grande échelle, et c'est un concept que presque aucun article sur l'extraction de factures n'aborde.
Voici comment le risque au niveau des champs se cumule dans les scénarios d'extraction courants, sur la base des taux de précision par champ observés dans les pipelines d'extraction IA en production :
| Champs extraits | Précision par champ | Factures entièrement correctes | Factures nécessitant une vérification | Exemple de scénario |
|---|---|---|---|---|
| 5 | 97 % | ~86 % | 14 % | N° de facture, date, fournisseur, total, taxes |
| 8 | 97 % | ~78 % | 22 % | Ci-dessus + date d'échéance, n° de bon de commande, devise |
| 15 | 97 % | ~63 % | 37 % | Ci-dessus + lignes d'articles, adresse de facturation, conditions de paiement, expédition |
| 20 | 97 % | ~54 % | 46 % | Ci-dessus + coordonnées, coordonnées bancaires, conditions de remise, notes |
Ce tableau ne signifie pas que vous devez vous limiter à 5 champs. Il signifie que vous devez choisir délibérément les champs à extraire — car chaque colonne ajoutée à votre liste d'extraction a un coût réel en temps de vérification. Tous les champs ne présentent pas le même risque. Une date de facture mal lue est un inconvénient. Un montant total mal lu peut entraîner un trop-payé. Voici comment les types de champs se répartissent par niveau de risque :
| Niveau de risque | Champs | Stratégie d'extraction |
|---|---|---|
| Élevé | Montant total, TVA/Taxes, Date d'échéance, N° de compte bancaire | Toujours vérifier. Les erreurs ici ont un impact financier direct. |
| Moyen | N° de facture, N° de bon de commande, Nom du fournisseur, Devise | Contrôle par sondage. Les erreurs entraînent des problèmes de rapprochement, mais sont généralement détectées en aval. |
| Faible | Date de facture, Adresse de livraison, Conditions de paiement, Descriptions des lignes | Accepter la sortie de l'IA. Les erreurs ici affectent rarement les processus en aval. |
La conclusion est simple : extrayez les champs à haut risque avec vérification, les champs à risque moyen avec des contrôles par sondage, et demandez-vous si les champs à faible risque méritent même l'espace à l'écran. C'est cette réflexion au niveau du champ qui distingue un flux d'extraction utilisable d'un flux qui crée autant de travail qu'il n'en économise.
Comment fonctionne l'extraction de colonnes personnalisées : vous définissez la sortie
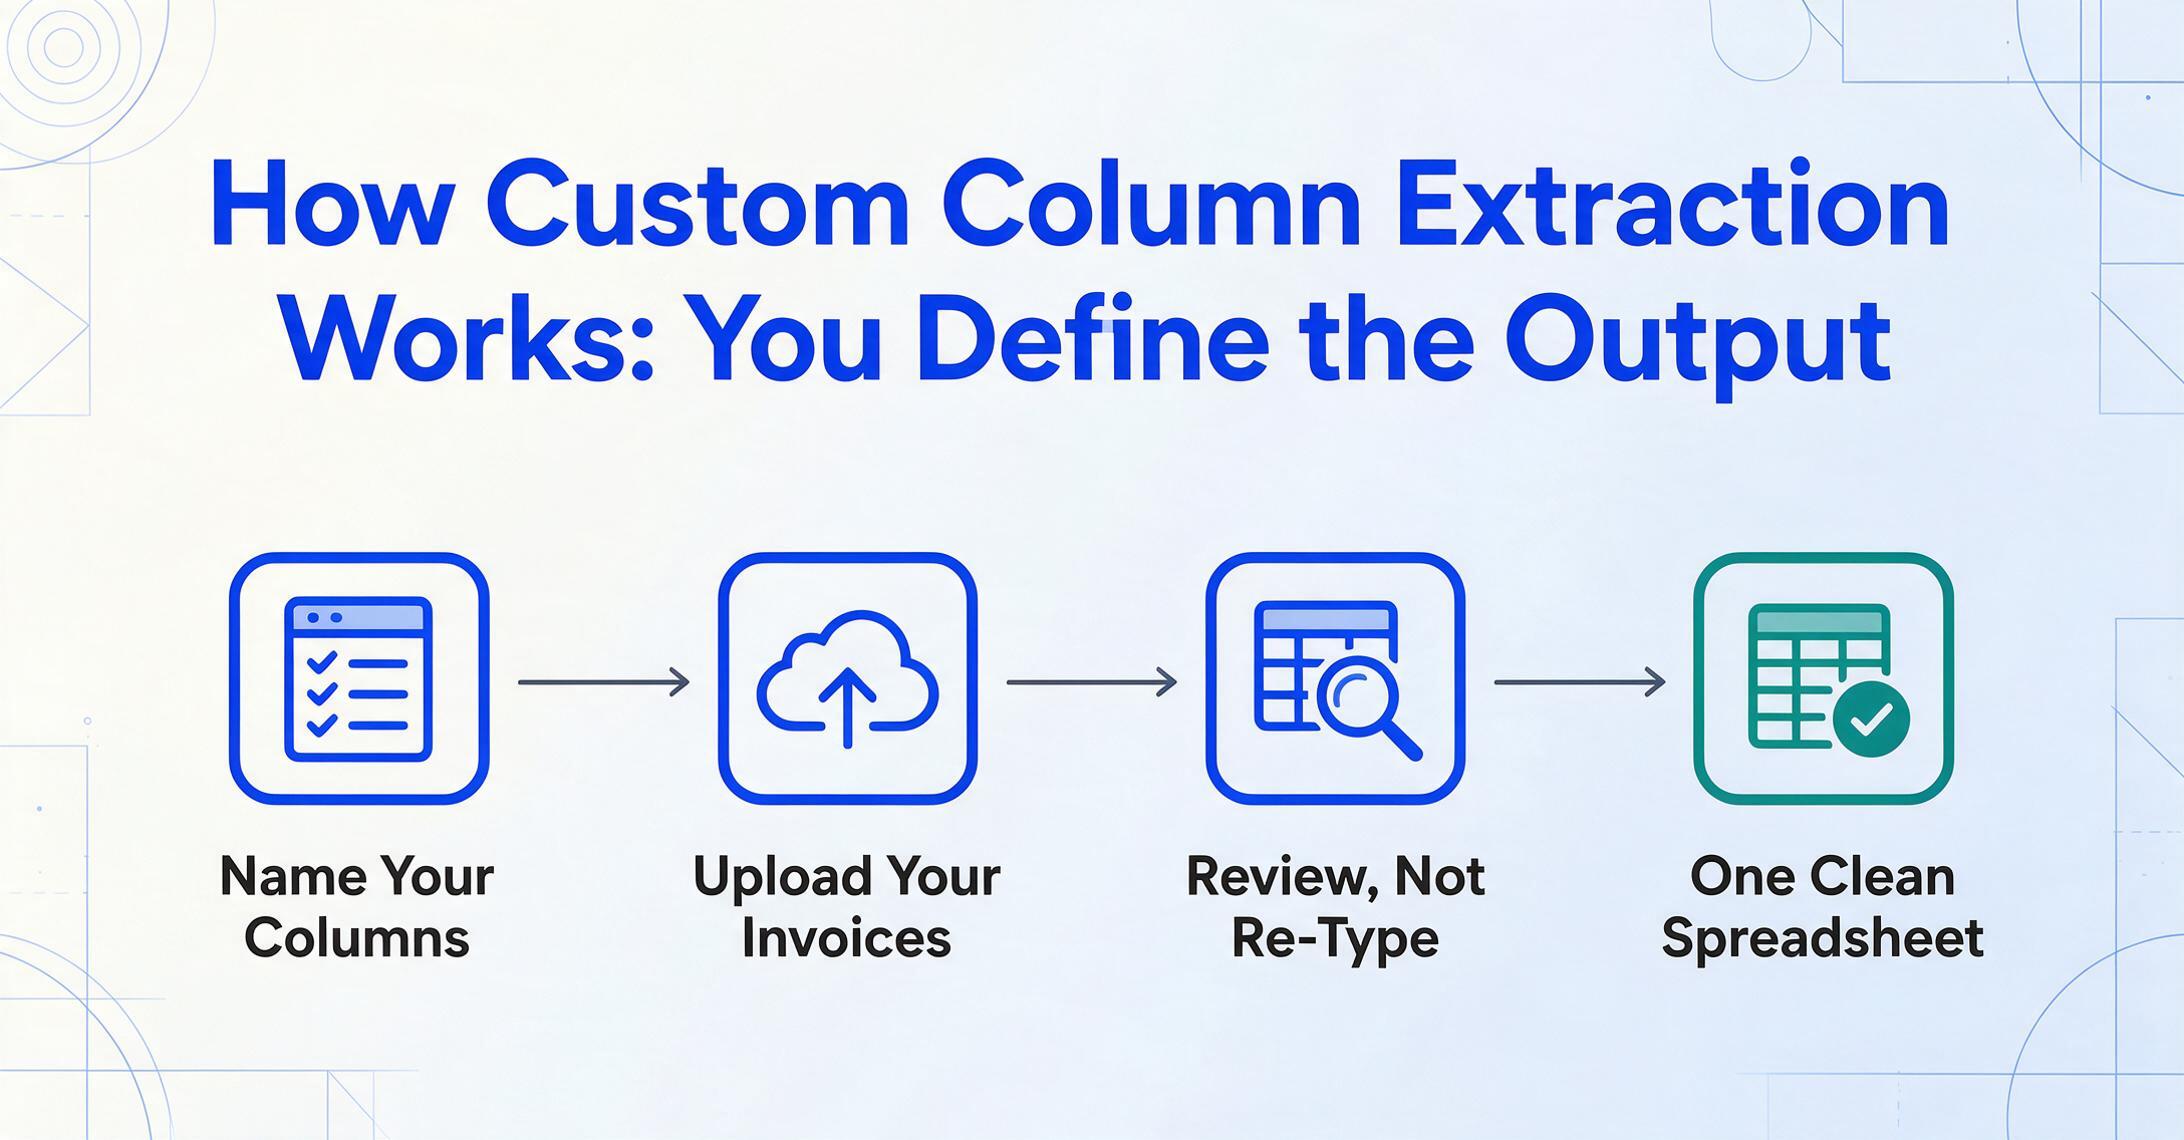
Les outils d'extraction PDF traditionnels vous demandent de dessiner des zones autour de chaque champ sur une facture d'exemple. L'extraction de colonnes personnalisées fonctionne dans le sens inverse : vous saisissez les noms des colonnes souhaitées, et l'IA localise les valeurs correspondantes en comprenant ce que signifie chaque champ, et non où il se trouve sur la page.
Cette distinction — extraction sémantique vs. extraction positionnelle — est ce qui rend l'extraction sélective de champs possible à grande échelle. Un outil basé sur des zones (Docparser, ABBYY ou tout moteur OCR à modèle) nécessite de définir un cadre de délimitation pour chaque champ sur le format de facture de chaque fournisseur. Lorsqu'un nouveau fournisseur envoie une facture avec une mise en page différente, les zones manquent leurs cibles et vous obtenez des données erronées. Avec l'extraction de colonnes personnalisées — le mécanisme central d'ImageToTable.ai — vous saisissez « N° de facture », « Date d'échéance », « Montant total » une seule fois, et l'IA trouve ces valeurs sur n'importe quelle mise en page, car elle lit pour le sens, pas pour la position.
Voici comment fonctionne l'extraction sélective en pratique :
Essayez par vous-même. La démo ci-dessous est en direct — téléversez une facture (ou tout document), saisissez les colonnes souhaitées, et observez l'IA les localiser. Aucune inscription requise.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Quels champs extraire (et lesquels ignorer)
Les bons champs dépendent de ce qui advient des données après l'extraction. Un comptable qui rapproche des écritures QuickBooks a besoin de colonnes différentes de celles d'un expert-comptable préparant des régularisations de fin de mois ou d'un responsable achats auditant les dépenses fournisseurs.
Commencez par vous demander : de quoi votre système de destination a-t-il réellement besoin ? Si vous importez dans QuickBooks Online, celui-ci a besoin du Fournisseur, de la Date, de la Date d'échéance, du Montant et de la Catégorie. Il n'a pas besoin du numéro de compte bancaire du fournisseur ni du code article de la ligne. Si vous alimentez SAP ou NetSuite, vous aurez peut-être besoin du numéro de bon de commande pour le rapprochement à trois. Si vous créez un tableau de bord des dépenses dans Google Sheets, vous voulez le Fournisseur, la Catégorie, le Montant et la Date — le numéro de facture est un plus, mais pas bloquant.
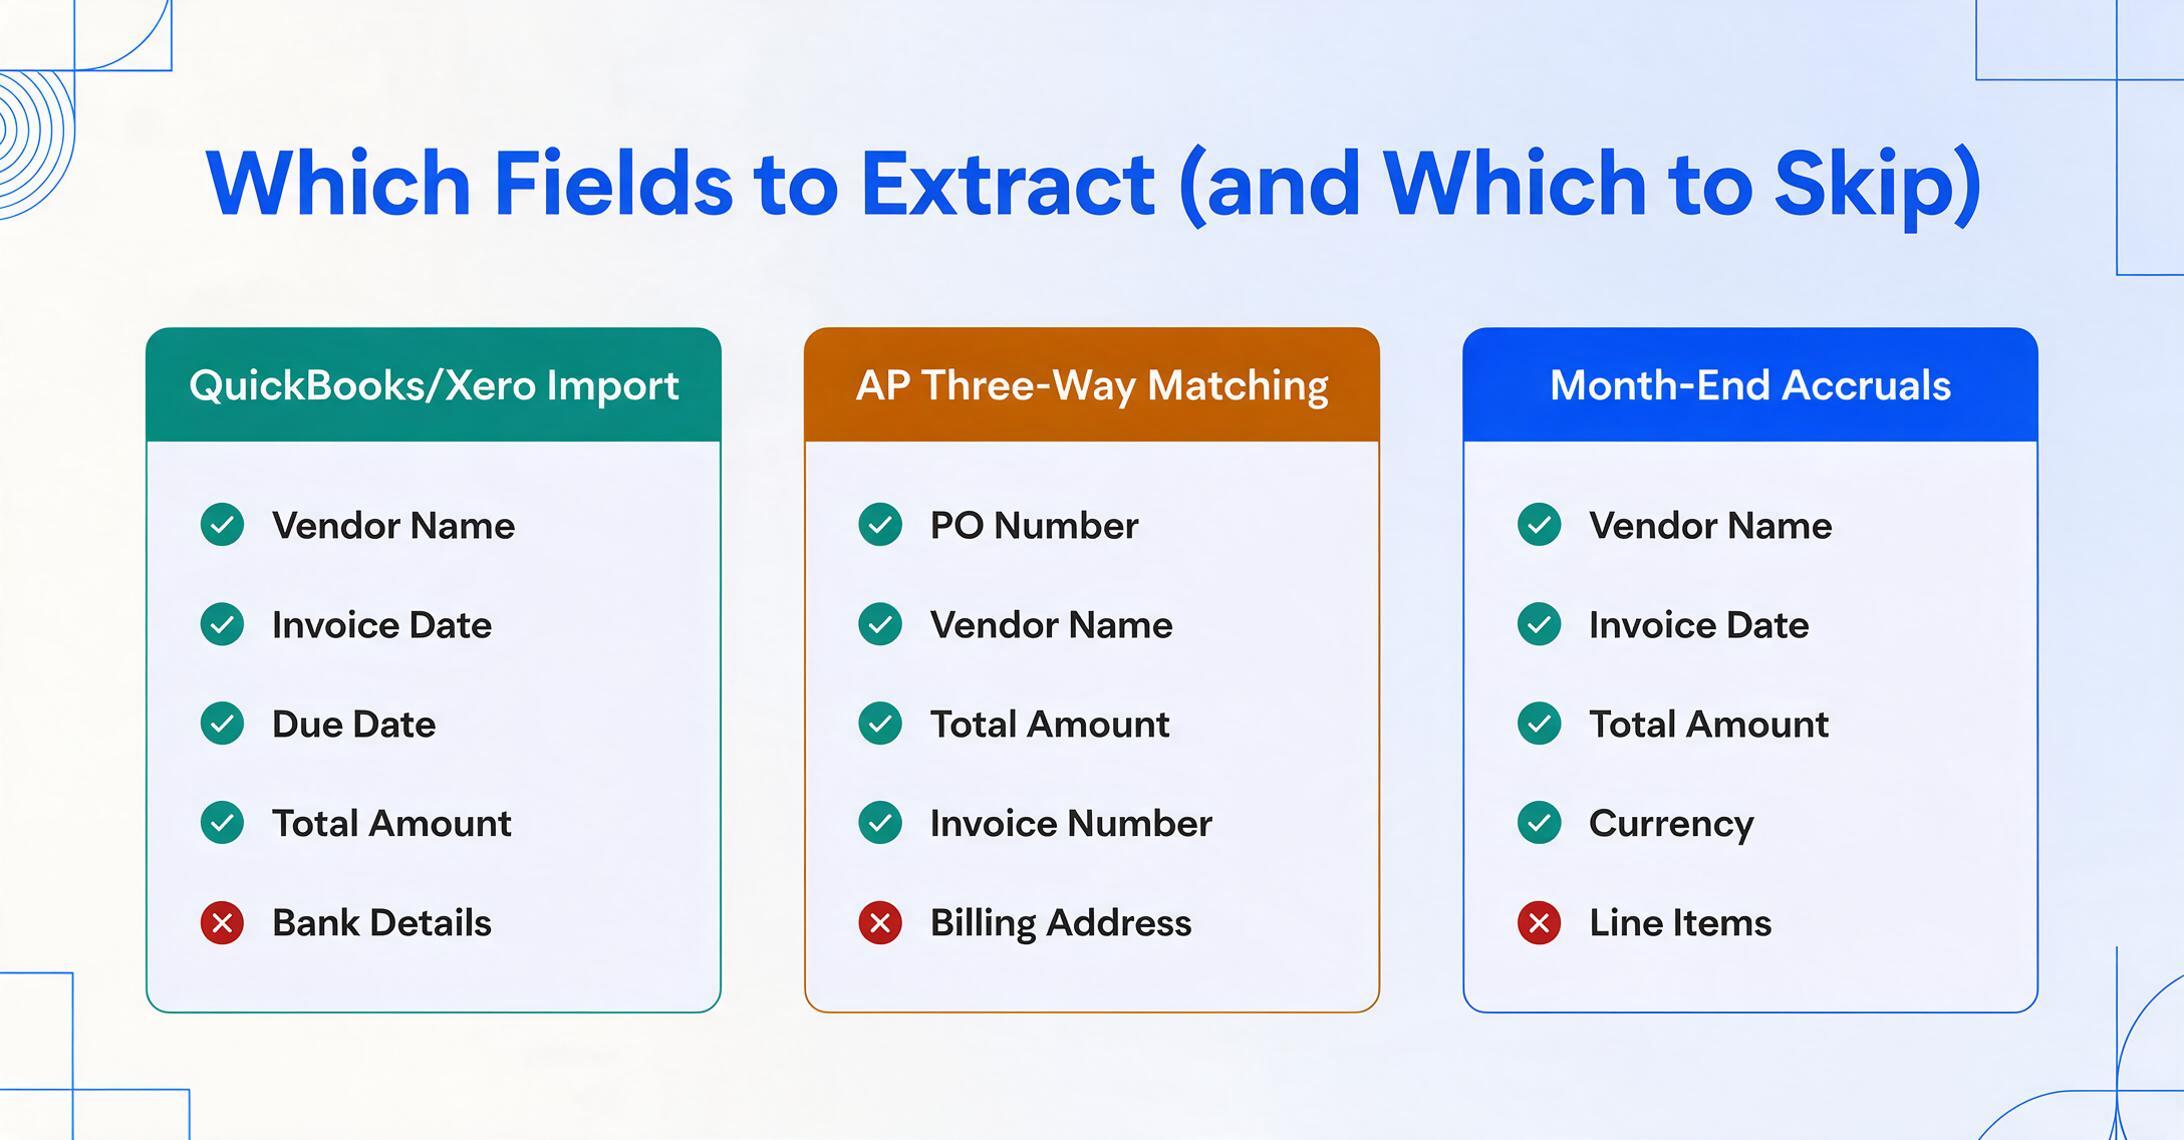
Voici un cadre de priorisation des champs basé sur les trois flux de travail facture-vers-système les plus courants :
| Flux de travail | À extraire absolument (non négociable) | À envisager (si le temps le permet) | À ignorer |
|---|---|---|---|
| Import QuickBooks/Xero | Nom du fournisseur, date de facture, date d'échéance, montant total | Numéro de facture, numéro de bon de commande, catégorie | Lignes, adresse de livraison, conditions de paiement, coordonnées bancaires |
| Rapprochement à trois (AP) | Numéro de bon de commande, nom du fournisseur, montant total, numéro de facture | Lignes (quantité, prix unitaire), montant de la taxe, devise | Adresse de facturation, coordonnées, conditions de remise |
| Régularisations de fin de mois | Nom du fournisseur, date de facture, montant total, devise | Date d'échéance, département/centre de coûts, catégorie | Numéro de bon de commande, lignes, expédition, conditions de paiement |
L'objectif est une extraction qui se termine dans le tableur — et non une extraction suivie d'une phase de nettoyage. Si une colonne de votre sortie n'alimente pas un système en aval, un rapport ou une décision, elle vous coûte du temps de relecture sans apporter de valeur.
ImageToTable.ai stocke ces configurations de colonnes sous forme de préréglages — des modèles de noms de colonnes réutilisables. Définissez votre liste de champs une fois, enregistrez-la comme préréglage, et chaque futur lot de factures sera traité avec le même ensemble de colonnes sélectif. Pour les formats de factures récurrents des mêmes fournisseurs (pensez aux factures mensuelles de services publics, aux livraisons hebdomadaires des fournisseurs), les préréglages éliminent entièrement l'étape de configuration.
Que se passe-t-il lorsque vous avez aussi besoin de colonnes calculées
Extraire le total d'une facture vous donne un chiffre. Ce dont vous avez souvent besoin, c'est la réponse à une question : la somme des lignes est-elle égale au total indiqué ? Quel est le montant hors taxes lorsque seul le brut est affiché ? Ce sont des colonnes calculées — des champs que l'IA calcule pendant l'extraction, et qu'elle ne se contente pas de lire sur la page.
Colonnes calculées sont l'une des capacités les plus sous-utilisées de l'extraction de factures par IA. Au lieu d'extraire des données brutes et d'exécuter des formules dans Excel ensuite, vous définissez le calcul dans un nom de colonne — et l'IA produit la réponse directement dans votre tableau de sortie.
Exemples pratiques de factures :
- Total de ligne (Qté × Prix unitaire) — La facture indique la quantité et le prix unitaire dans des colonnes séparées ; vous obtenez le produit dans une seule colonne.
- Montant de TVA (Total × 20 %) — Lorsque seul le total brut apparaît, l'IA applique le taux de taxe et génère le montant de la taxe.
- Écart (Total − Somme des lignes) — Signale automatiquement les factures où le total indiqué ne correspond pas au calcul des lignes.
- Catégorie (options : Matières premières / Produits finis / Services / Frais généraux) — L'IA lit les descriptions des lignes et classe chaque ligne dans votre plan comptable.
Les colonnes calculées amplifient les bénéfices de l'extraction sélective. Si vous pouvez extraire moins de champs et calculer le reste, votre plafond de précision augmente encore — car vous retirez entièrement ces champs du « tirage au sort de l'extraction » et les remplacez par une arithmétique déterministe que l'IA applique aux champs qu'elle a déjà lus correctement.
Quand la facture n'est pas la vôtre : liens de collecte pour les champs multipartites
Toutes les factures dont vous avez besoin ne parviennent pas dans votre boîte de réception. Si vous êtes comptable et que vous collectez les reçus de dépenses mensuels de 30 clients, ou si vous êtes entrepreneur et que vous rassemblez les factures fournisseurs pour le calcul des coûts de chantier, le goulot d'étranglement n'est pas l'extraction — c'est la collecte. Quelqu'un d'autre détient le fichier.
Lien de collecte résout ce problème en générant une page de téléversement partageable liée à votre compte. Vous envoyez le lien à un client, un travailleur de terrain ou un fournisseur. Ils l'ouvrent, saisissent un code de vérification court et téléversent leur facture directement — sans inscription, sans connexion, sans accès à vos autres fichiers. La facture arrive dans votre file de traitement, où vos colonnes présélectionnées et votre préréglage s'appliquent automatiquement.
Cela transforme votre configuration d'extraction sélective en pipeline. Vous définissez les champs une fois (par exemple, « Fournisseur, Date, Montant, Code de chantier »). Chaque facture qui passe par le lien de collecte — qu'elle vienne de trois ou trente clients — est traitée selon la même configuration de colonnes sélectives. L'expéditeur ne voit jamais vos colonnes. Il téléverse simplement. Vous obtenez exactement les champs dont vous avez besoin, rien de plus.
Traitement par lot : appliquez votre sélection de champs à grande échelle
Un employé de comptabilité fournisseurs manuel traite de 25 à 40 factures par jour, selon les références de l'IOFM. Avec le traitement par lot — téléversement de plusieurs fichiers à la fois et traitement selon les mêmes définitions de colonnes — ce nombre passe à des centaines. L'essentiel est que chaque facture du lot utilise le même ensemble de colonnes sélectives, ce qui signifie que chaque ligne de sortie est également éparse, également propre et également prête pour l'importation.
Le traitement par lot avec colonnes sélectives crée une structure de sortie cohérente que les systèmes en aval peuvent consommer sans reformatage manuel. Téléversez 50 factures, nommez 6 colonnes, obtenez une feuille de calcul avec 50 lignes et exactement 6 colonnes. Aucun écart de colonnes, aucune donnée parasite provenant de la 51e facture qui aurait eu un champ supplémentaire.
Le calcul des coûts est convaincant. Les références 2025 d'Ardent Partners situent le coût moyen de traitement manuel d'une facture à 9,84 $, l'Institute of Finance & Management (IOFM) citant jusqu'à 16 $ par facture pour les flux de travail entièrement manuels. À 500 factures par mois, cela représente 4 920 $ à 8 000 $ par mois rien que pour la saisie manuelle des données. Un flux de travail d'extraction sélective par lot — où une IA extrait uniquement les champs dont votre système comptable a besoin et où vous ne vérifiez que ceux à haut risque — ramène le coût par facture sous les 3 $, soit une réduction de 70 % ou plus.
Pour les équipes qui gèrent des factures de plusieurs clients ou départements, le traitement par lot de factures d'ImageToTable.ai préserve les configurations de champs par lot. Une entreprise de construction peut extraire « Fournisseur, Code de chantier, Montant, Retenue % » pour les factures de sous-traitants tout en extrayant « Fournisseur, Code GL, Montant, Taxe » pour les factures de frais généraux — deux ensembles de colonnes différents, deux lots différents, un seul outil.
Questions fréquentes
Et si je n'ai besoin que des lignes d'article, sans les champs d'en-tête ?
Vous pouvez extraire uniquement les données au niveau des lignes d'article — descriptions de produits, quantités, prix unitaires, totaux de ligne — sans toucher aux champs d'en-tête comme le numéro de facture ou le nom du fournisseur. Définissez vos colonnes comme « Description », « Qté », « Prix unitaire » et « Total de ligne ». L'IA renvoie une ligne par article, et vous obtenez toujours une seule feuille de calcul. C'est particulièrement utile pour le rapprochement des stocks ou la catégorisation des dépenses, où les données par article comptent plus que les métadonnées par facture.
Extraire moins de champs rend-il réellement l'IA plus précise sur les champs que je conserve ?
Pas directement — l'IA ne devient pas « plus précise » par champ lorsque vous en demandez moins. Mais le taux d'automatisation global s'améliore, car il y a moins de champs susceptibles de contenir une erreur. Avec 6 champs à 97 % de précision, environ 83 % de vos factures passent sans erreur. Avec 18 champs, ce taux chute à environ 58 %. Vous passez moins de temps au total à vérifier les corrections, ce qui est la véritable mesure d'efficacité.
Puis-je enregistrer ma sélection de colonnes et la réutiliser chaque mois ?
Oui — c'est exactement à cela que servent les préréglages. Définissez vos noms de colonnes une seule fois (par ex., « Fournisseur, N° de facture, Date, Date d'échéance, Total, Taxes »), enregistrez le préréglage, et chaque nouveau lot utilisera par défaut cette même configuration de colonnes. Vous pouvez gérer plusieurs préréglages pour différents fournisseurs, types de documents ou flux de travail comptables et basculer entre eux en un clic.
Que se passe-t-il si une facture ne contient pas l'un des champs demandés ?
L'IA laisse cette cellule vide dans le résultat. Elle n'invente pas de valeurs ni ne comble avec des suppositions. Si vous spécifiez « N° de bon de commande » et qu'une facture particulière n'en a pas, la colonne N° de bon de commande de cette ligne sera vide. C'est en réalité une fonctionnalité — une cellule vide est exploitable (vous savez qu'il faut relancer pour obtenir le bon de commande), alors qu'un numéro de bon de commande inventé pourrait corrompre votre rapprochement.
En quoi cela diffère-t-il du simple téléchargement de la facture dans ChatGPT pour lui demander d'extraire les champs ?
Un LLM généraliste comme ChatGPT peut extraire des champs d'une seule facture, mais il ne gère pas les lots nativement — vous devriez téléverser un fichier à la fois, et le format de sortie varie selon l'invite. Les outils d'extraction spécialisés fournissent une structure de colonnes cohérente pour chaque document d'un lot, ce qui rend la sortie importable dans QuickBooks, Xero ou tout flux de travail sur tableur. Les LLM généralistes manquent également de préréglages, de liens de collecte et de l'interface de traitement par lot qui élimine les interactions fichier par fichier.
Y a-t-il une limite à la spécificité de mes noms de colonnes ?
Aucune limite de caractères, mais les meilleurs résultats viennent de l'utilisation du langage que l'IA comprend — des termes financiers standard comme « Numéro de facture », « Date d'échéance », « Montant net ». Vous pouvez être plus précis avec les colonnes déduites : une colonne nommée « Catégorie (options : matières premières, produits finis, services) » indique à l'IA de lire chaque description de ligne et de la classer dans l'une de ces catégories — une tâche qui se fait normalement manuellement après l'extraction.
L'extraction sélective est plus rapide que l'extraction complète — voici pourquoi
La sagesse conventionnelle dit : extrayez tout, vous ne savez jamais ce dont vous aurez besoin plus tard. Les données disent : extrayez tout, et vous passerez plus de temps à nettoyer que ce que vous avez gagné en automatisant.
L'extraction sélective inverse la logique par défaut, passant de « tout extraire et supprimer plus tard » à « nommer ce dont vous avez besoin et obtenir exactement cela ». Le tableur arrive avec les colonnes demandées et rien d'autre. Pas d'étape de suppression. Pas de moment « qu'est-ce que cette colonne signifie même ». Lorsque vous n'extrayez que 6 champs au lieu de 20, vos factures passent d'une chance sur deux d'être correctes (54 %) à une forte probabilité (83 %) — et celles qui ne sont pas correctes ont moins de champs à vérifier.
Les références d'APQC montrent clairement où se situe le coût : 21,40 $ par facture manuelle, tombant à 2,78 $ avec l'automatisation par IA. L'écart entre ces chiffres n'est pas seulement l'étape d'extraction — c'est la vérification, le nettoyage, le reformatage, la suppression de colonnes. L'extraction sélective élimine l'étape de nettoyage de l'équation.
Essayez sur vos propres factures. Téléversez quelques PDF, nommez 5 ou 6 colonnes dont vous avez réellement besoin, et voyez ce qui revient. Si le résultat est plus propre que la sortie à laquelle vous êtes habitué — avec moins de colonnes à supprimer et moins de champs à vérifier — vous avez trouvé votre stratégie d'extraction.
Essayez maintenant