請求書データを抽出する方法
ページ単位ではなくフィールド単位で
ほとんどの請求書抽出ツールは同じ暗黙の前提に基づいています。それは、ページ上のすべてのデータポイントが必要だという前提です。仕入先名、請求書番号、日付、支払期日、小計、税額、明細項目、配送先住所、支払条件、銀行口座情報など、すべてを抽出します。その後、列を削除するのに10分を費やすことになります。選択的抽出はその論理を逆転させます。必要なフィールドを指定すると、AIはそのフィールドだけを見つけます。これにより、抽出後のクリーンアップが減り、フィールド単位の精度が向上し、完成に近い状態のスプレッドシートが得られます。このガイドでは、その方法をページ単位ではなくフィールド単位で正確に説明します。
重要なポイント
- 従来の考え方では、すべての請求書からすべてのフィールドを抽出すべきとされています。後でどのデータが必要になるかわからないからです。
- フィールド単位の精度97%は優れているように聞こえますが、20のフィールドにわたると、完全に正しい請求書はわずか54%です。各追加フィールドが独立した失敗ポイントになるためです。
- 会計システムが実際に必要とする6つのフィールドだけを抽出すれば、完全自動処理率は83%に跳ね上がり、クリーンアップのステップは完全に不要になります。
「すべてを抽出する」という前提が処理を遅くする
APQCの2024~2025年ベンチマーク調査によると、企業が1枚の請求書を手作業で処理するのにかかるコストの中央値は21.40ドルです。AIを活用した抽出では、優良企業のコストは2.78ドルまで下がります。これは87%の削減です。しかし、この削減効果は、データがスプレッドシートにきれいに反映されて初めて実現します。
経理チームに請求書から何を抽出したいか尋ねると、ほとんどのチームが「すべて」と答えます。その理由はもっともらしく聞こえます。データが多ければ、将来の分析がより充実するというものです。しかし、実際には、「すべて」を抽出すると、クリーンアップの工程が発生し、効率化のメリットのほとんどを帳消しにしてしまいます。AIが抽出する各フィールドには、小さな独立したエラー確率が伴います。8つではなく20のフィールドを抽出すると、これらの確率は複合的に積み重なり、気がつけば、元の文書を確認する代わりに、抽出結果の監査に時間を費やしていることになります。
このフラストレーションは理論上の話ではありません。r/Accountingのユーザーは、100枚の請求書のバッチでAI抽出をテストした後、次のように述べています。「正確ではなく、アップロードを待つよりも、レビューと編集に多くの時間を費やしていることに気づきました」。問題はAIではなく、すべての請求書のすべてのフィールドを抽出する必要があるという前提にあったのです。
Ardent PartnersのState of ePayables 2025レポートによると、人間の介入なしに完全自動処理される請求書はわずか35.4%で、平均的な例外発生率は18.4%です。この例外処理の多くは、抽出ツールが過剰にデータを取得しようとしたことが根本原因です。すべての列で人間による検証が必要になると、自動化はボトルネックを解消せず、データ入力からデータレビューへと移すだけです。
これが選択的抽出の核心です。会計システムがベンダー名、金額、支払期日のみをマッピングするのであれば、すべての請求書に配送先住所は必要ありません。カテゴリごとに経費を計上するのであれば、明細行の説明も不要です。抽出するフィールドを減らすことは妥協ではなく、実際に使えるスプレッドシートへの最短ルートです。
フィールド数が少ないほど精度が高まる理由(誰も語らない計算の話)
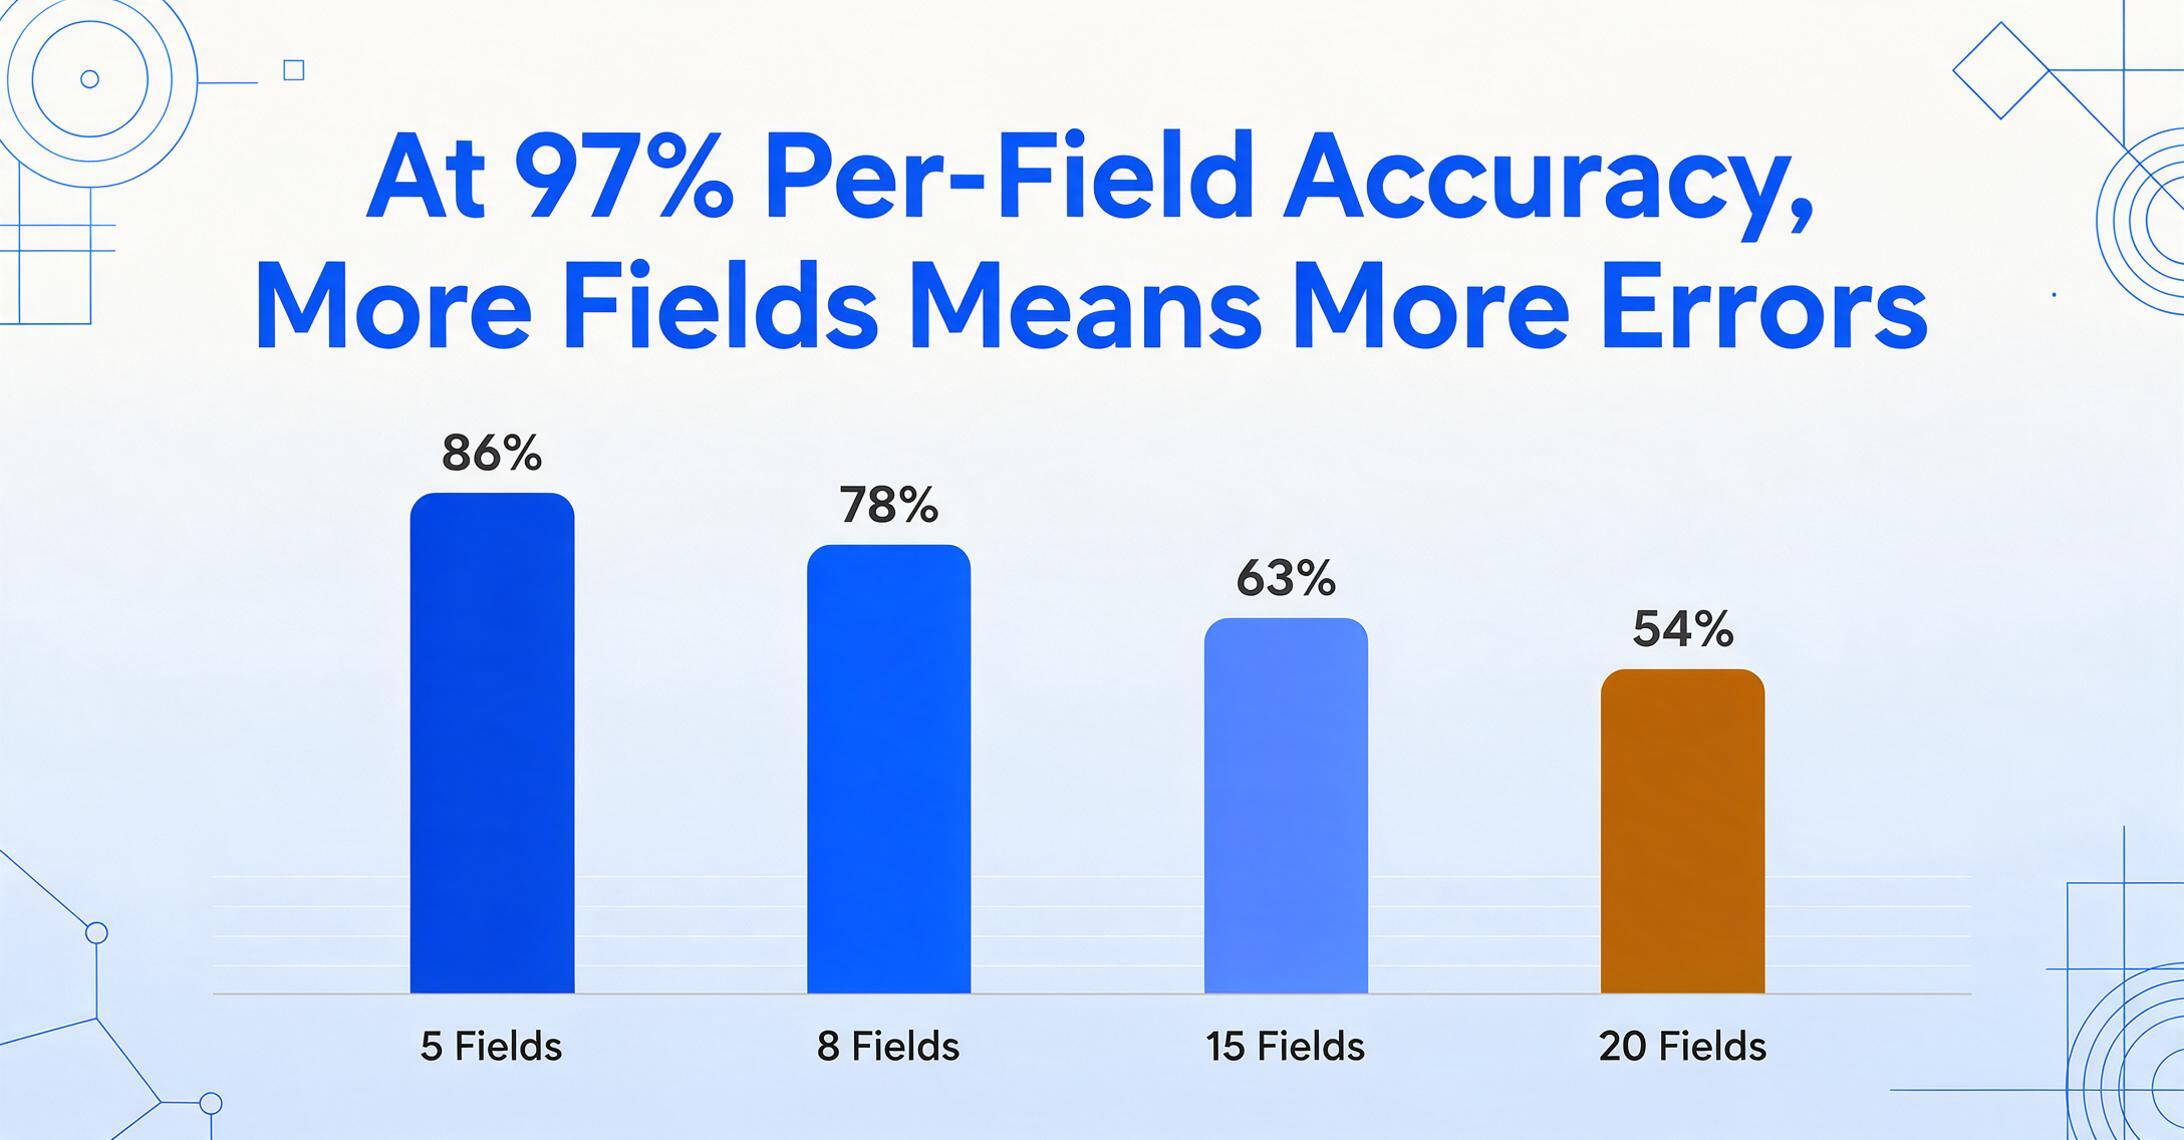
フィールド単位の精度が97%という、最新のAI抽出エンジンにとって優れたベンチマークであっても、20フィールドを抽出すると、完全に正しい請求書は約54%しかありません。8フィールドに減らせば、その数値は約78%まで跳ね上がります。
計算は単純です。0.97の8乗は0.784ですが、0.97の20乗は0.544です。抽出するフィールドが1つ増えるごとに、サイコロをもう1回振るようなものです。複合エラーこそ、「すべて抽出」ワークフローが大規模で失敗する理由であり、この概念に言及する請求書抽出の記事はほとんどありません。
以下は、本番のAI抽出パイプラインで観測されたフィールド単位の精度に基づき、フィールドレベルのリスクが一般的な抽出シナリオでどのように複合するかを示したものです。
| 抽出フィールド数 | フィールド単位の精度 | 完全に正しい請求書 | レビューが必要な請求書 | シナリオ例 |
|---|---|---|---|---|
| 5 | 97% | 約86% | 14% | 請求書番号、日付、取引先、合計、税額 |
| 8 | 97% | 約78% | 22% | 上記+支払期日、注文番号、通貨 |
| 15 | 97% | 約63% | 37% | 上記+明細行、請求先住所、支払条件、配送情報 |
| 20 | 97% | 約54% | 46% | 上記+連絡先情報、銀行口座情報、割引条件、備考 |
この表は、常に5フィールドだけを抽出すべきだという意味ではありません。抽出するフィールドを意図的に選ぶべきだということです。抽出リストに列を1つ追加するごとに、レビュー時間という実質的なコストが発生します。すべてのフィールドが同じリスクを伴うわけでもありません。請求書の日付の誤読は不便な程度ですが、合計金額の誤読は過払いを引き起こす可能性があります。以下は、フィールドタイプ別のリスク分類です。
| リスクレベル | フィールド | 抽出戦略 |
|---|---|---|
| 高 | 合計金額、VAT・税額、支払期日、銀行口座番号 | 常に検証。ここでのエラーは財務に直接影響します。 |
| 中 | 請求書番号、発注番号、仕入先名、通貨 | スポットチェック。エラーは照合の問題を引き起こしますが、通常は後続工程で検出されます。 |
| 低 | 請求日、配送先住所、支払条件、明細の説明 | AIの出力を受け入れます。ここでのエラーが後続工程に影響することはほとんどありません。 |
結論はシンプルです:高リスクのフィールドは検証付きで抽出し、中リスクのフィールドはスポットチェックを行い、低リスクのフィールドが画面スペースを割く価値があるかどうかを検討してください。これこそが、実用的な抽出ワークフローと、節約する以上に手間を生み出すワークフローを分けるフィールド単位の考え方です。
カスタム列抽出の仕組み:出力を定義するのはお客様
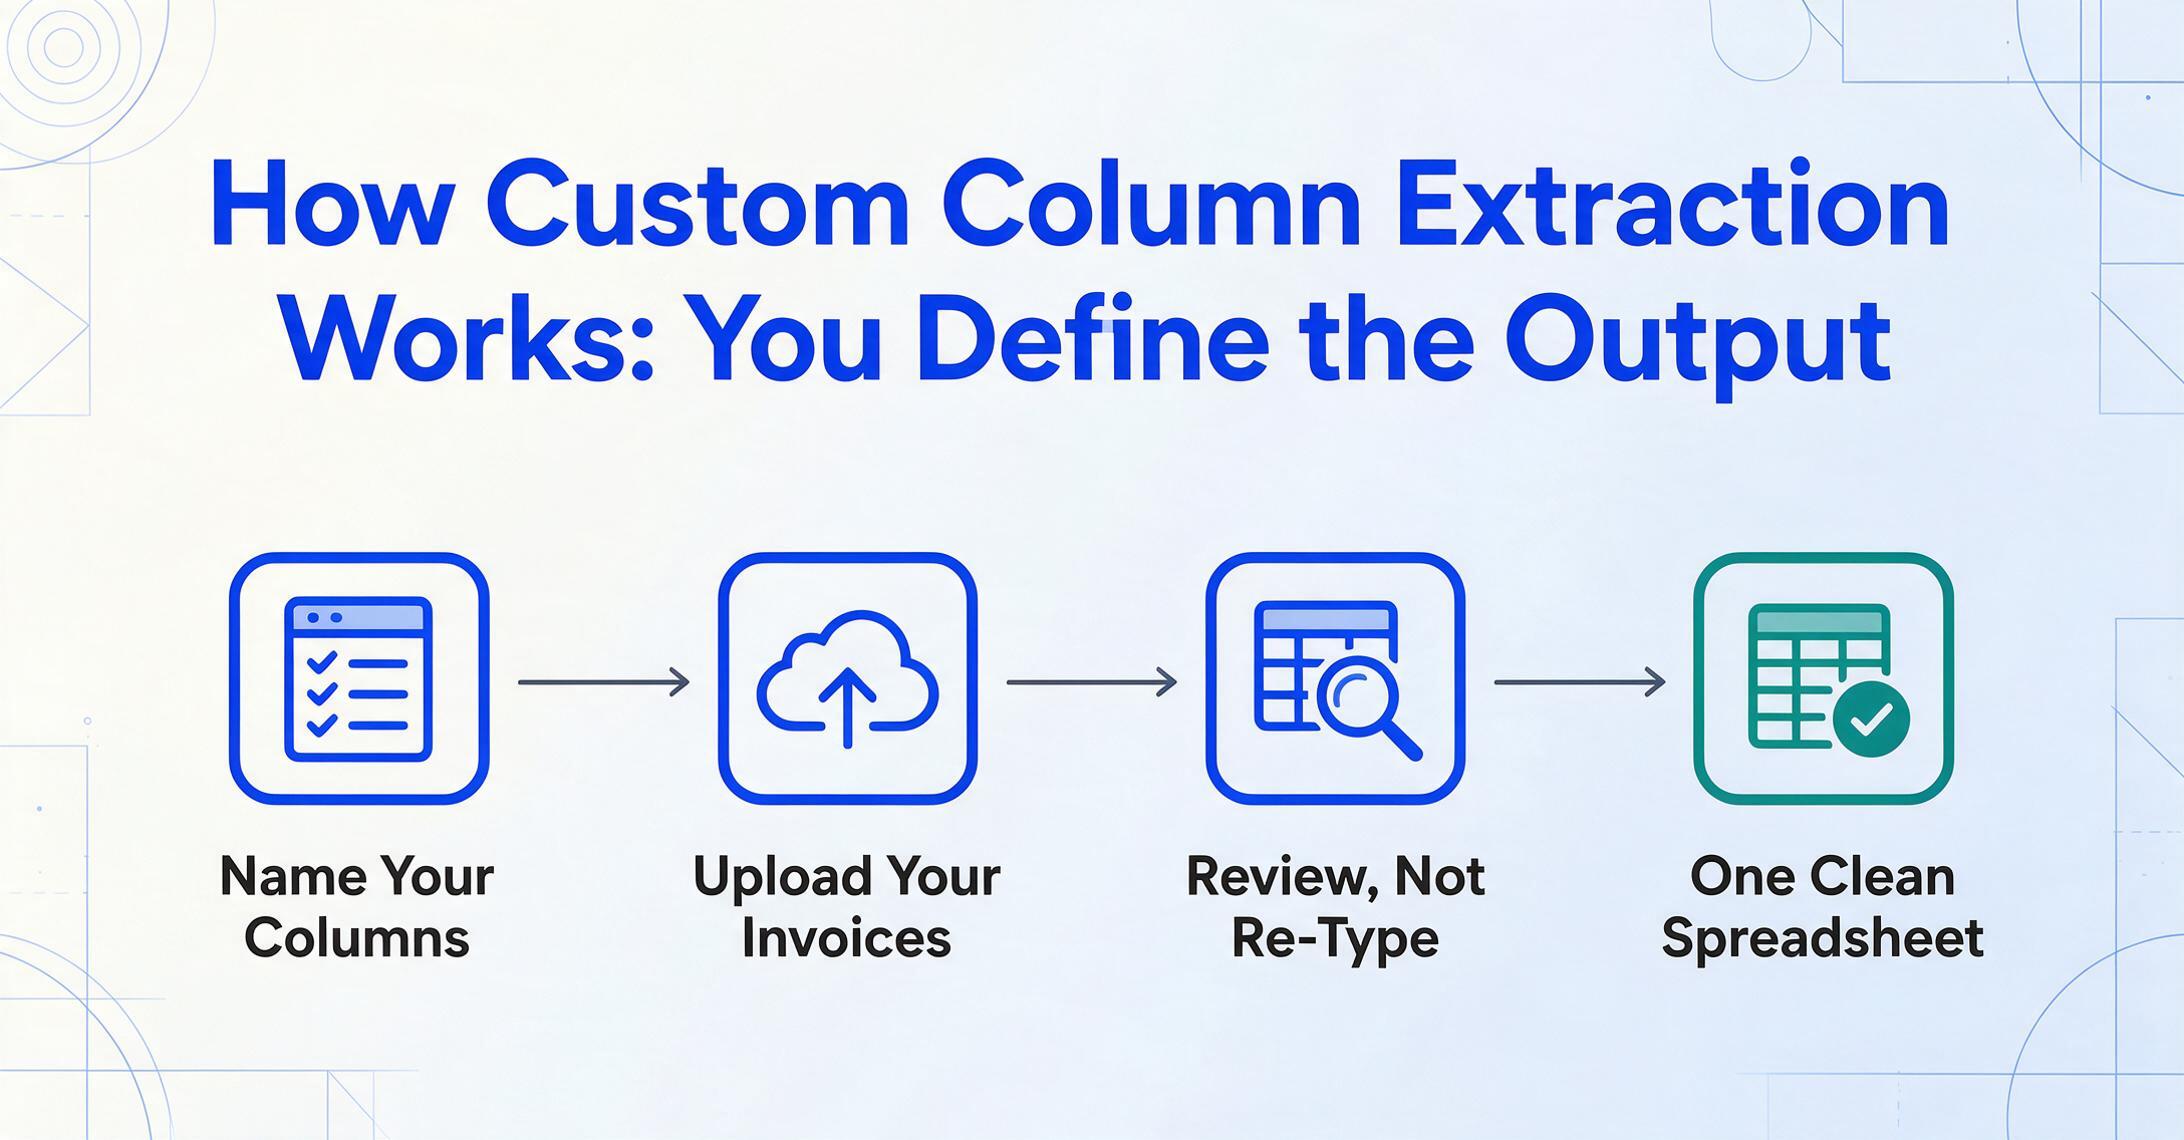
従来のPDF抽出ツールでは、サンプル請求書の各フィールドの周囲にゾーンを描画する必要があります。カスタム列抽出はその逆の方向で機能します:お客様が希望する列名を入力すると、AIが各フィールドの意味を理解して対応する値を特定します。ページ上の位置ではなく、意味に基づいて。
この違い — 意味ベースの抽出と位置ベースの抽出 — こそが、大規模な選択的フィールド抽出を可能にするものです。ゾーンベースのツール(Docparser、ABBYY、その他のテンプレートOCRエンジン)では、各仕入先の請求書フォーマットのすべてのフィールドにバウンディングボックスを定義する必要があります。新しい取引先が異なるレイアウトの請求書を送ってくると、ゾーンが対象を外れ、無価値なデータが生成されます。カスタム列抽出 — ImageToTable.aiの中核メカニズム — では、「請求書番号」「支払期日」「合計金額」を一度入力するだけで、AIが意味を読み取って位置に依存せず、あらゆるレイアウトでそれらの値を特定します。
選択的抽出が実際にどのように機能するかを説明します:
ぜひお試しください。以下のデモは実際に動作します。請求書(または任意の文書)をアップロードし、必要な列を入力すると、AIがそれらを特定します。サインアップは不要です。
ファイルは安全に処理され、保存されることはありません。
抽出するフィールド(およびスキップするフィールド)
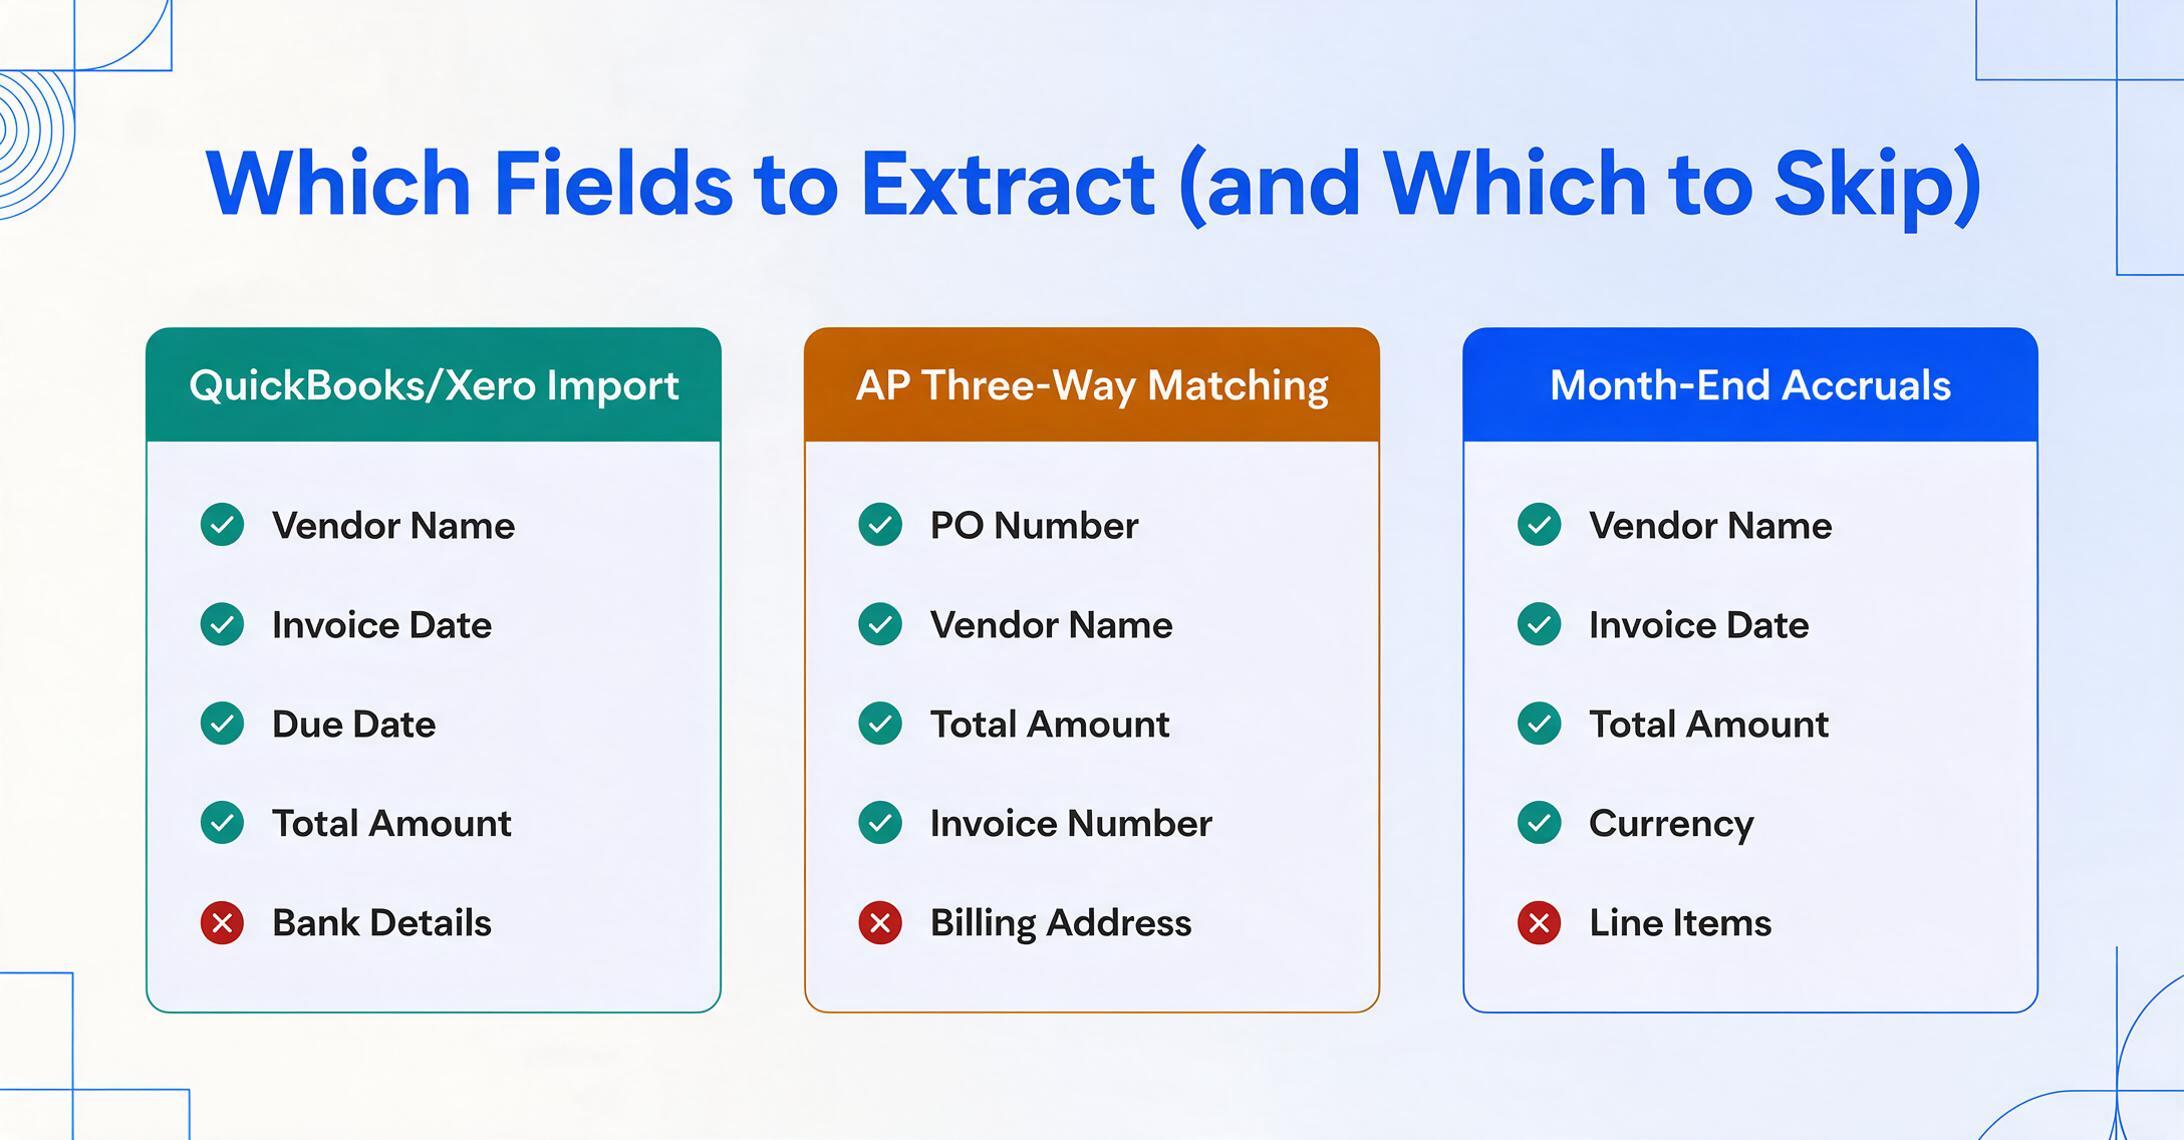
適切なフィールドは、抽出後にデータがどう使われるかによって異なります。QuickBooksの仕訳を照合する簿記担当者と、月末の見越し計上を準備する会計士、またはサプライヤー支出を監査する購買マネージャーとでは、必要な列が異なります。
まず自問してください:お客様の宛先システムは実際に何を必要としていますか? QuickBooks Onlineにインポートする場合、ベンダー、日付、期日、金額、カテゴリが重要です。サプライヤーの銀行口座番号や明細行のSKUは必要ありません。SAPやNetSuiteにデータを送る場合は、3ウェイマッチングのためにPO番号が必要になるかもしれません。Google Sheetsで支出ダッシュボードを構築する場合は、ベンダー、カテゴリ、金額、日付が必要です。請求書番号はあると便利ですが、必須ではありません。
以下は、最も一般的な3つの請求書からシステムへのワークフローに基づくフィールド優先順位付けのフレームワークです:
| ワークフロー | 必須抽出(譲れないもの) | 検討(時間があれば) | スキップ |
|---|---|---|---|
| QuickBooks/Xeroインポート | ベンダー名、請求日、期日、合計金額 | 請求書番号、PO番号、カテゴリ | 明細行、配送先住所、支払条件、銀行詳細 |
| AP 3ウェイマッチング | PO番号、ベンダー名、合計金額、請求書番号 | 明細行(数量、単価)、税額、通貨 | 請求先住所、連絡先情報、割引条件 |
| 月末見越し計上 | ベンダー名、請求日、合計金額、通貨 | 期日、部門/コストセンター、カテゴリ | PO番号、明細行、配送、支払条件 |
目標は、スプレッドシートで終了する抽出です。抽出後のクリーンアップフェーズを伴うものではありません。 出力の列がダウンストリームシステム、レポート、または意思決定に反映されない場合、その列は価値を提供せずにレビュー時間を費やしていることになります。
ImageToTable.aiは、これらの列設定をプリセットとして保存します。これは再利用可能な列名テンプレートです。フィールドリストを一度定義してプリセットとして保存すれば、将来のすべての請求書バッチが同じ選択的列セットに対して処理されます。同じベンダーからの定期的な請求書形式(毎月の公共料金、毎週のサプライヤー納品など)の場合、プリセットはセットアップステップを完全に排除します。
計算列も必要な場合はどうなるのか
請求書の合計を抽出すると数値が得られます。しかし、多くの場合に必要なのは質問への答えです。明細行の合計は記載された合計と一致しているか? 総額のみが表示されている場合、税抜き金額はいくらか? これらが計算列です。AIが抽出中に計算するフィールドであり、単にページから読み取るだけではありません。
計算列は、AI請求書抽出において最も活用されていない機能のひとつです。生データを抽出して後でExcelで数式を実行する代わりに、列名で計算を定義するだけで、AIが出力テーブルに直接答えを生成します。
実際の請求書の例:
- 明細合計(数量 × 単価) — 請求書に数量と単価が別々の列で記載されている場合、1つの列で積を取得できます。
- 消費税額(合計 × 20%) — 総額のみが表示されている場合、AIが税率を適用して税額を出力します。
- 差異(合計 − 明細行の合計) — 記載された合計が明細行の計算と一致しない請求書を自動的にフラグ付けします。
- カテゴリ(選択肢:原材料/完成品/サービス/間接費) — AIが明細行の説明を読み取り、各行を勘定科目コード表に分類します。
計算列は選択的抽出の利点をさらに高めます。抽出するフィールドを減らして残りを計算できれば、精度の上限はさらに上がります。なぜなら、「抽出の運任せ」からフィールドを完全に除外し、AIがすでに正しく読み取ったフィールドに対して実行する決定的な算術演算に置き換えるからです。
請求書が自分のものではない場合:複数当事者フィールド向けコレクションリンク
データが必要な請求書がすべて自分の受信トレイに届くわけではありません。30社のクライアントから毎月の経費領収書を集める会計士、またはジョブ原価計算のためにベンダー請求書を集める請負業者であれば、ボトルネックは抽出ではなく収集です。ファイルを誰か他の人が持っているのです。
コレクションリンクは、アカウントに紐づいた共有可能なアップロードページを生成することでこの問題を解決します。リンクをクライアント、現場作業員、またはサプライヤーに送信します。相手はリンクを開き、短い確認コードを入力し、請求書を直接アップロードします。登録もログインも不要で、他のファイルへのアクセスもありません。請求書は処理キューに届き、事前に選択した列とプリセットが自動的に適用されます。
これにより、選択的抽出の設定がパイプラインに変わります。フィールドを一度定義するだけで(例:「ベンダー、日付、金額、ジョブコード」)、コレクションリンクを通じて届くすべての請求書(3社でも30社でも)が同じ選択的列設定で処理されます。送信者は列を見ることはありません。アップロードするだけです。必要なフィールドだけが正確に得られます。
バッチ処理:フィールド選択を大規模に適用
手動のAP担当者は、IOFMのベンチマークによると1日あたり25〜40枚の請求書を処理します。バッチ処理(複数ファイルを一度にアップロードし、同じ列定義で処理すること)を使用すると、その数は数百枚に跳ね上がります。重要なのは、バッチ内のすべての請求書が同じ選択的列セットを使用するため、すべての出力行が同様にスパースで、同様にクリーンで、インポートの準備ができていることです。
選択的列を使用したバッチ処理は、下流システムが手動での再フォーマットなしに消費できる一貫した出力構造を作り出します。50枚の請求書をアップロードし、6つの列に名前を付け、50行と正確に6列の1つのスプレッドシートを取得します。列の不一致も、たまたま余分なフィールドがあった51枚目の請求書からの迷子データもありません。
コスト計算は説得力があります。Ardent Partnersの2025年ベンチマークでは、平均的な手動請求書処理コストは$9.84で、Institute of Finance & Management(IOFM)は完全に手動のワークフローで請求書1枚あたり最大$16としています。月500枚の場合、手動データ入力だけで月$4,920〜$8,000になります。選択的バッチ抽出ワークフロー(AIが会計システムに必要なフィールドのみを抽出し、リスクの高いものだけを検証する)では、請求書1枚あたりのコストが$3未満になり、70%以上の削減になります。
複数のクライアントや部門にわたって請求書を管理するチームにとって、ImageToTable.aiのバッチ請求書処理はバッチごとのフィールド設定を保持します。建設会社は、下請け業者の請求書には「ベンダー、ジョブコード、金額、保留%」を抽出し、経費の請求書には「ベンダー、GLコード、金額、税金」を抽出するかもしれません。2つの異なる列セット、2つの異なるバッチ、1つのツールです。
よくある質問
ヘッダーフィールドは不要で、明細項目だけが必要な場合はどうすればよいですか?
明細項目レベルのデータのみを抽出できます — 製品説明、数量、単価、明細合計など。請求書番号や仕入先名などのヘッダーフィールドには触れません。列を「説明」「数量」「単価」「明細合計」として定義してください。AIは明細項目ごとに1行を返し、スプレッドシートは1つにまとまります。これは、在庫照合や支出分類など、請求書ごとのメタデータよりも項目ごとのデータが重要な場合に特に役立ちます。
抽出するフィールドを減らすと、残したフィールドの精度は実際に上がりますか?
直接的な効果はありません — フィールド数を減らしても、AIのフィールドごとの精度が「上がる」わけではありません。ただし全体的な自動化率は向上します。エラーが発生し得るフィールドが減るためです。6フィールドで精度97%の場合、請求書の約83%がクリーンに処理されます。18フィールドでは約58%に低下します。修正の確認に費やす合計時間が減るため、これが実際の効率指標となります。
列の選択を保存して、毎月再利用できますか?
はい — これはまさにプリセットの用途です。列名を一度定義し(例:「仕入先、請求書番号、日付、期日、合計、税額」)、プリセットを保存すると、新しいバッチはすべて同じ列構成をデフォルトで使用します。異なる仕入先、文書タイプ、会計ワークフロー用に複数のプリセットを維持し、ワンクリックで切り替えることができます。
指定したフィールドの1つが請求書にない場合はどうなりますか?
AIは出力の該当セルを空白のままにします。値を捏造したり、推測で埋めたりすることはありません。「PO番号」を指定しても、特定の請求書にPO番号がない場合、その行のPO番号列は空になります。これは実は機能です — 空白セルはアクションにつながります(PO番号の確認が必要だと分かります)。一方、捏造されたPO番号は照合プロセスを壊す可能性があります。
請求書をChatGPTにアップロードしてフィールド抽出を依頼する方法と比べてどうですか?
汎用LLMであるChatGPTは、単一の請求書からフィールドを抽出できますが、バッチ処理には本来対応していません。ファイルを1つずつアップロードする必要があり、出力形式はプロンプトによって異なります。目的特化型の抽出ツールは、バッチ内のすべてのドキュメントで一貫した列構造を提供するため、QuickBooks、Xero、またはあらゆるスプレッドシートワークフローにインポート可能な出力が得られます。汎用LLMには、ファイルごとの操作を不要にするプリセット、コレクションリンク、バッチUIもありません。
列名の具体性に制限はありますか?
文字数制限はありませんが、最良の結果を得るには、AIが理解できる言語を使用することが重要です。「請求書番号」「支払期日」「正味金額」などの標準的な財務用語が適しています。推論列を使用すると、より具体的に指定できます。「カテゴリ(オプション:原材料、完成品、サービス)」という列名は、AIに各明細の説明を読み取らせ、それらのいずれかに分類するよう指示します。これは通常、抽出後に手動で行われるタスクです。
選択的抽出は全量抽出より速い — その理由はこちら
従来の考え方では、「すべてを抽出しておけば、後で必要になるかもしれない」と言われます。しかしデータは、「すべてを抽出すると、自動化で節約した時間以上に、クレンジングに時間を費やすことになる」と示しています。
選択的抽出は、「すべてを取得して後で削除する」というデフォルトを、「必要なものを指定して、その通りに取得する」に変えます。スプレッドシートには、リクエストした列だけが含まれ、それ以外は含まれません。削除ステップも、「この列は何を意味するのか」と悩む瞬間もありません。20フィールドではなく6フィールドだけを抽出する場合、請求書が正確である確率はコインフリップ(54%)から高い確率(83%)に向上し、正確でないものも検証すべきフィールドが少なくなります。
APQCのベンチマークは、コストがどこにあるかを明確に示しています。手動の請求書処理は1件あたり21.40ドル、AI自動化では2.78ドルに低下します。この差は抽出ステップだけではなく、レビュー、クレンジング、再フォーマット、列の削除も含まれます。選択的抽出は、方程式からクレンジングステップを排除します。
ご自身の請求書でお試しください。 PDFを数枚アップロードし、実際に必要な列を5〜6個指定して、結果を確認してください。削除する列が少なく、検証するフィールドも少ない、これまでよりクリーンな結果が得られれば、それが最適な抽出戦略です。
今すぐ試す