Warum ein 10-K einen PDF-Parser überfordert,
und was Sie bewahren sollten
Ein 10-K enthält vier oder fünf Abschlüsse, einen Anhangsteil, der sechzig Seiten lang sein kann, und eine Managementdiskussion in dem Spaltenformat, das der Setzer gewählt hat. Die Ziffern sind der leichte Teil. Was die Einreichung für Maschinen schwer lesbar macht, ist, dass jede Zahl nur in Bezug auf drei Dinge etwas bedeutet, die keine Zahlen sind: den Abschluss, in dem sie steht, die Berichtsperiode in der Spalte darüber und die Einheit, die einmal oben im Raster angegeben wird.
Ein allgemeiner PDF-Parser behandelt eine Seite als Textstrom und eine Tabelle als Rechteck aus Zellen. Ein 10-K ist keines von beidem, und die Lücke zeigt sich später als Tabellenkalkulation, die vollständig aussieht und zu nichts passt.
Die wichtigsten Punkte
- Ein PDF-Parser kann jede Ziffer eines 10-K korrekt lesen und trotzdem eine Zahl zurückgeben, die um den Faktor 1.000 danebenliegt.
- Dieser Fehler versteckt sich in einer Beschriftung, die einmal über dem Raster steht, sodass die Zelle selbst völlig normal aussieht.
- Vier Spalten, die Abschluss, Berichtsperiode, Einheit und Seite benennen, machen jede Zeile in Sekunden prüfbar.
Die Zielgruppe dieses Artikels ist die Person, die das PDF in der Hand hält, nicht die Person, die eine Retrieval-Pipeline aufbaut. Aktienanalysten ziehen Peer-Abschlüsse in ein Vergleichsblatt, Finanzdatenteams speisen ein Warehouse, Wirtschaftsprüfer ziehen Stichproben aus offengelegten Zahlen. In allen drei Fällen kam das Dokument von einer Investor-Relations-Seite, einer Kunden-E-Mail oder einem Filing-Agent, und es ist eine gerenderte Kopie von etwas, das auf EDGAR, dem Filing-System der SEC, in einem anderen Format existiert. Im Folgenden geht es darum, wo diese Kopie ihre Struktur verliert und was eine Extraktion daraus mitnehmen muss, damit sie es wert ist, behalten zu werden.
Ein 10-K ist ein Filing mit mehreren Abschlüssen, nicht eine Tabelle
Die erste Entscheidung, die eine 10-K-Extraktion treffen muss, ist, zu welchem Abschluss eine Zeile gehört, und ein generischer PDF-Parser stellt diese Frage nie. Ein Form 10-K gliedert sich in vier Teile und eine Liste von Items. Item 8 enthält die geprüften Abschlüsse und die Anhangsangaben, Item 7 die Lagebeurteilung des Managements, Item 1A die Risikofaktoren. Selbst innerhalb von Item 8 gibt es vier oder fünf Abschlüsse, jeder mit eigenem Titel, eigener Einheitenzeile und eigener Summenzeile, je nachdem, ob das Gesamtergebnis separat oder innerhalb der Gewinn- und Verlustrechnung dargestellt wird.
Das ist wichtig, weil „Total" keine Bezeichnung ist, die für sich genommen irgendetwas identifiziert. Jeder Abschluss hat eine Summenzeile, und mehrere verwenden dieselben Worte: total assets, total liabilities, total equity, total revenues. Liest man eine Summe, ohne zu wissen, welcher Abschluss sie hervorgebracht hat, kann man nicht sagen, was sie ergeben soll, womit sie verglichen werden soll oder ob sie in den Bilanzblock Ihrer Arbeitsmappe oder den Kapitalflussblock gehört. Ein Parser, der die Lesereihenfolge zurückgibt, liefert die Bezeichnungen korrekt und die Bedeutung überhaupt nicht.
Es gibt einen zweiten Grund, warum die Abschlussgrenze wichtig ist. Die Einheitenangabe wird einmal über jedem Raster abgedruckt, sodass die Bilanz in Tausenden stehen kann, während eine Anhangsangabe drei Seiten später in Millionen steht. Der Abschluss ist der Geltungsbereich der Einheit, was ihn zum Geltungsbereich der Arithmetik macht. Erfassen Sie die Grenze falsch, wird der Multiplikator über zwei verschiedene Geltungsbereiche angewendet.
Eine Tatsache über die Datei selbst sollte früh geklärt werden. Die von der SEC veröffentlichte Kopie ist HTML mit eingebettetem Inline XBRL, das heißt, die Finanzzahlen sind in einer maschinenlesbaren Taxonomie innerhalb der Seite selbst getaggt, und das PDF, mit dem die meisten arbeiten, ist ein von der Gesellschaft veröffentlichtes Rendering oder ein Scan eines gedruckten Geschäftsberichts. Die Aufgabe des 10-K-Parsings besteht hier also darin, die Struktur einer visuellen Kopie wiederherzustellen, und SEC-Filing-Extraktion ist überwiegend ein Layout-Problem, bevor sie ein Zeichenerkennungsproblem ist.
Dieses Layout ist zwischen Unternehmen nicht stabil, und genau dort liegt der größte Teil der Schwierigkeit. Praktiker beschreiben es ohne viel Geduld: „Table extraction from SEC filings is genuinely annoying because the formatting varies wildly across companies and even across years." (r/fintech). Eine Regel, die für die Bilanz eines Emittenten funktioniert, muss für den nächsten neu geschrieben werden, und erneut, wenn dasselbe Unternehmen den Abschlussprüfer wechselt oder einen neuen Standard übernimmt.
Zwei Abschlüsse können sich eine Seite teilen, wobei der zweite unterhalb der letzten Zeile des ersten beginnt
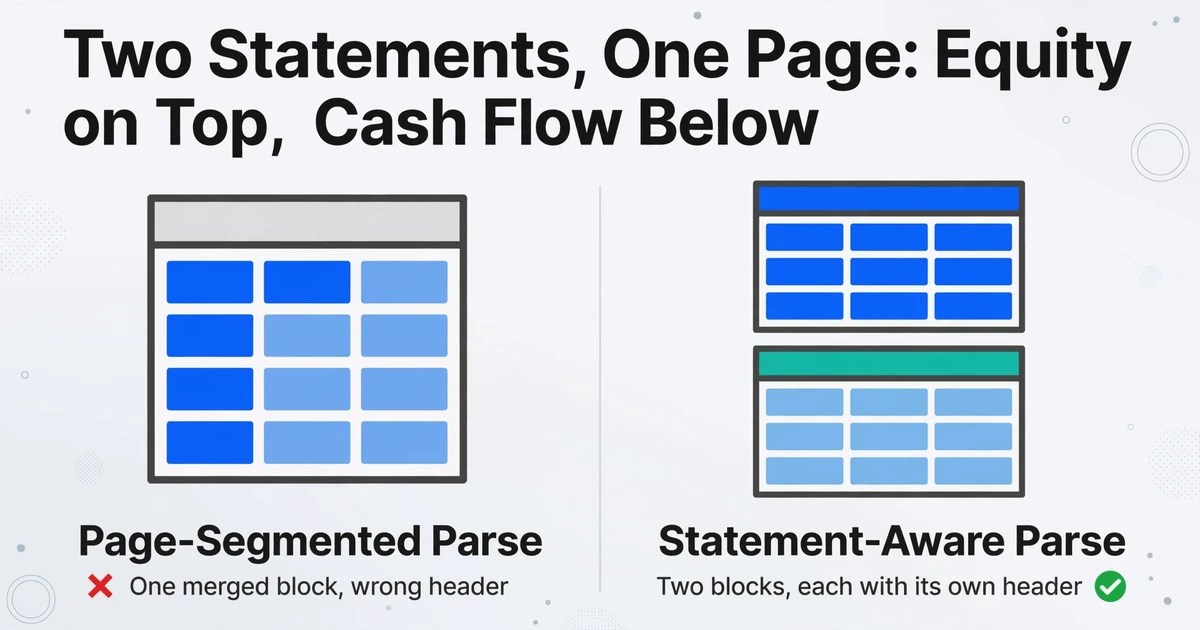
Setzer von Einreichungen geben nicht jedem Abschluss eine neue Seite. Um das Dokument nicht wachsen zu lassen, stehen die letzten Zeilen der Eigenkapitalveränderungsrechnung oft oben auf einer Seite, und die konsolidierte Kapitalflussrechnung beginnt unmittelbar darunter, mit eigenem Titel und eigener Kopfzeile.
Ein Parser, der nach Seiten segmentiert, liefert einen Block. Der Block ist intern so geordnet, wie ein Leser ihn sehen würde, sodass nichts kaputt aussieht: Die Eigenkapitalzeilen stehen oben, die Cashflow-Zeilen darunter, und jede Zahl steht an der richtigen Stelle auf der Seite. Der Schaden liegt in der Tabelle. Zeilen aus zwei Abschlüssen teilen sich nun eine Kopfzeile, und die Kopfzeile gehört zu dem Abschluss, dem der Parser sie zugeordnet hat. Eigenkapitalspalten wie das kumulierte sonstige Ergebnis landen über Cashflow-Werten, und die Cashflow-Zwischensumme erbt eine Spalte, unter der sie nie stehen sollte.
Der Fehler lässt die Zeilenzahl ungefähr richtig, weshalb er einen ersten Blick übersteht und bei der ersten Abstimmung scheitert.
Das nachgelagerte Symptom ist eindeutig. Der operative Cashflow sollte beim Nettoergebnis beginnen und bei der Veränderung der liquiden Mittel enden, und der Abschluss weist beide Enden aus. Wenn der Block zusammengeführt wird, kann die Prüfung entweder nicht laufen oder scheitert an einer Zeile, die tatsächlich in der falschen Tabelle steht. Der Analyst sieht einen Abstimmungsbruch und beginnt, nach einer falsch gelesenen Ziffer zu suchen, obwohl die Ziffer korrekt ist und die Zeile im falschen Abschluss steht.
Eine Tabelle, die über einen Seitenumbruch läuft, verliert ihre Kopfzeile, nicht ihre Zahlen
Eine Bilanz, die gegen Ende von Seite 58 beginnt, wird auf Seite 59 fortgesetzt, und die Fortsetzungsseite wiederholt möglicherweise den Titel des Abschlusses, manchmal mit „(Fortsetzung)", während die Spaltenüberschriften häufig fehlen. Die Zahlen laufen weiter; die Berichtsperioden darüber nicht.
Wenn Sie jede Seite unabhängig parsen, erhalten Sie zwei Tabellen. Die erste hat eine Kopfzeile und die Hälfte der Zeilen. Die zweite hat die restlichen Zeilen und überhaupt keine Periodenzuordnung. Ein Parser, der hilfreich sein will, nimmt die nächstgelegene Kopfzeile auf der Fortsetzungsseite, die zu einer völlig anderen Tabelle gehören kann, die weiter unten beginnt, und die Zeilen werden dann mit den falschen Jahren beschriftet. So oder so werden die Zahlen korrekt gelesen und unter der falschen Spalte abgelegt.
Seitenübergreifende Strukturen sind der Normalfall, kein Sonderfall. In FinMMDocR, einem Benchmark mit 1.200 von Experten erstellten Finanzfragen über 837 Dokumente mit durchschnittlich 50,8 Seiten, erfordern 65 % der Fragen Belege, die sich über mehr als eine Seite erstrecken, mit durchschnittlich 2,4 Belegseiten pro Frage. Die Fehleranalyse derselben Studie ist aufschlussreicher für alle, die der Arithmetik die Schuld geben: 78 von 100 untersuchten Fehlern waren Fehler beim Dokumentverständnis, das heißt, das Modell konnte den Beleg nicht finden oder lesen, während nur 5 Rechenfehler waren (Tang et al., FinMMDocR, AAAI 2026).
Die praktische Konsequenz ist, dass eine Extraktion auf Seitenebene die eigenen Prüfungen des Abschlusses nicht durchführen kann. Aktiva gleich Passiva plus Eigenkapital gilt nur, wenn alle Aktivzeilen und alle Passivzeilen mit ihren zugeordneten Berichtsperioden erhalten geblieben sind. Eine halbe Tabelle kann nicht gegen sich selbst geprüft werden, und so wird aus einer unbeschrifteten Fortsetzungsseite eine Tabellenkalkulation, die niemand validieren kann.
Die Berichtsperiode steckt in einer verbundenen Kopfzelle, und verbundene Zellen sind das Erste, was ein Parser einebnet
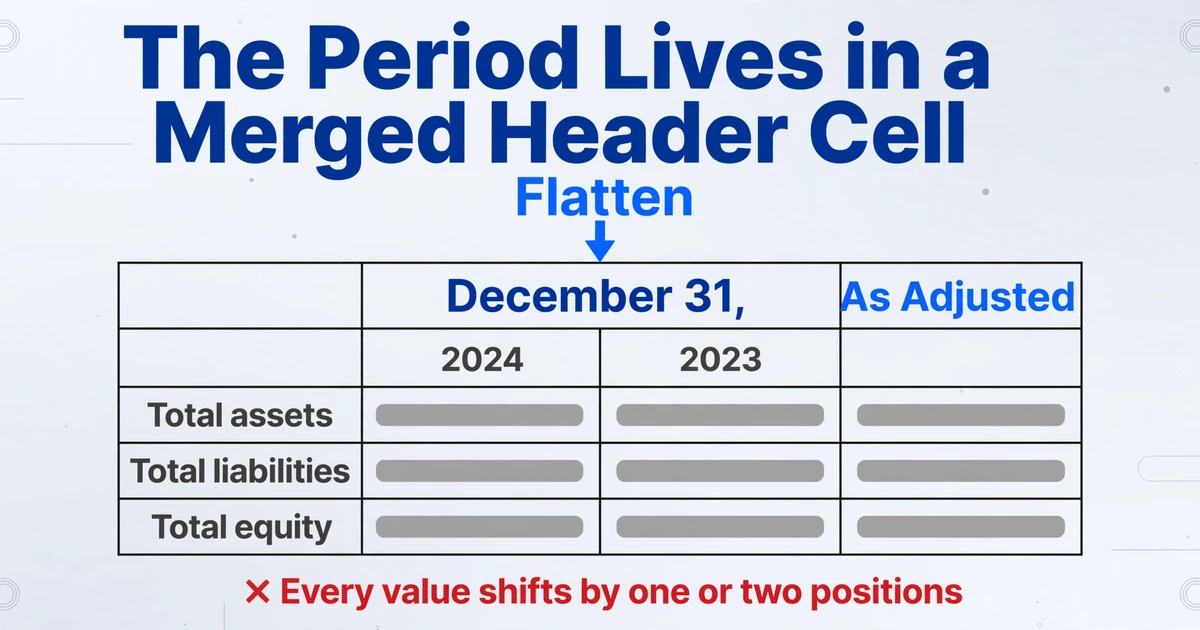
Eine 10-K-Kopfzeile ist selten eine einzelne Zeile mit Jahresbezeichnungen. Sie ist eine Hierarchie. „December 31," erstreckt sich über zwei Spalten, mit „2024" und „2023" darunter. Eine dritte Spalte trägt „As Adjusted". Nach einer Fusion oder einem Wechsel des Geschäftsjahres teilt sich die Kopfzeile in „Successor"- und „Predecessor"-Blöcke, getrennt durch eine Linie, und die Berichtsperioden auf beiden Seiten sind nicht gleich lang, sodass eine Spalte elf Monate und die nächste zwölf abdecken kann.
Das Einebnen dieser Hierarchie ist der Punkt, an dem Spaltenzuordnungen schiefgehen, und die Spalte „As Adjusted" zeigt, warum das schlimmer ist als ein fehlendes Label. Beide Spalten können das Jahr 2024 tragen. Eine ist die Zahl wie berichtet, die andere die Zahl, die auf Pro-forma-Basis für eine Akquisition angepasst wurde. Lassen Sie die Unterkopfzeile weg, haben Sie zwei Spalten mit demselben Namen, keine Möglichkeit zu unterscheiden, welche welche ist, und ein Vergleichsblatt, das stillschweigend eine berichtete Zahl mit einer angepassten vermischt.
Eine verbundene Zelle erzeugt eine zweite Art von Fehler. Wenn eine Kopfzelle drei Spalten umfasst und der Parser sie in die erste Spalte zusammenfaltet, verschiebt sich jeder Wert darunter um zwei Positionen nach links. Die Ziffern stimmen, die Zeilenbeschriftungen stimmen, und das Jahr ist falsch. Nichts in der Zelle weist darauf hin, denn eine falsche Spalte ist immer noch eine gültige Zahl.
Eine verbundene Kopfzeile ist eine Spaltenzuordnung, keine Beschriftung. Flachen Sie sie ab, verschiebt sich jeder Wert darunter.
Das Geschäftsjahr bringt ein Definitionsproblem mit sich, das die Extraktion nicht lösen, aber zumindest offenlegen kann. Eine Spalte mit der Bezeichnung 2024 kann im Januar enden, im Juni oder in einem 52/53-Wochen-Zeitraum, der ein paar Tage vom Kalender abweicht. Sie mit einem Peer mit Dezember-Jahresende zu vergleichen, ist ein Fehler in der Analyse, nicht im Parser, und die einzige Verteidigung besteht darin, die vollständige Periodenbezeichnung ("Geschäftsjahr zum 31. Januar 2024") statt der vier Ziffern beizubehalten.
Ein Notenverweis wandert mit der Zahl und wird als Erstes von ihr entfernt
In einem 10-K steht die Zahl, die Sie brauchen, oft im Abschluss, und der Grund, warum sie bedeutet, was sie bedeutet, steht in einer Anhangsangabe sechzig Seiten weiter. Der Abschluss signalisiert das mit einer Markierung: "See Note 12", eine hochgestellte 1, ein Sternchen oder eine eingeklammerte "(1)", die neben der Zahl gedruckt ist.
Zahlen-Parser entfernen diese Markierung, weil sie nicht Teil des Werts ist, und die Entfernung geht auf vorhersehbare Weise schief. Eine Zelle mit 1,234(1) kann als 1,234, als 1,2341 oder als 1,234.1 zurückkommen, je nachdem, wie die Hochstellung in der Textebene getrennt ist. Die Auszeichnung, die einen Leser zur Erklärung führen sollte, kommt als beschädigte Ziffer an.
Der subtilere Fehler enthält keine beschädigten Zeichen. Zeilen mit der Bezeichnung "Other, net", "Miscellaneous" oder "Other income (expense)" aggregieren mehrere Posten, und die Anhangsangabe ist der Ort, an dem die Aggregation aufgeschlüsselt wird. Extrahieren Sie die Zeile, haben Sie eine korrekte Zahl, die sich nicht zerlegen lässt, was bedeutet, dass sie nicht mit einem Peer verglichen werden kann, dessen "Other" andere Dinge enthält. Die Bilanzierungspolitik hat dasselbe Problem: Ob eine Belastung in den Umsatzkosten oder in den Vertriebs-, allgemeinen und Verwaltungskosten sitzt, wird in der Anhangsangabe angegeben, und das verändert die Bruttomarge, ohne dass sich eine einzige Zahl im Abschluss selbst ändert.
Das ist eine Grenze, die es wert ist, klar benannt zu werden. Eine Extraktion kann "Note 12" als Spaltenwert erfassen, damit ein Prüfer zur richtigen Seite navigieren kann. Sie löst die Anhangsangabe nicht auf, folgt nicht dem Querverweis und zieht nicht die Tabelle der Anhangsangabe heran. Diese Arbeit bleibt bei der Person, die das Filing liest.
Im MD&A liest man spaltenweise, die Textextraktion liest Zeile für Zeile
Die erzählenden Abschnitte eines 10-K, insbesondere die Management's Discussion and Analysis, sind häufig in zwei oder drei Spalten gesetzt, um mehr Text auf einer Seite unterzubringen. Ein Mensch liest die linke Spalte von oben nach unten, dann die rechte. Ein Textextraktor liest quer über die Seite, Zeile für Zeile, weil das die Reihenfolge ist, in der die Zeichen im Content-Stream auftreten.
Das Ergebnis ist entweder ineinander verschachtelte Prosa, bei der ein Satz über Umsatzerlöse mitten im Nebensatz eines Satzes über Liquidität weiterläuft, oder eine Spalte wird doppelt gelesen, während die andere entfällt. Beides sieht nicht wie ein Datenfehler aus und passiert daher die Prüfung. Zum Fehler wird es, wenn ein Satz wie „die Bruttomarge ist gestiegen" aus zwei verschiedenen Spalten zusammengesetzt wurde und im Filing das Gegenteil stand.
Das ist der Abschnitt, in dem die PDF-Extraktion ihren Platz verdient, statt mit strukturierten Daten zu konkurrieren. XBRL taggt die Zahlen. Es taggt nicht die Erklärung, warum sich die Zahlen bewegt haben, den Preisdruck, den das Management benennt, oder den Vertrag, der nächstes Jahr ausläuft. Wenn es beim Lesen des Filings darum geht, das Geschäft zu verstehen, statt eine Zahl abzurufen, ist die Erzählung der entscheidende Teil, und die Lesereihenfolge ist das ganze Spiel.
Eine korrekte Extraktion behält vier Felder, die keine Zahlen sind
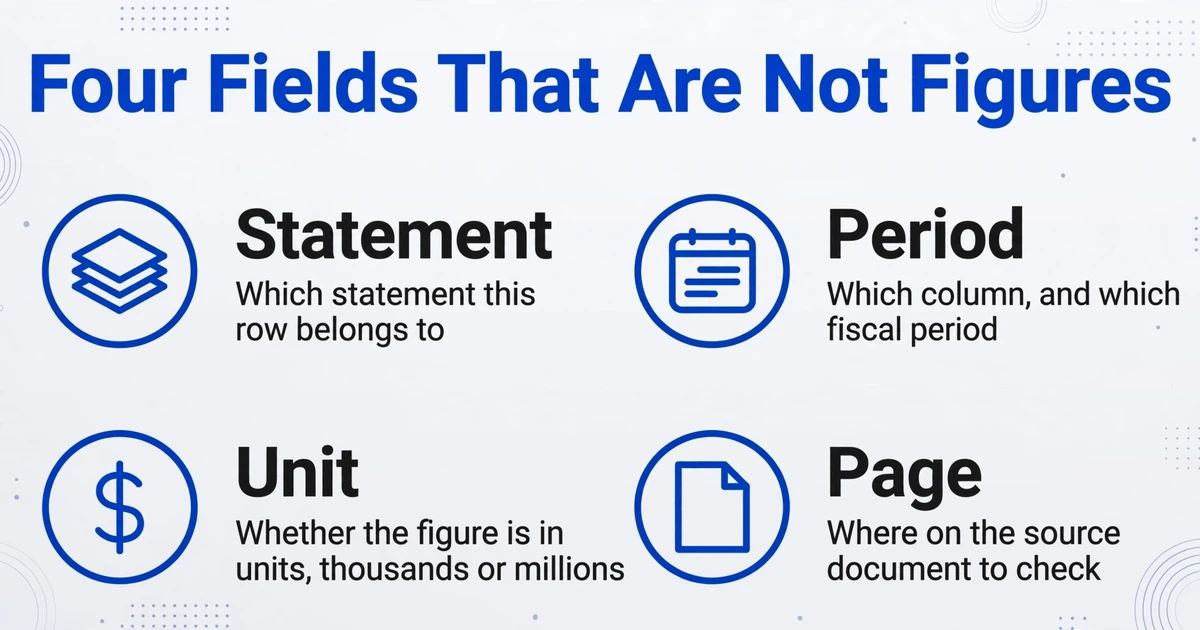
Eine korrekte 10-K-Extraktion wird am Herkunftsnachweis gemessen: Jede Zahl weiß noch, woher sie stammt. Vier Felder leisten diese Arbeit, und jedes beantwortet eine Frage, die die Zahl allein nicht beantworten kann.
| Feld | Was es beantwortet | Was ohne es schiefgeht |
|---|---|---|
| Statement | Zu welchem Abschluss diese Zeile gehört | Summen aus verschiedenen Abschlüssen werden verglichen, und die Abstimmung scheitert an der falschen Zeile |
| Period | Welche Spalte und welche Berichtsperiode sie tatsächlich abdeckt | Vorjahreszahlen landen unter dem laufenden Jahr, und jede Veränderung hat das falsche Vorzeichen |
| Unit | Ob die Zahl in Einheiten, Tausenden oder Millionen angegeben ist | Jeder Wert ist um den Faktor 1.000 daneben, während die Zelle normal aussieht |
| Page | Wo im Quelldokument nachzuprüfen ist | Die Prüfung wird zur Suche durch das PDF, sodass Fehler eher akzeptiert als verifiziert werden |
| Zeilenebene (optional) | Ob die Zeile eine Detailzeile oder eine Zwischensumme ist | Beim Summieren der Spalte wird dasselbe Geld zwei- oder dreimal gezählt |
Das Feld für die Einheit verdient die Betonung, die es bekommt, denn es ist das Teuerste, was ein Parser fallen lässt. Eine Studie der Suffolk University setzte ein untrainiertes LLM auf 5.000 zwischen 2014 und 2023 eingereichte Jahresberichte an und ließ es 26 Rechnungswesen-Kennzahlen abrufen. Etwa die Hälfte der Fehler waren Skalierungsfehler, und die Quoten lagen bei 8,16 % aus Text, 5,81 % aus HTML und 0,11 % aus XBRL (XBRL US-Zusammenfassung der Studie).
Die Ziffern bei einem 1.000-fachen Fehler wurden korrekt gelesen. Was fehlschlug, war die Übernahme einer Bildunterschrift außerhalb des Rasters, und eine Zelle mit einer gewöhnlichen Zahl meldet das nie.
Deshalb ist die Lösung eine Spalte und keine Modellanweisung, genauer zu lesen. Dieselbe Logik gilt für Klammern und die Zwischensummen-Hierarchie, die beiden anderen Konventionen, die entscheiden, ob ein Abschluss aufgeht, und diese sind in der Aufschlüsselung, warum Abschlüsse Einheiten, Vorzeichen und Zwischensummen verlieren dargelegt.
Das Setup, das funktioniert, ist langweilig: zuerst Kontextspalten, dann eine Zeilenform
ImageToTable.ai liest die Seite mit einem Vision-Modell und füllt Spalten, die Sie benennen, statt feste Koordinaten zuzuordnen, sodass die Felder, die Kontext tragen, genauso angefordert werden können wie die Zahlen. Das Konzept ist Custom Column Extraction: Sie geben die gewünschten Spaltennamen ein, und die KI lokalisiert jeden Wert danach, was er bedeutet, überall auf der Seite.
Zwei Zeilenformen decken die meiste Einreichungsarbeit ab, und der Rest dreht sich darum, Einreichungen auseinanderzuhalten und das Ergebnis zu prüfen.
Langformat: eine Zeile pro Position, für einen vollständigen Abschluss
Benennen Sie die Spalten Company, Statement, Line Item, FY2025, FY2024, Unit, Note Reference und Page. Jede Zeile ist eine Zeile eines Abschlusses, mit zugehöriger Berichtsperiode, Einheit und Quellseite. Diese Form eignet sich, wenn Sie den Abschluss selbst benötigen, denn jede gedruckte Zeile, einschließlich der Zwischensummen, kommt als eigene Zeile zurück.
Breitformat: eine Zeile pro Einreichung, für einen Peer-Vergleich
Benennen Sie die Positionen, die Sie vergleichen, als Spalten, etwa Revenue, Gross profit, Operating income, Net income, Total assets und Operating cash flow, mit einer Spalte Fiscal Year. Eine Einreichung wird zu einer Zeile, genau das, was ein Vergleichsblatt braucht.
Batch: eine Tabellenkalkulation für die Peer-Gruppe
Die Stapelverarbeitung nimmt mehrere Einreichungen gleichzeitig und führt die Ergebnisse in einer Excel-Datei zusammen, wobei eine Spalte Company sie auseinanderhält. Acht 10-Ks werden zu einem Blatt statt zu acht. Hier ist die Bezeichnungsvielfalt kein Problem mehr: Das eine Unternehmen druckt "Total revenues", ein anderes "Net sales", ein drittes "Total net revenue", und die semantische Zuordnung führt sie in dieselbe Spalte zusammen, was eine Koordinatenvorlage nicht leisten kann.
Prüfen: die Zelle zurück auf die Seite verweisen
Review Mode mit bbox locating hebt den genauen Bereich hervor, aus dem ein Wert stammt, wenn Sie mit der Maus über die Zelle fahren, und ein Klick auf einen Bereich auf der Seite springt zurück zu seiner Zelle. Nutzen Sie es für die zwei Dinge, die eine Zelle Ihnen nicht zeigen kann: zu welchem Abschluss die Zeile gehört und unter welcher Spalte der Wert stand. Model Tier ist aus demselben Grund bei älterem Material wichtig. Ein sauber gedruckter Abschluss ist auf der Standardstufe in Ordnung; ein dichter Scan, ein fotokopierter Geschäftsbericht oder eine fußnotenlastige Seite braucht eine höhere.
Eine berechnete Spalte kann einen weiteren Schritt gehen, ohne ein zweites Werkzeug hinzuzufügen. Da zeilenweise Arithmetik während der Extraktion ausgewertet wird, liefert eine Spalte, die als Differenz zwischen den beiden Periodenspalten definiert ist, die gedruckte Veränderung, sofern beide Spalten in derselben Einheit vorliegen. Sie kann nicht wissen, dass ein Abschluss in Tausenden und der nächste in Millionen angegeben ist, daher braucht ein Vergleich über verschiedene Einheiten hinweg den explizit in der Regel angegebenen Multiplikator. Selbst dann sagt sie Ihnen nicht, ob die Veränderung aussagekräftig ist. Das bleibt Ihre Aufgabe.
Was nach der Extraktion geschieht, nämlich jede Abschlusszeile der Zeile zuzuordnen, die Ihre eigene Vorlage erwartet, ist die Zuordnungsarbeit, die financial statement spreading beschreibt. Das Werkzeug füllt eine Zeile. Der Analyst entscheidet, wohin diese Zeile im Modell gehört.
Dateien werden sicher verarbeitet und nicht gespeichert.
Wenn der Filing auf EDGAR liegt, sind die getaggten Zahlen meist die bessere Quelle
Inline XBRL ist für Finanzberichtsinformationen von operativen Unternehmen seit 2019 für große beschleunigte Einreicher, 2020 für beschleunigte Einreicher und 2021 für alle anderen verpflichtend (SEC-Pressemitteilung 2018-117). Bei einem Filing, das es enthält, sind die getaggten Fakten bereits vom Layout getrennt, und sie abzurufen ist eine andere und oft bessere Aufgabe, als das PDF zu lesen. Das zu sagen gehört zu einer klaren Antwort dazu.
XBRL ist der richtige Weg, wenn Sie berichtete numerische Fakten in großem Umfang benötigen: Screening eines Universums, Berechnung von Kennzahlen über Perioden hinweg, Vergleich einer Zeile über zwanzig Unternehmen. Seine Grenzen sind real, aber andere als die eines Parsers. Unternehmen erweitern die Taxonomie um eigene Tags, was den unternehmensübergreifenden Vergleich schwächt; ein Fakt kommt ohne die gedruckte Darstellung, sodass die Zwischensummenstruktur und die Reihenfolge, die ein Mensch liest, nicht enthalten sind; das Tagging selbst enthält Fehler, wobei Vorzeichenkonventionen wiederkehrend sind; und die erzählenden Abschnitte sind überhaupt nicht getaggt.
Die PDF-Extraktion ist in vier Situationen der richtige Weg, und sie sind häufig genug, um sie einzuplanen. Das Filing ist ein Scan oder ein reines Bild-PDF ohne nutzbare Textebene. Das Dokument stammt aus der Zeit vor dem XBRL-Tagging, das 2009 begann. Das Paket, das Sie erhalten haben, ist überhaupt kein EDGAR-Filing, etwa ein gedruckter Jahresbericht, ein vom Broker zusammengestellter Peer-Vergleich oder der lokale Bericht einer ausländischen Muttergesellschaft. Oder Sie benötigen den erzählenden Teil, für den es keine strukturierte Quelle gibt, die vorzuziehen wäre. Wenn das Filing ein Scan von mehreren hundert Seiten ist, wird die Seitenverarbeitung zu einem eigenen Problem, behandelt in wie man ein PDF mit tausenden Seiten per OCR verarbeitet.
ImageToTable.ai parst kein XBRL, löst keine Fußnoten auf, folgt keinen Querverweisen und baut kein Modell. Es verwandelt die Seiten, die Sie ihm geben, in eine Tabelle, deren Zeilen ihre Abschluss, Berichtsperiode, Einheit und Seite tragen. Es auf ein Filing anzuwenden, das bereits saubere getaggte Daten hat, wäre die Wahl des schwierigeren Wegs.
Häufig gestellte Fragen
Kann ich die Abschlüsse eines 10-K aus einem PDF nach Excel extrahieren?
Ja, und die nützliche Ausgabe enthält mehr als nur die Zahlen. Benennen Sie Spalten für den Abschluss, die Berichtsperiode, die Einheit und die Seite neben den Posten und Werten, damit jede Zeile in der Tabellenkalkulation bis zu einer Seite zurückverfolgt werden kann. Ohne diese Felder ist der Export ein Raster aus Zahlen, deren Bedeutung von einem Layout abhängt, das Sie nicht mehr sehen können.
Warum landen die Zahlen in der falschen Jahresspalte?
Zwei Ursachen erklären den Großteil. Die Kopfzeile auf einer Fortsetzungsseite fehlt, sodass der Parser die nächstgelegene Kopfzeile zuweist, die er findet. Oder die Kopfzeile ist eine verbundene, mehrstufige Zelle (ein Jahr, das zwei Unterspalten umfasst, eine Spalte „angepasst" neben einer berichteten) und ihr Abflachen verschiebt jeden Wert um ein oder zwei Positionen. Prüfen Sie die ersten drei Zeilen gegen die Quellseite, bevor Sie sich auf die Spaltenreihenfolge verlassen.
Wie verhindere ich, dass „in thousands" jede Zahl falsch macht?
Erfassen Sie die Angabe als eigene Spalte, statt sie anzunehmen. Die Erklärung steht außerhalb des Rasters, sodass ein Parser, der Spalten liest, sie nie sieht, und jeder Wert kommt zifferngenau und um den Faktor 1.000 falsch zurück. Halten Sie den Multiplikator an einer Stelle, wenden Sie ihn einmal an, und denken Sie daran, dass Zusätze wie „except per share amounts" bedeuten, dass einige Zeilen gar nicht skaliert werden.
Werden die Fußnoten gelesen?
Es kann den Notenverweis, der neben einer Zeile steht, wie „Note 12", als Wert erfassen, was einem Prüfer hilft, die richtige Seite zu finden. Es löst den Verweis nicht auf, öffnet die Anhangsangabe nicht und bringt die Tabelle der Anhangsangabe nicht in die Ausgabe. Wenn die benötigte Zahl nur in einer Anhangsangabe steht, laden Sie die Seiten hoch, die sie enthalten, und extrahieren Sie sie als eigene Tabelle.
Ist XBRL besser als das Parsen des PDF?
Für berichtete numerische Fakten meist ja. Die getaggten Daten sind bereits vom Layout getrennt, und die Fehlerquoten spiegeln das wider: Eine Studie über 5.000 Jahresberichte fand Skalierungsfehler in 0,11 % der XBRL-Abrufe gegenüber 8,16 % aus reinem Text. Für Erzähltext, für gescannte oder reine Bild-Kopien und für Dokumente, die nie bei EDGAR eingereicht wurden, gibt es keine strukturierte Quelle, die vorzuziehen wäre.
Kann es einen gescannten oder älteren 10-K verarbeiten?
Ja. Ein Vision-Modell liest die Seite statt einer Textebene, sodass ein Scan oder eine Fotokopie funktioniert, und eine höhere Modellstufe hilft bei schwachem Druck, dichten Fußnoten und schiefen Seiten. Die praktische Grenze ist die Qualität der Quelle: Wenn eine Seite schräg kopiert wurde und eine Ziffer wirklich unlesbar ist, holt keine Extraktion sie zurück, und mit Review Mode finden Sie solche Zellen, statt sich auf sie zu verlassen.
Der Kontext ist der Teil, der sich lohnt zu extrahieren
Ein 10-K bringt einen allgemeinen PDF-Parser an seine Grenzen, weil das Dokument Bedeutung an Stellen speichert, die ein Parser als Dekoration behandelt: der Titel des Abschlusses, die verbundene Kopfzeile, die Beschriftung über dem Raster, der hochgestellte Verweis neben einer Zahl, das Spaltenlayout einer Seite Fließtext. Entfernen Sie diese, haben Sie zwar noch jede Ziffer, aber so angeordnet, dass keine Abstimmung sie bestätigen kann.
Die Prüfung für jede Extraktion ist daher, ob eine Zeile vier Fragen beantworten kann, ohne die Tabellenkalkulation zu verlassen: welcher Abschluss, welche Berichtsperiode, welche Einheit, welche Seite. Wenn ja, kann ein Prüfer sie in Sekunden kontrollieren und ein Analyst sie in einer Besprechung verteidigen. Wenn nicht, sind die Zahlen Vermutungen im Kostüm von Daten.