10-K가 PDF 파서를 무너뜨리는 이유,
그리고 지켜야 할 것
10-K에는 네다섯 개의 재무제표, 60페이지에 달할 수 있는 주석 섹션, 그리고 조판업자가 선택한 열 형식으로 배치된 경영진 논의가 담겨 있습니다. 숫자 자체는 쉬운 부분입니다. 이 공시 문서를 기계가 읽기 어렵게 만드는 것은 각 수치가 숫자가 아닌 세 가지와의 관계 속에서만 의미를 갖는다는 점입니다. 즉 그 수치가 속한 재무제표, 그 위의 보고 기간 열, 그리고 표 상단에 한 번 선언된 단위입니다.
일반적인 PDF 파서는 페이지를 텍스트의 흐름으로, 표를 셀의 사각형으로 취급합니다. 10-K는 어느 쪽에도 해당하지 않으며, 그 간극은 나중에 완벽해 보이지만 아무것도 검증되지 않는 스프레드시트로 드러납니다.
핵심 요약
- PDF 파서는 10-K의 모든 숫자를 정확히 읽고도 1,000배 차이 나는 값을 반환할 수 있습니다.
- 그 오류는 표 위에 한 번 인쇄된 캡션에 숨어 있어 셀 자체는 지극히 평범해 보입니다.
- 재무제표, 보고 기간, 단위, 페이지를 명시하는 네 개의 열이 있으면 모든 행을 몇 초 만에 검증할 수 있습니다.
이 글의 독자는 검색 파이프라인을 구축하는 사람이 아니라 PDF를 들고 있는 사람입니다. 주식 분석가는 동종 기업 재무제표를 비교 시트로 가져오고, 재무 데이터 팀은 웨어하우스에 데이터를 공급하며, 감사인은 공시된 수치를 표본 추출합니다. 세 경우 모두 문서는 투자자 관계 페이지, 고객 이메일 또는 공시 대행사에서 왔으며, 이는 SEC의 공시 시스템인 EDGAR에 다른 형식으로 존재하는 무언가의 렌더링된 사본입니다. 이어지는 내용은 그 사본이 어디에서 구조를 잃는지, 그리고 추출이 가치 있으려면 무엇을 담아내야 하는지를 다룹니다.
10-K는 하나의 표가 아니라 여러 재무제표를 담은 공시입니다
10-K 추출이 가장 먼저 내려야 할 결정은 특정 행이 어느 재무제표에 속하는지이며, 일반적인 PDF 파서는 이 질문을 하지 않습니다. Form 10-K는 네 개의 파트와 여러 항목 목록으로 구성됩니다. Item 8에는 감사된 재무제표와 주석이, Item 7에는 경영진 논의가, Item 1A에는 위험 요인이 담깁니다. Item 8 안에도 포괄손익이 별도로 표시되는지 손익계산서 안에 포함되는지에 따라 각기 고유한 제목, 단위 표기, 합계 집합을 가진 네다섯 개의 재무제표가 있습니다.
이것이 중요한 이유는 "Total"이라는 라벨 자체만으로는 아무것도 식별하지 못하기 때문입니다. 모든 재무제표에는 합계 행이 있고, 여러 곳에서 같은 단어를 사용합니다: total assets, total liabilities, total equity, total revenues. 어느 재무제표에서 나온 합계인지 모른 채 읽으면 그것이 무엇과 같아야 하는지, 무엇과 비교해야 하는지, 통합 문서의 재무상태표 블록에 속하는지 현금흐름 블록에 속하는지 말할 수 없습니다. 읽기 순서만 반환하는 파서는 라벨은 정확히 반환하지만 의미는 전혀 반환하지 않습니다.
재무제표 경계가 중요한 두 번째 이유가 있습니다. 단위 선언은 각 그리드 위에 한 번만 인쇄되므로, 재무상태표는 천 단위인데 세 페이지 뒤의 주석은 백만 단위일 수 있습니다. 재무제표는 단위의 범위이며, 따라서 산술의 범위이기도 합니다. 경계를 잘못 잡으면 승수가 서로 다른 두 범위에 걸쳐 적용됩니다.
파일 자체에 관한 한 가지 사실은 일찍 정리해 둘 가치가 있습니다. SEC가 게시하는 사본은 인라인 XBRL이 내장된 HTML이며, 이는 재무 수치가 페이지 자체 내에서 기계 판독 가능한 분류 체계로 태그되어 있음을 의미합니다. 그리고 대부분의 사람이 작업하는 PDF는 회사가 게시한 렌더링 또는 인쇄된 연차 보고서의 스캔입니다. 따라서 여기서 10-K 파싱의 임무는 시각적 사본의 구조를 복원하는 것이며, SEC 공시 추출은 문자 인식 문제이기 전에 주로 레이아웃 문제입니다.
그 레이아웃은 회사마다 안정적이지 않으며, 실제로 대부분의 어려움이 여기에 있습니다. 실무자들은 이를 인내심 없이 표현합니다: "SEC 공시에서 표 추출은 회사마다, 심지어 연도마다 서식이 제각각이라 정말 짜증납니다." (r/fintech). 한 공시자의 재무상태표에 통하는 규칙은 다음 공시자를 위해 다시 작성해야 하며, 같은 회사가 감사인을 바꾸거나 새 기준을 채택할 때 또다시 그러합니다.
두 재무제표는 한 페이지를 공유할 수 있으며, 두 번째 재무제표는 첫 번째의 마지막 행 아래에서 시작됩니다
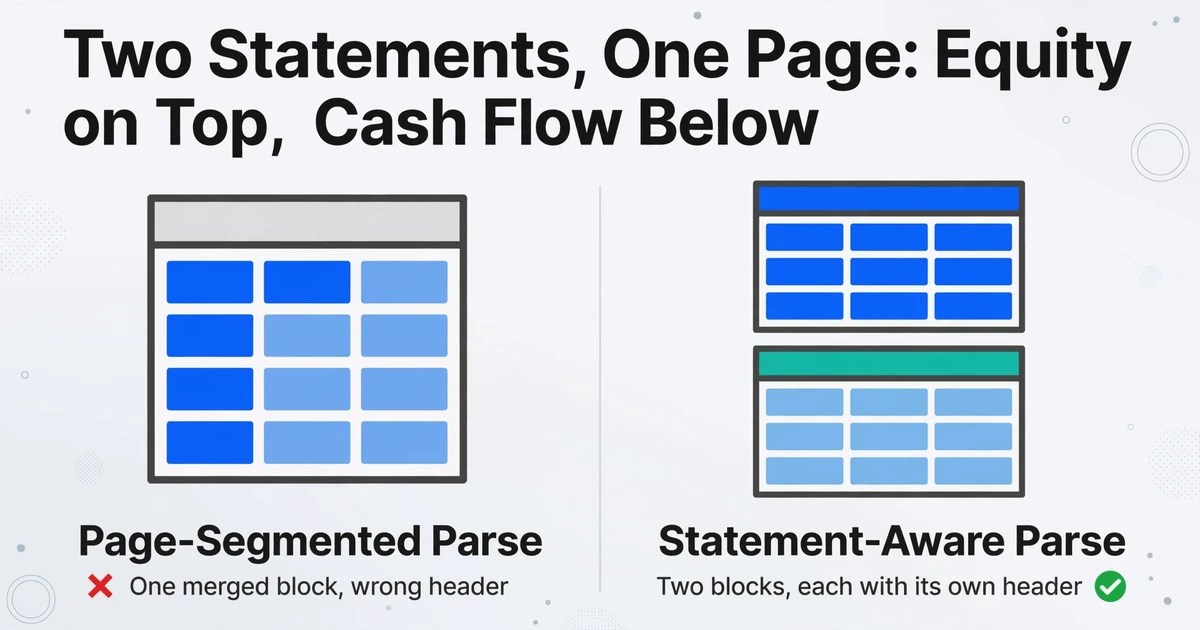
공시 문서 조판자는 모든 재무제표에 새 페이지를 할당하지 않습니다. 문서 분량이 늘어나는 것을 막기 위해 자본변동표의 마지막 행이 페이지 상단에 놓이고, 연결 현금흐름표가 바로 그 아래에서 자체 제목과 자체 헤더 행을 가지고 시작되는 경우가 많습니다.
페이지 단위로 분할하는 파서는 하나의 블록을 반환합니다. 이 블록은 독자가 보는 순서대로 내부 정렬되어 있어 겉보기에는 아무 문제가 없어 보입니다. 자본 항목 행이 위에, 현금흐름 행이 아래에 있고, 모든 숫자가 페이지상 올바른 위치에 있습니다. 문제는 표에 있습니다. 이제 두 재무제표의 행이 하나의 헤더를 공유하고, 그 헤더는 파서가 연결한 재무제표의 것입니다. 누적기타포괄손익 같은 자본 열이 현금흐름 수치 위에 놓이게 되고, 현금흐름 소계는 본래 속해서는 안 될 열을 물려받습니다.
이 실패는 행 수는 대략 맞게 남기 때문에 첫눈에는 문제없어 보이지만 첫 검증에서 실패합니다.
이후 나타나는 증상은 구체적입니다. 영업활동 현금흐름은 순이익에서 시작해 현금 변동에서 끝나야 하며, 재무제표는 양쪽 끝을 모두 표시합니다. 블록이 병합되면 이 검증은 실행되지 않거나 실제로는 잘못된 표에 있는 행에서 실패합니다. 분석가는 검증 불일치를 보고 잘못 읽힌 숫자를 찾기 시작하지만, 숫자는 정확하고 그 행이 잘못된 재무제표에 있는 것입니다.
페이지 나눔을 넘어가는 표는 숫자가 아니라 헤더를 잃는다
58페이지 하단에서 시작한 재무상태표가 59페이지로 이어지며, 이어지는 페이지에는 재무제표 제목이 "(계속)"과 함께 반복될 수 있지만 열 제목은 대개 빠져 있습니다. 숫자는 계속 이어지지만 그 위의 보고 기간은 그렇지 않습니다.
각 페이지를 독립적으로 파싱하면 표가 두 개 나옵니다. 첫 번째는 헤더와 절반의 행을 가집니다. 두 번째는 나머지 행을 가지지만 보고 기간 지정이 전혀 없습니다. 도움이 되려는 파서는 이어지는 페이지에서 가장 가까운 헤더를 가져오는데, 그것은 아래쪽에서 시작하는 전혀 다른 표에 속할 수 있으며, 그러면 행에 잘못된 연도가 붙습니다. 어느 쪽이든 숫자는 올바르게 읽히고 잘못된 열에 배치됩니다.
페이지를 넘나드는 구조는 예외가 아니라 일반적인 경우입니다. 평균 50.8페이지인 837개 문서에 대해 전문가가 만든 1,200개의 재무 질문으로 구성된 벤치마크 FinMMDocR에서, 질문의 65%는 두 페이지 이상에 걸친 근거를 필요로 하며 각 질문당 평균 2.4개의 근거 페이지가 필요합니다. 같은 연구의 오류 분석은 산술을 탓하는 사람에게 더 많은 것을 알려줍니다. 표본으로 뽑은 100개의 실패 중 78개는 문서 이해 실패, 즉 모델이 근거를 찾거나 읽지 못한 경우였고, 계산 오류는 5개에 불과했습니다(Tang et al., FinMMDocR, AAAI 2026).
실질적인 결과는 페이지 수준 추출로는 재무제표 자체의 검증을 실행할 수 없다는 것입니다. 자산이 부채와 자본의 합과 같으려면 모든 자산 행과 모든 부채 행이 보고 기간과 함께 살아남아야 합니다. 표의 절반은 그 자체로 검증할 수 없으며, 이렇게 해서 라벨 없는 이어지는 페이지가 아무도 검증할 수 없는 스프레드시트가 됩니다.
보고 기간은 병합된 헤더 셀에 살고, 병합된 셀은 파서가 가장 먼저 평탄화하는 대상이다
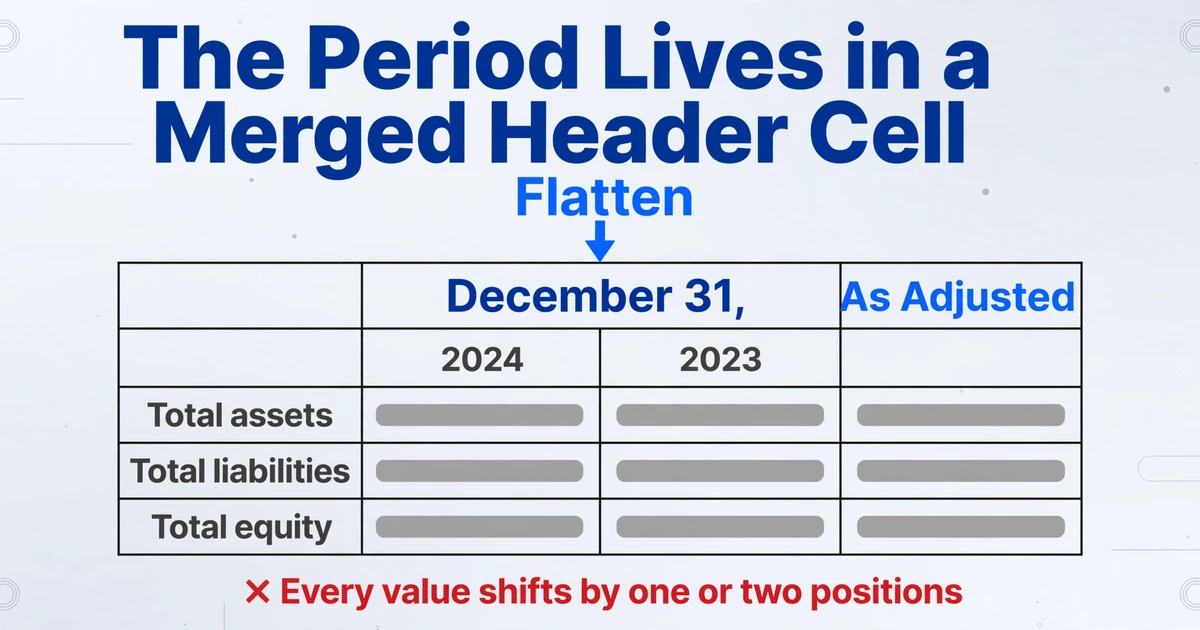
10-K 헤더는 연도 라벨 한 행인 경우가 드뭅니다. 그것은 계층 구조입니다. "December 31,"이 두 열에 걸쳐 있고 그 아래에 "2024"와 "2023"이 있습니다. 세 번째 열에는 "As Adjusted"가 있습니다. 합병이나 회계연도 변경 후에는 헤더가 구분선으로 나뉜 "Successor"와 "Predecessor" 블록으로 갈라지며, 양쪽의 보고 기간 길이가 같지 않아 한 열은 11개월을, 다음 열은 12개월을 포괄할 수 있습니다.
그 계층 구조를 평탄화하는 것이 바로 열 지정이 잘못되는 지점이며, "As Adjusted" 열은 그것이 라벨 누락보다 더 나쁜 이유를 보여줍니다. 두 열 모두 2024년을 가질 수 있습니다. 하나는 보고된 수치이고 다른 하나는 인수를 위한 pro forma 기준으로 재작성된 수치입니다. 하위 헤더를 없애면 이름이 같은 두 열이 생기고, 어느 쪽이 어느 쪽인지 구분할 방법이 없으며, 비교 시트가 보고된 숫자와 조정된 숫자를 조용히 섞게 됩니다.
병합된 셀은 두 번째 종류의 오류를 만듭니다. 하나의 헤더 셀이 세 열에 걸쳐 있는데 파서가 그것을 첫 번째 열로 축소하면, 그 아래의 모든 값이 왼쪽으로 두 칸씩 밀립니다. 숫자는 맞고 행 라벨도 맞지만 연도는 틀립니다. 잘못된 열도 여전히 유효한 숫자이기 때문에 셀 안에서 이를 알려주는 것은 아무것도 없습니다.
병합된 헤더 셀은 레이블이 아니라 열 할당입니다. 이를 평탄화하면 그 아래의 모든 값이 이동합니다.
회계연도는 추출이 해결할 수 없지만 최소한 드러낼 수는 있는 정의 문제를 추가합니다. 2024라고 표시된 열이 1월에 끝날 수도 있고, 6월에 끝날 수도 있으며, 달력에서 며칠 벗어난 52/53주 기간에 끝날 수도 있습니다. 이를 12월 결산 동종 기업과 비교하는 것은 파싱의 실수가 아니라 분석의 실수이며, 유일한 방어책은 네 자리 숫자 대신 전체 기간 레이블("2024년 1월 31일로 종료된 회계연도")을 유지하는 것입니다.
주석 참조는 숫자와 함께 이동하며 숫자에서 가장 먼저 제거되는 것입니다
10-K에서 필요한 숫자는 종종 재무제표에 있고, 그 숫자가 그런 의미를 갖는 이유는 60페이지 떨어진 주석에 있습니다. 재무제표는 "주석 12 참조", 위첨자 1, 별표 또는 해당 수치 옆에 인쇄된 괄호 안의 "(1)"과 같은 표시로 이를 알립니다.
숫자 파서는 이 표시가 값의 일부가 아니기 때문에 제거하며, 제거는 예측 가능한 방식으로 잘못됩니다. 1,234(1)로 읽히는 셀은 텍스트 레이어에서 위첨자가 분리되는 방식에 따라 1,234, 1,2341 또는 1,234.1로 반환될 수 있습니다. 독자를 설명으로 안내해야 했던 표시가 손상된 숫자로 도착합니다.
더 미묘한 실패에는 손상된 문자가 없습니다. "기타, 순액", "잡항" 또는 "기타 수익(비용)"으로 표시된 행은 여러 항목을 집계하며, 주석은 그 집계가 세분화되는 곳입니다. 행을 추출하면 분해할 수 없는 정확한 숫자를 얻게 되며, 이는 "기타"에 다른 항목이 포함된 동종 기업과 비교할 수 없음을 의미합니다. 정책도 같은 문제가 있습니다. 비용이 매출원가에 속하는지 판매비와관리비에 속하는지는 주석에 명시되어 있으며, 이는 재무제표 표면의 단일 수치도 바꾸지 않으면서 매출총이익률을 바꿉니다.
이것은 분명히 밝힐 가치가 있는 경계입니다. 추출은 검토자가 올바른 페이지로 이동할 수 있도록 "주석 12"를 열 값으로 캡처할 수 있습니다. 그러나 주석을 해석하거나 상호 참조를 따라가거나 주석 자체의 표를 가져오지는 않습니다. 그 작업은 공시 문서를 읽는 사람에게 남습니다.
MD&A에서는 읽기 순서가 열 기준인데, 텍스트 추출은 줄 단위로 읽습니다
10-K의 서술 섹션, 특히 경영진 논의 및 분석은 한 페이지에 더 많은 텍스트를 담기 위해 2~3단으로 조판되는 경우가 많습니다. 사람은 왼쪽 열을 위에서 아래로 읽은 뒤 오른쪽 열을 읽습니다. 텍스트 추출기는 문자 스트림에 나타나는 순서를 따르기 때문에 페이지를 가로질러 줄 단위로 읽습니다.
그 결과는 매출에 관한 문장이 유동성에 관한 문장의 절 중간에 끼어드는 뒤섞인 문장이 되거나, 한쪽 열은 두 번 읽히고 다른 쪽은 누락됩니다. 어느 쪽도 데이터 오류처럼 보이지 않아 검토를 통과합니다. "매출총이익률이 상승했다"고 읽히는 문장이 서로 다른 두 열에서 조립된 결과이고 원래 공시는 반대 내용이었다면, 그때 오류가 됩니다.
이 섹션은 PDF 추출이 구조화된 데이터와 경쟁하는 대신 존재 가치를 입증하는 부분입니다. XBRL은 수치에 태그를 붙입니다. 하지만 수치가 왜 움직였는지에 대한 설명, 경영진이 지목한 가격 압박, 내년에 만료되는 계약에는 태그를 붙이지 않습니다. 공시를 읽는 목적이 숫자를 가져오는 것이 아니라 사업을 이해하는 것이라면, 서술이야말로 중요한 부분이며 읽기 순서가 전부입니다.
올바른 추출은 숫자가 아닌 네 가지 필드를 유지합니다
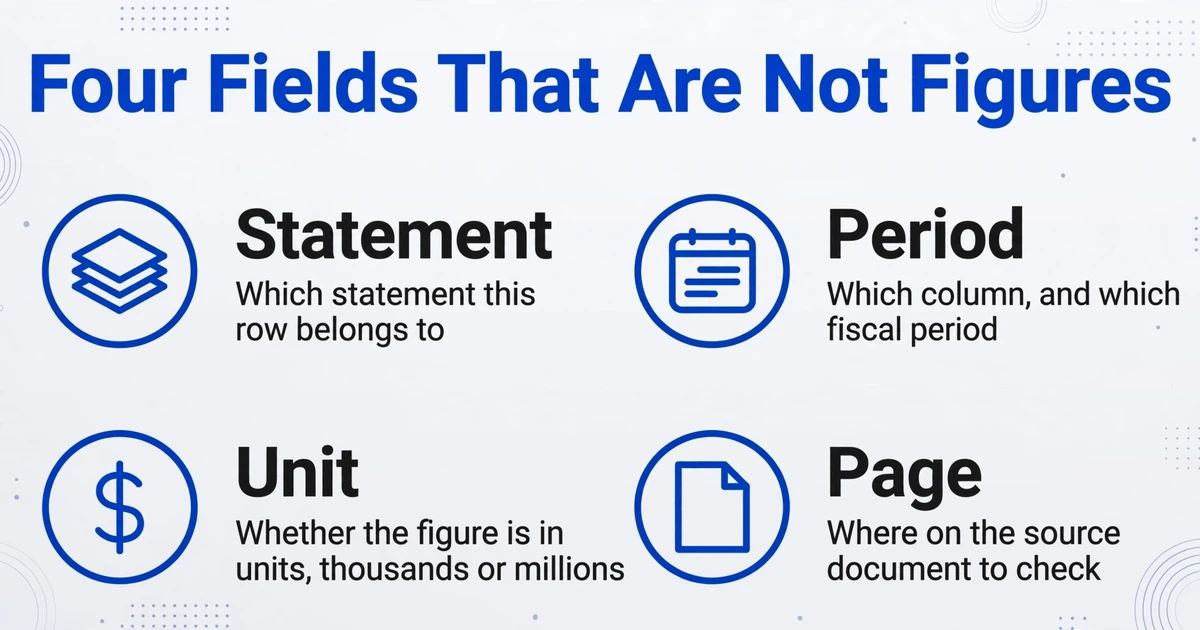
올바른 10-K 추출은 출처 정보로 평가됩니다. 모든 수치가 자신이 어디에서 왔는지 여전히 알고 있어야 합니다. 이 역할을 하는 네 가지 필드가 있으며, 각각은 숫자만으로는 답할 수 없는 질문에 답합니다.
| 필드 | 답하는 질문 | 없을 때 생기는 문제 |
|---|---|---|
| Statement | 이 행이 어느 재무제표에 속하는지 | 서로 다른 재무제표의 합계가 비교되어 엉뚱한 행에서 검증이 실패합니다 |
| Period | 어느 열이며 실제로 어느 회계연도를 포괄하는지 | 전년도 수치가 당해 연도 아래에 들어가 모든 변동의 부호가 뒤바뀝니다 |
| Unit | 수치가 단위, 천 단위, 백만 단위 중 무엇인지 | 셀은 평범해 보이는데 모든 값이 1,000배씩 어긋납니다 |
| Page | 원본 문서의 어디를 확인해야 하는지 | 검토가 PDF 전체 검색이 되어 오류를 검증하는 대신 그냥 받아들이게 됩니다 |
| 행 수준(선택) | 해당 행이 세부 항목인지 소계인지 | 열을 합산하면 같은 금액을 두세 번 계산하게 됩니다 |
단위 필드가 강조되는 데는 이유가 있습니다. 파서가 놓치는 항목 중 가장 치명적이기 때문입니다. Suffolk University 연구에서는 학습되지 않은 LLM에 2014년부터 2023년 사이에 제출된 5,000건의 연차 보고서를 주고 26개의 회계 지표를 추출하도록 했습니다. 발생한 오류의 약 절반이 배율 오류였으며, 오류율은 텍스트에서 8.16%, HTML에서 5.81%, XBRL에서 0.11%였습니다(XBRL US의 연구 요약).
1,000배 오류에서 숫자 자체는 올바르게 읽혔습니다. 실패한 것은 그리드 밖에 있는 캡션을 함께 가져오는 것이었고, 일반 숫자를 담은 셀은 이를 전혀 표시하지 않습니다.
그래서 해결책은 모델에게 더 꼼꼼히 읽으라고 지시하는 것이 아니라 열을 추가하는 것입니다. 같은 논리가 괄호와 소계 계층 구조에도 적용되는데, 이는 재무제표의 일치 여부를 결정하는 나머지 두 가지 관례이며, 재무제표에서 단위, 부호, 소계가 누락되는 이유에 대한 분석에서 설명합니다.
효과적인 설정은 지루합니다: 먼저 컨텍스트 열, 그다음 행 형태
ImageToTable.ai는 비전 모델로 페이지를 읽고 고정 좌표를 매핑하는 대신 지정한 열을 채우므로, 컨텍스트를 담는 필드도 숫자와 같은 방식으로 요청할 수 있습니다. 개념은 Custom Column Extraction입니다. 원하는 열 이름을 입력하면 AI가 페이지 어디에서든 각 값의 의미를 기준으로 찾아냅니다.
두 가지 행 형태로 대부분의 공시 작업을 처리할 수 있으며, 나머지는 공시 문서를 구분하고 결과를 확인하는 것입니다.
롱 형식: 전체 재무제표용으로 항목당 한 행
열 이름을 Company, Statement, Line Item, FY2025, FY2024, Unit, Note Reference, Page로 지정합니다. 각 행은 하나의 재무제표 항목 한 줄이며, 보고 기간, 단위, 출처 페이지가 함께 붙습니다. 소계를 포함한 모든 인쇄된 줄이 각각의 행으로 반환되므로, 재무제표 자체가 필요할 때 사용하는 형식입니다.
와이드 형식: 동종 기업 비교용으로 공시당 한 행
비교할 항목을 Revenue, Gross profit, Operating income, Net income, Total assets, Operating cash flow 같은 열로 지정하고 Fiscal Year 열을 추가합니다. 하나의 공시가 하나의 행이 되며, 이는 비교 시트에 필요한 형태입니다.
배치: 동종 기업 집합을 위한 하나의 스프레드시트
일괄 처리는 여러 공시를 한 번에 가져와 결과를 하나의 Excel 파일로 병합하며, Company 열이 이들을 구분합니다. 여덟 개의 10-K가 여덟 개가 아닌 하나의 시트가 됩니다. 바로 여기서 레이블 차이가 문제가 되지 않습니다. 한 회사는 "Total revenues", 다른 회사는 "Net sales", 또 다른 회사는 "Total net revenue"라고 인쇄하지만, 의미 기반 매칭이 이들을 같은 열로 해결합니다. 좌표 기반 템플릿은 이를 할 수 없습니다.
확인: 셀을 페이지로 다시 연결
bbox 위치 지정 기능이 있는 Review Mode는 셀에 마우스를 올리면 값이 나온 정확한 영역을 강조하고, 페이지에서 영역을 클릭하면 해당 셀로 이동합니다. 셀이 보여줄 수 없는 두 가지, 즉 그 행이 어느 재무제표에 속하는지와 값이 어느 열 아래에 있었는지 확인할 때 사용합니다. 오래된 자료에서는 같은 이유로 Model Tier가 중요합니다. 깨끗하게 인쇄된 재무제표는 표준 티어로 충분하지만, 빽빽한 스캔, 복사된 연차 보고서, 각주가 많은 페이지는 더 높은 티어가 필요합니다.
계산 열은 두 번째 도구를 추가하지 않고도 한 단계 더 나아갈 수 있습니다. 행 수준 산술은 추출 중에 평가되므로, 두 기간 열의 차이로 정의된 열은 두 열이 같은 단위일 경우 인쇄된 변동을 반환합니다. 하지만 한 재무제표는 천 단위이고 다음은 백만 단위라는 것을 알 방법이 없으므로, 단위가 다른 비교에는 규칙에 배수를 명시적으로 제공해야 합니다. 그렇더라도 그 변동이 유의미한지는 알려주지 않습니다. 그 판단은 여전히 여러분의 몫입니다.
추출 후 각 재무제표 항목을 여러분의 템플릿이 기대하는 항목에 맞추는 작업은 재무제표 스프레딩에서 설명하는 매핑 작업입니다. 도구는 행을 채웁니다. 그 행이 모델에서 어디에 속하는지는 분석가가 결정합니다.
파일은 안전하게 처리되며 저장되지 않습니다.
EDGAR에 제출된 공시라면 태그된 수치가 보통 더 나은 출처입니다
Inline XBRL은 운영회사 재무제표 정보에 대해 대형 가속 제출인의 경우 2019년부터, 가속 제출인의 경우 2020년부터, 그 외 모든 기업의 경우 2021년부터 의무화되었습니다(SEC 보도자료 2018-117). Inline XBRL이 포함된 공시라면 태그된 사실은 이미 레이아웃과 분리되어 있으므로, 이를 추출하는 것은 PDF를 읽는 것과는 다른, 종종 더 나은 작업입니다. 이 점을 밝히는 것도 솔직한 답변의 일부입니다.
XBRL은 보고된 수치 사실을 대규모로 다뤄야 할 때 올바른 경로입니다. 예를 들어 전체 종목을 스크리닝하거나, 여러 보고 기간에 걸쳐 비율을 계산하거나, 스무 개 기업의 동일 항목을 비교할 때 그렇습니다. XBRL의 한계는 실재하지만 파서의 한계와는 다릅니다. 기업들은 자체 태그로 분류 체계를 확장하는데, 이는 기업 간 비교를 약화시킵니다. 사실은 인쇄된 표현 없이 전달되므로, 사람이 읽는 소계 구조와 순서가 그 안에 담겨 있지 않습니다. 태깅 자체에도 오류가 있으며 부호 규칙이 반복적으로 나타나는 문제입니다. 또한 서술형 섹션은 전혀 태깅되지 않습니다.
PDF 추출이 올바른 경로인 상황은 네 가지이며, 이들은 충분히 흔하므로 미리 대비해야 합니다. 공시가 스캔본이거나 사용할 수 있는 텍스트 레이어가 없는 이미지만 있는 PDF인 경우입니다. 문서가 2009년에 시작된 XBRL 태깅보다 앞선 경우입니다. 제공받은 패키지가 EDGAR 공시가 전혀 아닌 경우, 예컨대 인쇄된 연차 보고서, 브로커가 편집한 동종 기업 세트, 해외 모회사의 현지 보고서 등입니다. 또는 필요한 것이 서술형 내용인 경우인데, 여기에는 우선할 구조화된 출처가 없습니다. 공시가 수백 페이지의 스캔본이라면 페이지 처리 자체가 별개의 문제가 되며, 이는 수천 페이지에 달하는 PDF를 OCR하는 방법에서 다룹니다.
ImageToTable.ai는 XBRL을 파싱하지 않고, 각주를 해석하거나 상호 참조를 따라가지 않으며, 모델을 구축하지도 않습니다. 이 도구는 제공된 페이지를 재무제표, 보고 기간, 단위, 페이지를 행에 담은 테이블로 변환합니다. 이미 깨끗하게 태그된 데이터가 있는 공시에 이 도구를 사용하는 것은 더 어려운 경로를 택하는 셈입니다.
자주 묻는 질문
PDF에서 10-K의 재무제표를 Excel로 추출할 수 있나요?
가능하며, 유용한 출력물은 숫자 이상의 정보를 담고 있습니다. 계정과목과 값 옆에 재무제표, 보고 기간, 단위, 페이지 열을 지정하면 스프레드시트의 각 행을 페이지로 추적할 수 있습니다. 이러한 필드가 없으면 내보낸 결과는 더 이상 볼 수 없는 레이아웃에 의미가 좌우되는 숫자 격자에 불과합니다.
숫자가 잘못된 연도 열 아래에 들어가는 이유는 무엇인가요?
대부분 두 가지 원인 때문입니다. 연속 페이지의 헤더가 누락되어 파서가 찾을 수 있는 가장 가까운 헤더를 할당하는 경우입니다. 또는 헤더가 병합된 다단계 셀(두 개의 하위 열에 걸친 연도, 보고된 열 옆의 "조정 후" 열)이어서 이를 평탄화하면 모든 값이 한두 위치씩 밀립니다. 열 순서를 신뢰하기 전에 처음 세 행을 원본 페이지와 대조해 확인하십시오.
"in thousands" 때문에 모든 수치가 틀려지는 것을 어떻게 막나요?
가정하지 말고 해당 표기를 별도의 열로 캡처하십시오. 이 선언은 격자 밖에 있어 열을 읽는 파서는 이를 보지 못하며, 모든 값이 숫자는 정확하지만 1,000배 틀리게 나옵니다. 배수를 한 곳에 보관하고 한 번만 적용하며, "except per share amounts"와 같은 한정어는 일부 행에 전혀 적용되지 않는다는 점을 기억하십시오.
각주도 읽나요?
"Note 12"와 같이 계정과목 옆에 인쇄된 주석 참조를 값으로 캡처할 수 있어 검토자가 올바른 페이지를 찾는 데 도움이 됩니다. 하지만 참조를 해석하거나 주석을 열거나 주석의 표를 출력물에 포함하지는 않습니다. 필요한 숫자가 주석 안에만 있다면 해당 숫자가 포함된 페이지를 업로드하여 별도의 표로 추출하십시오.
XBRL이 PDF를 파싱하는 것보다 나은가요?
보고된 수치 정보의 경우 대체로 그렇습니다. 태그된 데이터는 이미 레이아웃과 분리되어 있으며 오류율이 이를 반영합니다. 5,000개 연차 보고서를 대상으로 한 연구에서 XBRL 검색의 0.11%에서 배율 오류가 발견된 반면 일반 텍스트에서는 8.16%였습니다. 서술형 내용, 스캔본이나 이미지만 있는 PDF, EDGAR에 제출된 적 없는 문서의 경우에는 선호할 구조화된 소스가 없습니다.
스캔본이나 오래된 10-K도 처리할 수 있나요?
가능합니다. 비전 모델은 텍스트 레이어가 아닌 페이지를 읽으므로 스캔본이나 복사본도 작동하며, 더 높은 Model Tier는 흐린 인쇄, 빽빽한 각주, 기울어진 페이지에 도움이 됩니다. 실질적인 한계는 원본 품질입니다. 페이지가 비스듬히 복사되어 숫자를 실제로 읽을 수 없다면 어떤 추출도 이를 복원할 수 없으며, Review Mode는 해당 셀을 신뢰하는 대신 찾아내는 방법입니다.
맥락이야말로 추출할 가치가 있는 부분입니다
10-K는 범용 PDF 파서를 무력화합니다. 문서가 의미를 담는 위치를 파서는 장식으로 취급하기 때문입니다. 재무제표 제목, 병합된 헤더 셀, 표 위의 캡션, 숫자 옆의 위첨자, 서술형 페이지의 열 배치가 그렇습니다. 이것들을 걷어내도 모든 숫자는 남아 있지만, 어떤 검증으로도 확인할 수 없는 방식으로 배열되어 있습니다.
따라서 모든 추출의 시험대는 한 행이 스프레드시트를 벗어나지 않고 네 가지 질문에 답할 수 있는지입니다. 어느 재무제표인지, 어느 보고 기간인지, 어느 단위인지, 어느 페이지인지. 답할 수 있다면 검토자는 몇 초 만에 확인할 수 있고 분석가는 회의에서 이를 방어할 수 있습니다. 답할 수 없다면 그 숫자는 데이터의 옷을 입은 추측일 뿐입니다.