Por que um 10-K quebra um analisador de PDF,
e o que preservar
Um 10-K contém quatro ou cinco demonstrações, uma seção de notas que pode chegar a sessenta páginas e uma discussão da administração disposta no formato de colunas que o diagramador escolheu. Os dígitos são a parte fácil. O que torna o documento difícil de ler por máquina é que cada valor só significa algo em relação a três coisas que não são valores: a demonstração em que está, a coluna de período acima dele e a unidade declarada uma vez no topo da grade.
Um analisador de PDF genérico trata uma página como um fluxo de texto e uma tabela como um retângulo de células. Um 10-K não é nenhuma dessas coisas, e a lacuna aparece depois como uma planilha que parece completa e não concilia com nada.
Principais Conclusões
- Um analisador de PDF pode ler cada dígito de um 10-K corretamente e ainda retornar um valor errado por um fator de 1.000.
- Esse erro se esconde em uma legenda impressa uma vez acima da grade, então a célula em si parece perfeitamente comum.
- Quatro colunas que nomeiam a demonstração, o período, a unidade e a página tornam cada linha verificável em segundos.
O público deste artigo é a pessoa que tem o PDF em mãos, não a pessoa que constrói um pipeline de recuperação. Analistas de ações reúnem demonstrações de empresas pares em uma planilha de comparação, equipes de dados financeiros alimentam um data warehouse, auditores amostram valores divulgados. Nos três casos, o documento chegou de uma página de relações com investidores, de um e-mail de cliente ou de um agente de arquivamento, e é uma cópia renderizada de algo que existe em outro formato no EDGAR, o sistema de arquivamento da SEC. O que segue mostra onde essa cópia perde estrutura e o que uma extração precisa preservar dela para valer a pena.
Um 10-K É um Arquivamento com Várias Demonstrações, Não Uma Única Tabela
A primeira decisão que uma extração de 10-K precisa tomar é a qual demonstração uma linha pertence, e um analisador de PDF genérico nunca faz essa pergunta. Um Form 10-K percorre quatro partes e uma lista de itens. O Item 8 contém as demonstrações financeiras auditadas e as notas explicativas, o Item 7 contém a discussão da administração, o Item 1A contém os fatores de risco. Mesmo dentro do Item 8 há quatro ou cinco demonstrações, cada uma com seu próprio título, sua própria linha de unidade e seu próprio conjunto de totais, dependendo se o resultado abrangente é apresentado separadamente ou dentro da demonstração do resultado.
Isso importa porque "Total" não é um rótulo que identifica nada por si só. Toda demonstração tem uma linha de total, e várias usam as mesmas palavras: ativo total, passivo total, patrimônio líquido total, receita total. Leia um total sem saber qual demonstração o produziu e você não pode dizer a que ele deveria ser igual, com o que deveria ser comparado, ou se pertence ao bloco do balanço patrimonial da sua pasta de trabalho ou ao bloco do fluxo de caixa. Um analisador que retorna a ordem de leitura retorna os rótulos corretamente e o significado de forma alguma.
Há um segundo motivo pelo qual o limite da demonstração importa. A declaração de unidade é impressa uma vez acima de cada grade, então o balanço patrimonial pode estar em milhares enquanto uma nota três páginas depois está em milhões. A demonstração é o escopo da unidade, o que a torna o escopo da aritmética. Erre o limite e o multiplicador é aplicado em dois escopos diferentes.
Vale a pena esclarecer desde já um fato sobre o próprio arquivo. A cópia que a SEC publica é HTML com Inline XBRL incorporado, ou seja, os números financeiros são marcados em uma taxonomia legível por máquina dentro da própria página, e o PDF com que a maioria das pessoas trabalha é uma renderização publicada pela empresa ou uma digitalização de um relatório anual impresso. Assim, a tarefa de análise de 10-K aqui é recuperar a estrutura de uma cópia visual, e a extração de arquivamentos da SEC é, antes de tudo, um problema de layout antes de ser um problema de reconhecimento de caracteres.
Esse layout não é estável entre empresas, e é aí que mora a maior parte da dificuldade. Profissionais descrevem isso sem muita paciência: "A extração de tabelas de arquivamentos da SEC é genuinamente irritante porque a formatação varia enormemente entre empresas e até entre anos." (r/fintech). Uma regra que funciona para o balanço patrimonial de um declarante precisa ser reescrita para o próximo, e de novo quando a mesma empresa troca de auditores ou adota um novo padrão.
Duas Demonstrações Podem Compartilhar uma Página, com a Segunda Começando Abaixo da Última Linha da Primeira
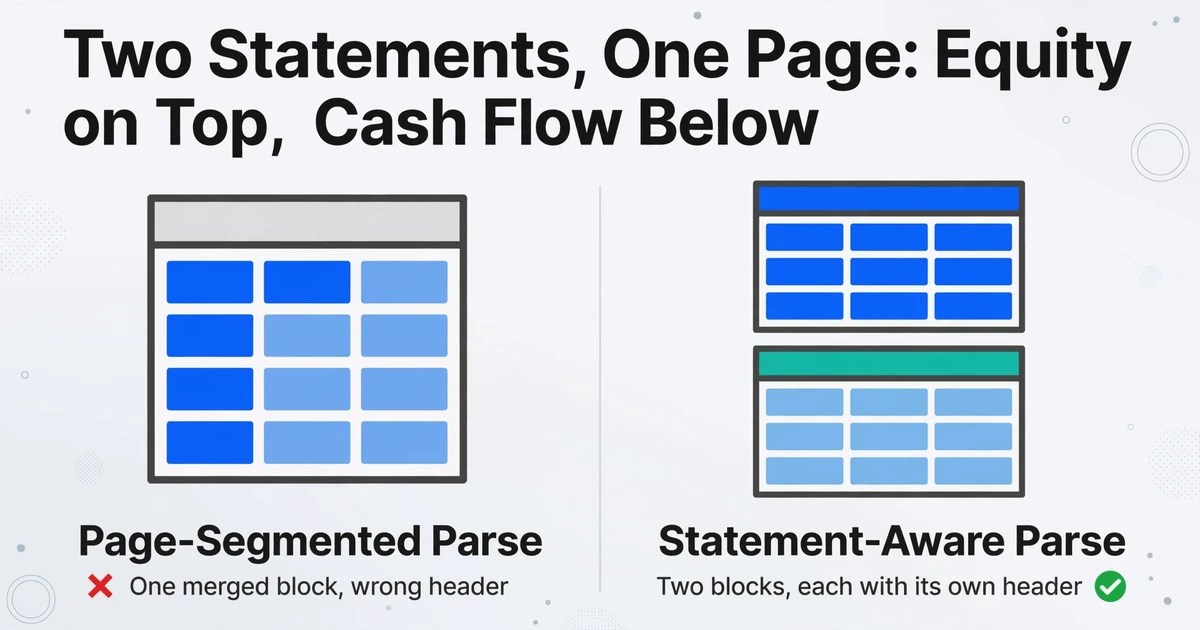
Os diagramadores de documentos não dão uma página nova para cada demonstração. Para evitar que o documento cresça, as últimas linhas da demonstração das mutações do patrimônio líquido costumam ficar no topo de uma página e a demonstração do fluxo de caixa consolidada começa imediatamente abaixo, com seu próprio título e sua própria linha de cabeçalho.
Um analisador que segmenta por página retorna um bloco. O bloco está ordenado internamente como um leitor o veria, então nada parece quebrado: as linhas do patrimônio líquido ficam em cima, as linhas do fluxo de caixa abaixo, e cada número está no lugar certo na página. O dano está na tabela. Linhas de duas demonstrações agora compartilham um cabeçalho, e o cabeçalho pertence à demonstração que o analisador anexou. Colunas do patrimônio líquido, como outros resultados abrangentes acumulados, acabam sobre valores do fluxo de caixa, e o subtotal do fluxo de caixa herda uma coluna sob a qual nunca deveria estar.
A falha deixa a contagem de linhas aproximadamente correta, e é por isso que ela sobrevive a uma primeira olhada e falha na primeira conciliação.
O sintoma a jusante é específico. O fluxo de caixa operacional deve começar pelo lucro líquido e terminar na variação de caixa, e a demonstração imprime ambos os extremos. Quando o bloco é mesclado, a verificação ou não pode ser executada ou falha em uma linha que na verdade está na tabela errada. O analista vê uma quebra de conciliação e começa a caçar um dígito mal lido, quando o dígito está correto e a linha está na demonstração errada.
Uma tabela que atravessa uma quebra de página perde o cabeçalho, não os números
Um balanço patrimonial que começa perto do fim da página 58 continua na página 59, e a página de continuação pode repetir o título da demonstração, às vezes com "(continuação)", enquanto os cabeçalhos das colunas frequentemente estão ausentes. Os números continuam vindo; os períodos acima deles, não.
Analise cada página de forma independente e você obtém duas tabelas. A primeira tem um cabeçalho e metade das linhas. A segunda tem as linhas restantes e nenhuma atribuição de período. Um analisador tentando ser útil vai pegar o cabeçalho mais próximo na página de continuação, que pode pertencer a uma tabela completamente diferente que começa mais abaixo, e as linhas acabam rotuladas com os anos errados. De qualquer forma, os valores são lidos corretamente e arquivados na coluna errada.
A estrutura entre páginas é o caso normal, não uma exceção. No FinMMDocR, um benchmark de 1.200 perguntas financeiras elaboradas por especialistas sobre 837 documentos com média de 50,8 páginas, 65% das perguntas exigem evidências que abrangem mais de uma página, com média de 2,4 páginas de evidência cada. A análise de erros do mesmo estudo é mais reveladora para quem culpa a aritmética: 78 de 100 falhas amostradas foram falhas de compreensão do documento, ou seja, o modelo não conseguiu localizar ou ler a evidência, enquanto apenas 5 foram erros de cálculo (Tang et al., FinMMDocR, AAAI 2026).
A consequência prática é que uma extração em nível de página não consegue executar as próprias verificações da demonstração. Ativos são iguais a passivos mais patrimônio líquido somente se todas as linhas de ativos e todas as linhas de passivos sobreviveram com seus períodos anexados. Metade de uma tabela não pode ser verificada contra si mesma, e é assim que uma página de continuação sem rótulo se transforma em uma planilha que ninguém consegue validar.
O período vive em uma célula de cabeçalho mesclada, e células mescladas são a primeira coisa que um analisador achata
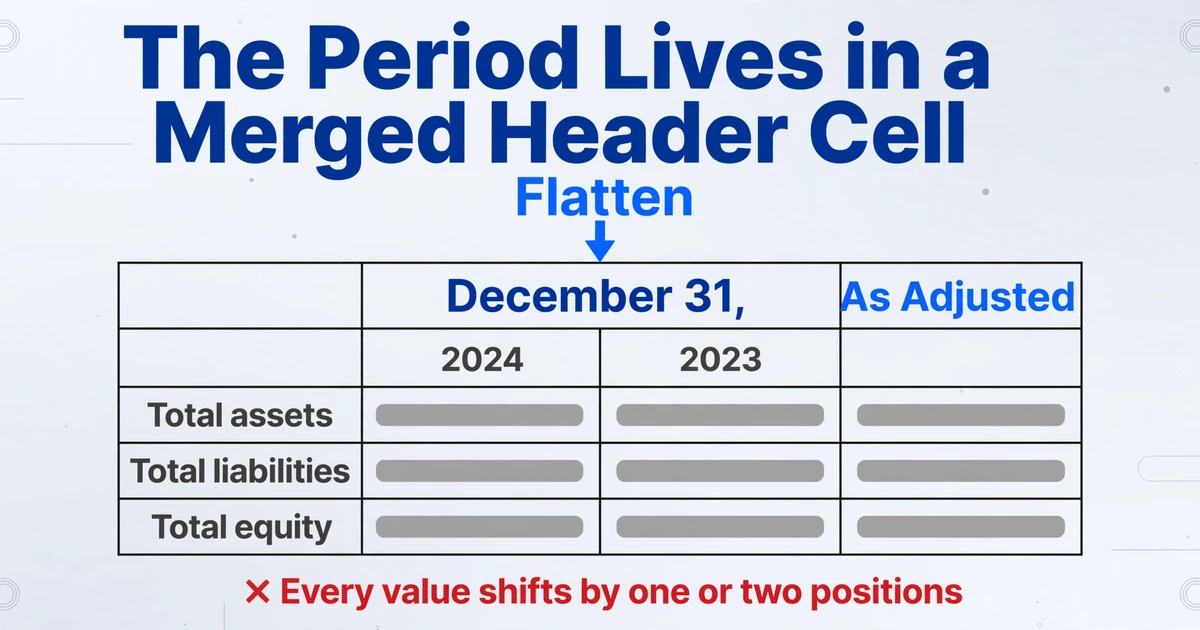
Um cabeçalho de 10-K raramente é uma única linha de rótulos de anos. É uma hierarquia. "December 31," abrange duas colunas, com "2024" e "2023" abaixo dela. Uma terceira coluna traz "As Adjusted". Após uma fusão ou uma mudança de exercício fiscal, o cabeçalho se divide em blocos "Successor" e "Predecessor" separados por uma linha, e os períodos de cada lado não têm o mesmo comprimento, então uma coluna pode cobrir onze meses e a seguinte doze.
Achatar essa hierarquia é onde as atribuições de colunas dão errado, e a coluna "As Adjusted" mostra por que isso é pior do que um rótulo ausente. Ambas as colunas podem trazer o ano de 2024. Uma é o valor conforme reportado, a outra é o valor reexpresso em base pro forma para uma aquisição. Elimine o subcabeçalho e você tem duas colunas com o mesmo nome, sem como distinguir uma da outra, e uma planilha de comparação que mistura silenciosamente um número reportado com um ajustado.
Uma célula mesclada cria um segundo tipo de erro. Quando uma célula de cabeçalho abrange três colunas e o analisador a reduz à primeira coluna, cada valor abaixo dela se desloca duas posições para a esquerda. Os dígitos estão certos, os rótulos das linhas estão certos, e o ano está errado. Nada na célula sinaliza isso, porque uma coluna errada ainda é um número válido.
Uma célula de cabeçalho mesclada é uma atribuição de coluna, não um rótulo. Achate-a e todos os valores abaixo dela se deslocam.
O exercício fiscal acrescenta um problema de definição que a extração não consegue resolver, mas ao menos pode expor. Uma coluna rotulada 2024 pode terminar em janeiro, ou em junho, ou em um período de 52/53 semanas que cai alguns dias fora do calendário. Compará-la com um par de ano fiscal encerrado em dezembro é um erro na análise, não no parse, e a única defesa é manter o rótulo completo do período ("exercício fiscal encerrado em 31 de janeiro de 2024") em vez dos quatro dígitos.
Uma referência de nota viaja com o número e é a primeira coisa removida dele
Em um 10-K, o número de que você precisa geralmente está na demonstração, e o motivo pelo qual ele significa o que significa está em uma nota a sessenta páginas de distância. A demonstração sinaliza isso com um marcador: "Ver Nota 12", um sobrescrito 1, um asterisco ou um "(1)" entre parênteses impresso junto ao valor.
Os analisadores de números removem esse marcador porque ele não faz parte do valor, e a remoção dá errado de forma previsível. Uma célula com 1,234(1) pode voltar como 1,234, como 1,2341 ou como 1,234.1, dependendo de como o sobrescrito é separado na camada de texto. A marcação que deveria levar o leitor à explicação chega como um dígito corrompido.
A falha mais sutil não tem caracteres corrompidos. Linhas rotuladas "Outros, líquido", "Diversos" ou "Outras receitas (despesas)" agregam vários itens, e é na nota que a agregação é detalhada. Extraia a linha e você tem um número correto que não pode ser decomposto, o que significa que não pode ser comparado com um par cujo "Outros" contém itens diferentes. A política contábil tem o mesmo problema: se um encargo está no custo das vendas ou nas despesas de vendas, gerais e administrativas é declarado na nota, e isso altera a margem bruta sem mudar um único valor na face da demonstração.
Este é um limite que vale declarar claramente. Uma extração pode capturar "Nota 12" como valor de coluna para que um revisor possa navegar até a página certa. Ela não resolve a nota, não segue a referência cruzada nem extrai a própria tabela da nota. Esse trabalho permanece com a pessoa que lê o documento.
No MD&A, a ordem de leitura é coluna por coluna, e a extração de texto lê linha por linha
As seções narrativas de um 10-K, em especial a discussão e análise da administração, costumam ser dispostas em duas ou três colunas para caber mais texto na página. Uma pessoa lê descendo a coluna da esquerda e depois a da direita. Um extrator de texto lê atravessando a página, linha por linha, porque é essa a ordem em que os caracteres aparecem no fluxo de conteúdo.
O resultado é ou uma prosa intercalada, em que uma frase sobre receita continua no meio de uma frase sobre liquidez, ou uma coluna lida duas vezes enquanto a outra é descartada. Nenhum dos dois parece um erro de dados, então passa pela revisão. Vira erro quando uma frase que diz "a margem bruta aumentou" foi montada a partir de duas colunas diferentes e o documento dizia o contrário.
É nesta seção que a extração de PDF justifica seu lugar em vez de competir com dados estruturados. O XBRL marca os números. Não marca a explicação de por que os números mudaram, a pressão de preços que a administração cita ou o contrato que vence no ano que vem. Se o objetivo de ler o documento é entender o negócio e não apenas buscar um número, a narrativa é a parte que importa, e a ordem de leitura é o jogo inteiro.
Uma extração correta mantém quatro campos que não são números
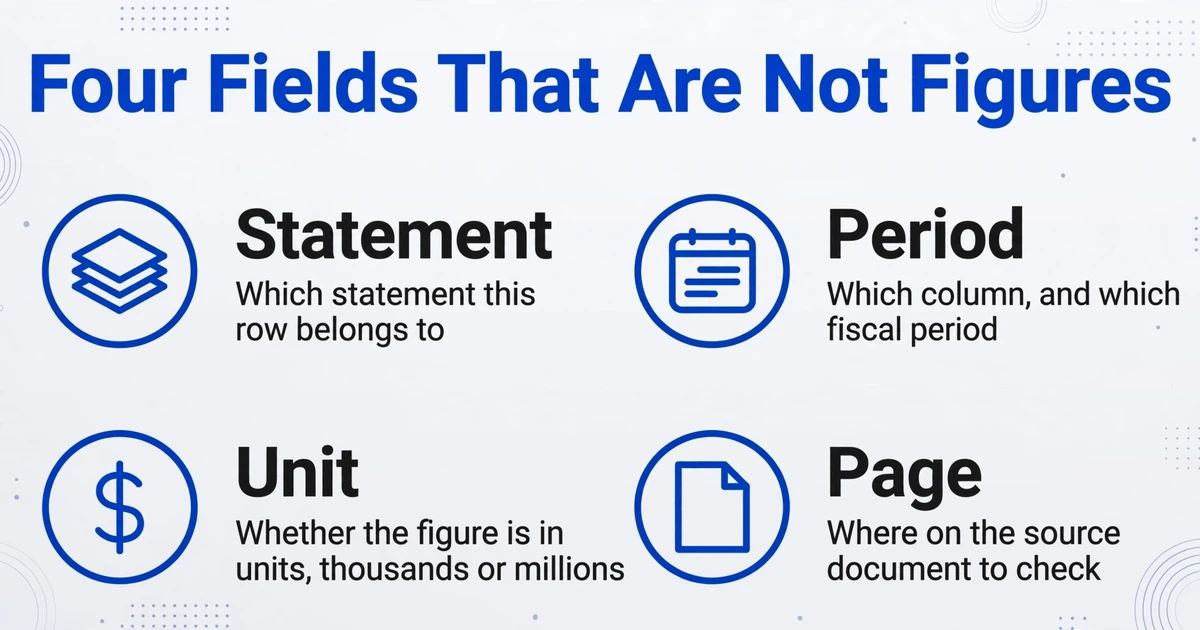
Uma extração correta de 10-K é medida pela rastreabilidade: cada número ainda sabe de onde veio. Quatro campos fazem esse trabalho, e cada um responde a uma pergunta que o número sozinho não responde.
| Campo | O que responde | O que dá errado sem ele |
|---|---|---|
| Statement | A qual demonstração financeira esta linha pertence | Totais de demonstrações diferentes são comparados, e a conciliação falha na linha errada |
| Period | Qual coluna, e qual período fiscal ela realmente cobre | Números do ano anterior caem sob o ano atual, e toda variação fica com o sinal errado |
| Unit | Se o número está em unidades, milhares ou milhões | Todo valor fica errado por um fator de 1.000 enquanto a célula parece normal |
| Page | Onde no documento de origem conferir | A revisão vira uma busca pelo PDF, então os erros são aceitos em vez de verificados |
| Nível da linha (opcional) | Se a linha é um detalhe ou um subtotal | Somar a coluna conta o mesmo dinheiro duas ou três vezes |
O campo de unidade merece a ênfase que recebe porque é a coisa mais cara que um analisador deixa passar. Um estudo da Suffolk University colocou um LLM sem treinamento contra 5.000 relatórios anuais arquivados entre 2014 e 2023, pedindo que ele recuperasse 26 métricas contábeis. Cerca de metade dos erros que cometeu foram erros de escala, e as taxas foram de 8,16% em texto, 5,81% em HTML e 0,11% em XBRL (resumo do estudo pela XBRL US).
Os dígitos de um erro de 1.000x foram lidos corretamente. O que falhou foi carregar uma legenda que fica fora da grade, e uma célula contendo um número comum nunca sinaliza isso.
É por isso que a correção é uma coluna, e não uma instrução ao modelo para ler com mais atenção. A mesma lógica vale para parênteses e hierarquia de subtotais, as duas outras convenções que decidem se uma demonstração fecha, e elas estão detalhadas no detalhamento de por que as demonstrações perdem unidades, sinais e subtotais.
A Configuração Que Funciona É Entediante: Primeiro as Colunas de Contexto, Depois um Formato de Linha
O ImageToTable.ai lê a página com um modelo de visão e preenche as colunas que você nomeia, em vez de mapear coordenadas fixas, então os campos que carregam contexto podem ser solicitados da mesma forma que os números. O conceito é Extração de Colunas Personalizadas: você digita os nomes das colunas que deseja, e a IA localiza cada valor pelo que ele significa em qualquer lugar da página.
Dois formatos de linha cobrem a maior parte do trabalho com arquivamentos, e o resto é sobre manter os arquivamentos separados e conferir o resultado.
Longo: uma linha por item, para uma demonstração completa
Nomeie as colunas como Company, Statement, Line Item, FY2025, FY2024, Unit, Note Reference e Page. Cada linha é uma linha de uma demonstração, com seu período, escala e página de origem anexados. Este é o formato a usar quando você precisa da demonstração em si, porque cada linha impressa, incluindo os subtotais, volta como sua própria linha.
Largo: uma linha por documento, para uma comparação entre pares
Nomeie os itens que você compara como colunas, como Revenue, Gross profit, Operating income, Net income, Total assets e Operating cash flow, com uma coluna Fiscal Year. Um documento vira uma linha, que é o que uma planilha de comparação quer.
Lote: uma planilha para o conjunto de pares
O processamento em lote pega vários documentos de uma vez e mescla os resultados em um único arquivo Excel, com uma coluna Company mantendo-os separados. Oito 10-Ks viram uma planilha em vez de oito. É aqui que a variação de rótulos deixa de ser um problema: uma empresa imprime "Total revenues", outra "Net sales", uma terceira "Total net revenue", e a correspondência semântica as resolve na mesma coluna, o que um modelo de coordenadas não consegue fazer.
Verifique: aponte a célula de volta para a página
Review Mode com localização por bbox destaca a região exata de onde um valor veio quando você passa o mouse sobre a célula, e clicar em uma região na página salta de volta para sua célula. Use-o nas duas coisas que uma célula não consegue mostrar: a qual demonstração a linha pertence e sob qual coluna o valor estava. Model Tier importa pelo mesmo motivo em material mais antigo. Uma demonstração impressa limpa vai bem no nível padrão; uma digitalização densa, um relatório anual fotocopiado ou uma página cheia de notas de rodapé precisa de um nível mais alto.
Uma coluna calculada pode dar mais um passo sem adicionar uma segunda ferramenta. Como a aritmética em nível de linha é avaliada durante a extração, uma coluna definida como a diferença entre as duas colunas de período retorna a variação impressa, desde que ambas as colunas estejam na mesma unidade. Ela não tem como saber que uma demonstração está em milhares e a próxima em milhões, então uma comparação entre escalas precisa do multiplicador fornecido explicitamente na regra. Mesmo assim, ela não dirá se a variação é significativa. Isso continua sendo seu.
O que acontece após a extração, casando cada linha da demonstração com a linha que seu próprio modelo espera, é o trabalho de mapeamento que financial statement spreading descreve. A ferramenta preenche uma linha. O analista decide onde essa linha pertence no modelo.
Os arquivos são processados com segurança e não são armazenados.
Se o documento está no EDGAR, os valores marcados costumam ser a fonte melhor
O Inline XBRL é obrigatório para informações de demonstrações financeiras de empresas operacionais desde 2019 para grandes declarantes acelerados, 2020 para declarantes acelerados e 2021 para todos os demais (comunicado à imprensa da SEC 2018-117). Para um documento que o contém, os fatos marcados já estão separados do layout, e extraí-los é um trabalho diferente e muitas vezes melhor do que ler o PDF. Dizer isso faz parte de dar uma resposta direta.
O XBRL é o caminho certo quando você precisa de fatos numéricos reportados em escala: triagem de um universo, cálculo de índices entre períodos, comparação de uma linha entre vinte empresas. Seus limites são reais, mas diferentes dos de um analisador. As empresas ampliam a taxonomia com suas próprias tags, o que enfraquece a comparação entre empresas; um fato chega sem a apresentação impressa, então a estrutura de subtotais e a ordenação que um humano lê não estão nele; a própria marcação contém erros, sendo as convenções de sinal um recorrente; e as seções narrativas não são marcadas de forma alguma.
A extração de PDF é o caminho certo em quatro situações, e elas são comuns o suficiente para se planejar. O documento é uma digitalização ou um PDF somente imagem sem camada de texto utilizável. O documento é anterior à marcação XBRL, que começou em 2009. O pacote que você recebeu não é um documento do EDGAR, como um relatório anual impresso, um conjunto de pares compilado por uma corretora ou um relatório local de uma controladora estrangeira. Ou o que você precisa é a narrativa, onde não há fonte estruturada a preferir. Quando o documento é uma digitalização de várias centenas de páginas, o tratamento de páginas se torna um problema à parte, abordado em como fazer OCR de um PDF que chega a milhares de páginas.
O ImageToTable.ai não analisa XBRL, não resolve notas de rodapé nem segue referências cruzadas, e não constrói um modelo. Ele transforma as páginas que você fornece em uma tabela cujas linhas carregam sua demonstração, período, unidade e página. Usá-lo em um documento que já tem dados marcados limpos seria escolher o caminho mais difícil.
Perguntas Frequentes
Posso extrair as demonstrações financeiras de um 10-K de um PDF para o Excel?
Sim, e o resultado útil carrega mais do que os números. Nomeie colunas para a demonstração, o período, a unidade e a página junto com os itens de linha e os valores, para que cada linha da planilha possa ser rastreada até uma página. Sem esses campos, a exportação é uma grade de números cujo significado depende de um layout que você não consegue mais ver.
Por que os números caem na coluna do ano errado?
Duas causas explicam a maior parte disso. O cabeçalho de uma página de continuação está ausente, então o analisador atribui o cabeçalho mais próximo que encontra. Ou o cabeçalho é uma célula mesclada de vários níveis (um ano abrangendo duas subcolunas, uma coluna "As Adjusted" ao lado de uma reportada) e achatá-la desloca cada valor em uma ou duas posições. Confira as três primeiras linhas com a página de origem antes de confiar na ordem das colunas.
Como evito que "in thousands" torne cada número errado?
Capture a legenda como uma coluna própria em vez de presumi-la. A declaração fica fora da grade, então um analisador que lê colunas nunca a vê, e cada valor volta correto no dígito e errado por um fator de 1.000. Mantenha o multiplicador em um só lugar, aplique-o uma vez e lembre-se de que qualificadores como "except per share amounts" significam que algumas linhas não são escaladas de forma alguma.
Ele lê as notas de rodapé?
Ele pode capturar a referência de nota impressa ao lado de uma linha, como "Note 12", como um valor, o que ajuda um revisor a encontrar a página certa. Ele não resolve a referência, não abre a nota nem traz a tabela da nota para a saída. Se o número de que você precisa existe apenas dentro de uma nota, envie as páginas que a contêm e extraia-as como uma tabela própria.
O XBRL é melhor do que analisar o PDF?
Para fatos numéricos reportados, geralmente sim. Os dados marcados já estão separados do layout, e as taxas de erro refletem isso: um estudo de 5.000 relatórios anuais encontrou erros de escala em 0,11% das recuperações via XBRL contra 8,16% a partir de texto simples. Para narrativa, para cópias digitalizadas ou somente imagem, e para documentos que nunca foram protocolados no EDGAR, não há fonte estruturada a preferir.
Ele consegue lidar com um 10-K digitalizado ou mais antigo?
Sim. Um modelo de visão lê a página em vez de uma camada de texto, então uma digitalização ou uma fotocópia funciona, e um nível de modelo mais alto ajuda em impressão fraca, notas de rodapé densas e páginas tortas. O limite prático é a qualidade da origem: se uma página foi copiada em ângulo e um dígito é genuinamente ilegível, nenhuma extração o recupera, e o Review Mode é como você encontra essas células em vez de confiar nelas.
O Contexto É a Parte que Vale Extrair
Um 10-K derrota um analisador de PDF genérico porque o documento armazena significado em lugares que o analisador trata como decoração: o título da demonstração, a célula de cabeçalho mesclada, a legenda acima da grade, o sobrescrito ao lado de um número, o layout de colunas de uma página de texto corrido. Remova isso e você ainda terá todos os dígitos, organizados de um jeito que nenhuma conciliação consegue confirmar.
Então o teste para qualquer extração é se uma linha consegue responder a quatro perguntas sem sair da planilha: qual demonstração, qual período, qual unidade, qual página. Se conseguir, um revisor pode conferir em segundos e um analista pode defendê-la em uma reunião. Se não conseguir, os números são palpites vestindo a fantasia de dados.