Précision d'extraction des formulaires de données de terrain :
météo, écriture manuscrite et conception de formulaire
La précision d'extraction des formulaires de données de terrain se joue bien avant que le fichier n'atteigne un outil d'extraction — elle se joue sur le porte-bloc, sous la pluie, entre les mains de la personne qui tient le stylo. Un technicien environnemental dans un fil r/Environmental_Careers l'a formulé d'une manière que quiconque a arpenté une zone humide comprend : « S'il n'y a pas de boue sur vos formulaires de données, avez-vous vraiment délimité la zone humide ? » Cette boue n'est pas qu'un gage d'authenticité — c'est le plus grand prédicteur de la fiabilité d'un comptage de nuisibles, d'une lecture de pH ou d'une constatation de sécurité à l'autre bout de la chaîne. Cet article cartographie chaque facteur qui se situe entre un formulaire sur le terrain et une ligne fiable dans votre base de données, et indique lesquels vous pouvez réellement contrôler.
Points clés à retenir
- Les problèmes de précision sur les formulaires de terrain ne sont presque jamais la faute de l'outil d'extraction — ils se jouent sur le porte-bloc, sous la pluie, entre les mains de la personne qui tient le stylo, bien avant que le fichier n'atteigne un logiciel.
- Les mêmes conditions qui rendent un formulaire difficile à lire pour l'IA le rendent difficile à lire pour les humains aussi : les taux d'erreur documentés de la saisie manuelle (saisir à la main ce qui figure sur un formulaire dans une base de données) vont de 1 à 10 %, et la seule qualité de capture fait varier les résultats d'extraction de 10 à 20 points de pourcentage.
- Cessez de chercher un meilleur outil d'extraction — votre vrai levier, c'est la chaîne : concevez des formulaires avec des codes plutôt que du texte libre, photographiez-les le jour de la collecte, et vérifiez uniquement les 10 % de cellules que l'IA signale comme incertaines au lieu de tout ressaisir.
Même une transcription parfaite commence avec du retard
Avant même l'intervention d'un logiciel, la copie manuelle des données de terrain perd déjà un pourcentage mesurable de celles-ci — et les données de terrain, collectées avec des gants et dans le vent, en perdent plus que les données de bureau.
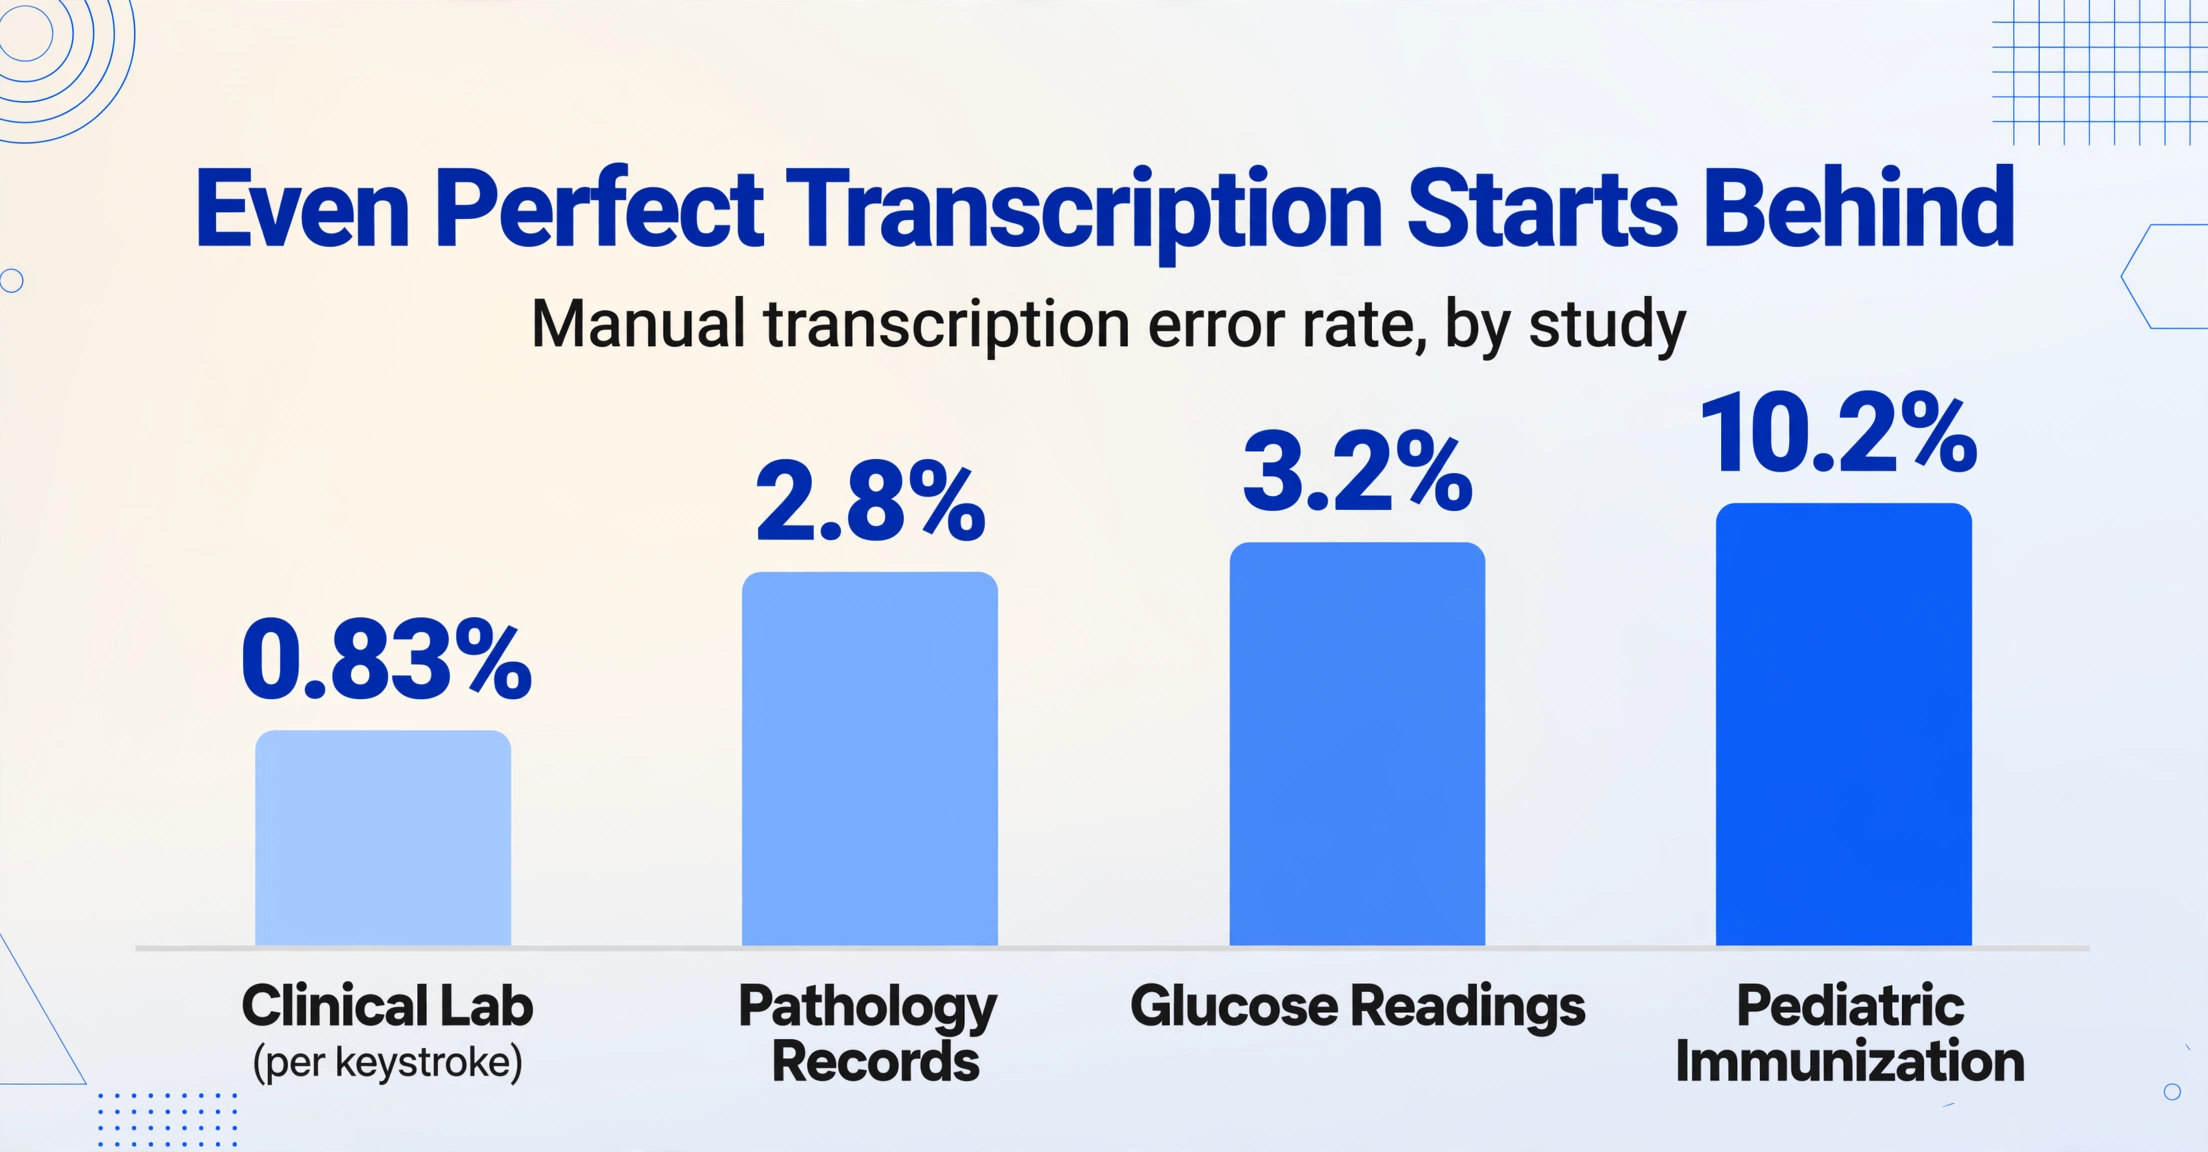
Des études sur les erreurs de transcription manuelle dans les contextes médicaux et de tenue de dossiers, résumées dans une revue à comité de lecture publiée sur les archives PMC du NCBI, ont révélé des taux d'erreur s'étendant sur un ordre de grandeur : 0,83 % par frappe dans un laboratoire clinique, 2,8 % au total dans une étude sur les dossiers de pathologie (variant de 0,5 à 6,4 % selon le champ), 3,2 % pour les relevés de glycémie au point de service, et 10,2 % dans un ensemble de données de vaccination pédiatrique. Le point commun est que même des personnes motivées et formées commettent des erreurs à un chiffre faible lorsqu'elles transfèrent des valeurs entre supports — et les erreurs se concentrent précisément dans les champs numériques dont dépend le travail de terrain : chiffres inversés dans le pH, mauvais identifiant d'échantillon sur un composite, niveau d'eau qui atterrit dans la colonne du voisin.
C'est la référence. Le logiciel d'extraction ne rivalise pas avec une transcription parfaite, mais avec cette référence imparfaite, à vitesse humaine — c'est pourquoi « l'IA est-elle précise ? » est la mauvaise question. La bonne question est « précise par rapport à quoi, sur quelles entrées ? » Le spectre de précision champ par champ que nous avons cartographié séparément montre le même phénomène du côté de l'outil : texte imprimé près de 99 %, écriture cursive près de 70 %, cases à cocher quelque part entre les deux — un écart de 25 points sur un seul formulaire. L'écart est là où vivent les formulaires de terrain, car tout ce qui rend un formulaire difficile à lire le rend également difficile à transcrire, que les mains qui lisent soient humaines ou mécaniques.
Pluie, boue et soleil : le terrain réécrit le formulaire
Les dommages physiques subis par le papier constituent le premier facteur de précision, et c'est aussi celui auquel les équipes de terrain s'attendent le moins, car elles cessent de les voir. Un technicien qui a transporté un carnet de terrain toute la saison ne remarque plus la tache d'eau sur la colonne de conductivité, le pli où la feuille a été glissée dans une poche arrière, ni l'encre délavée par le soleil en un gris pâle. Chacun de ces éléments dégrade le signal visuel que lit le modèle d'extraction — de la même manière qu'il dégrade le signal qu'un superviseur lisant le formulaire au bureau lirait.
Les équipes de terrain ont leurs propres solutions qui révèlent à quel point le problème est réel. Dans le même fil r/Environmental_Careers, un commentateur a partagé la solution classique : « Astuce de terrain : achetez le papier imperméable à feuilles mobiles et imprimez les formulaires dessus. Ça vaut le coût ! » Le papier résistant aux intempéries, les stylos à encre indélébile et les porte-bloc avec couvercle existent parce que l'eau, la boue et le soleil détruisent de manière fiable les enregistrements de terrain. Lorsque ces enregistrements survivent, ils arrivent au bureau avec la météo encore écrite dessus — et c'est l'entrée qu'un pipeline d'extraction reçoit.
Ce que vous contrôlez ici : photographiez ou numérisez le formulaire pendant qu'il est encore lisible — le jour où il est rempli, pas le jour où il arrive au bureau. Les formulaires photographiés au moment de la saisie capturent l'écriture avant qu'une semaine dans la cabine du camion ne la fane. Lorsque cela n'est pas possible, traitez les formulaires visiblement endommagés comme un lot séparé et plus petit, et prévoyez de les vérifier plus en profondeur (plus de détails sur la vérification ci-dessous).
Les copies carbone et les formulaires en double ajoutent une deuxième couche de dommages : la qualité d'impression sur les deuxième et troisième copies se dégrade fortement, et si les membres de l'équipe remplissent les deux copies en même temps, la pression peut rendre l'écriture de la feuille supérieure superficielle. L'extraction traite une copie carbone pâle comme le ferait une personne — elle la lit, hésite et peut mal lire. La même logique s'applique au crayon : effaçable et lisible pour celui qui écrit, mais pâle et sujet aux bavures pour quiconque le lit plus tard.
Écriture manuscrite après une longue journée
La qualité de l'écriture manuscrite varie davantage au cours d'un après-midi qu'entre deux outils d'extraction — le onzième formulaire de la journée d'un travailleur de terrain est nettement moins lisible que le premier. La recherche sur la reconnaissance de l'écriture traite la lisibilité comme une propriété du scripteur, mais sur le terrain, c'est une propriété des conditions : doigts froids, gants mouillés, presse-papiers en équilibre sur le capot d'un camion, pression de passer à la station suivante. Les techniciens de terrain sur Reddit décrivent précisément ce compromis — « Sur le terrain, il est tellement plus rapide d'écrire un chiffre sur un formulaire papier que de déverrouiller l'iPad, ouvrir l'application, taper le chiffre » — c'est pourquoi le papier survit à l'ère numérique, et pourquoi le papier qu'il produit est exactement ce que l'extraction doit traiter.
La bonne nouvelle, c'est que la plupart des écritures de terrain sont en lettres capitales ou en script, ce que l'extraction traite avec une grande précision ; le seuil de précision se situe au niveau de l'écriture cursive rapide et des chiffres écrits assez vite pour que 3 et 8, ou 1 et 7, se confondent. Un formulaire mixte — étiquettes imprimées, valeurs manuscrites en capitales, option encerclée, signature — est un cas courant, et les modèles de vision modernes lisent l'ensemble de manière holistique plutôt que d'exiger un style cohérent par page.
Il existe une réponse institutionnelle à ce problème qui précède l'IA, et elle vaut la peine d'être empruntée. Le Field Book for Describing and Sampling Soils (Version 4.0, 2024) de l'USDA NRCS demande aux pédologues de consigner les espèces végétales sous forme de codes symboliques standardisés — le barbon devient « ANGE », un code à quatre caractères tiré de la liste officielle des plantes — plutôt que d'écrire des noms dont l'orthographe et la longueur varient. Cette approche se transpose directement : moins le formulaire exige d'écriture libre, moins l'écriture elle-même a de place pour devenir une source d'erreur. Les codes, cases à cocher et chiffres sont plus lisibles pour les machines pour la même raison qu'ils le sont pour les humains fatigués. Notre guide d'amélioration de la précision de l'écriture manuscrite approfondit ce qui rend l'écriture d'un formulaire extractible et celle d'un autre non.
La conception du formulaire : le levier de précision dont personne ne parle
La conception du formulaire détermine la précision d'extraction plus que toute astuce de capture, car elle décide de ce que le modèle d'extraction doit interpréter en premier lieu. Les directives de gestion des données environnementales publiées par l'Interstate Technology & Regulatory Council (ITRC) soulignent ce point du côté de la tenue de registres : « Concevez une réponse de formulaire de données de terrain en connaissant le type de données attendu et la longueur du champ de base de données qui l'accueillera. » Un formulaire conçu en gardant à l'esprit sa base de données de destination — une valeur par case, des unités imprimées à côté de la case, pas de texte libre sur plusieurs lignes là où un code suffit — produit des lignes qui atterrissent dans les bonnes colonnes avec une interprétation minimale. Un formulaire conçu pour la commodité produit une ambiguïté qu'aucun modèle d'extraction ne peut résoudre entièrement.
Quatre choix de conception reviennent sans cesse dans les formulaires de données de terrain, et chacun correspond à un comportement de précision connu :
| Choix de conception | Pourquoi c'est un problème | La version favorable à la précision |
|---|---|---|
| Des espaces vides pour tout | Les champs libres invitent aux abréviations, aux raccourcis et à la confusion des unités — le rédacteur suppose un contexte que le lecteur n'aura pas | Des cases à cocher pour les options connues ; des unités imprimées dans l'étiquette (« pH (unités) »), des codes pour les valeurs récurrentes |
| Des lignes de règle traversant les zones de valeur | Les lignes de grille qui croisent le texte créent un bruit visuel qui entre en concurrence avec les caractères | Des espaces espacés ou des lignes de règle légères qui s'arrêtent avant la zone d'écriture |
| Haute densité — tout sur une seule page | Les champs exigus poussent l'écriture contre les étiquettes et les bords ; les valeurs se mélangent | Une valeur par case avec une séparation claire ; une deuxième page vaut mieux qu'une première surchargée |
| Orientation mixte dans un lot | Les pages paysage et portrait dans le même lot nécessitent chacune leur propre chemin de lecture | Une orientation par lot si possible ; en cas de mélange, l'outil doit toujours localiser les champs par le sens, pas par la position |
La dernière ligne compte car c'est là que les approches d'extraction divergent. L'OCR par modèle verrouille chaque champ à une coordonnée sur un formulaire de référence — faites pivoter le formulaire, changez la mise en page, ajoutez le modèle de journal différent d'une station, et les cases ne correspondent plus. L'approche sémantique qu'utilise ImageToTable.ai, Custom Column Extraction, inverse cette logique : vous saisissez les noms de colonnes souhaités (« pH », « Pest Count », « Station ID »), et l'IA localise la valeur qui répond à chaque nom n'importe où sur la page, par le sens plutôt que par la position. Un lot de formulaires de données de terrain avec des mises en page différentes, des écritures différentes et des niveaux de détérioration différents renvoie toujours les mêmes colonnes nommées, car le modèle lit le document comme le ferait une personne — il n'exige pas que le champ se trouve à une coordonnée mémorisée.
Capture : une photo, c'est la moitié de la précision
Entre deux photos d'un même formulaire, la qualité de capture à elle seule explique un écart de précision de 10 à 20 points de pourcentage — un chiffre que nos propres tests de précision de formulaire reproduisent systématiquement. La majeure partie de cet écart vient de quatre habitudes simples : poser le formulaire à plat sur une surface solide, éviter les reflets et le contre-jour, garder le téléphone parallèle à la page, et cadrer toute la page, y compris les identifiants d'en-tête. Les modes de numérisation de documents des appareils photo de téléphone automatisent la plupart de ces étapes — correction de perspective, aplatissement et suppression des ombres sont intégrés à tous les téléphones modernes — mais ils ne servent que si le technicien de terrain les active.
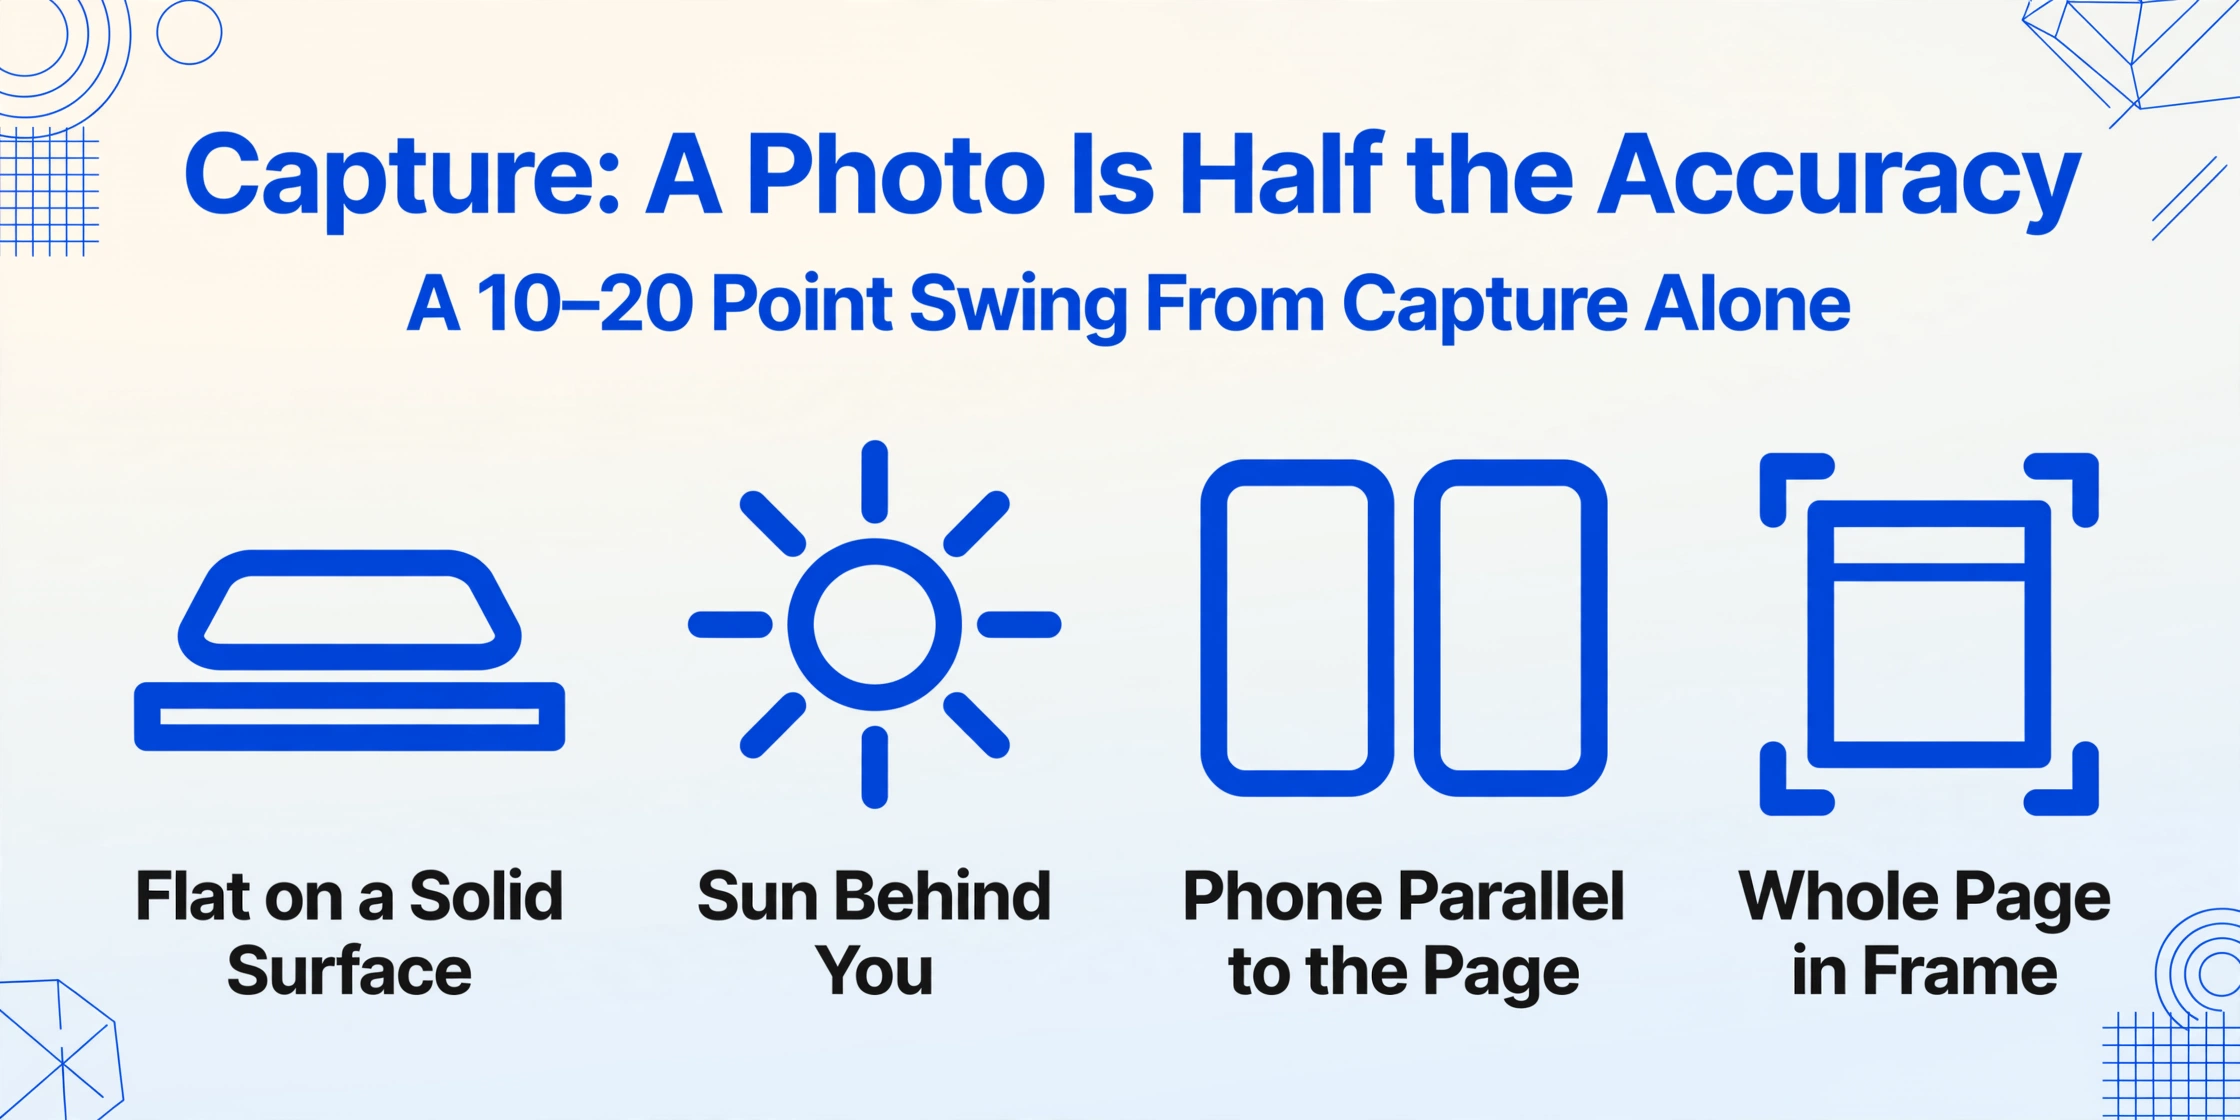
La capture en extérieur a ses propres modes de défaillance. La lumière directe du soleil qui efface la page et l'ombre du photographe qui tombe sur l'écriture sont les deux problèmes les plus courants, et tous deux se règlent par le même geste : se tourner pour que le soleil soit derrière le photographe, ou utiliser sa propre ombre pour ombrager la page. Le technicien du fil Reddit qui décrivait les formulaires numériques comme « difficiles à lire en plein soleil » décrivait la même physique qui sous-expose un formulaire papier tenu contre un ciel lumineux — sauf qu'un formulaire papier peut être ombragé, incliné ou déplacé, alors qu'une photo ne capture que ce que la caméra a vu.
La résolution importe moins que ce que l'on croit, au-delà d'un seuil modeste — une photo de téléphone d'un formulaire format lettre fait généralement 2 000 à 3 000 pixels de large, ce qui est largement suffisant — mais le type de capture compte : une numérisation plate et bien éclairée d'un formulaire propre est le cas idéal ; une photo du même formulaire prise dans le camion au crépuscule est le pire cas, et les deux peuvent se retrouver dans le même lot. Si les photos de votre équipe restent dans le camion pendant une semaine, le modèle de Lien de collecte que nous avons décrit dans notre guide de workflow de formulaire de terrain vers Excel — un lien partageable qui permet à l'équipe de téléverser les photos directement dans votre file de traitement — réduit cet écart et limite la dégradation des formulaires avant la capture.
Pourquoi l'extraction sémantique tient là où l'OCR par modèle échoue
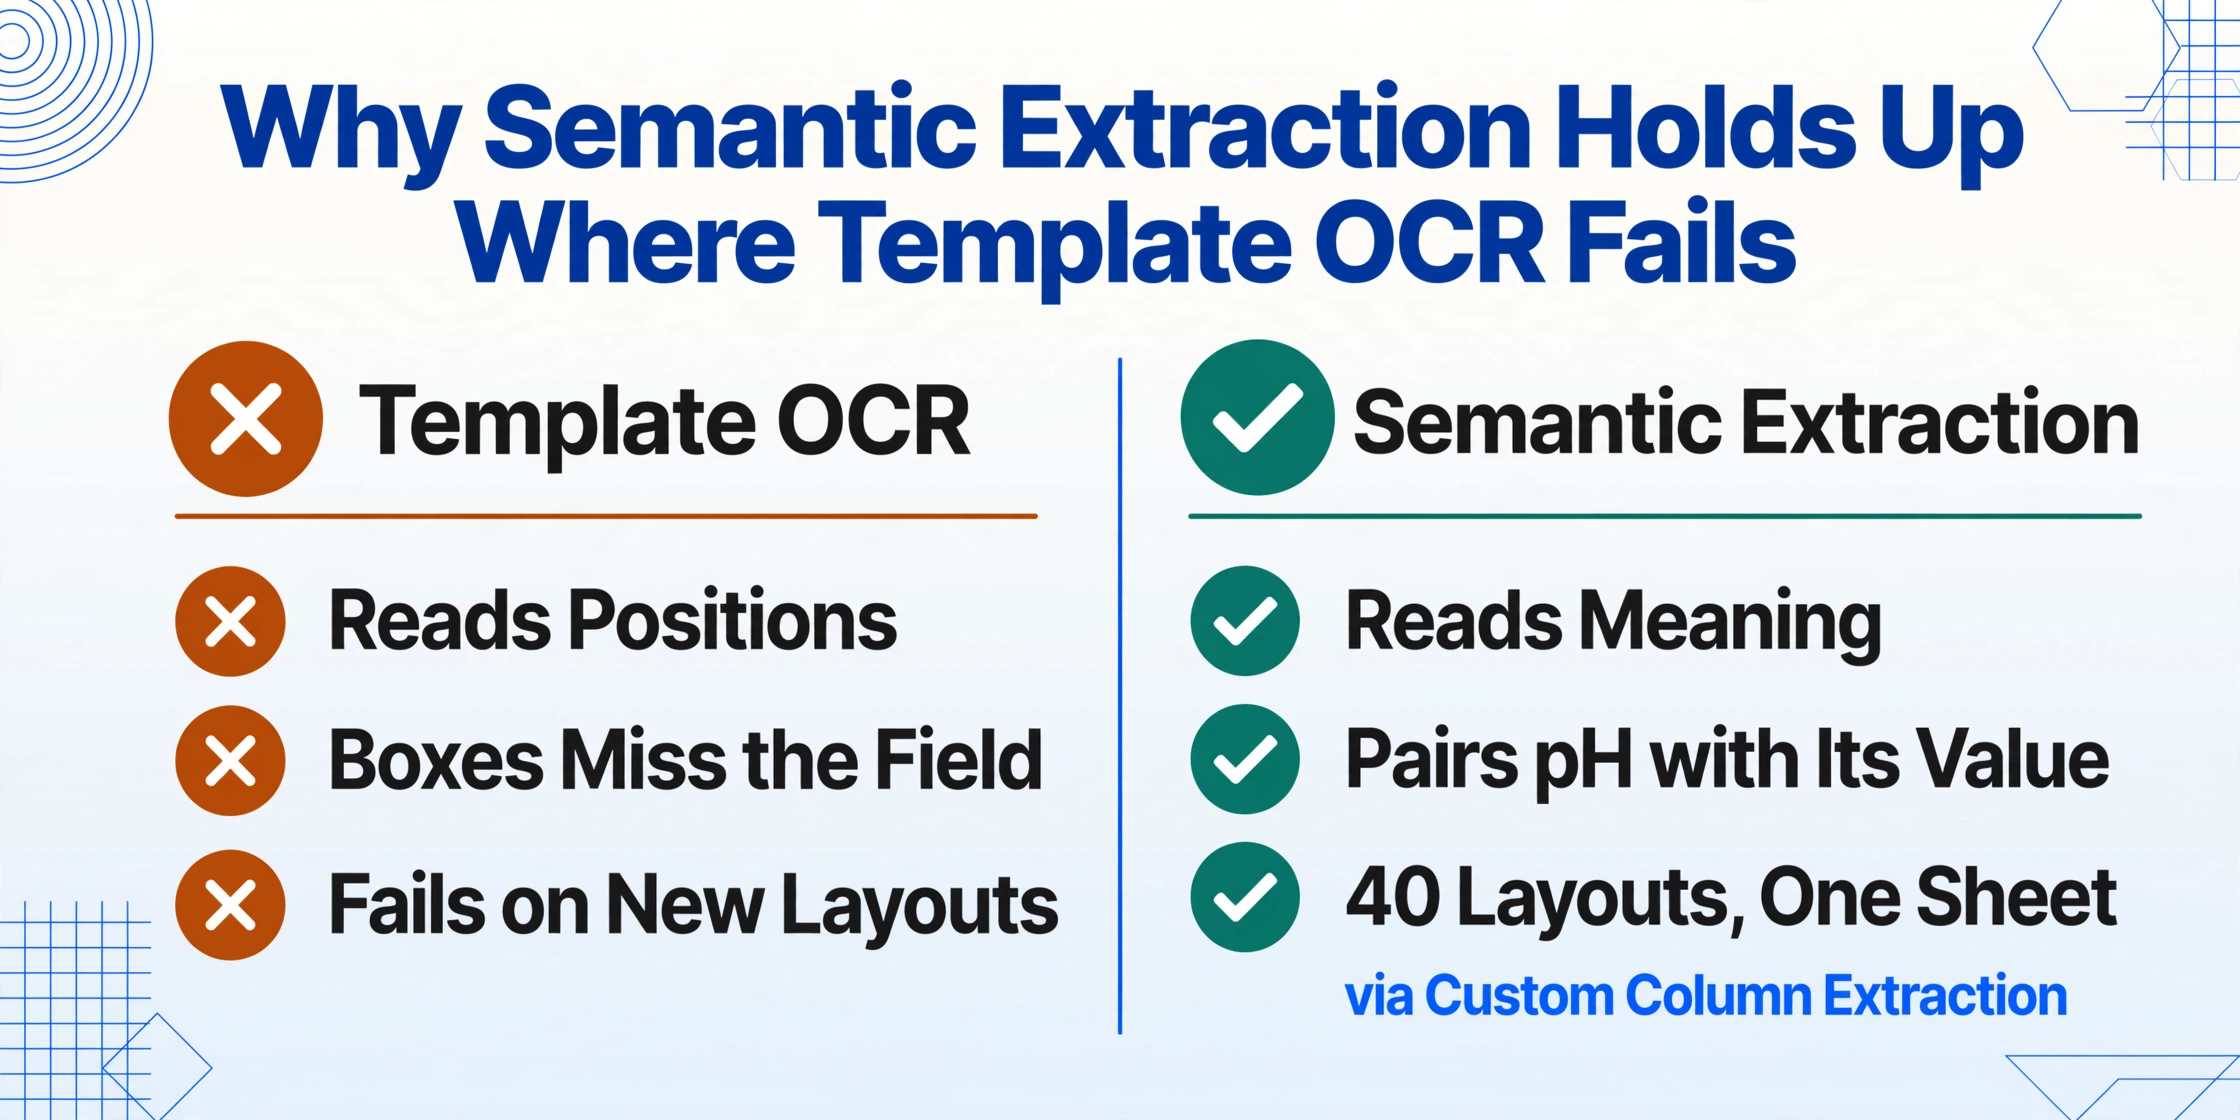
L'OCR par modèle lit les positions ; l'extraction sémantique lit le sens — et sur les formulaires de terrain, les positions mentent.
L'OCR par modèle a bâti sa réputation sur les factures et formulaires qui arrivent de la même source avec la même mise en page à chaque fois : dessinez une zone sur un document de référence, extrayez ce qui tombe dans la zone, recommencez. Les formulaires de données de terrain violent cette hypothèse à chaque tournant — différentes équipes utilisent différentes mises en page, les stations ont différents modèles de journal de bord, un formulaire peut être scanné en paysage un cycle puis photographié en portrait le suivant. Lorsque la mise en page change, les zones ne s'alignent plus avec les champs, et la précision s'effondre même si l'écriture est parfaitement lisible.
L'extraction par modèle de vision contourne entièrement cette défaillance positionnelle. Le modèle lit la page entière, comprend que « pH » est une mesure et que la valeur à côté y répond, et renvoie l'association où que se trouve la paire. C'est le mécanisme derrière Custom Column Extraction décrit ci-dessus, et c'est aussi pourquoi un lot de 40 formulaires avec 40 mises en page différentes produit toujours une seule feuille de calcul propre. Les directives de l'ITRC reconnaissent le même principe du côté des données — les données de terrain « méritent souvent une vigilance accrue en raison d'une probabilité accrue d'erreurs, comme la transcription ou la dérive de l'instrument in situ » — car les erreurs dans les données de terrain sont plus souvent sémantiques (mauvaise valeur pour un mauvais contexte) que positionnelles. Un outil qui comprend le contexte répond à la bonne question.
C'est l'endroit honnête pour préciser ce que l'extraction sémantique ne peut pas corriger : une écriture illisible, une valeur barrée d'un trait de stylo que le modèle interprète à tort comme faisant partie du nombre, ou une page où la pluie a transformé l'encre en aquarelle. Aucun outil — humain ou machine — ne récupère des données que le document source ne contient plus. Ce que l'extraction change, c'est le profil d'erreur : elle déplace la défaillance de milliers de frappes où les erreurs se cachent invisiblement, vers une poignée de cellules signalées qu'un humain peut vérifier. Pour un examen plus approfondi des modes de défaillance d'écriture restants, notre analyse des modes de défaillance d'extraction d'écriture manuscrite les catalogue en détail.
Vérifiez ce qui compte, pas tout
Parce qu'aucune extraction n'est fiable à 100 %, la question qui détermine si l'extraction de données de terrain fonctionne est de savoir où vous ciblez votre vérification — et la réponse est les mêmes champs que votre cadre de conformité surveille déjà. Le Quality Assurance Handbook for Air Pollution Measurement Systems (EPA-600/R-94/038a) de l'EPA et les programmes environnementaux qui le suivent définissent la vérification des données comme incluant le contrôle que « les données ont été transcrites et enregistrées avec précision » et que les enregistrements électroniques et papier montrent une correspondance un à un. La règle de tenue de registres 29 CFR 1904 de l'OSHA exige le rapport d'incident OSHA Form 301 dans les sept jours suivant une blessure enregistrable — une échéance qui fait de la vitesse d'extraction une fonctionnalité de conformité, et de la précision des détails transcrits une exigence de conformité. La norme de gestion des nutriments NRCS 590 de l'USDA conditionne l'éligibilité au partage des coûts aux procédures d'échantillonnage et d'analyse des sols conformes à la norme — y compris les enregistrements prouvant que les échantillons ont été manipulés correctement.
Tous les trois cadres convergent vers le même besoin opérationnel : un moyen de confirmer que les valeurs de la base de données correspondent aux valeurs des formulaires sources, sans relire chaque ligne à l'œil. C'est cette lacune que la vérification assistée par cadre de délimitation comble. Dans l'écran de révision d'ImageToTable.ai, survoler n'importe quelle cellule extraite met en évidence la région exacte de l'image d'origine d'où provient cette valeur — et cliquer sur une région de l'image ramène à la cellule correspondante. Au lieu de ressaisir pour vérifier, un réviseur confirme les quelques cellules que l'IA a signalées comme incertaines, et le reste est considéré comme fiable. Cela transforme « tout vérifier » (ce qui rend la transcription manuelle lente) en « vérifier les 10 % risqués » (ce qui prend quelques secondes par formulaire).
Le flux de travail réaliste est : traiter le lot, scanner les lignes extraites par rapport aux originaux avec la mise en évidence par cadre de délimitation, corriger les cellules signalées, et exporter. Le même schéma s'applique aux journaux de maintenance et aux enregistrements d'inspection d'autres opérations de terrain — le flux de travail de journal de maintenance vers Excel montre la même boucle capture-révision-export dans un contexte industriel, et notre analyse des points de rupture des pipelines de données de terrain explique pourquoi l'étape de vérification est là où la plupart des systèmes manuels échouent silencieusement.
FAQ
L'extraction peut-elle lire des formulaires endommagés par la pluie ou tachés d'eau ?
Cela dépend de la quantité d'écriture qui a survécu à la pluie. Les taches légères autour d'un texte lisible sont généralement bien gérées ; l'encre qui a coulé ou s'est estompée jusqu'à devenir illisible n'est récupérable par aucun outil, humain ou machine. La solution pratique réside dans le moment de la capture : photographiez les formulaires le jour où ils sont remplis, pendant que l'écriture est encore intacte, plutôt qu'après une semaine sur le terrain. Pour les formulaires qui doivent être stockés sur le terrain, le papier résistant aux intempéries et l'encre indélébile (l'astuce des équipes de terrain pour écrire sous la pluie) préservent le document.
Et si l'écriture de mon équipe est rapide ou brouillonne ?
La plupart des écritures de terrain sont en lettres capitales et s'extraient bien. Le seuil de précision d'extraction est l'écriture cursive rapide et les chiffres ambigus (3 vs 8, 1 vs 7). Deux choses aident : concevoir des formulaires qui minimisent l'écriture libre (codes, cases à cocher, une valeur par case — l'approche des symboles de plantes du NRCS), et utiliser l'étape de vérification pour contrôler exactement les cellules que l'IA signale comme incertaines, en utilisant la vérification assistée par cadre de délimitation sur l'image d'origine.
L'extraction gère-t-elle les cases à cocher, les options encerclées et les signatures ?
Oui. Les modèles de vision lisent les cases cochées, les options encerclées et les signatures manuscrites comme des éléments visuels, pas seulement du texte. Pour les champs où les membres de l'équipe encerclent ou cochent une option plutôt que d'écrire une valeur, définissez la colonne avec les options écrites en toutes lettres — Pression des ravageurs (options : Faible / Moyenne / Élevée) — afin que le modèle associe la marque à la bonne étiquette.
Une photo de téléphone suffit-elle, ou ai-je besoin d'un scanner ?
Une photo de téléphone plate et bien éclairée suffit pour la plupart des formulaires de terrain — le mode de numérisation de documents des téléphones modernes corrige automatiquement la perspective et les ombres. La qualité de la capture fait varier la précision de 10 à 20 points de pourcentage, donc les habitudes comptent plus que le matériel : surface plane, appareil photo parallèle, page entière dans le cadre, pas de reflets. Un scanner ne l'emporte que lorsque le formulaire est déjà propre et que vous en avez un à proximité.
Nos stations utilisent des formulaires aux formats différents. L'extraction fonctionnera-t-elle quand même ?
Oui — c'est précisément le cas qui fait échouer l'OCR par modèle. Parce qu'ImageToTable.ai localise les valeurs par leur sens plutôt que par leur position sur la page, un lot mélangeant différents formats, orientations et styles d'écriture renvoie toujours les mêmes colonnes nommées. Vous ne maintenez pas de modèle par format ; vous nommez les colonnes une fois et le modèle trouve les valeurs.
Quelle précision dois-je réellement attendre ?
Le texte imprimé des formulaires s'extrait à près de 99 % ; l'écriture manuscrite en lettres capitales lisibles s'extrait bien ; la cursive rapide tombe dans les 70 % — la même fourchette que les humains lorsqu'ils retranscrivent à la main, avec des taux d'erreur documentés de 1 à 10 % selon les études. Attendez-vous au meilleur résultat sur des formulaires propres, bien capturés et bien conçus, et prévoyez de vérifier les 10 % de cellules les plus risquées sur les formulaires endommagés ou brouillons. Tout outil qui promet 100 % sur des données de terrain ne vous dit pas la vérité sur vos intrants.
La précision sur les formulaires de terrain n'est pas une propriété du modèle d'IA — c'est une propriété de toute la chaîne : le papier, le stylo, la conception, la photo et l'étape de vérification. Chaque maillon est un élément que vous pouvez contrôler.
En travaillant la chaîne dans l'ordre, le résultat devient prévisible : concevez des formulaires qui exigent moins d'écriture, capturez-les tant qu'ils sont lisibles, traitez par lots avec un outil qui lit le sens plutôt que la position, et vérifiez les cellules risquées au lieu de tout ressaisir. C'est ainsi qu'un journal de qualité de l'eau écrit sous la pluie devient un jeu de données prêt pour la conformité — et qu'un formulaire d'échantillon de sol rempli en fin de journée conserve ses chiffres intacts jusqu'à la base de données. La boue a toujours fait partie du travail. Faire en sorte qu'elle ne vous coûte plus de données, c'est ce que gère l'extraction — testez-la sur un formulaire qui a réellement été sur le terrain.