Precisión de extracción de formularios de datos de campo:
Clima, escritura a mano y diseño de formularios
La precisión de extracción de formularios de datos de campo se decide mucho antes de que el archivo llegue a una herramienta de extracción: se decide en la tabla de campo, bajo la lluvia, por la persona que sostiene el bolígrafo. Un técnico ambiental en un hilo de r/Environmental_Careers lo expresó en términos que cualquiera que haya caminado por un humedal conoce: "Si no hay barro en sus formularios de datos, ¿realmente delineó el humedal?" Ese barro no es solo autenticidad: es el mayor predictor de si un conteo de plagas, una lectura de pH o un hallazgo de seguridad saldrán bien al otro lado. Este artículo mapea cada factor que se interpone entre un formulario en el campo y una fila confiable en su base de datos, y marca cuáles de ellos puede controlar realmente.
Conclusiones clave
- Los problemas de precisión en los formularios de campo casi nunca son culpa de la herramienta de extracción: se deciden en la tabla de campo, bajo la lluvia, por la persona que sostiene el bolígrafo, mucho antes de que el archivo llegue a cualquier software.
- Las mismas condiciones que dificultan la lectura de un formulario para la IA también lo dificultan para los humanos: las tasas de error documentadas de transcripción manual (escribir a mano lo que está en un formulario en una base de datos) oscilan entre 1 y 10%, y solo la calidad de captura varía los resultados de extracción en 10 a 20 puntos porcentuales.
- Deje de buscar una mejor herramienta de extracción: su verdadera palanca es la cadena: diseñe formularios con códigos en lugar de texto libre, fotográfielos el día de la recolección, y verifique solo el 10% de las celdas que la IA marca como inciertas en lugar de volver a escribir todo.
Incluso la Transcripción Perfecta Comienza en Desventaja
Antes de que intervenga cualquier software, el acto de copiar datos de campo manualmente ya pierde un porcentaje medible de ellos — y los datos de campo, recopilados con guantes y viento, se pierden más que los datos de oficina.
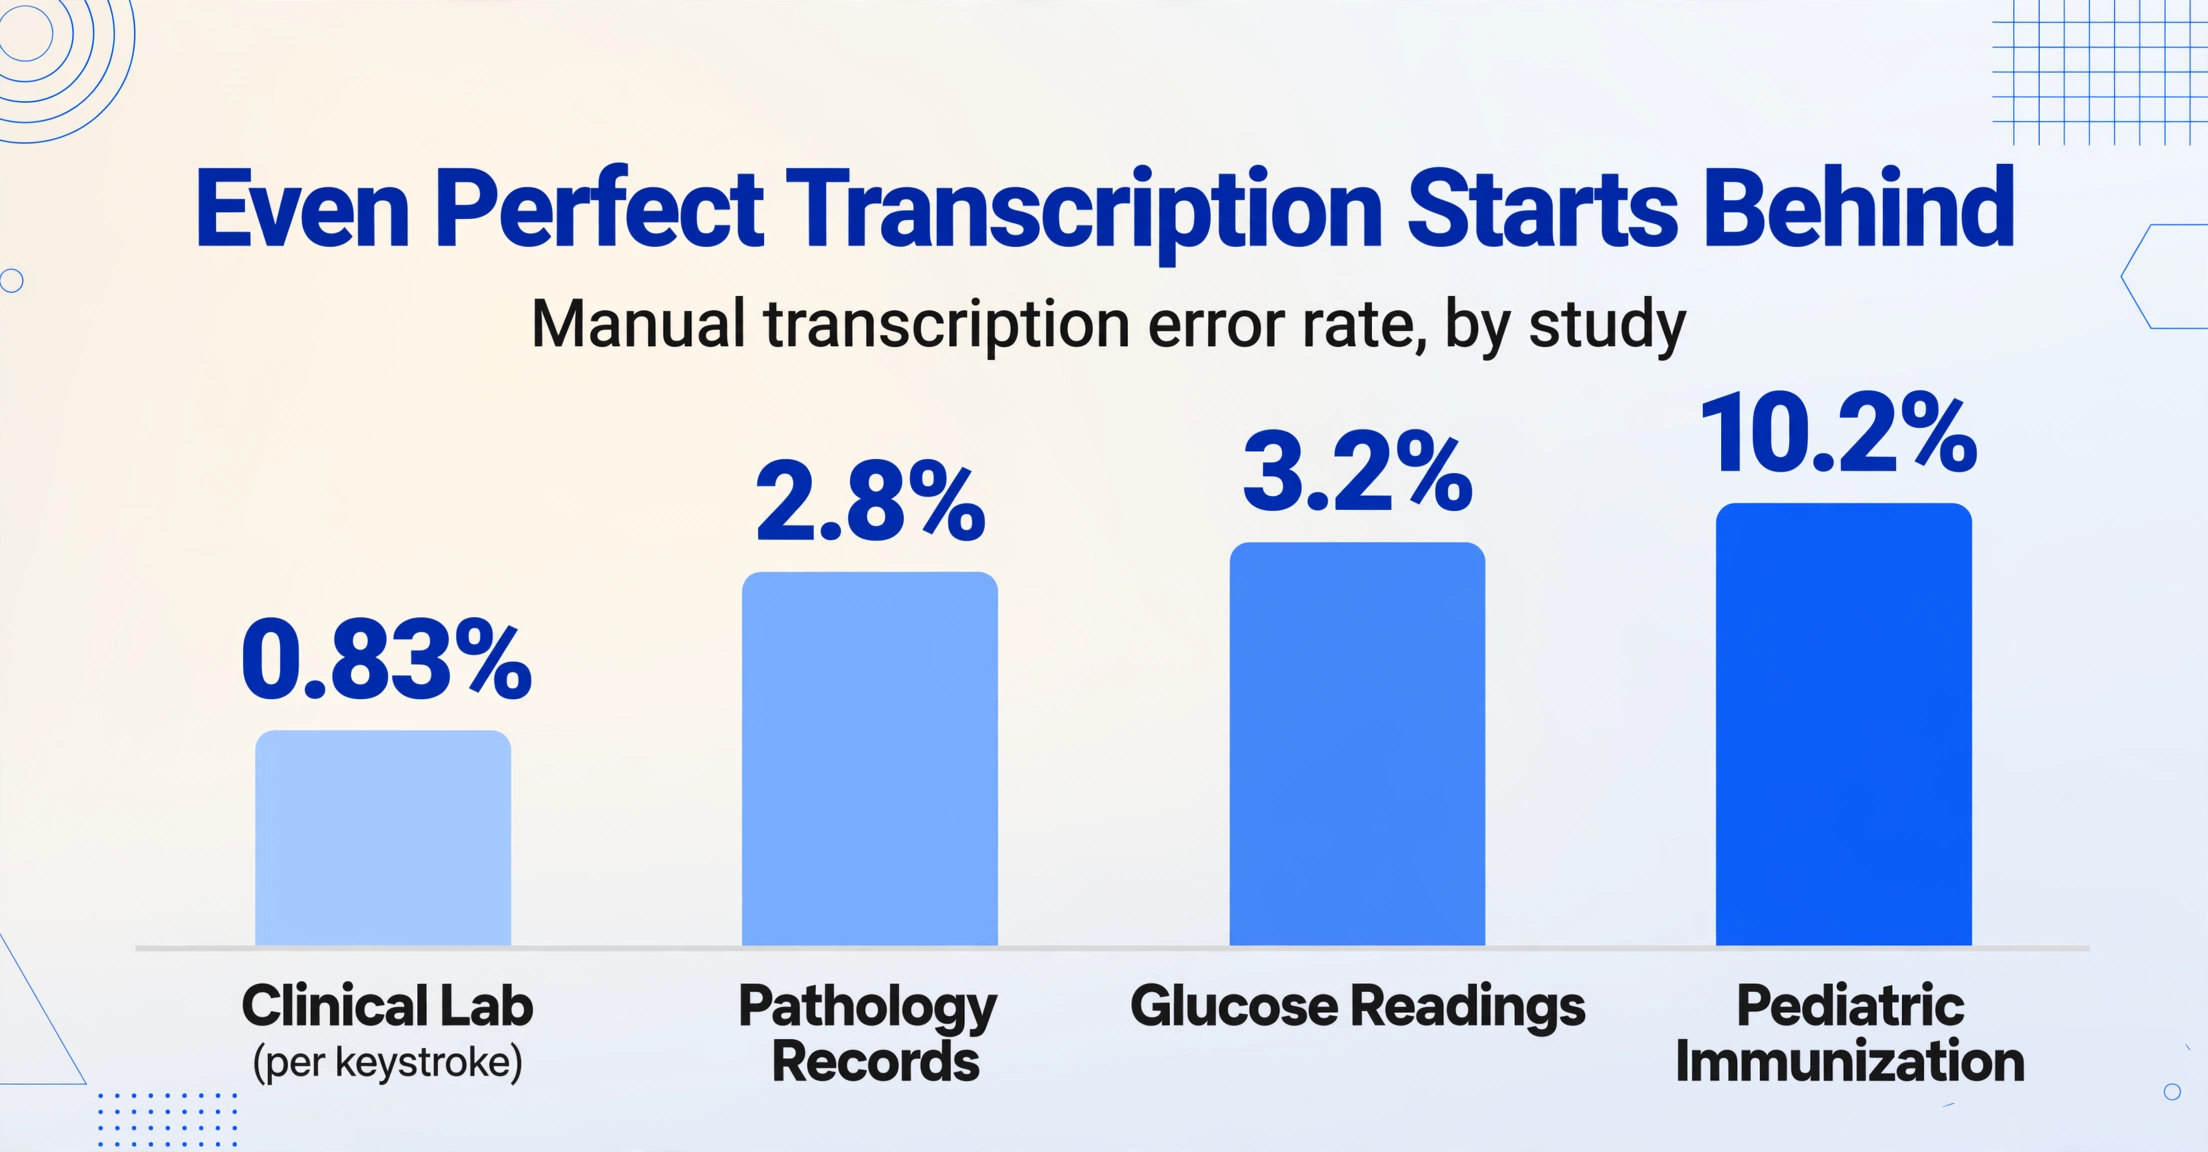
Los estudios sobre errores de transcripción manual en entornos médicos y de registros, resumidos en una revisión revisada por pares publicada en el archivo PMC de NCBI, encontraron tasas de error que abarcan un orden de magnitud: 0.83% por pulsación de tecla en un laboratorio clínico, 2.8% en general en un estudio de registros de patología (con un rango de 0.5–6.4% según el campo), 3.2% para lecturas de glucosa en el punto de atención, y 10.2% en un conjunto de datos de inmunización pediátrica. El hilo común es que incluso personas motivadas y capacitadas cometen errores de un solo dígito bajo al mover valores entre medios — y los errores se concentran precisamente en los campos numéricos de los que depende el trabajo de campo: dígitos transpuestos en el pH, la identificación de muestra incorrecta en un compuesto, un nivel de agua que cae en la columna del vecino.
Esa es la línea de base. El software de extracción no compite contra la transcripción perfecta, sino contra esta línea de base defectuosa y a velocidad humana — por eso "¿es precisa la IA?" es la pregunta equivocada. La pregunta correcta es "¿precisa en comparación con qué, y sobre qué entradas?" El espectro de precisión campo por campo que mapeamos por separado muestra el mismo fenómeno desde el lado de la herramienta: texto impreso cerca del 99%, cursiva cerca del 70%, casillas de verificación en algún punto intermedio — una diferencia de 25 puntos en un solo formulario. La diferencia es donde viven los formularios de campo, porque todo lo que hace difícil leer un formulario también lo hace difícil de transcribir, ya sean manos humanas o máquinas las que lean.
Lluvia, barro y sol: el campo reescribe el formulario
El daño físico al papel es el primer factor de precisión, y también el que menos esperan los equipos de campo que importe, porque dejan de verlo. Un técnico que ha llevado un cuaderno de registro toda la temporada ya no nota la mancha de agua en la columna de conductividad, el pliegue donde se dobló la hoja para guardarla en el bolsillo trasero, o la tinta que el sol desvaneció hasta un gris tenue. Cada uno de estos degrada la señal visual que lee el modelo de extracción — de la misma manera que degrada la señal que leería un supervisor al revisar el formulario en la oficina.
Los equipos de campo tienen sus propios trucos que revelan cuán real es el problema. En el mismo hilo de r/Environmental_Careers, un comentarista compartió la solución clásica: "Truco de campo: compren papel resistente al agua de hojas sueltas e impriman los formularios en él. ¡Vale la pena el costo!" El papel resistente a la intemperie, los bolígrafos de tinta indeleble y las tablillas con tapa existen porque el agua, el barro y el sol destruyen de forma confiable los registros de campo. Cuando esos registros sobreviven, llegan a la oficina con el clima aún escrito en ellos — y esa es la entrada que recibe un pipeline de extracción.
Lo que usted controla aquí: fotografie o escanee el formulario mientras aún sea legible — el día en que se llena, no el día en que llega a la oficina. Los formularios fotografiados en el momento del registro capturan la escritura antes de que una semana en la cabina del camión la desvanezca. Cuando eso no sea posible, trate los formularios visiblemente dañados como un lote separado y más pequeño, y espere verificarlos con mayor detenimiento (más sobre verificación abajo).
Las copias carbón y los formularios duplicados añaden una segunda capa de daño: la calidad de impresión en la segunda y tercera copias se degrada notablemente, y si los miembros del equipo llenan ambas copias a la vez, la presión puede hacer que la escritura de la hoja superior sea superficial. La extracción trata una copia carbón tenue como lo haría una persona — la lee, duda y puede malinterpretarla. La misma lógica aplica al lápiz: borrable y legible para quien escribe, tenue y propenso a mancharse para cualquiera que lo lea después.
Escritura a Mano de una Persona Cansada con Guantes
La calidad de la escritura a mano varía más en una tarde que entre dos herramientas de extracción: el undécimo formulario del día de un trabajador de campo es notablemente menos legible que el primero. La investigación sobre reconocimiento de escritura trata la legibilidad como una propiedad del escritor, pero en el trabajo de campo es una propiedad de las condiciones: dedos fríos, guantes mojados, un portapapeles equilibrado sobre el capó de una camioneta, la presión de pasar a la siguiente estación. Los técnicos de campo en Reddit describen la disyuntiva con precisión — "En el campo, es mucho más rápido escribir un número en un formulario de papel que desbloquear el iPad, abrir la aplicación y escribir el número" — razón por la cual el papel sobrevive en la era digital, y por la cual el papel que produce es exactamente lo que la extracción debe manejar.
La buena noticia es que la mayoría de la escritura de campo es en letra de molde o imprenta, que la extracción maneja con alta precisión; el precipicio de precisión se encuentra en la cursiva apresurada y en los dígitos escritos tan rápido que 3 y 8, o 1 y 7, se difuminan. Un formulario mixto — etiquetas impresas, valores manuscritos en bloque, una opción marcada con círculo, una firma — es un caso normal, y los modelos de visión modernos leen la mezcla de manera holística en lugar de requerir un estilo consistente por página.
Existe una respuesta institucional a esto que precede a la IA, y vale la pena adoptarla. El Field Book for Describing and Sampling Soils (Versión 4.0, 2024) del USDA NRCS instruye a los científicos del suelo a registrar especies de plantas como códigos de símbolos estandarizados — el pasto varilla se convierte en "ANGE," un código de cuatro caracteres de la lista oficial de plantas — en lugar de escribir nombres que varían en ortografía y longitud. La idea de diseño se transfiere directamente: cuanto menos escritura a mano libre exija el formulario, menos espacio hay para que la escritura misma se convierta en una fuente de error. Los códigos, las casillas de verificación y los números son más legibles para las máquinas por la misma razón que son más legibles para humanos cansados. Nuestra guía de mejora de precisión de escritura a mano profundiza en qué hace que la escritura de un formulario sea extraíble y la de otro no.
El diseño del formulario es la palanca de precisión de la que nadie habla
El diseño del formulario determina la precisión de extracción más que cualquier truco de captura, porque decide lo que el modelo de extracción tiene que interpretar en primer lugar. La guía de gestión de datos ambientales publicada por el Consejo Interestatal de Tecnología y Regulación (ITRC) lo plantea desde el lado del registro: "Diseñe una respuesta de formulario de datos de campo con conocimiento del tipo de dato esperado y la longitud del campo de la base de datos donde residirá". Un formulario diseñado pensando en su base de datos de destino — un valor por casilla, unidades impresas junto a la casilla, sin texto libre multilínea cuando un código es suficiente — produce filas que llegan a las columnas correctas con una interpretación mínima. Un formulario diseñado por conveniencia genera ambigüedad que ningún modelo de extracción puede resolver por completo.
Cuatro decisiones de diseño aparecen una y otra vez en los formularios de datos de campo, y cada una se asocia con un comportamiento de precisión conocido:
| Decisión de diseño | Por qué es un problema | La versión favorable a la precisión |
|---|---|---|
| Espacios en blanco abiertos para todo | Los campos de formato libre invitan a abreviaturas, siglas y confusión de unidades: quien escribe asume un contexto que quien lee no tendrá | Casillas de verificación para opciones conocidas; unidades impresas en la etiqueta ("pH (unidades)"), códigos para valores recurrentes |
| Líneas de guía que atraviesan las áreas de valor | Las líneas de cuadrícula que cruzan el texto crean ruido visual que compite con los caracteres | Espacios separados o líneas de guía claras que se detienen antes de la zona de escritura |
| Alta densidad: todo en una sola página | Los campos apretados empujan la escritura contra etiquetas y bordes; los valores se mezclan entre sí | Un valor por casilla con separación clara; una segunda página es mejor que una primera abarrotada |
| Orientación mixta dentro de un lote | Las páginas horizontales y verticales en el mismo lote requieren cada una su propia ruta de lectura | Una orientación por lote cuando sea posible; si es mixta, la herramienta debe localizar los campos por significado, no por posición |
La última fila importa porque es donde divergen los enfoques de extracción. El OCR con plantilla fija cada campo a una coordenada en un formulario de referencia: gire el formulario, cambie el diseño, añada la plantilla de bitácora diferente de una estación, y las casillas dejan de coincidir. El enfoque semántico que usa ImageToTable.ai, Custom Column Extraction, invierte eso: usted escribe los nombres de las columnas que desea ("pH", "Conteo de plagas", "ID de estación"), y la IA localiza el valor que responde a cada nombre en cualquier parte de la página, por significado y no por posición. Un lote de formularios de datos de campo con diseños diferentes, caligrafías diferentes y niveles de deterioro diferentes sigue devolviendo las mismas columnas nombradas, porque el modelo lee el documento como lo haría una persona: no exige que el campo esté en una coordenada memorizada.
Captura: una foto es la mitad de la precisión
Entre dos fotos del mismo formulario, la calidad de captura por sí sola representa una variación de precisión de 10 a 20 puntos porcentuales, una cifra que nuestras propias pruebas de precisión de formularios reproducen de manera consistente. La mayor parte de esa variación proviene de cuatro hábitos sencillos: colocar el formulario plano sobre una superficie sólida, evitar reflejos y contraluz, mantener el teléfono paralelo a la página y capturar toda la página, incluidos los identificadores del encabezado. Los modos de escaneo de documentos de las cámaras de los teléfonos automatizan gran parte de esto (corrección de perspectiva, aplanado y eliminación de sombras están integrados en cualquier teléfono moderno), pero solo ayudan si el técnico de campo los activa.
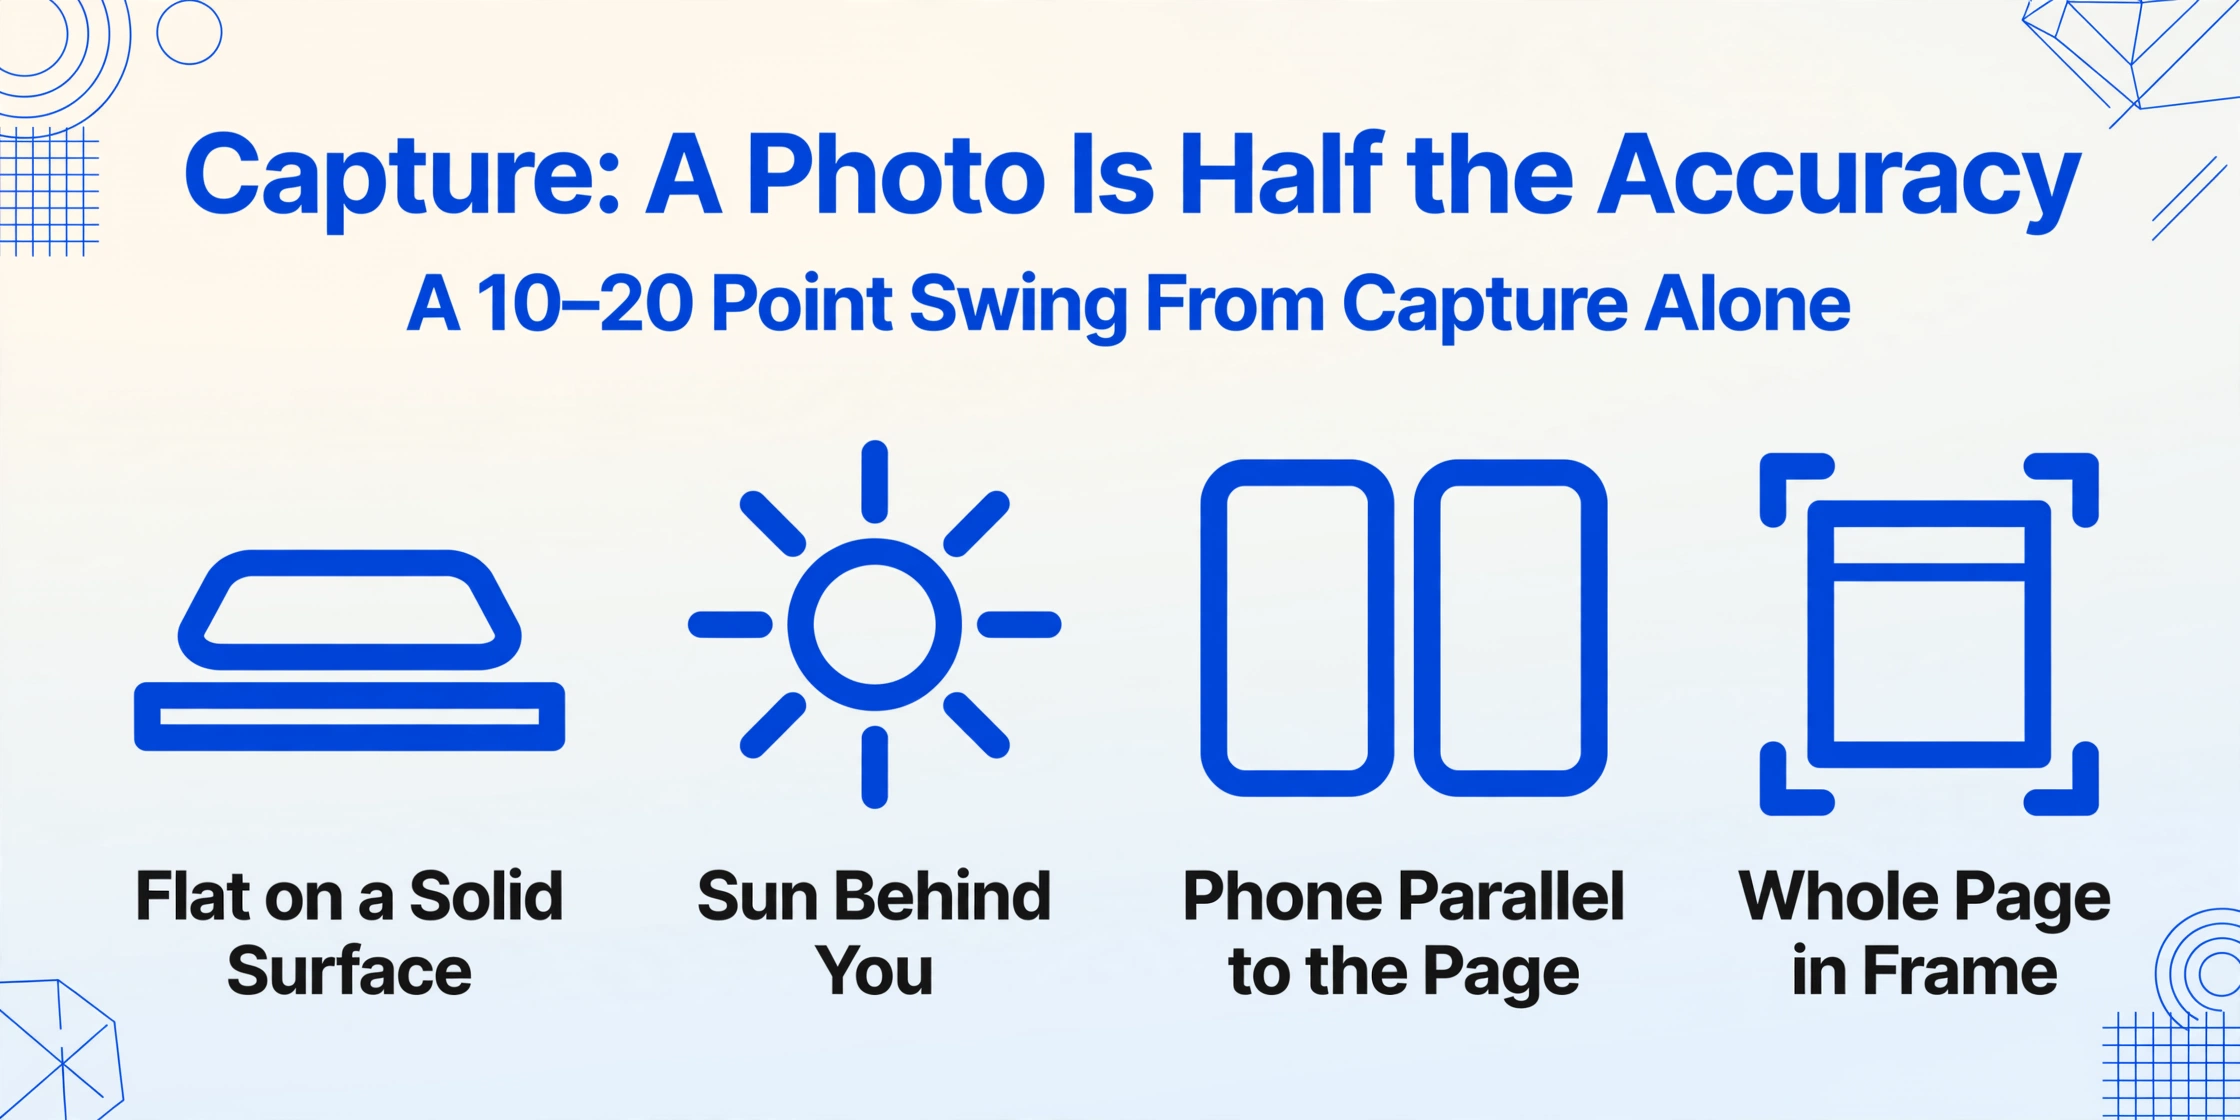
La captura en exteriores tiene sus propios modos de falla. La luz solar directa que apaga la página y la sombra del propio fotógrafo cayendo sobre la escritura son los dos más comunes, y ambos se corrigen con el mismo movimiento: girar para que el sol quede detrás del fotógrafo, o usar la propia sombra para dar sombra a la página. El técnico en el hilo de Reddit que describió los formularios digitales como "difíciles de leer bajo luz solar intensa" estaba describiendo la misma física que subexpone un formulario de papel sostenido contra un cielo brillante, excepto que un formulario de papel puede sombrearse, inclinarse o moverse, y una foto captura solo lo que la cámara vio.
La resolución importa menos de lo que la gente supone, más allá de un umbral modesto: una foto de teléfono de un formulario tamaño carta suele tener entre 2,000 y 3,000 píxeles de ancho, más que suficiente, pero el tipo de captura importa: un escaneo plano y bien iluminado de un formulario limpio es el mejor caso; una foto del mismo formulario tomada en la camioneta al anochecer es el peor caso, y ambos pueden estar en el mismo lote. Si las fotos de su equipo permanecen en la camioneta durante una semana, el patrón de Enlace de Recopilación que describimos en nuestra guía de flujo de trabajo de formularios de campo a Excel — un enlace compartible que permite al equipo subir fotos directamente a su cola de procesamiento — acorta esa brecha y limita cuánto se degradan los formularios antes de la captura.
Por qué la extracción semántica se mantiene donde el OCR con plantilla falla
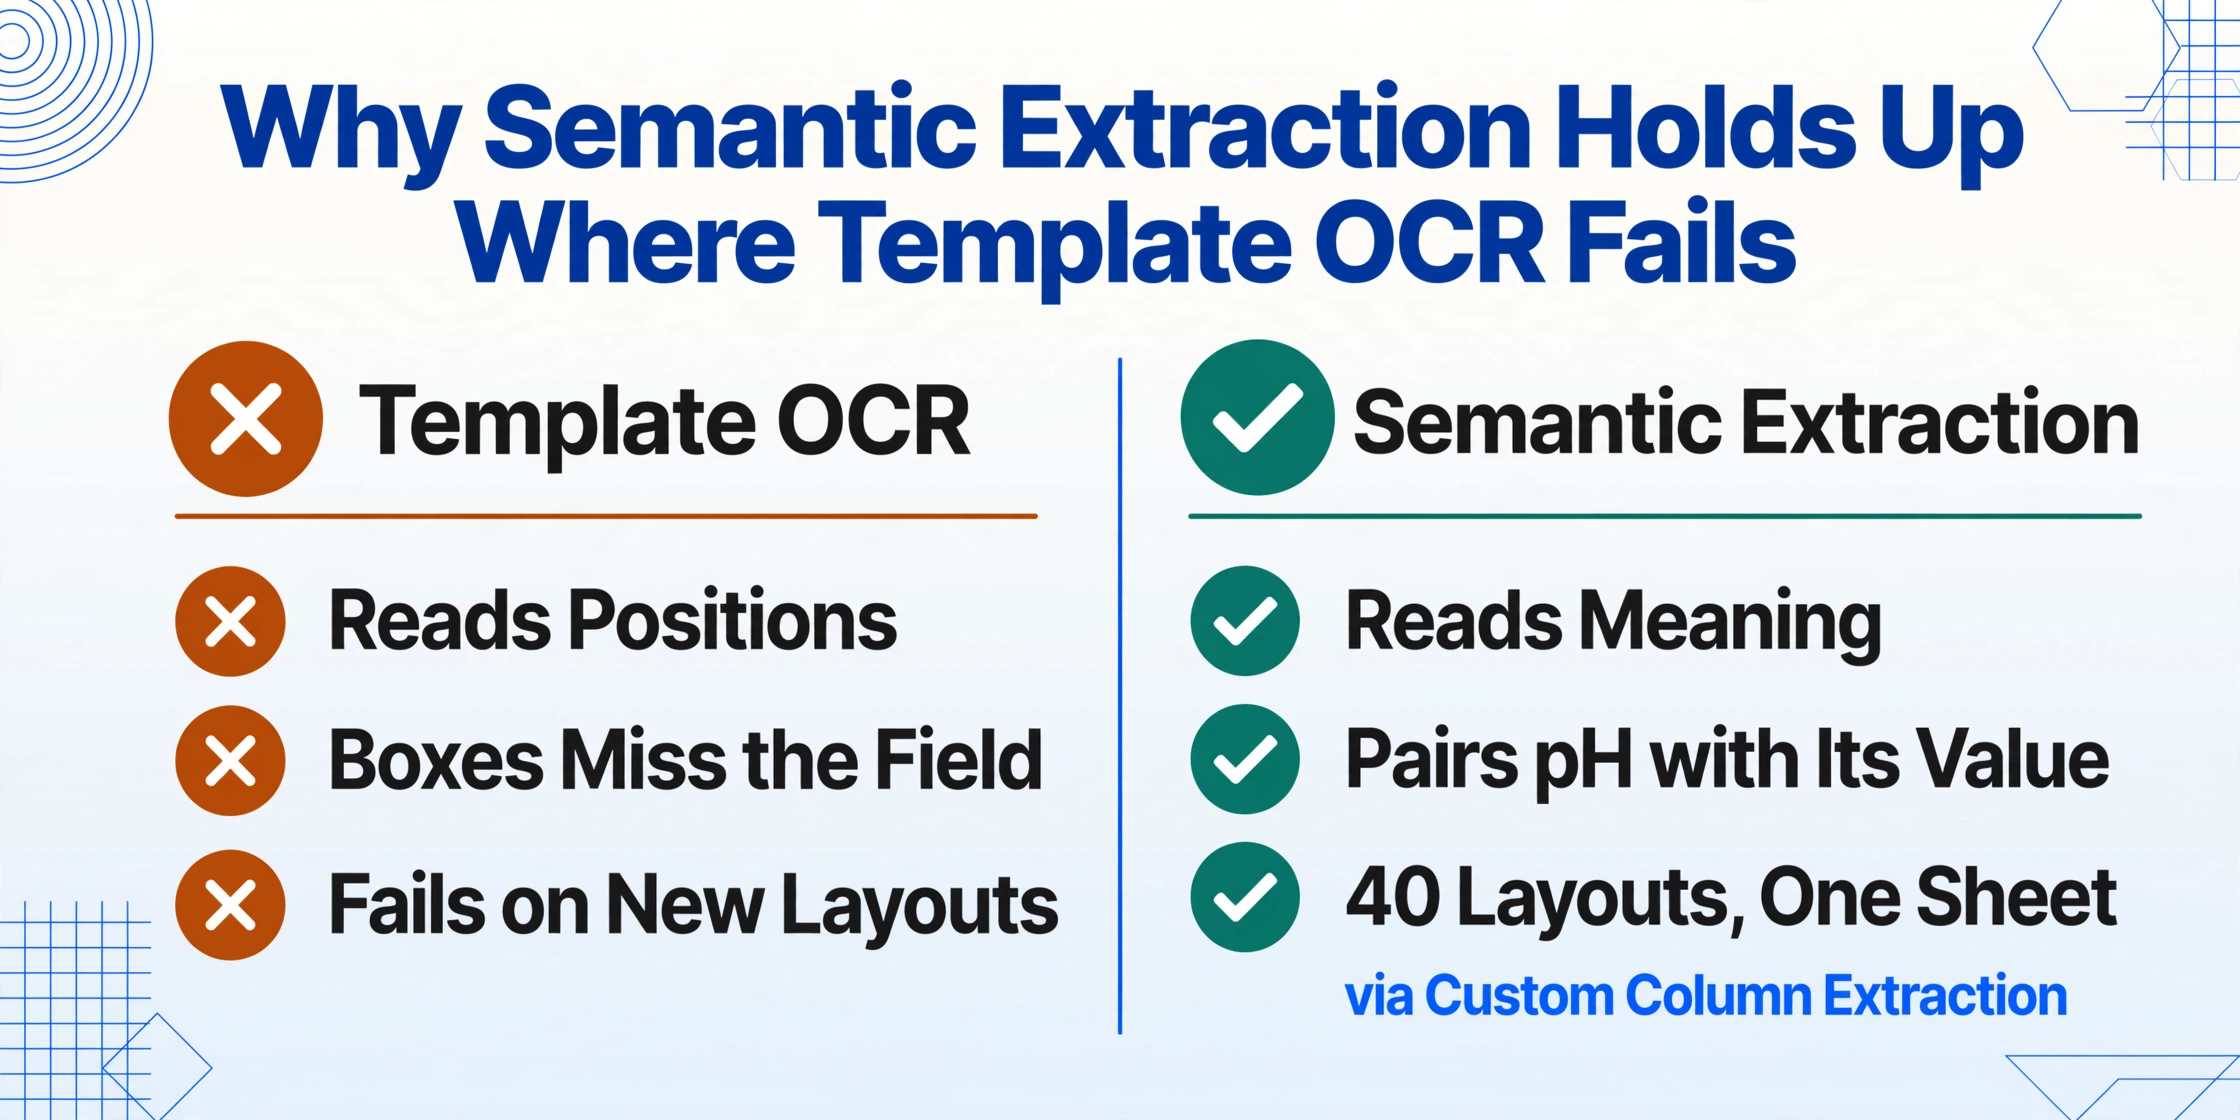
El OCR con plantilla lee posiciones; la extracción semántica lee significado — y en los formularios de campo, las posiciones mienten.
El OCR con plantilla se ganó su reputación en facturas y formularios que llegan de la misma fuente con el mismo diseño cada vez: dibuje un cuadro en un documento de referencia, extraiga lo que caiga dentro del cuadro, repita. Los formularios de datos de campo violan esa suposición en cada paso — diferentes cuadrillas usan diferentes diseños, las estaciones tienen diferentes plantillas de cuaderno de registro, un formulario puede escanearse en horizontal una ronda y fotografiarse en vertical la siguiente. Cuando el diseño cambia, los cuadros ya no se alinean con los campos, y la precisión se desploma aunque la escritura sea perfectamente legible.
La extracción con modelo de visión evita por completo el fallo posicional. El modelo lee la página completa, entiende que "pH" es una medición y que el valor a su lado la responde, y devuelve el emparejamiento sin importar dónde se encuentre el par. Ese es el mecanismo detrás de la Custom Column Extraction descrita anteriormente, y también es la razón por la que un lote de 40 formularios con 40 diseños diferentes sigue produciendo una hoja de cálculo limpia. La guía del ITRC reconoce el mismo principio desde el lado de los datos — los datos de campo "a menudo merecen un escrutinio adicional debido a la mayor probabilidad de errores, como los de transcripción o la deriva del instrumento in situ" — porque los errores en los datos de campo son semánticos (valor incorrecto para el contexto incorrecto) más a menudo que posicionales. Una herramienta que entiende el contexto está respondiendo a la pregunta correcta.
Este es el lugar honesto para declarar lo que la extracción semántica no puede arreglar: escritura ilegible, un valor tachado con un trazo de bolígrafo que el modelo malinterpreta como parte del número, o una página donde la lluvia ha convertido la tinta en acuarela. Ninguna herramienta — humana o máquina — recupera datos que el documento fuente ya no contiene. Lo que cambia la extracción es el perfil de error: mueve el fallo de miles de pulsaciones de teclas donde los errores se ocultan invisiblemente, a un puñado de celdas marcadas donde un humano puede revisarlas. Para un análisis más profundo de los modos de fallo restantes de la escritura a mano, nuestro análisis de modos de fallo de extracción de escritura a mano los cataloga en detalle.
Verifique lo que importa, no todo
Debido a que ninguna extracción es 100% precisa, la pregunta que determina si la extracción de datos de campo funciona es hacia dónde dirige su verificación — y la respuesta son los mismos campos que su marco de cumplimiento ya considera importantes. El Manual de Garantía de Calidad para Sistemas de Medición de Contaminación del Aire de la EPA (EPA-600/R-94/038a) y los programas ambientales que lo siguen definen la verificación de datos para incluir la comprobación de que "los datos se han transcrito y registrado con precisión" y que los registros electrónicos y en papel muestran una correspondencia uno a uno. La regla de mantenimiento de registros 29 CFR 1904 de OSHA exige el informe de incidentes del Formulario 301 de OSHA dentro de los siete días posteriores a una lesión registrable — un plazo que convierte la velocidad de extracción en una característica de cumplimiento, y la precisión de los detalles transcritos en un requisito de cumplimiento. El Estándar de Manejo de Nutrientes NRCS 590 del USDA condiciona la elegibilidad para el costo compartido a los procedimientos de muestreo y análisis de suelos que sigan el estándar — incluidos los registros que demuestran que las muestras se manejaron correctamente.
Los tres marcos convergen en la misma necesidad operativa: una forma de confirmar que los valores en la base de datos coinciden con los valores en los formularios de origen, sin volver a leer cada fila manualmente. Esa es la brecha que llena la verificación asistida por cuadro delimitador. En la pantalla de revisión de ImageToTable.ai, al pasar el cursor sobre cualquier celda extraída se resalta la región exacta de la imagen original de donde proviene ese valor — y al hacer clic en una región de la imagen se salta a la celda correspondiente. En lugar de volver a escribir para verificar, un revisor confirma las pocas celdas que la IA marcó como inciertas, y el resto se confía. Convierte "verificar todo" (que es por lo que la transcripción manual es lenta) en "verificar el 10% de riesgo" (que toma segundos por formulario).
El flujo de trabajo realista es: procesar el lote, escanear las filas extraídas contra los originales con resaltado de cuadro delimitador, corregir las celdas marcadas y exportar. El mismo patrón se aplica a los registros de mantenimiento y de inspección de otras operaciones de campo — el flujo de trabajo de registro de mantenimiento a Excel muestra el mismo ciclo de captura-revisión-exportación en un contexto industrial, y nuestro análisis de dónde fallan las tuberías de datos de campo explica por qué el paso de verificación es donde la mayoría de los sistemas manuales fallan silenciosamente.
Preguntas frecuentes
¿La extracción puede leer formularios dañados por la lluvia o con manchas de agua?
Depende de cuánta escritura haya sobrevivido a la lluvia. Las manchas tenues alrededor de texto legible generalmente se manejan bien; la tinta que se ha corrido o desvanecido hasta quedar ilegible no es recuperable por ninguna herramienta, humana o mecánica. La solución práctica es el momento de la captura: fotografíe los formularios el mismo día en que se llenan, mientras la escritura aún está intacta, en lugar de hacerlo después de una semana en el campo. Para formularios que deben almacenarse en el campo, el papel resistente a la intemperie y la tinta indeleble (el truco de escribir bajo la lluvia que comparten los equipos de campo) preservan el registro.
¿Qué pasa si la escritura de mi equipo es apresurada o desordenada?
La mayoría de la escritura de campo es en letra de molde y se extrae bien. El punto crítico de precisión es la escritura cursiva apresurada y los dígitos ambiguos (3 vs 8, 1 vs 7). Dos cosas ayudan: diseñar formularios que minimicen la escritura a mano libre (códigos, casillas de verificación, un valor por casilla — el enfoque de símbolos de plantas del NRCS), y usar el paso de verificación para revisar exactamente las celdas que la IA marca como inciertas, usando el resaltado de cuadro delimitador contra la imagen original.
¿La extracción maneja casillas de verificación, opciones circuladas y firmas?
Sí. Los modelos de visión leen casillas marcadas, opciones circuladas y firmas manuscritas como elementos visuales, no solo como texto. Para campos donde los miembros del equipo circulan o marcan una opción en lugar de escribir un valor, defina la columna con las opciones escritas — Pest Pressure (options: Low / Medium / High) — para que el modelo asigne la marca a la etiqueta correcta.
¿Es suficiente una foto de teléfono o necesito un escáner?
Una foto de teléfono plana y bien iluminada es suficiente para la mayoría de los formularios de campo — el modo de escaneo de documentos de los teléfonos modernos corrige la perspectiva y las sombras automáticamente. La calidad de captura varía la precisión en 10–20 puntos porcentuales, por lo que los hábitos importan más que el hardware: superficie plana, cámara paralela, página completa en el encuadre, sin reflejos. Un escáner solo gana cuando el formulario ya está limpio y tiene uno cerca.
Nuestras estaciones usan diferentes formatos de formularios. ¿La extracción seguirá funcionando?
Sí — este es el caso que precisamente rompe el OCR con plantilla. Como ImageToTable.ai localiza los valores por significado y no por posición en la página, un lote que mezcla diferentes formatos, orientaciones y estilos de escritura a mano sigue devolviendo las mismas columnas nombradas. No mantiene una plantilla por formato; usted nombra las columnas una vez y el modelo encuentra los valores.
¿Qué precisión debo esperar realmente?
El texto impreso de formularios se extrae cerca del 99%; la escritura en letra de molde legible se extrae bien; la escritura cursiva apresurada baja a los 70 — la misma variación que muestran los humanos al transcribir a mano, donde las tasas de error documentadas oscilan entre el 1 y el 10% según los estudios. Espere el mejor resultado en formularios limpios, bien capturados y bien diseñados, y espere verificar el peor 10% de las celdas en formularios dañados o desordenados. Cualquier herramienta que prometa 100% en datos de campo no está siendo honesta sobre sus entradas.
La precisión en formularios de campo no es una propiedad del modelo de IA — es una propiedad de toda la cadena: el papel, el bolígrafo, el diseño, la foto y el paso de verificación. Cada eslabón es uno que usted puede controlar.
Trabaje la cadena en orden y el resultado se vuelve predecible: diseñe formularios que exijan menos escritura a mano, captúrelos mientras sean legibles, procese por lotes con una herramienta que lea el significado en lugar de la posición, y verifique las celdas de riesgo en lugar de volver a escribir todo. Así es como un cuaderno de registro de calidad del agua escrito bajo la lluvia se convierte en un conjunto de datos listo para el cumplimiento normativo — y cómo un formulario de muestras de suelo llenado al final de un largo día conserva sus números intactos en el camino a la base de datos. El barro siempre fue parte del trabajo. Hacer que deje de costarle datos es lo que maneja la extracción — pruébela en un formulario que haya estado realmente en el campo.