El cuello de botella de los datos de campo
que nadie mide
Una ingeniera geotécnica está al borde de un pozo de perforación en el oeste de Colorado, abre su teléfono y fotografía el registro de muestras con cuchara partida. Tipo de suelo: arena limosa con grava. Profundidad: 14.5 pies. Número de golpes: 23. La foto captura todo: el registro escrito a mano, el marcador de profundidad, la marca de tiempo. Luego guarda el teléfono en su chaleco y se dirige a la siguiente ubicación. Más tarde, alguien en la oficina de Denver abrirá esa foto, leerá la letra manuscrita y escribirá cada dato en una hoja de cálculo. Ese paso de escritura consumió un estimado de 200 días laborables en toda la industria geotécnica el año pasado, y casi nadie lo presupuesta. La foto existe. Los datos existen. La verdadera pregunta es por qué ambos no se conectan sin un teclado de por medio.
La foto que ya tiene
Los trabajadores de campo de todas las industrias comparten un comportamiento: fotografían todo. Un lector de medidores de servicios públicos captura el registro digital antes de pasar a la siguiente casa. Un superintendente de construcción fotografía el tiquete de entrega contra el cielo de la mañana. Un técnico ambiental fotografía la lectura de profundidad del nivel freático de un pozo de monitoreo, con las manos embarradas. Un gerente de campo agrícola fotografía una sonda de suelo a 24 pulgadas, con la muestra de núcleo junto a una etiqueta numerada.
Estas fotos no son superfluas: son el mecanismo principal de captura de datos para millones de observaciones de campo al día. Y sin embargo, en la gran mayoría de las operaciones de campo, una fotografía se considera una ayuda de memoria, no una fuente de datos. Los datos dentro de la foto —los números, las casillas de verificación, las notas manuscritas— aún deben pasar por un teclado humano antes de ingresar a cualquier sistema que pueda calcular, comparar o reportar sobre ellos.
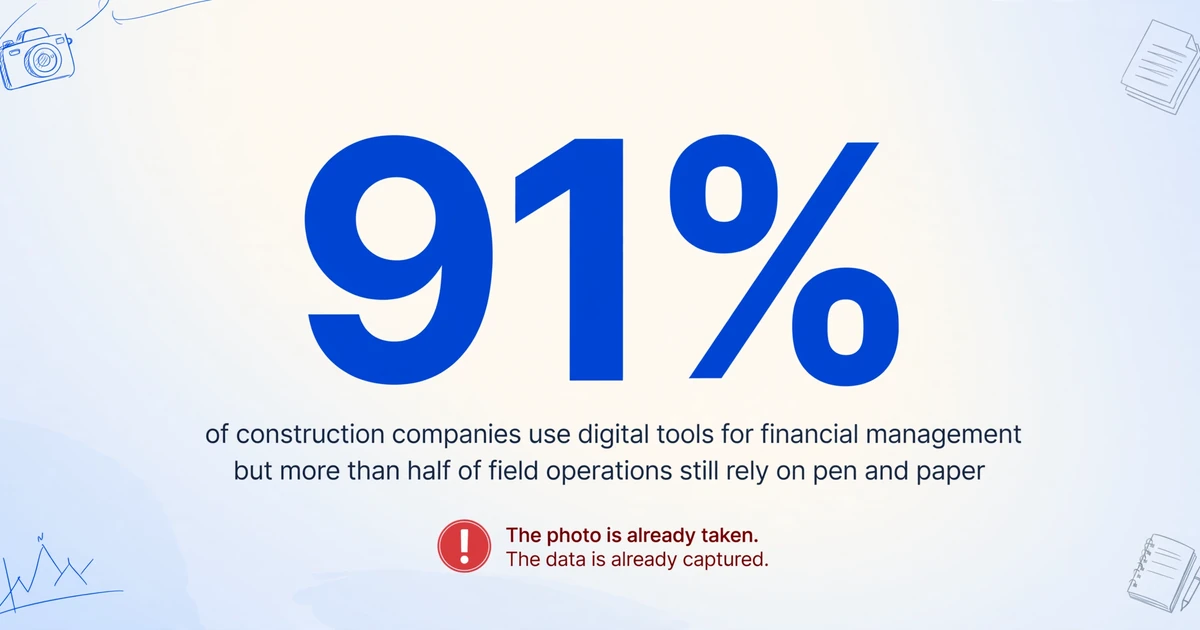
La magnitud de esta brecha está documentada, pero rara vez se conecta específicamente con el problema de las fotos. Un informe de 2025 de Intuit, citado por Construction Dive, encontró que el 91% de las empresas de construcción usan herramientas digitales para la gestión financiera, pero más de la mitad de las operaciones de campo aún dependen del lápiz y papel. El mercado global de aplicaciones de recopilación de datos de campo se valoró en $1.97 mil millones en 2024, con un crecimiento anual del 14.2%, pero esas aplicaciones resuelven el front end, reemplazando formularios en papel por digitales. No abordan el escenario mucho más común: la foto ya está tomada. Los datos ya están capturados. Alguien todavía los vuelve a escribir.
El cuello de botella de los datos de campo que la mayoría de los gerentes de operaciones nunca aísla no es la recopilación de datos. Es la hora entre la foto y la hoja de cálculo: un paso que no tiene línea presupuestaria formal, ni herramienta de automatización, y una tasa de error que se acumula con cada pulsación de tecla.
Los 30 minutos que nadie presupuesta
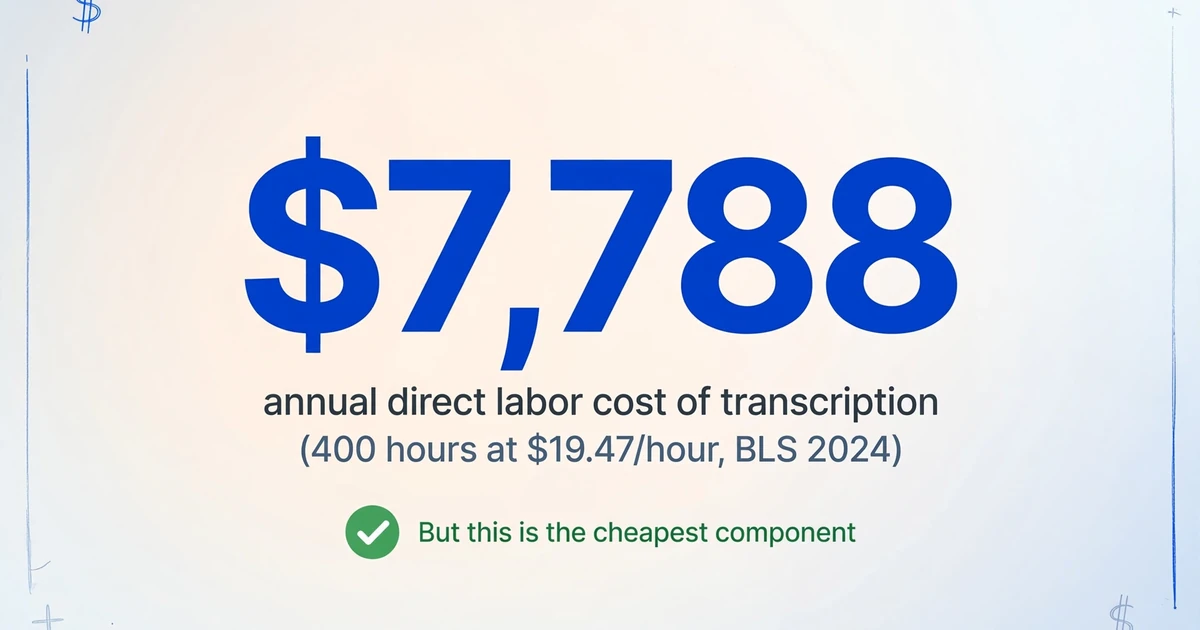
En un hilo de discusión en r/Contractor sobre métodos de registro diario, un superintendente reportó dedicar de 30 a 60 minutos cada día a completar un informe diario de construcción. El costo del lado de la oficina — un administrador de proyecto o PM que toma esos informes e ingresa manualmente conteos de cuadrillas, horas, uso de equipos y observaciones de seguridad en una hoja de cálculo de seguimiento — añade otros 30 a 60 minutos por informe. En un año de proyecto de 200 días laborables con dos sitios activos, eso representa de 200 a 400 horas reescribiendo datos desde fotos y notas de campo.
Multiplique eso en todas las industrias. Una firma de consultoría ambiental que opera cinco cuadrillas de campo recolectando datos de monitoreo de agua subterránea en 20 pozos cada una. Cada pozo requiere profundidad al nivel freático, pH, conductividad, temperatura y oxígeno disuelto — cinco puntos de datos. Eso son 500 puntos de datos por ronda de muestreo, fotografiados en tablillas o registrados en libretas impermeables, y luego transcritos en la oficina por un técnico junior que no visitó el sitio y tiene que interpretar escritura a mano, tinta corrida y notaciones de campo abreviadas.
La estructura de costos de este paso de transcripción tiene tres componentes, y la mayoría de los gerentes de operaciones solo rastrea uno:
Estos tres costos rara vez aparecen en la misma hoja de cálculo. La mano de obra directa está en el presupuesto de nómina. La corrección de errores se dispersa entre retrabajos, notas de crédito y llamadas a clientes. El costo de la demora es invisible: es el problema que no se detectó a tiempo. Aislarlos en un solo lugar revela un patrón constante: el paso de transcripción es donde la tubería pierde.
Cuatro industrias, el mismo patrón
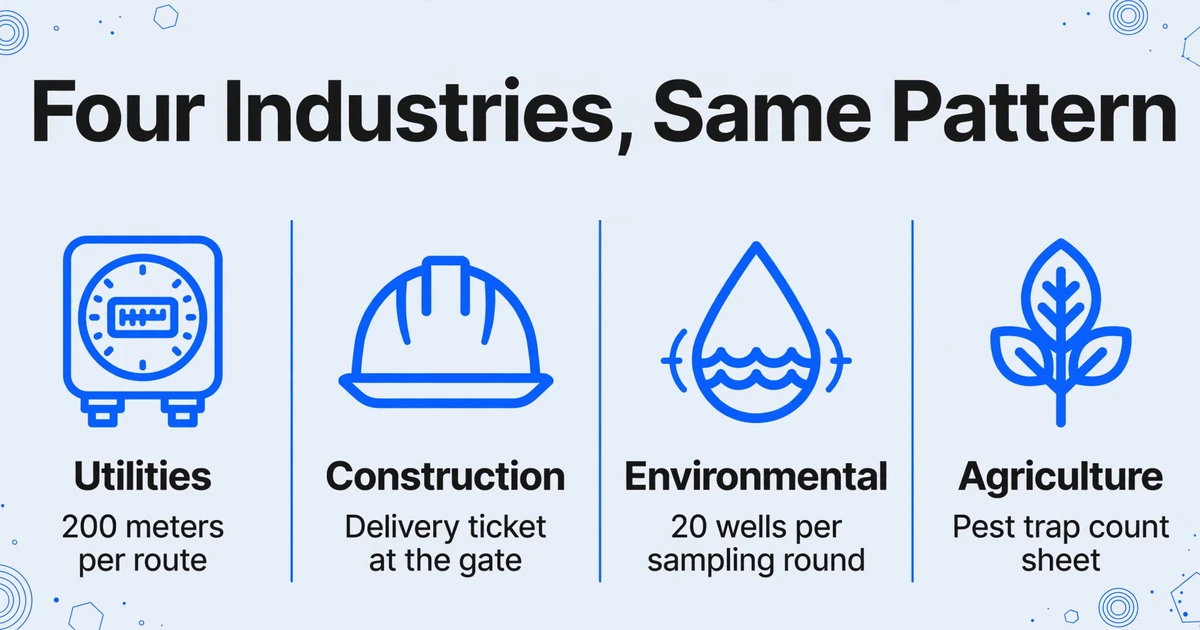
La brecha entre foto y hoja de cálculo no es exclusiva de ningún sector. Lo llamativo es lo idéntico que se ve el patrón entre industrias que no tienen nada más en común.
Servicios públicos. Un lector de medidores de un pequeño distrito de agua en el Pacífico Noroeste fotografía 200 registros de medidores por ruta. El registro muestra un número de seis dígitos; la foto también captura el ID del medidor estampado en la tapa. De vuelta en la oficina, un empleado de facturación abre cada foto, lee los dígitos y los escribe en la columna Current Reading de una hoja de cálculo de facturación. Una sola transposición —escribir 856421 como 856241— crea un error de facturación por el que el residente llamará. Una empresa de servicios públicos con 3,000 medidores leídos mensualmente genera 36,000 eventos de transcripción al año. Con una tasa de error conservadora del 0.5%, eso son 180 errores al año. Cada uno de esos errores produce una llamada telefónica del residente y un ciclo de corrección que cuesta mucho más que la tarifa por hora del empleado de facturación. Para las empresas de servicios públicos que integran la extracción con IA en esta misma tubería sin interrumpir las fórmulas posteriores, consulte nuestra guía de integración de lectura de medidores a facturación.
Construcción. Un superintendente fotografía un tiquete de entrega de concreto en la puerta del sitio de trabajo. El tiquete muestra yardas cúbicas entregadas, número de diseño de mezcla, hora del lote y número de camión. El ingeniero del proyecto necesita estos datos para verificar cantidades contra la solicitud de pago del subcontratista, pero los recibe cinco días después, cuando alguien los escribe en la hoja de cálculo de control del proyecto. La respuesta de la industria ha sido digitalizar todo el informe diario a través de plataformas como Procore, Fieldwire y Raken, pero las discusiones en r/Construction revelan una realidad persistente: muchos contratistas pequeños y medianos no pueden justificar el costo por usuario de las plataformas empresariales. Están operando con Excel y fotos almacenadas en una unidad compartida. Sus superintendentes toman las fotos. Alguien escribe los números. Esa tubería no va a ser reemplazada por un contrato de software de seis cifras, pero se puede acortar eliminando el paso de escritura.
Monitoreo ambiental. Los técnicos de campo fotografían las lecturas de los pozos de monitoreo, las mediciones de los medidores de caudal y los resultados de las sondas de gas del suelo. Estas fotos se convierten entonces en el documento fuente para los informes de cumplimiento que se presentan a las agencias ambientales estatales. EarthSoft, un proveedor líder de gestión de datos ambientales, describió el flujo de trabajo tradicional en su blog: "Los datos de campo se han recopilado en formularios de papel u hojas de cálculo, que luego se transcribían a algún formato digital en la oficina. Convertir estos datos manuales en datos digitales para los informes implicaba varios pasos que a menudo comenzaban por descifrar los formularios de campo y escribirlos en tablas, lo que podía introducir errores de transcripción y generar desconfianza en los datos". La frase "desconfianza en los datos" capta la consecuencia posterior: cuando los datos de campo se han vuelto a escribir manualmente, nadie está del todo seguro de que los números del informe coincidan con los números del registro original.
Agricultura. Un explorador de cultivos fotografía una hoja de conteo de plagas en trampas, escrita a mano en un portapapeles en el campo. La foto captura la fecha, el ID del campo, el número de trampa y el conteo de plagas. Esos datos deben llegar a la hoja de cálculo de gestión de la finca antes de tomar la decisión de fumigar, idealmente en horas, no en días. El propio inventario de casos de uso de IA del USDA, publicado en 2025, incluye la extracción automatizada de datos de formularios y facturas como un despliegue activo: "El personal está sobrecargado por el manejo manual de documentos, lo que deja menos tiempo para centrarse en tareas estratégicas de alto valor". Si el USDA considera que la extracción de datos a partir de fotos es lo bastante madura como para desplegarla en sus agencias, la tecnología ha cruzado el umbral de lo experimental a lo operativo.
En los cuatro escenarios, la foto existe. Los datos que contiene son legibles. El valor de esos datos aumenta cuanto más rápido llegan a la hoja de cálculo. Y el paso de transcripción es la única parte que se puede eliminar sin cambiar nada de lo que hace el trabajador de campo.
Por qué los formularios digitales no son la solución — y por qué su equipo no los usa
La receta estándar del sector para los problemas de datos de campo es una plataforma móvil de formularios digitales: dar a cada trabajador de campo una tableta con un formulario personalizado, dejar que escriba o toque sus datos directamente en ella y sincronizar con la nube. Este enfoque tiene un mercado de $1.97 mil millones y en crecimiento. También tiene un problema de adopción bien documentado.
Las barreras no son técnicas, sino de comportamiento y operativas. Los trabajadores de campo que llevan guantes no pueden manejar una pantalla táctil. El barro, la lluvia y la luz solar directa hacen que las tabletas sean inutilizables en obras de construcción, fincas y plataformas de pozos. Una cámara de teléfono manejada con una mano —incluso con un guante— captura la lectura en dos segundos. Escribir esa misma lectura en un formulario en el mismo teléfono lleva de 10 a 15 segundos e introduce errores de entrada de datos en el punto de captura. Cuando un técnico de campo tiene 200 paradas en una ruta, la diferencia entre una foto de dos segundos y una entrada de formulario de 15 segundos es de 43 minutos adicionales de tiempo de campo por ruta, tiempo que no existe en el cronograma.
Por eso persiste la foto. No porque los trabajadores de campo se resistan a la tecnología, sino porque la cámara es la herramienta de captura de datos más rápida y fiable disponible en condiciones de campo. No requiere navegar por menús, ni seleccionar opciones desplegables, ni validar campos: solo apuntar y disparar. El problema no es que la foto sea una fuente de datos inferior. El problema es lo que ocurre —o no ocurre— con la foto después de tomarla.
La foto no es el problema. La brecha entre la foto y la hoja de cálculo es el problema. Y cerrar esa brecha no requiere cambiar lo que hacen los trabajadores de campo. Requiere cambiar lo que ocurre cuando la foto llega a la oficina.
Qué cambia realmente cuando desaparece el paso de reescritura
La extracción de documentos con IA cambia exactamente un paso en el flujo de datos de campo: la transcripción. El trabajador de campo sigue fotografiando el medidor, el comprobante de entrega, la lectura del pozo de monitoreo, la hoja de conteo de plagas. La foto sigue llegando a la oficina. Pero en lugar de que una persona la abra y escriba lo que ve, la IA lee la foto directamente — extrayendo los puntos de datos específicos necesarios y poblándolos en columnas de hoja de cálculo.
Este enfoque — que ImageToTable.ai llama Extracción Personalizada de Columnas — funciona de manera diferente al OCR tradicional basado en plantillas. El OCR con plantillas requiere que definas dónde vive cada dato en la página: "la lectura del medidor está en el recuadro superior derecho, coordenadas X, Y". Cuando el diseño del formulario cambia — un comprobante de entrega de otro proveedor, un nuevo formato de registro de pozo — la plantilla se rompe. La Extracción Personalizada de Columnas toma el enfoque opuesto: nombras los datos que deseas ("Lectura del Medidor", "Yardas Cúbicas", "pH", "Conteo de Plagas"), y la IA localiza cada valor al entender qué significa — no dónde está en la página. El trabajador de campo puede fotografiar una docena de modelos de medidores, diseños de comprobantes de entrega o formatos de registro de pozos, y la IA encuentra los valores objetivo en todos ellos sin reconfiguración.
Esta es la diferencia crítica para los flujos de trabajo de campo. Los datos de campo no llegan en formatos consistentes. Un lector de medidores encuentra diales analógicos, pantallas digitales y placas metálicas estampadas — todo en una sola ruta. Un superintendente de construcción fotografía comprobantes de entrega de cinco proveedores de concreto diferentes, cada uno con su propio diseño. Un técnico ambiental fotografía equipos de monitoreo de tres fabricantes. La Extracción Personalizada de Columnas maneja esta variabilidad porque lee por significado, no por posición.
Lo que cambia operativamente:
Para una empresa de agua que procesa 3,000 lecturas mensuales del medidor, la aritmética es sencilla. La transcripción manual toma 30–60 minutos por cada 100 lecturas — aproximadamente 15 a 30 horas al mes para 3,000 medidores. Con el salario medio de BLS de $19.47 por hora, eso equivale a $292 a $584 al mes en mano de obra directa de transcripción, más el costo de 15 a 30 errores de facturación que requieren llamadas al cliente y correcciones. La extracción con IA reduce el paso de oficina de escribir a verificar — aproximadamente el 10% del tiempo original. Los ahorros son inmediatos, y la hoja de cálculo de facturación — con sus niveles de tarifa cuidadosamente construidos, fórmulas de recargo por alcantarillado y cálculos de fecha de vencimiento — permanece completamente intacta. La IA solo llena la columna de Lectura Actual. Cada fórmula a la derecha de esa columna sigue funcionando exactamente como siempre lo hizo.
Para equipos que gestionan datos de campo de múltiples trabajadores en varios sitios, la función Enlace de Recogida amplía este flujo de trabajo: los trabajadores de campo suben sus fotos directamente a través de un enlace compartido — sin cuenta, sin inicio de sesión, sin aplicación — y las fotos llegan automáticamente a la cola de procesamiento de la oficina. El personal de oficina no toca las fotos hasta que ya están extraídas en filas de hoja de cálculo, listas para verificar. Esto elimina la cadena de correos electrónicos, la carpeta compartida y el problema de "quién tiene la última versión" que afecta a los flujos de trabajo de campo basados en fotos. Para equipos que recopilan formularios de inspección de campo y listas de verificación, el mismo proceso de extracción maneja casillas de verificación, notas manuscritas y campos mixtos impresos y escritos a mano en una sola pasada — sin necesidad de un paso de procesamiento separado para cada tipo de campo.
El Proceso Que No Se Mueve
Lo más importante que no cambia cuando la extracción con IA reemplaza la transcripción manual es todo lo que sigue al paso de ingreso de datos. La hoja de cálculo con sus cálculos de tarifas, la plantilla de informes de cumplimiento, el formato de exportación de facturación — nada se mueve. La IA llena las columnas de entrada. Las fórmulas, macros y rutinas de exportación que tardaron meses en construirse y validarse siguen funcionando con las mismas posiciones de columna y los mismos tipos de datos. La hoja de cálculo no sabe ni le importa si el número en la celda C2 llegó mediante una pulsación de tecla o mediante extracción con IA.
Esto no es un detalle menor. Es la razón por la que la automatización de datos de campo se ha quedado atrás respecto a otras automatizaciones de procesos empresariales. Las plataformas empresariales exigen que reconstruyas todo tu flujo de trabajo en torno a su modelo de datos. Una empresa de servicios públicos que ha pasado años ajustando su hoja de cálculo de facturación — tarifas escalonadas que cambian según la temporada, recargos de alcantarillado que difieren según la clase de cliente, fechas de vencimiento calculadas a partir de ciclos de facturación — no puede permitirse abandonar esas fórmulas por un módulo de facturación de un proveedor. Una empresa de construcción que rastrea la productividad laboral en hojas de cálculo compartidas por tres gerentes de proyecto no puede migrar a una plataforma que imponga una estructura de datos diferente. La hoja de cálculo es la plataforma. El paso de extracción con IA la alimenta — y se detiene ahí.
Para los trabajadores de campo que fotografían medidores, calibradores, pantallas y lecturas manuscritas, esto significa que las lecturas de medidores fluyen directamente a Excel desde fotos de campo sin pasos intermedios. Para los gerentes de operaciones que envían cuadrillas a fotografiar horómetros de equipos, indicadores de nivel de tanques o lecturas de presión en sitios remotos, cualquier foto de campo se convierte en datos de hoja de cálculo en segundos. El trabajador de campo toma la misma foto. La hoja de cálculo recibe los mismos datos. Lo único que se elimina es el teclado en medio.
Preguntas frecuentes
¿Qué tan preciso es el AI al leer datos de fotos de campo?
Para texto impreso y pantallas digitales — registros de medidores, lecturas de equipos, tickets de entrega mecanografiados — la precisión alcanza hasta el 99%. Para notas de campo manuscritas, la precisión depende de la legibilidad de la escritura. Los caracteres claros y separados se leen de forma fiable. La escritura cursiva, las manchas intensas o las fotos con ángulos extremos reducen la precisión y pueden requerir corrección manual. La extracción con AI funciona mejor como un flujo de trabajo basado en verificación: revisas los valores marcados en lugar de escribir cada valor.
¿Funciona con los diferentes modelos de medidores y diseños de formularios que encuentran nuestros equipos de campo?
Sí. Debido a que la extracción es semántica — basada en lo que significan los datos, no en dónde están — el AI maneja la variación de formato sin reconfiguración. Un lector de medidores puede fotografiar diales analógicos, pantallas LCD digitales y placas metálicas grabadas en la misma ruta, y el AI localizará el valor de lectura en todos ellos usando la misma definición de columna. Esta es la diferencia fundamental con el OCR basado en plantillas.
¿Qué pasa con las notas de campo manuscritas y las listas de verificación?
El AI lee texto manuscrito en formularios de campo, hojas de registro y listas de verificación. El rendimiento es más fuerte con letras de molde y caracteres claramente separados. Los formularios mixtos impresos y manuscritos — comunes en registros de monitoreo ambiental donde el formulario está preimpreso y el técnico completa los valores a mano — funcionan bien porque el AI puede anclarse en las etiquetas impresas e interpretar los valores manuscritos en contexto.
¿Qué calidad de foto se requiere?
La foto debe ser lo suficientemente clara como para que una persona pueda leer los datos. La mayoría de las cámaras de teléfonos inteligentes modernos con luz natural producen imágenes muy por encima de este umbral. La fotografía con flash en cajas de medidores oscuras, tomas en ángulo y fotos con algo de sombra o reflejo generalmente se procesan correctamente. Las imágenes muy borrosas, las fotos tomadas en ángulos extremos donde los dígitos se acortan o las imágenes donde los datos objetivo están parcialmente ocultos producirán resultados no fiables.
¿Se pueden procesar varias fotos de campo a la vez?
Sí. El procesamiento por lotes está integrado en la herramienta: suba todas las fotos de una ruta de campo, una ronda de muestreo o un día de tickets de entrega en un solo lote, defina las columnas que desea extraer y la IA las procesa juntas, fusionando todos los resultados en una sola hoja de cálculo. Una ruta de 200 fotos de un lector de medidores se procesa como un solo lote, generando una hoja de cálculo con 200 filas de lecturas.
¿Funciona sin conexión en el campo?
Los trabajadores de campo no necesitan conectividad. Toman fotos con sus teléfonos como siempre lo hacen: la aplicación de la cámara funciona sin conexión. Las fotos se suben cuando el dispositivo se reconecta, ya sea por el trabajador al final de la ruta o por el personal de oficina que recibe las fotos. La extracción por IA ocurre en el servidor después de la subida.
¿En qué se diferencia de las aplicaciones de recolección de datos de campo como Fulcrum o GoFormz?
Esas plataformas reemplazan el formulario en papel por un formulario digital que los trabajadores de campo llenan en un dispositivo. Esto requiere un cambio de comportamiento: los trabajadores deben aprender una nueva interfaz, navegar menús desplegables y escribir en una pantalla táctil en condiciones de campo. La extracción de fotos por IA mantiene el comportamiento de campo existente — tomar una foto — y automatiza el paso de transcripción en la oficina. Es un punto de intervención diferente en el proceso.
Los archivos se procesan de forma segura y no se almacenan.