Der Engpass bei Felddaten,
den niemand misst
Eine Geotechnik-Ingenieurin steht am Rand eines Bohrlochs im westlichen Colorado, öffnet ihr Handy und fotografiert das Protokoll der Split-Spoon-Probe. Bodenart: schluffiger Sand mit Kies. Tiefe: 14.5 feet. Schlagzahl: 23. Das Foto erfasst all das — das handgeschriebene Protokoll, die Tiefenmarkierung, den Zeitstempel. Dann steckt sie das Handy zurück in die Weste und geht zum nächsten Standort. Später öffnet jemand im Büro in Denver dieses Foto, liest die Handschrift und tippt jeden Datenpunkt in eine Tabelle. Dieser Abtippschritt hat im vergangenen Jahr schätzungsweise 200 Arbeitstage in der Geotechnikbranche verbraucht — und kaum jemand plant dafür Budget ein. Das Foto existiert. Die Daten existieren. Die eigentliche Frage ist, warum die beiden nicht ohne Tastatur dazwischen zusammenfinden.
Das Foto, das Sie bereits haben
Außendienstmitarbeiter in allen Branchen teilen ein Verhalten: Sie fotografieren alles. Ein Zählerableser fotografiert den Ziffernstand, bevor er zum nächsten Haus weitergeht. Ein Bauleiter fotografiert den Lieferschein vor dem Morgenhimmel. Ein Umwelttechniker fotografiert den Grundwasserstand eines Messbrunnens, die Hände schlammig. Ein landwirtschaftlicher Betriebsleiter fotografiert eine Bodenprobe in 24 Zoll Tiefe, den Bohrkern neben einem nummerierten Anhänger.
Diese Fotos sind nicht überflüssig — sie sind der primäre Mechanismus zur Datenerfassung für Millionen von Feldbeobachtungen pro Tag. Und doch gilt ein Foto in der überwiegenden Mehrheit der Außendiensteinsätze als Gedächtnisstütze, nicht als Datenquelle. Die Daten im Foto — die Zahlen, die Kontrollkästchen, die handschriftlichen Notizen — müssen immer noch über eine menschliche Tastatur laufen, bevor sie in ein System gelangen, das sie berechnen, vergleichen oder darüber berichten kann.
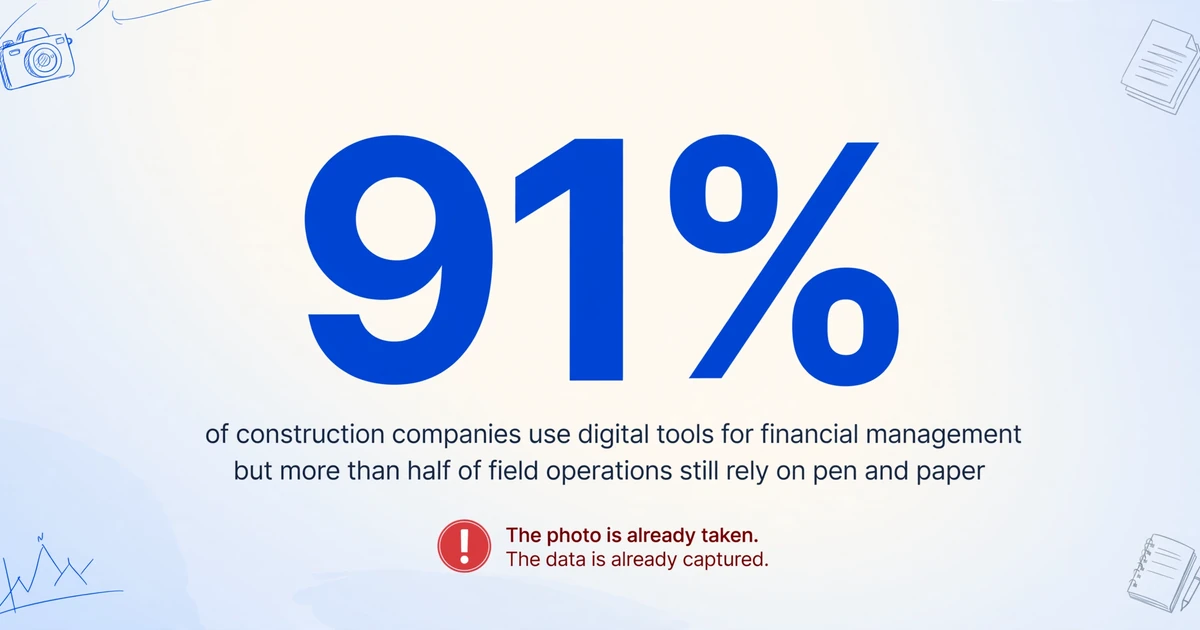
Das Ausmaß dieser Lücke ist dokumentiert, wird aber selten speziell mit dem Foto-Problem in Verbindung gebracht. Ein Bericht von Intuit aus dem Jahr 2025, zitiert von Construction Dive, ergab, dass 91% der Bauunternehmen digitale Werkzeuge für die Finanzverwaltung nutzen — aber mehr als die Hälfte der Außendiensteinsätze setzt noch immer auf Stift und Papier. Der globale Markt für Felddatenerfassungs-Apps wurde 2024 auf $1.97 Milliarden bewertet und wächst jährlich um 14.2% — doch diese Apps lösen nur das Frontend, indem sie Papierformulare durch digitale ersetzen. Sie adressieren nicht das weit häufigere Szenario: Das Foto ist bereits gemacht. Die Daten sind bereits erfasst. Jemand tippt sie trotzdem noch einmal ab.
Der Engpass bei Felddaten, den die meisten Betriebsleiter nie isolieren, ist nicht die Datenerfassung. Es ist die Stunde zwischen dem Foto und der Tabelle — ein Schritt, der keine formale Budgetposition, kein Automatisierungswerkzeug und eine Fehlerquote hat, die sich mit jedem Tastendruck vervielfacht.
Die 30 Minuten, für die niemand Zeit einplant
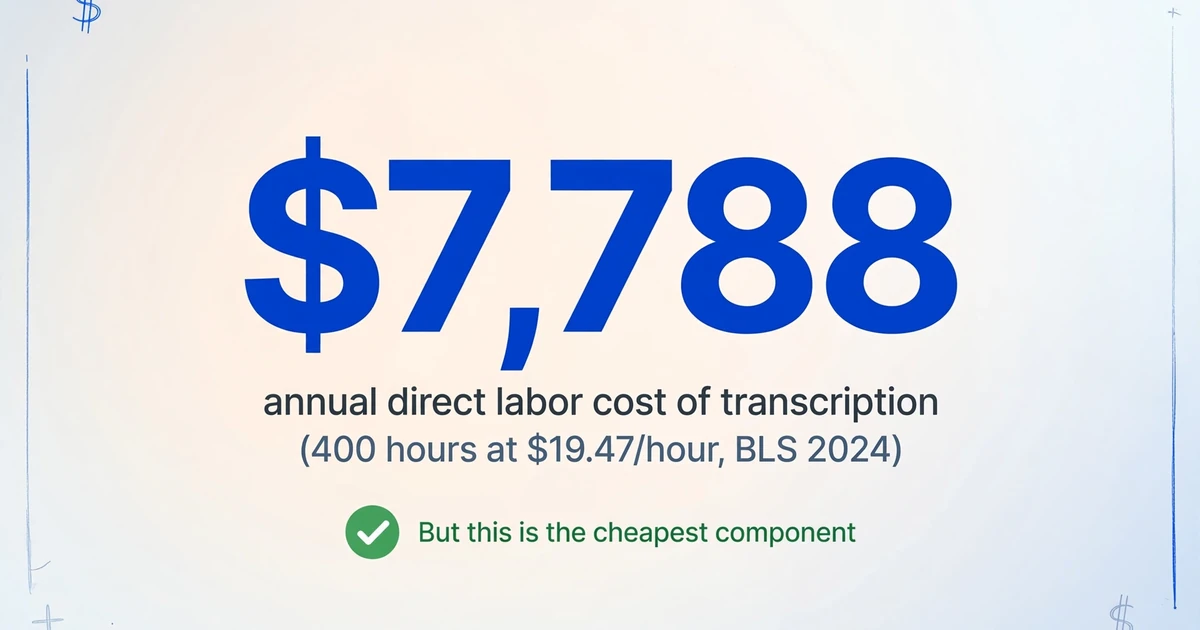
In einem Diskussionsthread auf r/Contractor über Methoden für Tagesberichte berichtete ein Bauleiter, dass er jeden Tag 30 bis 60 Minuten mit dem Ausfüllen eines Bautageberichts verbringt. Die büroseitigen Kosten — ein Projektadministrator oder PM, der diese Berichte entgegennimmt und Mannschaftsstärken, Stunden, Geräteeinsatz und Sicherheitsbeobachtungen manuell in eine Tracking-Tabelle einträgt — kommen mit weiteren 30 bis 60 Minuten pro Bericht hinzu. Bei einem Projektjahr mit 200 Arbeitstagen und zwei aktiven Standorten sind das 200 bis 400 Stunden, in denen Daten aus Fotos und Feldnotizen erneut abgetippt werden.
Multiplizieren Sie das über Branchen hinweg. Ein Umweltberatungsunternehmen mit fünf Feldteams, die Grundwasser-Messdaten an jeweils 20 Messbrunnen erfassen. Jeder Messbrunnen erfordert Wassertiefe, pH-Wert, Leitfähigkeit, Temperatur und gelösten Sauerstoff — fünf Datenpunkte. Das sind 500 Datenpunkte pro Beprobungsrunde, fotografiert auf Klemmbrettern oder eingetragen in wasserfeste Notizbücher und anschließend im Büro abgetippt von einem Junior-Techniker, der den Standort nicht besucht hat und Handschrift, verwischte Tinte und abgekürzte Feldnotationen interpretieren muss.
Die Kostenstruktur dieses Abtippschritts hat drei Komponenten, und die meisten Betriebsleiter verfolgen nur eine davon:
Diese drei Kosten erscheinen selten in derselben Tabelle. Direkte Arbeitskosten stehen im Personalbudget. Fehlerkorrekturen verteilen sich über Nacharbeit, Gutschriften und Kundenanrufe. Verzögerungskosten sind unsichtbar – sie sind das Problem, das nicht rechtzeitig erkannt wurde. Wenn man sie an einer Stelle isoliert, zeigt sich ein konsistentes Muster: Der Transkriptionsschritt ist die Stelle, an der die Pipeline undicht wird.
Vier Branchen, dasselbe Muster
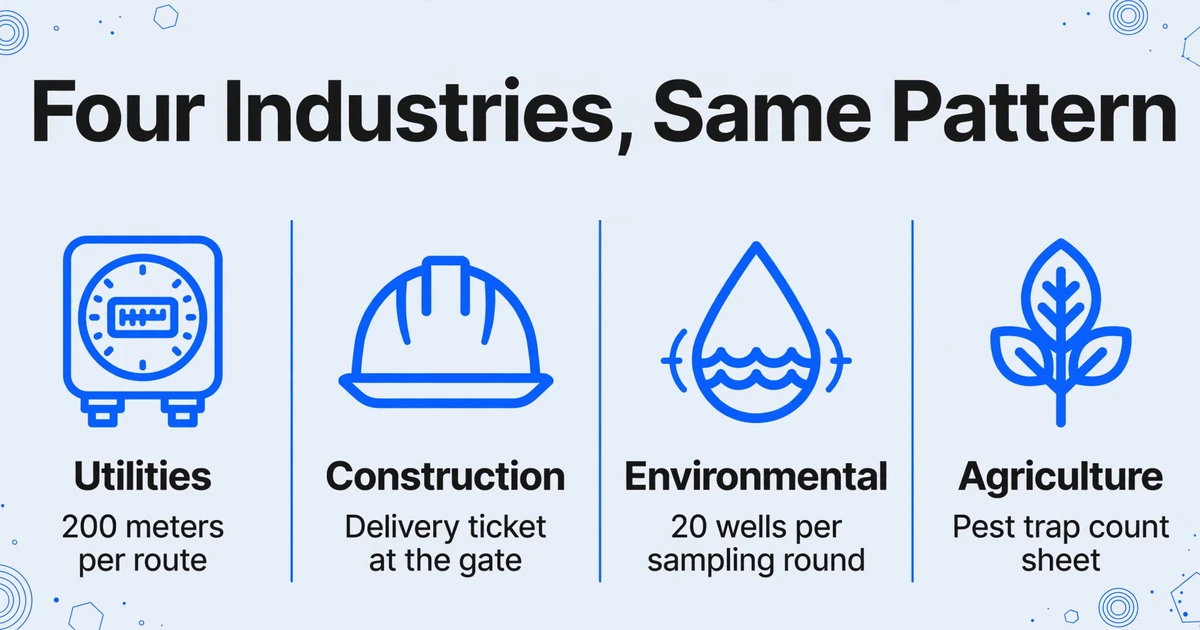
Die Lücke zwischen Foto und Tabelle ist nicht auf einen einzelnen Sektor beschränkt. Auffällig ist, wie identisch das Muster über Branchen hinweg aussieht, die sonst nichts gemeinsam haben.
Versorgungsunternehmen. Ein Zählerableser für einen kleinen Wasserversorgungsbezirk im pazifischen Nordwesten fotografiert 200 Zählerstände pro Route. Der Zählerstand zeigt eine sechsstellige Zahl; das Foto erfasst außerdem die auf dem Deckel eingeprägte Zähler-ID. Zurück im Büro öffnet ein Abrechnungssachbearbeiter jedes Foto, liest die Ziffern ab und tippt sie in die Spalte Aktueller Stand einer Abrechnungstabelle ein. Eine einzige Vertauschung – 856421 als 856241 eingegeben – erzeugt einen Abrechnungsfehler, wegen dem der Anwohner anrufen wird. Ein Versorgungsunternehmen mit 3.000 monatlich abgelesenen Zählern erzeugt 36.000 Transkriptionsvorgänge pro Jahr. Bei einer konservativen Fehlerquote von 0,5 % sind das 180 Fehler pro Jahr. Jeder dieser Fehler führt zu einem Anruf eines Anwohners und einem Korrekturzyklus, der weit mehr kostet als der Stundenlohn des Abrechnungssachbearbeiters. Wie Versorgungsunternehmen KI-Extraktion in genau diese Pipeline integrieren, ohne nachgelagerte Formeln zu stören, erfahren Sie in unserem Leitfaden zur Integration von Zählerstandserfassung in die Abrechnung.
Bauwesen. Ein Bauleiter fotografiert einen Beton-Lieferschein am Tor der Baustelle. Der Lieferschein zeigt gelieferte Kubikmeter, Mischungsnummer, Batch-Zeit und LKW-Nummer. Der Projektleiter benötigt diese Daten, um die Mengen gegen den Zahlungsantrag des Subunternehmers zu prüfen – bekommt sie aber erst fünf Tage später, wenn jemand sie in die Projektcontrolling-Tabelle eintippt. Die Branche hat darauf reagiert, indem sie den gesamten Tagesbericht über Plattformen wie Procore, Fieldwire und Raken digitalisiert – doch Diskussionen auf r/Construction offenbaren eine hartnäckige Realität: Viele kleine und mittlere Auftragnehmer können die Kosten pro Arbeitsplatz für Unternehmensplattformen nicht rechtfertigen. Sie wickeln ihren Betrieb über Excel und in einem gemeinsamen Laufwerk gespeicherte Fotos ab. Ihre Bauleiter machen die Fotos. Jemand tippt die Zahlen ein. Diese Pipeline wird nicht durch einen sechsstelligen Softwarevertrag ersetzt – aber sie kann verkürzt werden, indem man den Eingabeschritt entfernt.
Umweltmonitoring. Außendiensttechniker fotografieren Zählerstände von Messbrunnen, Abflussmessungen und Ergebnisse von Bodenluftsonden. Diese Fotos werden dann zum Ausgangsdokument für Compliance-Berichte, die bei staatlichen Umweltbehörden eingereicht werden. EarthSoft, ein führender Anbieter von Umweltdatenmanagement, beschrieb den traditionellen Workflow in seinem Blog: „Felddaten wurden auf Papierformularen oder Tabellen erfasst, die dann im Büro in irgendeine digitale Form übertragen wurden. Die Umwandlung dieser manuellen Daten in digitale Daten für Berichtsausgaben umfasste verschiedene Schritte, die oft damit begannen, die Feldformulare zu entziffern und sie in Tabellen einzutippen, was potenziell Transkriptionsfehler verursachen und zu Datenmisstrauen führen konnte." Der Begriff „Datenmisstrauen" erfasst die nachgelagerte Konsequenz: Wenn Felddaten manuell abgetippt wurden, ist sich niemand völlig sicher, ob die Zahlen im Bericht mit den Zahlen im Originalprotokoll übereinstimmen.
Landwirtschaft. Ein Pflanzenscout fotografiert ein Blatt mit Schädlingszahlen, das im Feld handschriftlich auf einem Klemmbrett ausgefüllt wurde. Das Foto erfasst Datum, Feld-ID, Fallennummer und Schädlingszahl. Diese Daten müssen die Farmmanagement-Tabelle erreichen, bevor die Spritzentscheidung getroffen wird — idealerweise innerhalb von Stunden, nicht Tagen. Das AI Use Case Inventory des USDA, veröffentlicht 2025, listet die automatisierte Datenextraktion aus Formularen und Rechnungen als aktiven Einsatz auf: „Das Personal ist durch manuelle Dokumentenbearbeitung überlastet, was weniger Zeit für strategische Aufgaben mit hohem Wert bedeutet." Wenn das USDA die Foto-zu-Daten-Extraktion für ausgereift genug hält, um sie behördenweit einzusetzen, hat die Technologie die Schwelle vom Experimentellen zum Operativen überschritten.
In allen vier Szenarien existiert das Foto. Die darin enthaltenen Daten sind lesbar. Der Wert dieser Daten steigt, je schneller sie die Tabelle erreichen. Und der Transkriptionsschritt ist der einzige Teil, der entfernt werden kann, ohne dass sich etwas an der Arbeit des Außendienstmitarbeiters ändert.
Warum digitale Formulare nicht die Antwort sind — und warum Ihr Team sie nicht nutzt
Die übliche Branchenempfehlung für Felddatenprobleme ist eine mobile digitale Formularplattform: Geben Sie jedem Außendienstmitarbeiter ein Tablet mit einem benutzerdefinierten Formular, lassen Sie ihn seine Daten direkt eintippen oder antippen, synchronisieren Sie mit der Cloud. Dieser Ansatz hat einen Markt von 1,97 Milliarden Dollar und wächst. Er hat auch ein gut dokumentiertes Akzeptanzproblem.
Die Hürden sind nicht technisch — sie sind verhaltensbedingt und operativ. Außendienstmitarbeiter mit Handschuhen können keinen Touchscreen bedienen. Schlamm, Regen und direktes Sonnenlicht machen Tablets auf Baustellen, Farmen und Bohrstellen unbrauchbar. Eine mit einer Hand — selbst mit behandschuhter Hand — bediente Handykamera erfasst den Messwert in zwei Sekunden. Denselben Messwert in ein Formular auf demselben Handy einzutippen dauert 10 bis 15 Sekunden und führt zu Dateneingabefehlern am Erfassungspunkt. Wenn ein Außendiensttechniker 200 Stopps auf einer Route hat, beträgt der Unterschied zwischen einem Zwei-Sekunden-Foto und einer 15-Sekunden-Formulareingabe 43 Minuten zusätzliche Feldzeit pro Route — Zeit, die im Zeitplan nicht existiert.
Deshalb bleibt das Foto bestehen. Nicht weil Außendienstmitarbeiter Technologie ablehnen, sondern weil die Kamera das schnellste und zuverlässigste Datenerfassungswerkzeug ist, das unter Feldbedingungen verfügbar ist. Sie erfordert keine Menünavigation, keine Dropdown-Auswahl, keine Feldvalidierung — einfach zielen und schießen. Das Problem ist nicht, dass das Foto eine minderwertige Datenquelle ist. Das Problem ist, was mit dem Foto nach der Aufnahme passiert — oder nicht passiert.
Das Foto ist nicht das Problem. Die Lücke zwischen dem Foto und der Tabelle ist das Problem. Und diese Lücke zu schließen erfordert nicht, dass sich etwas an der Arbeit der Außendienstmitarbeiter ändert. Es erfordert, dass sich etwas daran ändert, was passiert, wenn das Foto das Büro erreicht.
Was sich wirklich ändert, wenn der Abtipp-Schritt wegfällt
KI-gestützte Dokumentenextraktion verändert genau einen Schritt in der Felddaten-Pipeline: die Transkription. Der Außendienstmitarbeiter fotografiert weiterhin den Zähler, den Lieferschein, den Grundwassermesswert, das Schädlingszählblatt. Das Foto trifft weiterhin im Büro ein. Aber anstatt dass eine Person es öffnet und abtippt, was sie sieht, liest die KI das Foto direkt aus – extrahiert die benötigten Datenpunkte und trägt sie in die Spalten der Tabelle ein.
Diese Methode – die ImageToTable.ai Benutzerdefinierte Spaltenextraktion nennt – funktioniert anders als herkömmliche template-basierte OCR. Template-OCR erfordert, dass Sie definieren, wo sich jeder Datenpunkt auf der Seite befindet: „Der Zählerstand ist im Kästchen oben rechts, Koordinaten X, Y." Wenn sich das Formularlayout ändert – ein Lieferschein eines anderen Lieferanten, ein neues Grundwassermessprotokollformat –, bricht die Vorlage zusammen. Die benutzerdefinierte Spaltenextraktion verfolgt den umgekehrten Ansatz: Sie benennen die gewünschten Datenpunkte („Zählerstand", „Kubikmeter", „pH-Wert", „Schädlingszahl"), und die KI lokalisiert jeden Wert, indem sie versteht, was er bedeutet – nicht, wo er auf der Seite sitzt. Der Außendienstmitarbeiter kann ein Dutzend verschiedener Zählermodelle, Lieferscheinlayouts oder Messprotokollformate fotografieren, und die KI findet die Zielwerte in allen wieder, ohne Neukonfiguration.
Dies ist der entscheidende Unterschied für Feldarbeitsabläufe. Felddaten kommen nicht in einheitlichen Formaten an. Ein Zählerableser trifft auf analoge Zifferblätter, Digitalanzeigen und geprägte Metallschilder – alles auf einer Route. Ein Bauleiter fotografiert Lieferscheine von fünf verschiedenen Betonlieferanten, jeder mit eigenem Layout. Ein Umwelttechniker fotografiert Messgeräte von drei Herstellern. Die benutzerdefinierte Spaltenextraktion bewältigt diese Variabilität, weil sie nach Bedeutung liest, nicht nach Position.
Was sich operativ ändert:
Für einen Wasserversorger, der monatlich 3.000 Zählerstände verarbeitet, ist die Rechnung einfach. Manuelle Transkription dauert 30–60 Minuten pro 100 Messwerten – also etwa 15 bis 30 Stunden pro Monat für 3.000 Zähler. Beim BLS-Medianlohn von 19,47 $ pro Stunde sind das 292 bis 584 $ pro Monat an direkter Transkriptionsarbeit, plus die Kosten für 15 bis 30 Abrechnungsfehler, die Kundenanrufe und Korrekturen erfordern. KI-Extraktion reduziert den Büroschritt vom Abtippen zum Prüfen – auf etwa 10 % der ursprünglichen Zeit. Die Einsparungen sind sofort spürbar, und die Abrechnungstabelle – mit ihren sorgfältig aufgebauten Tarifstufen, Abwassergleichungsformeln und Fälligkeitsberechnungen – bleibt vollständig unberührt. Die KI füllt nur die Spalte „Aktueller Stand“ aus. Jede Formel rechts davon funktioniert weiterhin genau so, wie sie es immer getan hat.
Für Teams, die Felddaten von mehreren Mitarbeitern an verschiedenen Standorten verwalten, erweitert die Funktion Erfassungslink diesen Workflow: Außendienstmitarbeiter laden ihre Fotos direkt über einen geteilten Link hoch – ohne Konto, Login oder App – und die Fotos landen automatisch in der Büro-Warteschlange zur Verarbeitung. Das Büropersonal berührt die Fotos erst, wenn sie bereits in Tabellenzeilen extrahiert und bereit zur Überprüfung sind. Das eliminiert die E-Mail-Kette, den freigegebenen Ordner und das Problem der „neuesten Version“, das foto-basierte Feldworkflows plagt. Für Teams, die Feldinspektionsformulare und Checklisten erfassen, verarbeitet dieselbe Extraktionspipeline Kontrollkästchen, handschriftliche Notizen und gemischte gedruckte/handschriftliche Felder in einem Durchgang – ohne separaten Verarbeitungsschritt für jeden Feldtyp.
Die Pipeline, die sich nicht bewegt
Das Wichtigste, das sich nicht ändert, wenn KI-Extraktion die manuelle Transkription ersetzt, ist alles, was nach dem Dateneingabeschritt kommt. Die Tabelle mit ihren Tarifberechnungen, die Compliance-Berichtsvorlage, das Abrechnungsexportformat – nichts davon ändert sich. Die KI befüllt die Eingabespalten. Die Formeln, Makros und Exportroutinen, deren Aufbau und Validierung Monate gedauert haben, laufen weiterhin gegen dieselben Spaltenpositionen mit denselben Datentypen. Die Tabelle weiß nicht und interessiert sich nicht dafür, ob die Zahl in Zelle C2 per Tastendruck oder KI-Extraktion angekommen ist.
Das ist kein kleines Detail. Es ist der Grund, warum die Automatisierung von Felddaten hinter anderen Geschäftsprozessautomatisierungen zurückgeblieben ist. Unternehmensplattformen verlangen, dass Sie Ihren gesamten Workflow um ihr Datenmodell herum neu aufbauen. Ein Versorgungsunternehmen, das jahrelang seine Abrechnungstabelle optimiert hat – gestaffelte Tarife, die saisonal wechseln, Abwasserzuschläge, die sich nach Kundengruppe unterscheiden, Fälligkeitsdaten, die aus Abrechnungszyklen berechnet werden – kann es sich nicht leisten, diese Formeln für ein Abrechnungsmodul eines Anbieters aufzugeben. Ein Bauunternehmen, das die Arbeitsproduktivität über von drei Projektmanagern geteilte Tabellen verfolgt, kann nicht auf eine Plattform migrieren, die eine andere Datenstruktur erzwingt. Die Tabelle ist die Plattform. Der KI-Extraktionsschritt speist sie ein – und hört dort auf.
Für Außendienstmitarbeiter, die Zähler, Messgeräte, Anzeigen und handschriftliche Ablesungen fotografieren, bedeutet dies, dass Zählerstände direkt von Feldaufnahmen in Excel fließen, ohne Zwischenschritte. Für Betriebsleiter, die Teams zu abgelegenen Standorten schicken, um Betriebsstundenzähler, Tankfüllstände oder Druckmesswerte zu fotografieren, wird jedes Feldbild in Sekunden zu Tabellendaten. Der Außendienstmitarbeiter macht dasselbe Foto. Die Tabelle erhält dieselben Daten. Das Einzige, was entfernt wurde, ist die Tastatur dazwischen.
FAQ
Wie genau liest KI Daten aus Feldaufnahmen?
Bei gedrucktem Text und digitalen Anzeigen – Zählerstände, Geräteablesungen, getippte Lieferscheine – liegt die Genauigkeit bei bis zu 99 %. Bei handschriftlichen Feldnotizen hängt die Genauigkeit von der Leserlichkeit der Handschrift ab. Klare, getrennte Zeichen werden zuverlässig erkannt. Schreibschrift, starke Verschmutzungen oder extrem schräge Aufnahmen verringern die Genauigkeit und können manuelle Korrekturen erfordern. Die KI-Extraktion eignet sich am besten als prüfbasierter Workflow: Sie kontrollieren markierte Werte, anstatt jeden Wert einzutippen.
Funktioniert das mit den verschiedenen Zählermodellen und Formularlayouts, die unsere Außenteams vorfinden?
Ja. Da die Extraktion semantisch erfolgt – basierend auf der Bedeutung der Daten, nicht ihrer Position – verarbeitet die KI Formatabweichungen ohne Neukonfiguration. Ein Zählerableser kann auf derselben Route analoge Zifferblätter, digitale LCD-Anzeigen und geprägte Metallschilder fotografieren, und die KI findet den Ablesewert auf allen mit derselben Spaltendefinition. Dies ist der grundlegende Unterschied zur vorlagenbasierten OCR.
Was ist mit handschriftlichen Feldnotizen und Checklisten?
Die KI liest handschriftlichen Text auf Feldformularen, Protokollbögen und Checklisten. Die Leistung ist am besten bei Druckschrift und klar getrennten Zeichen. Gemischte gedruckte und handschriftliche Formulare – üblich bei Umweltüberwachungsprotokollen, bei denen das Formular vorgedruckt ist und der Techniker die Werte von Hand einträgt – funktionieren gut, da die KI sich an den gedruckten Bezeichnungen orientieren und die handschriftlichen Werte im Kontext interpretieren kann.
Welche Fotoqualität ist erforderlich?
Das Foto muss klar genug sein, dass eine Person die Daten daraus lesen könnte. Die meisten modernen Smartphone-Kameras liefern bei Tageslicht Bilder, die weit über dieser Schwelle liegen. Blitzlichtaufnahmen in dunklen Zählerkästen, schräge Aufnahmen und Fotos mit etwas Schatten oder Spiegelung werden in der Regel korrekt verarbeitet. Stark unscharfe Bilder, Fotos aus extremen Winkeln, bei denen Ziffern verkürzt dargestellt werden, oder Bilder, bei denen die Zieldaten teilweise verdeckt sind, liefern unzuverlässige Ergebnisse.
Können mehrere Feldaufnahmen gleichzeitig verarbeitet werden?
Ja. Die Stapelverarbeitung ist fest in das Tool integriert: Laden Sie alle Fotos einer Feldroute, eines Probenahmedurchgangs oder eines Tages Lieferbelege in einem einzigen Stapel hoch, definieren Sie die zu extrahierenden Spalten, und die KI verarbeitet sie gemeinsam – alle Ergebnisse werden in einer Tabelle zusammengeführt. Eine 200-Fotos-Route eines Zählerablesers wird als ein Stapel verarbeitet und erzeugt eine Tabelle mit 200 Zeilen Zählerständen.
Funktioniert das auch offline im Feld?
Außendienstmitarbeiter benötigen keine Verbindung. Sie machen Fotos wie gewohnt mit ihren Handys – die Kamera-App funktioniert offline. Die Fotos werden hochgeladen, sobald das Gerät wieder verbunden ist, entweder vom Außendienstmitarbeiter am Ende der Route oder von Büropersonal, das die Fotos erhält. Die KI-Extraktion erfolgt serverseitig nach dem Upload.
Was ist der Unterschied zu Datenerfassungs-Apps wie Fulcrum oder GoFormz?
Diese Plattformen ersetzen das Papierformular durch ein digitales Formular, das Außendienstmitarbeiter auf einem Gerät ausfüllen. Das erfordert eine Verhaltensänderung – Mitarbeiter müssen eine neue Oberfläche erlernen, Dropdowns bedienen und unter Feldbedingungen auf einem Touchscreen tippen. Die KI-Fotoextraktion behält das bestehende Feldverhalten bei – ein Foto machen – und automatisiert den nachgelagerten Übertragungsschritt im Büro. Es ist ein anderer Eingriffspunkt in der Prozesskette.
Dateien werden sicher verarbeitet und nicht gespeichert.