Le goulot d'étranglement des données de terrain
que personne ne mesure
Une ingénieure géotechnicienne se tient au bord d'un forage dans l'ouest du Colorado, ouvre son téléphone et photographie le journal d'échantillonnage à la cuillère fendue. Type de sol : sable limoneux avec gravier. Profondeur : 14,5 pieds. Nombre de coups : 23. La photo capture tout — le journal manuscrit, le repère de profondeur, l'horodatage. Puis elle remet le téléphone dans sa veste et se dirige vers l'emplacement suivant. Plus tard, quelqu'un au bureau de Denver ouvrira cette photo, lira l'écriture manuscrite et saisira chaque donnée dans un tableur. Cette étape de saisie a consommé environ 200 jours-homme dans l'industrie géotechnique l'an dernier — et presque personne ne la budgétise. La photo existe. Les données existent. La vraie question est de savoir pourquoi les deux ne se connectent pas sans un clavier entre eux.
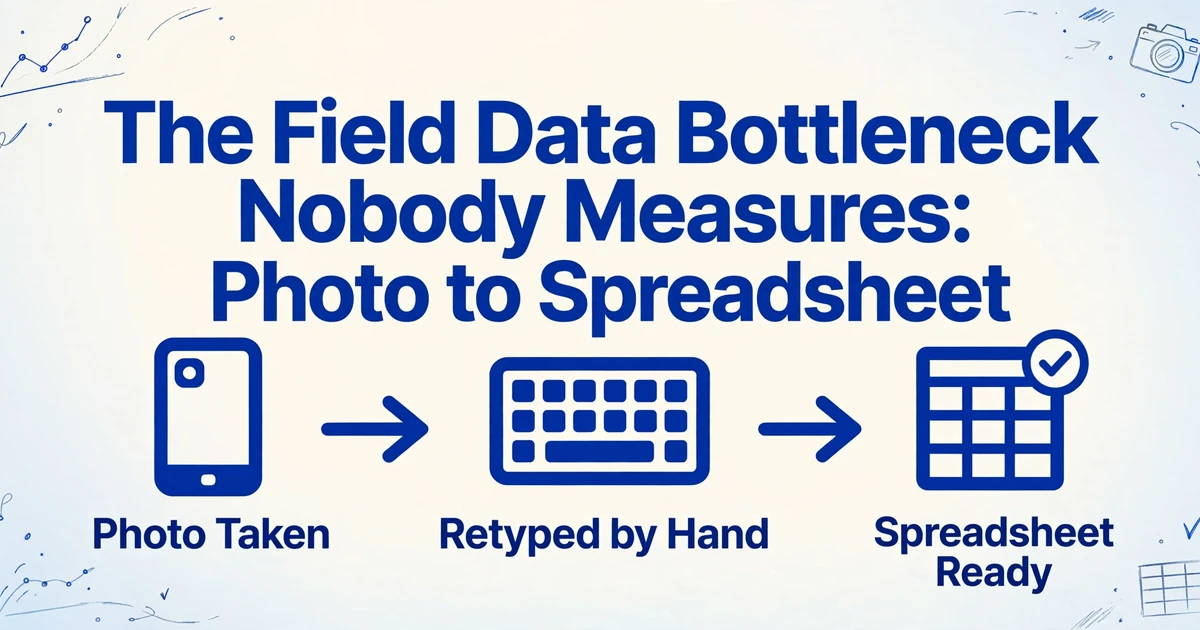
La photo que vous avez déjà
Les travailleurs de terrain, tous secteurs confondus, partagent un même réflexe : ils photographient tout. Un releveur de compteur photographie le registre chiffré avant de passer à la maison suivante. Un chef de chantier photographie le bon de livraison face au ciel du matin. Un technicien environnemental photographie le relevé de profondeur de la nappe d'un puits de surveillance, les mains couvertes de boue. Un responsable agricole photographie une sonde de sol à 24 pouces, la carotte posée à côté d'une étiquette numérotée.
Ces photos ne sont pas superflues : elles constituent le principal mécanisme de capture de données pour des millions d'observations de terrain chaque jour. Pourtant, dans la grande majorité des opérations de terrain, une photographie est considérée comme une aide-mémoire, pas comme une source de données. Les données contenues dans la photo — les chiffres, les cases à cocher, les notes manuscrites — doivent encore passer par un clavier humain avant d'entrer dans un système capable de les calculer, de les comparer ou d'en faire un rapport.
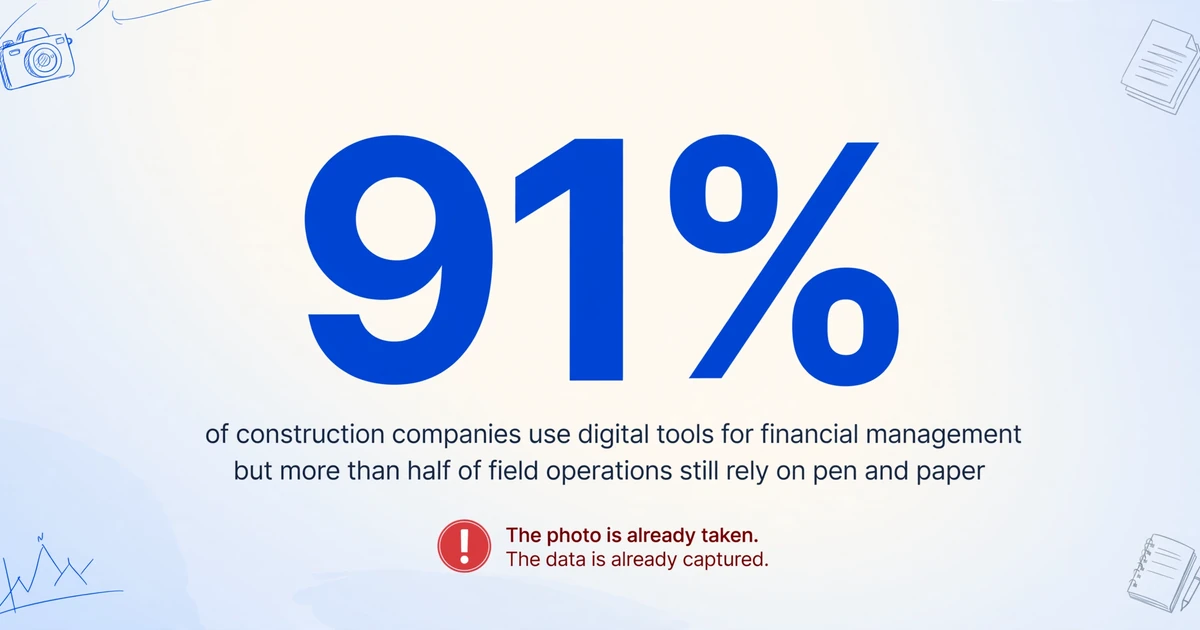
L'ampleur de cet écart est documentée, mais rarement reliée spécifiquement au problème de la photo. Un rapport d'Intuit de 2025, cité par Construction Dive, a révélé que 91 % des entreprises de construction utilisent des outils numériques pour la gestion financière — mais plus de la moitié des opérations de terrain reposent encore sur le papier et le stylo. Le marché mondial des applications de collecte de données de terrain était évalué à 1,97 milliard de dollars en 2024, avec une croissance de 14,2 % par an — mais ces applications ne résolvent que l'amont, en remplaçant les formulaires papier par des formulaires numériques. Elles ne traitent pas le scénario bien plus courant : la photo est déjà prise. La donnée est déjà capturée. Quelqu'un la retape encore.
Le goulot d'étranglement des données de terrain que la plupart des responsables d'exploitation n'isolent jamais n'est pas la collecte de données. C'est l'heure entre la photo et le tableur — une étape sans ligne budgétaire formelle, sans outil d'automatisation, et avec un taux d'erreur qui s'amplifie à chaque frappe.
Les 30 minutes que personne ne budgète
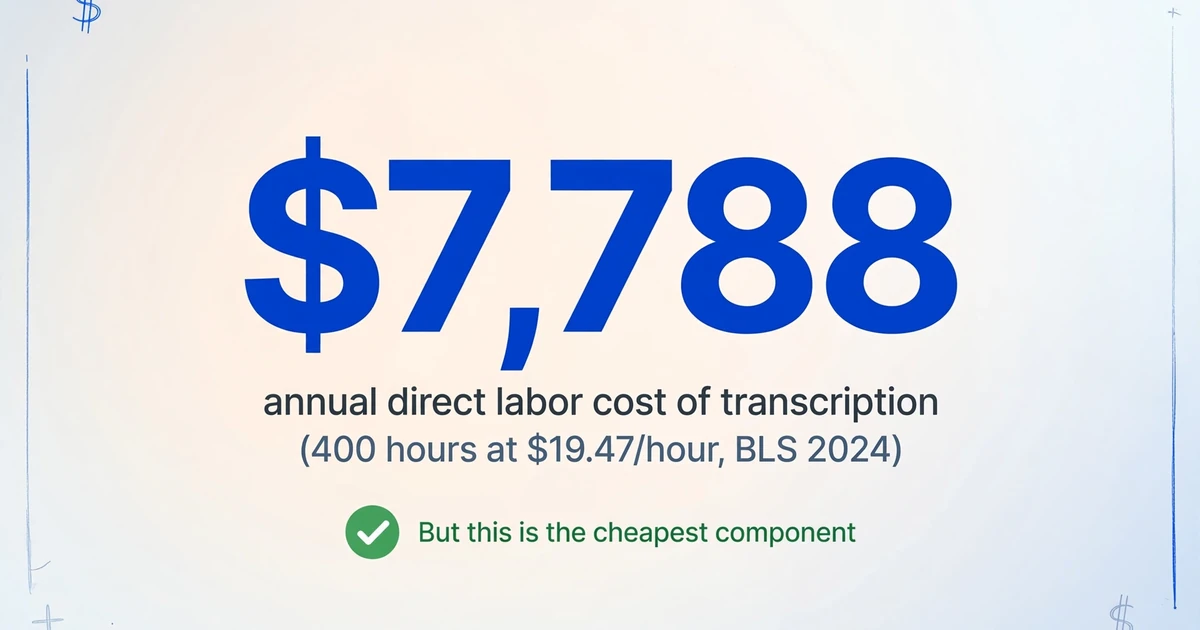
Sur un fil de discussion de r/Contractor consacré aux méthodes de journal quotidien, un chef de chantier a indiqué consacrer 30 à 60 minutes chaque jour à remplir un rapport journalier de chantier. Le coût côté bureau — un administrateur de projet ou un chef de projet qui reprend ces rapports et saisit manuellement les effectifs, les heures, l'utilisation des équipements et les observations de sécurité dans un tableur de suivi — ajoute 30 à 60 minutes par rapport. Sur une année de projet de 200 jours ouvrés avec deux sites actifs, cela représente 200 à 400 heures à ressaisir des données à partir de photos et de notes de terrain.
Multipliez cela par secteur. Un cabinet de conseil en environnement mobilisant cinq équipes de terrain qui collectent des données de surveillance des eaux souterraines sur 20 puits chacune. Chaque puits nécessite la profondeur de la nappe, le pH, la conductivité, la température et l'oxygène dissous — cinq points de données. Cela fait 500 points de données par campagne d'échantillonnage, photographiés sur des porte-blocs ou notés dans des carnets imperméables, puis transcrits au bureau par un technicien junior qui ne s'est pas rendu sur le site et doit interpréter une écriture manuscrite, de l'encre brouillée et des notations de terrain abrégées.
La structure de coûts de cette étape de transcription comporte trois composantes, et la plupart des responsables d'exploitation n'en suivent qu'une :
Ces trois coûts figurent rarement sur le même tableur. La main-d'œuvre directe relève du budget de paie. La correction des erreurs se disperse entre reprises, notes de crédit et appels clients. Le coût du retard est invisible — c'est le problème qui n'a pas été détecté à temps. Les isoler au même endroit révèle un schéma constant : l'étape de transcription est là où le pipeline fuit.
Quatre secteurs, même schéma
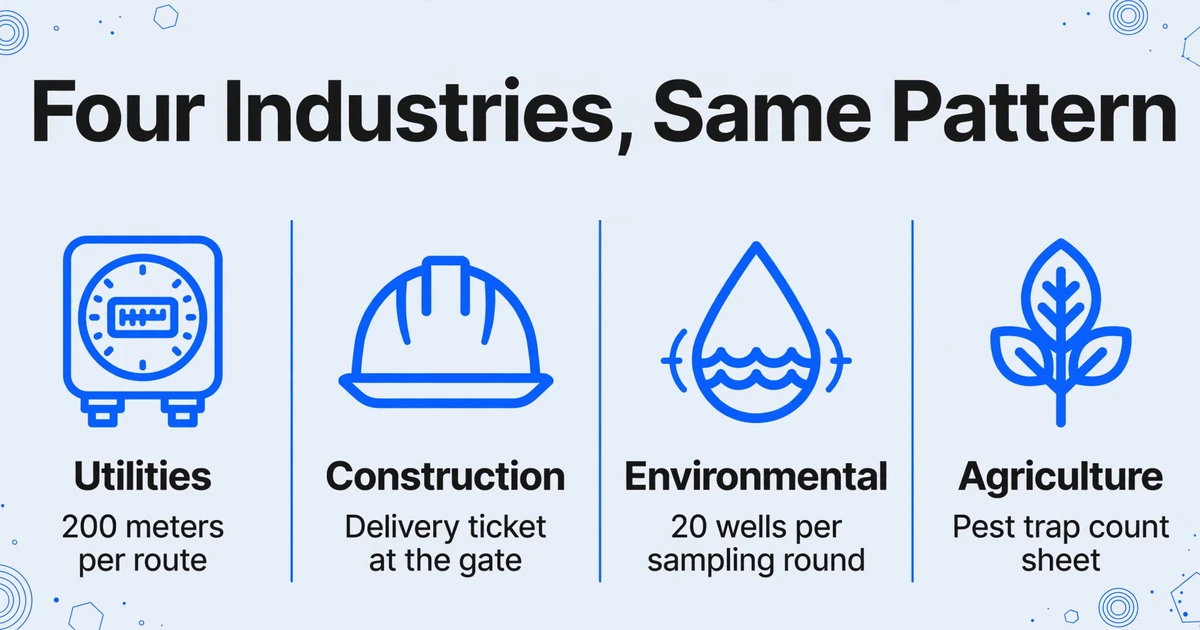
L'écart entre la photo et le tableur n'est propre à aucun secteur. Ce qui frappe, c'est à quel point le schéma est identique dans des secteurs qui n'ont rien d'autre en commun.
Services publics. Un releveur de compteurs d'un petit district d'eau du Pacific Northwest photographie 200 index de compteurs par tournée. L'index affiche un numéro à six chiffres ; la photo capture aussi l'ID du compteur estampillé sur le couvercle. De retour au bureau, un agent de facturation ouvre chaque photo, lit les chiffres et les saisit dans la colonne Current Reading d'un tableur de facturation. Une seule inversion — taper 856421 au lieu de 856241 — crée une erreur de facturation pour laquelle l'abonné appellera. Un service public avec 3 000 compteurs relevés chaque mois génère 36 000 événements de transcription par an. À un taux d'erreur prudent de 0,5 %, cela fait 180 erreurs par an. Chacune de ces erreurs entraîne un appel d'abonné et un cycle de correction qui coûte bien plus que le taux horaire de l'agent de facturation. Pour les services publics qui intègrent l'extraction par IA dans ce pipeline précis sans perturber les formules en aval, consultez notre guide d'intégration du relevé de compteur à la facturation.
Construction. Un chef de chantier photographie un bon de livraison de béton au portail du chantier. Le bon indique les yards cubes livrés, le numéro de formulation, l'heure de gâchée et le numéro du camion. L'ingénieur projet a besoin de ces données pour vérifier les quantités par rapport à la demande de paiement du sous-traitant — mais il les obtient cinq jours plus tard, quand quelqu'un les saisit dans le tableur de contrôle de projet. La réponse du secteur a été de numériser tout le rapport journalier via des plateformes comme Procore, Fieldwire et Raken — mais les discussions sur r/Construction révèlent une réalité tenace : beaucoup d'entrepreneurs petits et moyens ne peuvent pas justifier le coût par utilisateur des plateformes d'entreprise. Ils font tourner leurs opérations avec Excel et des photos stockées sur un lecteur partagé. Leurs chefs de chantier prennent les photos. Quelqu'un saisit les chiffres. Ce pipeline ne sera pas remplacé par un contrat logiciel à six chiffres — mais il peut être raccourci en supprimant l'étape de saisie.
Surveillance environnementale. Les techniciens de terrain photographient les relevés de puits de surveillance, les mesures de limnimètres et les résultats de sondes de gaz du sol. Ces photos deviennent ensuite le document source des rapports de conformité soumis aux agences environnementales des États. EarthSoft, un fournisseur de premier plan de gestion des données environnementales, a décrit le flux de travail traditionnel dans son blog : « Les données de terrain étaient collectées sur des formulaires papier ou des tableurs, puis transcrites sous une forme numérique au bureau. La conversion de ces données manuelles en données numériques pour les rapports comprenait diverses étapes qui commençaient souvent par déchiffrer les formulaires de terrain et les saisir dans des tableaux, ce qui pouvait introduire des erreurs de transcription et mener à une méfiance à l'égard des données. » L'expression « méfiance à l'égard des données » résume la conséquence en aval : lorsque les données de terrain ont été ressaisies manuellement, personne n'est tout à fait sûr que les chiffres du rapport correspondent à ceux du journal d'origine.
Agriculture. Un scout agricole photographie une fiche de comptage des ravageurs, manuscrite sur un porte-bloc dans le champ. La photo capture la date, l'ID du champ, le numéro du piège et le comptage des ravageurs. Ces données doivent parvenir au tableur de gestion de l'exploitation avant que la décision de pulvérisation ne soit prise — idéalement en quelques heures, pas en quelques jours. L'inventaire des cas d'usage de l'IA du USDA lui-même, publié en 2025, liste l'extraction automatisée de données à partir de formulaires et de factures comme un déploiement actif : « Le personnel est surchargé par la gestion manuelle des documents, ce qui réduit le temps consacré aux tâches stratégiques à forte valeur ajoutée. » Si le USDA considère l'extraction photo-vers-données suffisamment mature pour la déployer dans ses agences, la technologie a franchi le seuil de l'expérimental à l'opérationnel.
Dans les quatre scénarios, la photo existe. Les données qu'elle contient sont lisibles. La valeur de ces données augmente d'autant plus vite qu'elles atteignent le tableur. Et l'étape de transcription est la seule qui peut être supprimée sans rien changer à ce que fait le travailleur de terrain.
Pourquoi les formulaires numériques ne sont pas la solution — et pourquoi votre équipe ne les utilise pas
La prescription standard du secteur pour les problèmes de données de terrain est une plateforme mobile de formulaires numériques : donner à chaque travailleur de terrain une tablette avec un formulaire personnalisé, le laisser saisir ou toucher ses données directement, synchroniser vers le cloud. Cette approche représente un marché de 1,97 milliard de dollars en croissance. Elle présente aussi un problème d'adoption bien documenté.
Les obstacles ne sont pas techniques — ils sont comportementaux et opérationnels. Les travailleurs de terrain portant des gants ne peuvent pas utiliser un écran tactile. La boue, la pluie et la lumière directe du soleil rendent les tablettes inutilisables sur les chantiers, les fermes et les plateformes de puits. Un appareil photo de téléphone utilisé d'une seule main — même gantée — capture le relevé en deux secondes. Saisir le même relevé dans un formulaire sur le même téléphone prend 10 à 15 secondes et introduit des erreurs de saisie au moment de la capture. Lorsqu'un technicien de terrain a 200 arrêts sur une tournée, la différence entre une photo de deux secondes et une saisie de formulaire de 15 secondes représente 43 minutes de temps de terrain supplémentaire par tournée — un temps qui n'existe pas dans le planning.
C'est pourquoi la photo persiste. Non pas parce que les travailleurs de terrain résistent à la technologie, mais parce que l'appareil photo est l'outil de capture de données le plus rapide et le plus fiable disponible dans les conditions de terrain. Il ne nécessite aucune navigation dans les menus, aucune sélection dans une liste déroulante, aucune validation de champ — il suffit de pointer et de photographier. Le problème n'est pas que la photo soit une source de données inférieure. Le problème est ce qui arrive — ou n'arrive pas — à la photo après sa prise.
La photo n'est pas le problème. L'écart entre la photo et le tableur est le problème. Et combler cet écart ne nécessite pas de changer ce que font les travailleurs de terrain. Il nécessite de changer ce qui se passe lorsque la photo arrive au bureau.
Ce qui change vraiment quand l'étape de retranscription disparaît
L'extraction de documents par IA modifie exactement une étape dans le pipeline de données terrain : la transcription. L'agent terrain photographie toujours le compteur, le bon de livraison, la lecture du piézomètre, la feuille de décompte des nuisibles. La photo arrive toujours au bureau. Mais au lieu qu'une personne l'ouvre et tape ce qu'elle voit, l'IA lit directement la photo — extrayant les points de données spécifiques nécessaires et les insérant dans les colonnes du tableur.
Cette approche — qu'ImageToTable.ai appelle Extraction Personnalisée de Colonnes — fonctionne différemment de l'OCR traditionnel basé sur des modèles. L'OCR par modèle exige de définir où se trouve chaque donnée sur la page : « la lecture du compteur est dans le cadre en haut à droite, coordonnées X, Y ». Quand la mise en page du formulaire change — un bon de livraison d'un fournisseur différent, un nouveau format de relevé piézométrique — le modèle se casse. L'Extraction Personnalisée de Colonnes adopte l'approche inverse : vous nommez les données souhaitées (« Lecture du compteur », « Mètres cubes », « pH », « Décompte des nuisibles »), et l'IA localise chaque valeur en comprenant ce qu'elle signifie — pas où elle se trouve sur la page. L'agent terrain peut photographier une douzaine de modèles de compteurs, de formats de bons de livraison ou de relevés piézométriques différents, et l'IA trouve les valeurs cibles sur tous sans reconfiguration.
C'est la différence cruciale pour les workflows terrain. Les données terrain n'arrivent pas dans des formats cohérents. Un releveur de compteurs rencontre des cadrans analogiques, des affichages numériques et des plaques métalliques embouties — tout cela sur un seul parcours. Un chef de chantier photographie des bons de livraison de cinq fournisseurs de béton différents, chacun avec sa propre mise en page. Un technicien environnemental photographie des équipements de surveillance de trois fabricants. L'Extraction Personnalisée de Colonnes gère cette variabilité car elle lit pour le sens, pas pour la position.
Ce qui change sur le plan opérationnel :
Pour un service des eaux traitant 3 000 relevés de compteur par mois, le calcul est simple. La transcription manuelle prend 30 à 60 minutes pour 100 relevés — soit environ 15 à 30 heures par mois pour 3 000 compteurs. Au salaire médian du BLS de 19,47 $ de l'heure, cela représente 292 à 584 $ par mois en main-d'œuvre de transcription directe, plus le coût de 15 à 30 erreurs de facturation nécessitant des appels clients et des corrections. L'extraction par IA réduit l'étape administrative de la saisie à la vérification — environ 10 % du temps initial. Les économies sont immédiates, et le tableur de facturation — avec ses tranches tarifaires soigneusement construites, ses formules de surtaxe d'assainissement et ses calculs de dates d'échéance — reste totalement intact. L'IA ne remplit que la colonne Relevé actuel. Chaque formule à sa droite continue de fonctionner exactement comme avant.
Pour les équipes qui gèrent des données de terrain provenant de plusieurs opérateurs sur plusieurs sites, la fonction Lien de collecte va encore plus loin : les opérateurs téléversent leurs photos directement via un lien partagé — sans compte, sans connexion, sans application — et les photos atterrissent automatiquement dans la file d'attente de traitement du bureau. Le personnel du bureau ne touche aux photos qu'après leur extraction en lignes de tableur, prêtes à être vérifiées. Cela élimine la chaîne d'e-mails, le dossier partagé et le problème de « qui a la dernière version » qui gangrène les workflows de terrain basés sur des photos. Pour les équipes qui utilisent des formulaires d'inspection et listes de contrôle terrain, le même pipeline d'extraction traite les cases à cocher, les notes manuscrites et les champs mixtes imprimés-manuscrits en une seule passe — sans étape de traitement séparée pour chaque type de champ.
Le pipeline qui ne bouge pas
Le plus important, quand l'extraction par IA remplace la saisie manuelle, c'est que tout ce qui se trouve en aval de la saisie de données reste inchangé. Le tableur avec ses calculs de taux, le modèle de rapport de conformité, le format d'exportation de facturation — rien ne bouge. L'IA remplit les colonnes d'entrée. Les formules, macros et routines d'exportation qui ont pris des mois à construire et valider continuent de fonctionner sur les mêmes positions de colonnes avec les mêmes types de données. Le tableur ne sait pas et ne se soucie pas de savoir si le nombre dans la cellule C2 est arrivé par frappe ou par extraction IA.
Ce n'est pas un détail mineur. C'est la raison pour laquelle l'automatisation des données terrain a pris du retard par rapport à d'autres automatisations de processus métier. Les plateformes d'entreprise exigent de reconstruire l'intégralité de votre workflow autour de leur modèle de données. Une compagnie d'électricité qui a passé des années à peaufiner son tableur de facturation — tarifs progressifs qui changent selon les saisons, surtaxes d'assainissement qui diffèrent selon la classe de client, dates d'échéance calculées à partir des cycles de facturation — ne peut pas se permettre d'abandonner ces formules pour un module de facturation d'un fournisseur. Une entreprise de construction qui suit la productivité de la main-d'œuvre dans des tableurs partagés par trois chefs de projet ne peut pas migrer vers une plateforme qui impose une structure de données différente. Le tableur est la plateforme. L'étape d'extraction IA l'alimente — et s'arrête là.
Pour les opérateurs terrain qui photographient des compteurs, jauges, affichages et relevés manuscrits, cela signifie que les relevés de compteurs arrivent directement dans Excel depuis les photos terrain, sans étapes intermédiaires. Pour les responsables d'exploitation qui envoient des équipes photographier des compteurs horaires, des jauges de niveau de réservoir ou des relevés de pression sur des sites distants, toute photo terrain devient une donnée de tableur en quelques secondes. L'opérateur prend la même photo. Le tableur reçoit les mêmes données. La seule chose qui disparaît, c'est le clavier entre les deux.
FAQ
Quelle est la précision de l'IA pour lire les données sur des photos de terrain ?
Pour les textes imprimés et les affichages numériques — compteurs, relevés d'équipement, bons de livraison tapés — la précision atteint jusqu'à 99 %. Pour les notes manuscrites, la précision dépend de la lisibilité de l'écriture. Des caractères clairs et séparés sont lus de manière fiable. L'écriture cursive, les taches importantes ou les photos prises sous un angle extrême réduisent la précision et peuvent nécessiter une correction manuelle. L'extraction par IA fonctionne mieux comme un flux de vérification : vous contrôlez les valeurs signalées plutôt que de saisir chaque valeur.
Cela fonctionne-t-il avec les différents modèles de compteurs et formats de formulaires rencontrés par nos équipes terrain ?
Oui. Comme l'extraction est sémantique — basée sur la signification des données, pas sur leur emplacement — l'IA gère les variations de format sans reconfiguration. Un releveur peut photographier des cadrans analogiques, des écrans LCD numériques et des plaques métalliques estampillées sur un même parcours, et l'IA localisera la valeur de relevé sur tous ces supports en utilisant la même définition de colonne. C'est la différence fondamentale avec l'OCR basé sur des modèles.
Qu'en est-il des notes manuscrites et des listes de contrôle de terrain ?
L'IA lit les textes manuscrits sur les formulaires de terrain, les feuilles de relevés et les listes de contrôle. Les performances sont optimales sur les lettres majuscules et les caractères clairement séparés. Les formulaires mixtes imprimés et manuscrits — courants dans les journaux de surveillance environnementale où le formulaire est pré-imprimé et le technicien remplit les valeurs à la main — fonctionnent bien car l'IA peut s'appuyer sur les étiquettes imprimées et interpréter les valeurs manuscrites en contexte.
Quelle qualité de photo est requise ?
La photo doit être suffisamment nette pour qu'une personne puisse y lire les données. La plupart des appareils photo des smartphones modernes, à la lumière du jour, produisent des images bien au-dessus de ce seuil. Les photos avec flash dans des coffrets de compteurs sombres, les prises de vue inclinées et les photos présentant de l'ombre ou des reflets sont généralement traitées correctement. Les images fortement floues, les photos prises sous des angles extrêmes où les chiffres sont raccourcis, ou les images où les données cibles sont partiellement masquées produiront des résultats peu fiables.
Peut-on traiter plusieurs photos terrain en une seule fois ?
Oui. Le traitement par lots est intégré à l'outil : importez toutes les photos d'une tournée terrain, d'un cycle d'échantillonnage ou d'une journée de bons de livraison en un seul lot, définissez les colonnes à extraire, et l'IA les traite ensemble — en fusionnant tous les résultats dans un seul tableur. Une tournée de 200 photos d'un releveur de compteurs est traitée en un seul lot, produisant un tableur avec 200 lignes de relevés.
Fonctionne-t-il hors ligne sur le terrain ?
Les agents terrain n'ont pas besoin de connexion. Ils prennent des photos avec leur téléphone comme d'habitude — l'appareil photo fonctionne hors ligne. Les photos sont téléchargées lorsque l'appareil se reconnecte, soit par l'agent en fin de tournée, soit par le personnel de bureau qui reçoit les photos. L'extraction par IA s'effectue côté serveur après le téléchargement.
En quoi est-ce différent des applications de collecte terrain comme Fulcrum ou GoFormz ?
Ces plateformes remplacent le formulaire papier par un formulaire numérique que les agents remplissent sur un appareil. Cela nécessite un changement de comportement — les agents doivent apprendre une nouvelle interface, naviguer dans des menus déroulants et taper sur un écran tactile en conditions terrain. L'extraction par IA conserve le comportement terrain existant — prendre une photo — et automatise l'étape de transcription en back-office. C'est un point d'intervention différent dans la chaîne.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.