O Gargalo de Dados de Campo
Que Ninguém Mede
Uma engenheira geotécnica está na beira de um furo de sondagem no oeste do Colorado, abre o celular e fotografa o registro da amostra de colher partida. Tipo de solo: areia siltosa com cascalho. Profundidade: 14,5 pés. Contagem de golpes: 23. A foto captura tudo — o registro manuscrito, o marcador de profundidade, o carimbo de data e hora. Depois ela guarda o celular no colete e segue para o próximo local. Mais tarde, alguém no escritório de Denver vai abrir essa foto, ler a caligrafia e digitar cada dado em uma planilha. Essa etapa de digitação consumiu cerca de 200 dias úteis em toda a indústria geotécnica no ano passado — e quase ninguém reserva orçamento para isso. A foto existe. Os dados existem. A verdadeira questão é por que os dois não se conectam sem um teclado no meio.
A Foto Que Você Já Tem
Trabalhadores de campo em diversos setores compartilham um comportamento: eles fotografam tudo. Um leiturista de medidor de concessionária fotografa o registro numérico antes de seguir para a próxima casa. Um superintendente de obra fotografa a nota de entrega contra o céu da manhã. Um técnico ambiental fotografa a leitura de profundidade do lençol freático de um poço de monitoramento, com as mãos enlameadas. Um gerente agrícola de campo fotografa uma sonda de solo a 24 polegadas, com a amostra do núcleo ao lado de uma etiqueta numerada.
Essas fotos não são supérfluas — são o principal mecanismo de captura de dados para milhões de observações de campo por dia. E, no entanto, na grande maioria das operações de campo, uma fotografia é considerada um auxílio de memória, não uma fonte de dados. Os dados dentro da foto — os números, as caixas de seleção, as anotações manuscritas — ainda precisam passar por um teclado humano antes de entrar em qualquer sistema capaz de calcular, comparar ou gerar relatórios sobre eles.
A dimensão dessa lacuna está documentada, mas raramente é relacionada especificamente ao problema da foto. Um relatório de 2025 da Intuit, citado pela Construction Dive, constatou que 91% das empresas de construção usam ferramentas digitais para gestão financeira — mas mais da metade das operações de campo ainda depende de papel e caneta. O mercado global de aplicativos de coleta de dados de campo foi avaliado em $1,97 bilhão em 2024, crescendo 14,2% ao ano — mas esses aplicativos resolvem a ponta inicial, substituindo formulários em papel por digitais. Eles não abordam o cenário muito mais comum: a foto já foi tirada. O dado já foi capturado. Alguém ainda o digita novamente.
O gargalo dos dados de campo que a maioria dos gerentes de operações nunca isola não é a coleta de dados. É a hora entre a foto e a planilha — uma etapa que não tem linha orçamentária formal, nem ferramenta de automação, e uma taxa de erro que se acumula a cada tecla digitada.
Os 30 minutos que ninguém inclui no orçamento
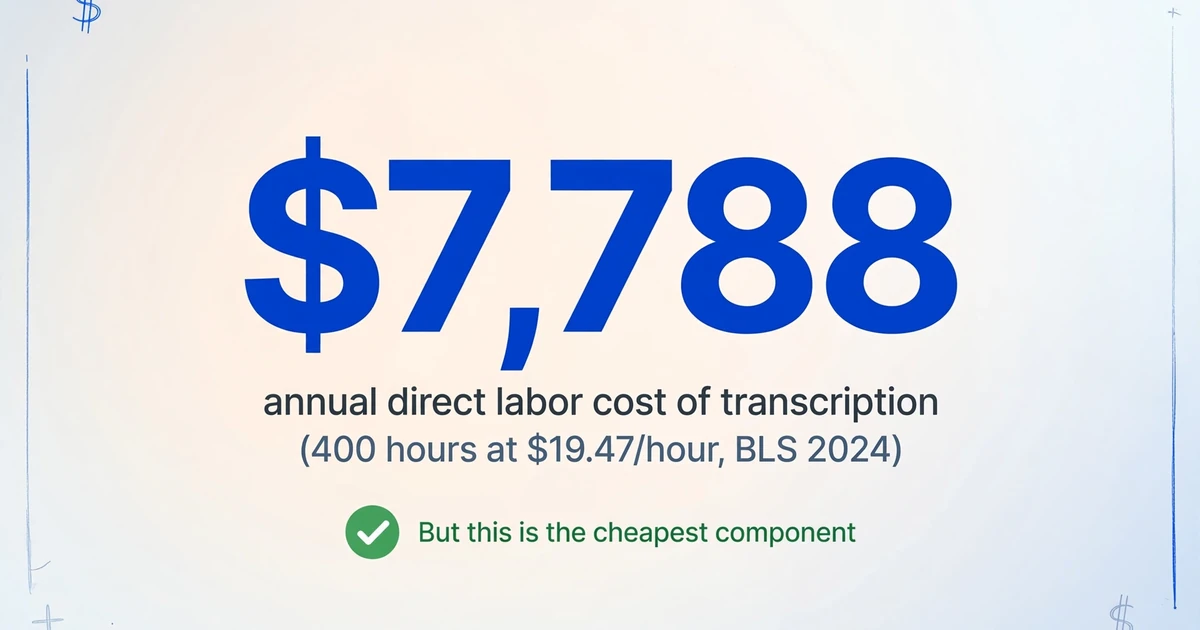
Em uma thread de discussão no r/Contractor sobre métodos de registro diário, um superintendente relatou gastar de 30 a 60 minutos todos os dias preenchendo um relatório diário de obra. O custo do lado do escritório — um administrador de projeto ou PM que pega esses relatórios e insere manualmente contagens de equipe, horas, uso de equipamentos e observações de segurança em uma planilha de acompanhamento — acrescenta mais 30 a 60 minutos por relatório. Em um ano de projeto com 200 dias úteis e dois canteiros ativos, isso representa de 200 a 400 horas redigitando dados de fotos e anotações de campo.
Multiplique isso por diversos setores. Uma consultoria ambiental com cinco equipes de campo coletando dados de monitoramento de águas subterrâneas em 20 poços cada. Cada poço exige nível d'água, pH, condutividade, temperatura e oxigênio dissolvido — cinco pontos de dados. São 500 pontos de dados por rodada de amostragem, fotografados em pranchetas ou anotados em cadernos à prova d'água, e depois transcritos no escritório por um técnico júnior que não visitou o local e precisa interpretar caligrafia, tinta borrada e notações de campo abreviadas.
A estrutura de custos dessa etapa de transcrição tem três componentes, e a maioria dos gerentes de operações acompanha apenas um:
Esses três custos raramente aparecem na mesma planilha. A mão de obra direta fica no orçamento de folha de pagamento. A correção de erros se dispersa entre retrabalho, notas de crédito e ligações de clientes. O custo do atraso é invisível — é o problema que não foi detectado a tempo. Isolá-los em um só lugar revela um padrão consistente: a etapa de transcrição é onde o fluxo vaza.
Quatro Setores, o Mesmo Padrão
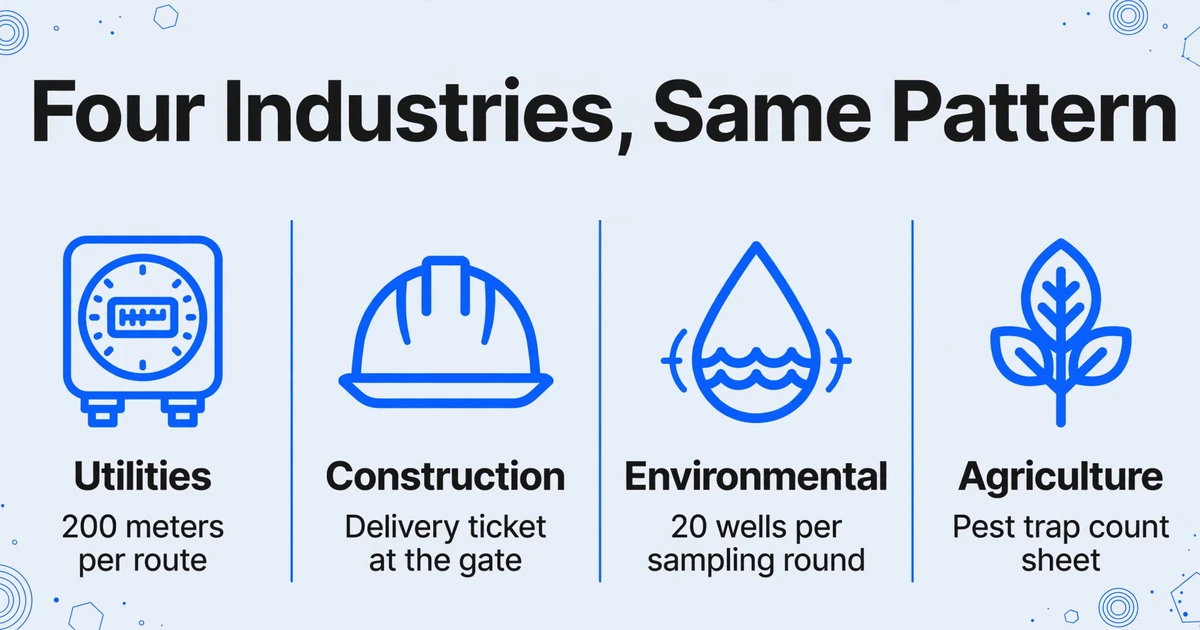
A lacuna entre foto e planilha não é exclusiva de nenhum setor. O que chama a atenção é como o padrão parece idêntico em setores que não têm nada mais em comum.
Serviços Públicos. Um leitor de medidores de um pequeno distrito de água no Noroeste Pacífico fotografa 200 registros de medidores por rota. O registro mostra um número de seis dígitos; a foto também captura o ID do medidor estampado na tampa. De volta ao escritório, um escriturário de faturamento abre cada foto, lê os dígitos e os digita na coluna Current Reading de uma planilha de faturamento. Uma única transposição — digitar 856421 como 856241 — cria um erro de faturamento sobre o qual o morador vai ligar. Uma concessionária com 3.000 medidores lidos mensalmente gera 36.000 eventos de transcrição por ano. A uma taxa de erro conservadora de 0,5%, isso dá 180 erros por ano. Cada um desses erros gera uma ligação de morador e um ciclo de correção que custa muito mais do que o valor da hora do escriturário de faturamento. Para concessionárias que integram a extração por IA exatamente nesse fluxo sem prejudicar as fórmulas subsequentes, consulte nosso guia de integração de leitura de medidor para faturamento.
Construção. Um superintendente fotografa uma nota de entrega de concreto no portão do canteiro de obras. A nota mostra jardas cúbicas entregues, número do traço, horário da batelada e número do caminhão. O engenheiro do projeto precisa desses dados para verificar as quantidades em relação ao pedido de pagamento do subcontratado — mas os recebe cinco dias depois, quando alguém os digita na planilha de controle do projeto. A resposta do setor tem sido digitalizar todo o relatório diário por meio de plataformas como Procore, Fieldwire e Raken — mas discussões no r/Construction revelam uma realidade persistente: muitos empreiteiros pequenos e médios não conseguem justificar o custo por assento das plataformas corporativas. Eles operam com Excel e fotos armazenadas em um drive compartilhado. Seus superintendentes tiram as fotos. Alguém digita os números. Esse fluxo não será substituído por um contrato de software de seis dígitos — mas pode ser encurtado removendo a etapa de digitação.
Monitoramento ambiental. Técnicos de campo fotografam leituras de poços de monitoramento, medições de réguas fluviais e resultados de sondagens de gás no solo. Essas fotos se tornam o documento de origem para relatórios de conformidade enviados a agências ambientais estaduais. A EarthSoft, fornecedora líder de gestão de dados ambientais, descreveu o fluxo de trabalho tradicional em seu blog: "Os dados de campo eram coletados em formulários de papel ou planilhas, que depois eram transcritos para algum formato digital no escritório. Transformar esses dados manuais em dados digitais para relatórios incluía várias etapas que muitas vezes começavam com a decifração dos formulários de campo e a digitação em tabelas, potencialmente introduzindo erros de transcrição que levavam à desconfiança nos dados." A expressão "desconfiança nos dados" captura a consequência posterior: quando os dados de campo foram redigitados manualmente, ninguém tem certeza absoluta de que os números no relatório correspondem aos números no registro original.
Agricultura. Um monitor de lavoura fotografa uma folha de contagem de pragas em armadilhas, escrita à mão em uma prancheta no campo. A foto captura a data, o ID do campo, o número da armadilha e a contagem de pragas. Esses dados precisam chegar à planilha de gestão da fazenda antes da decisão de pulverização — idealmente em horas, não em dias. O próprio inventário de casos de uso de IA do USDA, publicado em 2025, lista a extração automatizada de dados de formulários e faturas como uma implantação ativa: "A equipe está sobrecarregada com o manuseio manual de documentos, resultando em menos tempo para se concentrar em tarefas estratégicas de alto valor." Se o USDA considera a extração de foto para dados madura o suficiente para implantar em suas agências, a tecnologia cruzou o limiar do experimental para o operacional.
Em todos os quatro cenários, a foto existe. Os dados dentro dela são legíveis. O valor desses dados aumenta quanto mais rápido chegam à planilha. E a etapa de transcrição é a única parte que pode ser removida sem mudar nada do que o trabalhador de campo faz.
Por que formulários digitais não são a resposta — e por que sua equipe não os usa
A prescrição padrão do setor para problemas de dados de campo é uma plataforma móvel de formulários digitais: dar a cada trabalhador de campo um tablet com um formulário personalizado, deixá-los digitar ou tocar seus dados diretamente nele, sincronizar com a nuvem. Essa abordagem tem um mercado de US$ 1,97 bilhão e crescendo. Também tem um problema de adoção bem documentado.
As barreiras não são técnicas — são comportamentais e operacionais. Trabalhadores de campo usando luvas não conseguem operar uma tela sensível ao toque. Lama, chuva e luz solar direta tornam os tablets inutilizáveis em canteiros de obras, fazendas e plataformas de poços. Uma câmera de celular operada com uma mão — mesmo uma mão enluvada — captura a leitura em dois segundos. Digitar a mesma leitura em um formulário no mesmo celular leva de 10 a 15 segundos e introduz erros de entrada de dados no ponto de captura. Quando um técnico de campo tem 200 paradas em uma rota, a diferença entre uma foto de dois segundos e uma entrada de formulário de 15 segundos é de 43 minutos de tempo adicional em campo por rota — tempo que não existe na agenda.
É por isso que a foto persiste. Não porque os trabalhadores de campo resistem à tecnologia, mas porque a câmera é a ferramenta de captura de dados mais rápida e confiável disponível em condições de campo. Não exige navegação por menus, seleção em listas suspensas nem validação de campos — basta apontar e fotografar. O problema não é que a foto seja uma fonte de dados inferior. O problema é o que acontece — ou não acontece — com a foto depois de tirada.
A foto não é o problema. A lacuna entre a foto e a planilha é o problema. E fechar essa lacuna não exige mudar o que os trabalhadores de campo fazem. Exige mudar o que acontece quando a foto chega ao escritório.
O Que Realmente Muda Quando a Etapa de Redigitação Desaparece
A extração de documentos com IA altera exatamente uma etapa no pipeline de dados de campo: a transcrição. O trabalhador de campo ainda fotografa o medidor, o tíquete de entrega, a leitura do poço de monitoramento, a planilha de contagem de pragas. A foto ainda chega ao escritório. Mas, em vez de uma pessoa abri-la e digitar o que vê, a IA lê a foto diretamente — extraindo os pontos de dados específicos necessários e preenchendo-os nas colunas da planilha.
Essa abordagem — que o ImageToTable.ai chama de Extração Personalizada de Colunas — funciona de forma diferente do OCR tradicional baseado em modelos. O OCR por modelo exige que você defina onde cada ponto de dados está na página: "a leitura do medidor está na caixa superior direita, coordenadas X, Y." Quando o layout do formulário muda — um tíquete de entrega de um fornecedor diferente, um novo formato de registro de poço de monitoramento — o modelo quebra. A Extração Personalizada de Colunas adota a abordagem oposta: você nomeia os pontos de dados desejados ("Leitura do Medidor", "Jardas Cúbicas", "pH", "Contagem de Pragas"), e a IA localiza cada valor entendendo o que ele significa — não onde está na página. O trabalhador de campo pode fotografar uma dúzia de modelos diferentes de medidores, layouts de tíquetes de entrega ou formatos de registro de poço, e a IA encontra os valores-alvo em todos eles sem reconfiguração.
Esta é a diferença crítica para fluxos de trabalho de campo. Os dados de campo não chegam em formatos consistentes. Um leitor de medidores encontra mostradores analógicos, displays digitais e placas metálicas gravadas — tudo em uma única rota. Um superintendente de construção fotografa tíquetes de entrega de cinco fornecedores diferentes de concreto, cada um com seu próprio layout. Um técnico ambiental fotografa equipamentos de monitoramento de três fabricantes. A Extração Personalizada de Colunas lida com essa variabilidade porque lê pelo significado, não pela posição.
O que muda operacionalmente:
Para uma concessionária de água que processa 3.000 leituras mensais de medidores, a aritmética é simples. A transcrição manual leva 30–60 minutos por 100 leituras — cerca de 15 a 30 horas por mês para 3.000 medidores. No salário mediano do BLS de $19.47 por hora, isso representa $292 a $584 por mês em mão de obra direta de transcrição, mais o custo de 15 a 30 erros de faturamento que exigem ligações e correções com clientes. A extração por IA reduz a etapa do escritório de digitação para verificação — cerca de 10% do tempo original. A economia é imediata, e a planilha de faturamento — com suas faixas de tarifa cuidadosamente construídas, fórmulas de sobretaxa de esgoto e cálculos de vencimento — permanece completamente intacta. A IA preenche apenas a coluna Leitura Atual. Toda fórmula à direita dela continua funcionando exatamente como sempre funcionou.
Para equipes que gerenciam dados de campo de vários trabalhadores em vários locais, o recurso Link de Coleta amplia esse fluxo de trabalho: os trabalhadores de campo enviam suas fotos diretamente por um link compartilhado — sem conta, sem login, sem aplicativo — e as fotos caem automaticamente na fila de processamento do escritório. A equipe do escritório nunca toca nas fotos até que elas já estejam extraídas em linhas de planilha, prontas para verificação. Isso elimina a cadeia de e-mails, a pasta de drive compartilhada e o problema de "quem tem a versão mais recente" que assola os fluxos de trabalho de campo baseados em fotos. Para equipes que coletam formulários de inspeção de campo e listas de verificação, o mesmo pipeline de extração lida com caixas de seleção, anotações manuscritas e campos mistos (impressos e manuscritos) em uma única passagem — sem etapa de processamento separada para cada tipo de campo.
O Pipeline Que Não se Move
A coisa mais importante que não muda quando a extração por IA substitui a transcrição manual é tudo a jusante da etapa de entrada de dados. A planilha com seus cálculos de taxa, o modelo de relatório de conformidade, o formato de exportação de faturamento — nada disso se move. A IA preenche as colunas de entrada. As fórmulas, macros e rotinas de exportação que levaram meses para construir e validar continuam sendo executadas nas mesmas posições de coluna com os mesmos tipos de dados. A planilha não sabe nem se importa se o número na célula C2 chegou por digitação ou por extração de IA.
Isso não é um detalhe pequeno. É a razão pela qual a automação de dados de campo ficou para trás em relação a outras automações de processos de negócios. Plataformas empresariais exigem que você reconstrua todo o seu fluxo de trabalho em torno do modelo de dados delas. Uma concessionária que passou anos ajustando sua planilha de faturamento — tarifas escalonadas que mudam sazonalmente, sobretaxas de esgoto que diferem por classe de cliente, datas de vencimento calculadas a partir de ciclos de faturamento — não pode se dar ao luxo de abandonar essas fórmulas por um módulo de faturamento de um fornecedor. Uma construtora que acompanha a produtividade da mão de obra em planilhas compartilhadas por três gerentes de projeto não pode migrar para uma plataforma que force uma estrutura de dados diferente. A planilha é a plataforma. A etapa de extração por IA a alimenta — e para por aí.
Para trabalhadores de campo que fotografam medidores, mostradores, displays e leituras manuscritas, isso significa que as leituras de medidores fluem diretamente para o Excel a partir de fotos de campo, sem etapas intermediárias. Para gerentes de operações que enviam equipes para fotografar horímetros de equipamentos, medidores de nível de tanque ou leituras de pressão em locais remotos, qualquer foto de campo se torna dados de planilha em segundos. O trabalhador de campo tira a mesma foto. A planilha recebe os mesmos dados. A única coisa removida é o teclado no meio do caminho.
Perguntas Frequentes
Qual é a precisão da IA na leitura de dados de fotos de campo?
Para texto impresso e telas digitais — registros de medidores, leituras de equipamentos, tickets de entrega datilografados — a precisão chega a 99%. Para anotações manuscritas em campo, a precisão depende da legibilidade da caligrafia. Caracteres claros e separados são lidos de forma confiável. Letra cursiva, borrões intensos ou fotos com ângulo extremo reduzem a precisão e podem exigir correção manual. A extração por IA funciona melhor como um fluxo de verificação: você confere os valores sinalizados em vez de digitar cada um.
Funciona com os diferentes modelos de medidores e layouts de formulários que nossas equipes de campo encontram?
Sim. Como a extração é semântica — baseada no significado dos dados, não em sua posição — a IA lida com variações de formato sem reconfiguração. Um leitor de medidores pode fotografar mostradores analógicos, telas LCD digitais e placas de metal gravadas na mesma rota, e a IA localizará o valor da leitura em todos eles usando a mesma definição de coluna. Esta é a diferença fundamental do OCR baseado em modelos.
E quanto a anotações manuais e listas de verificação em campo?
A IA lê texto manuscrito em formulários de campo, folhas de registro e listas de verificação. O desempenho é melhor em letras de forma e caracteres claramente separados. Formulários mistos (impressos e manuscritos) — comuns em registros de monitoramento ambiental, onde o formulário é pré-impresso e o técnico preenche os valores à mão — funcionam bem porque a IA pode se ancorar nos rótulos impressos e interpretar os valores manuscritos no contexto.
Qual qualidade de foto é necessária?
A foto precisa ser clara o suficiente para que uma pessoa consiga ler os dados. A maioria das câmeras de smartphones modernos, com luz do dia, produz imagens bem acima desse limite. Fotos com flash em caixas de medidores escuras, fotos angulares e fotos com alguma sombra ou reflexo geralmente são processadas corretamente. Imagens severamente desfocadas, fotos em ângulos extremos onde os dígitos estão encurtados ou imagens onde os dados-alvo estão parcialmente obstruídos produzirão resultados não confiáveis.
É possível processar várias fotos de campo de uma só vez?
Sim. O processamento em lote é nativo da ferramenta: carregue todas as fotos de uma rota de campo, uma rodada de amostragem ou um dia de tickets de entrega em um único lote, defina as colunas que deseja extrair, e a IA processa tudo junto — mesclando todos os resultados em uma única planilha. A rota de 200 fotos de um leiturista é processada como um lote único, gerando uma planilha com 200 linhas de leituras de medidores.
A ferramenta funciona offline em campo?
Os trabalhadores de campo não precisam de conectividade. Eles tiram fotos com seus celulares como sempre fizeram — o aplicativo da câmera funciona offline. As fotos são enviadas quando o dispositivo se reconecta, seja pelo trabalhador ao final da rota ou pela equipe do escritório que recebe as imagens. A extração por IA ocorre no servidor após o upload.
Qual a diferença para aplicativos de coleta de dados em campo como Fulcrum ou GoFormz?
Essas plataformas substituem o formulário de papel por um formulário digital que os trabalhadores preenchem no dispositivo. Isso exige mudança de comportamento — os trabalhadores precisam aprender uma nova interface, navegar por menus suspensos e digitar em uma tela sensível ao toque em condições de campo. A extração de fotos por IA mantém o comportamento de campo existente — tirar uma foto — e automatiza a etapa de transcrição no escritório. É um ponto de intervenção diferente no fluxo de trabalho.
Os arquivos são processados com segurança e não são armazenados.