Precisão da Extração de Formulários de Dados de Campo:
Clima, Caligrafia e Design de Formulários
A precisão da extração de formulários de dados de campo é decidida muito antes de o arquivo chegar a uma ferramenta de extração — é decidida na prancheta, sob a chuva, pela pessoa que segura a caneta. Um técnico ambiental em um tópico do r/Environmental_Careers resumiu em termos que qualquer pessoa que já percorreu uma área úmida entende: "Se não há lama nos seus formulários de dados, você realmente demarcou a área úmida?" Essa lama não é apenas autenticidade — é o maior indicador isolado de que uma contagem de pragas, uma leitura de pH ou uma constatação de segurança sairá correta do outro lado. Este artigo mapeia cada fator entre um formulário em campo e uma linha confiável no banco de dados, e indica quais deles estão realmente sob seu controle.
Principais Conclusões
- Problemas de precisão em formulários de campo quase nunca são culpa da ferramenta de extração — são decididos na prancheta, sob a chuva, pela pessoa que segura a caneta, muito antes de o arquivo chegar a qualquer software.
- As mesmas condições que dificultam a leitura de um formulário pela IA também dificultam para humanos: taxas de erro documentadas de transcrição manual (digitar o que está no formulário em um banco de dados à mão) variam de 1 a 10%, e somente a qualidade da captura altera os resultados da extração em 10 a 20 pontos percentuais.
- Pare de procurar uma ferramenta de extração melhor — sua verdadeira alavanca é a cadeia: projete formulários com códigos em vez de texto livre, fotografe-os no dia da coleta e verifique apenas os 10% das células que a IA sinaliza como incertas, em vez de redigitar tudo.
Mesmo a Transcrição Perfeita Começa Atrás
Antes de qualquer software entrar em ação, o ato de copiar dados de campo manualmente já perde uma porcentagem mensurável deles — e os dados de campo, coletados com luvas e vento, perdem mais do que os dados de escritório.
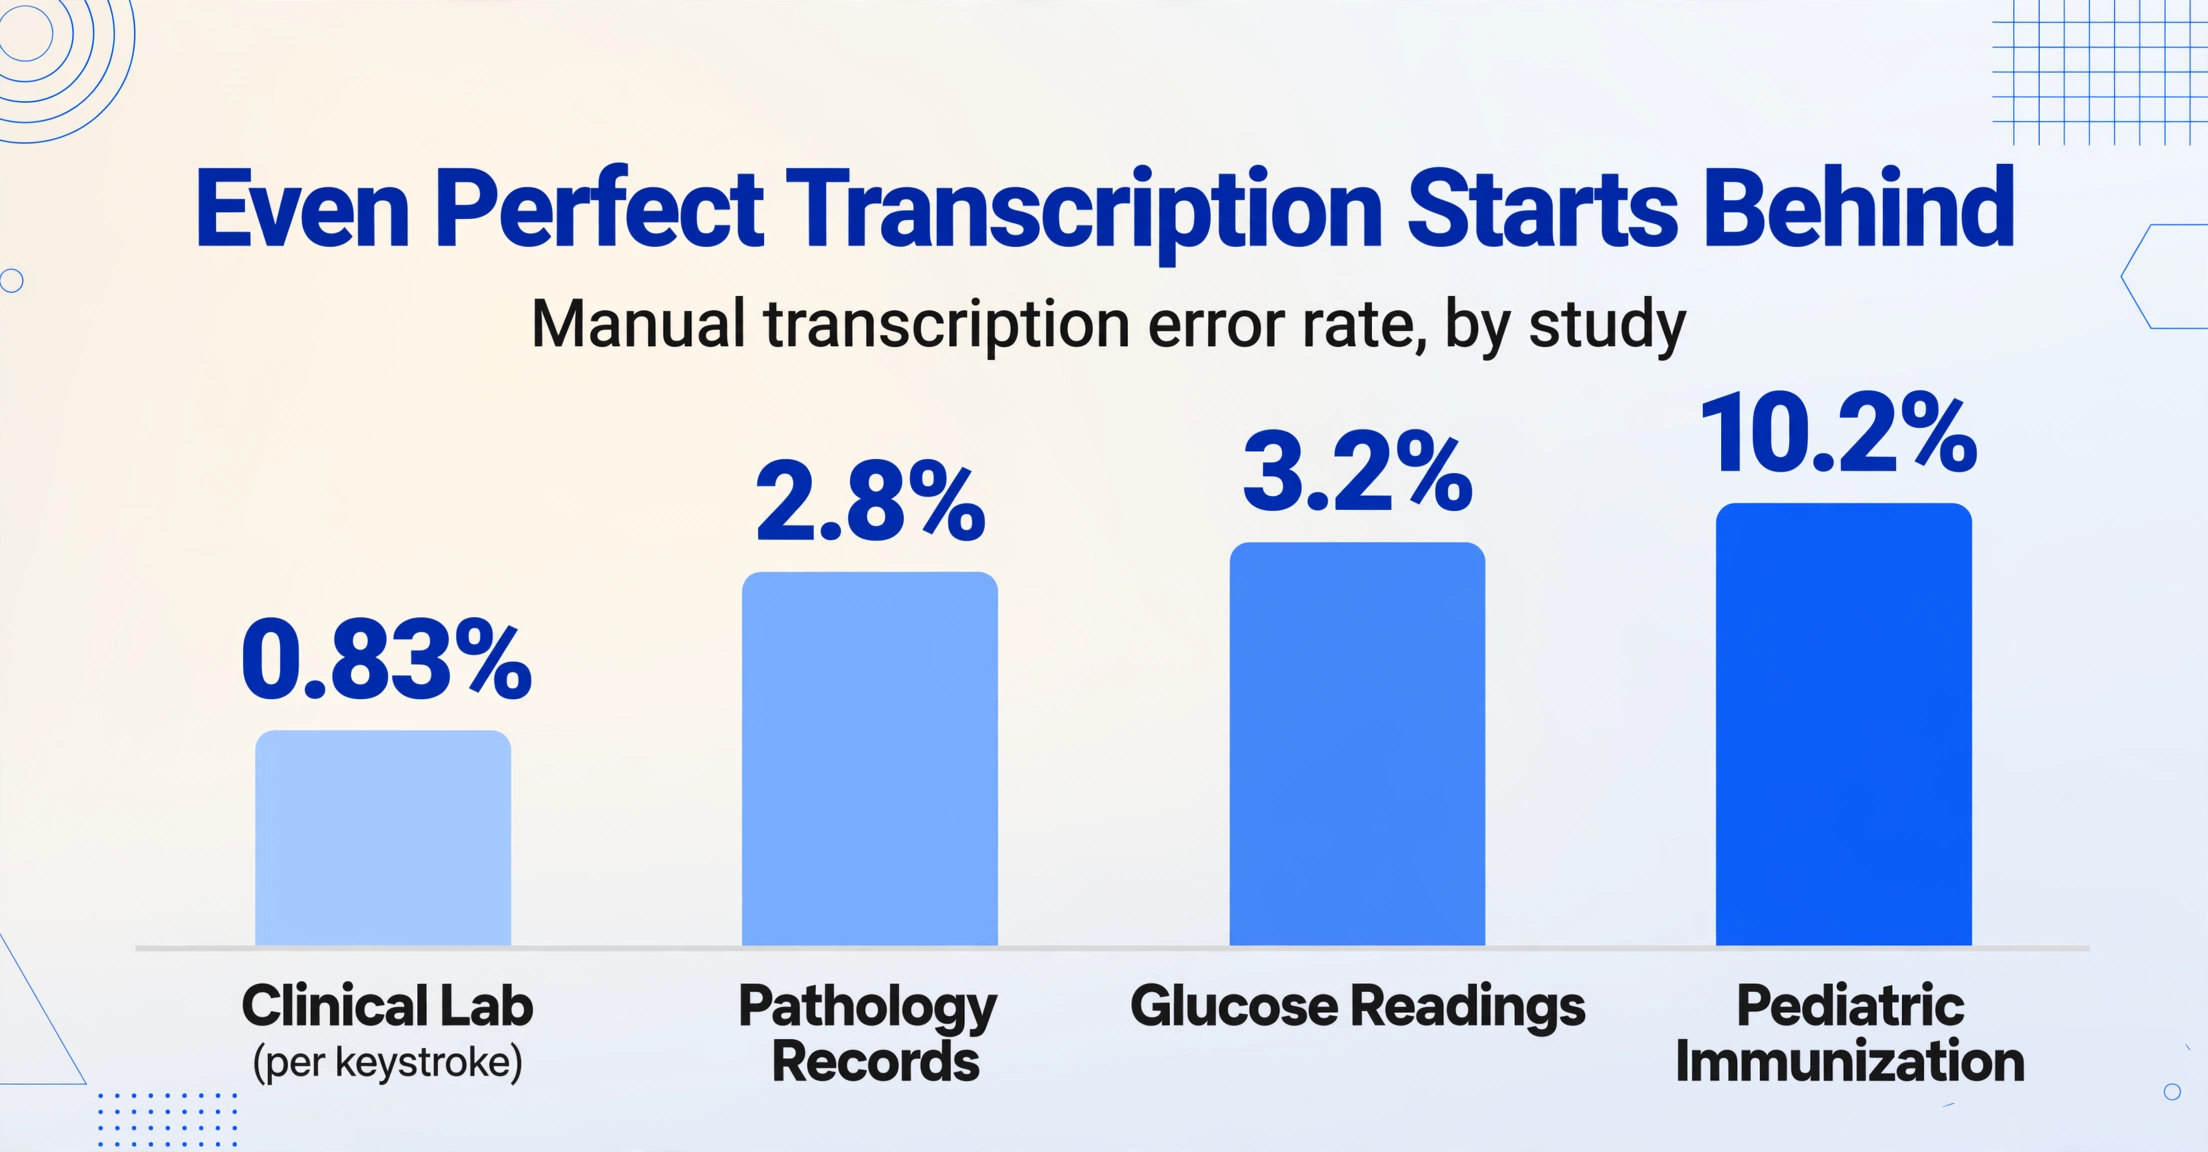
Estudos sobre erros de transcrição manual em ambientes médicos e de registros, resumidos em uma revisão revisada por pares publicada no arquivo PMC do NCBI, encontraram taxas de erro abrangendo uma ordem de magnitude: 0,83% por toque de tecla em um laboratório clínico, 2,8% no geral em um estudo de registros de patologia (variando de 0,5–6,4% dependendo do campo), 3,2% para leituras de glicose no ponto de atendimento e 10,2% em um conjunto de dados de imunização pediátrica. O ponto em comum é que mesmo pessoas motivadas e treinadas cometem erros de dígito único baixo ao mover valores entre mídias — e os erros se concentram exatamente nos campos numéricos dos quais o trabalho de campo depende: dígitos transpostos em pH, o ID de amostra errado em um composto, um nível de água que cai na coluna do vizinho.
Essa é a linha de base. O software de extração compete não contra a transcrição perfeita, mas contra essa linha de base falha e em velocidade humana — por isso "a IA é precisa?" é a pergunta errada. A pergunta certa é "precisa em comparação com o quê, em quais entradas?" O espectro de precisão campo por campo que mapeamos separadamente mostra o mesmo fenômeno do lado da ferramenta: texto impresso perto de 99%, cursiva perto de 70%, caixas de seleção em algum lugar entre — uma variação de 25 pontos em um único formulário. A variação é onde vivem os formulários de campo, porque tudo o que torna um formulário difícil de ler também o torna difícil de transcrever, sejam as mãos que leem humanas ou de máquina.
Chuva, Lama e Luz Solar: O Campo Reescreve o Formulário
O dano físico ao papel é o primeiro fator de precisão, e também é o que as equipes de campo menos esperam que importe, porque param de vê-lo. Um técnico que carregou um diário de bordo durante toda a temporada não nota mais a mancha de água na coluna de condutividade, o vinco onde a folha foi dobrada no bolso da calça, ou a tinta que o sol desbotou para um cinza fraco. Cada um desses degrada o sinal visual que o modelo de extração lê — da mesma forma que degrada o sinal que um supervisor lendo o formulário no escritório leria.
As equipes de campo têm seus próprios truques que revelam o quão real é o problema. No mesmo tópico do r/Environmental_Careers, um comentarista compartilhou a solução clássica: "Dica de campo: compre o papel solto à prova d'água e imprima os formulários nele. Vale o custo!" Papel resistente à água, canetas de tinta indelével e pranchetas com tampa existem porque água, lama e sol destroem de forma confiável os registros de campo. Quando esses registros sobrevivem, chegam ao escritório ainda com o clima escrito neles — e essa é a entrada que um pipeline de extração recebe.
O que é controlado aqui: fotografar ou escanear o formulário enquanto ainda está legível — no dia em que é preenchido, não no dia em que chega ao escritório. Formulários fotografados no momento do registro capturam a escrita antes que uma semana na cabine do caminhão a desbote. Quando isso não for possível, tratar formulários visivelmente danificados como um lote separado e menor, e esperar verificá-los mais intensamente (mais sobre verificação abaixo).
Cópias carbono e formulários duplicados adicionam uma segunda camada de dano: a qualidade da impressão na segunda e terceira cópias degrada acentuadamente, e se os membros da equipe preencherem ambas as cópias ao mesmo tempo, a pressão pode tornar a escrita da folha superior superficial. A extração trata uma cópia carbono fraca da mesma forma que uma pessoa — lê, hesita e pode ler errado. A mesma lógica se aplica ao lápis: apagável e legível para o escritor, fraco e propenso a borrões para qualquer um que o leia depois.
Escritura Manual Feita por uma Persona Cansada Usando Luvas
A qualidade da escrita manual varia mais ao longo de uma tarde do que entre quaisquer duas ferramentas de extração — o décimo primeiro formulário de um trabalhador de campo é mensurabilmente menos legible que o primeiro. A pesquisa sobre reconhecimento de escrita manual trata a legibilidade como uma propriedade do escritor, mas no trabalho de campo é uma propriedade das condições: dedos frios, luvas molhadas, uma prancheta equilibrada sobre o capó de um caminhão, a pressão de avançar à próxima estação. Técnicos de campo no Reddit descreven o tradeoff com precisão — "No campo, é muito mais rápido escrever um número em um formulário de papel que desbloquear o iPad, abrir o app, digitar o número" — razão pela qual o papel sobrevive na era digital, e por que o papel que produz é exatamente o que a extração deve manejar.
A boa noticia é que a maioria da escrita de campo é em letra de imprenta ou estilo impresso, que a extração maneja com alta precisão; o precipício de precisão está na cursiva apressada e nos dígitos escritos rápido o suficiente para que 3 e 8, ou 1 e 7, se confundam. Um formulário misto — etiquetas impressas, valores em bloco manuscritos, uma opção circulada, uma firma — é um caso normal, e os modelos modernos de visão leem a mistura de forma holística em lugar de exigir um estilo consistente por página.
Existe uma resposta institucional a isso que precede a IA, e vale a pena roubar. O Field Book for Describing and Sampling Soils (Versão 4.0, 2024) do USDA NRCS instruye aos cientistas do solo a registrar espécies de plantas como códigos de símbolo estandarizados — big bluestem se torna "ANGE," um código de quatro caracteres da lista oficial de plantas — em lugar de escrever nomes que variam em ortografia e longitude. A percepção de design se transfere diretamente: quanto menos escrita manual de forma livre exige o formulário, menos espaço há para que a própria escrita se converta em fonte de erro. Códigos, caixas de verificação e números são mais legibles para máquinas pela mesma razão que são mais legibles para humanos cansados. Nosso guia de melhora da precisão da escrita manual aprofunda no que faz que a escrita de um formulário seja extraíble e a de outro não.
O Design do Formulário é a Alavanca de Precisão que Ninguém Menciona
O design do formulário determina a precisão da extração mais do que qualquer truque de captura, porque decide o que o modelo de extração precisa interpretar em primeiro lugar. A orientação de gerenciamento de dados ambientais publicada pelo Interstate Technology & Regulatory Council (ITRC) aborda o ponto pelo lado do registro: "Projete uma resposta de formulário de dados de campo com conhecimento do tipo de dado esperado e do comprimento do campo do banco de dados que a receberá." Um formulário projetado com seu banco de dados de destino em mente — um valor por caixa, unidades impressas ao lado da caixa, sem texto livre multilinha onde um código resolve — produz linhas que caem nas colunas certas com interpretação mínima. Um formulário projetado por conveniência gera ambiguidade que nenhum modelo de extração consegue resolver completamente.
Quatro escolhas de design aparecem repetidamente em formulários de dados de campo, e cada uma corresponde a um comportamento conhecido de precisão:
| Escolha de design | Por que é um problema | Versão favorável à precisão |
|---|---|---|
| Espaços em branco abertos para tudo | Campos de texto livre incentivam abreviações, siglas e confusão de unidades — o escritor assume contexto que o leitor não terá | Caixas de seleção para opções conhecidas; unidades impressas no rótulo ("pH (unidades)"), códigos para valores recorrentes |
| Linhas pautadas atravessando áreas de valor | Linhas de grade cruzando o texto criam ruído visual que compete com os caracteres | Espaços espaçados ou linhas pautadas leves que param antes da zona de escrita |
| Alta densidade — tudo em uma página | Campos apertados empurram a escrita contra rótulos e bordas; valores se misturam | Um valor por caixa com separação clara; uma segunda página é melhor que uma primeira lotada |
| Orientação mista em um lote | Páginas paisagem e retrato no mesmo lote exigem cada uma seu próprio caminho de leitura | Uma orientação por lote quando possível; se misturado, a ferramenta deve localizar campos por significado, não por posição |
A última linha importa porque é onde as abordagens de extração divergem. O OCR de modelo fixa cada campo a uma coordenada em um formulário de referência — gire o formulário, mude o layout, adicione um modelo de diário de bordo diferente de uma estação, e as caixas param de corresponder. A abordagem semântica que o ImageToTable.ai usa, Custom Column Extraction, inverte isso: você digita os nomes das colunas desejadas ("pH", "Contagem de Pragas", "ID da Estação"), e a IA localiza o valor que responde a cada nome em qualquer lugar da página, por significado e não por posição. Um lote de formulários de dados de campo com layouts diferentes, caligrafias diferentes e níveis diferentes de dano ainda retorna as mesmas colunas nomeadas, porque o modelo lê o documento como uma pessoa leria — não exige que o campo esteja em uma coordenada memorizada.
Captura: Uma Foto é Metade da Precisão
Entre duas fotos do mesmo formulário, a qualidade da captura sozinha responde por uma variação de 10 a 20 pontos percentuais na precisão — um número que nossos próprios testes de precisão de formulários reproduzem consistentemente. A maior parte dessa variação vem de quatro hábitos baratos: colocar o formulário plano sobre uma superfície sólida, evitar reflexos e contraluz, manter o telefone paralelo à página e enquadrar a página inteira, incluindo os identificadores do cabeçalho. Os modos de digitalização de documentos das câmeras de celular automatizam a maior parte disso — correção de perspectiva, achatamento e remoção de sombras são recursos integrados a qualquer telefone moderno — mas só ajudam se o técnico de campo os ativar.
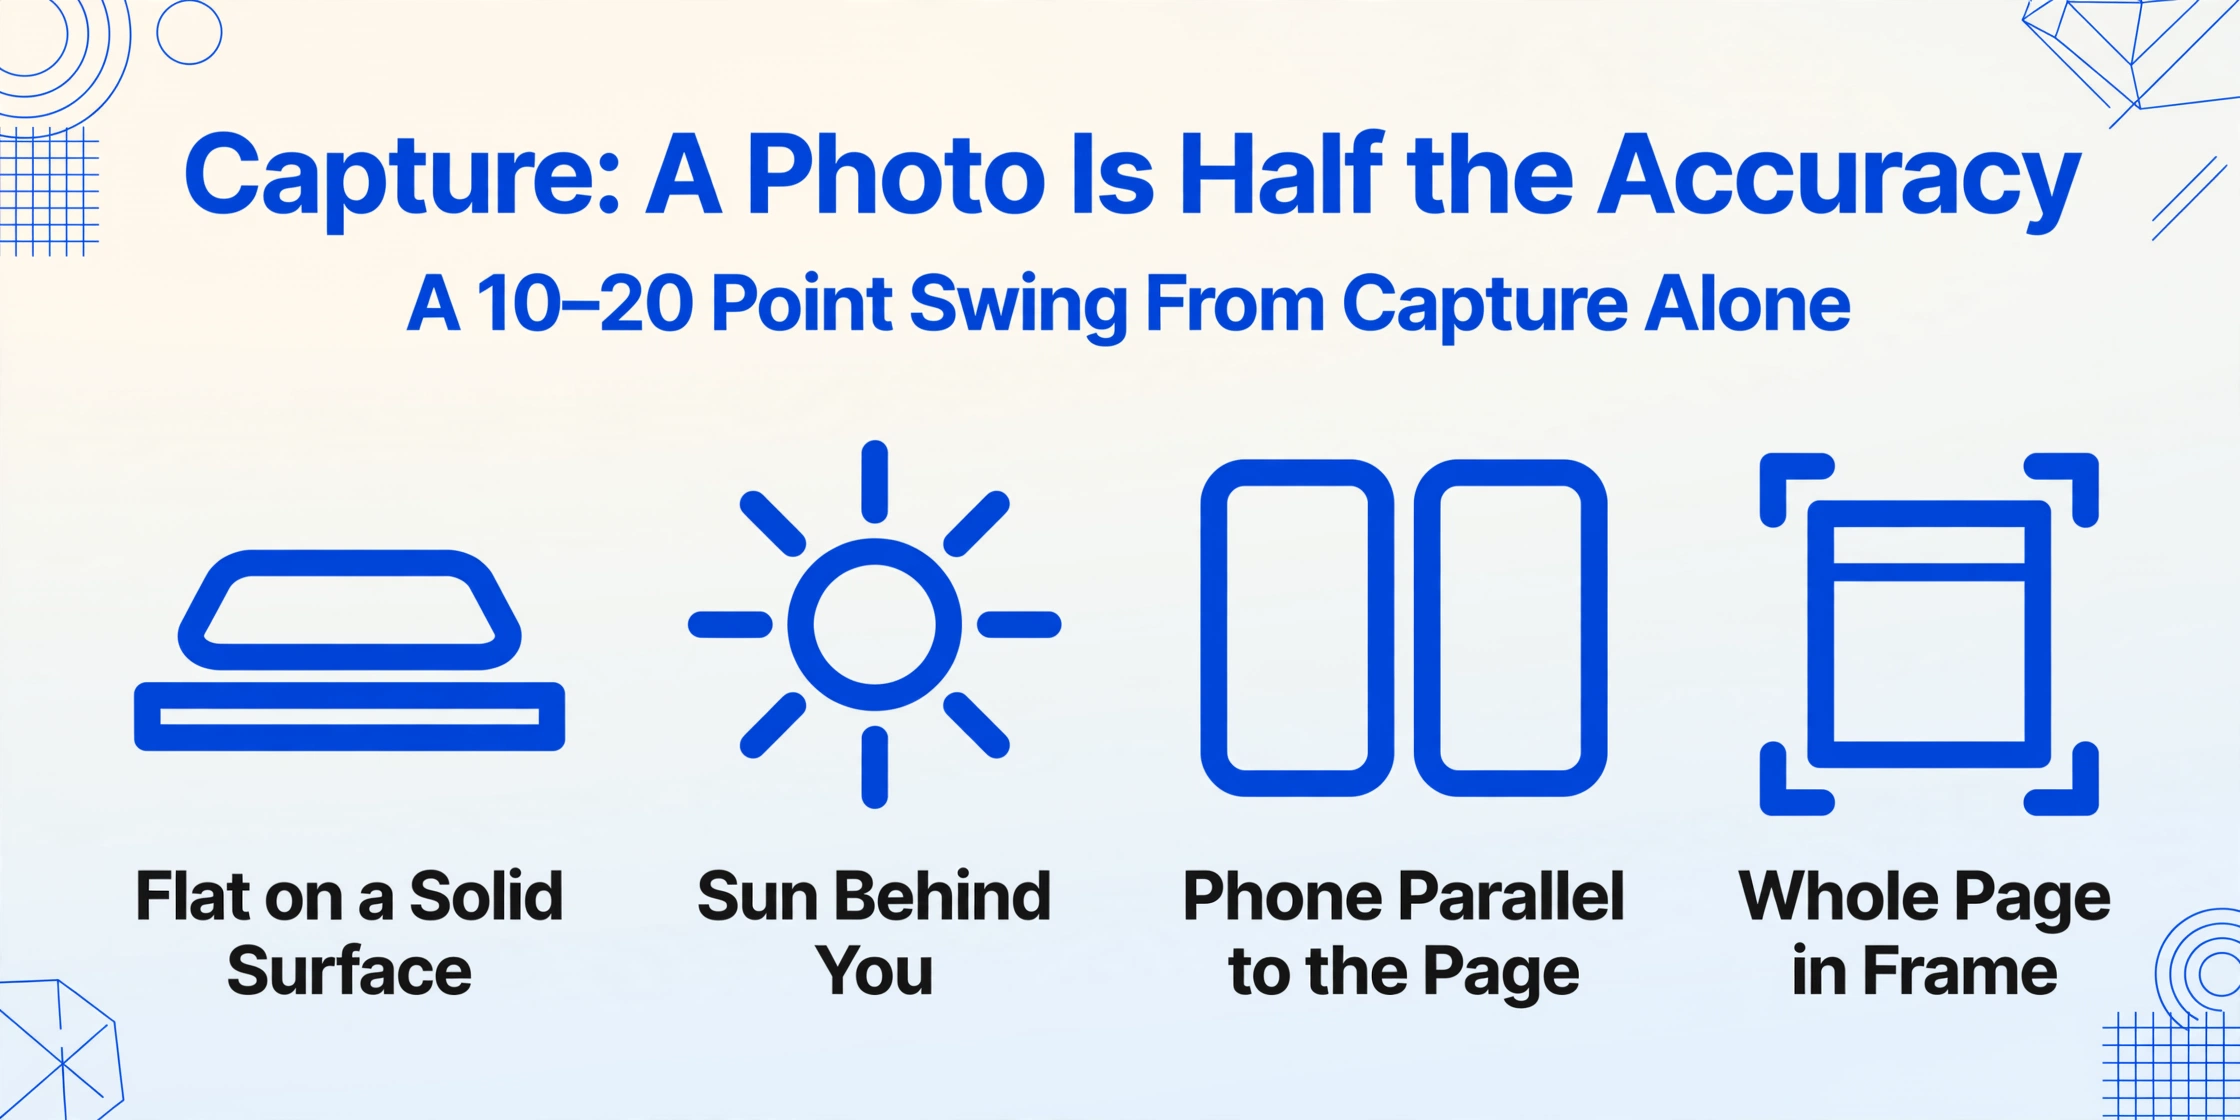
A captura ao ar livre tem seus próprios modos de falha. A luz solar direta apagando a página e a própria sombra do fotógrafo caindo sobre a escrita são os dois mais comuns, e ambos são corrigidos pelo mesmo movimento: virar-se para que o sol fique atrás do fotógrafo, ou usar a própria sombra para proteger a página. O técnico no tópico do Reddit que descreveu formulários digitais como "difíceis de ler sob luz solar intensa" descrevia a mesma física que subexpõe um formulário de papel segurado contra um céu claro — exceto que um formulário de papel pode ser sombreado, inclinado ou movido, e uma foto captura apenas o que a câmera viu.
A resolução importa menos do que as pessoas supõem, além de um limite modesto — uma foto de celular de um formulário tamanho carta tem tipicamente 2.000–3.000 pixels de largura, mais que suficiente — mas o tipo de captura importa: uma digitalização plana e bem iluminada de um formulário limpo é o melhor caso; uma foto do mesmo formulário tirada no caminhão ao anoitecer é o pior caso, e ambos podem estar no mesmo lote. Se as fotos da equipe ficam no caminhão por uma semana, o padrão de Link de Coleta que descrevemos no nosso guia de fluxo de trabalho de formulário de campo para Excel — um link compartilhável que permite à equipe enviar fotos diretamente para a fila de processamento — encurta essa lacuna e limita o quanto os formulários se degradam antes da captura.
Por que a extração semântica resiste onde o OCR de modelo falha
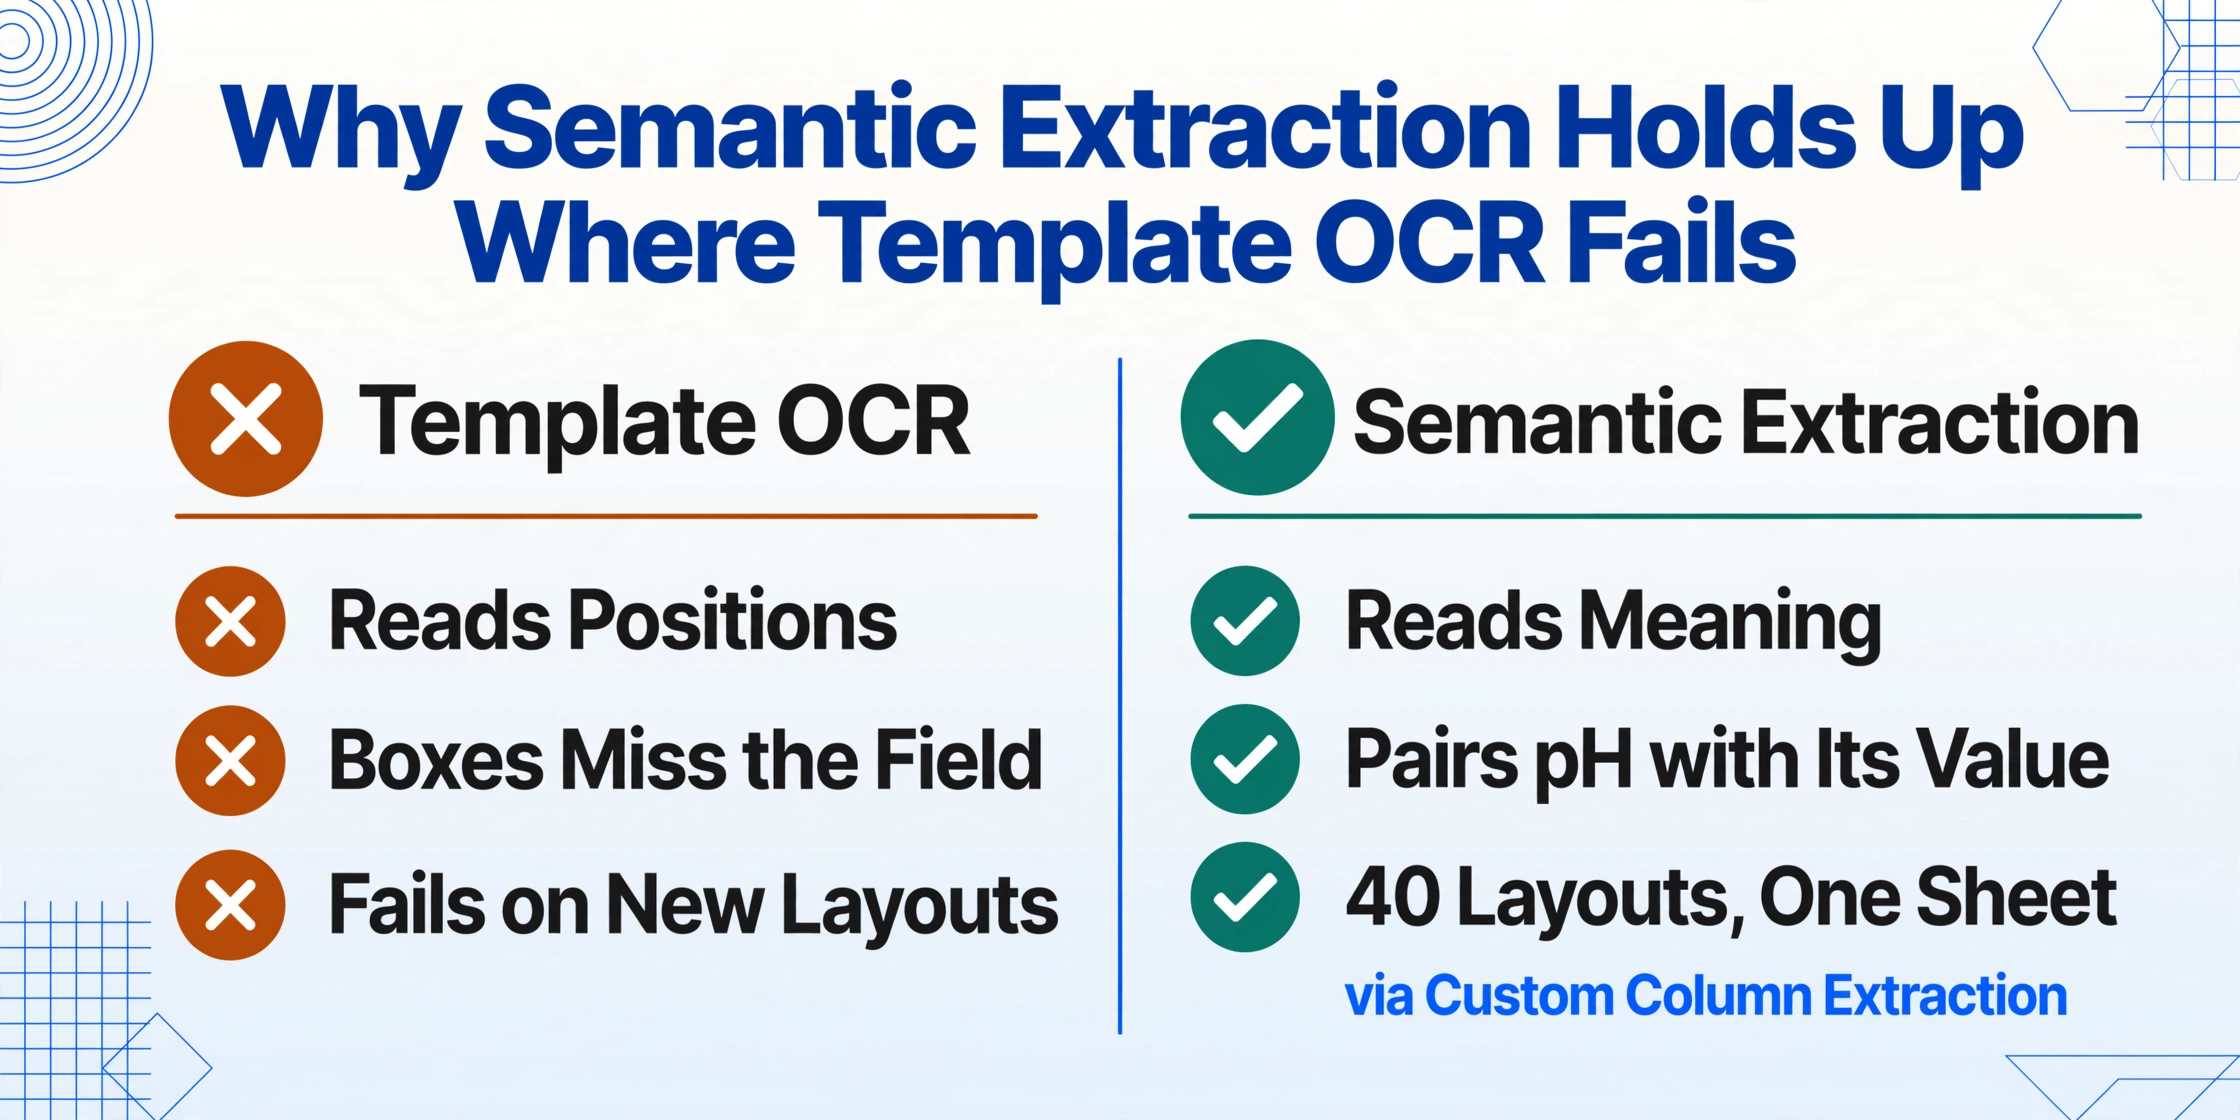
O OCR de modelo lê posições; a extração semântica lê significado — e em formulários de campo, as posições mentem.
O OCR de modelo ganó sua reputação em faturas e formulários que chegam da mesma fonte no mesmo layout toda vez: desenhe uma caixa em um documento de referência, extraiga o que caiga na caixa, repita. Os formulários de dados de campo violan essa suposição em cada turno — diferentes equipes usan layouts diferentes, as estaciones têm modelos de registro diferentes, um formulário pode ser escaneado em horizontal uma ronda e fotografado em vertical na seguinte. Quando o layout se desloca, as caixas já não se alinean com os campos, e a precisão colapsa mesmo quando a escritura é perfeitamente legible.
A extração por modelo de visão evita por completo a falha posicional. O modelo lê a página completa, entende que "pH" é uma medição e que o valor ao lado responde a ela, e devolve o par independentemente de onde se situe. Este é o mecanismo por trás da Custom Column Extraction descrita acima, e também é o motivo pelo qual um lote de 40 formulários com 40 layouts diferentes ainda produz uma única planilha limpa. A guía do ITRC reconoce o mesmo princípio desde o lado dos dados — os dados de campo "frecuentemente merecen escrutinio adicional debido a la mayor probabilidad de errores, como transcripción o deriva del instrumento in situ" — porque os erros nos dados de campo são semánticos (valor equivocado para contexto equivocado) mais frequentemente que posicionais. Uma ferramenta que entende o contexto está respondendo à pregunta correta.
Este é o lugar honesto para declarar o que a extração semántica não pode corrigir: escritura ilegible, um valor riscado com um traço de caneta que o modelo interpreta mal como parte do número, ou uma página onde a chuva converteu a tinta em aquarela. Nenhuna ferramenta — humana ou máquina — recupera dados que o documento de origem já não contém. O que a extração cambia é o perfil de erro: move a falha de milhares de teclas onde os erros se ocultan invisiblemente, a um punhado de células marcadas onde um humano pode verificarlas. Para um olhar mais profundo sobre os modos de falha restantes da escritura manual, nossa análise de modos de falha de extração de escritura manual os cataloga em detalhe.
Verifique o Que Importa, Não Tudo
Como nenhuma extração é 100% precisa, a questão que decide se a extração de dados de campo funciona é onde você direciona sua verificação — e a resposta são os mesmos campos que seu framework de conformidade já prioriza. O Quality Assurance Handbook for Air Pollution Measurement Systems (EPA-600/R-94/038a) da EPA e os programas ambientais que o seguem definem a verificação de dados como a checagem de que "os dados foram transcritos e registrados com precisão" e que os registros eletrônicos e em papel mostram correspondência um a um. A regra de manutenção de registros 29 CFR 1904 da OSHA exige o relatório de incidente OSHA Form 301 dentro de sete dias após uma lesão registrável — um prazo que torna a velocidade da extração um recurso de conformidade e a precisão dos detalhes transcritos um requisito de conformidade. O Padrão de Gestão de Nutrientes NRCS 590 do USDA condiciona a elegibilidade de custos compartilhados a procedimentos de amostragem e teste de solo que seguem o padrão — incluindo os registros que comprovam que as amostras foram manuseadas corretamente.
Os três frameworks convergem na mesma necessidade operacional: uma forma de confirmar que os valores no banco de dados correspondem aos valores nos formulários de origem, sem reler cada linha manualmente. Essa é a lacuna que a verificação assistida por caixa delimitadora preenche. Na tela de revisão do ImageToTable.ai, passar o mouse sobre qualquer célula extraída destaca a região exata da imagem original de onde aquele valor veio — e clicar em uma região da imagem salta de volta para a célula correspondente. Em vez de redigitar para verificar, um revisor confirma as poucas células que a IA sinalizou como incertas, e o restante é confiável. Isso transforma "verificar tudo" (que é o que torna a transcrição manual lenta) em "verificar os 10% arriscados" (que leva segundos por formulário).
O fluxo de trabalho realista é: processar o lote, escanear as linhas extraídas contra os originais com destaque de caixa delimitadora, corrigir as células sinalizadas e exportar. O mesmo padrão se aplica aos registros de manutenção e inspeção de outras operações de campo — o fluxo de trabalho de registro de manutenção para Excel mostra o mesmo ciclo de captura-revisão-exportação em um contexto industrial, e nossa análise de onde os pipelines de dados de campo falham explica por que a etapa de verificação é onde a maioria dos sistemas manuais falha silenciosamente.
Perguntas Frequentes
A extração consegue ler formulários danificados pela chuva ou com manchas de água?
Depende de quanto da escrita sobreviveu à chuva. Manchas leves ao redor de texto legível geralmente são tratadas sem problemas; tinta que escorreu ou desbotou a ponto de ficar ilegível não é recuperável por nenhuma ferramenta, humana ou máquina. A solução prática é o momento da captura: fotografar os formulários no dia em que são preenchidos, enquanto a escrita ainda está intacta, em vez de depois de uma semana no campo. Para formulários que precisam ser armazenados no campo, papel resistente à água e tinta indelével (o truque de escrever na chuva que as equipes de campo compartilham) preservam o registro.
E se a caligrafia da minha equipe for apressada ou bagunçada?
A maioria da escrita de campo é em letra de forma e extrai bem. O ponto crítico de precisão é a caligrafia cursiva apressada e dígitos ambíguos (3 vs 8, 1 vs 7). Duas coisas ajudam: projetar formulários que minimizem a escrita à mão livre (códigos, caixas de seleção, um valor por caixa — a abordagem de símbolos de plantas do NRCS) e usar a etapa de verificação para conferir exatamente as células que a IA sinaliza como incertas, usando o destaque por caixa delimitadora contra a imagem original.
A extração lida com caixas de seleção, opções circuladas e assinaturas?
Sim. Os modelos de visão leem caixas marcadas, opções circuladas e assinaturas manuscritas como elementos visuais, não apenas texto. Para campos em que os membros da equipe circulam ou marcam uma opção em vez de escrever um valor, defina a coluna com as opções por extenso — Pressão de Pragas (opções: Baixa / Média / Alta) — para que o modelo mapeie a marca para o rótulo correto.
Uma foto de celular é suficiente ou preciso de um scanner?
Uma foto de celular plana e bem iluminada é suficiente para a maioria dos formulários de campo — o modo de digitalização de documentos dos celulares modernos corrige perspectiva e sombras automaticamente. A qualidade da captura varia a precisão em 10–20 pontos percentuais, então os hábitos importam mais que o hardware: superfície plana, câmera paralela, página inteira no quadro, sem reflexos. Um scanner só vence quando o formulário já está limpo e está por perto.
Nossas estações usam layouts de formulário diferentes. A extração ainda funcionará?
Sim — este é o caso que quebra especificamente o OCR de modelo. Como o ImageToTable.ai localiza valores pelo significado, e não pela posição na página, um lote que mistura diferentes layouts, orientações e estilos de caligrafia ainda retorna as mesmas colunas nomeadas. Não é necessário manter um modelo por layout; basta nomear as colunas uma vez e o modelo encontra os valores.
Qual precisão devo realmente esperar?
Texto impresso em formulários extrai perto de 99%; caligrafia legível em letras de forma extrai bem; cursiva apressada cai para a casa dos 70 — a mesma variação que os humanos apresentam ao transcrever manualmente, onde as taxas de erro documentadas variam de 1 a 10% em estudos. Espere o melhor resultado em formulários limpos, bem capturados e bem projetados, e espere verificar os piores 10% das células em formulários danificados ou bagunçados. Qualquer ferramenta que prometa 100% em dados de campo não está sendo honesta sobre suas entradas.
A precisão em formulários de campo não é uma propriedade do modelo de IA — é uma propriedade de toda a cadeia: o papel, a caneta, o design, a foto e a etapa de verificação. Cada elo é algo que você pode controlar.
Trabalhe a cadeia em ordem e o resultado se torna previsível: projete formulários que exijam menos caligrafia, capture-os enquanto estão legíveis, processe em lote com uma ferramenta que lê significado em vez de posição e verifique as células arriscadas em vez de redigitar tudo. É assim que um diário de qualidade da água escrito na chuva se torna um conjunto de dados pronto para conformidade — e como um formulário de amostra de solo preenchido no fim de um longo dia mantém seus números intactos no caminho para o banco de dados. A lama sempre fez parte do trabalho. Fazer com que ela pare de custar seus dados é a parte que a extração resolve — teste em um formulário que realmente esteve no campo.